Вайб-кодинг · сентябрь 2026
Почему вайб-кодинг обходится дороже: 4 статьи расхода
Смотришь на цену подписки - цифра выглядит скромной. По независимому подсчёту 2444 компаний, из каждого доллара расхода на ИИ-разработку только 18 центов доезжают до готового результата, остальные 82 цента уходят на починку, переделку и проверку. Дело не в том, что тебя обманули с тарифом: за одну и ту же задачу платишь несколько раз подряд, просто это не видно в моменте
Дальше по порядку: куда на самом деле уходит доллар, потраченный на вайб-кодинг, что в этом счёте объективная цена инструмента, а что убирается за одну минуту своими же руками
Открой историю своих запросов ассистенту за последнюю неделю и посчитай, сколько раз ты просил переделать уже готовый результат, а не написать новый. Каждая такая переделка - это токены, оплаченные дважды за одну и ту же задачу, и именно они чаще всего и составляют разницу между заявленной ценой подписки и фактическим счётом
Куда реально уходит доллар, потраченный на вайб-кодинг
Есть живое исследование, которое разложило деньги, потраченные компаниями на ИИ-разработку, по составляющим - не мнение, а подсчёт по 2444 реальным командам. Считают эти деньги в токенах - так называют кусочки текста, на которые модель режет твой запрос и свой ответ, примерно как слова в предложении, только чуть мельче: чем длиннее переписка с ассистентом, тем больше таких кусочков набегает и тем больше денег с тебя спишется
Раскладка на каждый потраченный доллар такая: 18 центов доезжают до готового результата, который реально попадает в работу. Остальные 82 цента растворяются в трёх местах - 44 цента на починку того, что сломалось, 27 центов на переписывание того, что ассистент сделал не по задаче, и 11 центов на трение при проверке готового куска перед тем, как его принять
Что это тебе даёт: понимание, что цена подписки - это не итоговая цена задачи. Итоговая цена задачи равна цене подписки, помноженной на то, сколько раз тебе пришлось возвращаться к одному и тому же куску работы. Три из этих четырёх статей расхода (починка, переписывание, трение проверки) снижаются конкретными привычками - им и посвящена вторая половина этой статьи
Почему код от ИИ чаще ломается уже после сдачи
Вторая скрытая статья расхода - это не деньги в моменте, а время, которое всплывает позже, когда код уже вроде бы готов
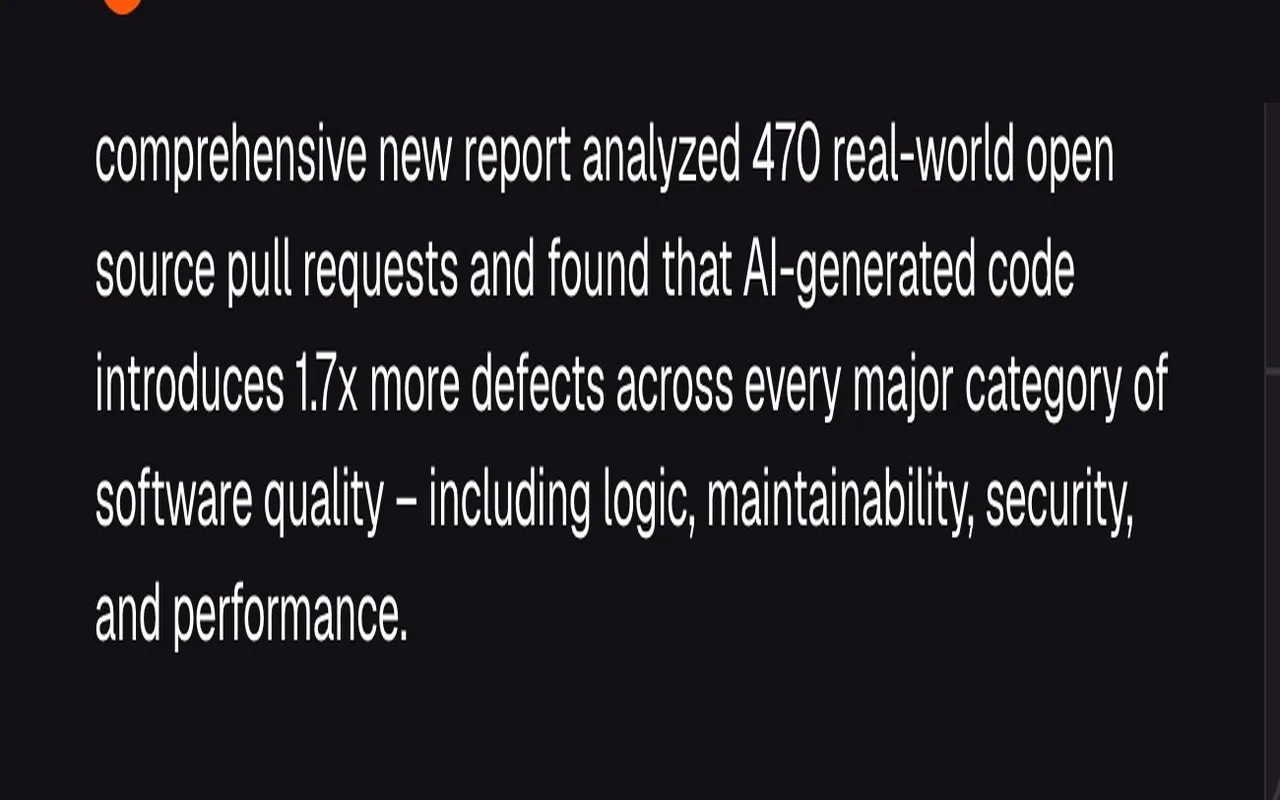
Независимый анализ реальных изменений кода показал: у кода, написанного ИИ, критичных и крупных дефектов почти в два раза больше, чем у кода, написанного человеком - в 1,7 раза, если точно. Внутри этой цифры отдельно выделяются логические ошибки (их на 75% больше) и проблемы читаемости (их больше более чем втрое)
Что это тебе даёт: разница между «код заработал один раз на экране» и «код можно спокойно оставить в проекте» - ровно в этом зазоре живёт та самая скрытая цена. Работающий с первого взгляда пример ещё не значит собранный правильно навсегда
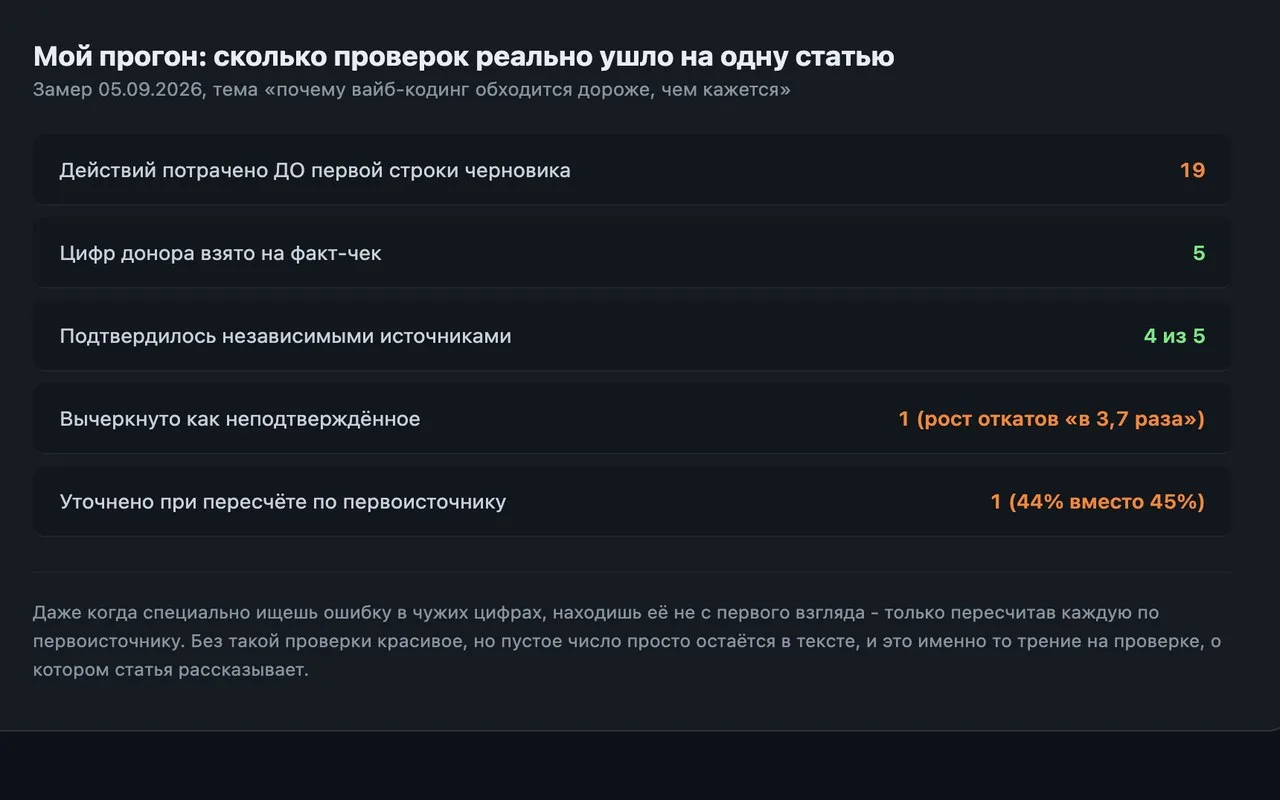
Мой собственный замер по этой же статье, 05.09.2026
- 19 отдельных проверочных действий потрачено ещё ДО первой строчки текста - чтение канона, проверка соседних статей, факт-чек четырёх цифр донора
- одна цифра из первоначального черновика (рост числа откатов «в 3,7 раза») не нашла ни одного независимого источника и в статью не попала
- три из четырёх других цифр подтвердились независимо, но с уточнением: официальный отчёт Veracode говорит про 44% кода с уязвимостью, а не 45%, как было в первой версии материала
Это мой собственный прогон именно на этой задаче: даже когда специально ищешь ошибку в чужих цифрах, находишь её не с первого взгляда, а только пересчитав каждую цифру по первоисточнику. Без такой проверки красивое, но пустое число просто остаётся в тексте
Если нужен полный маршрут по этому шагу, он расписан в разборе Цена обучения Claude Code с нуля в 2026 году: 3 слоя расходов
Шаг 1. Посчитать переделки за неделю
Открой историю своих последних разговоров с ассистентом - там же, где обычно пишешь задачи, есть список прошлых сессий - и посчитай, сколько раз ты просил исправить уже готовый ответ вместо того, чтобы получить его с первого раза
Что увидишь: список твоих последних задач с короткими подписями. Часть из них будут повторами одной и той же темы с разницей в несколько минут или часов - это и есть переделки
Что это даёт: конкретное число вместо ощущения «что-то дорого выходит». Если переделок оказалось больше трети от всех задач за неделю, дальше в этой статье стоит читать особенно внимательно раздел про формулировку запроса. Если ассистент вообще делает не то, что ты просил, а не просто неточно - это отдельная и более частая причина, у меня есть отдельный разбор шести причин, почему Claude делает не то, что просил, и как это исправить
Шаг 2. Добавить одну фразу про проверку в свой запрос
В следующий раз, когда просишь ассистента написать код, добавь одну короткую строку прямо в тот же запрос: «проверь на типичные уязвимости и объясни, от чего они защищают»
Что увидишь: ответ станет чуть длиннее обычного - помимо самого кода появится короткое объяснение, что именно проверено и почему это важно
Что это даёт: часть тех самых 44 центов из раскладки выше уходит на «код без единой мысли о безопасности». Одна фраза в запросе не гарантирует идеальный результат, но заметно снижает шанс, что тебе придётся чинить это позже, когда ошибка уже проявится на практике. Как вообще правильно строить запрос к ассистенту, из каких частей он состоит и что в нём лишнее - я разбирал отдельно: промт это что такое, определение и пять частей и базовые правила запроса к ИИ для новичка
Шаг 3. Разбить крупную задачу на части перед стартом
Один длинный расплывчатый запрос на большую задачу почти всегда превращается в несколько раундов переделок - ассистент домысливает детали, которые ты не назвал, и не всегда угадывает правильно
Прежде чем писать большой запрос, набросай простым списком, из каких маленьких шагов состоит задача. Например: сначала форма для ввода данных, потом проверка введённого, потом сохранение результата. Веди ассистента по списку, шаг за шагом, а не одной командой на всё сразу
Что увидишь: на каждый маленький шаг приходит короткий конкретный ответ, который проще проверить целиком, чем один длинный ответ на всё разом
Что это даёт: меньше почвы для переписывания мимо задачи - именно та статья расхода из раскладки Entelligence, которая съедает 27 центов с каждого потраченного доллара. Мелкий шаг ошибиться может, но ошибку в нём видно сразу, а не через десять минут внутри огромного куска кода. Если задача настолько крупная, что хочется вести её сразу несколькими параллельными разговорами, у меня есть разбор параллельных сессий Claude Code через git worktree - там же честно про то, когда это усложняет больше, чем упрощает. Разбивку задачи на шаги удобно поручить самому ассистенту, если он умеет держать роль наставника - см. Claude как старший инженер: 10 ролей для сложных задач
Шаг 4. Следить за длиной одного разговора
Чем дольше тянется один и тот же диалог с ассистентом без явного завершения задачи, тем выше риск, что качество ответов начнёт проседать - ассистент держит в голове всю историю разговора целиком, и она постепенно перегружается
Если один разговор перевалил за пару десятков сообщений подряд без результата, закрой его и начни новый с коротким пересказом того, что уже сделано и что осталось
Что увидишь: новый разговор начинается с чистого листа, и первый же ответ в нём обычно точнее, чем был бы двадцать пятый ответ в перегруженном старом диалоге
Что это даёт: меньше шансов, что ассистент «забудет» важную деталь задачи из начала долгого разговора и предложит решение мимо цели - именно так рождается часть тех самых переделок из Шага 1. Если ассистент, наоборот, слишком часто перечитывает весь проект заново и это ощутимо замедляет ответ, у меня есть отдельный разбор: Claude Code перечитывает проект - 3 причины и что с этим делать. А если задача поручается агенту, который действует без твоего постоянного присмотра, стоит заранее посмотреть 4 риска безопасности автономных ИИ-агентов в 2026 году - там же про то, как эти риски снижаются
Что в этом счёте объективно, а что зависит от тебя
Не вся скрытая цена вайб-кодинга управляется дисциплиной. Есть часть, которая относится к самому инструменту, а не к тому, как им пользуешься
Новое поколение моделей считает длину текста по-другому: тот же самый текст на новом счётчике превращается в заметно большее число мелких кусочков, чем на предыдущей модели - примерно на 30% больше для английского языка и кода. Цена за один такой кусочек при этом формально не меняется, но их на ту же задачу уходит больше, а значит и итоговый счёт растёт
По собственной проверке официальной модели тарификации Claude Code, каждое новое сообщение внутри одного разговора учитывает не только само сообщение, а весь предыдущий диалог целиком - чем длиннее разговор, тем дороже обходится каждый следующий шаг внутри него, и это прямое следствие того, как считается контекст, а не скрытая наценка
Что это тебе даёт: два разных вида экономии. Формулировку запроса, разбивку задачи на шаги и слежку за длиной разговора контролируешь ты сам уже сегодня. То, как модель режет текст на мелкие кусочки и что за это берёт - это факт инструмента, который стоит просто знать и закладывать заранее, а не пытаться перехитрить
Сколько стоит один и тот же результат в цифрах
Если раскладывать это в понятные пропорции, получается такая картина
| Куда уходит доллар токенов | Доля | Что с этим делать |
|---|---|---|
| Готовый результат, дошедший до дела | 18 центов | это и есть цель, к ней стремимся |
| Починка того, что сломалось | 44 цента | Шаг 2: одна фраза про проверку в запросе |
| Переписывание мимо задачи | 27 центов | Шаг 3: разбивка на маленькие шаги |
| Трение на проверке результата | 11 центов | Шаг 4: не растягивать один разговор |
Таблица прокручивается вбок →
Что это тебе даёт: три из четырёх статей расхода поддаются прямому влиянию уже сегодня, без смены инструмента и без доплаты за более дорогой тариф. Прикинуть свою собственную картину расходов по задаче заранее, до того как она превратится в реальный счёт, можно на калькуляторе экономики вайб-кодинга - вводишь свои цифры и сразу видишь, сколько в среднем стоит довести задачу твоего масштаба до готового результата
Три признака, что пора остановиться и переформулировать
Не каждую переделку стоит терпеть до конца, надеясь, что следующий ответ окажется точным. Есть три сигнала, по которым проще закрыть текущий разговор и начать заново с более чётким запросом, чем продолжать давить тем же способом
| Сигнал | Что происходит | Что делать |
|---|---|---|
| Третья правка подряд об одном и том же | ассистент каждый раз чинит симптом, а не причину | остановиться, переформулировать задачу целиком, не патчить дальше |
| Ответ стал длиннее, а точность не выросла | разговор перегружен историей, важное тонет в объёме | закрыть диалог, начать новый с коротким пересказом (Шаг 4) |
| Правка одного места ломает другое | задача была слишком крупной для одного захода | разбить на маленькие шаги и вести по списку (Шаг 3) |
Таблица прокручивается вбок →
Что это тебе даёт: три конкретных повода перестать пытаться дожать один и тот же разговор. Каждый из трёх сигналов уже разобран отдельным шагом выше - таблица просто помогает быстро узнать момент, когда стоит применить нужный шаг, а не тратить ещё один раунд переделки впустую
Что путают чаще всего
Слово «дороже» в теме этой статьи легко перепутать с двумя соседними, но разными вопросами. Путаница обычно и рождает вывод «значит, вайб-кодинг вообще не стоит того»
| Что имеют в виду | Что это на самом деле | Где искать ответ |
|---|---|---|
| «Вайб-кодинг дорого стоит на старте» | цена подписки и инструмента до начала работы | вайб-кодинг простыми словами: цены и бесплатный старт |
| «Курс вайб-кодинга дорогой и бесполезный» | цена обучения, которое не даёт нужной дисциплины | как выбрать курс и не попасться на красные флаги |
| «Счёт за задачу больше, чем я планировал» | именно тема этой статьи: цена переделок, а не тарифа | четыре шага и раскладка расходов выше |
Таблица прокручивается вбок →
Что это тебе даёт: точный вопрос вместо общего разочарования. Если дорого показалось на старте - смотри первую строку таблицы, если разочаровал курс - вторую, а если счёт вырос уже после того, как ты начал работать - решение именно в этой статье
Смежная часть работы разобрана в гайде Цены на инструменты вайб-кодинга в 2026 году: 5 сервисов
Когда переплата - это цена курса, а не инструмента
Часть переплаты в вайб-кодинге вообще не связана с токенами - это деньги, отданные за обучение, которое не закрывает нужную задачу. Разбирал это отдельно: как выбрать курс вайб-кодинга и не попасться на шесть красных флагов - там как раз про то, как за пятнадцать минут до оплаты понять, дадут ли тебе реальную дисциплину проверки и разбивки задач или просто покажут красивую запись экрана
Если ты пока не выбрал вообще ни один инструмент и стартуешь с нуля, начни с базового разбора: вайб-кодинг простыми словами и первый проект за вечер - там как раз про честную стартовую цену входа, до всех переделок и скрытых статей расхода из этой статьи. А если уже выбираешь между конкретными инструментами по цене и задачам, пригодится сравнение четырёх инструментов вайб-кодинга
Про заработок и профессии на стыке ИИ и вайб-кодинга у меня отдельный раздел сайта - все разборы денег и профессий одним списком: там и про то, как из навыка вайб-кодинга собрать первые деньги, и про смежные темы вокруг заработка с нейросетями. Два конкретных примера оттуда: фриланс с нейросетями - три биржи, цены и первый заказ и заработать на сайтах - путь новичка с ИИ без кода
Ещё разборы вокруг вайб-кодинга
Маршрут вокруг самой дисциплины работы с ассистентом: как строить запрос, как не терять контроль над задачей и что вообще умеет инструмент
- Что умеет Claude Cowork и три режима проверки - режим, где ассистент видит всю твою папку целиком
- Как подключить свой первый сервис через Claude MCP - когда ассистенту нужны чужие данные
- Скиллы для Claude: что это и как установить - готовые умения поверх обычного чата
- Агенты для Claude Code: полный разбор для новичка - когда одного диалога уже не хватает
- Бесплатные готовые умения с GitHub для Claude Code - расширить возможности без доплаты
- CLAUDE.md: памятка для ИИ и замок на важное - чтобы не объяснять контекст заново каждый разговор
- Лимит сообщений в Claude: как работать весь день без стопа - вторая половина уравнения расхода, время без остановки
- 5-часовой лимит ChatGPT Plus: как проверить свою квоту - если работаешь через другой инструмент
Источники
Числа про раскладку доллара расхода, качество кода и стоимость токенов сняты с независимых отчётов и официальной документации 05.09.2026. Число про свою собственную работу над этой статьёй - из своего замера, запись действий лежит в каталоге статьи
- Исследование Entelligence AI по 2444 компаниям, раскладка расходов на ИИ-разработку на каждый потраченный доллар - Yahoo Finance, разбор с дословной цитатой раскладки, тот же материал голым адресом - finance.yahoo.com/sectors/technology/articles/82-ai-engineering-spend-lost-220000330.html
- Отчёт Veracode «2026 GenAI Code Security Report», средний процент прохождения проверки безопасности по 100+ моделям - veracode.com, полный отчёт, тот же отчёт прямым адресом - veracode.com/resources/analyst-reports/2026-genai-code-security-report
- Отчёт CodeRabbit «State of AI vs Human Code Generation», 470 реальных изменений кода, кратность дефектов ИИ-кода против человеческого - coderabbit.ai, полный отчёт, тот же отчёт прямым адресом - coderabbit.ai/whitepapers/state-of-AI-vs-human-code-generation-report
- Разбор Simon Willison про смену токенизатора Claude Sonnet 5 и рост числа токенов на тот же текст - simonwillison.net, темы про Claude, тот же адрес голой строкой - simonwillison.net/tags/claude
- Официальная модель тарификации Claude Code: как считаются токены за сообщение и за весь разговор - docs.claude.com, стоимость Claude Code, тот же документ голой строкой - docs.claude.com/en/docs/claude-code/costs
- Официальные актуальные цены Anthropic за миллион токенов по моделям - docs.claude.com, цены, тот же документ голой строкой - docs.claude.com/en/docs/about-claude/pricing
Памятка: где реально теряются деньги на вайб-кодинге
Четыре строки, по которым проходит вся разница между заявленной ценой и фактическим счётом
Сохрани себе
- на каждый доллар токенов в среднем 18 центов доезжают до готового результата, остальное съедают починка, переделка и проверка
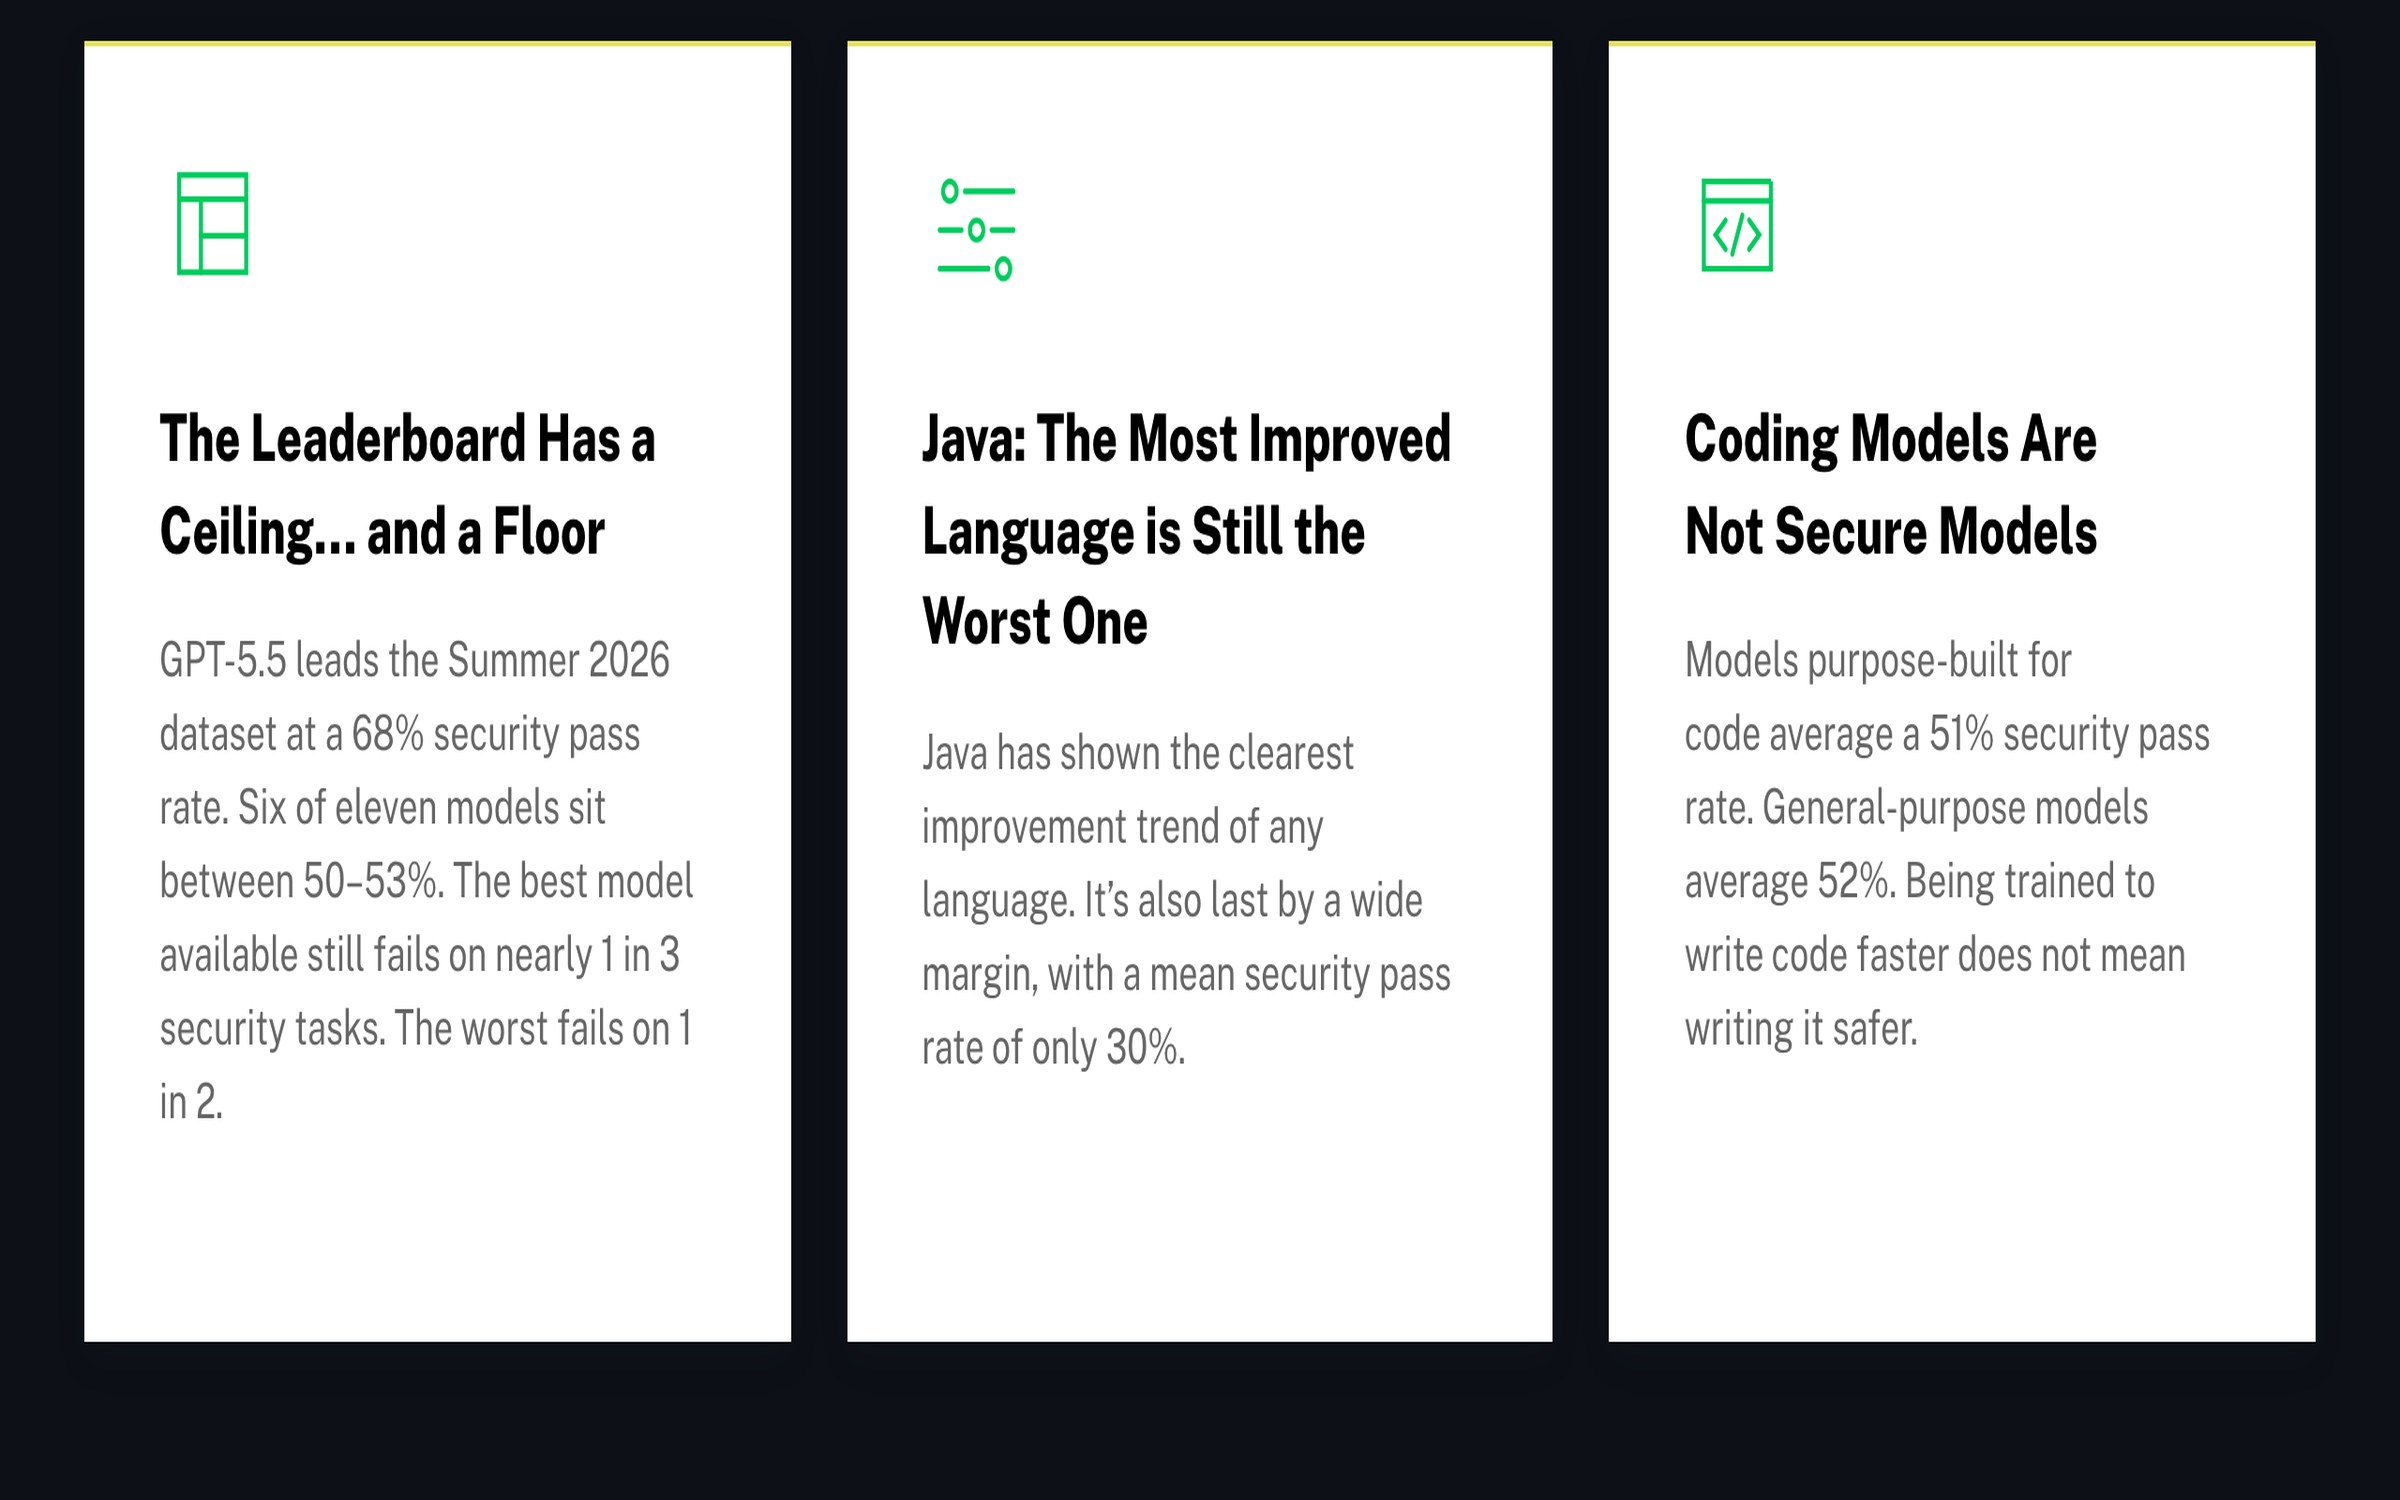
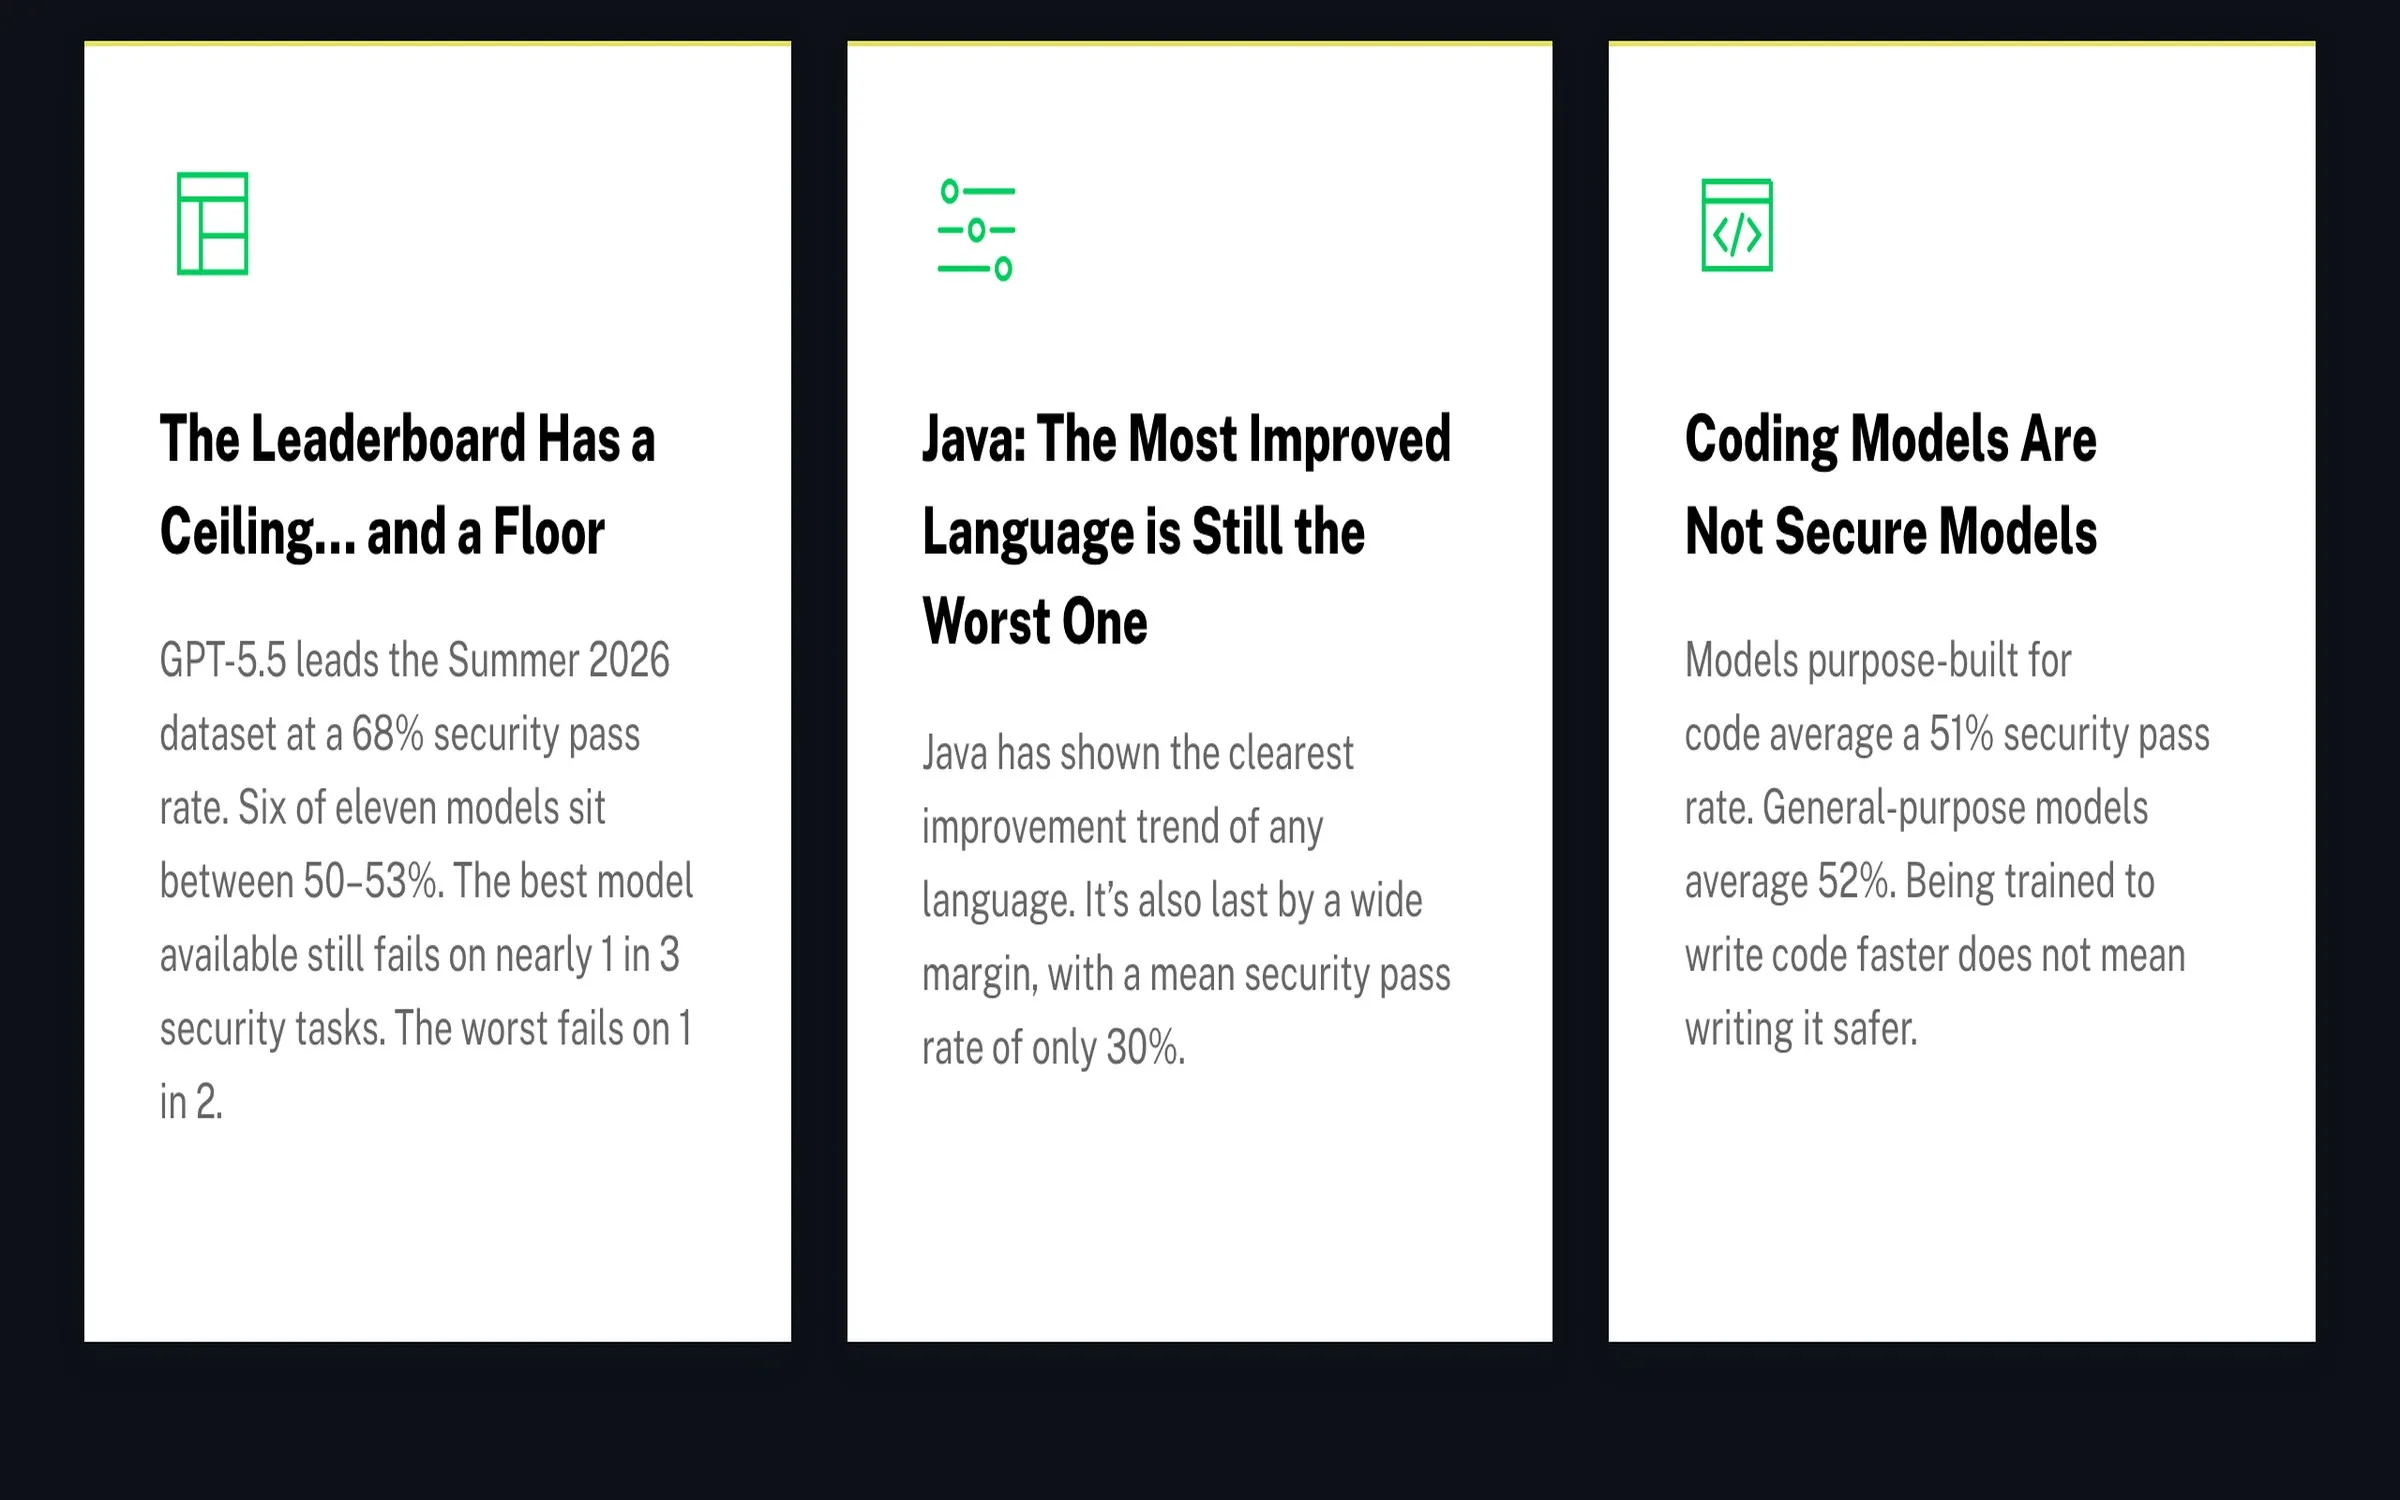
- почти половина кода без явного указания думать о безопасности несёт хотя бы одну известную уязвимость
- у кода от ИИ почти вдвое больше критичных дефектов, чем у кода человека, если не проверять его отдельно
- три статьи расхода из четырёх снижаются без смены инструмента: явная просьба проверить, разбивка на шаги, короткие разговоры
Порог входа
Дисциплину проверки один раз ставят, а не изобретают каждый раз заново
Считать переделки руками и держать в голове формулировку каждого запроса - рабочий способ, но на объёме он перестаёт масштабироваться
Заходят и те, кто до этого умел ровно одно - переписываться с нейросетью в браузере
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Значит ли это, что вайб-кодинг обходится слишком дорого?
Нет, значит, что реальная цена задачи часто выше заявленной цены подписки, если считать переделки. Три из четырёх статей расхода снижаются простыми привычками из этой статьи без единой дополнительной оплаты
Откуда взялась цифра про 44 цента на починку?
Из независимого исследования по 2444 реальным компаниям, которое разложило расход на ИИ-разработку по составляющим на каждый потраченный доллар токенов. Ссылка на первоисточник - в разделе «Источники» ниже
Правда ли, что почти половина кода от ИИ содержит уязвимости?
По данным официального отчёта одной из крупных компаний по безопасности кода, в среднем 44% кода, написанного без явного указания думать о безопасности, содержит минимум одну известную уязвимость. Отчёт проверял больше ста разных моделей
Может ли обычный человек без опыта в коде вообще на это повлиять?
Да. Три конкретных шага из этой статьи - фраза про проверку в запросе, разбивка задачи на маленькие части, слежка за длиной одного разговора - не требуют технического бэкграунда и делаются прямо внутри обычного окна чата с ассистентом
Почему новая модель обходится дороже при той же цене за токен?
Новый счётчик токенов считает одну и ту же фразу по-другому и получает большее число токенов, чем считал предыдущий счётчик - примерно на 30% больше для английского текста и кода. Цена за один токен не изменилась, но токенов на ту же задачу уходит больше