Гайд · Claude Code · сентябрь 2026
Claude Code перечитывает проект: 3 причины и карта на 4 строки
Просишь Claude Code поправить одну строку, а он открывает половину проекта заново - и лимит сессии сгорает быстрее, чем должен. Разбираю 3 технические причины этого поведения по официальной документации Anthropic и своему собственному прогону: одинаковый тестовый проект я прогнал 4 раза с разными настройками и посчитал разницу в ходах и деньгах
Я лично прогнал свой тестовый проект из 36 файлов через Claude Code 5 сентября 2026 года четыре раза подряд: без карты проекта и с картой, с широкой формулировкой задачи и с узкой. Разница видна в терминал-выводах, которые лежат рядом со статьёй без сокращений
Положи в корень проекта файл CLAUDE.md с короткой картой папок (что где лежит и что не читать без явной просьбы), формулируй задачи узко - называй конкретный файл и строку, а не «разберись в проекте». Оба приёма проверены моим собственным прогоном: без карты и с широкой формулировкой Claude Code уходит в 6-7 ходов и читает вдвое больше токенов, чем с картой и узкой задачей
Что вообще значит «перечитывает проект»
Когда ты работаешь с Claude Code, каждый файл, который он открывает командой чтения, добавляется в контекстное окно - это как рабочий стол, на котором лежат открытые страницы. Стол не бесконечный: у Sonnet 5 он держит 1 миллион токенов (единица подсчёта текста, примерно ¾ слова каждая) разом, но заполняется быстро, если агент открывает файлы, которые задаче не нужны. Если хочется понять эту единицу измерения на живом примере с документами, а не только с кодом - смотри разбор Claude и PDF: как скормить документы без лишних токенов
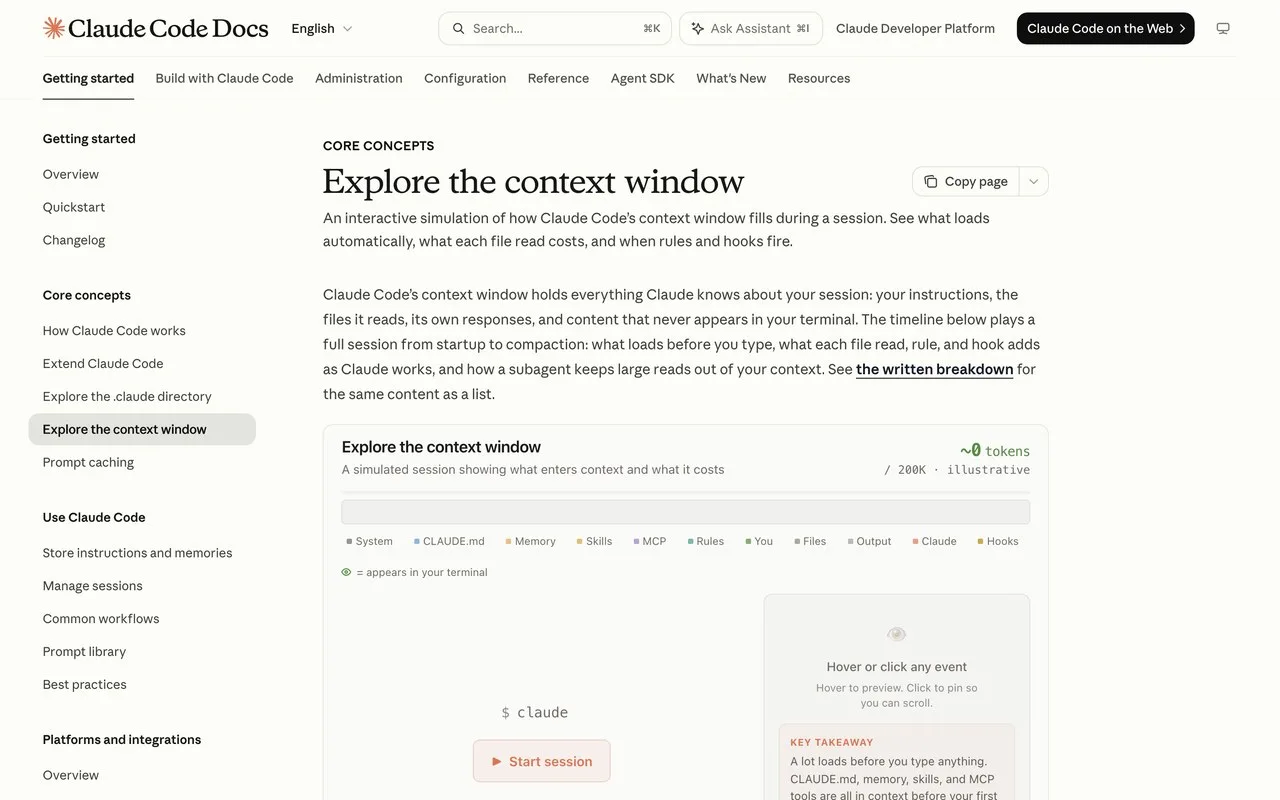
«Перечитывает проект» на практике выглядит так: ты просишь что-то мелкое, а в окне с командами одна за другой мелькают строки «Read» с именами файлов, которые вообще не связаны с твоей задачей. Официальная документация Anthropic называет три технических источника этого поведения, и все три можно проверить своими руками - разбираю их по порядку. Если проект уже разросся настолько, что в нём несколько связанных частей и запутаться легко даже с картой - смотри отдельный разбор большой проект в Claude Code: схема из 4 звеньев без хаоса
Что уже загружается в контекст ещё до твоего первого сообщения
Прежде чем разбирать причины перечитывания, полезно увидеть общую картину: часть контекстного окна занята ещё до того, как ты вообще написал первую просьбу. По тому же официальному симулятору, в самом начале сессии в контекст автоматически попадают системные инструкции помощника, файл памяти о прошлых сессиях, список доступных навыков-скиллов и сам файл CLAUDE.md (и глобальный из твоей домашней папки, и файл конкретного проекта)
Это не потерянные впустую токены - без них Claude Code не будет знать твои личные правила и не сможет пользоваться навыками. Но именно поэтому размер и точность самого CLAUDE.md имеют значение: чем он длиннее и расплывчатее, тем больше места он занимает ещё до старта работы, и тем меньше остаётся для настоящей задачи
Причина 1: у проекта нет карты в файле CLAUDE.md
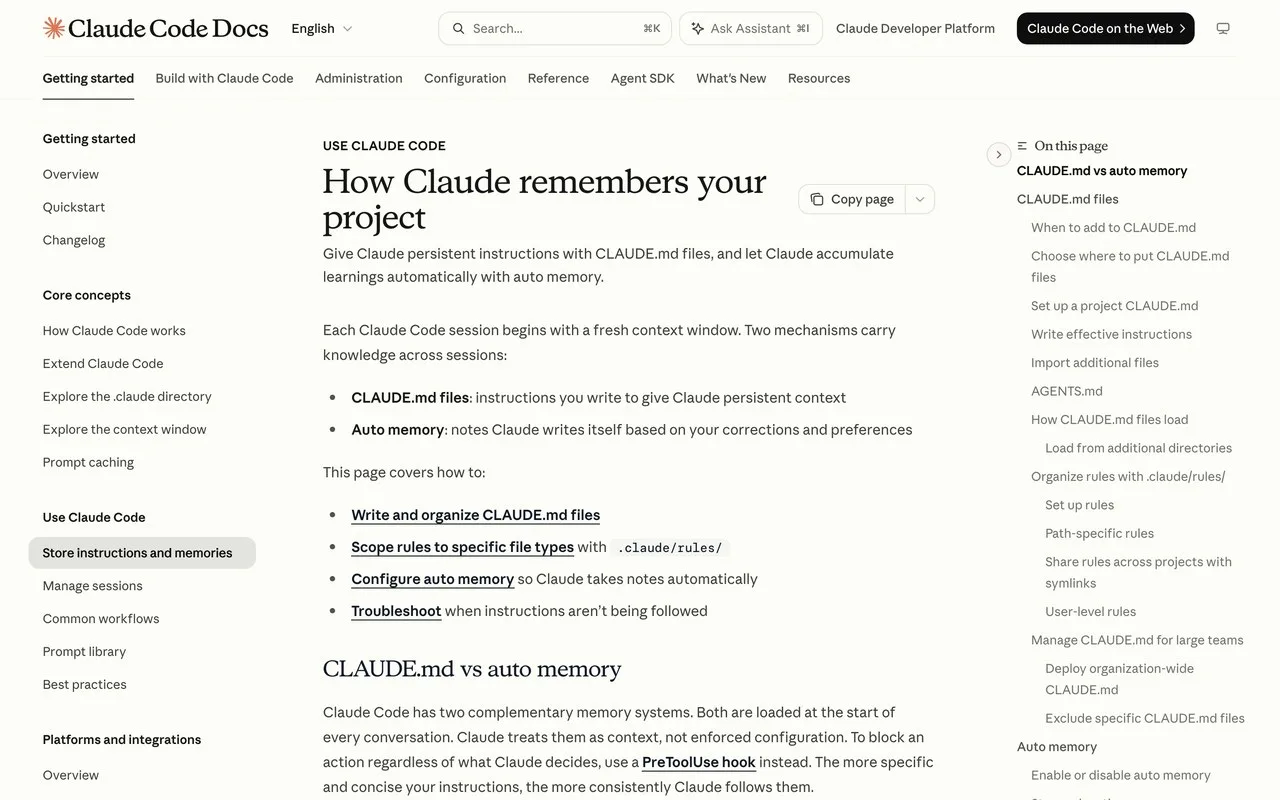
Claude Code не умеет заглянуть в папку и сразу понять, что в ней важно, а что можно пропустить. Без подсказки он действует так же, как ты бы действовал в чужом незнакомом проекте: открывает файлы один за другим, чтобы разобраться. Файл CLAUDE.md в корне проекта - это записка, которую Claude Code читает в начале КАЖДОЙ сессии, и в ней можно прямо написать, какие папки не трогать без явной просьбы
Важная оговорка сразу: CLAUDE.md - это просьба, а не жёсткий запрет. Модель старается следовать написанному, но гарантии стопроцентного соблюдения нет - для по-настоящему железного запрета есть отдельный механизм под названием хуки, разобранный в короткой справке хуки (hooks) в Claude Code. Готовый набор из 4 коротких правил для самого файла CLAUDE.md, которым сейчас пользуются сотни тысяч разработчиков - в разборе CLAUDE.md Karpathy: 210K звёзд и 4 правила простыми словами
Я проверил это своим прогоном. Собрал синтетический тестовый проект (36 файлов, около 864 килобайт: рабочий файл index.js плюс две папки-заглушки с бессмысленным содержимым для симуляции объёма) и прогнал в нём одну и ту же команду claude -p "разберись в проекте" дважды - в одной копии проекта CLAUDE.md не было, в другой лежал файл с 4 строками карты
| Без CLAUDE.md-карты | С CLAUDE.md-картой | |
|---|---|---|
| Ходов агента | 6 | 3 |
| Прочитано текста (в токенах) | 161 365 | 108 752 |
| Стоимость запроса | 0,81 доллара | 0,55 доллара |
| Что ответил агент | «Я проверил все 35 файлов» | «По карте проекта это служебные заглушки, их я по инструкции не открывал» |
Таблица прокручивается вбок →
Разница на абсолютно одинаковом содержимом: в 2 раза меньше ходов, почти в 1,5 раза меньше прочитанного текста, стоимость ниже почти на треть. Карта проекта не ускоряет саму модель - она просто избавляет её от необходимости выяснять то, что ты и так знаешь заранее
Полный вывод прогонов на том же тестовом проекте из 36 файлов лежит рядом со статьёй в формате JSON без сокращений, с точными числами ходов, токенов и стоимости - я не пересказываю чужие цифры, а прикладываю свои
Причина 1 на практике: карта в CLAUDE.md
- Что напечатать создай файл CLAUDE.md в самом корне проекта (там же, где ты открываешь Claude Code) и коротким списком опиши папки: что в них лежит и что не читать без явного запроса
- Что увидишь на экране в начале следующей сессии Claude Code не покажет содержимое файла явно, но в ответах начнёт ссылаться на него: «по карте проекта это...», и не будет открывать папки, помеченные как второстепенные
- Что это тебе даёт меньше ходов на простую задачу и меньше сожжённых денег на запрос - в моём прогоне разница составила треть стоимости одного запроса на одинаковой задаче
Как разложить структуру проекта и файл CLAUDE.md с нуля, если у тебя её ещё нет - подробный разбор в отдельном гайде структура проекта для Claude Code: папки и файл CLAUDE.md. Здесь речь только про то, как отсутствие карты технически приводит к перечитыванию, сама структура там
Причина 2: широкая формулировка задачи вместо узкой
Вторая причина не про файл настроек, а про то, как ты формулируешь просьбу. «Почини баг» и «в файле index.js замени строку hello на нужную» - это две принципиально разные задачи для агента с точки зрения того, сколько ему придётся читать, чтобы понять, что вообще имеется в виду
Я проверил и это своим прогоном, на том же тестовом проекте, свежими копиями без предыдущей истории
| Широкая: «почини баг с приветствием» | Узкая: «в index.js замени строку hello» | |
|---|---|---|
| Ходов агента | 7 | 4 |
| Прочитано текста (в токенах) | 241 134 | 150 982 |
| Стоимость запроса | 0,82 доллара | 0,58 доллара |
Таблица прокручивается вбок →
Разница: широкая формулировка без названного файла заставила агента искать «баг» по всему дереву папок проекта - 7 ходов и 241 134 токена чтения. Узкая формулировка с прямым указанием файла и конкретной строки закрыла ту же по сути задачу за 4 хода при 150 982 токенах - на 37% меньше чтения на живых цифрах
Обе команды прогонялись на свежих копиях тестового проекта из 36 файлов без общей истории разговора, чтобы разница была честной, а не следствием того, что модель что-то запомнила из прошлого прогона
Что делать с этим дальше, разобрано в статье почему ими не пользуются и 7 задач, где экономят часы
Причина 2 на практике: узкая формулировка
- Что напечатать вместо «почини баг» или «сделай форму красивее» назови конкретный файл, функцию или даже строку: «в файле контактной формы поправь текст ошибки под полем email»
- Что увидишь на экране агент сразу открывает названный файл, а не начинает поиск по всем файлам проекта подряд, перебирая папку за папкой в поисках нужного места
- Что это тебе даёт меньше ходов и меньше прочитанного текста на ту же по сути задачу - в моём прогоне разница составила больше трети стоимости запроса
Узость формулировки не значит, что нужно знать код досконально. Достаточно указать ориентир - имя файла, название функции, кусок текста на экране, который нужно поменять. Если у тебя большая задача, которую сложно свести к одному файлу, лучше явно попросить Claude Code сначала предложить план, а не сразу бросаться переписывать код - про это отдельный разбор в гайде флаги Claude Code: 6 команд запуска, которые экономят часы, где разобран режим планирования запуска. Первые шаги после установки, если ты только начинаешь работать в Claude Code вообще - в гайде что делать после установки Claude Code: первые шаги
Причина 3: компакция стирает историю, а перезагружает не всё подряд
Третья причина - механизм, который срабатывает автоматически и без твоего участия: когда разговор становится слишком длинным, Claude Code сжимает его в краткий пересказ командой /compact (сам или по твоей команде). Проблема в том, что этот пересказ не хранит содержимое файлов, которые уже читались - оно заменяется коротким описанием
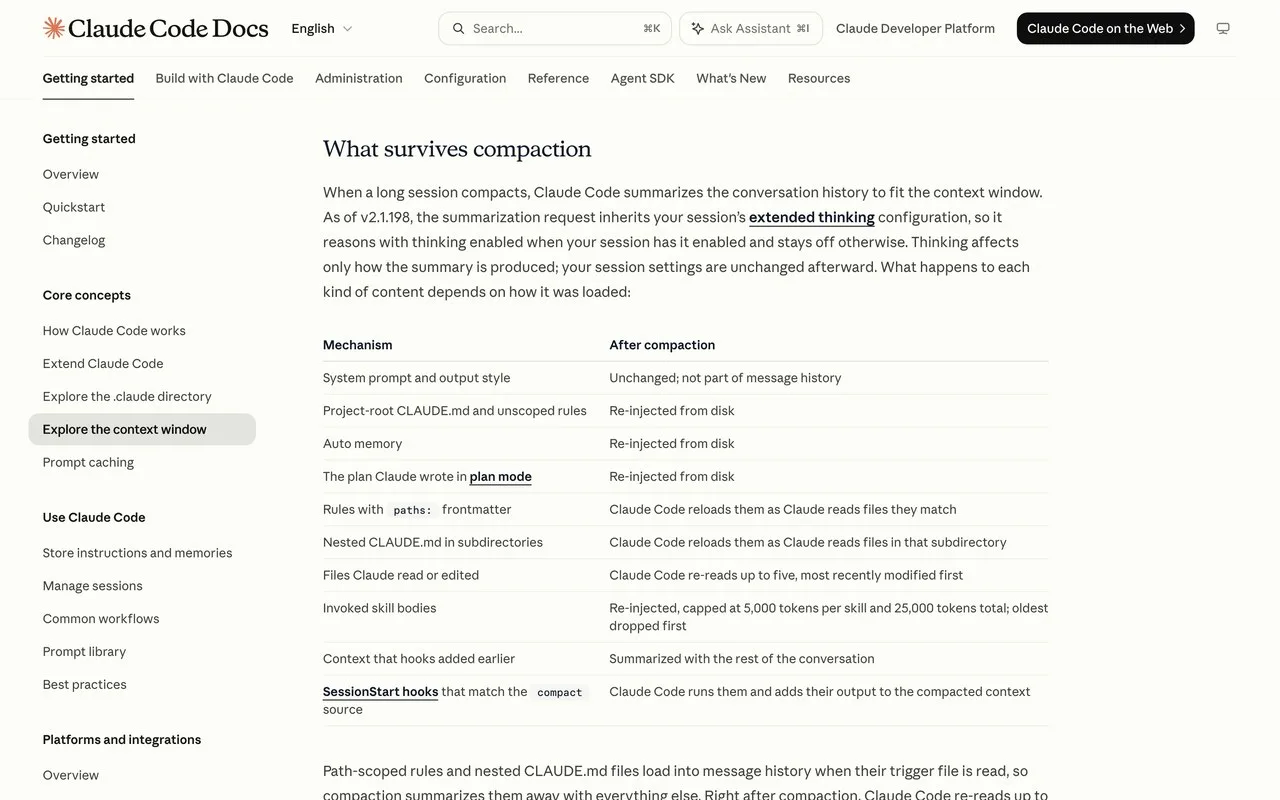
По официальной документации Anthropic, сразу после сжатия Claude Code «re-reads up to five of the files Claude has read or edited in the session, choosing the ones modified most recently» - перечитывает заново до пяти файлов, выбирая те, что менялись позже всех остальных. Файл, который был открыт до сжатия и в это число не попал, приходит обратно как ссылка на путь без содержимого - документация называет это «Referenced file instead of Read». Если тебе снова понадобится его содержимое, Claude Code честно откроет его повторно - и это тоже читается со стороны как «перечитывает проект», хотя на самом деле это не баг, а прямое следствие того, как устроена сама компакция
Второй важный факт из той же документации: правила, которые подгружаются вместе с файлами определённых папок (path-scoped rules) и вложенные CLAUDE.md в подпапках, «reload as Claude reads files they apply to» - перезагружаются заново по мере того, как Claude читает файлы соответствующих папок, а не сразу все разом при старте. Если инструкция обязательно нужна каждую сессию, документация советует прямо: «drop the paths: frontmatter or move it to the project-root CLAUDE.md» - убрать привязку к конкретным путям и перенести правило в корневой CLAUDE.md, который перезагружается всегда. Если ты работаешь с телефона и хочешь видеть, что происходит с контекстом сессии на ходу - смотри Claude Code с телефона: включаем Remote Control за 3 шага
Причина 3 на практике: /compact с фокусом
- Что напечатать прямо в поле ввода открытого окна: /compact и следом уточнение того, что важно сохранить, например /compact сохрани план миграции и список изменённых файлов
- Что увидишь на экране подтверждение, что разговор сжат в краткое содержание, а следом - одна строка «Read» на каждый из перезагруженных файлов (их не больше пяти, самые свежие идут первыми)
- Что это тебе даёт ты сам решаешь, что войдёт в краткий пересказ, вместо того чтобы полагаться на то, что автоматическое сжатие угадает правильно
Если после сжатия разговора Claude Code вдруг «забыл» какое-то правило, которое ты называл раньше только словами в переписке, а не файлом - это ожидаемо: правило из обычного диалога компакция не хранит, оно живёт только в кратком пересказе. Постоянные требования переносятся в CLAUDE.md заранее, до того как понадобятся снова. Похожий механизм отката к более раннему состоянию разговора и кода - не то же самое, что сжатие, но живёт в том же меню - подробно разобран в гайде как откатить изменения Claude Code: /rewind, git и 5 путей
Три причины рядом: что решает каждая
Три разобранные причины действуют независимо друг от друга и лечатся разными приёмами - удобно свести их в одну таблицу, чтобы понять, с какой начать в твоём конкретном случае
| Причина | Когда срабатывает | Что чинит |
|---|---|---|
| Нет карты в CLAUDE.md | В начале и на протяжении всей сессии | Файл CLAUDE.md с короткой картой папок |
| Широкая формулировка | На каждый твой отдельный запрос | Называть конкретный файл или строку в самой просьбе |
| Компакция | Только после сжатия длинного разговора | Постоянные правила держать в корневом CLAUDE.md, а важное сохранять фокусом /compact |
Таблица прокручивается вбок →
Если у тебя проблема на каждом новом запросе с самого начала сессии - вероятнее всего дело в карте. Если проблема появляется только в очень длинных разговорах ближе к вечеру работы - вероятнее всего дело в компакции
Перечитывание, которое не является проблемой
Не любое повторное чтение файла - это брак. Если ты действительно правишь один и тот же файл несколько раз подряд в рамках одной задачи, Claude Code читает его снова каждый раз перед новой правкой, чтобы не затереть чужие изменения поверх устаревшей версии - это нормальная страховка, а не лишний расход
Разница простая: если файл читается заново ПОСЛЕ того, как он менялся (твоей рукой или самим агентом) - это ожидаемо. Если файл читается заново БЕЗ единой правки между двумя чтениями, и задача при этом не менялась - вот тогда стоит смотреть на три причины выше
Есть ли файл .claudeignore, чтобы просто закрыть папку от чтения
По наряду этой статьи я отдельно проверил вопрос про .claudeignore - файл по аналогии с .gitignore, который в теории должен был бы закрывать папки от Claude Code вообще. Проверка была буквальной: я скачал markdown-версии шести официальных страниц документации (про контекстное окно, настройки, права доступа, структуру .claude-директории и хранение памяти) и построчно проверил их на слово «claudeignore»
Результат отрицательный: ни в одном из шести документов слово не встречается ни разу. Отдельного файла .claudeignore в Claude Code на сентябрь 2026 нет - это распространённое заблуждение по аналогии с похожими файлами других инструментов, а не реальный встроенный механизм
Рабочая замена - обычный файл .gitignore, который у тебя, скорее всего, уже есть в проекте (он говорит системе версий Git, какие файлы не сохранять в историю изменений). Claude Code по умолчанию уважает этот же список: файлы, перечисленные в нём, автоматически выпадают из подсказок и обычного поиска файлов. Для более точечного запрета на чтение конкретной папки, даже если она не в этом списке, есть отдельные правила прав доступа с похожими правилами написания путей - подробно они устроены сложнее одной строки в статье и заслуживают отдельного разбора, здесь важен сам факт: специального файла-игнора нет, работает то, что у тебя, скорее всего, уже есть
Продолжение темы у меня разобрано отдельно: Как оплатить Qwen Code из России в 2026
Частая ошибка: слишком длинная и расплывчатая карта вместо короткой
Написать CLAUDE.md мало - легко перестараться в другую сторону и превратить его в длинное описание всего проекта подряд, что тоже вредит, только по-другому: по официальной документации, файлы длиннее 200 строк занимают больше места в контексте и хуже соблюдаются моделью. Разница не в объёме папок, которые ты описал, а в том, насколько чётко названо, что можно пропустить
Рабочий приём - писать карту так же коротко, как в моём тестовом прогоне: три-четыре строки, каждая называет папку и одно правило про неё, без пересказа того, что и так видно из названия файлов. Если правил становится действительно много и они относятся к разным частям большого проекта - лучше не раздувать единый CLAUDE.md, а разнести их по отдельным файлам правил, которые подключаются только когда Claude работает с соответствующей папкой. Устройство такой раскладки на конкретных папках разобрано в гайде структура проекта для Claude Code: папки и файл CLAUDE.md
Что делать, если карта и узкая формулировка уже есть, а перечитывания всё равно много
Иногда причина не в тебе, а в масштабе самой задачи: если файл, который агенту приходится держать в контексте, весит больше 5000 токенов, после сжатия разговора он всё равно вернётся как ссылка на путь без содержимого, и Claude Code откроет его заново при первом же обращении - это документированное поведение, а не сбой
Здесь помогают два приёма из документации: разбивать длинную сессию на более короткие через /clear, когда переключаешься на несвязанную задачу (старый разговор без того будет занимать место, которое тебе больше не нужно), и отправлять тяжёлые исследовательские задачи отдельному помощнику, у которого своё собственное контекстное окно - в твой основной разговор возвращается только итоговый вывод, а не содержимое всех прочитанных им файлов. Как устроен такой помощник и когда его звать вместо обычной просьбы - в отдельном гайде агенты для Claude Code: полный разбор для новичка. Если тебе не хватает встроенных приёмов и хочется дополнительного стороннего инструмента для сжатия счёта - есть отдельный разбор внешнего инструмента в гайде Headroom GitHub: сжатие токенов Claude Code, счёт ниже на 95%
Как проверить, что причина действительно устранена
После правки карты проекта или формулировки задачи проверка простая: набери команду /context прямо в поле ввода открытого окна Claude Code - она покажет живую разбивку контекста по категориям с указанием того, какие файлы CLAUDE.md и памяти подгрузились на самом деле. Если после узкой формулировки в списке всё ещё мелькают файлы папок, которые ты пометил как второстепенные в карте - проверь, что CLAUDE.md действительно лежит в корне того каталога, откуда запускается Claude Code, а не на уровень выше или ниже. Если ты вообще не уверен, что запускаешь Claude Code из правильного места - смотри общий разбор с нуля как пользоваться Claude Code: установка и 9 шагов до проекта
Что дальше, если хочется разобраться в структуре проекта глубже
Эта статья разбирает ПОЧЕМУ Claude Code перечитывает файлы и три конкретных технических рычага, чтобы это остановить. Как именно раскладывать папки проекта с нуля и что писать в самом CLAUDE.md по содержанию, а не только про перечитывание - в отдельном подробном гайде структура проекта для Claude Code: папки и файл CLAUDE.md. Если проект достаточно большой, чтобы в нём появлялись дополнительные навыки-помощники под конкретные задачи - смотри скиллы для Claude: что это, как установить и 7 готовых под контент и как сделать свой Skill в Claude за 5 шагов: живой прогон 2026
Куда идти дальше на этом же сайте
- Настройка Claude Code бесплатно: запуск с нуля и выбор модели по ОЗУ - если Claude Code у тебя ещё не установлен
- Ultracode в Claude Code: 2 способа включить режим workflow - заранее заданный порядок действий вместо разовой узкой просьбы
- Claude Code Windows: одна команда установки, разбор 7 ошибок - если работаешь не с Mac
- Claude MCP: как подключить свой первый сервис за 10 минут - подключение к внешним сервисам добавляет ещё один источник контекста, о котором стоит знать
- Безопасность автономных ИИ-агентов: 4 риска 2026 года - если делегируешь агенту не только чтение файлов, но и более широкие действия
Источники
Ниже страницы, которые я открывал сам при подготовке этой статьи 5 сентября 2026 года:
- Anthropic, документация Claude Code, интерактивный симулятор контекстного окна - механизм перечитывания до пяти файлов после компакции, ссылки Referenced file, что переживает сжатие - code.claude.com/docs/en/context-window, голый адрес https://code.claude.com/docs/en/context-window
- Anthropic, документация Claude Code, раздел про хранение памяти проекта - вложенные файлы CLAUDE.md по подпапкам, path-scoped rules, порядок загрузки по дереву каталогов - code.claude.com/docs/en/memory, голый адрес https://code.claude.com/docs/en/memory
- Anthropic, документация Claude Code, справочник встроенных команд - точное описание /compact с фокусом - code.claude.com/docs/en/commands, голый адрес https://code.claude.com/docs/en/commands
- Anthropic, документация Claude Code, права доступа и паттерны gitignore-синтаксиса для правил чтения - code.claude.com/docs/en/permissions, голый адрес https://code.claude.com/docs/en/permissions
- Anthropic, документация Claude Code, полный справочник настроек - проверка отсутствия ключа claudeignore, настройка respectGitignore - code.claude.com/docs/en/settings-reference, голый адрес https://code.claude.com/docs/en/settings-reference
Памятка: 3 причины перечитывания и 3 починки
Три строки, по которым проходит проверка
Сохрани себе
- Нет карты проекта - создай CLAUDE.md в корне с коротким списком папок и что в них не трогать без запроса
- Широкая формулировка задачи - называй конкретный файл, функцию или строку вместо общего описания проблемы
- Компакция перезагружает только 5 последних файлов - постоянные правила держи в корневом CLAUDE.md, а не в path-scoped rules
- Отдельного файла .claudeignore нет (проверено по 6 официальным документам) - работает .gitignore через respectGitignore
- После правки проверяй результат командой /context - она покажет, какие файлы памяти подгрузились на самом деле
Порог входа
Три причины перечитывания ты теперь видишь, структуру проекта - ещё нет
Дальше вопрос упирается не в контекст одной сессии, а в то, как вообще организован твой проект целиком - с чего начинать новый, куда класть файлы, когда их становится больше десятка
За три дня на Лагере из твоего собственного проекта собирается рабочая структура, при которой новые задачи не превращаются в разбор того, что где лежит
Это заявка в мой закрытый канал, не оплата. Впускаю сразу, дальше бот в личке отдаёт путёвку на три дня
Частые вопросы
Почему Claude Code перечитывает один и тот же файл несколько раз за сессию
Чаще всего это следствие компакции: после сжатия длинного разговора Claude Code перечитывает до пяти самых недавно изменённых файлов автоматически, а остальные, если они снова понадобятся, открывает заново по факту обращения, а не заранее. Это документированное поведение, не сбой
Помогает ли просто более короткий CLAUDE.md
Да, но не сам по себе размер, а точность формулировок в нём. Документация Anthropic советует держать файл короче 200 строк: более длинные файлы занимают больше места в контексте и хуже соблюдаются моделью. Короткая карта с чёткими «что не трогать» работает надёжнее длинного описания всего проекта подряд
Что если задача действительно требует прочитать много файлов
Тогда перечитывание оправдано и не является проблемой - вопрос в том, читает ли агент лишнее сверх задачи. Для по-настоящему объёмных исследовательских задач в документации рекомендован отдельный приём: отправить чтение файлов в субагента с собственным контекстным окном, а в основной разговор вернётся только итоговый вывод
Правда ли, что .claudeignore существует в других похожих инструментах
В некоторых других инструментах кодогенерации подобный механизм действительно есть, и путаница возникает именно из переноса ожиданий с них. В Claude Code на сентябрь 2026 года такого отдельного файла нет - проверено прямым поиском по официальной документации, ноль совпадений по шести документам
Как узнать, сколько токенов прямо сейчас занимает мой открытый проект
Команда /context, введённая прямо в поле ввода открытого окна Claude Code, покажет живую разбивку по категориям: сколько токенов заняли CLAUDE.md, память, прочитанные файлы и остальное - это самый быстрый способ увидеть, что именно раздувает контекст в конкретной твоей сессии