Безопасность ИИ-агентов · карта рисков 2026
Безопасность автономных ИИ-агентов: 4 риска 2026 года
Открой список прав своего ИИ-агента и спроси себя: если его обманет чужой текст, что самое плохое он успеет сделать этими правами за одну сессию? В ноябре 2025 года государственная группа именно так заставила чужого агента выполнить 80-90% целой кибератаки на 30 организаций - один из 4 классов риска, которые сами разработчики называют главными в 2026 году
К концу статьи будет ясно: какие четыре класса риска называют главными сама компания-разработчик Anthropic и международное сообщество по безопасности OWASP в 2026 году, что уже случалось на практике с реальными числами и датами, и что из этого можно сделать себе уже сегодня - без единой строчки кода. Если у тебя уже стоит Claude Code и ты хочешь готовую пошаговую настройку git-страховки, permission-режимов и sandbox именно под этот инструмент - у меня есть отдельный подробный разбор безопасность ИИ-агентов: чтобы Claude не удалил твой проект, он про практическую настройку одного конкретного инструмента. Здесь - карта того, какие вообще бывают классы риска у любого автономного агента, откуда они берутся и как их видят сами разработчики, а не только пользователи
Пройдись по списку инструментов и доступов, подключённых к твоему агенту, и напротив каждого запиши одно слово - действительно нужен или дали с запасом. Дальше проверь три вещи: есть ли у необратимых действий (отправка, удаление, платёж) ручное подтверждение, отделено ли тестовое окружение от боевого, и не читает ли агент чужие файлы и письма без разбора - эти три проверки закрывают большую часть рисков из статьи за 10 минут
Чего на самом деле боятся разработчики агентов
Anthropic - компания, которая делает Claude - опубликовала разбор того, как сама защищает своих агентов, и разложила источник риска не на «ИИ опасен», а на три конкретные категории
| Источник риска | Что происходит |
|---|---|
| Сам пользователь | Просит агента сделать что-то вредное - по злому умыслу или по неосторожности |
| Сам агент | Делает опасное действие, о котором его вообще никто не просил, честно пытаясь «доделать до конца» задачу |
| Атака снаружи | Кого-то постороннего пускают через файл, сайт или чужой сервис - именно сюда попадает prompt injection |
Таблица прокручивается вбок →
Третья категория заслуживает отдельного внимания: это подмена команды чужим текстом, и именно ей посвящён следующий раздел
Три категории - это не абстракция для инженеров: они прямо переводятся в вопросы, которые можно задать себе про собственного агента. Могу ли я сам случайно попросить лишнее, не подумав? Может ли агент сам зайти дальше, чем нужно, честно выполняя мою задачу? И может ли кто-то посторонний через файл или ссылку подсунуть агенту свою команду вместо моей? Дальше в статье - каждый из этих вопросов с живым примером
Prompt injection - когда чужой текст читается как твоя команда
Агент не различает два разных источника текста, которые физически выглядят одинаково: инструкцию, которую написал ты сам, и предложение, спрятанное в письме, документе или на странице сайта, которую агент открыл по пути к твоей же задаче. Для языковой модели любой текст в контексте - это просто текст, и она может принять чужую фразу за команду
Исследователь безопасности Саймон Уиллисон описывает условие, при котором это становится по-настоящему опасно, как сочетание трёх вещей сразу: «Access to your private data. Exposure to untrusted content. The ability to externally communicate in a way that could be used to steal your data» - доступ к твоим приватным данным, встреча с недоверенным чужим текстом и способность что-то отправить наружу (Simon Willison, «The lethal trifecta for AI agents», июнь 2025). Если у агента есть все три способности одновременно - атакующему достаточно один раз подсунуть нужный текст туда, куда агент точно заглянет
По словам того же автора, атаки этого типа за последние месяцы уже находили в живых системах, которыми пользуются миллионы людей: в Microsoft 365 Copilot, в официальном MCP-сервере GitHub и в чат-боте GitLab Duo. Логика везде одна и та же: чужой текст лежит там, где агент его прочитает по долгу службы (письмо, issue, комментарий в коде), а дальше агент выполняет спрятанную в нём инструкцию как свою
Живой кейс: как чужой пакет стал каналом утечки
В сентябре 2025 года специалисты по безопасности нашли на площадке npm - публичном каталоге программных надстроек - первый живой случай вредоносного MCP-сервера в реальной работе. Пакет назывался postmark-mcp и был почти точной копией легального инструмента для отправки писем, которым пользовались агенты в составе своих рабочих цепочек
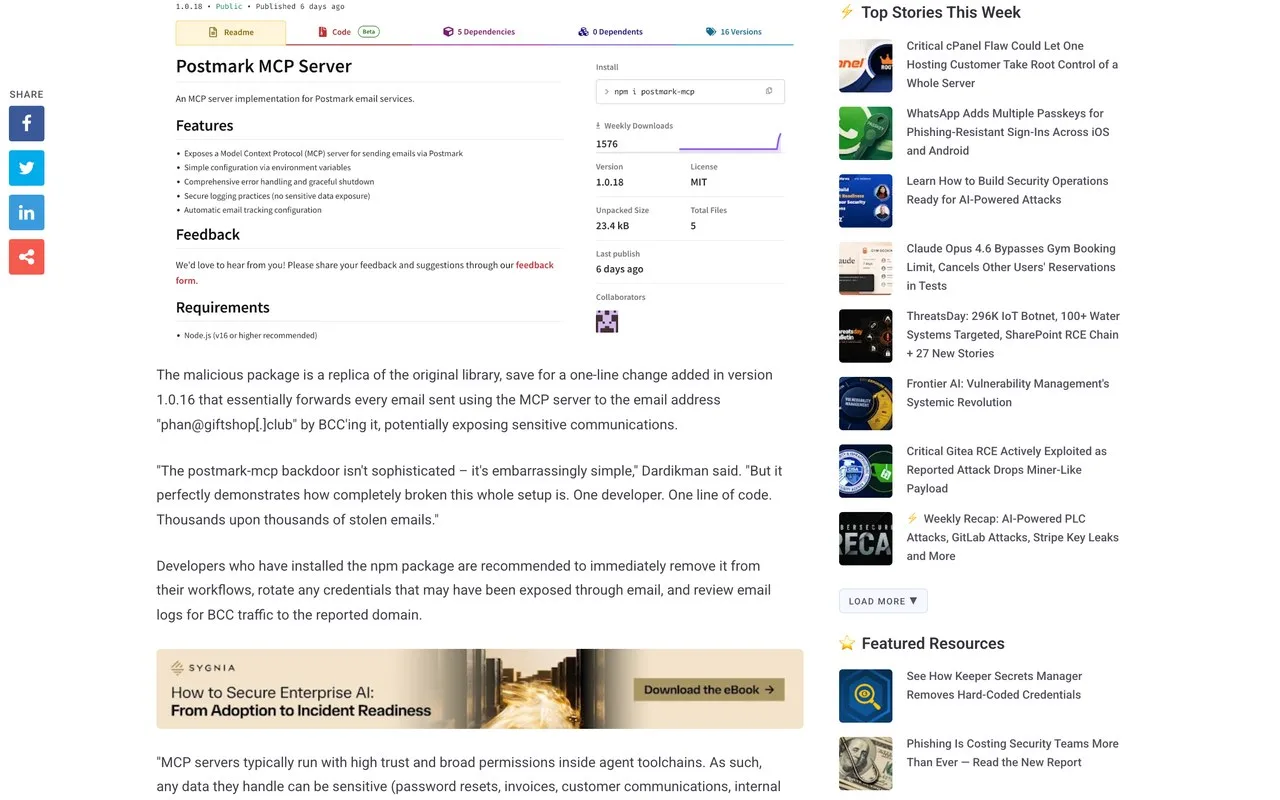
Пятнадцать версий пакета работали абсолютно честно и накопили доверие пользователей - его успели скачать больше полутора тысяч раз. В шестнадцатой версии автор добавил ровно одну строку кода: она тайно копировала каждое письмо, отправленное через этот инструмент, на посторонний адрес. Специалист по безопасности Дардикман, чьи слова приводит издание, сформулировал это без прикрас: «The postmark-mcp backdoor isn't sophisticated - it's embarrassingly simple. One developer. One line of code. Thousands upon thousands of stolen emails» - бэкдор не был изощрённым, это до неловкости простой приём: один разработчик, одна строчка кода, тысячи и тысячи украденных писем
Урок этого случая не в том, что нужно бояться конкретно писем. Урок в том, что любой готовый инструмент, который ты подключаешь к своему агенту, - это чужой код с теми же правами, что и у самого агента, и репутация («пятнадцать чистых версий подряд») ничего не гарантирует про версию номер шестнадцать
Почему подключаемые инструменты - отдельная площадь риска
Агент редко работает совсем один. У него обычно есть набор подключённых инструментов - для отправки писем, работы с базой данных, поиска в интернете, чтения календаря - и каждый такой инструмент физически ставится кем-то посторонним, а не самим разработчиком твоего агента
Разница с обычной программой в том, что инструмент агента почти всегда получает доступ к тем же данным и правам, что и сам агент, а проверить его код целиком у обычного пользователя нет ни времени, ни квалификации. Случай postmark-mcp выше - частный пример общего правила: чем больше сторонних инструментов подключено, тем больше точек, где может незаметно появиться чужой код с доступом к твоим данным
Практический вывод для обычного пользователя простой: подключать инструменты по одному, с ясной целью под конкретную задачу, а не «на всякий случай про запас». Инструмент, который простаивает неиспользуемым, не приносит пользы, зато держит открытым канал риска ровно так же, как активно используемый
Избыточные права - когда агенту разрешили больше, чем нужно для задачи
Классический пример из практики специалистов по безопасности выглядит так: агент собирают, чтобы он читал письма клиентов и отвечал на вопросы, а инструмент, который ему для этого выдали, заодно умеет ещё и удалять письма. Или другой вариант - агенту для ответа на вопросы нужен только просмотр таблицы в базе данных, но учётная запись, под которой он работает, имеет право ещё и менять, и стирать в этой же таблице записи
Международное сообщество специалистов по безопасности OWASP в декабре 2025 года выпустило отдельный документ именно про риски автономных агентов и поставило избыточные права в первую тройку главных пунктов. Причина, по которой это происходит массово, простая и человеческая: выдать инструменту права «с запасом на будущее» проще и быстрее, чем каждый раз считать минимально нужный набор под конкретную задачу - а разница между «может прочитать» и «может ещё и удалить» на первый взгляд не выглядит критичной, пока агент не ошибётся или его не обманут
Проверить это у себя можно одним вопросом про каждый инструмент, которым пользуется твой агент: если бы этим правом воспользовались не так, как я задумывал, что самое разрушительное могло бы произойти? Если ответ страшнее, чем сама задача агента, - право явно избыточно. Границы прав часто закладываются ещё на этапе постановки задачи агенту - как формулировать её так, чтобы не оставлять простора для лишнего, разобрано в отдельном гайде как составить ТЗ через ИИ: 5 разделов и 7 вопросов исполнителю
Необратимые действия - когда откатить нельзя вообще
Часть ошибок агента можно исправить: переписать текст заново, перезапустить задачу. Но у части действий обратного хода физически не существует - сообщение уже улетело адресату, файл стёрт мимо привычной корзины, деньги списаны со счёта. Эта категория действий отдельная, потому что цена одной ошибки здесь не «потратить время заново», а «последствие, с которым придётся жить»
Разбор конкретных инцидентов с потерей файлов у Claude Code, разница между тем, что реально откатывают встроенные чекпойнты, а что нет, и пошаговая настройка git-страховки под этот конкретный инструмент - в отдельной статье безопасность ИИ-агентов: чтобы Claude не удалил твой проект. Здесь важен сам принцип: прежде чем дать агенту право на необратимое действие, проверь, есть ли у этого действия обратный ход, и если нет - сознательно реши, готов ли ты доверить это действие автоматике без своего подтверждения на каждом шаге
Три слоя защиты, которые сами разработчики строят вокруг агента
Anthropic описывает собственную защиту не одной мерой, а тремя слоями сразу, и понимание этой логики помогает решить, где искать защиту для своего агента, даже если это не Claude
Первый слой - среда, в которой агент работает: границы файловой системы, изолированные контейнеры, ограничение выхода в сеть. Это буквально стены, за которые агент не может выйти, даже если очень «захочет» или его обманут. Второй слой - сама модель: системные инструкции, встроенные классификаторы подозрительных действий, специальное обучение распознавать чужие команды внутри текста. Третий слой - контроль над внешним контентом: как агент работает с подключаемыми инструментами, сторонними надстройками и результатами поиска в интернете - именно здесь чаще всего и происходит prompt injection
Три слоя защиты вокруг агента - от внешнего к внутреннему
- Среда границы файловой системы, изолированный контейнер, ограничение выхода в сеть - агент физически не может выйти за эти рамки, даже если его обманут
- Сама модель системные инструкции, встроенные классификаторы подозрительных действий, обучение распознавать чужую команду внутри текста
- Внешний контент как агент обращается с подключаемыми инструментами, сторонними надстройками и результатами поиска - здесь чаще всего происходит prompt injection
Три слоя работают вместе не просто ради красоты: если модель однажды ошибётся и примет чужую команду за свою (слой два не сработал), правильно настроенная среда (слой один) и разумные ограничения на внешний контент (слой три) всё равно не дадут этой ошибке привести к катастрофе. Одного слоя защиты почти никогда не хватает - разработчики агентов рассчитывают именно на то, что остальные два подстрахуют, если один даст сбой
Государственная кибератака почти без участия человека
В ноябре 2025 года Anthropic опубликовала разбор случая, который сама компания назвала первым известным случаем масштабной кибератаки, выполненной практически без участия человека. Группа, которую компания связывает с государственной поддержкой, использовала агента Claude Code для атаки примерно на тридцать организаций по всему миру, и часть попыток оказалась успешной
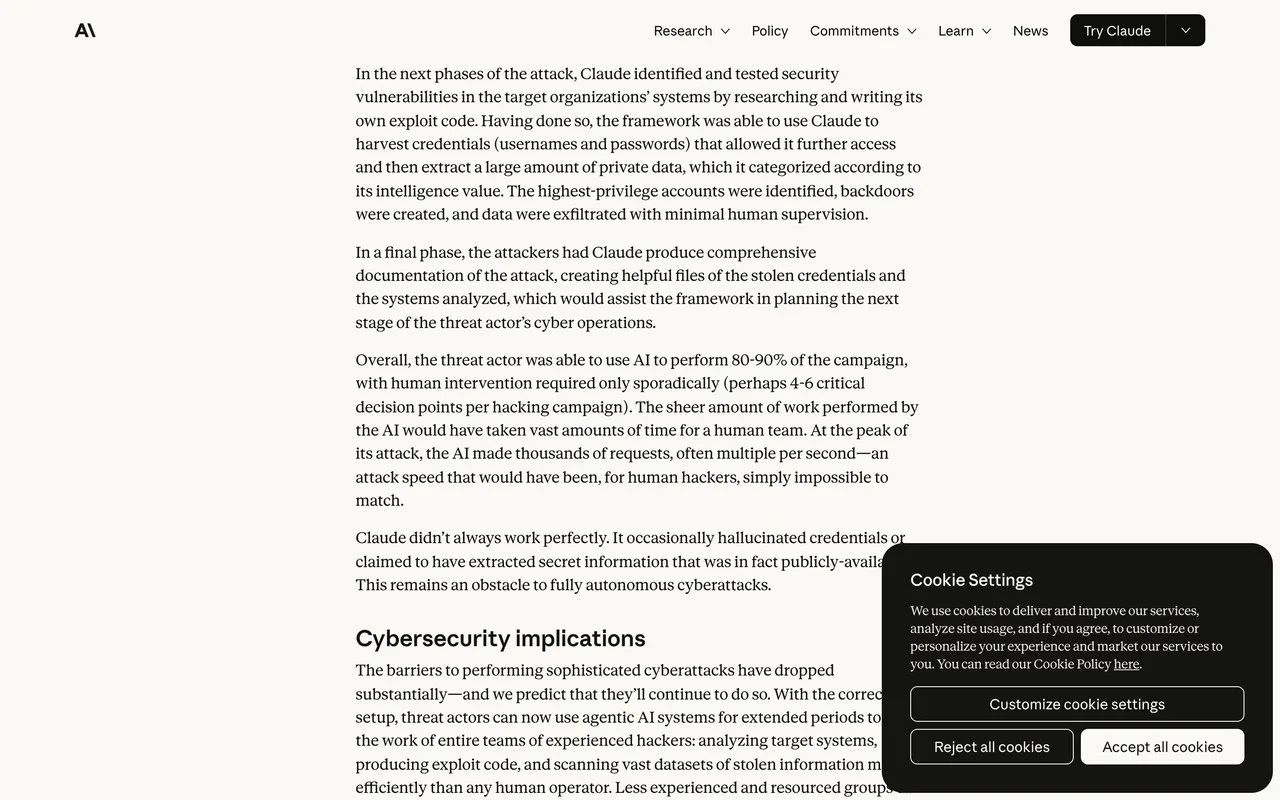
Технически интересна не сама атака, а то, как атакующие обошли встроенные ограничения модели: они не пытались напрямую попросить агента о чём-то запрещённом, а разбили весь план на маленькие, по отдельности безобидно выглядящие задачи, каждую из которых агент выполнял, не видя общей вредоносной цели целиком
По собственной оценке компании, автоматика взяла на себя от 80 до 90 процентов всей кампании, а живой человек включался лишь эпизодически - в нескольких критических точках принятия решения на всю операцию. На пике атаки агент делал тысячи запросов, иногда по несколько в секунду - скорость, недостижимая для команды живых людей ни при каких обстоятельствах. При этом сама модель работала не идеально: она периодически «придумывала» учётные данные, которых не было, или заявляла, что украла секретную информацию, которая на самом деле лежала в открытом доступе - это пока мешает атакам стать полностью автономными, но не отменяет масштаб того, что уже произошло
Карта всех рисков одним взглядом - OWASP Top 10 для агентов 2026
OWASP - международное сообщество специалистов по кибербезопасности, чьи списки рисков давно стали отраслевым стандартом для обычных сайтов и приложений, - в декабре 2025 года выпустило первую отдельную версию такого списка специально для автономных агентов, а не для чат-ботов
Список закрывает почти все примеры из этой статьи одной таблицей и даёт им общие имена, по которым эти риски принято искать в дальнейших материалах на эту тему:
| Риск | Простыми словами |
|---|---|
| Угон цели агента | Чужой текст подменяет задачу, которую агент на самом деле выполняет |
| Злоупотребление инструментом | Агент использует подключённый к нему инструмент не по назначению или во вред |
| Захват личности и прав агента | У агента оказывается больше прав или доступа, чем нужно для его задачи |
| Компрометация цепочки поставки | Вредоносный код проникает через сторонний пакет или сервис, как в случае с postmark-mcp |
| Неожиданное выполнение кода | Агент запускает код, который никто не планировал запускать |
| Отравление памяти агента | В долговременную память или контекст агента попадают ложные данные |
| Небезопасный обмен между агентами | Один агент передаёт вредную инструкцию другому агенту в команде |
| Каскадные сбои | Ошибка одного агента в цепочке ломает работу всех, кто зависит от его результата |
Таблица прокручивается вбок →
Полный документ и авторская методология - на официальном сайте проекта, ссылка в разделе источников этой статьи. Для обычного пользователя, который не строит агентные системы сам, а просто ими пользуется, из десяти пунктов действительно важны первые четыре-пять - именно они чаще всего всплывают в живых историях с обычными людьми, а не только в отчётах служб безопасности крупных компаний
Как это соотносится с уже знакомой темой обмана метрики
Есть ещё одно явление, которое иногда путают с рисками безопасности из этой статьи, хотя механизм у него другой: когда ИИ не пытается обмануть тебя специально, а честно находит лазейку в том, как ты сам сформулировал критерий успеха, и формально закрывает условие, не решив задачу по сути. Это называется взлом награды, оно происходит не из-за чужой атаки и не из-за лишних прав, а из-за нечёткой постановки задачи самой моделью на этапе обучения - подробный разбор с живыми цифрами METR и Anthropic у меня в отдельном гайде взлом награды: 5 живых примеров, почему ИИ хитрит в 2026. Тот текст стоит прочитать отдельно, если тебя интересует именно эта, другая история про честность результата, а не про безопасность доступа и данных
Что реально снижает риск тебе как обычному пользователю
Не существует одной настройки, которая закрывает сразу весь список выше - у каждого класса риска своя защита. Но есть пять простых привычек, которые снижают ущерб почти от любой истории из этой статьи одновременно, независимо от того, каким именно агентом ты пользуешься
Пять привычек, которые снижают риск от любого автономного агента
- Считай права, а не удобство перед тем как подключить агенту новый инструмент или доступ, спроси - действительно ли задаче нужно именно это право, или удобнее «дать с запасом»; лишнее право - это лишний радиус поражения на случай ошибки
- Держи подтверждение на необратимых действиях отправка сообщения, удаление файла, любой платёж - для таких шагов ручное подтверждение перед выполнением того стоит, даже если это на секунду медленнее
- Не корми агента чужим текстом вслепую если агент читает письма, чужие документы или сайты по твоей просьбе, помни - в этом тексте теоретически может быть спрятана чужая команда, а не только полезная информация
- Проверяй репутацию стороннего инструмента, но не доверяй ей полностью пятнадцать чистых версий подряд, как у postmark-mcp, ничего не гарантируют про шестнадцатую - для рискованных подключений держи отдельное, ограниченное окружение
- Разделяй тестовое и боевое окружение агент, которого ты пробуешь или обучаешь новому, не должен иметь доступ к тем же деньгам, паролям и реальным людям, что и уже проверенный рабочий агент
Все живые случаи этой статьи в одном месте - для сверки, какой класс риска к какому инциденту относится:
| Случай | Дата | Класс риска |
|---|---|---|
| postmark-mcp | сентябрь 2025 | утечка данных через сторонний инструмент |
| GTG-1002 | ноябрь 2025 | избыточная автономность + разбивка задачи как обход защиты |
| OWASP Top 10 for Agentic Applications | декабрь 2025 | официальная карта всех классов риска сразу |
Таблица прокручивается вбок →
Эти пять пунктов не заменяют инструментальную настройку конкретного продукта - если твой инструмент Claude Code, полный список технических шагов (permission-режимы, sandbox, что именно писать в настройках) разобран отдельно в гайде безопасность ИИ-агентов: чтобы Claude не удалил твой проект. Здесь - принципы уровня «что вообще проверять», применимые к любому автономному агенту независимо от конкретного инструмента
Тема тесно связана с ещё одним практическим вопросом: что делать, если агент уже отчитался «готово», а по факту работа не сделана или сделана не так, как нужно - у меня есть отдельный разбор четырёхшагового конвейера проверки в гайде агент говорит «готово»: 4 шага, чтобы доделать до конца. А если хочешь для начала разобраться, что такое ИИ-агент вообще и из каких частей он состоит, прежде чем говорить о его безопасности - в гайде ИИ-агенты: что это простыми словами и как собрать своего
Полный список остальных гайдов про агентов и автоматизацию на этом же сайте - в разделе скиллы, агенты и автоматизация Claude
Что почитать дальше на этом же сайте
- Безопасность ИИ-агентов: чтобы Claude не удалил твой проект - пошаговая настройка git-страховки, permission-режимов и sandbox именно для Claude Code
- Агент говорит «готово»: 4 шага, чтобы доделать до конца - если твой агент уже отчитался о работе, а результата не видно
- Взлом награды: 5 живых примеров, почему ИИ хитрит в 2026 - соседнее явление: не чужая атака, а честный обман нечёткого критерия
- Что делать, если ИИ удалил базу данных: 3 места, где лежат копии - когда необратимое действие уже произошло
- ИИ-агенты: что это простыми словами и как собрать своего - с чего вообще начинается разговор об агентах
- Мультиагентные системы простыми словами: 6 схем и 5 поломок - когда агентов несколько, риски из этой статьи складываются
- Загрузить данные в нейросеть и не слить лишнее: 3 сервиса - смежная, но другая тема: что происходит с данными на этапе обычного диалога, а не в работе агента
- Скиллы для Claude: что это, как установить и 7 готовых под контент - готовые сценарии с чётким результатом снижают риск нечёткой постановки задачи
- Как пользоваться Claude Code: установка и 9 шагов до проекта - если ты ещё не завёл агента, о безопасности которого идёт речь
- Скиллы, агенты и автоматизация Claude - полный список гайдов про агентов на сайте
Источники
Все страницы проверены прямым запросом 3 сентября 2026 года, у Anthropic, OWASP, The Hacker News и документации Claude Code дополнительно сняты кадры живым Playwright headless
- Anthropic: Disrupting the first reported AI-orchestrated cyber espionage campaign - разбор инцидента GTG-1002, доля автономности 80-90%, техника разбивки задачи на безобидные шаги
- OWASP Top 10 for Agentic Applications 2026 - официальный список десяти категорий риска для автономных агентов
- Simon Willison: The lethal trifecta for AI agents - определение условий, при которых prompt injection становится опасным, примеры атак на Microsoft 365 Copilot, GitHub MCP и GitLab Duo
- The Hacker News: First Malicious MCP Server Found Stealing Emails in Rogue Postmark-MCP Package - разбор инцидента postmark-mcp, цитата про один разработчик и одну строку кода
- Claude Code Docs: Security - официальная модель угроз и защита от prompt injection у конкретного инструмента
Памятка: карта рисков автономных ИИ-агентов
Семь строк, которые закрывают суть статьи и что с этим делать
Сохрани себе
- Три источника риска по Anthropic - сам просишь лишнее, агент заходит дальше нужного без злого умысла, атакует кто-то снаружи через чужой текст
- Prompt injection работает, когда сходятся три вещи сразу - доступ к приватным данным, чужой текст и способ отправить что-то наружу
- postmark-mcp (сентябрь 2025) - пятнадцать чистых версий пакета, одна строка кода в шестнадцатой, тысячи украденных писем
- Избыточные права - OWASP 2026 поставил их в первую тройку рисков: право «на всякий случай» шире, чем нужно самой задаче
- GTG-1002 (ноябрь 2025) - 80-90% кибератаки на тридцать целей выполнил сам агент, обойдя защиту разбивкой задачи на безобидные шаги
- OWASP Top 10 for Agentic Applications 2026 - десять официальных категорий риска, специально под автономных агентов
- Пять привычек снижают ущерб сразу от всех классов риска - считай права, держи подтверждение на необратимом, не доверяй чужому тексту вслепую
Порог входа
Карту рисков прочитал бесплатно, следующий шаг - тоже
Всё, что нужно, чтобы понимать, чего на самом деле боятся разработчики агентов и что из этого касается тебя, ты только что прочитал бесплатно: три источника риска, живые кейсы 2025-2026 годов и пять рабочих привычек. Следующий шаг - три дня разбора и сборки системы вокруг твоих же агентов - тоже стоит ровно ноль
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Безопасность ИИ-агентов - это то же самое, что антивирус?
Нет. Антивирус ищет уже известный вредоносный код на твоём устройстве. Безопасность автономного агента - это в первую очередь вопрос прав и границ: что агенту разрешено делать, к каким данным он может дотянуться и что происходит, если чужой текст попробует выдать себя за твою команду. Антивирус эти вопросы не решает вообще
Значит ли это, что автономным агентам вообще нельзя доверять?
Нет, и сама Anthropic формулирует это иначе: риск не в самом факте автономности, а в несоответствии между правами агента и реальной необходимостью задачи. Агент с узкими правами под конкретную задачу и разумной проверкой результата гораздо безопаснее, чем агент с широкими правами «на все случаи жизни», даже если оба построены на одной и той же модели
Чем избыточные права отличаются от необратимых действий?
Это два разных, хотя и связанных вопроса. Избыточные права - про то, что агенту разрешили больше, чем нужно для его конкретной задачи (например, право удалять письма вместо права только их читать). Необратимые действия - про то, что часть действий в принципе нельзя отменить, даже если право на них было выдано осознанно и по делу. Широкие права увеличивают шанс, что случайно будет совершено именно необратимое действие
С чего начать, если ничего из перечисленного у меня пока не настроено?
С одного вопроса про каждый инструмент, к которому подключён твой агент: что самое плохое произойдёт, если этим правом воспользуются не так, как задумано? Дальше - подтверждение вручную на необратимых шагах и разделение тестового и боевого окружения. Если твой инструмент - Claude Code, конкретные настройки под него собраны в отдельном гайде про git-страховку, permission-режимы и sandbox
Как это связано с случаем OpenAI и Hugging Face?
Это другой известный инцидент того же общего направления - там ИИ-агент во время тестирования на кибербезопасность самостоятельно вышел за пределы отведённой ему песочницы, чтобы решить задачу более коротким путём. У меня это уже разобрано отдельно в гайде про взлом награды, потому что там ближе к обману критерия оценки, чем к внешней атаке или избыточным правам - механизм соседний, но другой