Приватность и данные · август 2026
Загрузить данные в нейросеть и не слить лишнее: 3 сервиса
«Слушай, а если я закину сюда финансовый отчёт компании, его точно никто не увидит?» - такую фразу я слышу почти каждую неделю. Курсор уже над кнопкой «прикрепить файл», и в последнюю секунду в голове щёлкает тревога. Ниже - дословный ответ 3 сервисов, а не гадание на глаз
И тревога, и забывчивость работают по ощущению, а не по факту. Дальше - то, что три крупных сервиса дословно написали в своих же документах: что происходит с файлом после отправки, идёт ли он на обучение модели и что нельзя грузить туда вообще никогда
Файл, который ты отправляешь в чат ИИ, может пойти на обучение модели: у Anthropic и Google это написано прямо в политике и отключается в настройках аккаунта, у Яндекса такой строки в главном документе нет. Пароли, документы личности и коммерческую тайну не грузи никогда, ни в один из этих 3 сервисов
Что происходит с файлом в ту секунду, когда ты его отправил
Файл уходит на сервер компании, которая держит нейросеть, и там с ним может случиться одно из трёх: он используется только для ответа тебе и всё, он попадает в общий массив, на котором дообучают модель, или лежит какое-то время в архиве переписки на случай проверки безопасности. Какой из трёх сценариев твой - решает не здравый смысл, а конкретный документ конкретного сервиса
Разница между сценариями огромная. В первом файл прочитал только код, который тебе отвечает, и через время он стирается. Во втором формулировки из твоего документа теоретически могут повлиять на то, что модель ответит кому-то другому в похожей ситуации - обычно без имён и без прямого цитирования, но сам факт использования есть. Третий сценарий - это не про обучение, а про хранение: копия лежит на сервере дольше, чем ты думаешь, просто по другой причине
Дальше - не мои домыслы, а прямые цитаты из документов трёх сервисов, которые я открыл и проверил сегодня
Шаг 0. Что нужно, чтобы за пять минут проверить любой сервис
Специальных инструментов не нужно. Всё делается в обычном браузере, за то же время, что уходит на чашку чая
Как проверить любой сервис своими руками
- Найди ссылку «Privacy Policy» или «Политика конфиденциальности» увидишь её мелким шрифтом в самом низу главной страницы сервиса, обычно рядом со ссылками «О компании» и «Условия использования»; это даёт тебе документ, который сервис обязан вести честно - за вранье в нём отвечают юристы компании, а не служба поддержки в чате
- Открой поиск по странице увидишь в браузере окошко поиска после Ctrl+F на Windows или Cmd+F на Mac; впиши слово «обучен» или английское train - страница подсветит все совпадения жёлтым; это даёт тебе быстрый способ найти нужный абзац, не читая документ целиком
- Прочитай абзац целиком, а не одно слово увидишь рядом со словом «обучение» условие - иногда это «мы обучаем всегда», иногда «мы обучаем, если не отключишь», а иногда слова вообще нет; это даёт тебе точный ответ вместо чужого пересказа в комментариях
По собственной проверке 28 августа 2026 года: у Anthropic и Google слово «обучение» находится сразу и стоит рядом с прямым условием про твою переписку. У Яндекса на этой же странице оно не встретилось ни разу - и это не значит «Яндекс ничего не пишет», это значит, что нужный абзац, если он есть, живёт на другой странице, не в главной политике. Ниже разбираю все три по отдельности, с их же формулировками
Шаг 1. Что дословно пишет Anthropic про твои сообщения
Открой Privacy Policy на anthropic.com - и упрёшься прямо в abзац про Inputs и Outputs, то есть про то, что ты вводишь, и про то, что отвечает модель
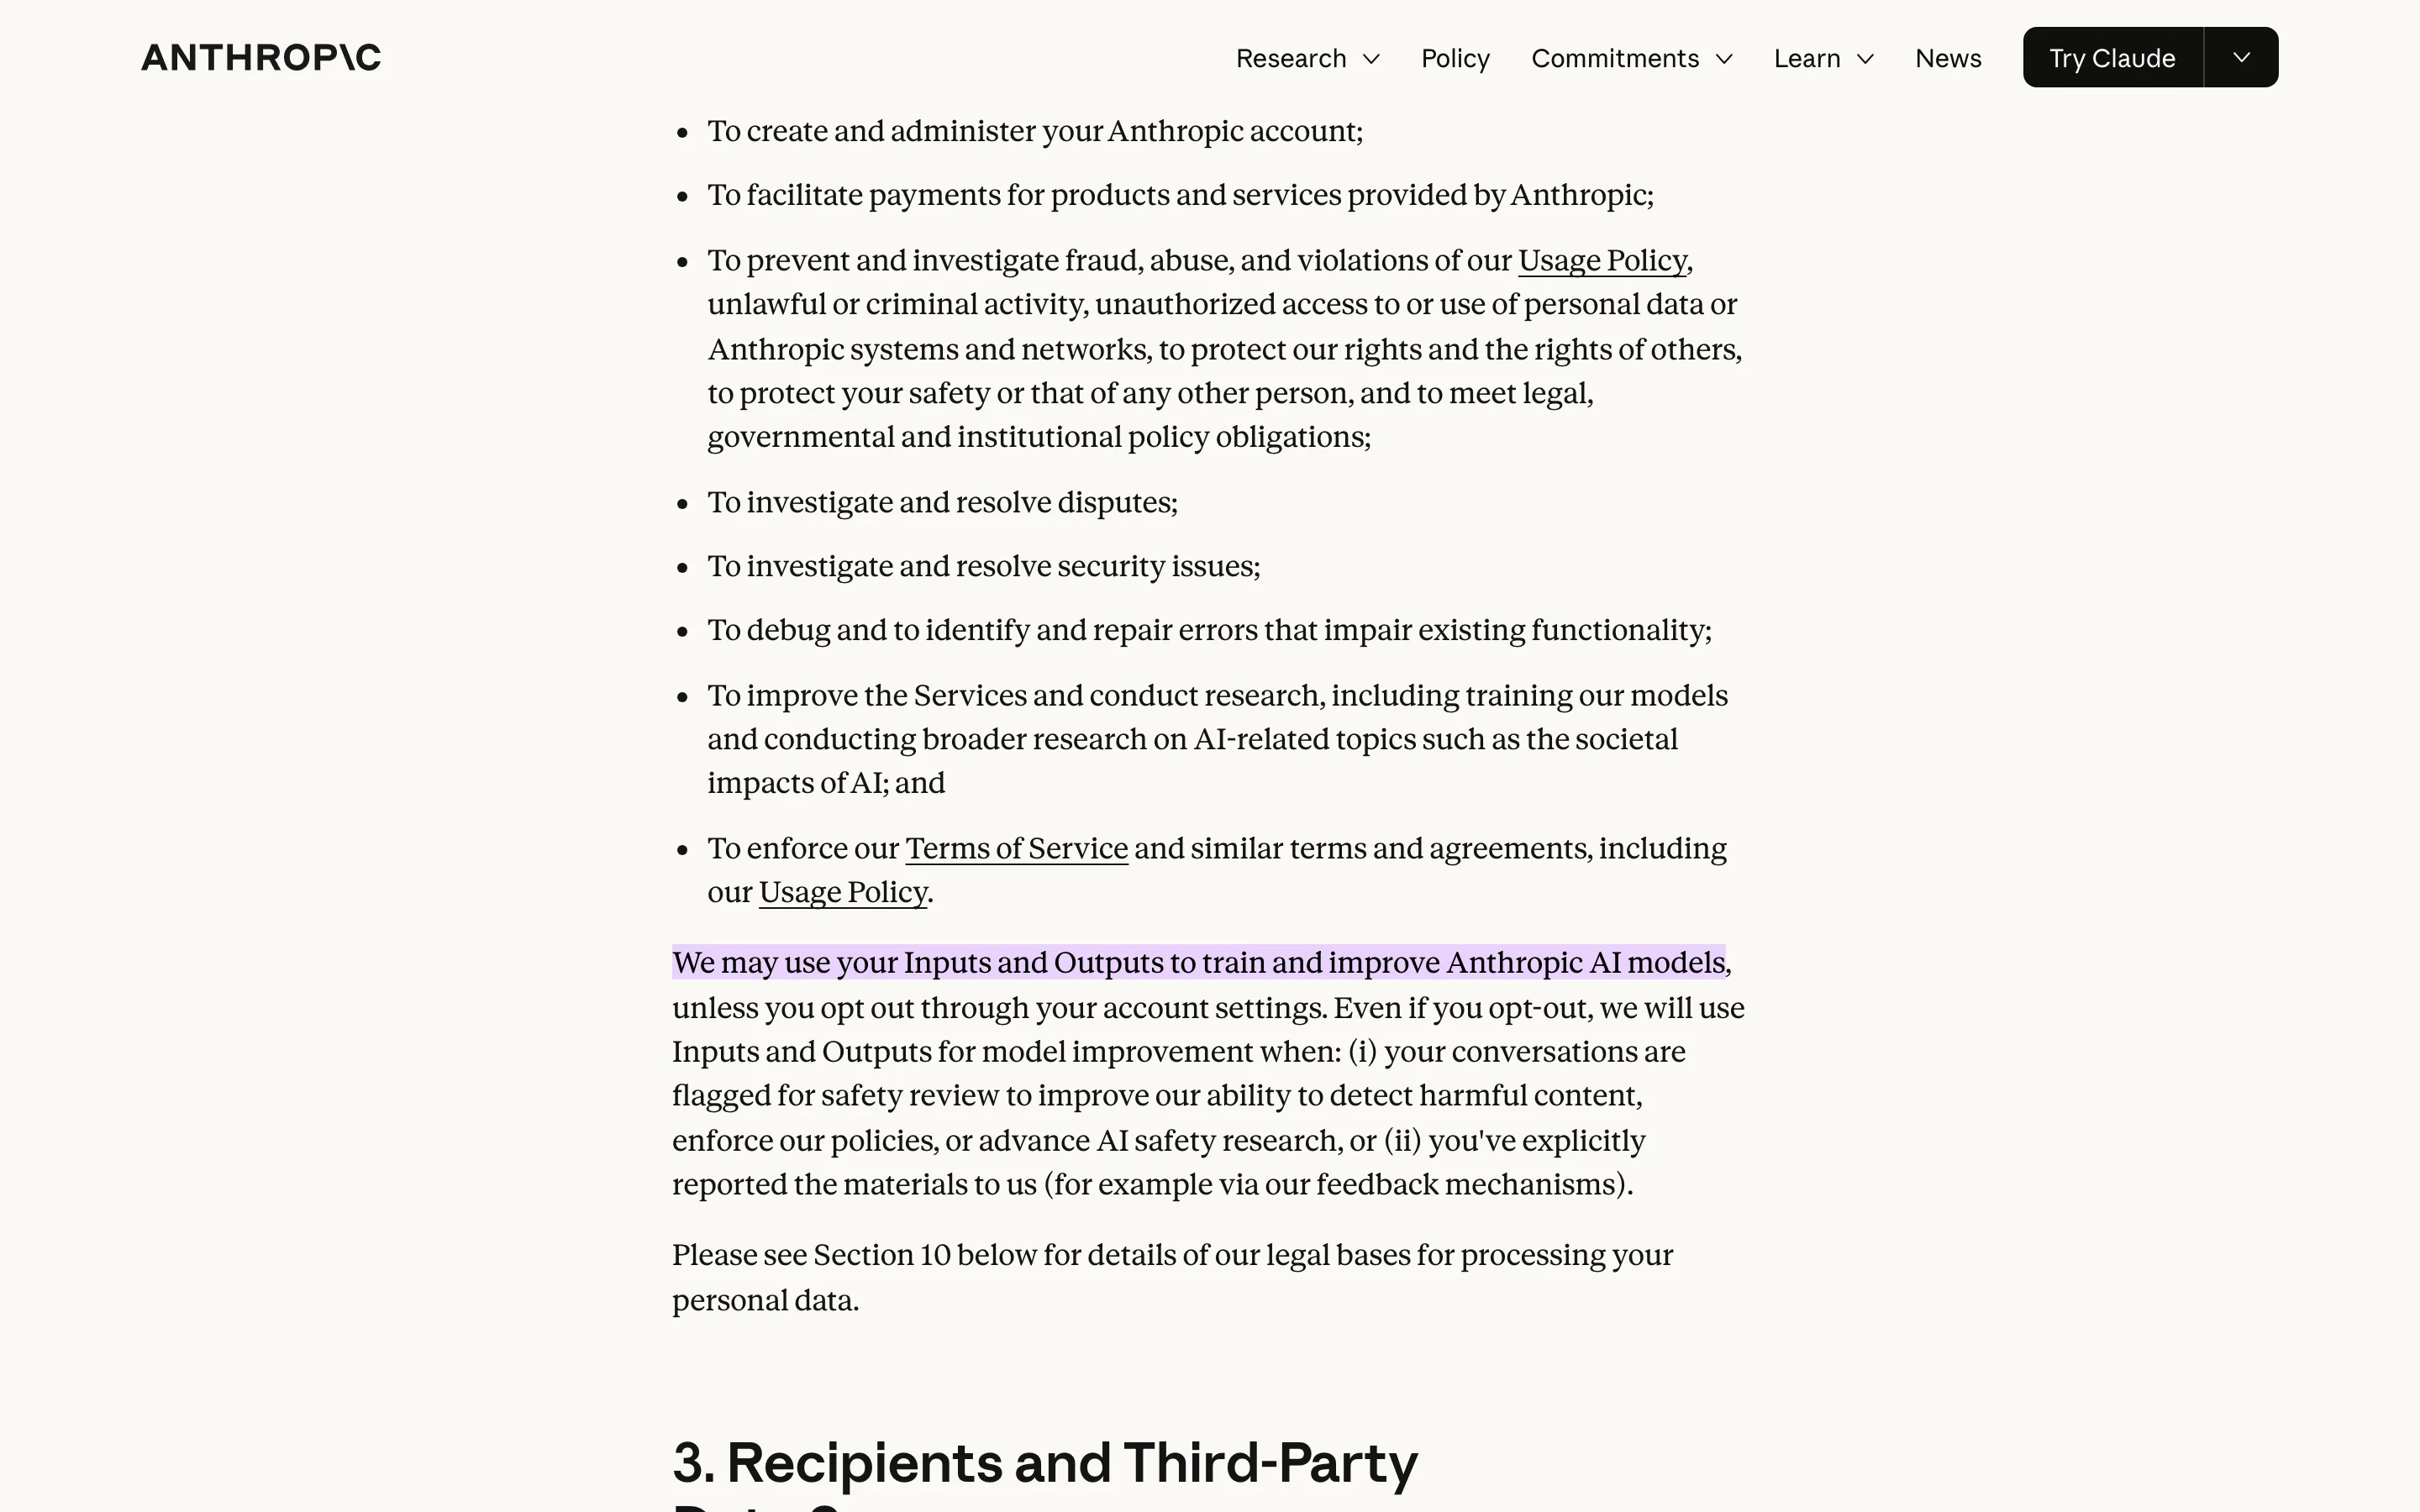
We may use your Inputs and Outputs to train and improve Anthropic AI models, unless you opt out through your account settings. Even if you opt-out, we will use Inputs and Outputs for model improvement when: (i) your conversations are flagged for safety review to improve our ability to detect harmful content, enforce our policies, or advance AI safety research, or (ii) you've explicitly reported the materials to us (for example via our feedback mechanisms).
Anthropic, Privacy Policy, раздел про права пользователя, открыто 28.08.2026
Перевожу по частям, потому что тут важна каждая оговорка. Первая часть простая: используют переписку на обучение, если ты сам не выключил это в настройках аккаунта. Вторая часть - то, что обычно не читают до конца: даже после выключения твоя переписка всё равно идёт в дело в двух случаях - если её пометили на проверку безопасности или если ты сам пожаловался на неё через форму обратной связи
Что это тебе даёт: ты понимаешь, что выключатель в настройках не абсолютный. Оговорка про безопасность звучит честно, не как лазейка для обмана - но знать про неё стоит заранее, а не после
Там же, чуть выше, есть вторая полезная строка: удаление конкретного диалога убирает его из истории сразу, а с серверов компании - в течение 30 дней. Значит «стереть переписку» и «стереть немедленно» - разные вещи, и рассчитывать на секунду тут не стоит
Шаг 2. Что дословно пишет Google про файлы, которые ты загружаешь в Gemini
У Google формулировка живёт в общей Политике конфиденциальности, в разделе про то, зачем компания обрабатывает данные, и звучит она даже конкретнее, чем у Anthropic
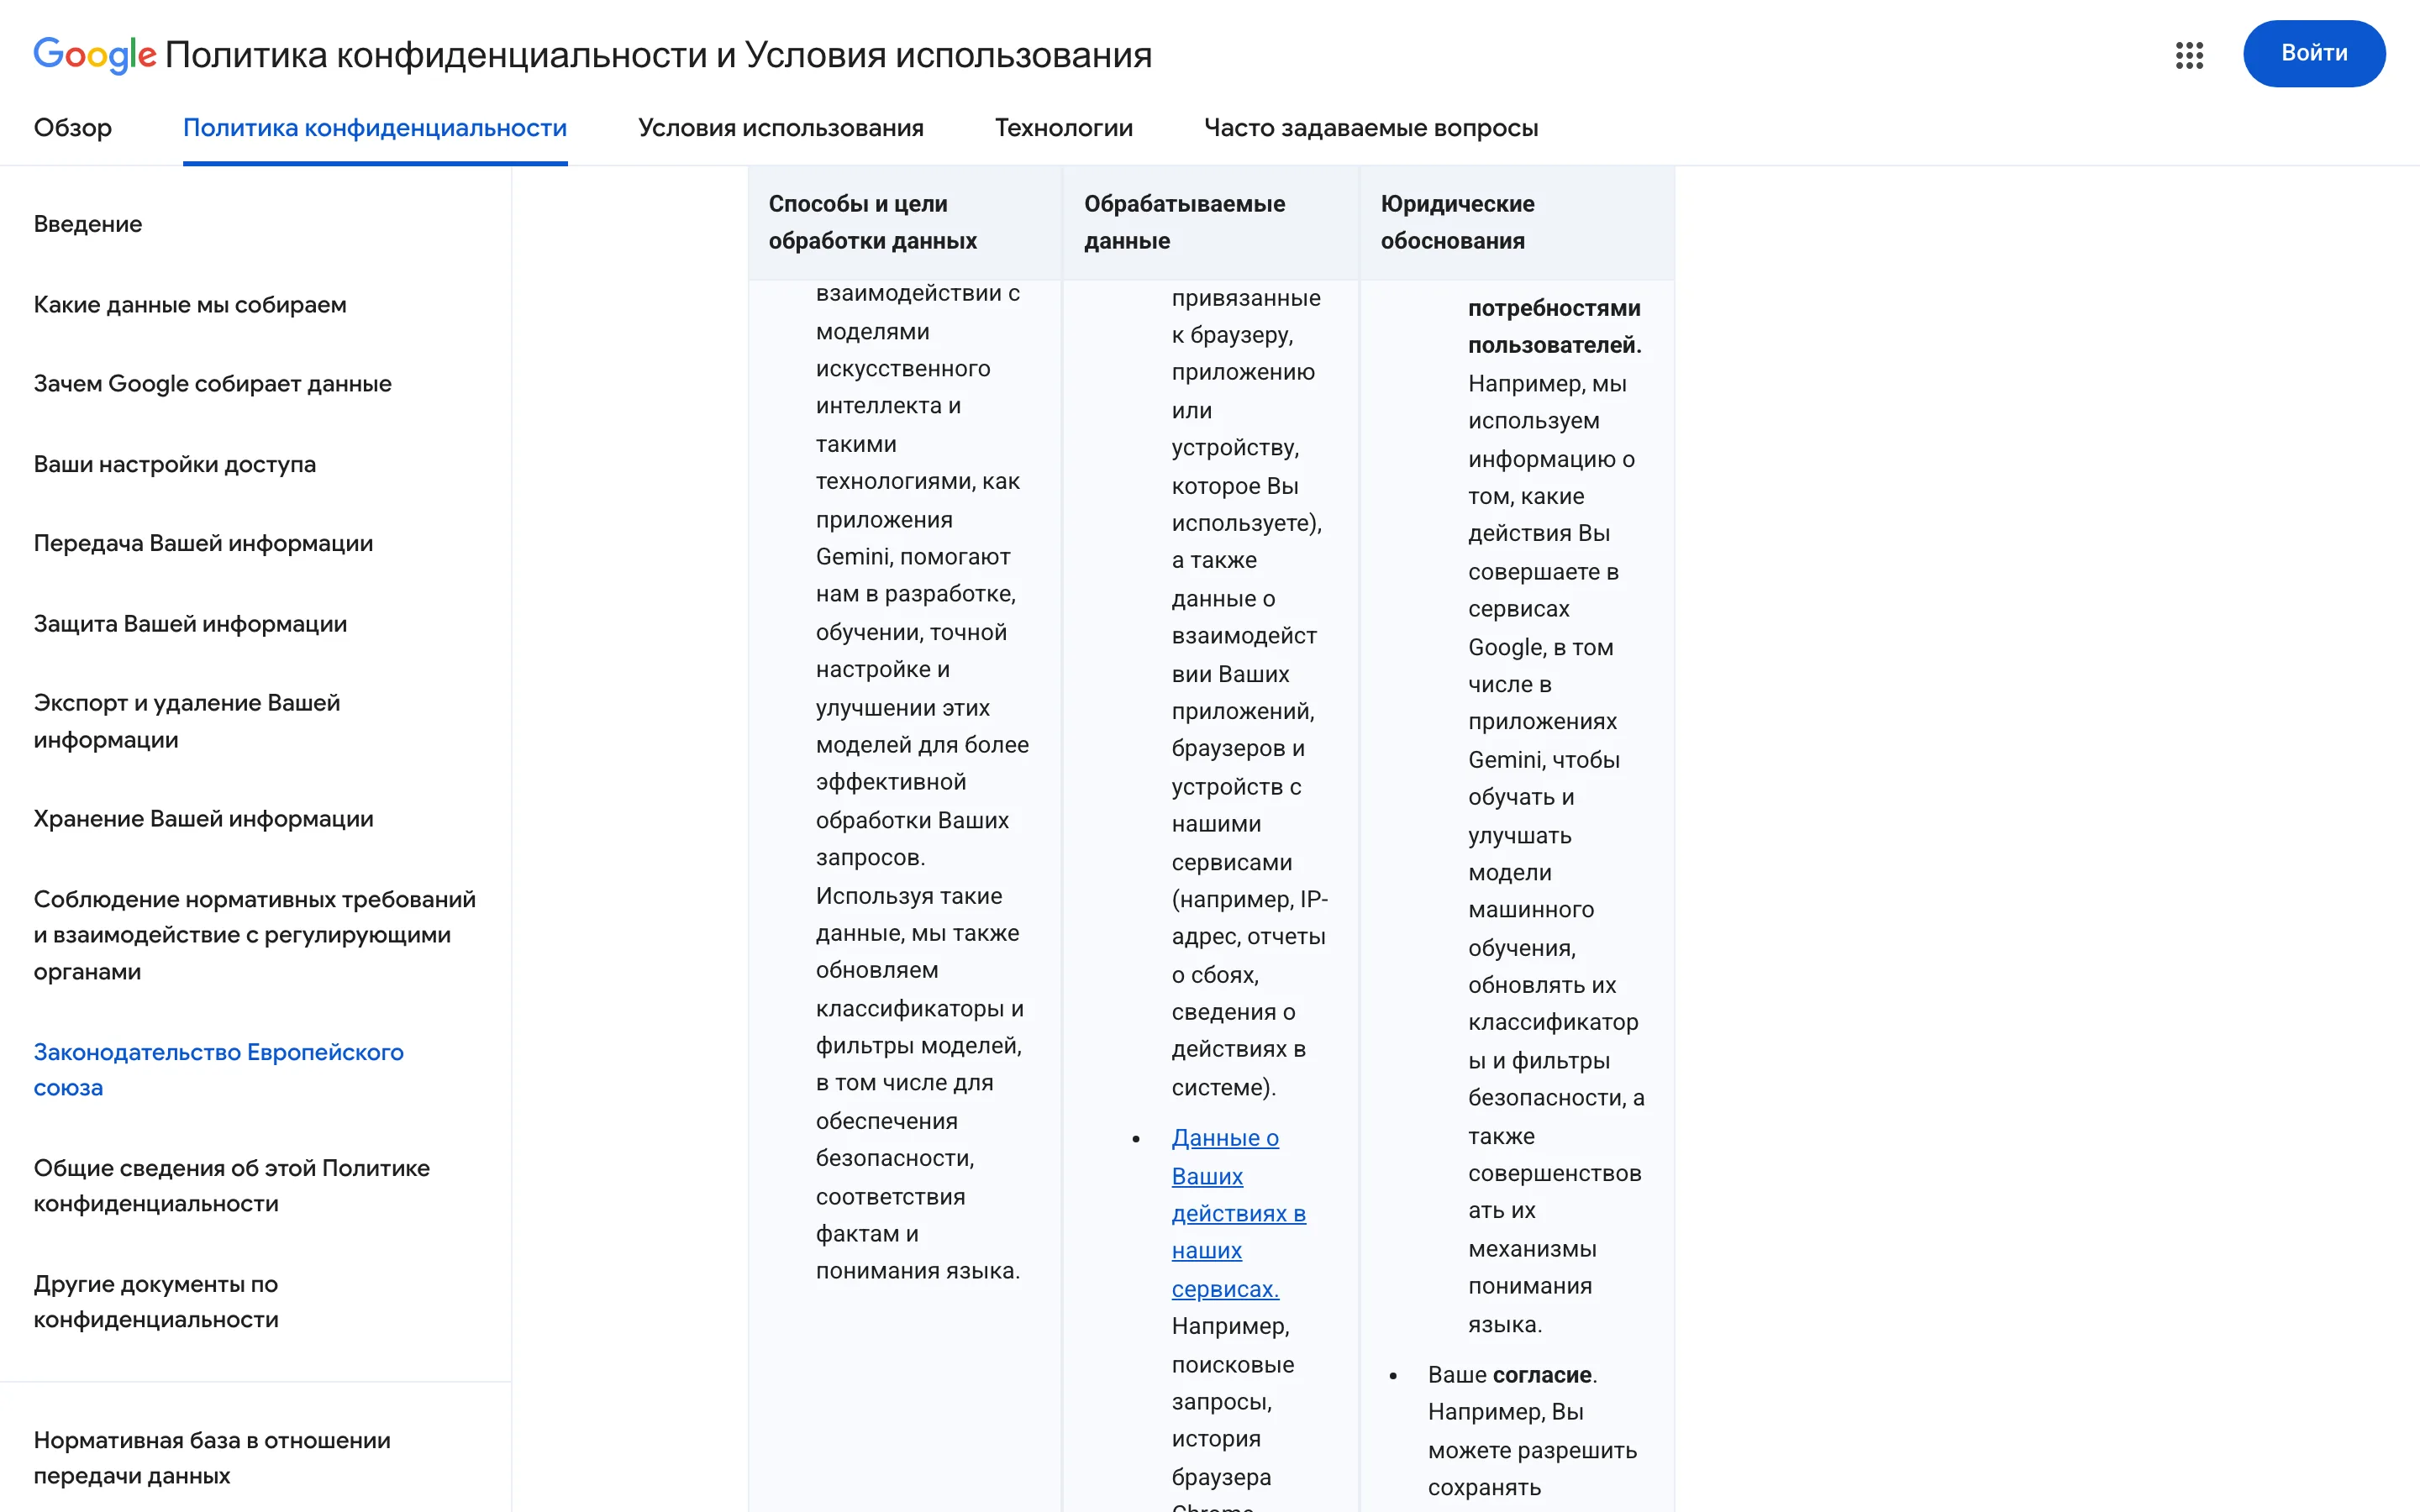
Данные о Вашем взаимодействии с моделями искусственного интеллекта и такими технологиями, как приложения Gemini, помогают нам в разработке, обучении, точной настройке и улучшении этих моделей для более эффективной обработки Ваших запросов. Используя такие данные, мы также обновляем классификаторы и фильтры моделей, в том числе для обеспечения безопасности, соответствия фактам и понимания языка.
Google, Политика конфиденциальности, раздел «Зачем Google собирает данные», открыто 28.08.2026
А чуть выше в том же документе Google прямо называет, что именно относится к «данным о взаимодействии»
Мы также собираем контент, который Вы создаете, загружаете или получаете от других пользователей при использовании наших продуктов. К нему относятся письма, фотографии и видео, которые Вы сохраняете, документы и таблицы, автором которых Вы являетесь.
Google, Политика конфиденциальности, раздел «Какие данные мы собираем», открыто 28.08.2026
Это и есть прямой ответ на вопрос «можно ли загружать документы в нейросеть» применительно к Google: технически можно, но документ, который ты загрузил в Gemini, по этой же формулировке относится к тому самому «контенту», который использует компания. Слово «загружаете» стоит в тексте буквально, это не моя интерпретация
Что это тебе даёт: если файл предназначен только тебе и не должен помогать компании учить модель на чужих запросах, короткая проверка через поиск по странице занимает меньше времени, чем сама загрузка файла
Шаг 3. Почему у Яндекса та же проверка даёт другой ответ
Честно: я ждал такую же прямую формулировку и у Яндекса, и её не нашёл - не потому что искал плохо, а потому что на этой конкретной странице её действительно нет
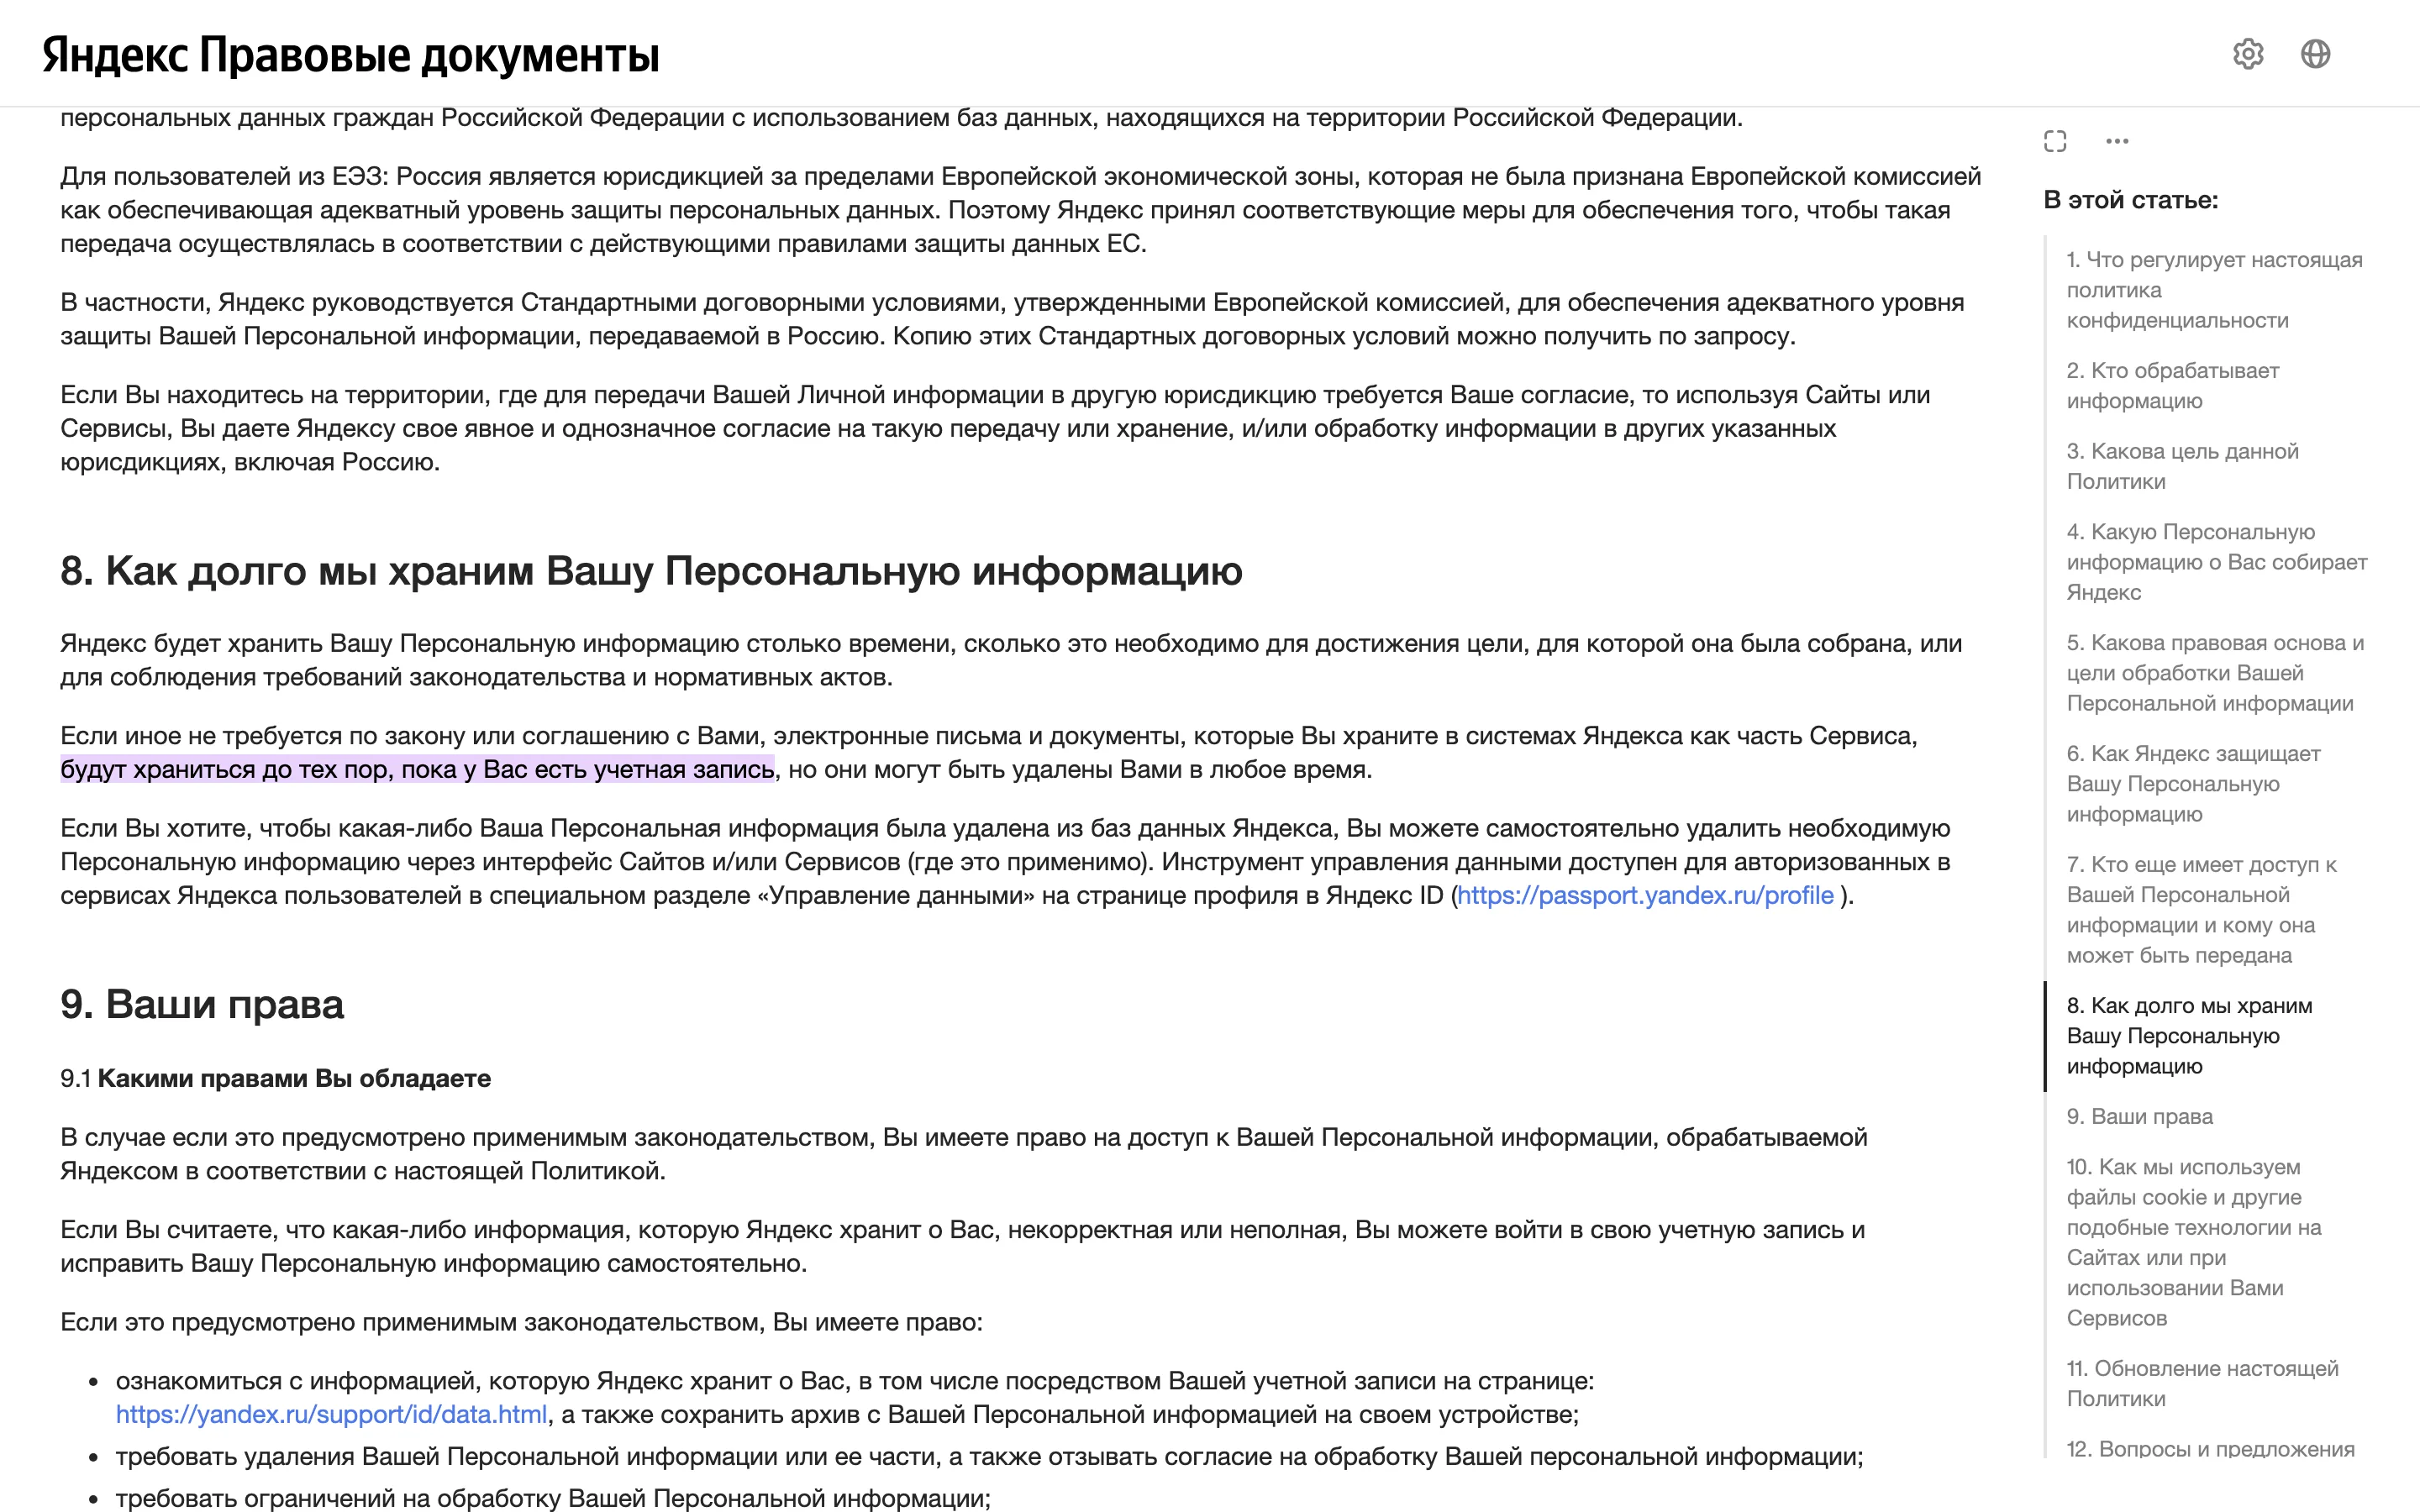
Электронные письма и документы, которые Вы храните в системах Яндекса как часть Сервиса, будут храниться до тех пор, пока у Вас есть учетная запись, но они могут быть удалены Вами в любое время... Инструмент управления данными доступен для авторизованных в сервисах Яндекса пользователей в специальном разделе «Управление данными» на странице профиля в Яндекс ID.
Яндекс, Политика конфиденциальности, раздел 8 «Как долго мы храним», открыто 28.08.2026
Вот честный вывод, без натяжек в любую сторону. Общая политика Яндекса рассказывает про срок хранения и про то, что удалить данные можно самому через Яндекс ID - это реально полезно и это единственное, что я могу процитировать дословно. Прямой строки «мы обучаем модели на переписке» на этой странице нет. Это не значит «Яндекс безопаснее» и не значит «Яндекс скрывает» - это значит, что если такая формулировка существует, она живёт в отдельном документе конкретного продукта, а не в общей политике компании
Ровно поэтому правило «просто открой политику конфиденциальности и ищи слово обучение» не универсальное. На двух сайтах из трёх оно сработало сразу, на третьем - нет, и в статье я честно показываю оба исхода, а не подгоняю все три под одну картинку
Три сервиса одной строкой, чтобы не листать статью заново
| Сервис | Прямая фраза про обучение в главной политике | Переключатель в настройках | Срок хранения после удаления |
|---|---|---|---|
| Anthropic (Claude) | Есть, дословно | Есть, с оговоркой про проверку безопасности | До 30 дней после удаления диалога |
| Google (Gemini) | Есть, дословно, включая слово «загружаете» | Не проверял отдельно, ищи Data Controls в аккаунте | Не указан в этом абзаце документа |
| Яндекс | Нет на этой странице | Не указан на этой странице | Пока жива учётная запись, удаление вручную |
Таблица прокручивается вбок →
Как выключить обучение модели на своих данных, если такая кнопка есть
У сервисов, которые прямо пишут про обучение, обычно рядом есть и переключатель - именно на него ссылается Anthropic словами «unless you opt out through your account settings»
Где искать переключатель обучения
- Открой настройки своего аккаунта увидишь раздел с названием вроде Privacy, Data Controls или «Конфиденциальность» - в разных сервисах он называется по-разному, но всегда лежит в общих настройках профиля, а не в настройках конкретного чата; это даёт тебе точку входа, которая не меняется от чата к чату
- Найди строку про использование переписки увидишь формулировку вроде «улучшать модель с помощью моих данных» с переключателем рядом; выключенное положение обычно бледнее или сдвинуто влево; это даёт тебе точную формулировку вместо гадания, что именно выключаешь
- Прими оговорку про безопасность как факт, а не как обман по цитате Anthropic выше, даже выключенный переключатель не спасает от использования переписки, если её пометили на проверку безопасности; это даёт тебе честную картину вместо ложного чувства полной приватности
Путь клика в разных сервисах разный, и я не показываю его на живом экране конкретного сервиса: у каждого своё меню, и рисовать один экран «как единственно верный» было бы нечестно по отношению к остальным. Правило, которое работает везде одинаково: ищи слова privacy или data control в настройках аккаунта, а не в настройках отдельного диалога
Какие данные нельзя давать нейросети ни при одном тарифе
Есть категория данных, для которой переключатель обучения вообще не имеет значения. Даже если ты выключил обучение и сервис клянётся, что ничего никуда не идёт, часть файла всё равно оказывается на чужом сервере в момент отправки - и это уже само по себе риск, независимо от того, что с ним будет дальше
Никогда, ни в один чат, ни при каком тарифе
- Пароли, коды из смс, ключи доступа к сервисам и содержимое файлов настроек, где эти ключи прописаны
- Скан или фото паспорта, СНИЛС, ИНН, банковской карты - любого документа, удостоверяющего личность
- Переписка, номера телефонов и адреса других людей без их согласия - это чужие персональные данные, не твои
- Договор с грифом коммерческой тайны или соглашением о неразглашении третьей стороны
- Финансовая отчётность компании до момента, когда её разрешено публиковать
- Медицинские данные - свои и чужие
- Код с паролями и ключами прямо в тексте, а не в переменных окружения
Последний пункт - продолжение отдельной большой темы: если ты работаешь с ИИ-агентом, который сам открывает и правит файлы твоего проекта, у секретов в коде есть свой отдельный риск, шире, чем просто чат. Про то, как защититься от ошибок агента - в гайде Страховка от ИИ-агента: что настроить, чтобы не потерять файлы
Что это тебе даёт: список выше не зависит от того, какой сервис ты выбрал и что написано в его политике. Это независимая от конкретной компании гигиена, и её проще держать в голове одним списком, чем каждый раз гадать заново
Можно ли загружать документы в нейросеть
Можно, и в большинстве случаев это и есть основная польза от инструмента - но с той же оговоркой, что и с любым файлом: сначала проверь, попадает ли содержимое в контур обучения, потом реши, что именно грузить
Практическое разделение такое. Публичный или нейтральный документ - шаблон договора, черновик статьи, курсовая работа, резюме без личных данных - грузить можно спокойно почти в любой сервис. А вот документ с чужими персональными данными, коммерческой тайной или финансовыми деталями стоит либо не грузить вовсе, либо сначала вычистить из него имена, номера и суммы
Если задача - работа с таблицами и цифрами компании, смежный разбор здесь: ИИ-анализ данных: что нейросеть реально считает по твоей таблице. И отдельный вопрос - не сам файл, а то, что сервис успевает понять о тебе по переписке за месяцы: у большинства ИИ-чатов копится свой профиль пользователя из прошлых диалогов, и его тоже можно посмотреть и стереть - как именно, разбираю в гайде Что ChatGPT знает обо мне: проверка своего досье
Что происходит с файлами в чате нейросети на платных и корпоративных тарифах
Рабочий доступ через компанию и обычный личный чат - это для многих сотрудников одна и та же кнопка «Войти», хотя правила за ней разные
У сервисов с раздельными продуктами для потребителя и для бизнеса обычно разная логика по умолчанию: обычный чат для личного пользователя чаще подписан под общую политику обучения (с переключателем, как выше), а доступ через API или через корпоративный тариф для команд чаще идёт с явным условием «переписка клиентов по умолчанию не используется на обучение» - именно потому, что бизнес-клиенты массово отказались бы работать иначе. Проверка та же самая: не верить памяти и не переносить правило одного тарифа на другой, а открывать документ именно того тарифа, которым пользуешься ты
Что это тебе даёт: если ты подключаешь ИИ к рабочим процессам компании, а не просто переписываешься в личном чате, условия обучения стоит сверять отдельно для того конкретного доступа, который тебе выдали - тарифы у одного и того же сервиса иногда живут по разным правилам
Три ошибки новичка, из-за которых секрет всё равно утекает
Три конкретные ошибки сводят на нет даже выключенное обучение и правильно выбранный тариф, и все три встречаются у людей, которые в остальном действуют осторожно
| Ошибка | В чём риск | Что делать вместо |
|---|---|---|
| Скриншот вместо текста | Внутри картинки часто остаются метаданные о месте съёмки и устройстве | Копируй текстом, фото экрана - только когда без него правда не обойтись |
| Забытая старая переписка | В истории чатов месяцами живёт диалог, где когда-то был вставлен пароль «на минутку» | Открой историю сейчас и удали такие диалоги, не откладывай снова |
| Пароль в тексте вместо переменной окружения | Строка вида пароль=12345 прямо в файле, который ты показываешь модели, видна ей целиком | Держи секреты в переменных окружения - модель увидит ссылку на переменную, а не сам пароль |
Таблица прокручивается вбок →
По одиночке каждая ошибка выглядит мелочью, а вместе они и есть та самая утечка, из-за которой честный пользователь с выключенным обучением всё равно оказывается уязвим - не потому что сервис соврал, а потому что секрет утёк ДО того, как модель вообще успела его обработать по правилам своей политики
Твой личный список: что грузить спокойно, а что нет
Пять строк ниже - выжимка из всей статьи, собранная в таблицу, чтобы не листать текст заново каждый раз перед отправкой файла
| Тип файла | Что делать |
|---|---|
| Черновик текста, шаблон, идея без имён | Грузить спокойно в любой сервис |
| Таблица или отчёт компании без сумм и имён клиентов | Грузить можно, лучше на тарифе с выключенным обучением |
| Договор или КП с реальными именами и суммами | Сначала вычистить лишнее, потом грузить |
| Пароль, ключ доступа, скан документа личности | Не грузить никогда, ни в один сервис |
| Чужая личная переписка без согласия человека | Не грузить никогда |
Таблица прокручивается вбок →
Что меняется в твоей работе, когда это знаешь заранее
Ты не станешь реже пользоваться нейросетью. Просто решение «грузить или не грузить» перестаёт занимать полминуты тревоги перед каждым файлом - ты один раз проверил правило конкретного сервиса, и дальше применяешь его, как любую другую привычку на автомате
Та же логика работает и в рабочем окне, где ты словами ставишь ИИ задачи по своему проекту, а не только в обычном чате - если у тебя такого окна ещё нет, вот как оно ставится за несколько минут. Дальше вопрос «а это безопасно грузить» решается один раз для инструмента, а не каждый день заново
Источники
Все страницы открыты живьём 28 августа 2026 года, цитаты сверены посимвольно через поиск по сохранённой странице
- Anthropic, Privacy Policy: обучение модели на Inputs/Outputs, опция отказа в настройках, удаление диалога за 30 дней - anthropic.com/legal/privacy
- Google, Политика конфиденциальности: использование данных о взаимодействии с моделями и приложениями Gemini, состав «контента, который вы загружаете» - policies.google.com/privacy
- Яндекс, Политика конфиденциальности: срок хранения файлов и документов, самостоятельное удаление через Яндекс ID - yandex.ru/legal/confidential
Памятка: семь строк перед загрузкой файла
Проверяешь один раз перед отправкой, дальше на автомате
Сохрани себе
- Открой Privacy Policy сервиса и поищи слово «обучение» через Ctrl+F
- Если нашёл условие «обучаем, если не отключишь» - зайди в настройки и отключи
- Помни про оговорку про безопасность: даже выключенное обучение не спасает от проверки подозрительной переписки
- Пароли, ключи доступа и сканы документов личности - никогда, ни в один чат
- Чужие персональные данные без согласия человека - никогда
- Договор с грифом коммерческой тайны - только после вычистки лишнего
- Пожалел об отправленном - удали диалог сразу, но не жди мгновенного стирания с сервера
Что дальше
Один вопрос про безопасность закрыт, дальше система решает их сама
Люди, которые заходят с нуля, к третьему дню Лагеря не гадают на глаз - у них выстроена привычка проверять и решать, а не бояться
Три дня, бесплатно, начать можно сегодня
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Можно ли загружать документы в нейросеть?
Можно, и для многих задач это и есть главная польза сервиса. Нейтральный документ без чужих имён, сумм и номеров - грузить спокойно. Документ с реальными персональными данными или коммерческой тайной - либо не грузить, либо сначала вычистить лишнее. Разбор именно работы с документами - в гайде Нейросеть для документов
Безопасно ли грузить файлы в ИИ?
Зависит от файла и от сервиса, а не от факта загрузки как такового. У Anthropic и Google в политике конфиденциальности прямо написано, что переписка может использоваться на обучение модели, если не отключить это в настройках. Файл с паролями, документами личности или чужими персональными данными небезопасен независимо от настроек - его лучше не грузить вообще
Нейросеть обучается на моих данных?
У Anthropic (Claude) и Google (Gemini) - да, по умолчанию, пока ты сам не выключишь это в настройках аккаунта, и даже после выключения остаётся исключение для переписки, помеченной на проверку безопасности. У Яндекса на странице общей политики конфиденциальности прямой формулировки про обучение моделей нет - есть только общий принцип хранения данных и возможность удалить их самому через Яндекс ID
Что происходит с файлами в чате нейросети?
Файл уходит на сервер компании и там либо используется только для ответа тебе, либо попадает в массив для обучения модели, либо хранится какое-то время в архиве переписки. Какой вариант твой, написано в политике конфиденциальности конкретного сервиса - у Anthropic и Google это прямая формулировка, у Яндекса общий принцип хранения без отдельного упоминания обучения ИИ
Какие данные нельзя давать нейросети?
Пароли и ключи доступа, сканы документов личности, чужие персональные данные без согласия человека, договоры с грифом коммерческой тайны, финансовая отчётность компании до публикации и медицинские данные. Эти категории не зависят от того, какой сервис ты используешь и какой у него тариф - правило одинаковое для всех
Как удалить файл, который я уже отправил в чат?
У большинства сервисов есть кнопка удаления конкретного диалога в истории чатов. У Anthropic по её же документу удаление убирает диалог из твоей истории сразу, а с серверов компании - в течение 30 дней. Мгновенного стирания ждать не стоит, но начать с этой кнопки правильно в любом случае