ИИ-агенты · честная проверка 2026
ИИ-агенты: почему ими не пользуются и 7 задач, где экономят часы
Тезис «агентами почти никто не пользуется» звучит везде, и у него есть реальная опора - опрос Pew Research Center 2026 года. Проблема в том, что эта опора измеряет совсем не агентов, а обычные чат-боты, и подмена этих двух вещей превращает честную статистику в неверный вывод
К концу статьи будет ясно: что из тезиса «никто не пользуется» подтверждено данными трёх независимых организаций (Pew, MIT, McKinsey), а что оказывается подменой понятий, и семь задач, которые я лично прогнал в своём Claude Code с секундомером в руках - с реальным временем, а не оценкой на глаз. Если после этого решишь, что тебе нужен именно агент, а не просто чат, отдельный гайд ИИ-агенты: что это простыми словами и как собрать своего разберёт сборку по шагам
Открой список из 7 задач ниже и найди свою: перед тем как заводить агента под неё, сначала прогони задачу один раз сам и засеки время по часам. Если ручная версия занимает больше 15-20 минут и результат легко проверить одним взглядом - это кандидат на агента. Если задачу нельзя проверить за минуту - агент сэкономит время только на бумаге, а на деле съест его же на проверке
Откуда взялся тезис «никто не пользуется ИИ-агентами»
Тезис обычно строят на одной цифре без контекста: сколько людей пробовали чат с ИИ. Цифра реальная, свежая, и звучит скромно - но дальше начинается подмена, о которой почти никто не предупреждает
Что показывает опрос про использование чатов
У Pew Research Center есть прямой замер этого вопроса на выборке в 5119 взрослых США, опрос проведён 17-23 февраля 2026 года
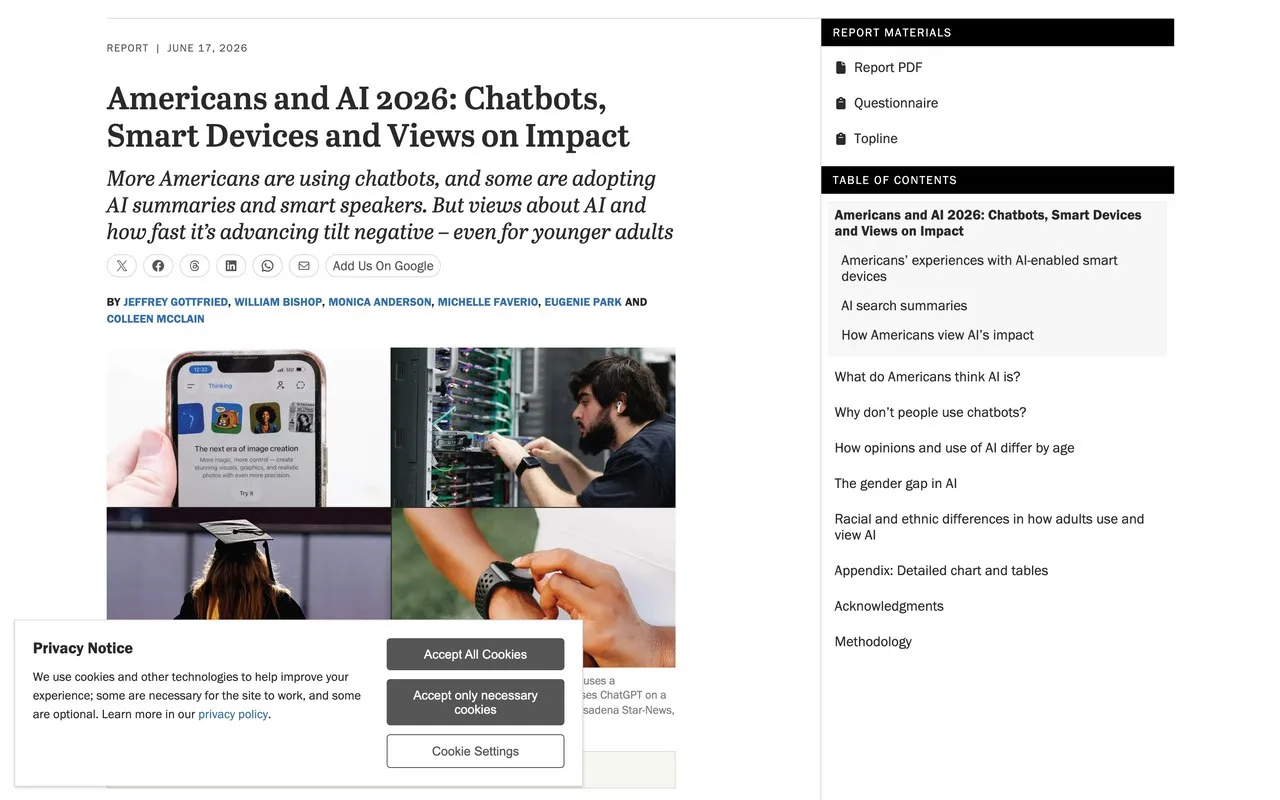
По этому опросу 49% взрослых американцев хотя бы раз пользовались ИИ-чат-ботом - рост с трети в 2024 году. При этом 24% обращаются к чату каждый день, 60% читают ИИ-сводки прямо в результатах поиска, а 51% - то есть чуть больше половины - не пользуются вообще ни разу
Само по себе число «49%» не выглядит катастрофой: почти половина страны хотя бы попробовала. Проблема начинается там, где эту цифру берут как доказательство того, что «агентами не пользуется никто»
Чат и агент - две разные вещи, и цифра про одно не говорит про другое
Вот здесь и происходит подмена, из-за которой тезис «никто не пользуется» звучит убедительнее, чем есть. Чат - это разговор, где ты пишешь одно сообщение и получаешь один ответ, как с человеком за соседним столом. Агент - это помощник, которому ты один раз объясняешь задачу целиком, а он сам проходит несколько шагов подряд без твоего участия на каждом из них, как курьер, которому дал адрес и деньги, а не диктуешь каждый поворот
Опрос Pew мерит именно первое - разговоры. Про второе - долю тех, кто доверяет агенту цепочку шагов - у него цифр нет вообще, потому что вопрос был не про это. Взять цифру про чаты и сделать вывод про агентов - это как посчитать, сколько людей умеет варить кофе, и сделать вывод, что никто не открывает собственную кофейню
Что происходит с агентами в крупном бизнесе
McKinsey ежегодно опрашивает тысячи руководителей по всему миру именно про использование ИИ, и в опросе 2026 года (1719 респондентов из 97 стран, опрос прошёл с 4 мая по 8 июня) есть цифра именно про агентов, а не про чаты
| Показатель | Значение по опросу McKinsey 2026 |
|---|---|
| Регулярно используют ИИ хотя бы в одной функции бизнеса | 88% |
| Масштабируют агентов хотя бы в одной функции (год назад было 27%) | 40% |
| Из них - крупные организации | двигаются заметно быстрее мелких |
| Малый бизнес, рост за год | почти не изменился, около 22% |
Таблица прокручивается вбок →
40% крупных организаций, масштабирующих агентов - это не «никто», это почти половина. Год назад было 27%, то есть рост за 12 месяцев внушительный. Картина честная: агентов реально внедряют, просто не равномерно - крупный бизнес идёт быстрее мелкого, и это две разные скорости, а не общий ноль
А что с провалом 95% корпоративных пилотов - это ведь тоже реальная цифра
Да, и это не противоречит McKinsey - это про другую стадию процесса. По отчёту исследовательской инициативы MIT NANDA, основанному на 150 интервью с руководителями, опросе 350 сотрудников и разборе 300 реальных внедрений, воронка выглядит так: 80% компаний пробуют инструменты ИИ, 60% доходят до оценки корпоративных решений, 20% запускают пилотный проект, и только 5% доводят пилот до продакшена с измеримым эффектом на прибыль
Воронка провала пилотов по MIT NANDA
- 80% пробуют компания тестирует инструмент ИИ хотя бы раз, без обязательств
- 60% оценивают смотрят на корпоративные решения серьёзнее, сравнивают варианты
- 20% запускают пилот внедряют инструмент в реальный рабочий процесс одного отдела
- 5% доходят до результата пилот превращается в постоянный инструмент с измеримым эффектом на прибыль
Почему провал пилота - это не страх людей и не плохие агенты
Ключевая деталь отчёта MIT NANDA - причина провала. Это не «люди боятся ИИ» и не «агенты плохо спроектированы», как утверждают некоторые пересказы этой темы. Причина - организационный разрыв: компании не умеют встраивать инструмент в СВОИ конкретные процессы. Универсальный чат хорошо работает для одного человека именно потому, что гибкий, а корпоративное внедрение спотыкается там, где инструмент нужно подстроить под чужой уже существующий workflow
Прогноз Gartner: рост и отмена проектов одновременно
Аналитическая компания Gartner идёт ещё дальше и прогнозирует, что больше 40% agentic-проектов будут отменены к 2027 году из-за роста издержек и неясной пользы для бизнеса. Но в том же прогнозе указано: сегодня агентов уже развернули 17% организаций, а больше 60% планируют развернуть в течение двух лет - тренд растущий, а не нулевой, просто с высокой долей неудачных попыток по дороге
| Показатель по прогнозу Gartner | Значение |
|---|---|
| Организации, уже развернувшие агентов сегодня | 17% |
| Планируют развернуть в течение двух лет | больше 60% |
| Проектов будет отменено к концу 2027 года | больше 40% |
| Причина отмены по Gartner | рост издержек, неясная бизнес-ценность, недостаточный контроль рисков |
Таблица прокручивается вбок →
Четыре организации (Pew, McKinsey, MIT NANDA, Gartner) смотрят на разные срезы одной картины, и свести их вместе полезно, чтобы не путать между собой
| Организация | Что измеряет | Ключевая цифра |
|---|---|---|
| Pew Research Center | использование чат-ботов людьми | 49% пробовали хотя бы раз |
| McKinsey | масштабирование агентов в бизнесе | 40% крупных организаций (было 27%) |
| MIT NANDA | доведение пилотов до результата | 5% доходят до измеримой прибыли |
| Gartner | судьба agentic-проектов к 2027 | больше 40% будет отменено, но 60% планируют внедрить |
Таблица прокручивается вбок →
Почему длинная задача разваливается чаще короткой
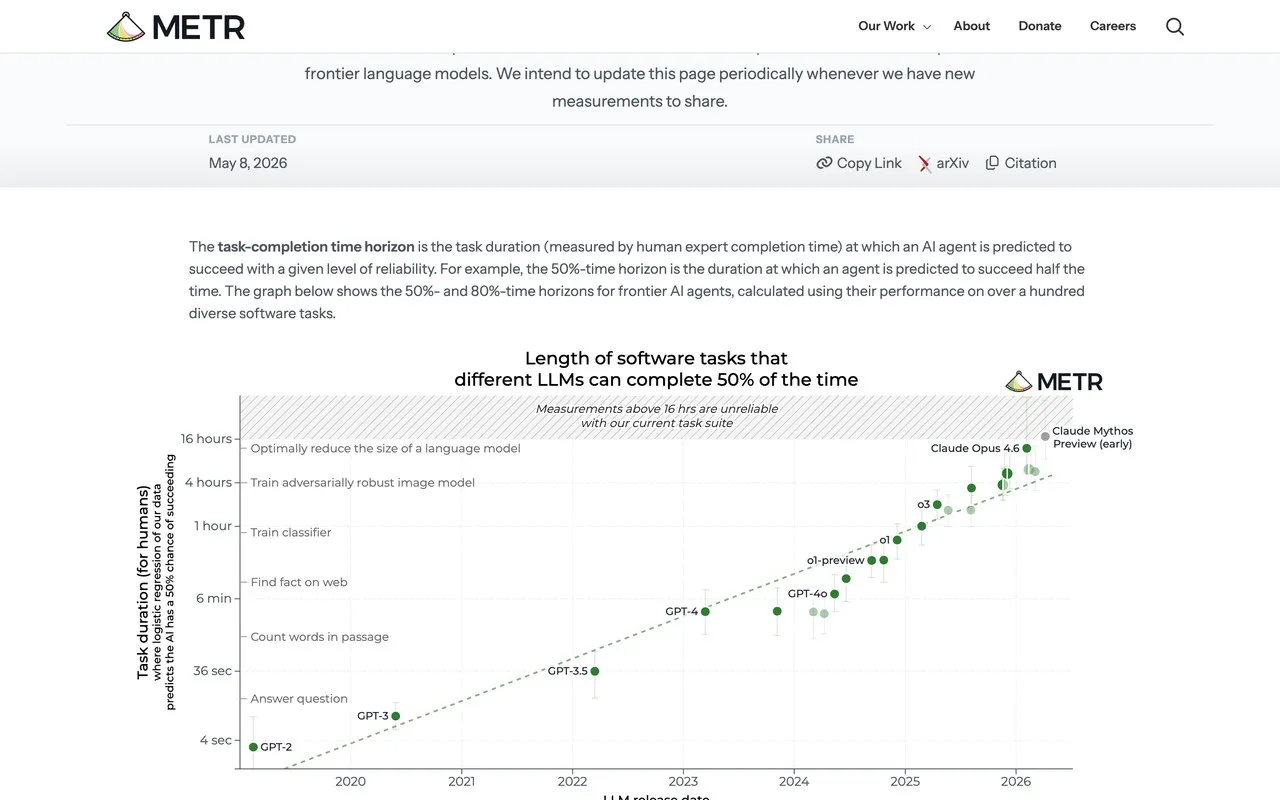
Здесь тезис «агенты не работают» перестаёт быть подменой понятий и становится честным техническим ограничением. У исследовательской организации METR есть прямой замер (график - на самом верху статьи): они называют его time horizon - длина задачи в часах человеческой работы, на которой модель справляется ровно в половине попыток
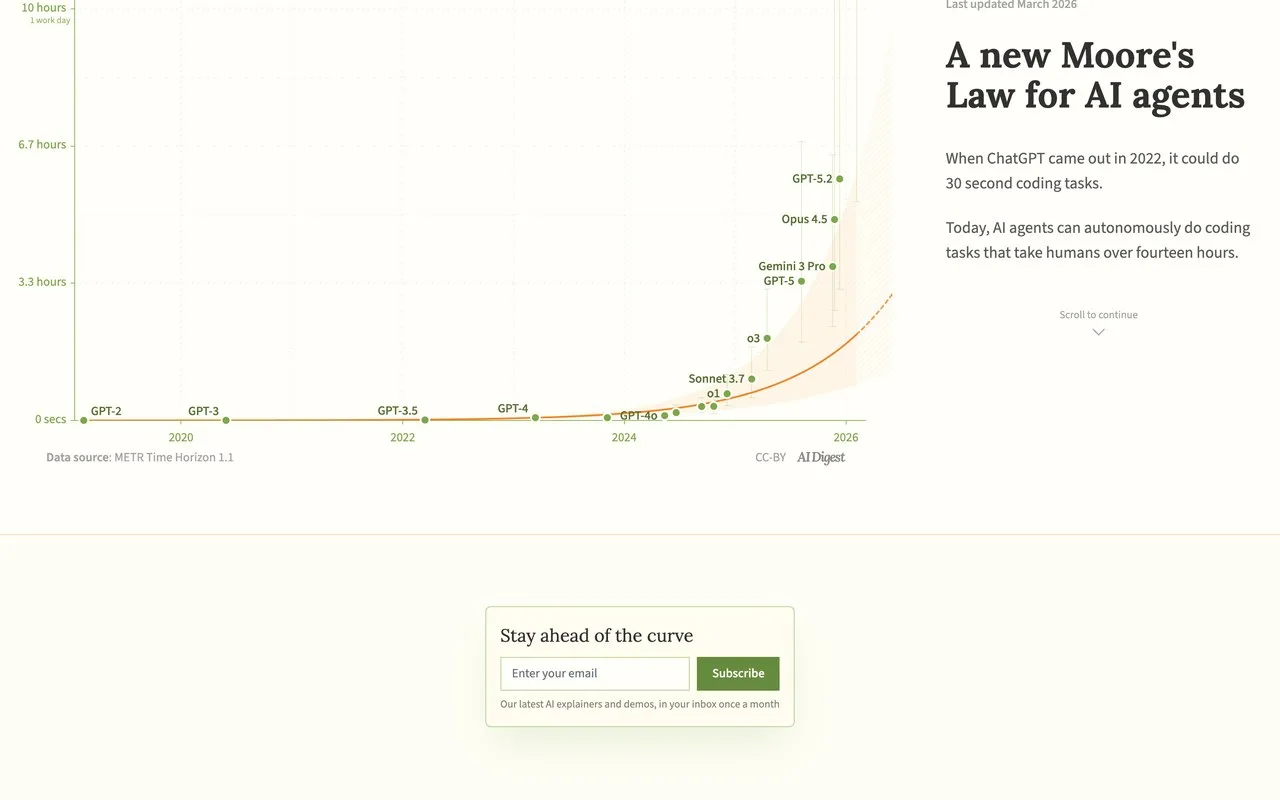
По последнему обновлению METR от 8 мая 2026 года самая способная модель на графике достигает планки около 14-16 часов - и сами исследователи прямо помечают на графике, что измерения выше 16 часов уже ненадёжны на их наборе задач. При этом планка растёт быстро: с 2019 по 2025 год она удваивалась примерно раз в 7 месяцев, а к 2024-2025 годам темп ускорился до удвоения раз в 4 месяца, по данным независимого разбора AI Digest на тех же измерениях METR
Дело не в том, что модель вдруг резко глупеет к вечеру пятого часа работы. Дело в том, как устроены длинные многошаговые задачи: каждый шаг несёт свой небольшой шанс мелкой ошибки, а ошибки внутри одной цепочки складываются, а не гасят друг друга. Если взять шаг с надёжностью 85% и увеличивать число шагов подряд, итоговый шанс полного успеха падает быстрее, чем кажется на глаз
| Число шагов подряд | Шанс пройти всю цепочку без единой ошибки |
|---|---|
| 1 шаг | 85% |
| 3 шага | 61% |
| 5 шагов | 44% |
| 10 шагов | 20% |
Таблица прокручивается вбок →
Отсюда и практический вывод: короткая задача с понятным результатом - хороший кандидат на агента уже сегодня, а длинная многошаговая цепочка без точек проверки - это по факту монетка, и чем длиннее цепочка, тем ближе итог к случайности
7 задач, которые я прогнал сам с секундомером
Вместо чужого списка я взял свои реальные рабочие папки и файлы и прогнал каждую задачу лично в своём Claude Code (полный разбор агентов внутри Claude Code - в гайде агенты для Claude Code), засекая время командой в терминале до и после каждого прогона. Это не пересказ чужой статьи - каждая цифра ниже получена мной лично сегодня
7 задач с реальным замером времени агента
- Разбор файлового завала прогнал по папке с 158 рабочими файлами - агент за 11 секунд нашёл, что 90,5% веса папки съедают старые резервные копии всего трёх файлов, у одного из них накопилось 41 версия. Руками через Finder на это ушло бы 15-20 минут кликов и сложения размеров в уме
- Выжимка структуры длинного документа документ на 2189 слов агент разобрал на 11 разделов и нашёл все числовые упоминания за 46 секунд. Прочитать документ целиком и выписать структуру самому - 10-15 минут
- Сравнение вариантов свёл 4 файла по весу и дате изменения в таблицу за 6 секунд. Открывать свойства каждого файла по очереди и сводить вручную - около 5 минут
- Разбор файлов по возрасту из тех же 158 файлов агент разложил их по трём периодам (сегодня, эта неделя, старше недели) меньше чем за секунду. Сортировать список в Finder и считать по периодам руками - около 10 минут
- Карточка статуса проекта агент проверил 439 рабочих папок и дал сводку за долю секунды: 429 полностью готовы, 10 в процессе. Открыть каждую из 439 папок и проверить содержимое руками физически нереально за разумное время
- Регулярный отчёт по свежим файлам агент собрал агрегат по 89 файлам за сутки (164 548 слов суммарно, среднее 1849 на файл) меньше чем за секунду. Открыть 89 файлов по одному и сложить количество слов - час и больше
- Поиск конкретных данных по множеству файлов из 100 файлов агент нашёл и отсортировал топ-5 по числовому полю меньше чем за секунду. Искать глазами число в каждом из 100 файлов и сортировать руками - 40-60 минут
Сколько именно времени экономит каждая из 7 задач
Свожу все семь прогонов в одну таблицу: сколько реально занял агент и сколько ушло бы руками
| Задача | Время агента | Время руками (моя оценка по типовой скорости) |
|---|---|---|
| Разбор файлового завала (158 файлов) | 11 секунд | 15-20 минут |
| Выжимка структуры документа (2189 слов) | 46 секунд | 10-15 минут |
| Сравнение 4 файлов по весу и дате | 6 секунд | около 5 минут |
| Разбор файлов по возрасту (158 файлов) | меньше секунды | около 10 минут |
| Карточка статуса (439 папок) | меньше секунды | час и больше |
| Регулярный отчёт (89 файлов) | меньше секунды | час и больше |
| Поиск данных (100 файлов) | меньше секунды | 40-60 минут |
Таблица прокручивается вбок →
Разброс экономии по семи задачам большой: от пяти минут на простом сравнении до часа и больше там, где ручной перебор сотен файлов физически утомителен настолько, что человек либо это не делает вообще, либо тратит на порядок больше времени, чем занимает у агента. Общее у всех семи задач одно: результат агента я проверил одним взглядом за секунды - таблица либо совпадает с реальностью файлов, либо нет, тут нечего перепроверять построчно. Более широкий список готовых задач для бизнеса, а не только для личных файлов, разобран в гайде какие задачи бизнеса отдать ИИ-агенту
Как понять, подходит ли ТВОЯ задача под агента
После цифр про adoption и своего прогона есть простой практический фильтр из трёх вопросов
Три вопроса перед тем, как отдать задачу агенту
- Сколько шагов подряд без твоей проверки чем короче цепочка, тем ближе шанс успеха к надёжности одного шага - длинная цепочка копит ошибки, а не усредняет их
- Можно ли проверить результат одним взглядом таблица либо совпадает с файлами на диске, либо нет - если проверка занимает столько же времени, сколько заняла бы сама работа руками, смысла в агенте нет
- Делаешь ли ты эту задачу больше одного раза разовая пятиминутная задача не окупает время на объяснение агенту - а вот регулярный отчёт или поиск по десяткам файлов окупается уже со второго раза
Задача, которая проходит все три вопроса - хороший кандидат уже сегодня. Задача, которая упирается в первый вопрос (много шагов подряд без проверки), не значит «агент не справится вообще» - значит, стоит разбить её на более короткие куски с точкой проверки между ними
Что делать, если задача не проходит фильтр
Разбить длинную цепочку на этапы с точкой проверки между ними - эта лесенка внедрения по уровням разобрана в отдельном гайде 5 уровней автоматизации на Claude
Если задача явно длиннее, чем модель тянет надёжно уже сегодня, вопрос «может ли нейросеть заменить тебя целиком» разбирается в соседней статье Может ли нейросеть работать за тебя: 3 признака и правда 2026 - там подробный разбор именно этой границы присмотра по данным тех же исследований
А если после ответа «да, моя задача подходит» ты решишь собрать себе такого помощника с нуля - гайд ИИ-агенты: что это простыми словами и как собрать своего разберёт шаги сборки, а не только теорию. Похожая, но более широкая конструкция - когда одному агенту доверяют сразу несколько ролей - разобрана в гайде Штат ИИ-агентов из одного ассистента
Что проверить перед тем, как дать агенту доступ
Прежде чем давать агенту доступ к почте, документам или файлам, стоит прочитать отдельный разбор рисков - Безопасность автономных ИИ-агентов: 4 риска 2026 года, там же разобрано, какие права выдавать постепенно, а какие не выдавать вообще. И отдельная ловушка, о которой стоит знать заранее - агент может ответить не на тот вопрос, который ты задал, разбор шести причин собран в гайде Claude делает не то, что просил
Масштаб задач, которые вообще можно доверить одному человеку с набором агентов, разбирает статья Один человек с ИИ вместо компании - там же честно про то, где присмотр всё равно нужен по частям
Полный список гайдов про агентов и автоматизацию на этом же сайте собран в разделе скиллы и агенты
Что почитать дальше на этом же сайте
- ИИ-агенты: что это простыми словами и как собрать своего - если решишь собрать себе такого помощника после прочтения этой статьи
- Может ли нейросеть работать за тебя: 3 признака и правда 2026 - тот же корпус фактов METR под другим углом: три признака задачи, которую можно доверить целиком
- Какие задачи бизнеса отдать ИИ-агенту: 3 зоны автономности - более широкий список задач для бизнеса, не только для личных файлов
- 5 уровней автоматизации на Claude - лесенка внедрения для того, кто уже решил разбить длинную задачу на куски
- Штат ИИ-агентов из одного ассистента - когда одной задачи мало и нужно несколько ролей сразу
- Безопасность автономных ИИ-агентов: 4 риска 2026 года - что проверить перед тем, как дать агенту действовать без присмотра
- Агент говорит «готово»: 4 шага, чтобы доделать до конца - живая ловушка, когда агент отчитался, но задача не решена
- Claude делает не то, что просил: 6 причин и как исправить - соседняя ловушка, когда агент ответил мимо задачи целиком
- Один человек с ИИ вместо компании: почему это работает - что меняется в масштабе задач, когда присмотр всё же нужен по частям
- Агенты для Claude Code: полный разбор для новичка - как устроены агенты, которых я гонял в семи задачах этой статьи
- Скиллы и агенты - полный список гайдов по теме на сайте
Источники
Все страницы проверены прямым запросом 5 сентября 2026 года, у METR, AI Digest и Pew Research Center дополнительно сняты кадры живым Playwright headless. Цифры McKinsey и Gartner взяты из согласующихся вторичных пересказов деловых изданий - прямые первоисточники блокируют автоматический запрос (см. research.md, раздел 6)
- Pew Research Center: Americans and AI 2026 - опрос 5119 взрослых США об использовании ИИ-чат-ботов, 49% пользователей
- METR: Task-Completion Time Horizons of Frontier AI Models - прямой замер 50%-time horizon фронтирных моделей, обновление 8 мая 2026 года
- AI Digest: A new Moore's Law for AI agents - независимый разбор темпа роста time horizon на данных METR, обновление март 2026 года
- McKinsey: The State of AI - Global Survey 2026 - опрос 1719 респондентов из 97 стран, доля организаций, масштабирующих агентов
- Gartner: пресс-релиз о прогнозе отмены 40% agentic AI проектов - прогноз на 2027 год и текущая доля развёрнутых агентов
Памятка: ИИ-агенты и adoption gap
Шесть строк, которые закрывают суть статьи и что с этим делать
Сохрани себе
- Pew (49% используют чат-боты) и adoption агентов - разные измерения: чат отвечает на вопрос, агент проходит цепочку шагов сам
- McKinsey 2026: доля крупных организаций, масштабирующих агентов, выросла с 27% до 40% за год - тренд растущий, не нулевой
- MIT NANDA: 95% корпоративных пилотов не доходят до измеримого эффекта, причина - организационный разрыв, не страх людей и не плохие модели
- METR: топовая модель тянет задачу около 14-16 часов работы, но лишь в половине попыток - длина цепочки шагов главный предсказатель провала
- 7 своих задач с секундомером: от 5 минут экономии на простом сравнении до часа+ на переборе сотен файлов
- Фильтр из трёх вопросов перед тем, как отдать задачу агенту: сколько шагов, проверяется ли одним взглядом, делаешь ли больше раза
Порог входа
Список задач прочитал бесплатно, разбор своей рутины - тоже
Всё, что нужно, чтобы честно ответить себе на вопрос «стоит ли заводить агента под мою задачу», ты только что прочитал бесплатно: живые цифры Pew, McKinsey, MIT и METR, семь своих задач с секундомером и фильтр из трёх вопросов. Следующий шаг - разобрать твою конкретную рутину за три дня Лагеря - тоже стоит ровно ноль
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Значит, ИИ-агентами правда почти никто не пользуется?
Нет, если говорить о крупном бизнесе - по опросу McKinsey 40% таких организаций уже масштабируют агентов, и это выросло с 27% год назад. Тезис «никто не пользуется» получается из подмены: берут опрос про чат-боты (Pew, 49%) и делают вывод про агентов, хотя это разные вещи с разным уровнем внедрения
Тогда откуда цифра про 95% провалов?
Это отдельное честное измерение MIT NANDA именно про корпоративные ПИЛОТЫ - и оно не противоречит McKinsey: одно измеряет долю пилотов, доведённых до измеримой прибыли (5%), другое измеряет долю крупных компаний, масштабирующих агентов хоть в одной функции (40%). Разные стадии одной воронки, а не два взаимоисключающих факта
Как выбрать свою первую задачу для агента, если хочется начать сегодня
Прогони фильтр из трёх вопросов раздела выше на любой рутинной задаче: сколько шагов подряд, можно ли проверить результат одним взглядом, делаешь ли ты это больше одного раза. Из моих семи задач проще всего начать с той, что похожа на твою - разбор файлов, выжимка документа или регулярный отчёт подходят почти всем
Почему у меня агент может ошибаться даже на короткой задаче
Отдельная ловушка - агент может честно написать «готово», хотя задача решена не так, как нужно. Это не редкость и не признак того, что задача была слишком длинной: полный разбор с проверочными шагами - в гайде агент говорит «готово»
Если задача явно длиннее, чем агент тянет надёжно, что делать
Разбить на этапы с точками проверки между ними - тот же принцип, что держит фильтр из трёх вопросов этой статьи. Готовую лесенку такого разбиения смотри в гайде 5 уровней автоматизации, а более глубокий разбор именно границы автономности - в статье может ли нейросеть работать за тебя