Автономность ИИ · вердикт 2026
Может ли нейросеть работать за тебя: 3 признака и правда 2026
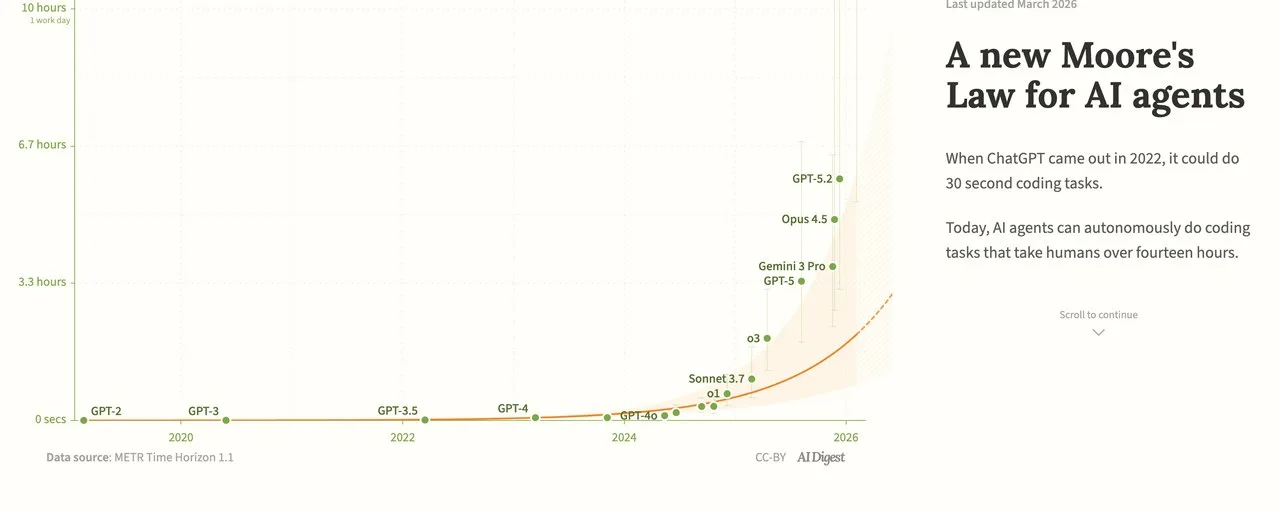
Полтора года назад нейросеть тянула задачу на 30 секунд человеческой работы. Сегодня, по замеру исследовательской организации METR (обновление 8 мая 2026 года), самая свежая модель справляется с задачей длиной больше 14 часов человеческой работы - но справляется лишь в половине попыток, и это ключевая деталь, которую реклама автоматизации обычно не договаривает
К концу статьи будет ясно: что из обещаний «нейросеть работает за тебя» подтверждено живыми замерами исследователей, а что остаётся рекламной формулировкой без цифры за ней, где реально проходит граница присмотра для задач 2026 года, и по каким трём признакам заранее понять, потянет ли нейросеть именно твою задачу без тебя рядом. Если решишь после этого собрать себе такого помощника - отдельный гайд ИИ-агенты: что это простыми словами и как собрать своего разберёт это по шагам
Проверь одну вещь у своей задачи: сколько шагов подряд без твоей проверки она требует. Одна-две минуты работы нейросеть тянет почти всегда, а вот задачу на несколько часов подряд без единой сверки с тобой не тянет ни одна модель 2026 года - слишком высокий шанс, что мелкая ошибка на середине пути испортит весь результат
Откуда вообще взялось обещание «нейросеть заменит тебя на работе»
Реклама сервисов автоматизации звучит одинаково у всех: подключи агента, распишись под задачей, а дальше он сам. Формулировка не выдумана из воздуха - у неё есть реальное основание, просто урезанное до одной цифры без контекста
Компания Anthropic в собственном отчёте об использовании прямо пишет, что всё больше сессий с Claude состоят не из короткого диалога, а из «длинных агентных задач» - то есть модель правда стала брать на себя больше шагов подряд, чем ещё год назад (полный разбор, что такое агенты Claude и как они устроены внутри, есть в отдельном гайде агенты для Claude Code). Проблема рекламной версии этого факта не в том, что она врёт про направление тренда - тренд реальный. Проблема в том, что она молчит про два числа, без которых обещание нельзя проверить: сколько именно шагов подряд модель тянет и с какой вероятностью не срывается на середине пути
Сколько часов подряд нейросеть правда тянет без тебя
У исследовательской организации METR есть прямой замер этого вопроса, и он не про мнение, а про счётчик. Они называют его time horizon - протяжённость задачи, измеренная в часах человеческой работы, на которой модель справляется в половине попыток
Как читать цифру time horizon
- Что мерят берут больше сотни разных программистских задач, где заранее известно, сколько времени тратит на них живой человек-эксперт
- Как считают смотрят, на какой длине задачи модель успевает ровно в половине попыток - это и называется 50%-time horizon
- Что это значит для тебя если твоя задача длиннее этой планки, шанс, что модель доведёт её до конца без единой ошибки, уже ниже 50% - это не мнение автора статьи, а прямое определение метрики
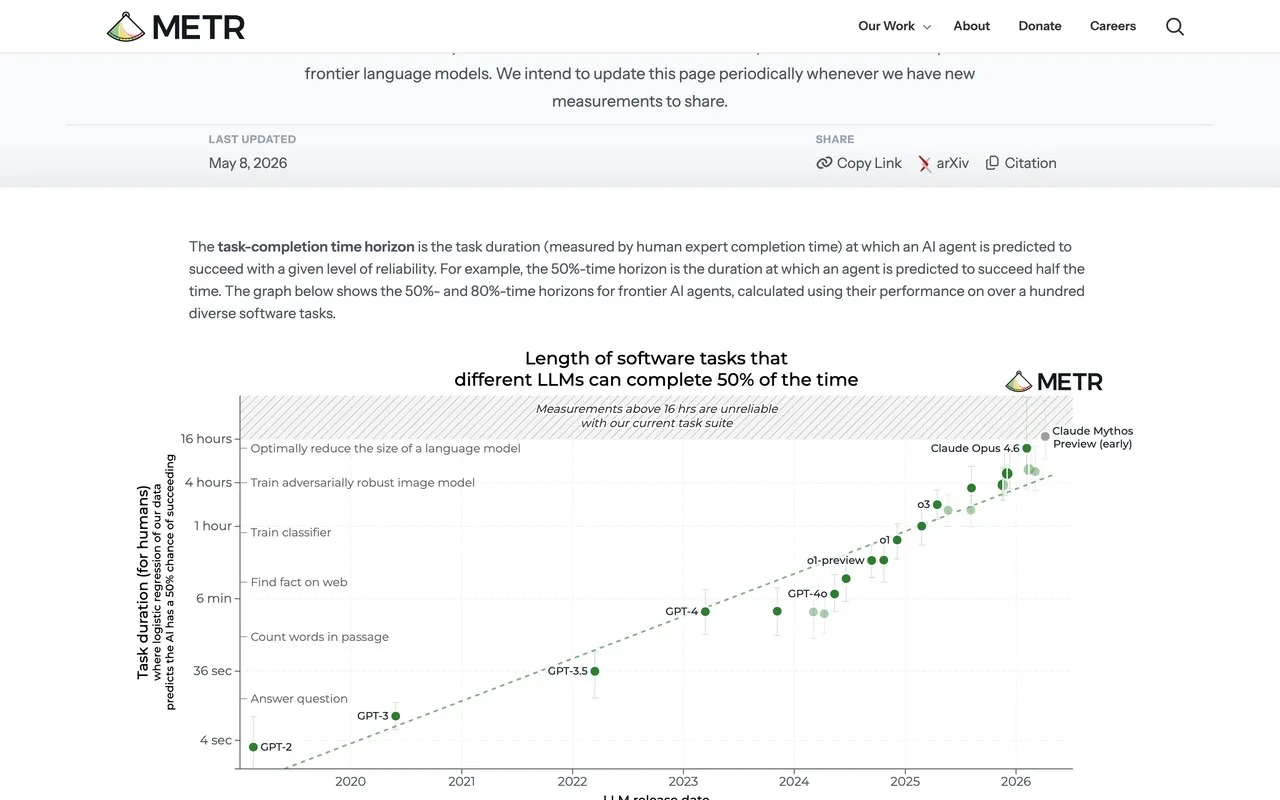
По последнему обновлению METR от 8 мая 2026 года, самая способная модель на графике достигает планки около 14-16 часов человеческой работы - и сами исследователи прямо помечают на графике, что измерения выше 16 часов уже ненадёжны на их наборе задач. Скорость роста этой планки при этом впечатляющая: с 2019 по 2025 год она удваивалась примерно раз в 7 месяцев, а к 2024-2025 годам темп ускорился до удвоения раз в 4 месяца, по данным независимого разбора AI Digest на тех же измерениях METR
Здесь и прячется главное расхождение между рекламой и фактом. Реклама читает эту цифру как «нейросеть тянет 14 часов работы» и на этом останавливается. Факт звучит иначе: на задаче такой длины модель проваливается в половине случаев. Для короткой задачи (пара минут) успех почти гарантирован, а вот доверить агенту рабочий день целиком без единой проверки - это по факту монетка
Куда идёт планка дальше: прогноз на несколько лет вперёд
Раз планка растёт по предсказуемой кривой, у неё есть и прогноз на будущее - AI Digest прямо экстраполирует тот же темп удвоения на ближайшие годы. Прогноз не означает, что планка обязательно дойдёт до этих значений точно в срок: экспонента может замедлиться, а может и ускориться, сами авторы разбора называют это именно продолжением тренда, а не гарантией
| Год | Планка time horizon по прогнозу | Что это по-человечески |
|---|---|---|
| 2027 | 8 часов | один полный рабочий день |
| 2028 | 40 часов | одна полная рабочая неделя |
| 2029 | 167 часов | один полный рабочий месяц |
Таблица прокручивается вбок →
Даже если прогноз сбудется буквально, смысл цифры остаётся тем же самым, что и сегодня у 14 часов: это планка, на которой модель справляется в ПОЛОВИНЕ попыток, а не гарантированно. Растущая планка не отменяет монетку на её собственной границе - она просто отодвигает эту границу дальше
Почему длинная задача разваливается чаще короткой
Дело не в том, что модель вдруг резко глупеет к вечеру пятого часа работы. Дело в том, как устроены длинные многошаговые задачи в принципе: каждый шаг имеет свой небольшой шанс мелкой ошибки, а ошибки внутри одной цепочки складываются, а не гасят друг друга (базовый рабочий цикл из шести шагов, на котором строится любая такая цепочка, разобран в гайде Claude: рабочий цикл для новичка)
Представь задачу из десяти последовательных шагов, где каждый отдельный шаг модель делает верно в 85 случаях из 100 - на первый взгляд отличный результат для одного шага. Но чтобы вся цепочка из десяти шагов прошла без единой осечки, нужно, чтобы все десять сработали подряд - а вероятность этого события намного ниже, чем 85%: перемножение шансов по цепочке уводит итоговый результат в район 20% успеха на весь десятишаговый путь целиком
Как считается эта арифметика на разной длине цепочки
Правило простое: вероятности отдельных шагов перемножаются, а не усредняются. Если взять тот же самый шаг с надёжностью 85% и просто увеличивать число шагов подряд, итоговый шанс полного успеха падает быстрее, чем кажется на глаз
| Число шагов подряд | Шанс пройти всю цепочку без единой ошибки |
|---|---|
| 1 шаг | 85% |
| 3 шага | 61% |
| 5 шагов | 44% |
| 10 шагов | 20% |
| 20 шагов | 4% |
Таблица прокручивается вбок →
Отсюда и вытекает практический вывод раздела про три признака ниже: чем короче автономный прогон, тем ближе итоговый шанс успеха к надёжности одного шага. Длинная цепочка не прощает даже небольшую вероятность ошибки на каждом отдельном шаге - она копит её
Живой пример: почему 1600 попыток закончились в основном провалом
Исследователи из Беркли прогнали больше 1600 записанных попыток семи разных мульти-агентных систем и разложили каждый провал на причину. Итог по всей выборке жёсткий: от 41 до почти 87 процентов попыток заканчивались неудачей на стандартных проверочных заданиях, в зависимости от конкретной системы
| Причина провала | Доля всех отказов |
|---|---|
| Задачу изначально плохо поставили или систему плохо спроектировали | 41,8% |
| Агенты внутри системы не поняли друг друга при передаче работы | 36,9% |
| Результат никто толком не проверил перед сдачей | 21,3% |
Таблица прокручивается вбок →
Самая частая причина провала - даже не сбой модели в моменте, а изначально нечёткая постановка задачи и слабое разделение ролей между агентами. Это прямое опровержение самой рекламной версии тезиса «дальше он сам»: если задачу изначально сформулировали расплывчато, автономность не чинит эту проблему, а усиливает - ошибка просто разгоняется дальше по цепочке шагов, пока кто-то её не заметит (полный разбор рисков автономных агентов и как их снижать - в гайде безопасность автономных ИИ-агентов)
Какие именно системы проверяли и на чём
Исследователи из Беркли не брали одну систему - в выборку попали семь разных мульти-агентных систем, каждая со своим бенчмарком и своей моделью внутри. Это важно: провалы - не баг одного конкретного продукта, а закономерность, которая повторяется у разных команд и разных архитектур
| Система | Проверочное задание | Модель внутри |
|---|---|---|
| ChatDev | ProgramDev | GPT-4o |
| MetaGPT | ProgramDev | GPT-4o |
| HyperAgent | SWE-Bench Lite | Claude-3.7-Sonnet |
| AppWorld | Test-C | GPT-4o |
| AG2 (MathChat) | GSM-Plus | GPT-4 |
| Magentic-One | GAIA | GPT-4o |
| OpenManus | ProgramDev | GPT-4o |
Таблица прокручивается вбок →
Разброс моделей внутри систем говорит о том же, о чём и общий итог: дело не в конкретной модели, которую взяли за основу, а в том, как вообще устроена передача задачи между несколькими агентами внутри одной системы
Что значит «автоматизация» у самого вендора, а не в рекламе
Компания Anthropic - та самая, что делает Claude - в собственном отчёте об использовании прямо разводит два разных режима работы с нейросетью, и определение стоит прочитать буквально, а не по пересказу маркетинга
Разговор считается «автоматизацией» тогда, когда модель выполняет задачу «с минимальным участием пользователя или вовсе без него» - и в отчёте это конкретно означает короткую прямую команду («переведи этот документ») или короткую петлю правок («сделай письмо более неформальным»). Второй режим - «augmentation», усиление: человек и модель работают вместе над задачей, обмениваясь репликами дольше одной команды
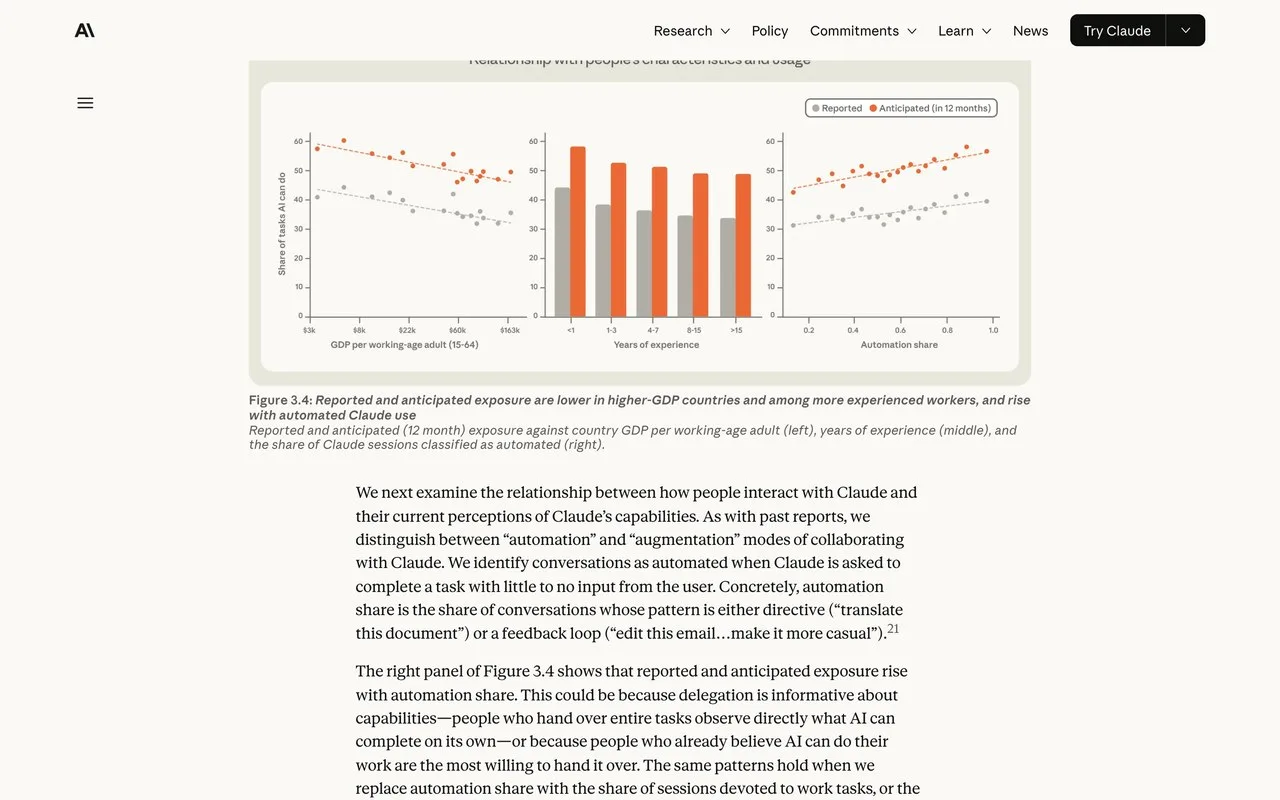
Здесь и находится вторая скрытая деталь рекламы: слово «автоматизация» у вендора значит «модель сделала шаг с минимальным вводом от тебя», а вовсе не «отпустил и полностью забыл на весь день». В том же отчёте виден дополнительный живой факт: доля задач, которую люди СЧИТАЮТ доступной для ИИ, в среднем на 10 процентных пунктов ниже в странах с высоким доходом, чем в странах с низким. Восприятие «нейросеть заменит меня» и реальная граница автономности - это две разные шкалы, и они расходятся ещё до всякой рекламы
Где проходит граница: три признака задачи, которую можно доверить целиком
После всех цифр выше есть практический вопрос - как заранее понять, потянет ли нейросеть именно твою задачу без присмотра. Три признака вместе дают достаточно надёжный фильтр
Три признака задачи, которую можно отдать без постоянной проверки
- Короткая по времени минуты, максимум десятки минут человеческой работы - на такой длине шанс полного успеха у моделей 2026 года ощутимо выше, чем на многочасовой
- Обратимая если результат можно откатить, переделать или проверить одним взглядом до того, как он куда-то уйдёт (письмо, платёж, публикация) - цена ошибки низкая
- С чётким критерием готово / не готово задача, где легко проверить результат одним взглядом («файл появился», «сумма сошлась»), а не задача, где «готово» - вопрос вкуса или контекста, который знаешь только ты
Задача, которая проходит все три признака сразу, - хороший кандидат на автономный прогон без твоей ежеминутной проверки. Задача, которая проваливает хотя бы один признак, требует присмотра: не значит «нейросеть не справится вообще», значит «не оставляй её одну на всю длину, проверяй по частям»
Что делать, если задача не проходит эти три признака
Не выбрасывать идею целиком, а сузить кусок. Длинную многошаговую работу можно разбить на несколько коротких прогонов с твоей проверкой между ними - это не откат к ручному труду, а способ снизить длину каждого отдельного автономного шага до той зоны, где модель ошибается реже
Практический приём: раздели задачу на этапы так, чтобы после каждого этапа появлялся артефакт, который ты можешь проверить одним взглядом за минуту - файл, черновик, промежуточный расчёт. Чем чаще в цепочке появляется такая точка проверки, тем меньше шанс, что мелкая ошибка ранних шагов доедет незамеченной до самого конца и испортит весь результат целиком. Готовую лесенку уровней, от «правит текст под присмотром» до «делает цепочку задач сама», разбирает отдельный гайд 5 уровней автоматизации на Claude
Где нейросеть реально ошибается, даже когда кажется, что закончила
Отдельная ловушка - модель может честно написать «готово», хотя задача не решена или решена не так, как нужно. Это не выдумка и не редкость: у меня есть отдельный разбор именно этого случая с конкретной проверочной последовательностью из четырёх шагов - агент говорит «готово»: 4 шага, чтобы доделать до конца. Похожий, но не тождественный случай - когда модель формально ответила, но ответ мимо задачи целиком, разбор шести причин и правок собран в гайде Claude делает не то, что просил
Связь с этой статьёй прямая: слово «готово» от модели не отменяет третий признак из раздела выше - чёткую проверку результата тобой. Даже короткая обратимая задача с понятным критерием готовности всё равно нуждается в одном взгляде на результат перед тем, как считать её закрытой
Полный список гайдов про нейросети и инструменты на этом же сайте собран в разделе нейросети и инструменты
Что почитать дальше на этом же сайте
- ИИ-агенты: что это простыми словами и как собрать своего - если после вердикта решишь собрать себе такого помощника
- Агент говорит «готово»: 4 шага, чтобы доделать до конца - живая проверка результата, когда модель уже отчиталась
- 5 уровней автоматизации на Claude - лесенка внедрения для того, кто уже решил двигаться дальше вердикта
- Нейросеть для работы: 5 рабочих задач без VPN за день - конкретные задачи, где нейросеть помогает тебе, а не работает вместо тебя
- Штат ИИ-агентов из одного ассистента: как это устроено - когда одной автономной задачи мало и нужно несколько ролей сразу
- Безопасность автономных ИИ-агентов: 4 риска 2026 года - что проверить перед тем, как дать агенту действовать без присмотра
- Агенты для Claude Code: полный разбор для новичка - как устроены агентные задачи, с которыми сравнивался вердикт этой статьи
- Claude делает не то, что просил: 6 причин и как исправить - соседняя ловушка, когда модель ответила мимо задачи целиком
- Один человек с ИИ вместо компании: почему это работает - что меняется в масштабе задач, когда присмотр всё же нужен по частям
- Нейросети и инструменты - полный список гайдов по теме на сайте
Источники
Все страницы проверены прямым запросом 4 сентября 2026 года, у METR, AI Digest и Anthropic дополнительно сняты кадры живым Playwright headless
- METR: Task-Completion Time Horizons of Frontier AI Models - прямой замер 50%-time horizon фронтирных моделей, обновление 8 мая 2026 года
- AI Digest: A new Moore's Law for AI agents - независимый разбор темпа роста time horizon на данных METR, обновление март 2026 года
- Cemri et al., Why Do Multi-Agent LLM Systems Fail? (MAST) - разбор 1600+ трасс выполнения на семи мульти-агентных фреймворках, три класса причин отказа
- Anthropic: Anthropic Economic Index report - Cadences - определение режимов automation/augmentation и связь восприятия автономности с доходом страны
- Kwa et al., Measuring AI Ability to Complete Long Software Tasks - научная методика time horizon, на неё ссылается сама страница METR, откуда взят способ подсчёта 50%-планки
Памятка: может ли нейросеть работать за тебя
Шесть строк, которые закрывают суть статьи и что с этим делать
Сохрани себе
- METR (8 мая 2026): топовая модель тянет задачу длиной около 14-16 часов человеческой работы, но справляется лишь в половине попыток
- Скорость роста этой планки удваивалась каждые 7 месяцев (2019-2025), затем ускорилась до 4 месяцев (2024-2025)
- MAST-исследование Berkeley: 41-87% провалов мульти-агентных систем на стандартных задачах, чаще всего из-за нечёткой постановки задачи, а не сбоя модели в моменте
- Anthropic называет «автоматизацией» короткую команду или короткую петлю правок с минимальным вводом от тебя - не «отпустил на весь день»
- Три признака задачи под автономный прогон - короткая, обратимая, с чётким критерием готовности
- Не проходит признаки - не отказ от идеи, а разбивка на этапы с твоей проверкой между ними
Порог входа
Вердикт прочитал бесплатно, разбор своей задачи - тоже
Всё, что нужно, чтобы честно ответить себе на вопрос «может ли нейросеть работать за меня», ты только что прочитал бесплатно: живые цифры METR и Berkeley, определение автоматизации от самого вендора и три признака задачи под автономный прогон. Следующий шаг - разобрать твою конкретную задачу за три дня Лагеря - тоже стоит ровно ноль
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Может ли нейросеть работать за тебя полностью, без единой проверки?
На задачах в пару минут - почти всегда да, судя по замерам METR. На задачах длиннее нескольких часов - нет, и это не оценочное мнение: сама метрика time horizon прямо означает, что на такой длине модель проваливает попытку примерно в половине случаев. Граница проходит по длине задачи и числу шагов, а не по общему ощущению «модели стали умнее»
Почему тогда реклама сервисов автоматизации звучит так уверенно?
Потому что берёт верхнюю границу возможностей («14 часов работы») и опускает вторую половину факта - вероятность успеха на этой границе. METR прямо публикует обе цифры вместе, реклама обычно берёт только первую
Если агент часто ошибается на длинных задачах, значит, автономность - это миф?
Нет, и дело не в мифе, а в масштабе задачи. На короткой обратимой задаче с понятным критерием готовности автономность работает предсказуемо хорошо уже сегодня. Миф - это конкретно формулировка «подключи и забудь про любую задачу», а не сам факт растущей автономности
Что делать, если моя рабочая задача явно длиннее, чем модель тянет надёжно?
Разбить на этапы с точками проверки между ними, как описано в разделе про три признака. Это не откат к ручной работе целиком, а способ держать длину каждого отдельного автономного шага в зоне, где модель ошибается реже. Готовую лесенку такого разбиения для Claude смотри в гайде 5 уровней автоматизации
Чем это отличается от вопроса «агент сказал готово, а не готово»?
Это соседний, но другой вопрос. Здесь статья про заранее оцениваемую вероятность успеха по длине задачи. Тот вопрос - про то, что происходит уже ПОСЛЕ прогона, когда модель формально отчиталась о завершении, но результат не соответствует задаче. Полный разбор с проверочными шагами - в отдельном гайде агент говорит «готово»