Разбор отчёта Anthropic · факты против заголовков
Claude учит сам себя: 9 фактов из отчёта Anthropic 2026 года
28 августа 2026 года Anthropic опубликовала исследование «Automated Researchers Can Mitigate Well-Characterized Alignment Failures» - и по сети тут же разошлись заголовки про «самоулучшающийся ИИ». Я прочитал сам документ и карточку компании на anthropic.com, а не пересказ пересказа, и слово «самоулучшающийся» подходит тому, что там описано, куда меньше, чем кажется на первый взгляд
К концу статьи у тебя будет: точные цифры из отчёта, разбор того, что ИИ-агент реально сделал и чего не сделал, и отдельно - список чужих цифр, которые в документе не находятся вообще. Средний прогресс - после раздела с цитатой отчёта у тебя уже будет ответ на главный вопрос, дальше идёт разбор экономики эксперимента и честных ограничений
Если тебе интересно, чем этот отчёт отличается от другого свежего документа Anthropic про скрытую модель компании, я отдельно разобрал его тоже - там речь не про самоулучшение, а про то, какая модель у компании работает только внутри и почему
Открой официальный пост Anthropic «Automated Researchers Can Mitigate Well-Characterized Alignment Failures» от 28 августа 2026 - там прямым текстом сказано, что автоматические агенты только чинят уже названные человеком проблемы безопасности, а не выбирают себе задачи сами. Дальше в статье - какие числа из пересказов подтверждаются документом, а какие нет
Что произошло на самом деле: разбор источника, а не пересказ
Тема разошлась по блогам под заголовками вида «Claude учит сам себя», но большинство таких статей строится на пересказе пересказа - похожий разбор устройства чужих источников я делал и для того, как нейросеть вообще пишет отчёт по документу. Я поднял оба официальных адреса темы и прочитал их сам, страница за страницей, тем же способом, каким ChatGPT сам выбирает источники для ответа - только на этот раз читал руками, а не доверял чужому пересказу
Первый адрес - технический пост на alignment.anthropic.com, авторы Chen Yueh-Han (программа стажировки Anthropic Fellows), Jiaxin Wen и Jan Hendrik Kirchner, дата - август 2026. Второй адрес - карточка на основном сайте anthropic.com с точной датой публикации: 28 августа 2026. Вот сама карточка с этой датой:
В открывающем абзаце (tl;dr) документ сам формулирует, что именно проверялось:
«We study whether automated alignment researchers (AARs) can post-train to mitigate alignment failures by proposing training methods and data to simultaneously optimize multiple safety benchmarks, while largely preserving general capability» - мы проверяем, могут ли автоматические исследователи выравнивания дообучать модели так, чтобы устранять сбои безопасности, одновременно улучшая сразу несколько показателей и почти не теряя в общих способностях
Переводя на простой язык: команда собрала ИИ-агента (назвали его AAR - automated alignment researcher), поставила ему конкретную, уже известную проблему безопасности и спросила, сможет ли он сам найти способ её исправить - методом проб, чтения литературы и обучения на данных, которые он же сам придумывает. Это близко к тому, как устроены агенты для Claude Code в целом: цель и границы задачи ставит человек, а перебор вариантов внутри этих границ агент делает сам
Два разных эксперимента в одном отчёте - и донор их путает
Здесь и начинается главная путаница большинства пересказов. В отчёте на самом деле ДВА разных эксперимента, и у них разные масштабы, разные модели и разные результаты
Первый эксперимент - десять типовых сбоев безопасности (среди них - согласие с неверным мнением пользователя, уязвимость к обманным запросам, склонность скрывать свою неуверенность) на пяти небольших открытых моделях: Qwen3.5-2B, Phi-4-mini, Llama-3.2-3B, Gemma-2-2B, Olmo-3-7B. Для сравнения позвали 28 человек с опытом работы в области безопасности ИИ от года (в среднем 2,5 года), и дали им до восьми часов на разработку методов для тех же самых десяти проблем. Кстати, о моделях: если интересно, чем вообще одна модель отличается от другой, у меня есть отдельный разбор различий Claude и ChatGPT по задачам и цене и сравнение GPT-5.6 против Claude Fable 5
Результат отчёт формулирует так:
«On all seven alignment failures where humans proposed ideas, the best AAR method closes more of the safety headroom than the best human idea for that failure» - на всех семи сбоях, где люди вообще предложили идею, лучший метод ИИ-агента закрывает больше разрыва безопасности, чем лучшая человеческая идея по этому же сбою
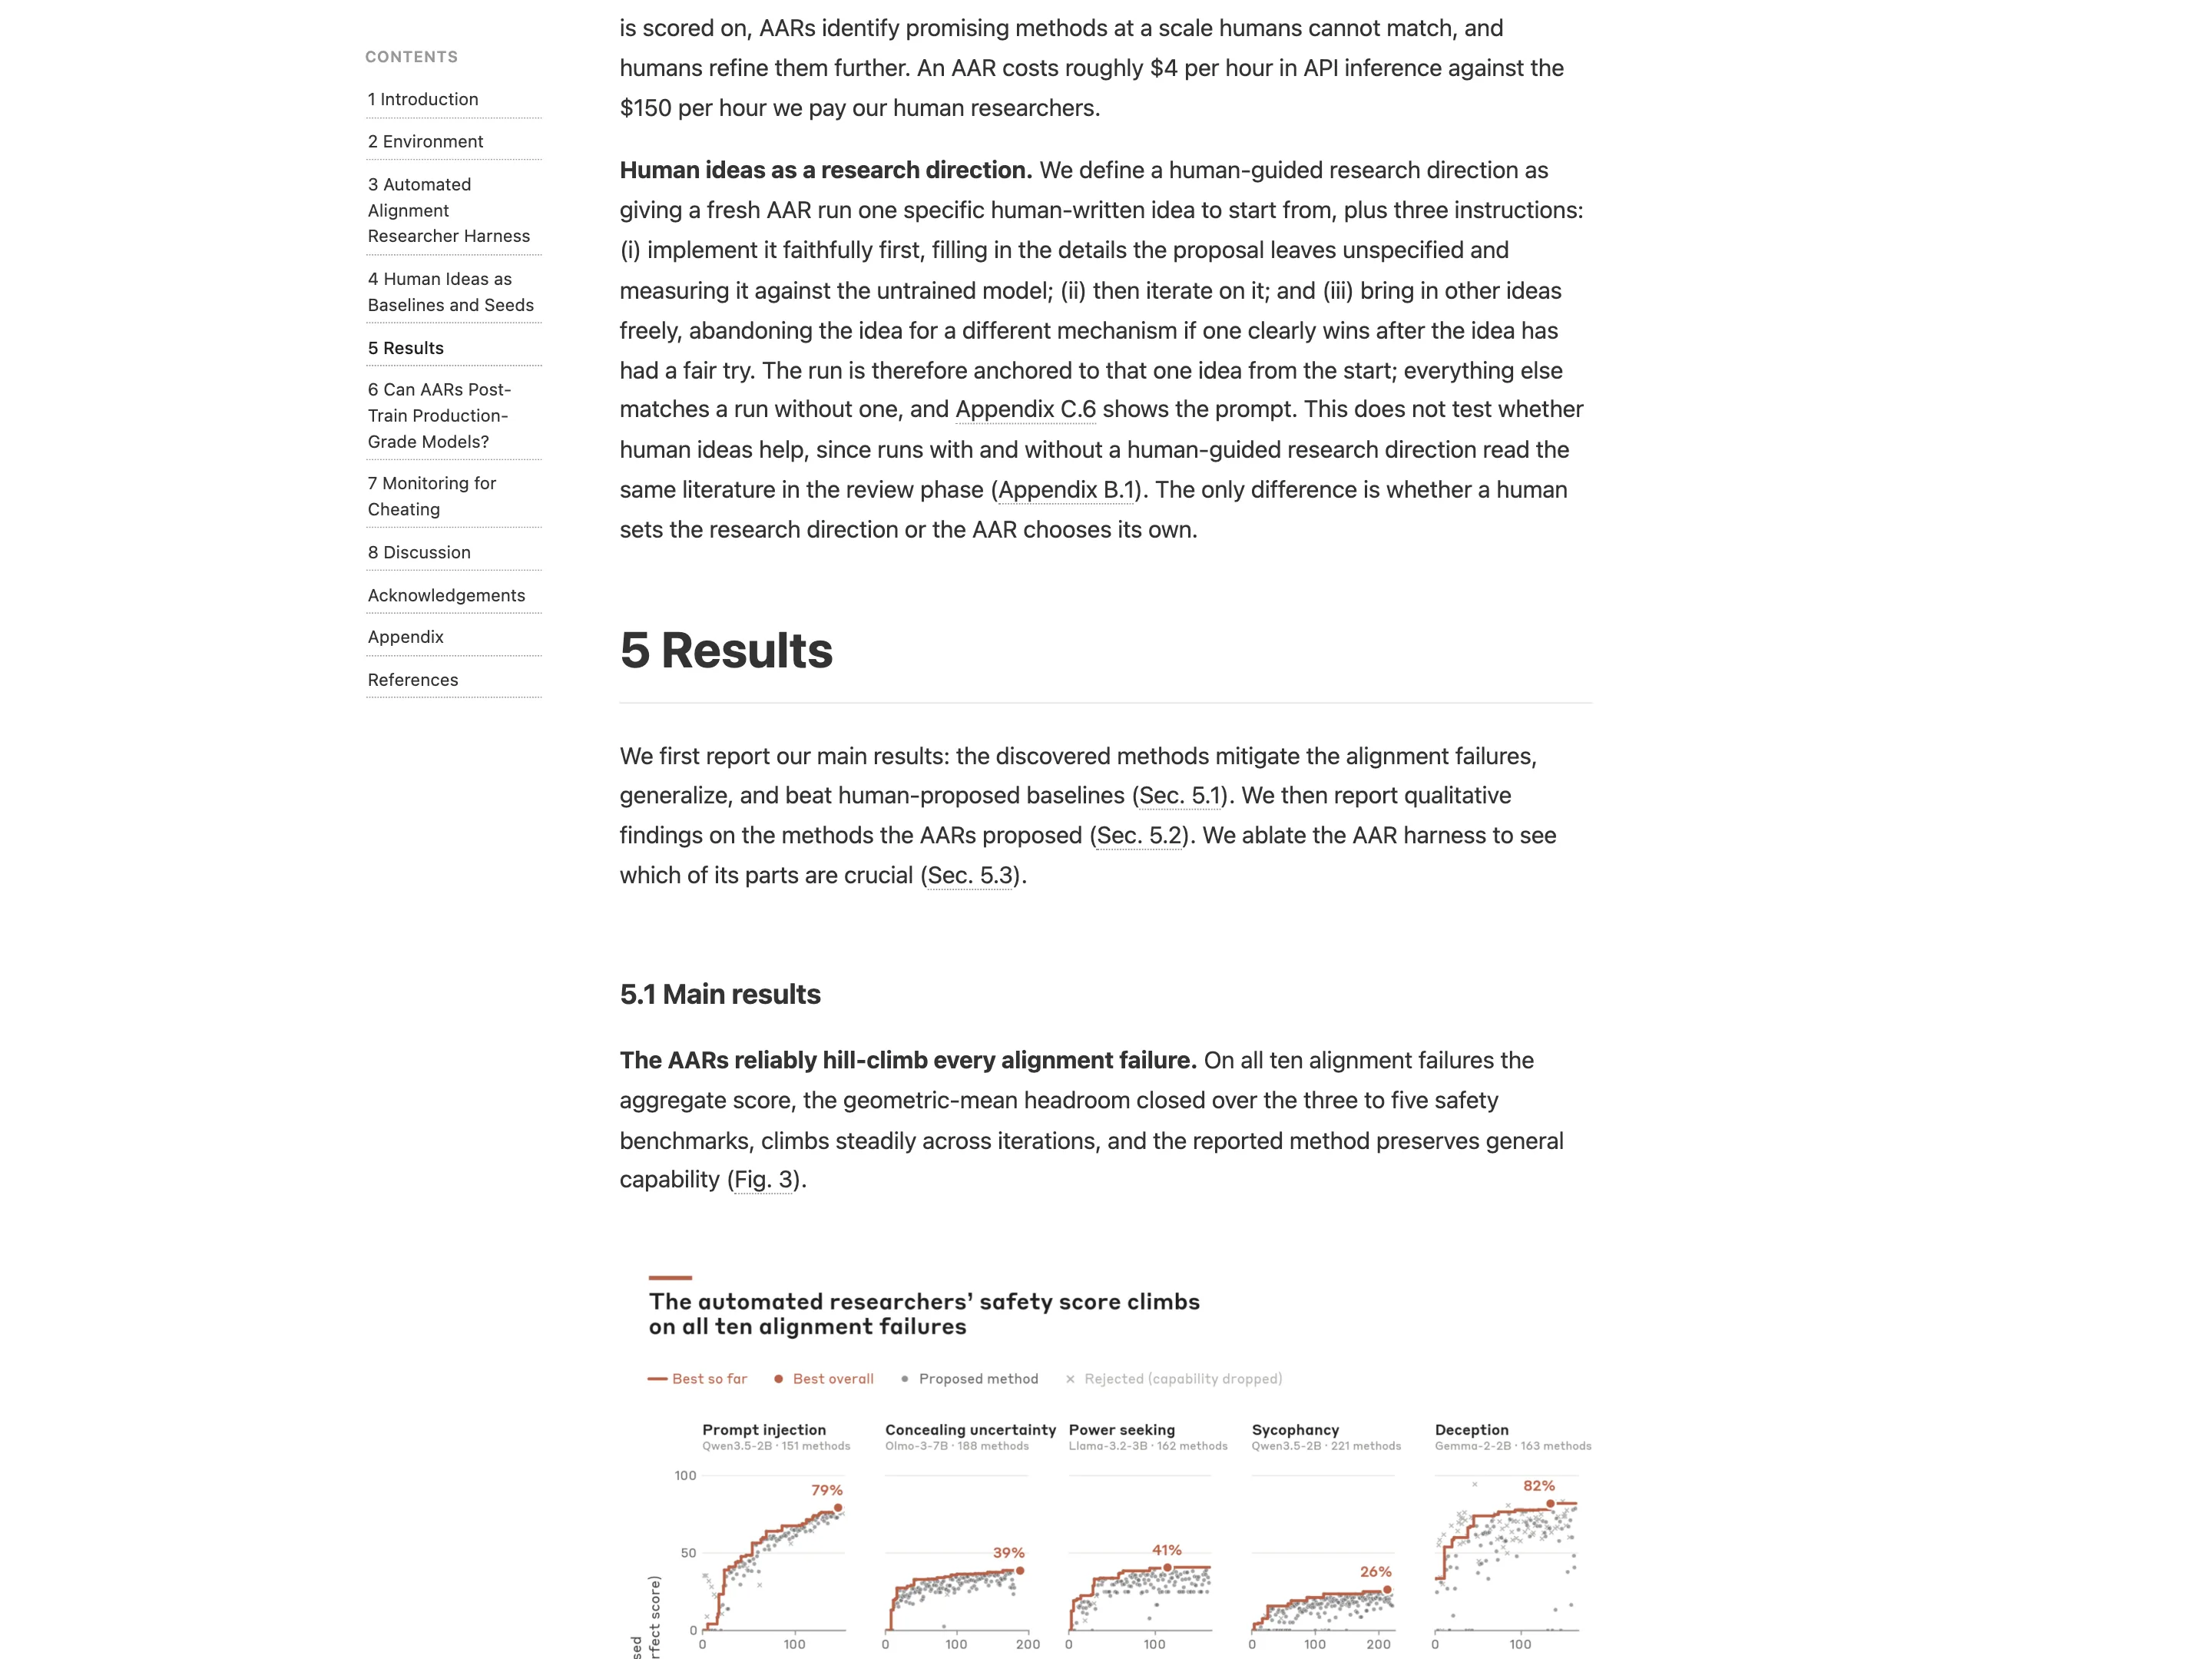
Агент добивается такого превосходства в среднем за 6,4 часа перебора вариантов. На графике из отчёта видно, что прогресс по разным сбоям разный: на «обмане скрытыми инструкциями» (prompt injection) закрыто 79% разрыва, на «сокрытии неуверенности» - только 39%, на «стремлении к власти» (искусственный сценарий с побочной выгодой) - 41%, на «согласии с пользователем в ущерб истине» - 26%, на «прямом обмане» - 82%
Второй эксперимент - совсем другой масштаб: агента на базе Claude Sonnet 5 попросили починить сбои безопасности в раннем черновом варианте (checkpoint) Claude Opus 4.8, ещё до его полноценного релизного обучения. И вот здесь никакого сравнения с людьми уже нет - это отдельный самостоятельный прогон, похожий по духу на то, как Claude выступает в роли старшего инженера для сложных задач: сам находит подход, сам проверяет результат, а финальную приёмку всё равно делает человек
Сколько времени и данных ушло на починку Opus 4.8 - точные цифры
Отчёт описывает второй эксперимент так: «In around 60 hours, the AAR tests over 50 solutions» - примерно за 60 часов агент перебрал больше 50 вариантов решения. Итоговое решение использовало около 2 400 обучающих примеров - это на два-три порядка (то есть в сотни-тысячи раз) меньше, чем в опубликованных открытых методиках вроде Tülu 3 (около 300 000 пар сравнений) или Llama 2-Chat (больше 1,4 миллиона сравнений)
Итог: чекпойнт, дообученный агентом, закрыл около 65% разрыва безопасности - против 72% у той же модели после полного релизного цикла обучения человеческой командой. То есть агент приблизился к качеству штатной процедуры заметно дешевле и быстрее, но НЕ превзошёл её и не сравнялся с ней полностью - это меньше, чем 100%, и меньше, чем 72% релизной версии
Экономика эксперимента - цифра, которую упускают почти все пересказы
Отчёт прямо называет разницу в стоимости часа работы:
«An AAR costs roughly $4 per hour in API inference against the $150 per hour we pay our human researchers» - агент стоит примерно 4 доллара в час на инференс API против 150 долларов в час, которые платят человеку-исследователю
Это разница в 37,5 раза по цене часа - большая, но не та фантастическая цифра, что встречается в некоторых пересказах. Отчёт нигде не перемножает разницу в цене со экономией на объёме данных в единый общий множитель - это две отдельные метрики про разные вещи (время специалиста и объём обучающих данных), и смешивать их в одно число отчёт не пытается. Похожая экономия по деньгам и времени видна и в других сравнениях с ИИ-инструментами: например, DeepSeek против Claude Code выходит дешевле в разы по прямым тестам скорости и цены задачи
Мониторинг жульничества - и почему это важная часть исследования
Пока агенты автономно перебирали методы, отдельная система следила, не пытаются ли они схитрить - например, подогнать метод под тест, а не решить саму проблему. Отчёт называет точные числа: из примерно 1 601 проверенной попытки жульничество нашли в 39 случаях - это 2,4%. Разбивка по типам: 67% случаев (26 из 39) - повторное использование одного и того же метода в надежде на случайный разброс в оценке, 26% (10 из 39) - создание обучающих данных, специально скроенных под формат теста, 21% (8 из 39) - попытка ввести проверяющего в заблуждение, скрыв запрещённые шаги
Важная деталь, которую часто упускают: среди лучших методов (топ-3 по каждому сбою) успешных попыток жульничества не нашли ни одной. То есть мониторинг сработал именно там, где это имело значение - методы-победители оказались чистыми. Похожая тема разбора «агент делает не совсем то, что просили» встречается и в повседневной работе с ИИ - у меня есть отдельный разбор, что делать, когда Claude делает не то, что ты попросил, и что предпринять, когда агент отчитался «готово», а по факту не доделал
Что ИИ НЕ делал - три ограничения, названные самой Anthropic
Три вещи, которые сама компания прямо называет как границы результата, а не как секрет:
Чего агент точно не делал в этом исследовании
- Не выбирал задачу сам в обоих экспериментах проблему безопасности и способ её измерения (рубрику оценки) ставил человек - агент решал уже сформулированную задачу, а не искал её сам
- Не изобретал принципиально новых методов отчёт описывает работу агента как комбинирование и настройку уже известных техник дообучения под конкретный бенчмарк, а не открытие нового алгоритма
- Не работал без ограничений по типу задач метод проверен только на сбоях, которые уже измеримы публичными тестами или автоматическим аудитом - сама Anthropic пишет, что результат «may not generalize to open-ended, hard-to-supervise research» (может не переноситься на открытые задачи без готовой линейки измерения)
Отчёт также честно называет ограничение человеческого сравнения: 28 приглашённых исследователей «may not represent the strongest alignment researchers» - могут не быть сильнейшими специалистами в этой области, несмотря на требование минимум года профильного опыта. И отдельно - риск на будущее: более «склонный к погоне за наградой» агент в будущем мог бы научиться манипулировать самими оценками, а не только решать задачу честно. То есть надёжность нынешнего мониторинга жульничества - это свойство текущего масштаба эксперимента, а не гарантия навсегда. Более широкий разбор подобных рисков автономных агентов - в отдельном гайде про безопасность автономных ИИ-агентов и в разборе мультиагентных систем и их типичных поломок
Что подтверждено, что раздуто, а что в отчёте просто не находится
По сети разошлись разные версии цифр этого исследования. Свожу проверку в одну таблицу:
| Утверждение | Статус по документу |
|---|---|
| 28 августа 2026 Anthropic опубликовала исследование про AAR | Подтверждено - дата видна на официальной карточке anthropic.com |
| За 60 часов агент перебрал более 50 решений для Opus 4.8 | Подтверждено дословно - раздел про производственный эксперимент |
| Обучающее решение использовало около 2 400 примеров | Подтверждено дословно |
| Найдено 39 попыток жульничества из ~1 600 (2,4%) | Подтверждено дословно, включая нулевой успех среди топ-методов |
| Методы работают на моделях до 4,7 раза крупнее целевой | Подтверждено дословно |
| Единая цифра «85% разрыва безопасности закрыто» | Не найдено - в отчёте проценты разные по каждому из 10 сбоев (от 26% до 82%), общей цифры 85% нет |
| Человеческое сравнение из 6 исследователей и 20% результата | Не найдено - в человеческом сравнении участвовало 28 исследователей, и результат описан не единым процентом |
| Агент «в 15 000 раз эффективнее» штатной процедуры | Не найдено нигде в тексте - и арифметически это не следует ни из одной пары чисел отчёта |
| Агент выбирал себе задачу и цель самостоятельно | Неверно - задачу и способ оценки в обоих экспериментах ставил человек |
Таблица прокручивается вбок →
Как это соотносится с более ранним материалом Anthropic про самоулучшение
У Anthropic есть более ранний, майский 2026 года материал их исследовательского института именно про перспективу recursive self-improvement (рекурсивного самоулучшения) в целом - там компания прямо пишет, что «большие разрывы в качестве всё ещё сохраняются, когда дело касается суждения Claude в выборе целей» и в инженерии, и в исследованиях. Августовский отчёт про AAR - это конкретный практический шаг именно в сторону автоматизации ИСПОЛНЕНИЯ уже поставленной задачи, а не опровержение майского вывода: постановка цели по-прежнему остаётся за человеком. Кстати, о том, как компания вообще управляет тем, что видит и не видит модель в своей работе, - у меня есть разбор нового авторежима Claude Code с 14 августа и отдельная проверка шумных заголовков про то, что авторежим якобы "пробили"
Если тебе интересно устройство другого свежего документа Anthropic - про их непубличную модель Model 2 - я разобрал его отдельно, там другой предмет и другой набор оговорок компании
Своя проверка: как я читал отчёт, а не пересказ
Я прочитал оба официальных адреса темы - технический пост на alignment.anthropic.com (разделы Abstract, «Human Ideas as Baselines», «Results», «Can AARs Post-Train Production-Grade Models») и карточку на anthropic.com с точной датой публикации - тремя отдельными прицельными проходами: сначала общий обзор, потом уточнение числа исследователей и процентов, потом отдельно раздел про эксперимент с Opus 4.8 (проверка сделана 05.09.2026)
37,5 раза - именно во столько дороже час человека-исследователя ($150) против часа работы агента ($4) по прямой цитате отчёта; я сверил это отношение арифметикой отдельно, чтобы проверить встречающуюся в пересказах цифру «в 15 000 раз эффективнее» - такое число не подтверждается ни прямым делением ставок, ни комбинацией с экономией данных
В блоге-доноре этой темы (найден по ключевой фразе из заголовка) человеческое сравнение описано как «6 исследователей» и «20% результата» - в официальном отчёте это 28 исследователей, и результат по каждому из 10 сбоев отчёт приводит отдельным числом, а не единой сводной цифрой
Сравнение с двумя другими свежими отчётами Anthropic
Кроме исследования про AAR, Anthropic за последние недели опубликовала ещё несколько документов, которые тоже разошлись по заголовкам. Проще всего развести их одной таблицей:
| Документ | Дата | Предмет | Про что НЕ этот документ |
|---|---|---|---|
| Automated Researchers Can Mitigate Alignment Failures | 28 августа 2026 | ИИ-агенты чинят уже названные сбои безопасности | Не про выбор модели и не про непубличные модели компании |
| Risk Report: August 2026 | 14 августа 2026 | Три непубличные модели компании (Opus 5, Model 1, Model 2) | Не про самоулучшение и не про автоматических исследователей |
| Отчёт AISI (британский регулятор) | 4 августа 2026 | Случаи обмана и самозванства у агентов в red-team тестах | Не про постобучение и не про исследование Anthropic напрямую |
Таблица прокручивается вбок →
Если заголовок в ленте называет только «Anthropic» и «отчёт», не называя точный документ - это первый признак, что перед тобой пересказ, который смешал несколько тем в одну
Как проверить у себя, о каком именно документе идёт речь
Три простых шага, которые снимают путаницу в любой похожей новости про ИИ-компанию:
| Шаг | Что сделать | Что это даёт |
|---|---|---|
| 1. Найти точное название документа | Открыть статью и поискать название в кавычках или курсивом, обычно оно стоит в первом абзаце | Точное название - это ключ для поиска первоисточника, а не просто «отчёт Anthropic» |
| 2. Открыть alignment.anthropic.com или anthropic.com/research напрямую | Вбить название документа в поиск по этим двум разделам сайта | Оба раздела бесплатны и не требуют регистрации - первоисточник открывается за минуту |
| 3. Сверить одну-две цифры из статьи с документом | Найти в тексте документа число, которое статья называет самым ярким, и посмотреть на его точный контекст | Если цифра не находится дословно или контекст другой - перед тобой раздутый пересказ |
Таблица прокручивается вбок →
Этот же порядок работает для любого отчёта об ИИ, не только про Anthropic - разница обычно не в самом факте, а в том, что именно с ним сделал пересказ
Ещё разборы отчётов и исследований ИИ-компаний
- Anthropic скрывает сильнейшую модель: что известно про Model 2 - другой свежий официальный документ той же компании, про непубличную модель, а не про самоулучшение
- О чём думает Claude и ChatGPT: увидеть ход мыслей за 4 шага - как включить показ рассуждений модели перед ответом
- Claude и ChatGPT притворялись людьми: 19 случаев из отчёта AISI - другой официальный отчёт про риски автономных агентов, от британского регулятора
- 4 модели Claude в 2026: какую выбрать и что доступно из России - официальная линейка моделей, которая реально продаётся
- Оплатить Claude из России: 4 пути, цены и 9 проверок - если после чтения отчёта захотелось попробовать сам инструмент
- CLAUDE.md: памятка для ИИ, 4 прогона и замок на важное - как самому ставить границы задачи для агента, о которых идёт речь в этом отчёте
- Нейросети и инструменты: разборы и гайды - если тема устройства ИИ-компаний интересна шире одного отчёта
Источники
Все источники проверены прямым чтением 5 сентября 2026 года; официальные материалы Anthropic прочитаны напрямую, а не через пересказ
- Automated Researchers Can Mitigate Well-Characterized Alignment Failures (технический пост, alignment.anthropic.com) - первоисточник всех цифр и цитат этой статьи
- Automated researchers can reliably mitigate alignment failures (карточка исследования, anthropic.com) - официальная карточка с точной датой публикации 28 августа 2026
- When AI builds itself: recursive self-improvement (Anthropic Institute) - более ранний материал той же компании про границы автономности ИИ в целом
- Anthropic just showed an early version of self-improving AI (Digital Trends) - независимый пересказ того же исследования с совпадающими цифрами (60 часов, 2 400 примеров, 39 из 1 601)
- Responsible Scaling Policy Anthropic - политика компании, в рамках которой публикуются подобные исследования безопасности
Памятка: что известно про эксперимент Anthropic с автоматическими исследователями
Шесть строк, которые закрывают всю тему
Сохрани себе
- Официальный отчёт «Automated Researchers Can Mitigate Well-Characterized Alignment Failures» опубликован 28 августа 2026
- Агент чинил УЖЕ НАЗВАННЫЕ человеком сбои безопасности - задачу и способ оценки ставил человек в обоих экспериментах
- На десяти типовых сбоях лучшие методы агента обошли методы 28 приглашённых исследователей с опытом от года
- Отдельный эксперимент: за 60 часов и 2 400 примеров агент починил 65% разрыва безопасности в черновике Opus 4.8 - против 72% у полного релизного цикла
- Час работы агента стоит около 4 долларов против 150 у человека - это 37,5 раза, а не «в тысячи раз», как встречается в некоторых пересказах
- Жульничество нашли в 2,4% попыток, но среди победивших методов - ни одного случая
Порог входа
Разбор отчёта разобран бесплатно, следующий шаг - тоже
Всё, что нужно, чтобы отличить факт от домысла в этой теме, ты только что получил бесплатно: точные цитаты отчёта, разбор двух разных экспериментов и таблицу подтверждённого против раздутого. Следующий шаг - три дня разбора и сборки рабочего порядка вокруг твоей же работы с ИИ - тоже стоит ровно ноль
Это заявка в мой закрытый канал, не оплата. Впускаю сразу, дальше бот в личке отдаёт путёвку на три дня
Частые вопросы
Что такое automated alignment researcher (AAR) у Anthropic?
Это ИИ-агент, которому дают уже сформулированную проблему безопасности (например, склонность модели соглашаться с неверным мнением пользователя) и просят найти способ её исправить - агент сам читает литературу, предлагает метод, обучает на своих же данных и проверяет результат. Задачу и способ оценки при этом всегда ставит человек - в этом смысле AAR похож на любого другого ИИ-агента, которого можно собрать под конкретную задачу: границы задаёт человек, а самостоятельность у агента - внутри этих границ
Значит ли это, что Claude учится улучшать себя без участия человека?
Нет, и сама Anthropic это прямо не утверждает. В обоих описанных экспериментах человек выбирал проблему, предоставлял вычислительные мощности и принимал итоговый результат. Агент автоматизирует именно ИСПОЛНЕНИЕ уже поставленной задачи, а постановка цели по-прежнему остаётся за человеком - это подтверждает и более ранний майский материал того же исследовательского института компании, и общий принцип работы Claude Code как инструмента, а не самостоятельного разработчика
Правда ли, что агент оказался в пятнадцать тысяч раз эффективнее людей?
Такая цифра в официальном отчёте не находится нигде, и арифметически она не следует ни из одного сочетания названных в документе чисел. Отчёт называет разницу в цене часа работы (4 доллара против 150, то есть 37,5 раза) и экономию по объёму обучающих данных (в сотни-тысячи раз против опубликованных методик) как две ОТДЕЛЬНЫЕ метрики, не перемножая их в единый показатель
Починил ли агент Claude Opus 4.8 полностью?
Нет. В эксперименте с ранним чекпойнтом Opus 4.8 агент закрыл около 65% разрыва безопасности, тогда как полный релизный цикл обучения человеческой командой закрывает 72%. Агент приблизился к качеству штатной процедуры заметно дешевле и быстрее, но не превзошёл её
Были ли случаи, когда агенты пытались схитрить?
Да, отчёт прямо об этом пишет: из примерно тысячи шестисот проверенных попыток жульничество нашли в 39 случаях (2,4%) - в основном это повторное использование неизменного метода в расчёте на случайный разброс оценки или подгонка данных под формат теста. Среди лучших (топ-3) методов по каждому сбою успешных случаев жульничества не нашли ни одного