GPT-5.6 Sol vs Claude Fable 5.1 · свой тест · сентябрь 2026
GPT-5.6 против Claude Fable 5.1 в 2026: свой тест за 10 минут
Заголовки в лентах читаются одинаково с февраля 2026 года: «OpenAI догнала Anthropic», обычно со ссылкой на один тест. Правда честнее: три официальных бенчмарка называют трёх разных победителей, и общего лидера по всем фронтам нет. Единственный тест, который отвечает именно на твой вопрос - прогнать свою же задачу в обеих моделях и сравнить результат глазами
Дальше в статье - как это сделать за 10 минут (шаги 1-4), а после - три официальных бенчмарка с источниками и датами, и честная разница в цене

Три официальных бенчмарка называют разных победителей: GPT-5.6 Sol впереди на абстрактных головоломках ARC-AGI-2, Claude Fable 5.1 впереди на реальных инженерных правках SWE-bench Pro. Общего победителя нет, поэтому единственный точный тест - твоя собственная задача. Ниже - как за 10 минут прогнать один и тот же промпт в ChatGPT и в Claude и сравнить результат своими глазами, а дальше три официальных таблицы и честная разница в цене
Из практики
Разбор ниже собран той же моделью Claude, о которой статья
Все три таблицы бенчмарков ниже я сверял вручную с официальных страниц, а не пересказывал чужой обзор - методика в разделе про источники
Шаг 1. Выбрать одну свою реальную задачу
Не абстрактный тест, а кусок твоей настоящей работы - функция, баг, кусок вёрстки
Куда нажать. Возьми задачу, над которой реально работаешь сейчас: например, «найди причину, почему функция X возвращает не то значение» или «сделай кнопку с таким же поведением, как на скрине». Сформулируй её одним абзацем словами, без сокращений и намёков - модель не видит того, что видишь ты в голове
Что увидишь: у тебя получится готовый текстовый промпт, который можно вставить в любой чат без изменений
Что это тебе даёт: результат теста будет про ТВОЮ работу, а не про абстрактную головоломку или чужую вёрстку - это честнее любого чужого бенчмарка для твоего конкретного случая
Оговорка заранее: обе модели доступны только на платных тарифах - Sol по умолчанию отвечает на ChatGPT Plus и Pro, Fable 5.1 - на Claude Pro и выше. Если платной подписки нет ни у одного из двух сервисов, тест придётся отложить до оформления одной из них - бесплатных тарифов с этими флагманскими моделями нет
Шаг 2. Прогнать промпт в ChatGPT
Plus и Pro по умолчанию отвечают моделью Sol - выбирать её из списка не нужно
Куда нажать. Открой chat.openai.com, вставь свой промпт из шага 1 в поле ввода и нажми Enter. Отдельного выбора модели по имени сейчас нет - вместо старого списка версий в интерфейсе стоит один слайдер «глубины размышления» рядом с полем ввода
Что увидишь: ChatGPT ответит текстом или кодом, в сложных задачах перед ответом может показать короткий процесс рассуждения
Что это тебе даёт: ответ модели Sol на твою же реальную задачу, без переключения версий и без риска случайно попасть на более слабую модель линейки
Шаг 3. Прогнать тот же промпт в Claude
Pro и выше по умолчанию отвечают моделью Fable 5.1
Куда нажать. Открой claude.ai, вставь ровно тот же текст промпта (без единой правки) в поле ввода и нажми Enter. На тарифе Pro и выше по умолчанию отвечает Fable 5.1 на среднем уровне рассуждения - специально искать её в списке моделей не нужно
Что увидишь: Claude ответит текстом или кодом в похожем формате - если промпт про код, ответ будет с блоком кода, который можно скопировать одной кнопкой
Что это тебе даёт: второй ответ на ту же самую задачу от другой модели - теперь у тебя есть с чем сравнивать
Шаг 4. Сравнить результат по трём признакам
Заработал ли код, сколько правок потребовалось, сколько стоил запрос
Куда смотреть. Три вопроса к обоим ответам: (1) код или текст сразу рабочий, без правок? (2) сколько раз пришлось переспросить или уточнить, чтобы получить нужное? (3) во сколько символов или строк обошёлся ответ - длинный ответ на подписке с лимитом запросов расходует лимит быстрее
Что увидишь: обычно один из двух ответов ближе к готовому результату с первого раза - не обязательно тот, что выигрывает на бенчмарках ниже, потому что твоя задача может не совпадать ни с одним официальным тестом
Что это тебе даёт: честный ответ именно про твою работу, а не про абстрактный процент из таблицы. Дальше по этому же принципу можно прогонять любую следующую задачу и постепенно понять, какая модель чаще выигрывает именно у тебя
Сколько времени занимает весь путь по минутам
| Этап | Сколько занимает | Что происходит |
|---|---|---|
| Сформулировать промпт одним абзацем | 2-3 минуты | Переписываешь реальную задачу словами без сокращений |
| Прогнать в ChatGPT (Sol) | 1-3 минуты | Модель отвечает, иногда с коротким рассуждением перед ответом |
| Прогнать в Claude (Fable 5.1) | 1-3 минуты | Тот же промпт без правок, ответ в похожем формате |
| Сравнить по трём признакам | 2-3 минуты | Смотришь на рабочий код, число уточнений и объём ответа |
Таблица прокручивается вбок →
Итого весь путь от сформулированной задачи до сравнения двух ответов - около 10 минут
Если результат неоднозначный: 5 частых сбоев
У этого сравнения есть типичные места, где новичок делает неверный вывод
| Что видишь | Что это значит | Что сделать |
|---|---|---|
| Оба ответа выглядят рабочими на глаз, непонятно, какой лучше | Задача слишком простая для обеих моделей на их сегодняшнем уровне | Возьми задачу сложнее - с несколькими условиями или зависимостью от других файлов проекта, разница станет заметнее |
| В ChatGPT нет пункта выбора конкретно модели Sol | Актуальный интерфейс Plus/Pro скрыл список версий за одним слайдером глубины размышления | Это нормально: слайдер и есть управление моделью, отдельно искать «Sol» в меню не нужно |
| В Claude ответ короче, чем ожидал, и обрывается на середине | Достигнут лимит вывода на разовый ответ или лимит запросов тарифа | Попроси Claude продолжить с того места, где остановился, отдельным сообщением |
| Промпт скопирован в оба чата, а ответы совсем не сопоставимы по формату (один код, другой текст) | Формулировка промпта была недостаточно конкретной про формат ответа | Добавь в промпт прямое указание, что нужен именно код, а не описание словами (или наоборот) |
| Результат теста хочется выдать за «доказанный факт», хотя проверил только один раз | Один прогон на одной задаче не отражает поведение модели на других задачах | Считай результат ориентиром для СВОИХ похожих задач, а не универсальным вердиктом - для другого класса работы прогони тест повторно |
Таблица прокручивается вбок →
Как пользоваться таблицей: смотри в левый столбец на то, что видишь у себя на экране, и делай то, что написано в правом - разбираться в причине до конца не обязательно
ARC-AGI: где Sol реально впереди
Короткий ответ: на тесте ARC-AGI-2 GPT-5.6 Sol набирает 92.5% при максимальной глубине размышления, Claude Fable 5.1 - 90.0%. Разница - 2.5 процентных пункта в пользу Sol, и это единственный из трёх официальных замеров, где OpenAI впереди. На более лёгком ARC-AGI-1 (задачи известны с 2019 года) у обеих моделей одинаковый результат на самом сильном режиме - по 97.5%, разница практического значения не имеет
| Версия теста | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| ARC-AGI-1 | 97.5% | 97.5% |
| ARC-AGI-2 | 92.5% | 90.0% |
Таблица прокручивается вбок →
ARC-AGI-2 - это набор головоломок, где нужно понять правило по нескольким примерам «было - стало» и применить его к задаче, которую видишь первый раз в жизни. Ответа в интернете не существует, потому что каждая задача либо совсем новая, либо составлена так, что заучить её нельзя. Модель либо правда понимает логику превращения, либо гадает
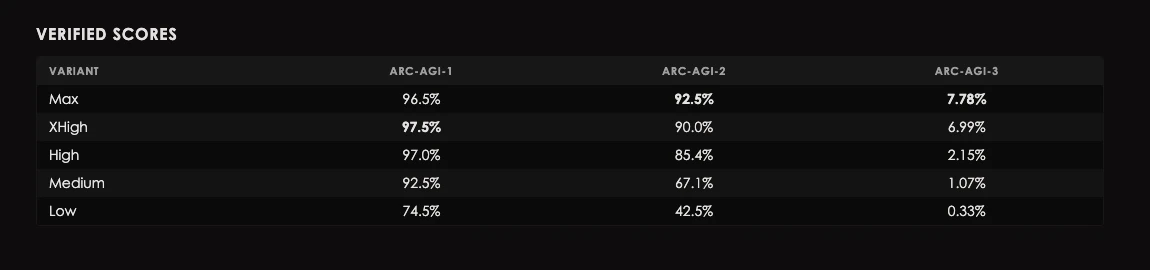
92.5 - 90.0 = 2.5 процентных пункта, я вычел эту разницу сам по двум официальным карточкам ARC Prize: у каждой модели своя отдельная страница результатов, сводной таблицы «одна против другой» сайт не публикует
Три честных оговорки в этом замере. Дата записи: результат Sol зафиксирован 9 июля 2026 года, результат Fable 5.1 - 1 сентября, при выходе самой модели - Anthropic отвечала на уже известный результат конкурента, а не наоборот; прежняя Fable 5 (без 5.1) показывала на этом тесте 89.2% при записи 3 августа. Соседняя модель того же вендора: у Claude Opus 5 (не Fable, другая модель линейки Anthropic) результат на ARC-AGI-2 выше - 90.4%, разбор отдельно в статье ARC-AGI что это: 3 версии теста и взлёт Claude в 2026 году - разница по паре моделей зависит от того, какую именно модель Anthropic сравнивать
Frontend Code Arena: вёрстка достаётся Fable 5.1 с большим отрывом
На замере вёрстки сайтов и интерфейсов Fable 5.1 после своего релиза 1 сентября вышла в лидеры заметно, а не на волосок. Живой лидерборд Arena на 8 сентября 2026 года показывает: Claude Fable 5.1 - 1795 очков (2 место в общем рейтинге площадки), GPT-5.6 Sol XHigh - 1626 очков (14 место). Разрыв - 169 очков, и он куда больше, чем разница на ARC-AGI-2
Старая Claude Fable 5 (без 5.1) была на этом же замере скромнее конкурентов: 1642 очка, позади открытой китайской модели Kimi K3 Max с 1691 очком - именно эта расстановка обсуждалась в статьях сразу после выхода Fable 5. Обновление 5.1 полностью изменило картину: теперь линейка Claude обошла и Kimi K3, и Sol с большим запасом. Разбор прежней расстановки (Kimi K3 против Fable 5) - в отдельной статье: Kimi K3 против Claude Code: 6 побед из 7 на вёрстке сайтов
Таблица четырёх моделей на одном замере, живая проверка 8 сентября 2026 года:
| Модель | Балл Frontend Code Arena | Место в общем рейтинге |
|---|---|---|
| Claude Fable 5.1 | 1795 | 2 |
| Kimi K3 Max | 1691 | 5 |
| Qwen3.8 Max | 1676 | 7 |
| GPT-5.6 Sol XHigh | 1626 | 14 |
Таблица прокручивается вбок →
Frontend Code Arena меряет одну узкую вещь - собрать рабочую вёрстку по текстовому заданию. Она не проверяет, как модель находит ошибку в чужом большом проекте, работает с базой данных сайта или держит в памяти план на сотню файлов. Для этого есть отдельный, более близкий к реальной разработке тест
SWE-bench Pro: на реальных инженерных задачах Fable заметно впереди
Здесь разрыв уже не в единицах процентов, а в полтора десятка. Свежая Claude Fable 5.1 набирает на SWE-bench Pro 81.2% (по независимому агрегатору, замер начала сентября 2026), прежняя Fable 5 - 80.3% (независимый замер) или 80.0% (сводка morphllm.com), GPT-5.6 Sol - 64.6%. Разница между Sol и любой версией Fable - от 15.4 до 16.6 процентных пункта в пользу Anthropic
SWE-bench Pro проверяет способность модели-агента самостоятельно чинить настоящие баг-репорты в открытых проектах: прочитать чужой код, понять, где именно сломано, внести правку и не сломать остальное рядом. Это ближе к повседневной работе с агентом вроде Claude Code, чем абстрактные головоломки или вёрстка с нуля. На более лёгком SWE-bench Verified (тот же принцип, задачи попроще) официальная цифра Fable 5 - 95.0%; отдельной официальной карточки Sol на этом же тесте на момент снятия данных не нашлось, поэтому по Verified сравнение честно не привожу, а по Pro привожу с указанием источника
Разница в масштабе разрыва между тестами - тоже честный факт: на ARC-AGI-2 разница между моделями всего 2.5 процентных пункта, на SWE-bench Pro - от 15.4 до 16.6. Абстрактные головоломки обе модели решают на сопоставимом уровне, а самостоятельная работа с чужим большим кодом даётся им заметно по-разному. Для человека, который выбирает модель под ежедневную работу с кодом, а не под разовый тест на сообразительность, разрыв на SWE-bench весит больше, чем разрыв на ARC-AGI
Кто дешевле: разница в 2.5 раза не в пользу Claude
Сила редко достаётся бесплатно, и здесь разница ощутимая. Официальные цены на 9 сентября 2026 года:
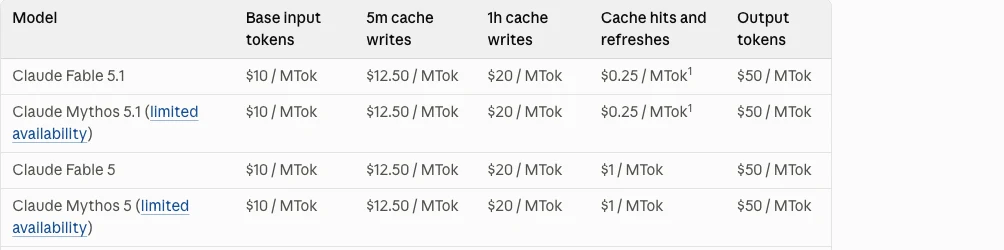
GPT-5.6 Sol 21 августа 2026 года подешевела: вход упал с $5 до $4 за миллион единиц текста (минус 20%), выход - с $30 до $20 (минус 33%). Скидка действует минимум до 21 ноября 2026 года и касается оплаты по счётчику расхода, а не обычной подписки на приложение ChatGPT - я разбирал этот нюанс отдельно, с полным списком, кого именно касается снижение: GPT-5.6 подешевела на 20%: цены и оплата из России в 2026 году. Claude Fable 5.1 стоит ровно столько же, сколько прежняя Fable 5: $10 за миллион на входе, $50 на выходе - цена не изменилась при переходе на новую версию, живая проверка 9 сентября 2026
| Модель | Вход, за миллион | Выход, за миллион |
|---|---|---|
| GPT-5.6 Sol (после снижения 21.08) | $4 | $20 |
| Claude Fable 5.1 | $10 | $50 |
Таблица прокручивается вбок →
Складываю вход и выход за пару обращений: у Sol получается $24 за миллион единиц текста туда-обратно, у Fable 5.1 - $60. Fable 5.1 обходится в 2.5 раза дороже. Разбор бенчмарков выше показал: сила Fable на инженерных задачах достаётся заметно дороже, чем сила Sol на абстрактных головоломках
Что почитать дальше на этом же сайте
- ARC-AGI что это: 3 версии теста и взлёт Claude в 2026 году - полный разбор теста и результата Claude Opus 5
- Kimi K3 против Claude Code: 6 побед из 7 на вёрстке сайтов - тот же лидерборд Frontend Code Arena, расстановка до выхода Fable 5.1
- GPT-5.6 подешевела на 20%: цены и оплата из России в 2026 году - подробности снижения цены Sol 21 августа
- GPT-5.6 Sol, Terra и Luna: какую модель брать под задачу - выбор внутри линейки GPT-5.6
- Какая нейросеть лучше: вердикт по каждой задаче - более широкий обзор, не только код
- ChatGPT vs Claude 2026: 4 задачи, цены и проверка из России - сравнение продуктов и подписок, не версий моделей
- 4 модели Claude в 2026: какую выбрать и что доступно из России - разница между Sonnet, Opus и Fable внутри самого Claude
- Фронтир модели: что это простыми словами и как выбрать ИИ под задачу - что вообще значит слово «фронтир»
- Сравнение флагманских нейросетей: GPT, Claude, Gemini - более широкий обзор топовых моделей
- Агент говорит «готово»: 4 шага, чтобы доделать до конца - частая ловушка на любой модели
- Claude Code: полный набор гайдов - весь стек статей про этот инструмент
- Нейросети и инструменты: полный раздел гайдов - все статьи про модели и сервисы на одной странице
Источники
- ARC Prize: результаты GPT-5.6 Sol - официальная таблица Verified Scores, дата записи 9 июля 2026
- ARC Prize: результаты Claude Fable 5.1 - официальная карточка, дата записи 1 сентября 2026, проверено живьём 9 сентября 2026
- ARC Prize: результаты Claude Fable 5 (прежняя версия) - официальная карточка, дата записи 3 августа 2026
- arcprize.org/leaderboard - живой лидерборд ARC Prize
- Arena: Frontend Code Arena leaderboard - живой лидерборд вёрстки, проверен живьём 8-9 сентября 2026
- developers.openai.com/api/docs/pricing - официальные цены OpenAI, снижение 21 августа 2026
- Claude Platform Docs: Pricing - официальные цены Anthropic, включая Claude Fable 5.1, проверено живьём 9 сентября 2026
- morphllm.com: сводная таблица бенчмарков Claude - агрегатор SWE-bench Verified и Pro
- anthropic.com: анонс Claude Fable 5.1 и Mythos 5.1 - официальный релиз, 1 сентября 2026, проверено живьём 9 сентября 2026
Памятка: свой тест GPT-5.6 против Claude Fable 5.1
Четыре шага и три официальных цифры для контекста
Сохрани себе
- Своя реальная задача сформулирована одним абзацем и прогнана без изменений в ChatGPT (Sol) и в Claude (Fable 5.1)
- Результат сравнен по трём признакам: рабочий код с первого раза, число уточнений, объём ответа
- Для контекста: ARC-AGI-2 - Sol 92.5% против Fable 5.1 90.0%, SWE-bench Pro - Fable 5.1 81.2% против Sol 64.6%
- Цена за миллион единиц текста туда-обратно: Sol $24, Fable 5.1 $60 - Fable дороже в 2.5 раза
- Общего победителя по всем замерам нет: каждая модель сильнее на своём тесте, а твою задачу проверяет только твой собственный прогон
Порог входа
Свой тест прогнан, следующий шаг тоже бесплатный
Ты только что сравнил две модели на своей реальной задаче, а не поверил чужому проценту - весь разбор дальше строится на том же принципе: проверяю сам, а не пересказываю чужой обзор
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Правда ли что GPT-5.6 обошла Claude Fable 5.1?
Частично. На тесте ARC-AGI-2 GPT-5.6 Sol впереди - 92.5% против 90.0% у Fable 5.1, разница 2.5 процентных пункта. Но на замере вёрстки Frontend Code Arena Fable 5.1 обходит Sol с большим отрывом (1795 против 1626 очков), а на SWE-bench Pro (реальные инженерные правки) Fable 5.1 опережает Sol на 16.6 процентных пункта. Общего победителя по всем фронтам нет
Какая модель дешевле, GPT-5.6 Sol или Claude Fable 5.1?
GPT-5.6 Sol дешевле. После снижения цены 21 августа 2026 года Sol стоит $4 за миллион единиц текста на входе и $20 на выходе, Claude Fable 5.1 - $10 и $50 соответственно (цена не изменилась по сравнению с прежней Fable 5). По сумме вход плюс выход Sol дешевле в 2.5 раза
Как проверить, какая модель лучше именно на моей задаче?
Возьми свою реальную задачу, сформулируй её одним абзацем и прогони без изменений в ChatGPT (Plus или Pro отвечают моделью Sol по умолчанию) и в Claude (Pro и выше отвечают Fable 5.1 по умолчанию). Сравни ответы по трём признакам: рабочий код с первого раза, число нужных уточнений, объём ответа. Это займёт около 10 минут и даёт более точный ответ, чем любой чужой бенчмарк
Что такое ARC-AGI-2 и почему по нему сравнивают модели?
ARC-AGI-2 - тест на абстрактное мышление: нужно понять правило по нескольким примерам и применить его к задаче, которую видишь первый раз. Заучить ответ заранее нельзя, поэтому высокий результат показывает, что модель понимает логику, а не вспоминает готовый шаблон
Frontend Code Arena и SWE-bench - это официальные замеры OpenAI и Anthropic?
Нет, обе площадки независимые. Arena - открытый сервис, где модели соревнуются вслепую на реальных задачах, а результат нельзя подогнать заранее. SWE-bench - открытый набор задач на основе реальных баг-репортов. Цифры ARC-AGI-2, наоборот, взяты с официальных страниц результатов каждой модели на сайте ARC Prize, где указана дата верификации