ARC-AGI · объясняем на пальцах
ARC-AGI что это: 3 версии теста и взлёт Claude в 2026 году
24.07.2026 на странице результатов ARC Prize появилась запись: новая модель Anthropic, Claude Opus 5, набрала на тесте ARC-AGI-2 90.4% - против 68.8% у предыдущей модели, Opus 4.6. Разница - 21.6 процентных пункта, я посчитал её сам по двум официальным цифрам с arcprize.org. Дальше в статье - что это за тест, откуда он взялся и почему такой скачок вообще что-то значит
К концу статьи ты будешь знать: что такое тест ARC-AGI и почему обычные нейросети годами его проваливали, чем версия 2 отличается от версии 1, где посмотреть текущую расстановку моделей своими глазами и что скачок на этом тесте значит для твоей повседневной работы с ИИ, а что нет
Открой страницу результатов на arcprize.org/results и найди свою модель - там прямым текстом написан процент по каждой версии теста. Если тебе интересна конкретная задача (код, тексты, аналитика), процент ARC-AGI смотри как намёк, а не гарантию: проверяй модель на СВОЕЙ задаче, а не на чужом проценте
ARC-AGI - это не «ещё один рейтинг», а тест на новую мысль
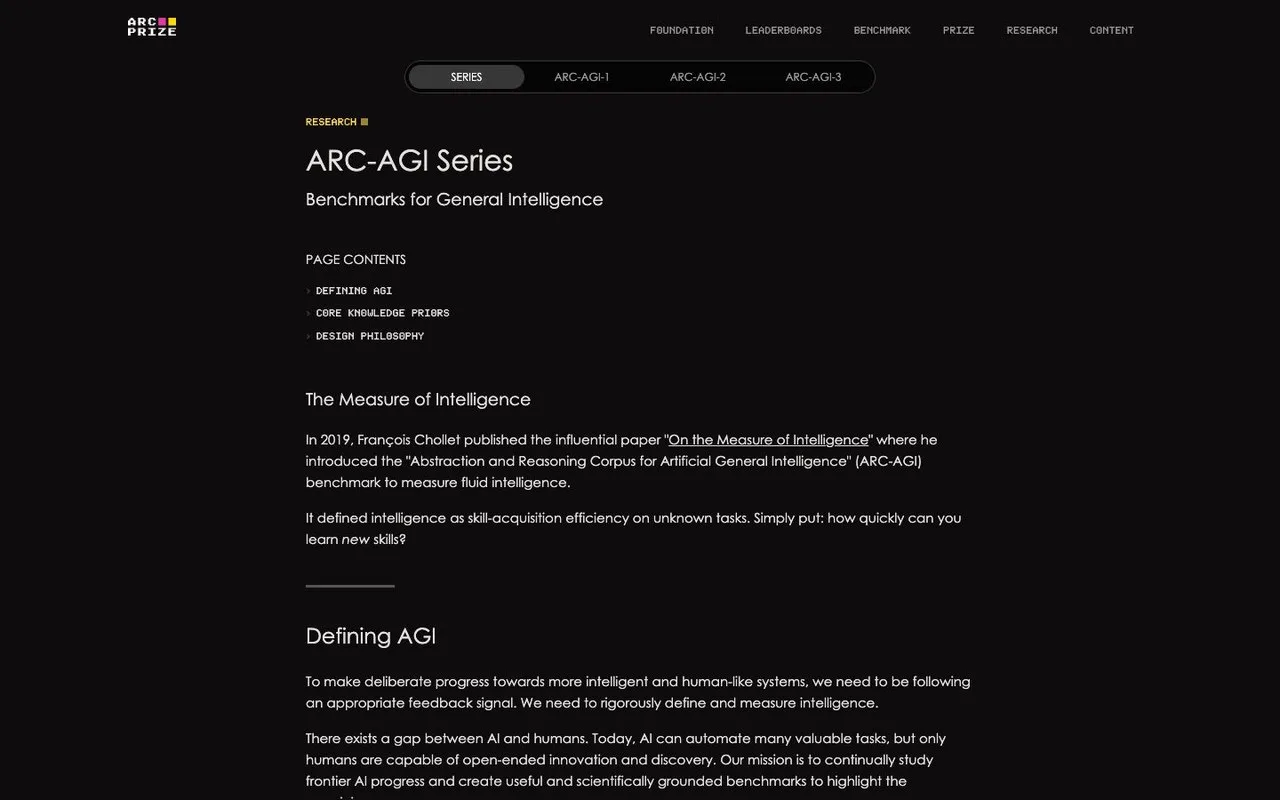
Короткий ответ: ARC-AGI - это набор головоломок, где нужно понять правило по нескольким примерам и применить его к задаче, которую видишь первый раз в жизни. Придумал его в 2019 году исследователь Франсуа Шолле (François Chollet), создатель библиотеки Keras, в статье «On the Measure of Intelligence»
Каждая задача ARC-AGI выглядит как маленькая сетка из цветных клеток. Тебе показывают несколько пар «было - стало»: вот такая картинка на входе превращается вот в такую на выходе. Обычно таких пар от трёх до пяти. Дальше дают новую картинку - только вход, без ответа - и просят применить то же самое правило. Единственный способ ответить правильно - действительно понять логику превращения, а не подставить готовый шаблон
Вот почему это работает как тест на интеллект, а не на эрудицию: ответа на конкретную задачу в интернете не существует, потому что каждая задача либо совсем новая, либо составлена так, что заучить её заранее нельзя. Обычные вопросы вроде «столица Франции» модель отвечает знаниями из обучения. Задачу ARC она обязана решить прямо сейчас, вслепую
Почему языковые модели годами проваливали эти задачи
Здесь и кроется дыра, которую ARC-AGI обнажает у обычных больших языковых моделей. Модель вроде ChatGPT или Gemini после обучения «застывает»: она отвечает на любой вопрос уже готовыми знаниями и не учится ничему новому прямо во время разговора. Даже если ты дообучишь такую модель на похожих головоломках, точность вырастает всего примерно до 10%, потому что каждая новая задача ARC требует немного другого правила - подсказки от похожих примеров помогают слабо
Человек решает такие задачи легко, потому что у него есть врождённые «приоры»: понимание геометрии, симметрии, счёта предметов, объектности. Увидел три примера - и за секунды понял, что фигура поворачивается или что цвет копируется по контуру. У модели таких приоров нет, ей приходится выводить логику из голых чисел
Отсюда практический вывод для читателя: если модель хорошо отвечает на твои привычные вопросы, это ещё не значит, что она умеет разбираться с чем-то принципиально новым. ARC-AGI как раз меряет именно второе - способность понять с нуля, а не вспомнить готовое
Claude Opus 5: 90.4% против 68.8% у прошлой модели
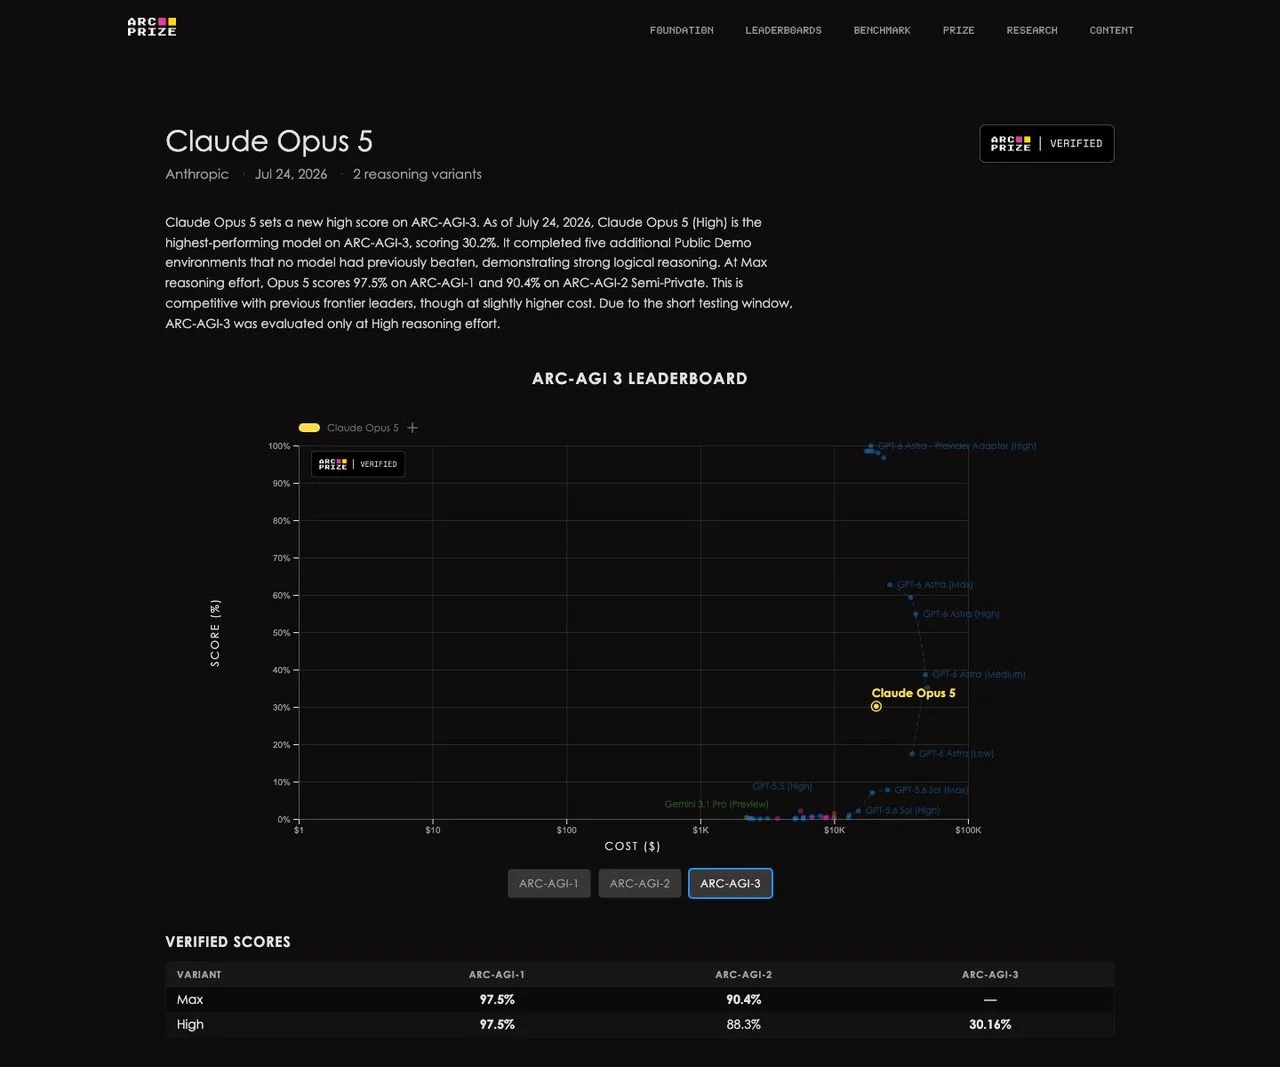
24.07.2026 на странице результатов Claude Opus 5 на arcprize.org появилась таблица с тремя цифрами: 97.5% на ARC-AGI-1, 90.4% на ARC-AGI-2, 30.2% на ARC-AGI-3 (это уже другой, более новый тест, о нём отдельно ниже). Для сравнения: предыдущая модель Anthropic, Claude Opus 4.6, показывала на ARC-AGI-2 68.8% - запись об этом на arcprize.org датирована 05.02.2026
21.6 процентных пункта разницы - это и есть тот самый «взлёт» из заголовков новостей. Я посчитал число сам, вычитанием двух официальных цифр с разных страниц arcprize.org: такой сводки нет ни на одной отдельной странице сайта, обе цифры лежат порознь, у каждой модели своя карточка результатов
Скачок дороже по деньгам, и это тоже часть честной картины
Высокий процент на сложном тесте не даётся бесплатно. По данным страницы результатов, одна задача ARC-AGI-1 обходится модели в 0.70 доллара, а задача ARC-AGI-2 - уже в 2.06 доллара. Более сложный тест требует больше вычислений на каждую попытку, а не просто более умную модель
ARC Prize прямо считает эту стоимость наравне с процентом решённых задач - у них это отдельная метрика эффективности, а не сноска мелким шрифтом. Причина понятна: модель, которая тратит на одну задачу в разы больше вычислений, может показать более высокий процент просто потому, что ей дали больше «времени подумать», а не потому что стала умнее в узком смысле слова. Учитывать оба числа сразу - процент решённых задач и цену за задачу - и есть честный способ читать такие результаты, а не только заголовок с одним процентом
ARC-AGI-1 и ARC-AGI-2: почему появилась вторая версия
Версия 1 перестала быть честным измерением примерно по той же причине, по которой любой школьный тест теряет смысл, если ответы утекли в интернет: задачи ARC-AGI-1 попали в обучающие выборки моделей, и часть головоломок стало можно решить перебором готовых программ без настоящего понимания. Задача из первой версии в среднем занимает у человека около 30 секунд
Версия 2 намного жёстче в трёх местах: каждая задача, по заявлению авторов, полностью новая и не пересекается с ранее известными паттернами; задача из второй версии в среднем занимает у человека около 300 секунд - в 10 раз дольше, потому что требует не мгновенного узнавания, а обдумывания; добавлена метрика эффективности - важен не только правильный ответ, но и сколько вычислений на него ушло
Есть и третья версия тестов, ARC-AGI-3, но это уже совсем другая механика: не статичные картинки, а интерактивные игровые окружения, где модель-агент должна на ходу разбираться с правилами новой игры. Раз речь зашла про модель-агента в незнакомой среде - это тот же принцип, что стоит за автономными ИИ-агентами в повседневной работе, и там же прячутся свои риски: разбор в гайде безопасность автономных ИИ-агентов: 4 риска 2026 года
Три версии рядом, чтобы не путать их между собой:
| Версия | Формат задачи | Время человека | Результат Claude Opus 5 |
|---|---|---|---|
| ARC-AGI-1 | статичная сетка цветных клеток | около 30 секунд | 97.5% |
| ARC-AGI-2 | статичная сетка, задачи полностью новые | около 300 секунд | 90.4% |
| ARC-AGI-3 | интерактивная игровая среда | не измеряется так же | 30.2% |
Таблица прокручивается вбок →
Третье место, а не первое: честная расстановка на сентябрь 2026
По независимым сводкам бенчмарков на начало сентября 2026 года расстановка на ARC-AGI-2 такая: GPT-6 Astra от OpenAI - 95%, GPT-5.6 Sol от OpenAI - 92.5%, Claude Opus 5 от Anthropic - 90.4%. Три числа рядом дают честную картину: Opus 5 совершил самый резкий скачок в СВОЁМ семействе моделей, но занимает третье место, если сравнивать со всем рынком, а не только с прошлой версией себя же
| Место | Модель | Компания | ARC-AGI-2 (Max) |
|---|---|---|---|
| 1 | GPT-6 Astra | OpenAI | 95.0% |
| 2 | GPT-5.6 Sol | OpenAI | 92.5% |
| 3 | Claude Opus 5 | Anthropic | 90.4% |
Таблица прокручивается вбок →
Если тебе интересно сравнение моделей по практическим задачам, а не только по одному тесту, у меня есть отдельный разбор какая нейросеть лучше в 2026 году под конкретную задачу и разбор трёх версий GPT-5.6 по цене и бенчмаркам
Чем ARC-AGI отличается от «фронтир-модели» - это не одно и то же
Термины часто путают, потому что оба звучат на слуху в одних новостях, но отвечают на разные вопросы. Фронтир-модель - это КТО: самая новая и мощная модель на рынке прямо сейчас, будь то Claude Opus, GPT или Gemini. ARC-AGI - это ЧЕМ её меряют: один из тестов, которым проверяют, насколько хорошо конкретная модель справляется с абстрактным мышлением. Если хочешь разобраться, что вообще значит «фронтир-модель» и как её выбрать под свою задачу - это отдельный гайд про фронтир-модели простыми словами
Похожая путаница бывает и с режимом рассуждений внутри диалога: когда модель показывает пользователю «ход мыслей» перед ответом, это другая механика - разбор в гайде о чём думает Claude и ChatGPT. ARC-AGI меряет результат на внешнем, заранее подготовленном тесте, а не показывает мысли внутри обычного разговора
ARC Prize: кто вообще считает эти проценты
ARC Prize - организация, которая проводит открытое соревнование по решению задач ARC-AGI и держит независимый лидерборд: сама прогоняет модели разных компаний по одной и той же методике и подтверждает результат значком «ARC Prize | Verified» - его видно на кадре выше, рядом с таблицей результатов Opus 5. Цифры в этой статье взяты не из пресс-релиза компании, выпустившей модель, а из независимого замера сторонней организации
Что этот процент значит для твоей работы, а что нет
Здесь и живёт самый частый вопрос читателя: раз новый Claude «поумнел» на тесте, значит ли это, что он теперь лучше пишет код или тексты? Прямого ответа «да» нет, и вот почему
ARC-AGI меряет одну конкретную способность - находить новое правило по нескольким примерам на абстрактной картинке. Это не тест на код, не тест на письмо, не тест на работу с документами. Рост на нём показывает, что модель стала лучше справляться с ситуациями, которых раньше не видела - а это косвенно полезно в любой задаче, где встречается что-то нестандартное, не по шаблону. Но переводить процент напрямую в «значит, теперь код в полтора раза лучше» - нечестно по отношению к самому тесту
Практический вывод: процент ARC-AGI - это ориентир при выборе, куда смотреть в первую очередь среди новых моделей, а не гарантия результата на твоей конкретной задаче. Единственный надёжный способ проверить пользу - прогнать модель на СВОЕЙ задаче и сравнить с тем, что было раньше
| Что показывает скачок ARC-AGI | Что он НЕ показывает |
|---|---|
| модель лучше находит новое правило по паре примеров | что код или тексты автоматически стали лучше |
| модель эффективнее справляется с нестандартной, незнакомой задачей | результат на ТВОЕЙ конкретной задаче без проверки |
| независимая организация подтвердила число по единой методике | что это число - от первого места на всём рынке |
Таблица прокручивается вбок →
Где посмотреть, какую модель выбрать под свою задачу
Процент ARC-AGI - только один из способов сравнить модели. Если задача практическая, а не тестовая, полезнее прямое сравнение под конкретную работу. У меня есть отдельные разборы, куда можно пойти дальше по своей задаче:
- Общее сравнение ChatGPT против Claude по 4 практическим задачам, ценам и доступу из России - если выбираешь между двумя главными экосистемами, а не смотришь только на один тест
- 4 модели Claude в 2026 году: какую выбрать и что доступно из России - если уже решил остаться на Claude, но не понимаешь разницу между Fable, Opus, Sonnet и Haiku
- Claude Opus 5 или Sonnet: 3 способа переключить и цены - конкретно про эту модель из статьи: как включить и сколько это стоит
- Как пользоваться Claude Code: установка и 9 шагов до проекта - если модель нужна не для чата, а для работы с кодом
- ИИ-поиск: 3 сервиса без VPN, но честно отвечает один - другой практический тест, только про поиск информации, а не про абстрактное мышление
- Агрегатор нейросетей: 3 сервиса и как платить одной картой - если хочешь пробовать сразу несколько моделей без отдельной подписки на каждую
- Сколько стоит подписка на нейросеть: 12 ценников в рублях - прежде чем переходить на новую модель, сравни её реальную цену
Частые ошибки при чтении новостей про бенчмарки
Путать «первое место в семействе» с «первым местом на рынке». Компания честно пишет «наш лучший результат», и это правда - но не значит первое место среди ВСЕХ моделей. Всегда проверяй полный список, а не только пресс-релиз одной компании
Путать ARC-AGI-1, ARC-AGI-2 и ARC-AGI-3. Это три разных теста с разной сложностью и разной механикой (статичные картинки против интерактивных игр). Процент по одной версии не говорит ничего о результате на другой - у Opus 5 разница между версиями почти в три раза (97.5% против 30.2%)
Считать процент бенчмарка гарантией для своей задачи. Тест меряет узкую способность - абстрактное мышление на цветных сетках. Твоя реальная задача (написать письмо, разобрать таблицу, сделать сайт) устроена иначе, и единственная честная проверка - попробовать самому
Забыть, что даже умная модель может остановиться на полпути. Высокий процент на тесте не защищает от привычной ошибки в работе - модель говорит «готово», хотя задача выполнена наполовину. Как это ловить, разобрано в отдельном гайде агент говорит «готово»: 4 шага, чтобы доделать до конца
Что ещё почитать про модели и работу с ИИ
- Мультиагентные системы: когда одной модели мало - если тебе интересна не только оценка одной модели, а связка нескольких
- Как проверить код от ИИ, прежде чем его запускать - практическая проверка результата, а не доверие к проценту бенчмарка
- Лучший ИИ для вайбкодинга в 2026 году - сравнение моделей именно под задачу написания кода
- О чём думает Claude и ChatGPT: увидеть ход мыслей за 4 шага - другая механика: как модель показывает рассуждение внутри обычного диалога
- Фронтир-модели простыми словами: как выбрать ИИ под задачу - что вообще значит термин «самая новая модель» и как в нём не потеряться
- Сол Терра Луна: какую модель GPT-5.6 выбрать - разбор конкурента Claude по цене и практическим бенчмаркам
- Какая нейросеть лучше в 2026 году: 6 задач, Opus 5, GPT, Gemini - выбор модели под конкретную практическую задачу, а не под один тест
Источники
Все цифры проверены живым запросом к arcprize.org 4 сентября 2026 года: страницы результатов Claude Opus 5, GPT-6 Astra и GPT-5.6 Sol открылись и дословно содержат заявленные проценты. Единственное исключение - цифра Claude Opus 4.6 (68.8%): отдельной страницы результатов для этой модели на arcprize.org не нашлось (её не сохранили отдельно, когда вышла модель постарше), цифра подтверждена независимым сравнением на Hacker News
- ARC-AGI Series на arcprize.org - официальное определение теста, автор Франсуа Шолле, ссылка на работу «On the Measure of Intelligence» 2019 года
- Результаты Claude Opus 5 - официальная таблица VERIFIED SCORES: 97.5% ARC-AGI-1, 90.4% ARC-AGI-2, 30.2% ARC-AGI-3, запись от 24.07.2026
- Результаты GPT-6 Astra - официальная страница результатов на arcprize.org
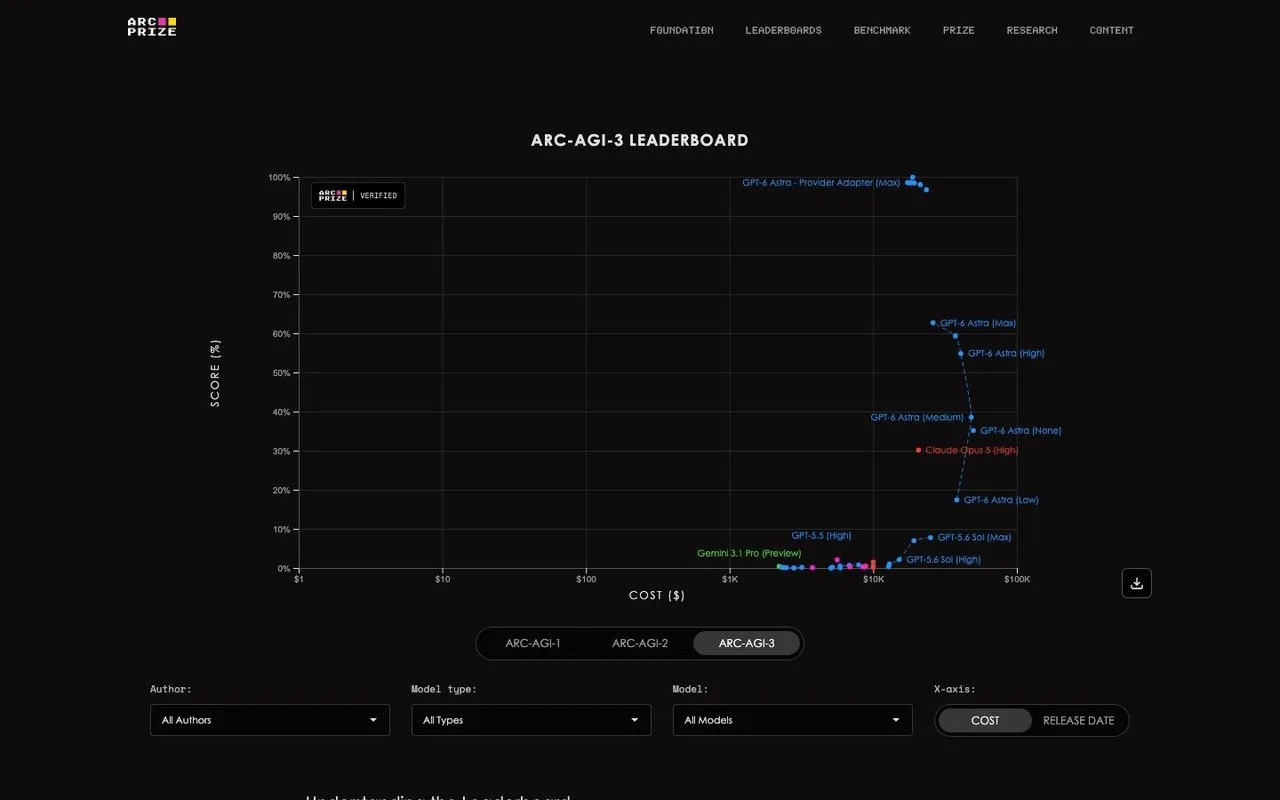
- Живой лидерборд ARC Prize - график «стоимость задачи против результата» по всем проверенным моделям
- Guide: что такое задача ARC-AGI - формат задачи, почему языковые модели её проваливают, роль врождённых приоров у человека
- Результаты GPT-5.6 Sol - официальная страница результатов на arcprize.org, дословно содержит «92.5%»
- arcprize.org - официальный источник данной статьи, все цифры сверены дословно
Памятка: что запомнить про ARC-AGI
Пять строк, если нужно освежить в памяти через месяц
Сохрани себе
- ARC-AGI - тест 2019 года авторства Франсуа Шолле: понять правило по нескольким примерам и применить к новой задаче
- обычные языковые модели проваливали его годами, потому что отвечают готовыми знаниями, а не учатся в моменте
- 24.07.2026 Claude Opus 5 показал 90.4% на ARC-AGI-2 против 68.8% у Opus 4.6 - разница 21.6 процентных пункта
- на сентябрь 2026 впереди GPT-6 Astra (95%) и GPT-5.6 Sol (92.5%) - у Opus 5 честное третье место
- процент ARC-AGI - ориентир, не гарантия результата на твоей конкретной задаче
Порог входа
Тест разобрали бесплатно, разбор твоих задач - тоже бесплатный
Всё, что нужно знать про ARC-AGI, ты только что прочитал: что это, откуда взялось, что показал новый Claude и что это значит на практике
Следующий шаг - три дня разбора, как встроить актуальные модели в твою собственную работу, а не в общий пример - тоже стоит ровно ноль
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
ARC-AGI что это простыми словами?
Это тест для нейросетей: показывают несколько примеров «было - стало» на картинке из цветных клеток, и модель должна понять правило и применить его к новой картинке, которую видит впервые. Придумал тест в 2019 году Франсуа Шолле, автор библиотеки Keras
Почему Claude Opus 5 показал такой скачок именно сейчас?
По записи arcprize.org от 24.07.2026, модель набрала 90.4% на ARC-AGI-2 против 68.8% у предыдущей модели Opus 4.6 - разница 21.6 процентных пункта. Причины скачка сама Anthropic на странице результатов не раскрывает, ARC Prize независимо подтверждает только итоговый процент
Значит ли это, что Claude Opus 5 - лучшая модель на рынке?
Нет, на самом тесте ARC-AGI-2 он на третьем месте по независимым сводкам на сентябрь 2026: впереди GPT-6 Astra (95%) и GPT-5.6 Sol (92.5%). Скачок реальный внутри линейки Anthropic, лидерства на всём рынке этот конкретный тест не показывает
Чем ARC-AGI-2 отличается от ARC-AGI-1?
Версия 2 сложнее и честнее: задачи полностью новые (версия 1 частично утекла в обучающие выборки моделей), в среднем занимают у человека около 300 секунд против 30 секунд у версии 1, и добавлена метрика стоимости решения, а не только правильности ответа
Что такое ARC-AGI-3 и почему у него другой процент?
Это отдельный, более новый тест: не статичные картинки, а интерактивные игровые окружения, где модель-агент должна на ходу разбираться с правилами новой среды. У Claude Opus 5 на нём 30.2% - намного ниже, чем на ARC-AGI-2, потому что это принципиально другая, более сложная задача
Помогает ли высокий процент ARC-AGI в повседневной работе с ИИ?
Косвенно да, напрямую - нет. Тест меряет способность разбираться с новым, непривычным заданием, и это полезно в любой нестандартной задаче. Но он не тестирует код, тексты или работу с документами напрямую, поэтому единственный надёжный способ проверить пользу - попробовать модель на своей конкретной задаче