Модели · GPT-5.6

GPT-5.6 Sol, Terra и Luna: какую модель брать под задачу
OpenAI показала три модели GPT-5.6 26 июня, а 30 июля срезала цены двум из них, и половина обзоров в поиске до сих пор носит старый прайс. Здесь свежие цифры, сверенные по официальным тарифам и по независимым замерам бенчмарка, а главное правило выбора, которое переживёт эти три названия
Sol, Terra и Luna это три ценовые полки одного семейства GPT-5.6. По прайсу на 3 августа 2026 года: Sol $5 за миллион входных токенов и $30 за выходной миллион, Terra $2 и $12, Luna $0.20 и $1.20. Разрыв между верхней и нижней полкой двадцатипятикратный
На агентном тесте Terminal-Bench 2.1 разрыв внутри семейства маленький: по цифрам OpenAI 88.8% у Sol против 84.7% у Luna, то есть 4.1 процентного пункта. Отсюда правило: бери самую дешёвую полку, которую класс задачи позволяет, и поднимайся выше только когда результат не устроил
Выбрать полку это арифметика на пять минут. Собрать на модели работающее производство контента и продукт учу на бесплатном ИИ-Лагере
Что за модели Sol, Terra и Luna и почему OpenAI развела их по трём полкам?
Sol, Terra и Luna это не три версии одной модели, а три ценовые полки семейства GPT-5.6: $5, $2 и $0.20 за миллион входных токенов. Разница между верхней и нижней полкой на входе двадцатипятикратная, а на тесте Terminal-Bench 2.1 по цифрам OpenAI между ними 4.1 процентного пункта
Раньше выбор был грубый: есть модель помощнее, есть подешевле, берёшь по ощущениям. Теперь производитель сам разложил линейку по полкам и написал, какая полка под что. Показали семейство 26 июня 2026 года, сейчас все три уже стоят в общем прайсе API и раздаются через посредников вроде OpenRouter, окно доступа только для избранных организаций закрылось
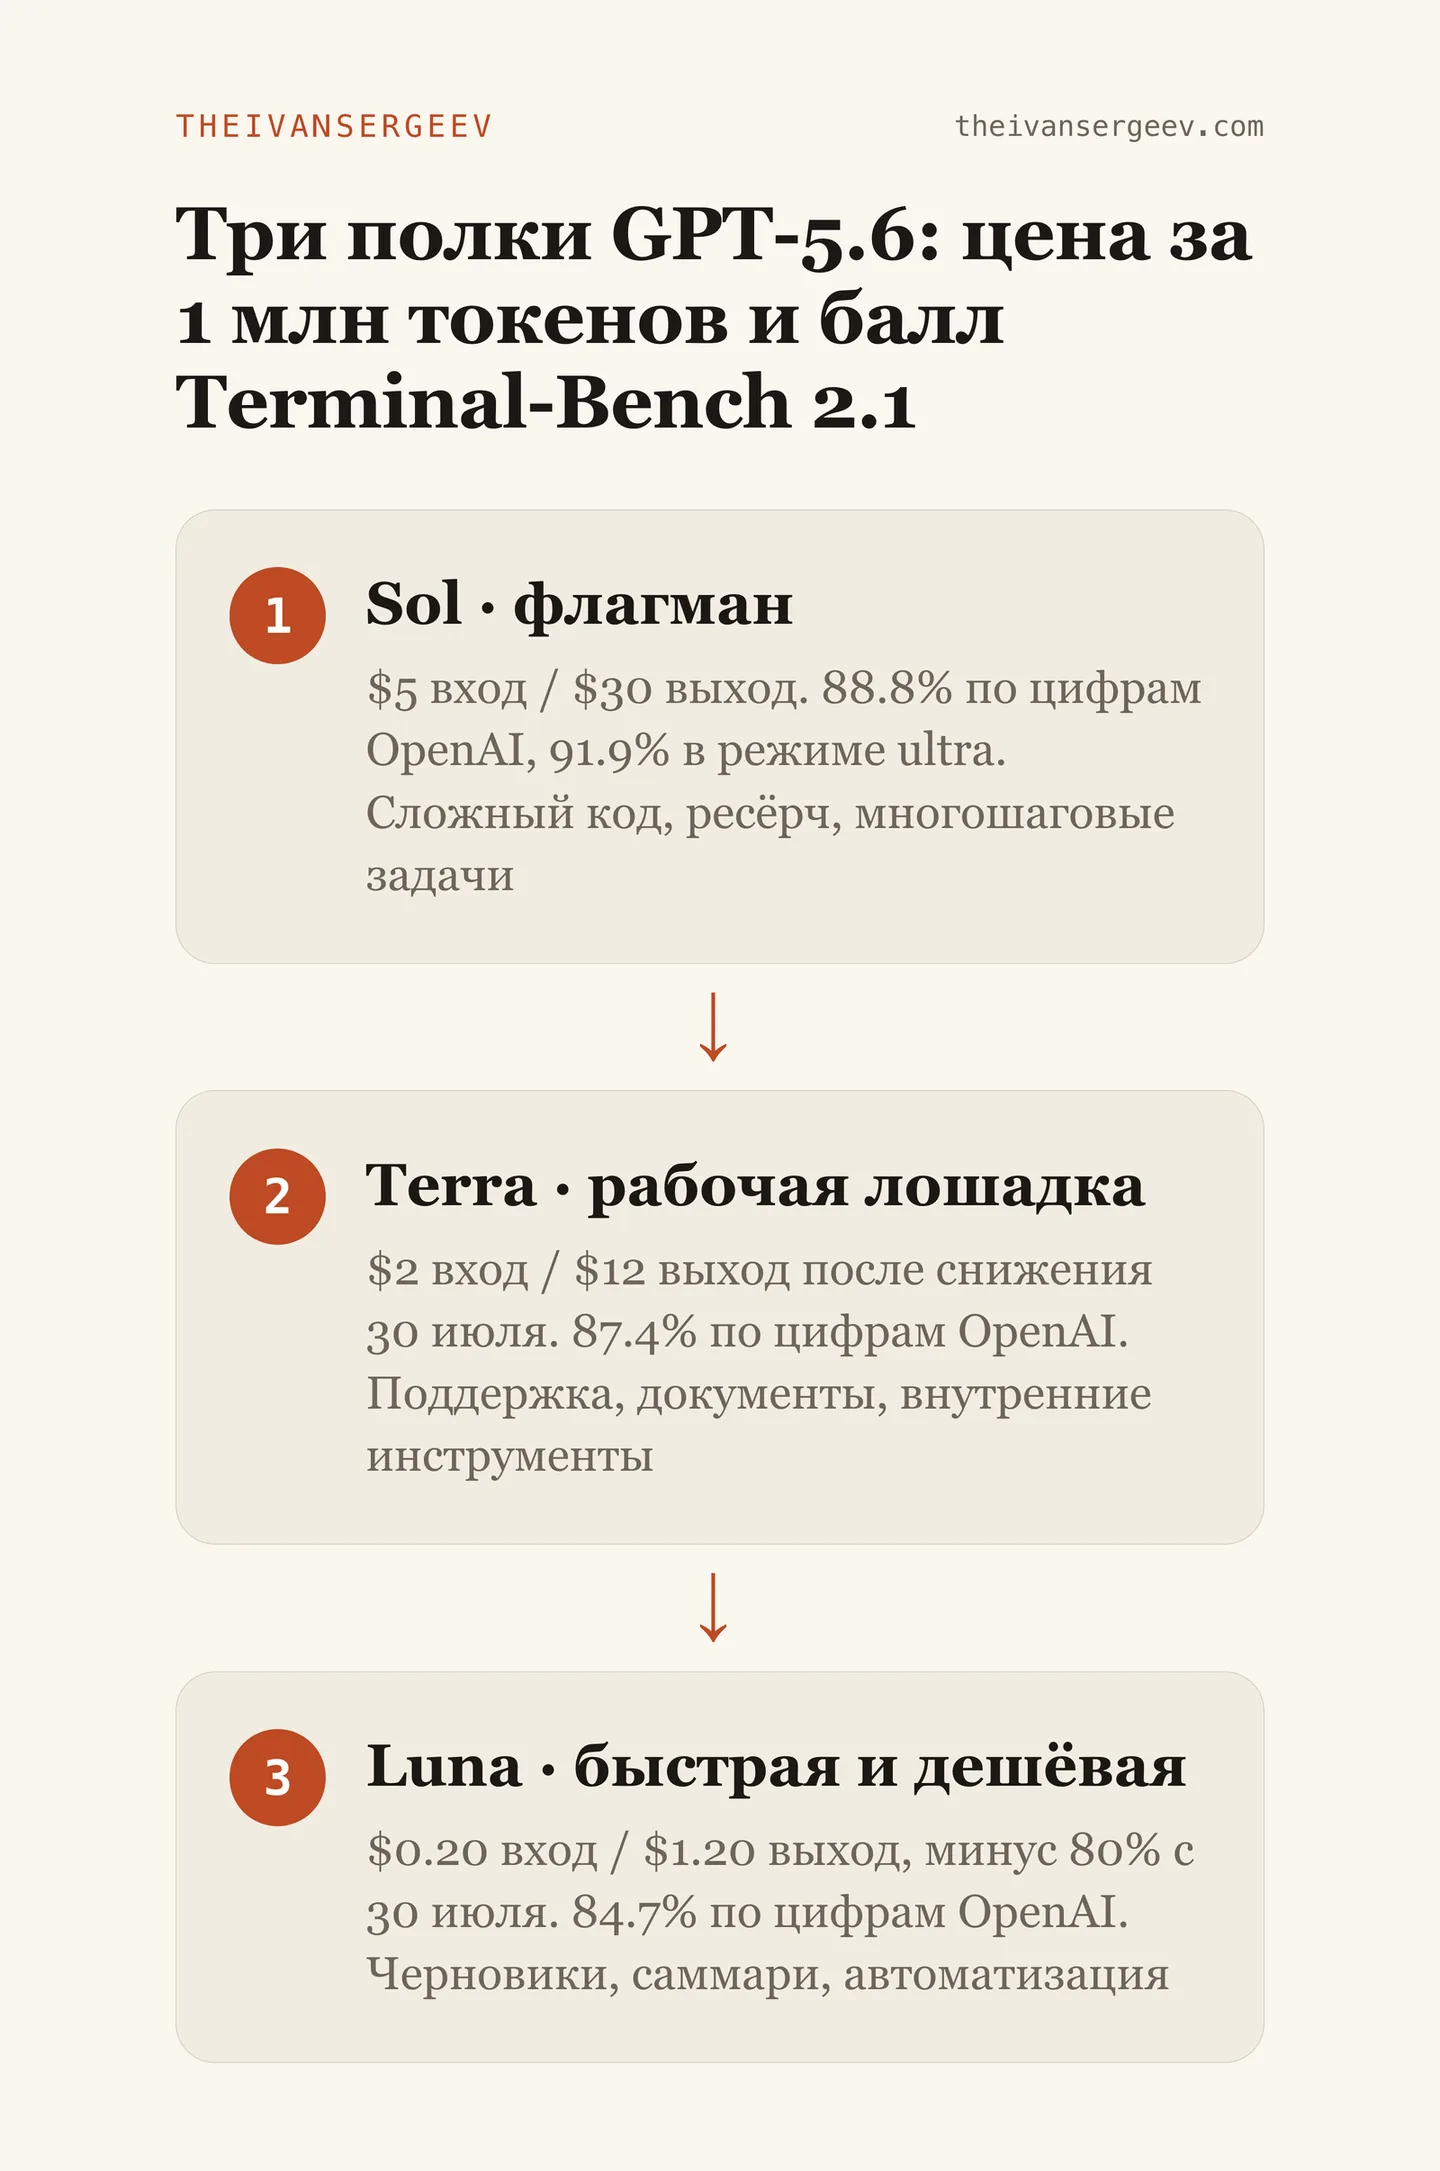
Логика разделения важнее самих названий. Названия живут полгода-год и сменяются, а сама идея «дорогая полка под редкое тяжёлое, дешёвая под поток» переносится на любого производителя: у Anthropic то же самое, у Google то же самое. Поэтому дальше я разбираю не только три модели, но и правило, по которому ты будешь выбирать и через год
Сколько стоит миллион токенов у Sol, Terra и Luna?
По официальному прайсу OpenAI на 3 августа 2026 года: Sol стоит $5 за миллион входных токенов и $30 за миллион выходных, Terra $2 и $12, Luna $0.20 и $1.20. Вход это то, что ты подаёшь модели, выход это то, что она отвечает, и выход всегда дороже входа в шесть раз
| Модель | Вход / 1 млн | Выход / 1 млн | Под что |
|---|---|---|---|
| Sol | $5 | $30 | сложный код, ресёрч, многошаговые задачи |
| Terra | $2 | $12 | объём бизнес-задач, поддержка, документы |
| Luna | $0.20 | $1.20 | рутина, черновики, автоматизация |
Цифры я сверял в этой сессии по странице тарифов на developers.openai.com, а не по обзорам. Обзоры до сих пор носят старый прайс, и это не мелочь: разница между старой и новой ценой Luna пятикратная. Прайс у посредников считается от этих же чисел, у OpenRouter на Terra висит скидка 50%, то есть $1 и $6 за миллион, и контекст там заявлен на миллион токенов
Как читать эту таблицу. Миллион токенов это примерно 700 тысяч слов на входе. Если ты гоняешь модель через чат по паре сообщений в день, ты этих денег вообще не увидишь: они начинаются там, где модель работает через API, в агенте или в редакторе, и жуёт файлы пачками
Что случилось с ценами 30 июля и почему Luna подешевела в пять раз?
30 июля 2026 года OpenAI срезала прайс двух нижних полок: Terra на 20% (было $2.50 и $15), Luna на 80% (было $1 и $6). Sol остался на $5 и $30, его не трогали. Из-за этого разрыв между верхней и нижней полкой вырос с пятикратного до двадцатипятикратного за одну ночь
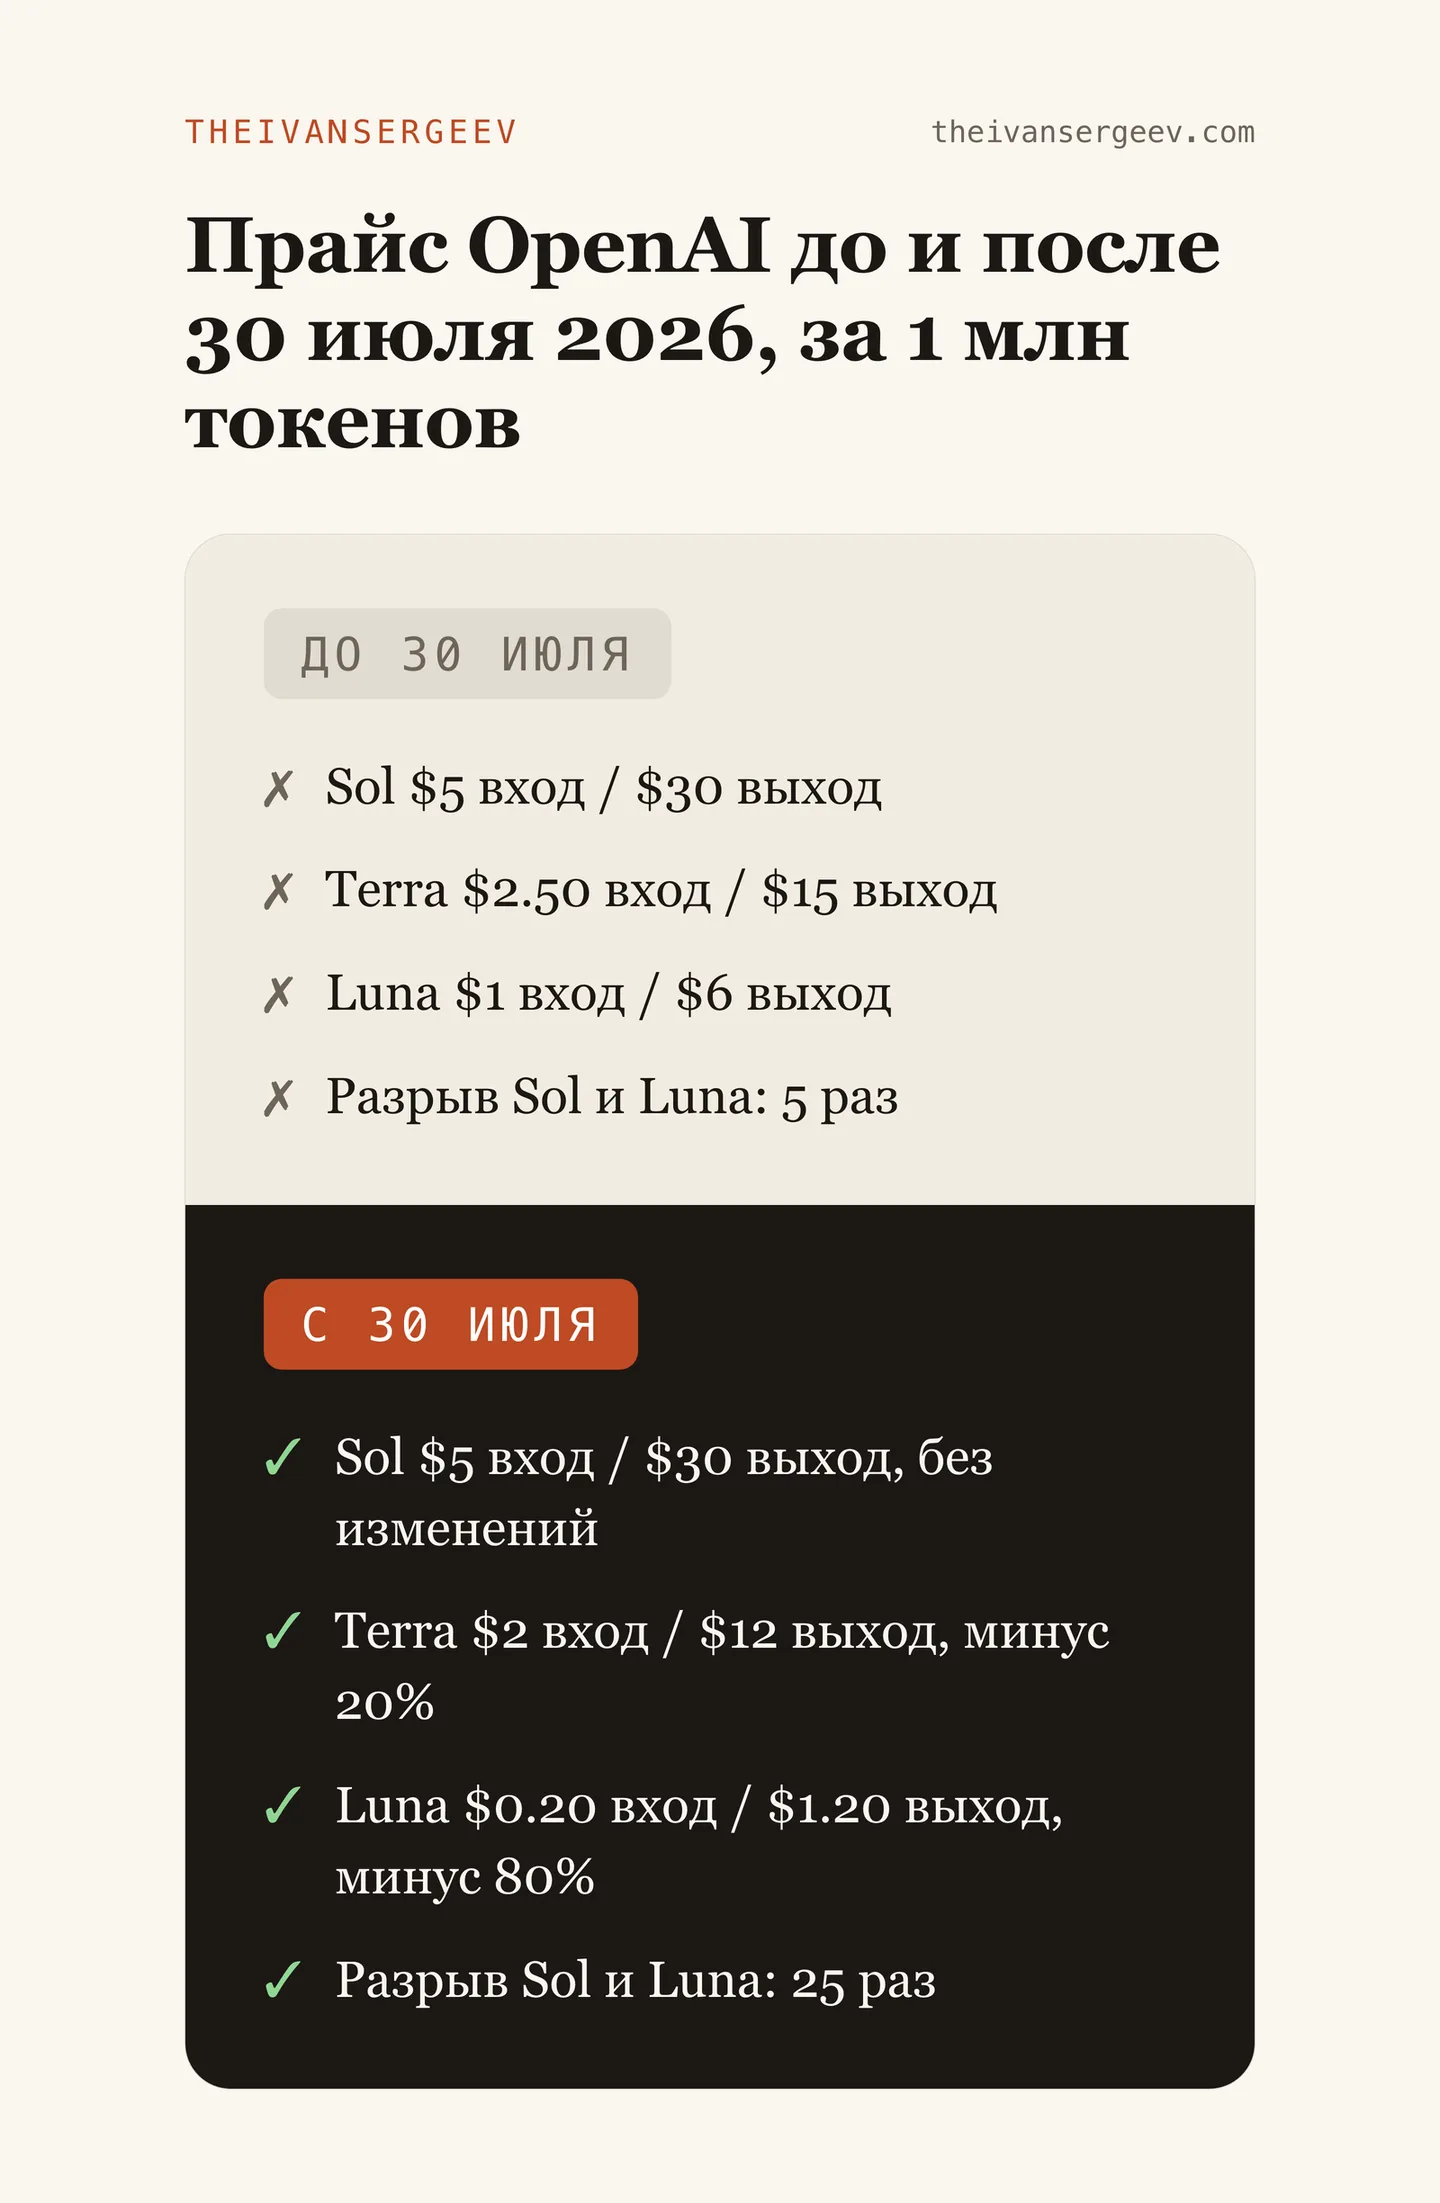
Следствий тут два. Любая арифметика выбора, посчитанная до 30 июля, устарела, и если ты выбирал модель месяц назад, посчитай заново. И дешёвая полка подешевела сильнее, чем дорогая, а значит выигрыш от «спустись на тир ниже и проверь» стал больше, чем был. Раньше экономия была в пять раз, теперь в двадцать пять
Отсюда пункт, который я дописал в своё правило выбора: перечитывать прайс раз в месяц. Цены на модели за 2026 год ходят только вниз, и привычка «я же помню, сколько это стоит» обходится дороже, чем пять минут на страницу тарифов
Что показывает Terminal-Bench 2.1 и почему цифры OpenAI выше независимых замеров?
Terminal-Bench 2.1 меряет, как модель работает в командной строке и с агентными задачами, то есть когда ИИ сам пошагово делает работу, а не только отвечает на вопрос. По цифрам OpenAI там Sol в режиме ultra выдаёт 91.9%, обычный Sol 88.8%, Terra 87.4%, Luna 84.7%. Независимые лаборатории на том же тесте получают заметно меньше
| Кто мерил | Что получилось |
|---|---|
| OpenAI, свои цифры | Sol ultra 91.9% · Sol 88.8% · Terra 87.4% · Luna 84.7% · Claude Mythos 5 88.0% |
| vals.ai, прогон от 1 августа | Sol 85.77% · Luna 79.03% · GPT-5.5 76.40% · Claude Opus 5 84.64% |
| Artificial Analysis | Sol в режиме xhigh 89.5% · Terra в режиме max 88.0% · Claude Opus 5 89.1% |
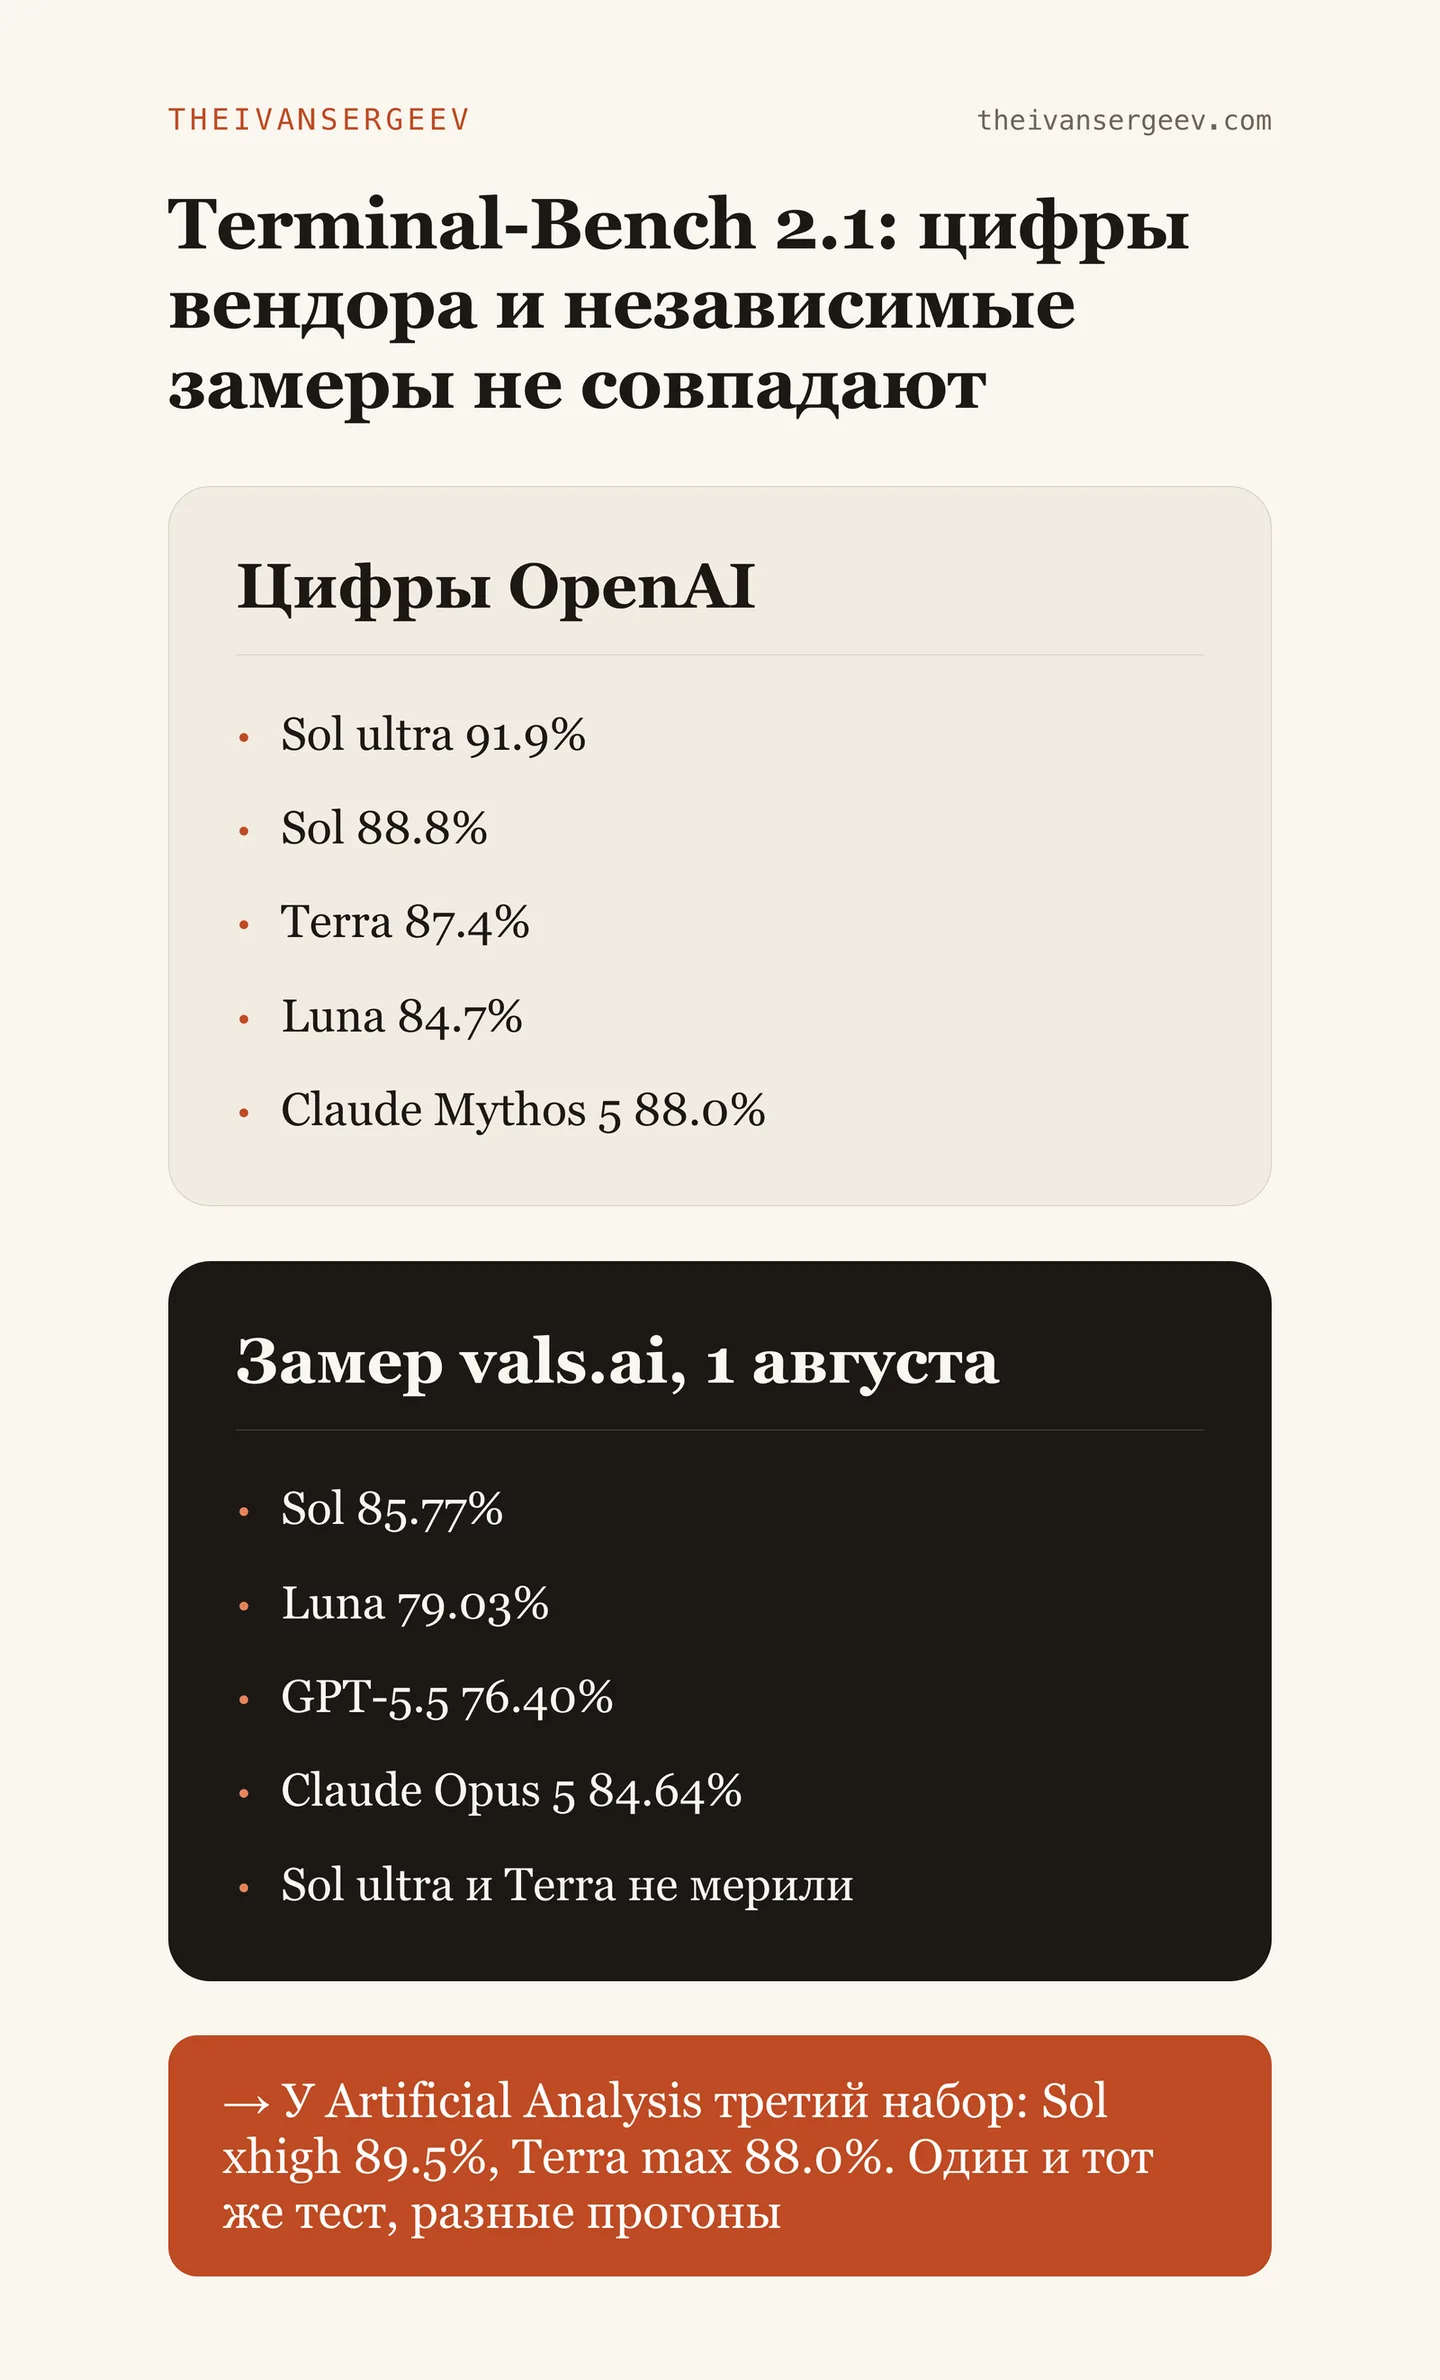
Три набора чисел на одном тесте это не чей-то обман, а нормальное состояние бенчмарков: у каждой лаборатории свой прогон, свои настройки усилия, свой способ считать отказы модели. У vals.ai рядом с результатом Claude Opus 5 прямо написано, что девять зачтённых задач спорные и при другом подсчёте балл падает с 84.64% до 81.27%. Вот столько весит методика
Читай не абсолютную цифру, а порядок моделей, и он во всех трёх замерах одинаковый: верхняя полка выше средней, средняя выше дешёвой, разрыв внутри семейства мал по сравнению с разрывом в цене. Числа GPT-5.5 я в эту статью не тащу: три источника дают ему 76.40%, 85.6% и 88.0%, а утверждение, у которого разброс в двенадцать пунктов, утверждением не является
Чем режим max отличается от ultra и почему их дали только Sol?
Режим max разрешает Sol думать над задачей дольше, ultra запускает четыре агента параллельно, и они дробят большой проект на куски. Именно в ultra Sol и выбивает свои 91.9%, то есть плюс 3.1 процентного пункта к обычному прогону, но и токенов такой прогон съедает кратно больше
Отличаются они тем, ЧТО именно ты покупаешь за лишние токены. В max ты покупаешь время на размышление у одного исполнителя. В ultra ты покупаешь параллельную бригаду: задача рубится на части, части идут одновременно, результат собирается обратно. На многошаговом проекте это даёт и балл выше, и ответ раньше, на коротком вопросе не даёт ничего
Оба режима открыты только у Sol. У Terra и Luna их нет, и это ровно тот случай, когда отсутствие функции не дефект: полка под поток не должна уметь думать неделю над одним сообщением. Если ты не пишешь сложный код и не ведёшь ресёрч, max и ultra тебе не понадобятся вообще. Включать ultra на подписи к посту это как гонять на грузовике за хлебом
Как разложить свои задачи на три класса и подобрать под них тир?
Разложи всё, что ты отдаёшь ИИ, на три класса: тяжёлое и редкое, объём бизнес-задач, массовая рутина. Верхний тир берётся только под первый класс, средний под второй, дешёвый под третий. Это и есть то, ради чего написана статья: названия сменятся, а три класса останутся
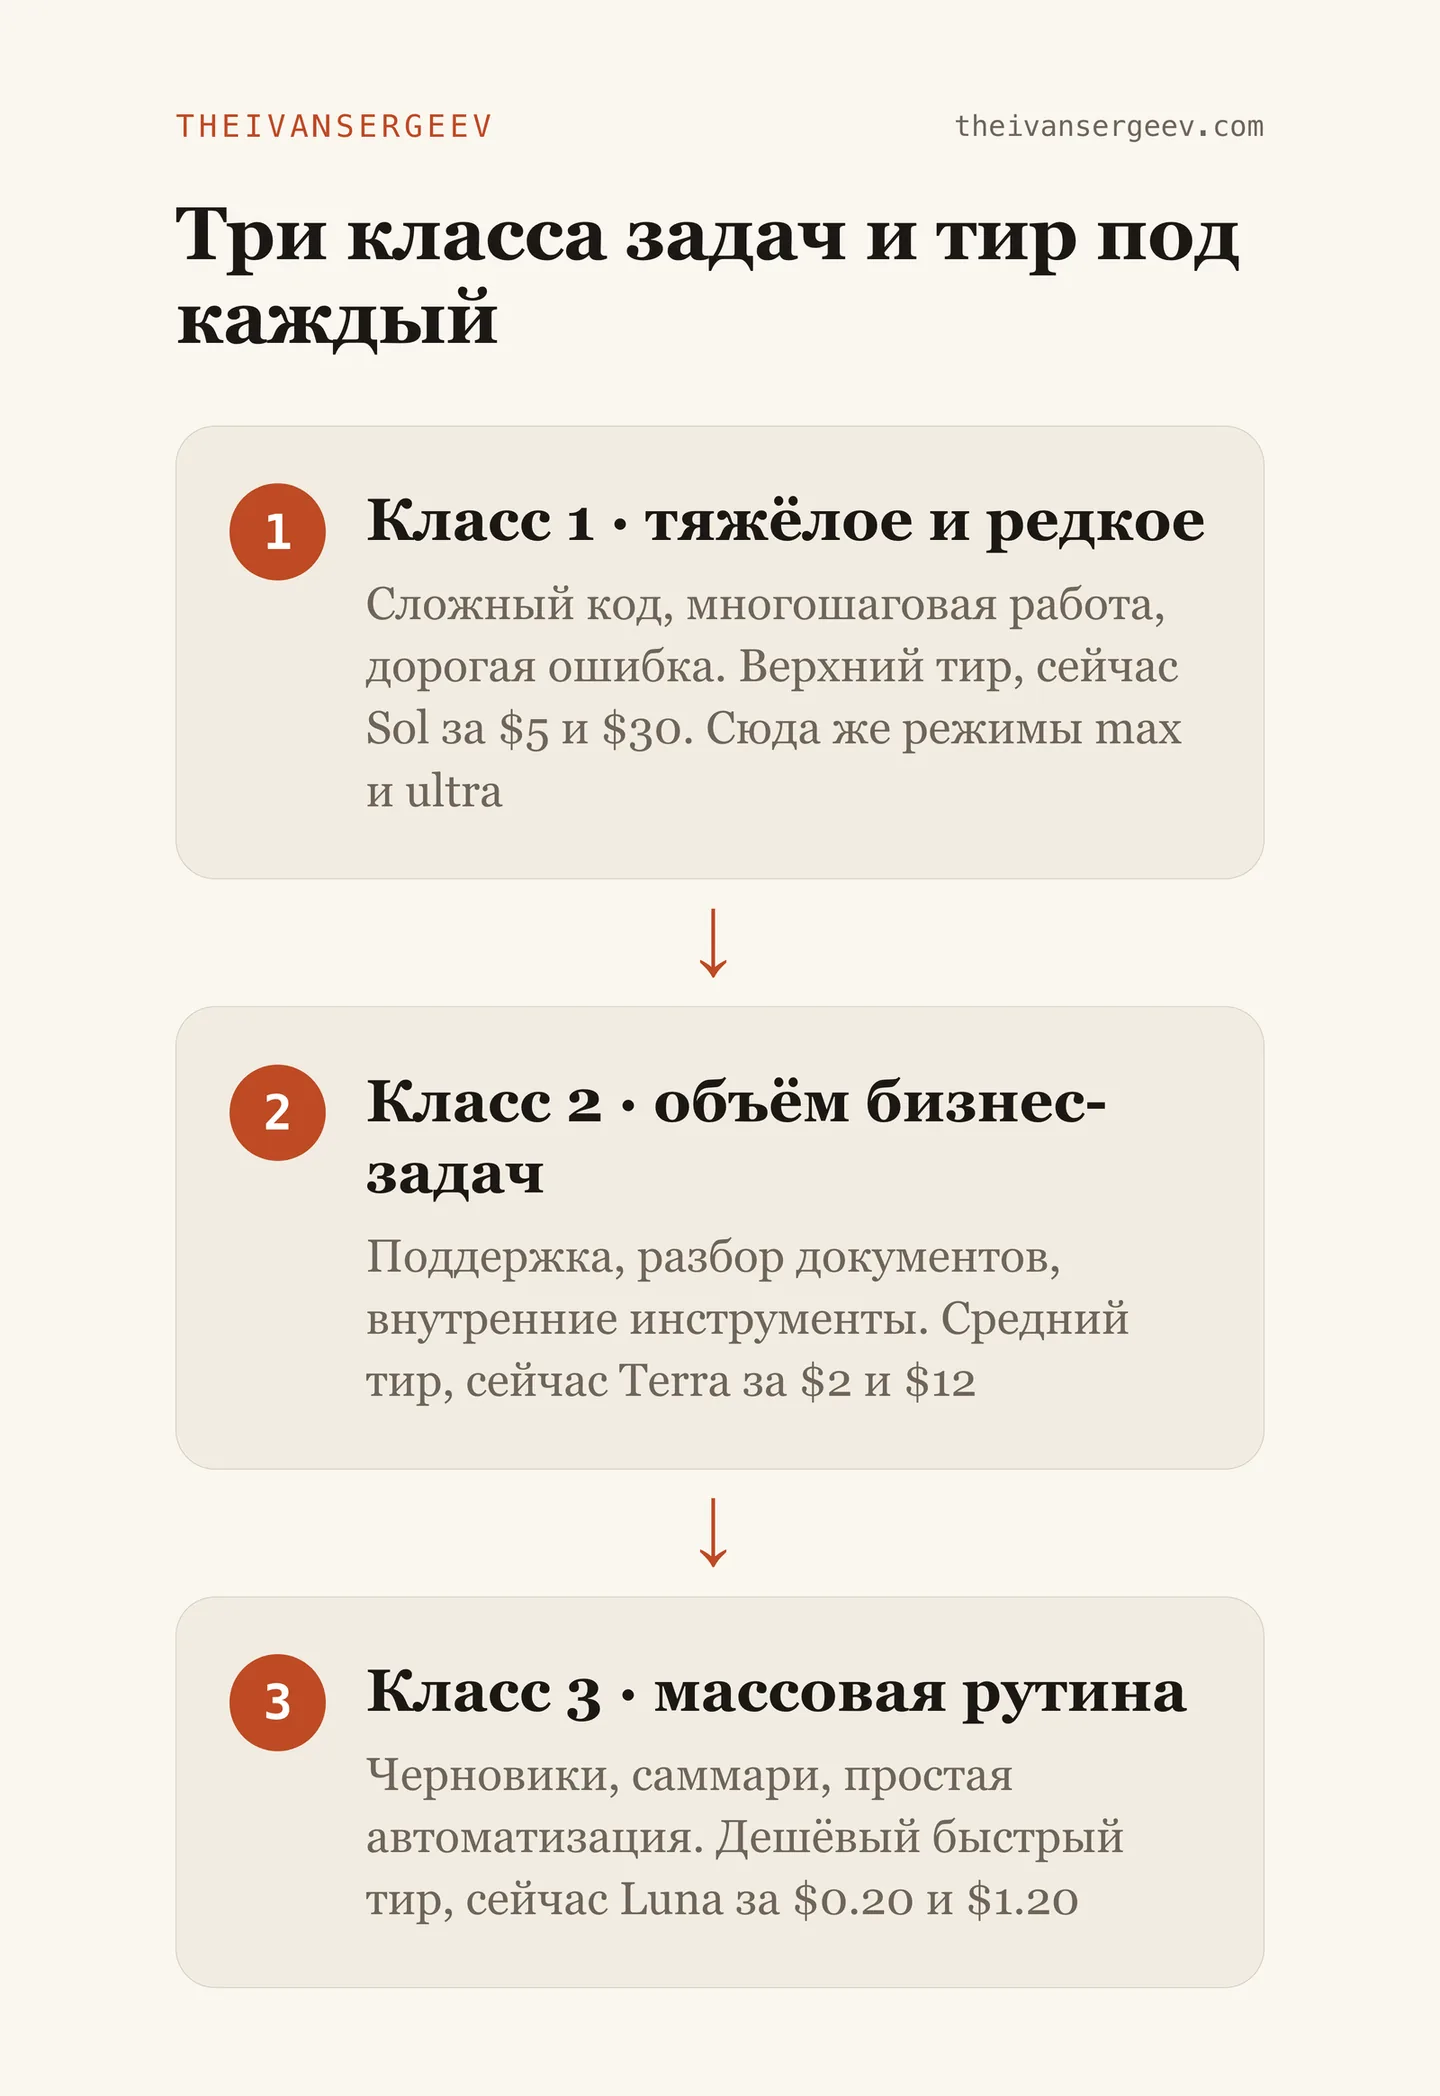
Класс 1, тяжёлое и редкое. Сложный код, многошаговая работа, задачи, где ошибка дорого стоит. Таких задач у тебя немного, и именно на них не жалко заплатить за максимум, включая режимы max и ultra
Класс 2, объём бизнес-задач. Поддержка, разбор документов, внутренние инструменты, всё что идёт потоком и должно быть надёжным, но не требует гениальности. Средний тир держит баланс цены и силы
Класс 3, массовая рутина. Черновики постов, короткие саммари, простая автоматизация, всё где скорость и цена важнее последнего процента качества. На этой полке экономия самая большая: после снижения 30 июля прогон стоит в двадцать пять раз дешевле флагманского
Готовое правило, скопируй себе
# Как выбрать модель ИИ под задачу

1. Спроси: к какому классу относится задача?
   - тяжёлое и редкое (сложный код, ресёрч, дорогая ошибка) -> верхний тир
   - объём бизнес-задач (поддержка, документы, инструменты)  -> средний тир
   - массовая рутина (черновики, саммари, автоматизация)      -> дешёвый быстрый тир

2. Начни с самого дешёвого тира, который класс задачи позволяет.
   Не хватило качества - поднимись на тир выше. А не наоборот.

3. Спецрежимы (max / ultra) включай ТОЛЬКО под класс 1.
   На рутине они жгут деньги без пользы.

4. Прайс перечитывай раз в месяц: 30 июля Luna подешевела на 80%
   за одну ночь, и вся арифметика выбора поехала.
Главная ошибка новичка это брать флагман на всё подряд, потому что «он же лучший». На черновике для рилса разницу между флагманом и дешёвой моделью ты не заметишь, а счёт вырастет в двадцать пять раз. Бери под класс задачи, а не по названию
Сколько выходит по счёту: 10 млн токенов на каждой из трёх моделей
Возьмём один и тот же прогон, 10 млн токенов входа и 2 млн выхода, и посчитаем по августовскому прайсу: Sol выходит в $110, Terra в $44, Luna в $4.40. Считается в лоб, вход умножаем на цену входа, выход на цену выхода, складываем
| Модель | Вход 10 млн | Выход 2 млн | Итого за прогон | Terminal-Bench 2.1 |
|---|---|---|---|---|
| Sol | $50 | $60 | $110 | 88.8% |
| Terra | $20 | $24 | $44 | 87.4% |
| Luna | $2 | $2.40 | $4.40 | 84.7% |
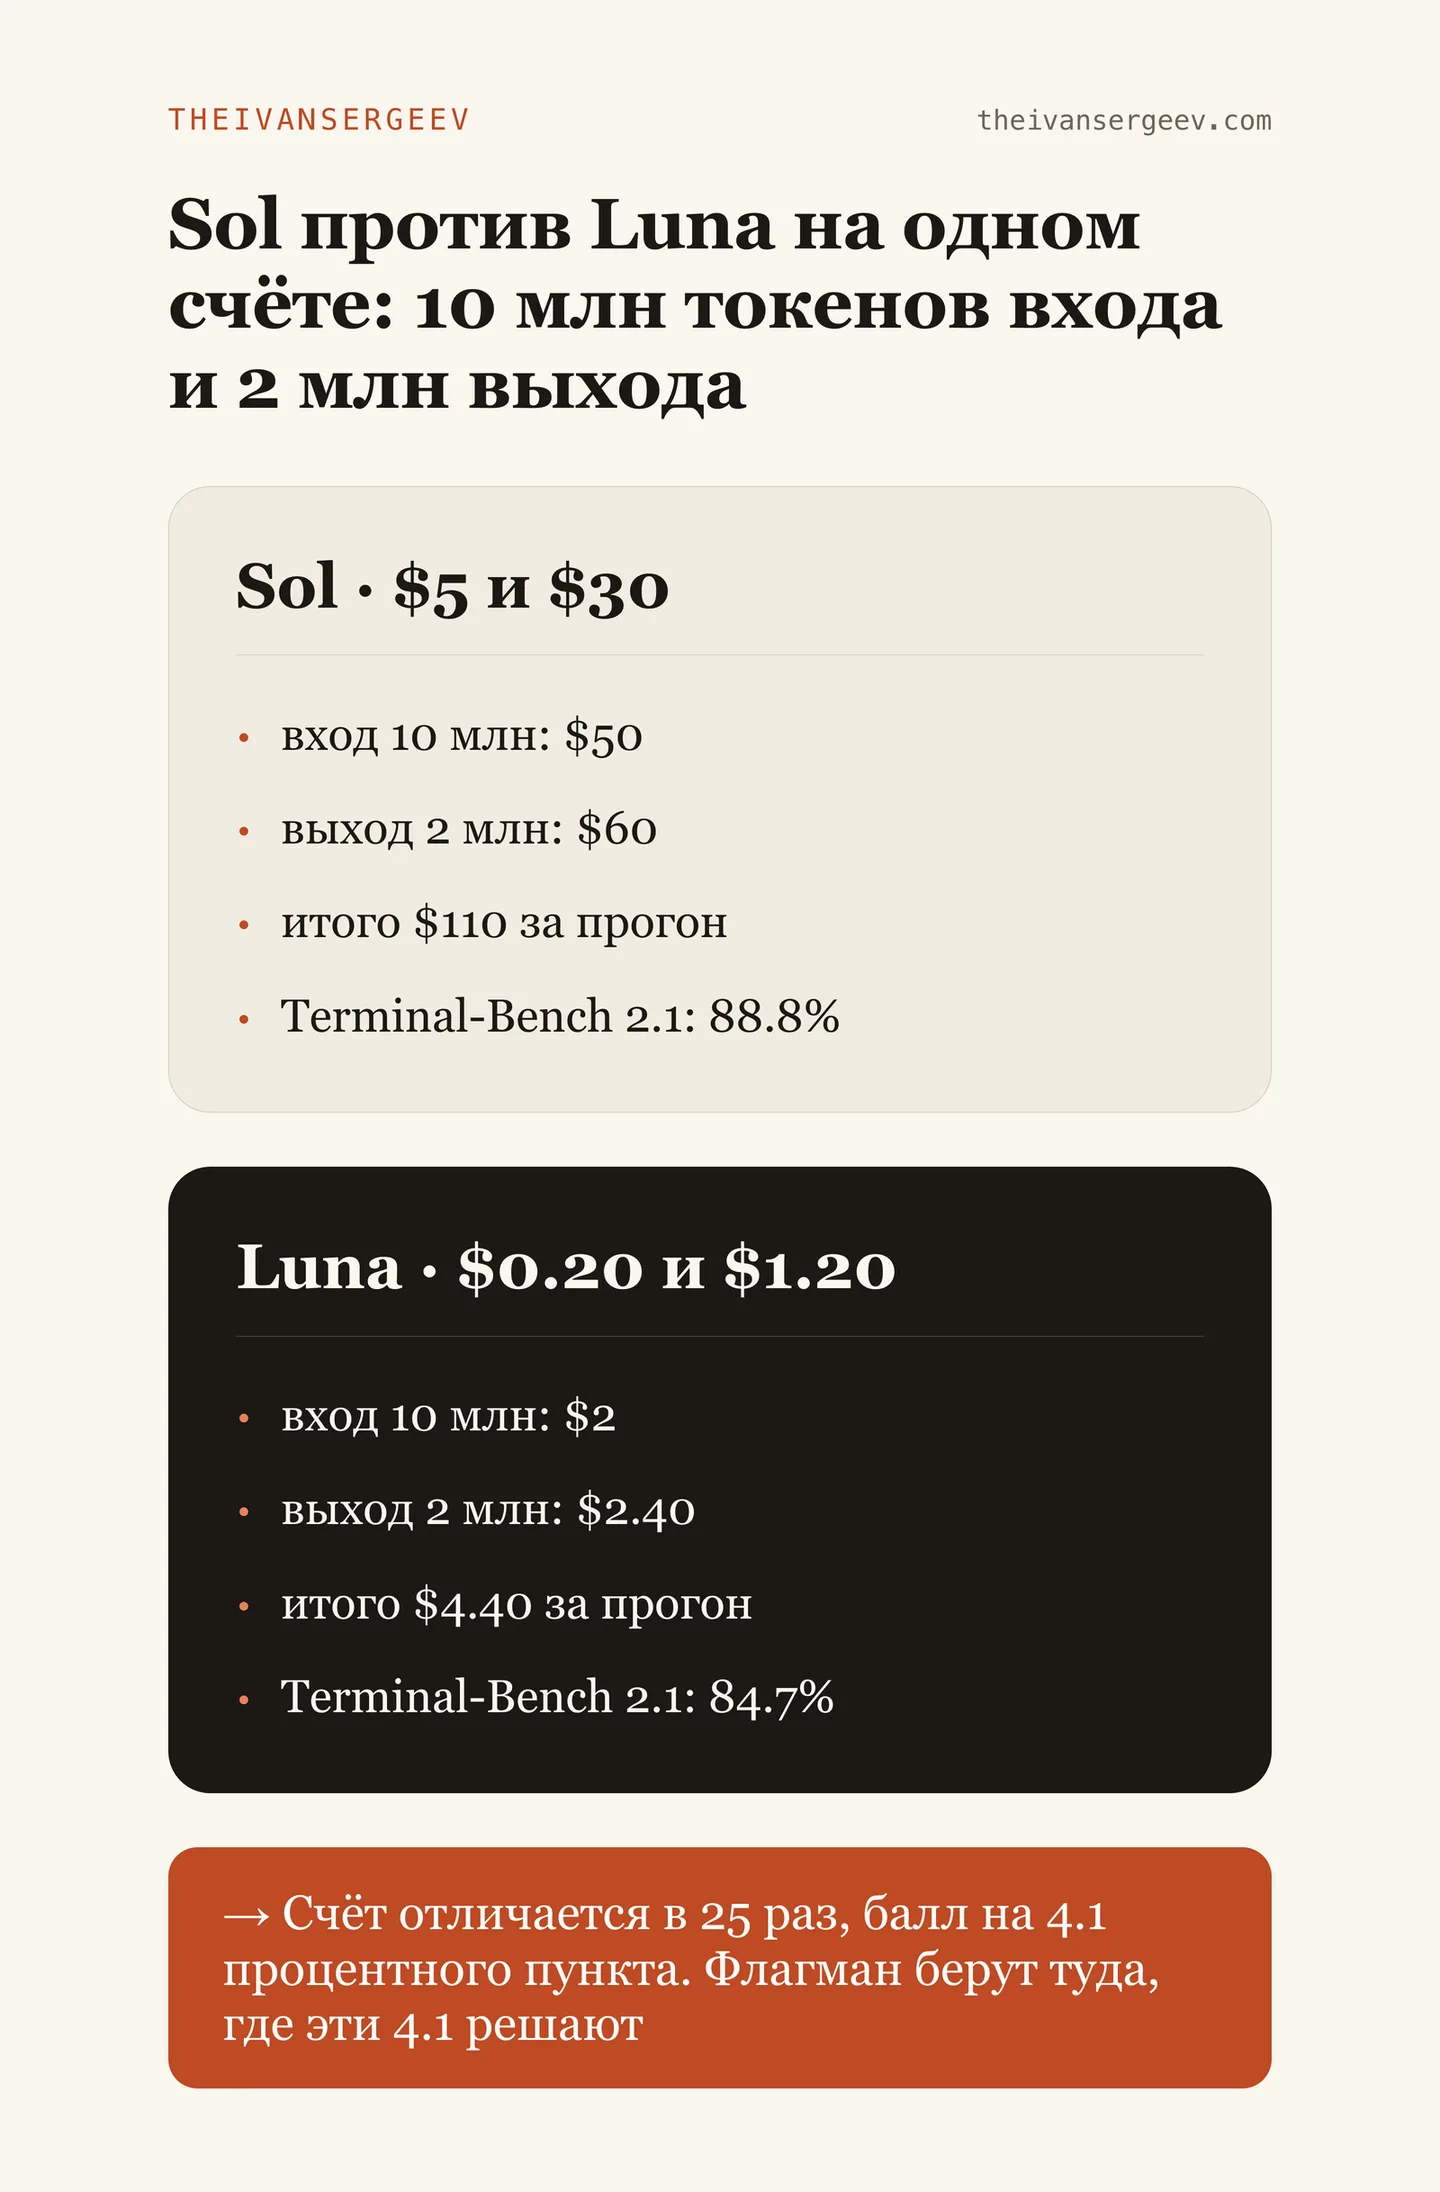
Между Sol и Terra по счёту разница в два с половиной раза, а по баллу 1.4 процентного пункта. Между Sol и Luna по счёту разница в двадцать пять раз, а по баллу 4.1 пункта. Дальше вопрос простой: твоя задача из тех, где эти 4.1 пункта решают, или из тех, где ты их не заметишь
Если каждый месяц у тебя двадцать таких прогонов, цена ошибки в выборе полки становится видимой невооружённым глазом: $2200 против $88. И это ещё без режима ultra, который на той же работе съедает токенов кратно больше
На каких задачах Sol это переплата, а на каких он окупается?
Sol оправдан там, где задача многошаговая и цена ошибки выше $110 за прогон: продакшен-код, безопасность, деньги. На подписи к посту, на саммари встречи и на простой автоматизации это переплата в двадцать пять раз, потому что Luna сделает то же самое и разницы ты не увидишь
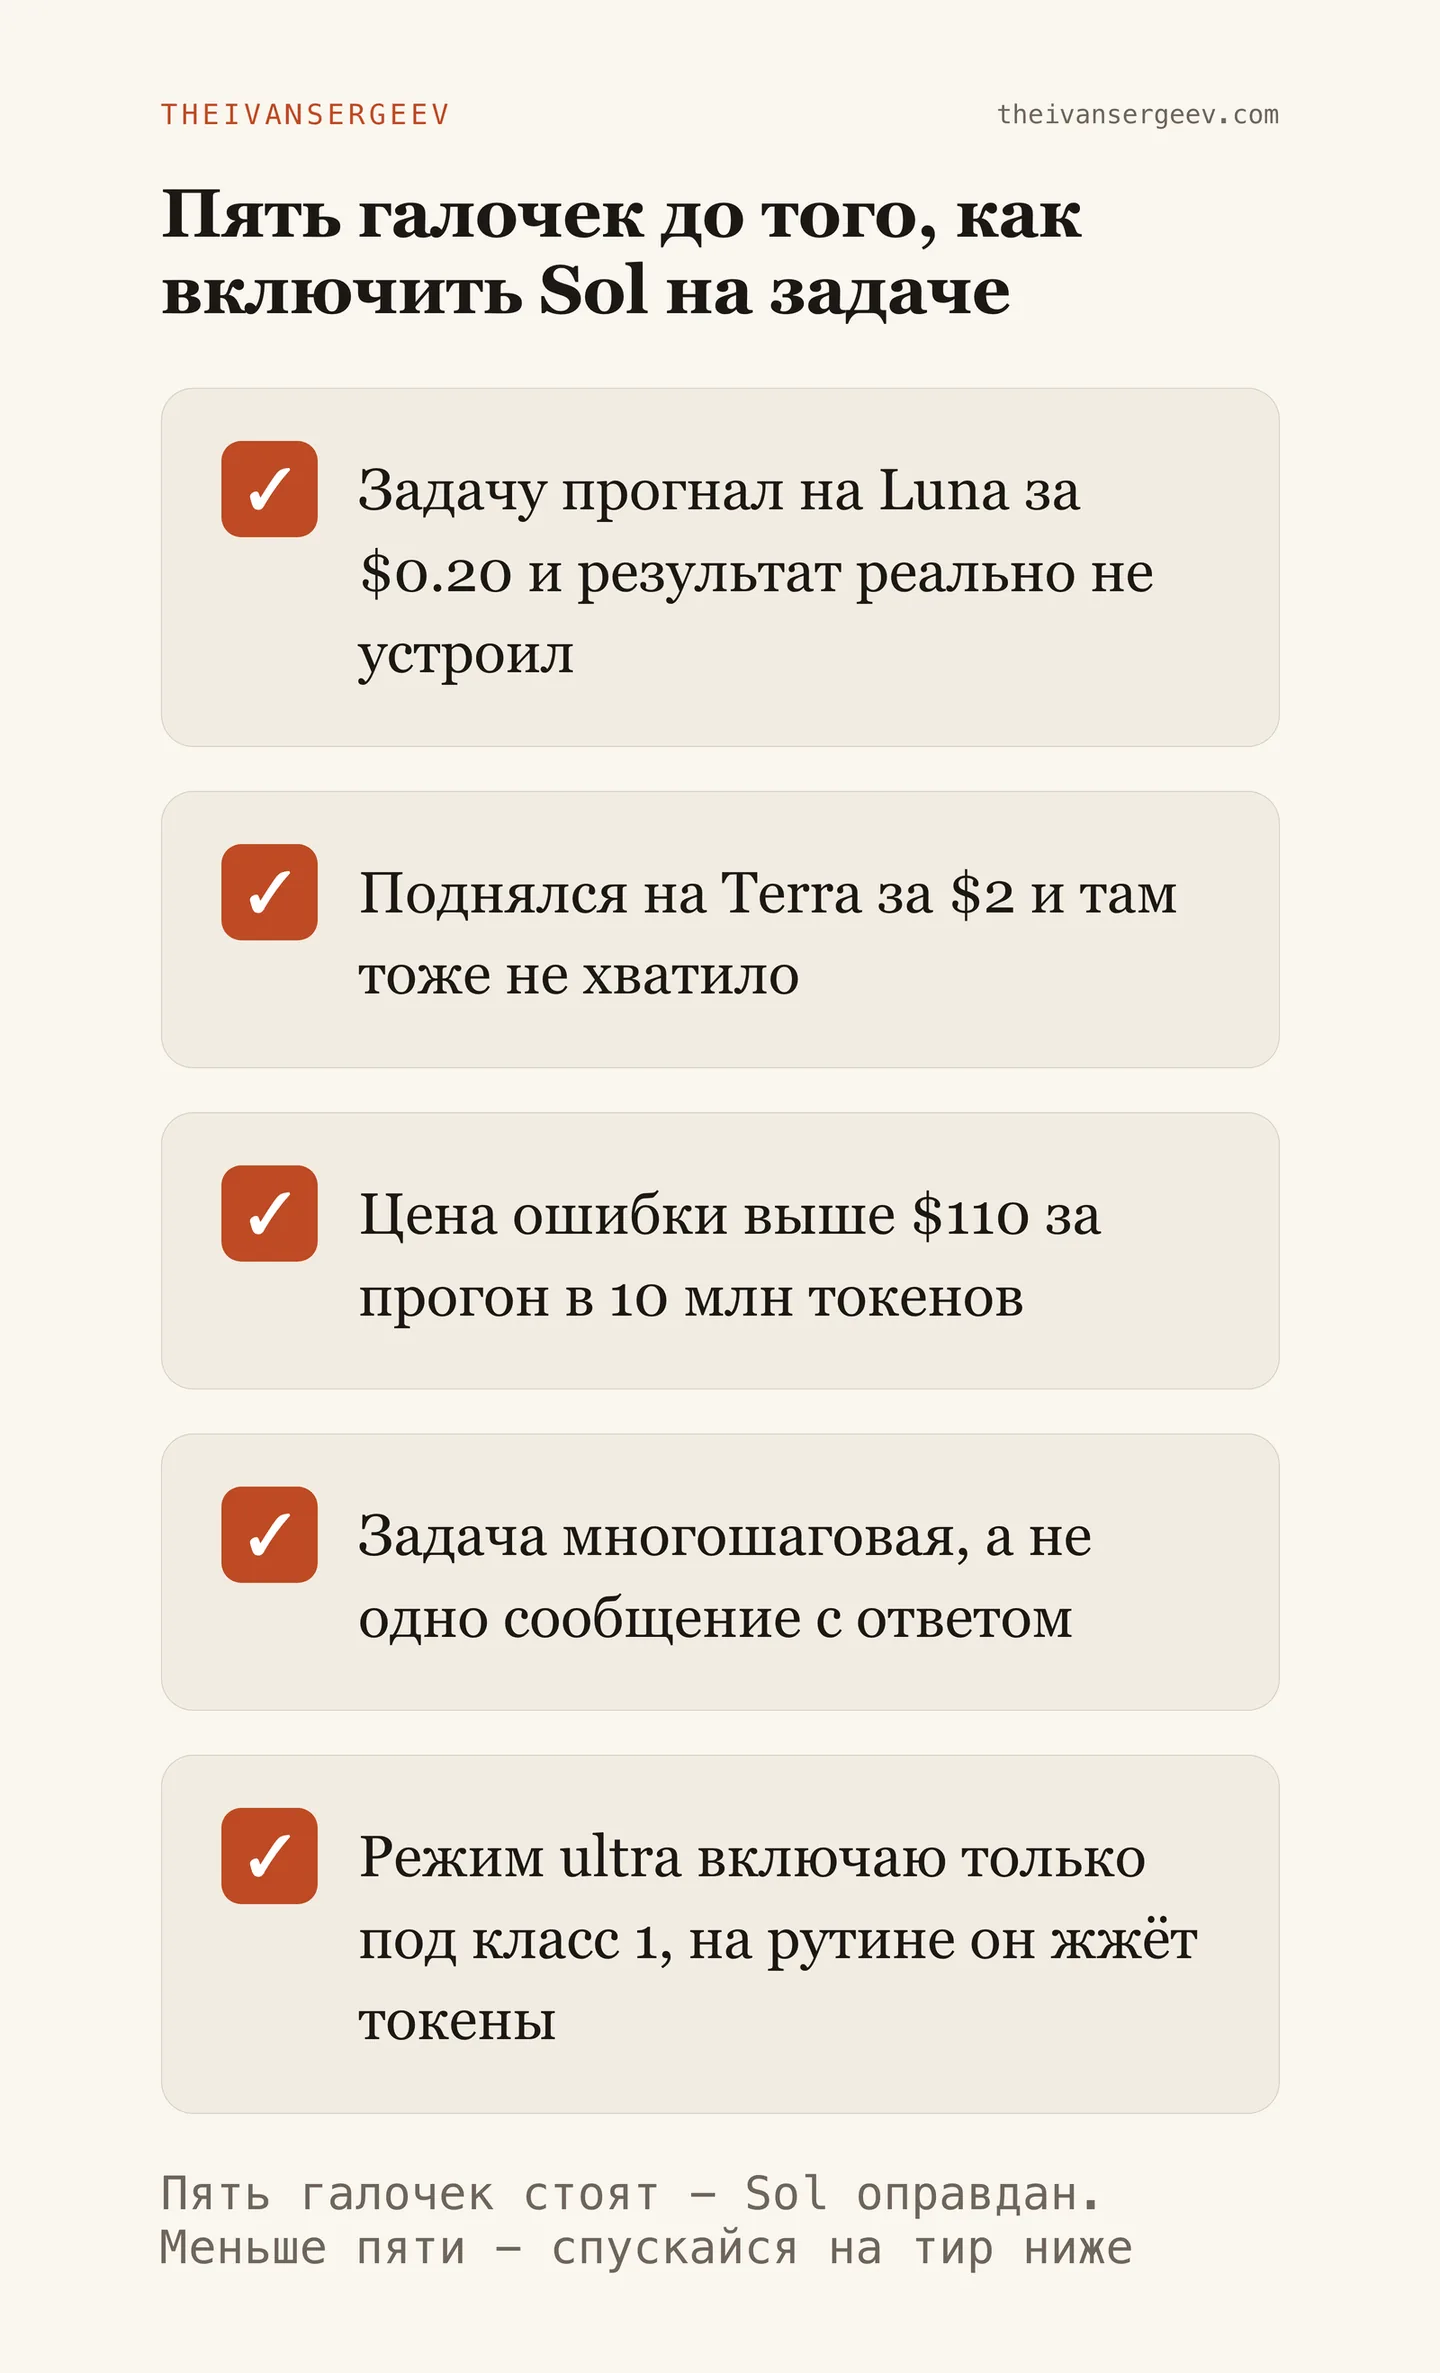
Порядок проверки идёт снизу вверх, а не сверху вниз. Сначала прогоняешь задачу на дешёвой полке, потому что это $4.40, и только если результат не устроил, поднимаешься на среднюю. Люди делают наоборот: берут флагман, получают приемлемый результат и никогда не проверяют, справилась бы дешёвая модель. Проверка стоит четыре доллара, незнание стоит сотню за прогон
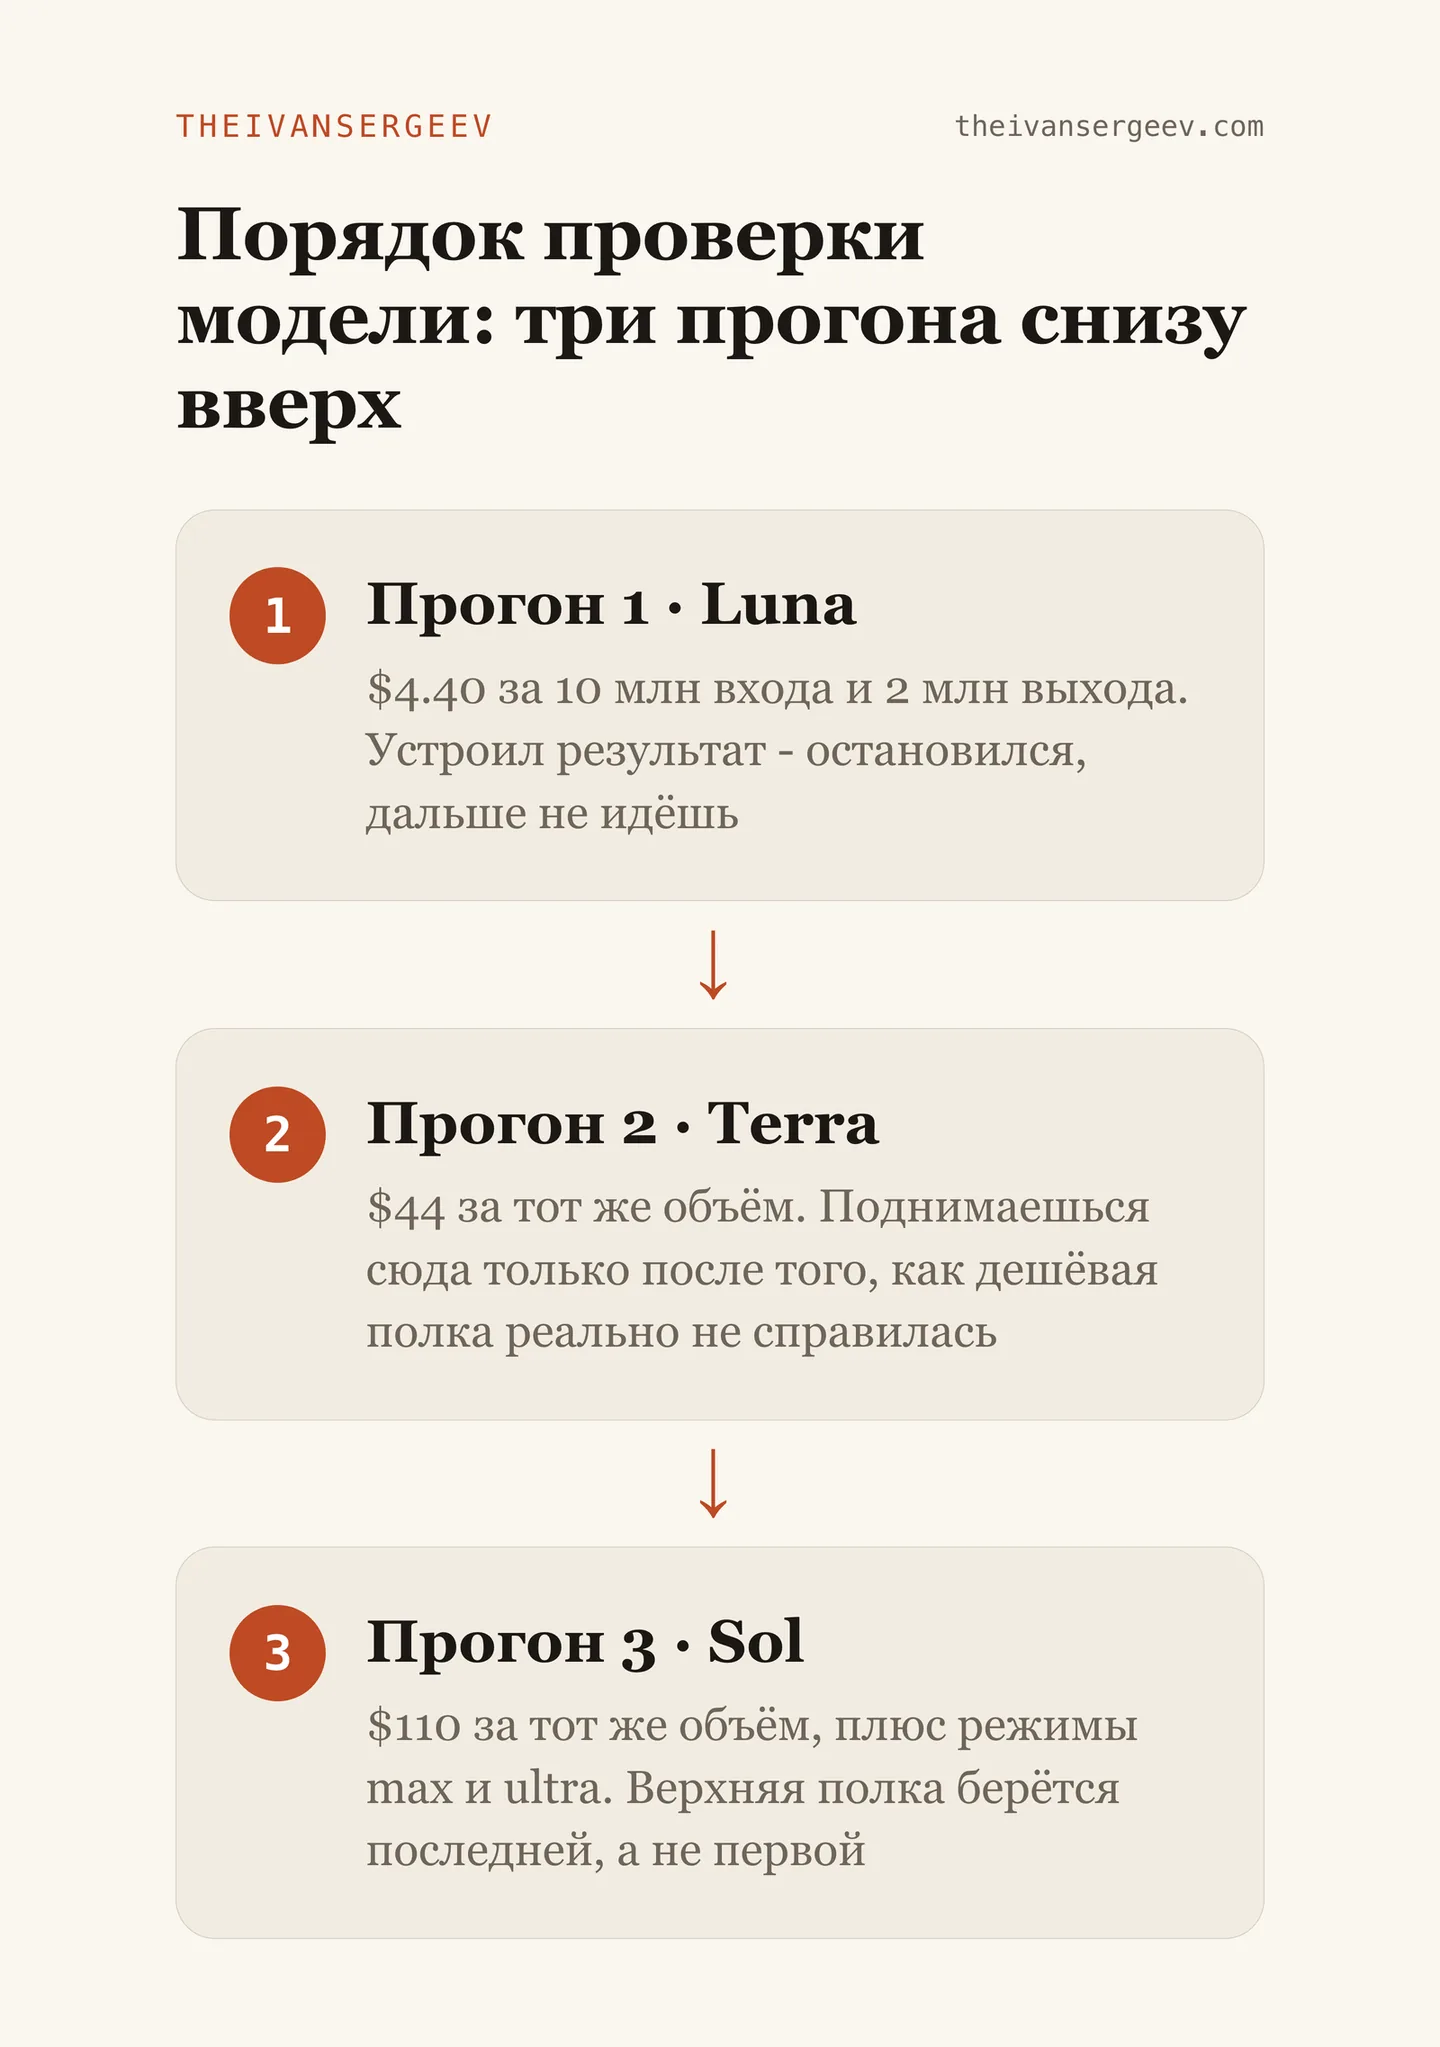
Тут не про жадность, а про здравый смысл. Дорогая модель сама по себе не делает твой контент или продукт лучше. Лучше их делает то, КАК ты с моделью работаешь: какую задачу ставишь, как формулируешь, как встраиваешь в процесс. А это уже не про выбор модели
Почему правило выбора переживёт и Sol, и Terra, и Luna?
Три полки это не изобретение OpenAI, а форма, к которой сходятся все производители: у Anthropic та же лестница, у Google та же. Поэтому правило «класс задачи определяет полку» работает и с моделью, которой ещё не существует, а знание конкретных цифр устаревает за месяц, что и показало 30 июля
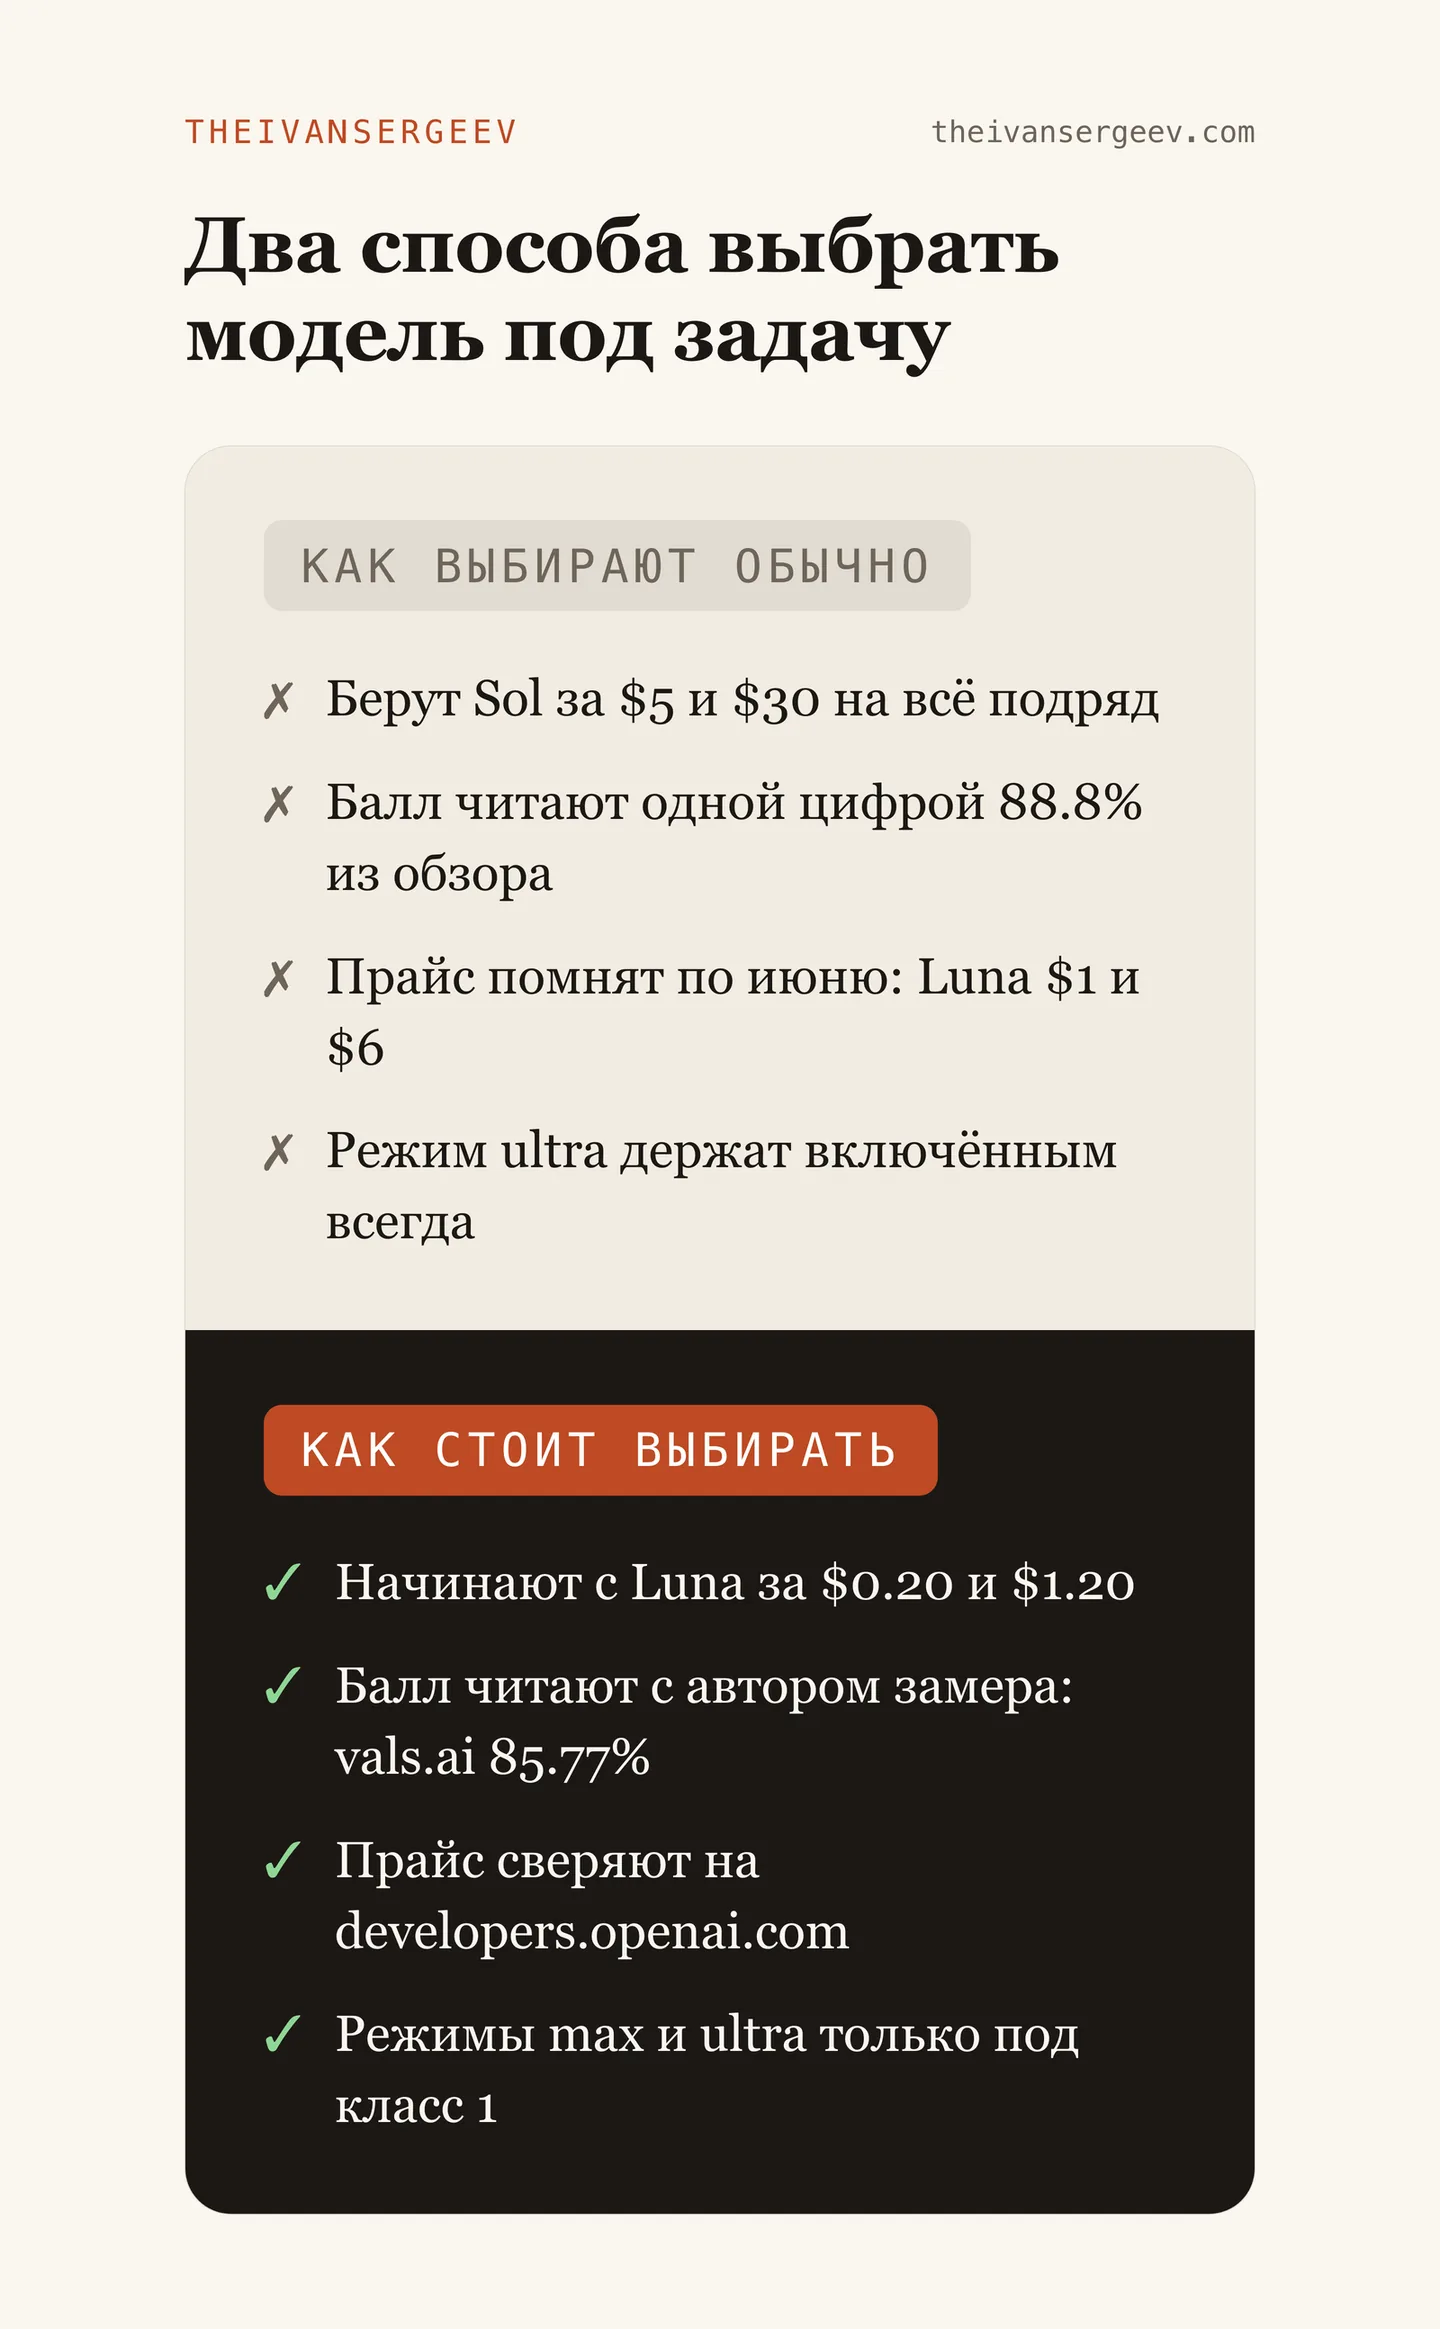
Открой прайс любого производителя и посмотри, сколько у него уровней и какой между ними разрыв по цене. Дальше подставь свои три класса задач. Названия в таблице будут другие, а решение, которое ты примешь, будет тем же самым
Именно поэтому я не советую заучивать, что Sol это $5, а Luna это $0.20. Через полгода эти числа будут другими, и по обеим позициям вниз. Заучивать стоит порядок действий: класс задачи, самая дешёвая полка, которая класс тянет, проверка результата, подъём на полку выше только если не хватило
Где пробовать модели: браузерный чат или редактор с агентом?
Полки расходятся только на агентных задачах, а в браузерном чате ты их не поставишь: там модель отвечает текстом и не трогает файлы. Чтобы проверить правило выбора на своей работе, нужна среда, где ИИ получает задачу, файлы и команды. Я и мои ученики работаем в Claude Code внутри редактора VS Code, ставится бесплатно
Устроить то же самое на моделях OpenAI можно прямо в редакторе, это разобрано отдельно: GPT-5.6 в VS Code. Если ты вообще не ставил ни одного агента, начни с базы, там весь маршрут по шагам: Claude Code, что это и как пользоваться
Дальше начинается то, из-за чего вся эта арифметика вообще имеет смысл. Выбрать полку это первый сантиметр пути, а результат приносит система: как из модели собрать производство контента, как поставить ролики и посты на поток, как этим инструментом собрать продукт, который приносит деньги. Систему я собираю на ИИ-Лагере, там же разбираю свои прогоны по деньгам
Источники
Цены и баллы сверены по первоисточникам 3 августа 2026 года:
- Официальный прайс OpenAI API - актуальные цены за миллион токенов по gpt-5.6-sol, gpt-5.6-terra и gpt-5.6-luna
- vals.ai, Terminal-Bench 2.1 - независимый прогон бенчмарка от 1 августа 2026 с оговорками по подсчёту отказов
- Artificial Analysis, Terminal-Bench v2.1 - третий независимый замер того же теста с разбивкой по режимам усилия
- OpenRouter, gpt-5.6-terra - доступность модели у посредника, контекст и цена со скидкой
- Vellum, разбор трёх тиров GPT-5.6 - дата и размер снижения цен 30 июля 2026, баллы Terra и Luna, четыре агента в режиме ultra
- Eden AI, гайд по GPT-5.6 Sol - цифры OpenAI по Terminal-Bench 2.1 и дата анонса 26 июня 2026
Что проверить до того, как поставишь модель на поток
Семь пунктов закрыты - выбор сделан по цифрам, а не по названию модели
Сохрани себе
- Прайс открыт на developers.openai.com и сверен сегодня, а не по обзору из поиска
- Свои задачи разложены на три класса: тяжёлое и редкое, объём, рутина
- Задача прогнана на дешёвой полке ($4.40 за 10 млн входа) до того, как взят флагман
- Посчитан счёт за месяц по всем трём полкам, а не за один прогон
- Режимы max и ultra включены только под класс 1, на рутине выключены
- Балл бенчмарка взят с указанием, кто мерил: цифры вендора и vals.ai расходятся
- В календаре стоит напоминание перечитать прайс через месяц
Бесплатный ИИ-Лагерь
Полку под задачу ты выбирать научился. Дальше собираем на ней то, что приносит деньги
Между «понял, какую модель брать» и «у меня работает производство контента» лежит система: как поставить ролики и посты на поток, как собрать продукт, как сделать запуск. Это и есть программа Лагеря, по шагам и с разборами
Бесплатно · в браузере без VPN · живые эфиры. Вступай в закрытый канал - бот сразу пришлёт путёвку в ИИ-Лагерь тебе в личку
Частые вопросы
Какая модель GPT-5.6 самая дешёвая и сколько она стоит?
Luna: $0.20 за миллион входных токенов и $1.20 за миллион выходных по прайсу на 3 августа 2026 года. Это в двадцать пять раз дешевле флагманской Sol, у которой $5 и $30. До 30 июля Luna стоила $1 и $6, цену срезали на 80%
Чем Terra отличается от Sol, если по баллам разница маленькая?
По цифрам OpenAI на Terminal-Bench 2.1 у Sol 88.8%, у Terra 87.4%, то есть 1.4 процентного пункта. По деньгам разница в два с половиной раза: $5 и $30 против $2 и $12. Плюс у Terra нет режимов max и ultra, они открыты только у Sol
Что такое режим ultra и когда его включать?
В режиме ultra Sol по умолчанию ведёт четыре агента параллельно: большая задача дробится на куски, куски идут одновременно. На Terminal-Bench 2.1 это даёт 91.9% против 88.8% у обычного прогона. Токенов такой прогон съедает кратно больше, поэтому включать его стоит только под сложный многошаговый проект
Почему баллы бенчмарка у разных источников не совпадают?
У каждой лаборатории свой прогон, свои настройки усилия и свой способ засчитывать отказы модели. На том же Terminal-Bench 2.1 vals.ai в прогоне от 1 августа даёт Sol 85.77%, а Artificial Analysis для Sol в режиме xhigh 89.5%. Читать стоит порядок моделей, он у всех совпадает, а не абсолютную цифру
Можно ли пользоваться Sol, Terra и Luna из России?
Модели раздаются через API OpenAI и через посредников вроде OpenRouter, то есть доступ зависит от того, как оплачен твой доступ к API, а не от самой модели. Разбор способов доступа и оплаты я держу отдельно от этой статьи, потому что условия там меняются чаще, чем прайс на модели
Устареет ли это правило выбора, когда выйдет следующее поколение?
Названия устареют, правило нет. Трёхуровневая линейка это форма, к которой пришли все крупные производители, поэтому «класс задачи определяет полку» работает и с моделью, которой ещё нет. Устаревают именно цифры: прайс за 2026 год двигался только вниз, последний раз 30 июля
Иван Сергеев
Соло-предприниматель на базе ИИ. Собираю продукты и маркетинг командами по-русски, без программистов, и считаю деньги на прогонах
Читайте также
Фронтир модели: что это и как выбрать
Чем верхний тир отличается от остальных и когда он вообще нужен
GPT-5.6 в VS Code: вайбкодинг с нуля
Как поставить эти модели в редактор и проверить полки на своей работе
Claude Code: что это и как пользоваться
Агент в редакторе: чем отличается от чата и что собирают им первым
ИИ-агенты: что это и как собрать своего
Где начинаются агентные задачи, на которых полки и расходятся