ChatGPT и источники · механика изнутри
Как ChatGPT выбирает источники: разбор 3 ботов OpenAI
ChatGPT не читает весь интернет каждый раз, когда отвечает. У него работают три отдельных робота с разными задачами, и по документации OpenAI (проверено живым запросом 04.09.2026) только один решает, что покажет ChatGPT источником прямо в диалоге. И у него есть слабое место: без готового списка страниц от Bing он часто не процитирует даже открытую для него страницу
К концу статьи ты будешь знать: как называются все три бота OpenAI и чем они занимаются, как за одну минуту проверить, пускает ли твой сайт нужного из них, почему одного открытого robots.txt мало и что ещё нужно, чтобы ChatGPT вообще заметил твою страницу
Открой свой robots.txt (адрес твой-сайт.ru/robots.txt) и проверь глазами, разрешены ли там строки OAI-SearchBot и ChatGPT-User - именно эти два бота решают, увидит ли ChatGPT твою страницу вообще, третий бот GPTBot к живым ответам отношения не имеет
Три бота ChatGPT - и только один ищет ответ на твой вопрос
У OpenAI три разных робота-обходчика, и они называются по-разному не для красоты - каждый занят своим делом, и правило "открыт для одного - открыт для всех" тут не работает
GPTBot. Собирает тексты по всему интернету, чтобы на них потом ОБУЧАЛАСЬ будущая версия модели - как студент, который читает учебники заранее, до экзамена. К тому, что ChatGPT покажет тебе СЕГОДНЯ в диалоге как источник, этот робот отношения не имеет: он не ищет ответ на твой вопрос, он копит материал на будущее
OAI-SearchBot. Вот это и есть тот самый робот, который ищет ответ на конкретный вопрос ПРЯМО СЕЙЧАС и решает, какую страницу процитировать в диалоге. По официальной формулировке OpenAI: сайты, закрывшие доступ именно этому боту, не покажутся в поисковых ответах ChatGPT - даже если та же страница отлично видна в обычном поиске Google или Яндекса
ChatGPT-User. Выполняет прямую просьбу живого человека внутри диалога - когда ты сам просишь "открой вот эту ссылку и перескажи мне" или пользуешься встроенным помощником с доступом к конкретному сайту. Это не самостоятельный обход интернета, а разовое поручение по твоей же команде
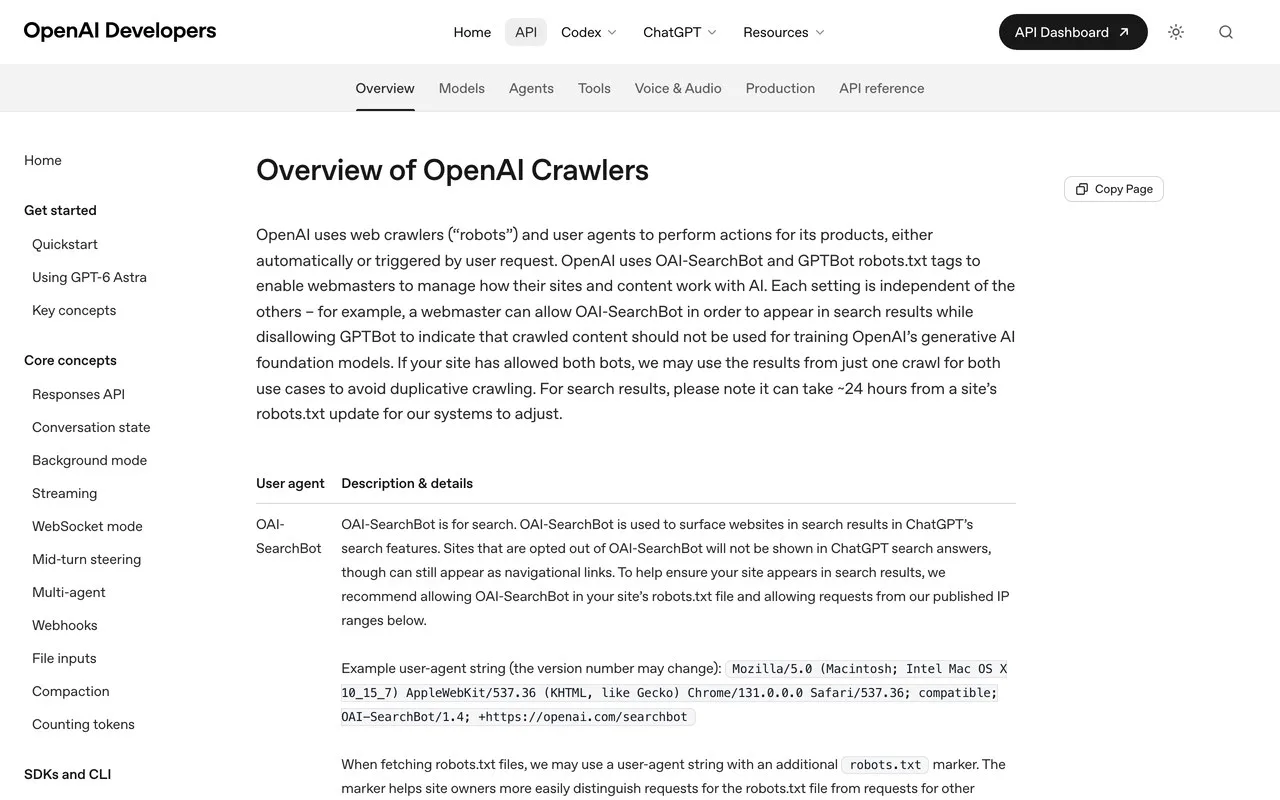
Отсюда практический вывод: если тебе важно, чтобы ChatGPT цитировал твои страницы в живых ответах, смотреть нужно конкретно на OAI-SearchBot, а не на GPTBot. Спутать их - частая ошибка, разбираю её отдельно ниже в разделе про частые ошибки
Три бота рядом: у кого какая работа и что с этим делать
Собрал разницу между ботами в одну таблицу, чтобы не листать три отдельных абзаца туда-обратно, когда нужно быстро вспомнить, кто из них что делает:
| Бот | Что делает | Влияет ли на сегодняшний ответ ChatGPT | Что сделать владельцу сайта |
|---|---|---|---|
| GPTBot | собирает тексты для обучения будущей модели | нет, это работа на будущее | не обязателен для сегодняшних цитат, но и закрывать без причины не стоит |
| OAI-SearchBot | ищет ответ на конкретный вопрос прямо сейчас | да, это и есть бот живого поиска | держать открытым в robots.txt - без этого цитат не будет вообще |
| ChatGPT-User | выполняет прямую просьбу человека внутри диалога | да, но только по разовой команде самого человека | ничего специально настраивать не нужно, страница открыта - работает |
Таблица прокручивается вбок →
Из таблицы видно главное: если тебе нужны живые цитаты твоего сайта в ответах ChatGPT, есть ровно одна строка, которая решает исход, - разрешение для OAI-SearchBot. Остальные два бота либо работают на будущее, либо срабатывают по отдельной команде человека
Проверь свой robots.txt: пускаешь ли ты вообще нужного бота
Файл robots.txt - это список правил на твоём же сайте, который говорит роботам, куда им можно заходить, а куда нельзя. Он лежит по прямому адресу: твой-сайт.ru/robots.txt - открывается в любом браузере, как обычная страница, ничего скачивать не нужно
Три шага, чтобы проверить у себя:
- Набери в браузере адрес своего сайта плюс
/robots.txt. Например,theivansergeev.com/robots.txt. Откроется страница с обычным текстом - не картинка, не файл для скачивания, а просто текстовые строчки - Найди глазами строку
User-agent: OAI-SearchBot. Это заголовок раздела для нужного тебе бота (Ctrl+F или Cmd+F по словуSearchBotнаходит её за секунду) - Посмотри, что написано в следующей строке.
Allow: /значит "заходи куда хочешь",Disallow: /значит "не заходи вообще" - если такого раздела нет совсем, большинство сайтов по умолчанию открыты, но лучше вписать явную строку самому, чтобы не зависеть от умолчаний хостинга
Так это выглядит у меня самого - я собственный robots.txt проверял живым запросом в тот же день, когда писал эту статью:
Я открыл свой собственный robots.txt живым запросом 04.09.2026: у меня явно прописаны все 3 бота OpenAI поимённо (GPTBot, OAI-SearchBot, ChatGPT-User), и у каждого стоит разрешение `Allow: /`
Если у тебя раздела с этими именами нет вообще - не паника, но и не гарантия: лучше добавить явную строку, чем полагаться на то, что хостинг настроил правильно по умолчанию
Что делать, если бот запрещён
Если строка Disallow: / стоит именно у OAI-SearchBot - это либо решение прошлого владельца сайта, либо настройка хостинга по умолчанию, о которой никто не думал. Три шага для правки:
- Открой файл robots.txt на своём хостинге. У большинства платформ (Tilda, WordPress, самописный сайт) он лежит либо в корневой папке сайта, либо редактируется через отдельный пункт настроек SEO - название пункта зависит от платформы, поищи слово "robots" в поиске по настройкам
- Замени
Disallow: /наAllow: /в блоке нужного бота. Если блокаUser-agent: OAI-SearchBotнет вообще, добавь его отдельными двумя строками, как показано на кадре выше - Сохрани файл и проверь результат тем же способом, что и в разделе выше - снова открой
твой-сайт/robots.txtв браузере и убедись, что строка поменялась
Результат правки применяется не мгновенно (подробности в разделе про Bing ниже), но сама смена строки в файле происходит сразу же
Без индекса Bing цитаты не будет, даже если у тебя всё разрешено
Здесь прячется практическая ловушка, из-за которой открытый robots.txt иногда не помогает вообще
OAI-SearchBot - маленький и узкий робот. Он физически не может заново обойти весь интернет при каждом вопросе пользователя - это заняло бы часы, а ответ должен появиться за секунды. Поэтому он работает как человек, который вместо похода в библиотеку открывает уже готовый каталог: таким каталогом служит поисковый индекс Bing
Практический вывод из нескольких независимых разборов документации (не прямая цитата OpenAI, а логичное следствие из его же официального описания): чтобы ChatGPT процитировал твою страницу, нужны сразу ДВА условия одновременно, а не одно
| Условие | Что это значит | Как проверить |
|---|---|---|
| Страница открыта для OAI-SearchBot | твой robots.txt не запрещает этому боту заходить | шаги выше, раздел про robots.txt |
| Страница есть в индексе Bing | Bing вообще знает о существовании этой страницы | бесплатный сервис Bing Webmaster Tools |
Таблица прокручивается вбок →
Открытый robots.txt без индекса Bing - это открытая дверь в комнату, о существовании которой никто не знает. Формально войти можно, но искать её никто не будет
Как узнать, знает ли Bing про твой сайт
Bing Webmaster Tools - бесплатный сервис самого Bing, куда владелец сайта добавляет свой адрес и смотрит, что поисковик о нём знает. Три шага, чтобы проверить у себя без специальных знаний:
- Зайди на сайт Bing Webmaster Tools и войди через существующую почту (Microsoft, Google или Facebook - сервис принимает разные варианты входа). Откроется рабочий экран с полем для ввода адреса сайта
- Впиши адрес своего сайта и подтверди владение. Подтверждение обычно происходит через уже настроенный Google Search Console (если он у тебя есть) - это самый быстрый способ, сервис сам заберёт нужные данные
- Посмотри раздел с числом проиндексированных страниц. Если там ноль или сервис пишет, что сайт ещё не обходили - вот причина, по которой ChatGPT не может процитировать твои страницы, даже если robots.txt разрешает всё
Настройка Bing Webmaster Tools - отдельная тема сама по себе, здесь достаточно знать, что она существует и решает именно эту задачу
Что физически видит модель, прежде чем открыть твою страницу
Тут ещё один слой механики, который многие пропускают. Прежде чем ChatGPT откроет страницу целиком и вчитается в неё, он сначала видит её как ТРИ короткие строчки: заголовок, короткое описание страницы и сам адрес - примерно то же самое, что ты видишь в выдаче Google, когда ищешь что-то сам
По методологии независимого разбора этого поведения (не первоисточник OpenAI, вторичный анализ): именно по этим трём строчкам модель принимает первое решение - открывать страницу полностью или пропустить. Значит то, что написано у тебя в заголовке страницы и в коротком описании под ним, физически влияет на то, откроет ли модель твою страницу вообще, ещё до того, как она увидит содержимое
Официальная справка самого OpenAI подтверждает механику поиска в общих чертах - модель ищет в сети, когда решает, что вопросу нужны свежие данные, и показывает ссылки на источники прямо в ответе:
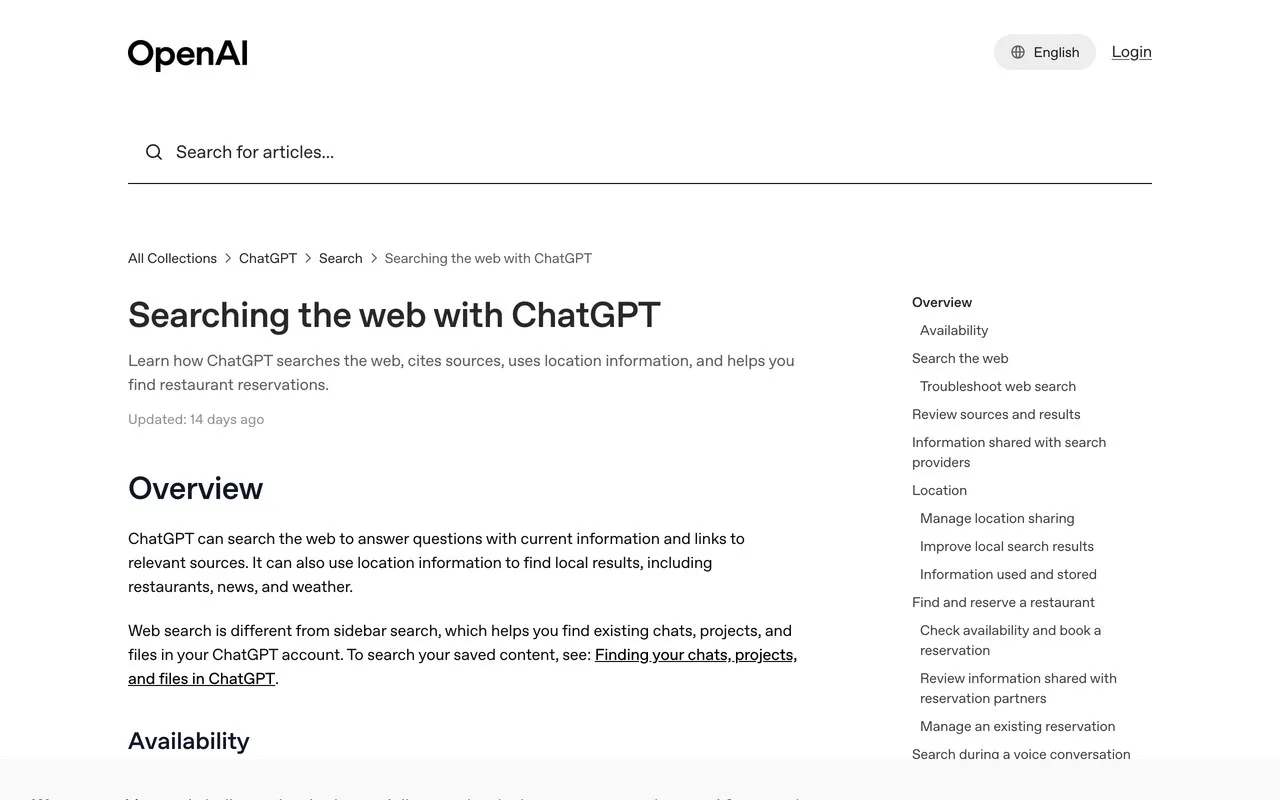
Практический вывод: заголовок и короткое описание страницы - не формальность для галочки, а первый фильтр, через который твоя страница вообще должна пройти, прежде чем у неё появится шанс попасть в ответ
Заголовок и описание страницы: что проверить у себя за минуту
Раз эти две строчки - первый фильтр, разберём, что в них должно быть, тремя шагами:
- Открой любую свою страницу и посмотри на вкладку браузера сверху. Там показан заголовок страницы - если там написано что-то техническое вроде названия файла или общее "Главная страница", а не то, о чём страница реально рассказывает, это сигнал переписать заголовок
- Найди своё описание страницы через поиск в Google (набери в поиске
site:твой-сайт.ruи найди нужную страницу в результатах). Под заголовком в выдаче покажется короткий текст - это и есть описание, которое видит и модель - Проверь, отвечает ли описание сразу на вопрос "о чём эта страница". Если там общие слова без конкретики - перепиши так, чтобы человек, прочитавший только эти две строчки, понял суть без перехода на саму страницу
Если у тебя уже есть чёткий заголовок и понятное описание - этот пункт не требует правок, переходи к следующему разделу
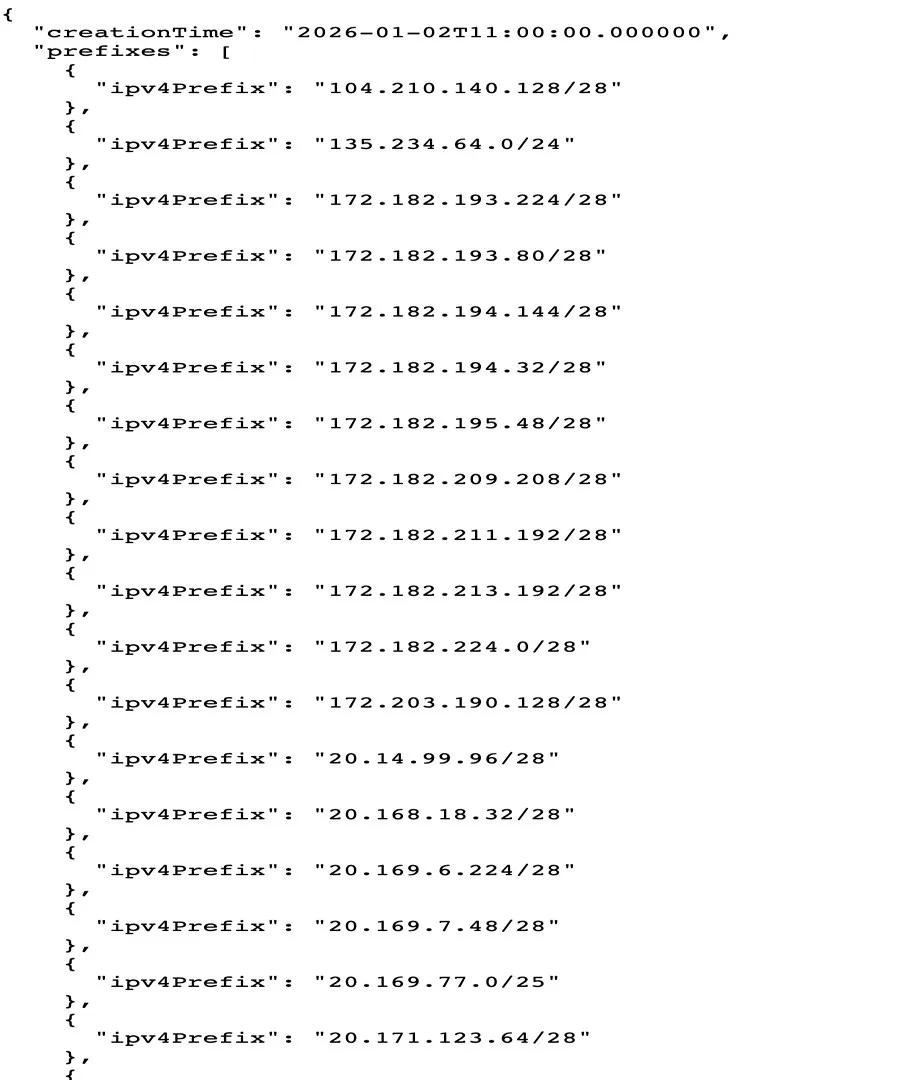
Здесь же лежит защита от подделки: файл с адресами каждого бота публикует сам OpenAI (тот же кадр выше), и любой сайт при желании может сверить, что к нему действительно постучался официальный робот OpenAI, а не кто-то, кто просто представился его именем в заголовке запроса. Тема для владельца сайта скорее техническая, разбирать её здесь не буду - для большинства достаточно знать, что такая проверка вообще существует
Решает ли ChatGPT искать в интернете вообще
Ещё один момент, который стоит понимать: ChatGPT не ходит в интернет за каждым вопросом подряд. Модель сама решает, нужен ли ей свежий поиск, или она ответит по тому, что уже знает из обучения
По разборам поведения модели: вопросы про недавние события, конкретные компании, актуальные цены или живых людей чаще запускают поиск - модель понимает, что её собственные знания могут устареть. Широкие вопросы про общие понятия чаще получают ответ без похода в сеть вообще
Отсюда следствие для владельца сайта: если твоя тема - что-то стабильное, не завязанное на свежие цифры и события, у тебя меньше шансов попасть в живой поиск ChatGPT в принципе, и тут работает уже общая SEO-настройка сайта под генеративный поиск, а не тонкости именно этих трёх ботов
Чем это отличается от обычного поиска Google и Яндекса
Логично спросить: если ChatGPT в итоге тоже смотрит на заголовок, описание и индекс, чем это вообще отличается от обычного SEO под Google или Яндекс? Разница в том, откуда каждый берёт свой список страниц:
| Система | Чей индекс использует | Дополнительное условие |
|---|---|---|
| Обычный поиск Google | собственный индекс Google | ничего сверх обычного SEO |
| Обычный поиск Яндекса | собственный индекс Яндекса | ничего сверх обычного SEO |
| ChatGPT (живой поиск) | индекс Bing, через своего бота OAI-SearchBot | страница обязана быть открыта именно для OAI-SearchBot в robots.txt, помимо самой индексации |
Таблица прокручивается вбок →
Отсюда практический вывод: страница, отлично видная в Google и Яндексе, может быть невидима для ChatGPT ровно по одной причине - её нет в индексе Bing или её закрыли именно от OAI-SearchBot. Это два разных мира с разными правилами входа, и настройка одного не гарантирует настройку другого
Частые ошибки новичка с ботами ChatGPT
Четыре вещи, которые путают чаще всего
- Разрешили GPTBot и решили, что готово GPTBot собирает материал на обучение будущей модели, а не ищет ответ прямо сейчас - за живые ответы отвечает OAI-SearchBot, и разрешение нужно именно ему
- Забыли про индекс Bing открытый robots.txt без индекса Bing не даёт цитаты - боту физически неоткуда взять твою страницу, если её нет в готовом каталоге
- Слабый заголовок и пустое описание страницы модель сначала смотрит на три строчки (заголовок, описание, адрес) и только потом решает, открывать ли страницу целиком - неинформативные строчки режут шанс ещё на старте
- Ждут результата за один день обновления robots.txt применяются поисковой системой не мгновенно, по независимым разборам документации счёт может идти на сутки - проверять эффект в тот же час бессмысленно
Что ещё почитать про настройку сайта под нейросети
- Как попасть в ответы нейросетей: 3 двери GEO в 2026 году - общий чек-лист настройки под ЛЮБУЮ генеративку разом (ChatGPT, Perplexity, Google AI Overviews, Яндекс Нейро), если нужен не разбор одного движка, а порядок действий целиком
- Как сделать чтобы нейросети советовали тебя клиентам - фокус на личной репутации эксперта в ответах нейросетей, а не на технической механике одного бота
- ИИ-поиск: 3 сервиса - если вопрос про то, какой ИИ-поисковик выбрать для себя как читателя, а не про механику одного из них
- 7 промптов на точный ответ в нейросетях - как самому формулировать запросы, чтобы получать более точные ответы
- SEO-план страниц скиллом Claude Code - инструмент для планирования SEO-работы на сайте
- Индексация чатов Claude в Google - смежная тема про попадание чужого содержимого в поиск, но другой предмет: там про чаты, здесь про страницы сайта
- ChatGPT на русском: как пользоваться - если нужен не разбор ботов, а базовый вход в сам сервис
- ChatGPT или Claude: что выбрать - сравнение двух моделей для повседневных задач
- Gemini или ChatGPT: что выбрать - сравнение с ещё одной нейросетью
- Как оплатить ChatGPT из России - если вопрос не про источники, а про доступ к платному тарифу
- Тарифы ChatGPT - что даёт платная версия и чем отличается от бесплатной
- YandexGPT: что это и как работает - для сравнения механики поиска у российской модели
- Google убрал классический поиск в пользу ИИ-ответов - похожая механика на стороне другого поисковика
- OpenAI ChatGPT: разбор сервиса - более широкий обзор самого продукта OpenAI
- Секреты ChatGPT: скрытые функции - если интересно не про источники, а про возможности самого чата
- Презентация через ChatGPT - практическая задача внутри самого чата, не про механику поиска
- Реклама в ChatGPT - смежная тема про монетизацию внимания внутри чата
- ChatGPT для учёбы - другой сценарий использования того же инструмента
- ChatGPT и Google-таблицы - практическая связка инструментов, не про источники
- ChatGPT с телефона - базовая настройка доступа с мобильного устройства
Источники
Документация OpenAI и связанные официальные файлы открыты прямым запросом 4 сентября 2026 года; страница про трёх ботов и список адресов OAI-SearchBot дополнительно сняты живым браузером, собственный robots.txt проверен тем же днём
- OpenAI: документация про трёх ботов (GPTBot, OAI-SearchBot, ChatGPT-User) - официальное описание задач каждого бота
- OpenAI: официальный список адресов OAI-SearchBot - JSON-файл для проверки подлинности бота
- OpenAI: официальный список адресов GPTBot - JSON-файл со списком адресов бота обучения
- OpenAI: официальный список адресов ChatGPT-User - JSON-файл со списком адресов бота прямых запросов пользователя
- OpenAI: справка про поиск в ChatGPT - официальная справочная страница про работу поиска внутри ChatGPT
- Независимый разбор трёх ботов OpenAI - вторичное подтверждение формулировок официальной документации
Памятка: проверка своего сайта под ChatGPT за 5 минут
Семь строк, которые закрывают базовую проверку
Сохрани себе
- Открой
твой-сайт/robots.txtв браузере - это обычная текстовая страница, читается без инструментов - Найди строку
User-agent: OAI-SearchBot- именно этот бот ищет ответы в реальном времени - Убедись, что следующая строка
Allow: /, а неDisallow: / - GPTBot и ChatGPT-User - другие роботы с другими задачами, их разрешение живых ответов не прибавляет
- Без индекса Bing разрешённый robots.txt не спасает - проверь, знает ли Bing о твоём сайте вообще
- Заголовок и описание страницы - первый фильтр модели, до чтения самого текста
- Изменения в robots.txt применяются не мгновенно, по независимым разборам - счёт идёт на сутки
Порог входа
Три бота разобраны, свой сайт проверен - что дальше решаешь ты
Всё, что нужно для первой проверки сайта под ChatGPT, ты только что прочитал бесплатно: три бота, robots.txt, индекс Bing и первый фильтр по заголовку. Следующий шаг - три дня разбора и сборки рабочего порядка вокруг твоего же сайта - тоже стоит ровно ноль
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Чем GPTBot отличается от OAI-SearchBot?
GPTBot собирает тексты, чтобы на них ОБУЧАЛАСЬ будущая версия модели - это работа на будущее, к сегодняшним ответам отношения не имеет. OAI-SearchBot ищет ответ на конкретный вопрос прямо сейчас и решает, какую страницу процитировать в диалоге. Если тебе важны живые цитаты в ответах ChatGPT, разрешение нужно именно OAI-SearchBot
Что делает ChatGPT-User?
Выполняет прямую просьбу живого человека внутри диалога - когда сам пользователь просит открыть конкретную ссылку и пересказать содержимое, или пользуется встроенным помощником с доступом к сайту. Это разовое поручение по команде человека, а не самостоятельный обход интернета
Как проверить свой robots.txt на разрешение для ChatGPT?
Открой в браузере адрес твой-сайт/robots.txt - это обычная текстовая страница. Найди раздел User-agent: OAI-SearchBot и посмотри следующую строку: Allow: / значит доступ открыт, Disallow: / значит закрыт. У меня самого этот раздел открыт для всех трёх ботов OpenAI, проверено живым запросом 04.09.2026
Почему открытого robots.txt может быть недостаточно?
Потому что OAI-SearchBot не обходит весь интернет заново при каждом вопросе - он подглядывает в уже готовый список страниц, и этот список берётся из индекса Bing. Страница может быть полностью открыта для бота, но если её нет в индексе Bing, процитировать её всё равно не получится
Как быстро применяются изменения в robots.txt?
Мгновенно результат не появляется. По независимым разборам документации (не прямая цифра от OpenAI), обновления применяются поисковой системой не сразу - счёт может идти на сутки. Проверять эффект в тот же час смысла нет