GEO-оптимизация · попадание в ответы нейросетей
Как попасть в ответы нейросетей: 3 двери GEO в 2026 году
Три вещи решают, попадёт ли твоя страница в ответ нейросети: открытость для ИИ-ботов, разметка-объяснение и простой каталог из главных страниц. Я настроил всё это у себя на https://theivansergeev.com и проверил результат живьём 3 сентября 2026 года - ниже показываю, что получилось и как повторить у тебя
К концу статьи ты будешь знать, как проверить у своего сайта все три слоя настройки, что означает каждый из них человеческим языком и как убедиться официальным бесплатным инструментом, что машина действительно поняла твою страницу. Если сайта для проверки ещё нет вовсе - сначала собери его, например, в Claude Code, и возвращайся сюда
Открой у себя в браузере файл /robots.txt, посмотри правый клик страницы на разметку-объяснение и проверь, есть ли в корне сайта файл-справочник. Дальше в статье - по одному шагу на каждую проверку и живой пример моего собственного сайта, снятый за один вечер
Шаг 0. Пойми, что вообще проверяем: три независимых слоя
GEO расшифровывается как generative engine optimization - настройка сайта под генеративные ИИ-системы вроде ChatGPT, Perplexity, Google AI Overviews и Яндекс Нейро, а не только под классический поиск. Термин моложе SEO, но задача похожая: сделать так, чтобы машина нашла твою страницу и выбрала именно её, когда собирает ответ на чей-то вопрос
Три слоя настройки не заменяют друг друга, а работают как разные двери в одном доме:
- Дверь входа. Файл
robots.txtв корне сайта - список правил, кому вообще можно заходить. Если тут стоит запрет напротив имени ИИ-бота, дальше проверять нечего: машина просто не увидит страницу - Понимание внутри. Разметка-объяснение (у неё есть техническое название - JSON-LD) - невидимый блок кода на странице, который прямым текстом рассказывает машине структуру: где заголовок, где автор, где источники фактов. Без неё нейросети приходится угадывать это по обычному тексту, и она угадывает не всегда верно
- Быстрый справочник. Отдельный файл-справочник (у него тоже есть техническое имя - llms.txt) - простой список всех страниц сайта с коротким описанием каждой. Машине не обязательно читать весь сайт целиком, чтобы понять, о чём он
Дальше по одному шагу на каждую дверь, с проверкой своими руками
Шаг 1. Проверь, не заблокирован ли твой сайт для ИИ-ботов
Куда нажать: открой в браузере адрес своего сайта с приставкой /robots.txt - например, тво-сайт.ru/robots.txt. Это обычная текстовая страница, открывается как любая другая, без пароля и без специальных программ
Что увидишь: список коротких блоков, каждый начинается со строки User-agent: (имя бота) и дальше идут строки Allow: (разрешено) или Disallow: (запрещено). Если файла нет вовсе - браузер покажет «страница не найдена», это тоже важный сигнал, разберём его в разделе про грабли ниже
Что это даёт: за минуту ты видишь, не закрыт ли твой сайт от конкретных ИИ-ботов случайно, ещё на старте разработки
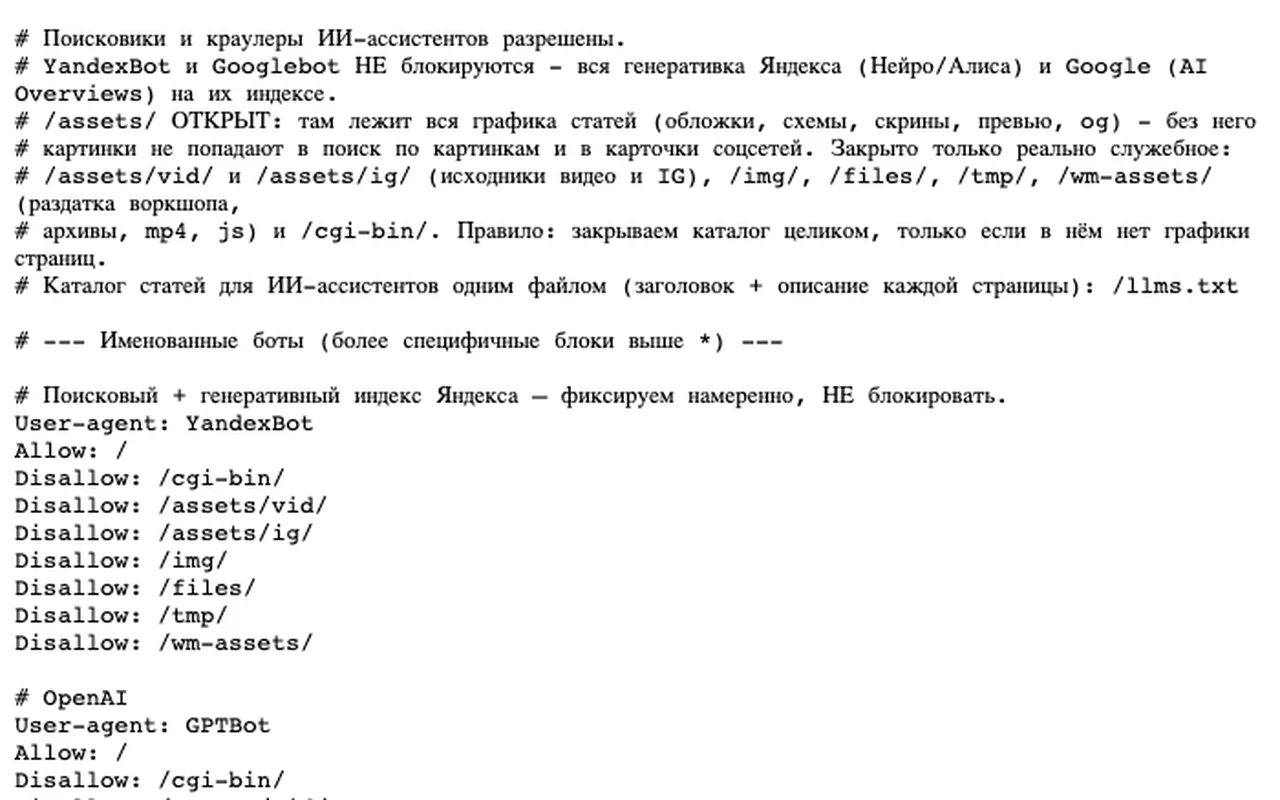
robots.txt на https://theivansergeev.com, снят 03.09.2026: 22 именованных ИИ-краулера с явным разрешением заходить на сайт, включая GPTBot, ClaudeBot и PerplexityBotУ меня в этом файле стоит комментарий прямо над правилами: «Поисковики и краулеры ИИ-ассистентов разрешены. YandexBot и Googlebot НЕ блокируются - вся генеративка Яндекса (Нейро/Алиса) и Google (AI Overviews) на их индексе». Дальше идут отдельные блоки на каждого из 22 ботов - от GPTBot (OpenAI) и ClaudeBot (Anthropic) до PerplexityBot и Bytespider - и у каждого стоит Allow: /, то есть «заходи и читай»
Честно про один нюанс: у меня в файле есть комментарий, что ClaudeBot реально получает отказ, но не из-за правила в этом файле, а на уровне самого хостинга - я держу тикет провайдеру открытым, пока не починят. Разрешение в robots.txt - это моя часть работы, а вот что происходит дальше на сервере, я контролирую не полностью, и говорю это прямо, а не молчу об ограничении
Шаг 2. Собери каталог сайта в одном файле llms.txt
Куда нажать: в Claude Code (или любом текстовом редакторе) создай новый файл с именем ровно llms.txt и положи его в САМЫЙ КОРЕНЬ сайта - туда же, где лежит главная страница index.html, не во вложенную папку
Что писать внутри: формат этого файла-справочника простой и человекочитаемый - заголовок с названием сайта одной строкой (# Название сайта), следом абзац с коротким описанием, о чём сайт вообще, а дальше списком - разделы сайта и ссылки на главные страницы в формате [название страницы](адрес): короткое описание. Никакого кода, обычный читаемый текст
Что увидишь: если открыть адрес этого файла в браузере после публикации, страница покажет обычный текст - без вёрстки, без картинок, просто структурированный список. Это нормально: файл делается для машины, а не для человека, поэтому выглядит скромно
Что это даёт: нейросети не приходится обходить весь сайт целиком, чтобы понять его содержание. Вместо десятков страниц она читает один компактный файл и сразу знает, какие темы у тебя есть и куда за ними идти - это экономит машине время и повышает шанс, что она вообще заглянет глубже одной страницы
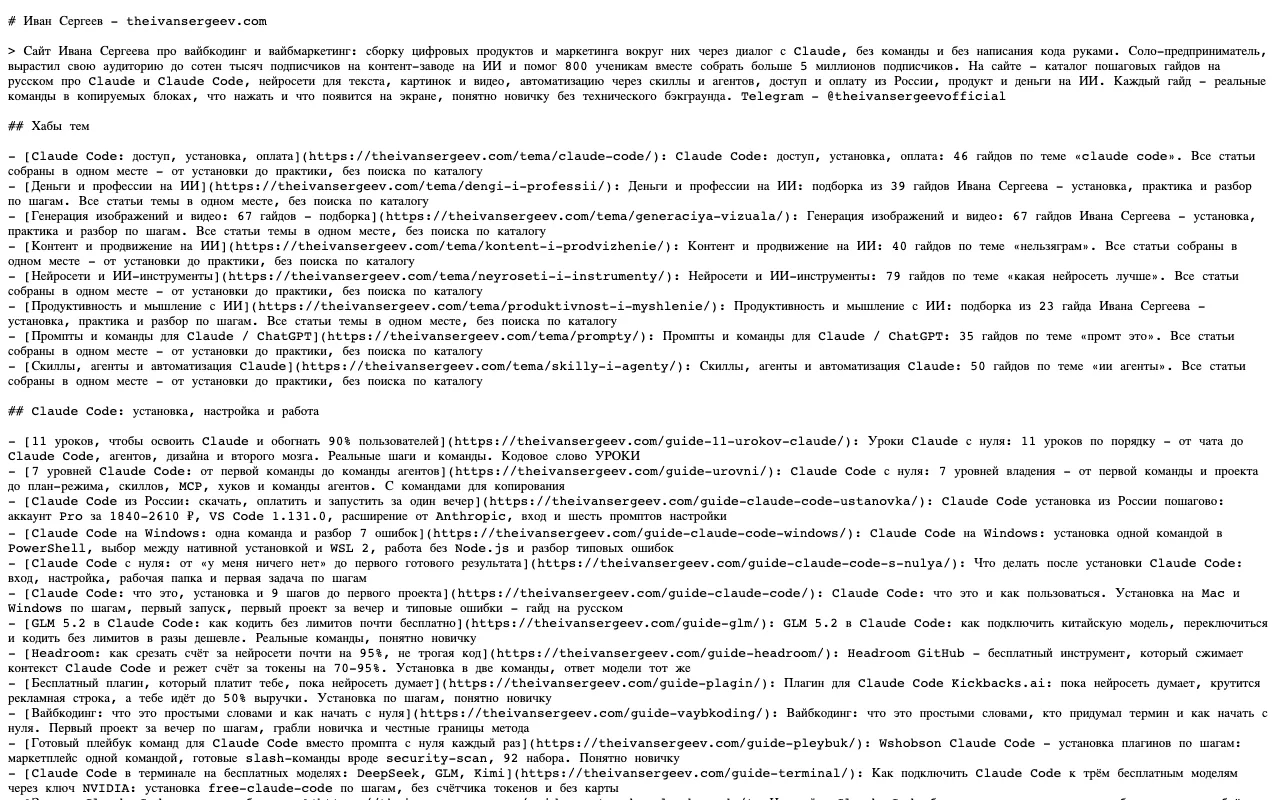
У меня этот файл-справочник живёт по адресу https://theivansergeev.com/llms.txt, я проверил его прямым запросом 3 сентября 2026 года - страница открылась сразу, в файле 575 строк: сначала общее описание проекта одним абзацем, потом восемь тематических разделов (хабов) с их адресами, а внутри каждого - список конкретных гайдов с короткими описаниями. Формат предложил разработчик Джереми Ховард в сентябре 2024 года именно с такой идеей: дать машине сжатую версию сайта вместо того, чтобы заставлять её продираться через меню, рекламу и вёрстку обычной HTML-страницы
Дальше по этой теме идёт разбор 3 роли под одним названием и зарплаты 2026
Шаг 3. Объясни машине, из чего состоит страница, разметкой-объяснением
Куда нажать: этот шаг делается один раз для всего сайта через шаблон страницы, а не вручную на каждой статье - если сайт собирается в Claude Code, попроси добавить в конец каждой страницы блок <script type="application/ld+json"> с описанием статьи
Что писать внутри: структурированный текст по словарю Schema.org - общему стандарту, которым пользуются и Google, и ИИ-системы. Минимальный набор для статьи: тип Article (это статья, а не, например, товар), имя автора, дата публикации, список источников (поле citation), и если в статье есть частые вопросы - отдельный блок FAQPage с теми же вопросами и ответами, что видны в тексте
Что увидишь: сама разметка не видна на странице глазами, это код внутри HTML. Проверить, что она там есть, можно нажатием правой кнопки мыши на странице и выбором пункта «Просмотр кода страницы» - искать там строку application/ld+json
Что это даёт: без этой разметки нейросети приходится самой додумывать, кто автор текста и насколько ему можно доверять. С разметкой это сказано прямым текстом, и по данным независимых разборов рынка, страницы с полным набором такой разметки получают на AI-цитирование заметно больше шансов, чем страницы без неё - хотя сама компания Google прямо говорит: обязательной такая разметка не является (честная оговорка - раздел «Что это НЕ гарантирует» ниже)
У меня на каждой статье в одном блоке @graph объединены сразу девять типов разметки: сама статья (Article), страница (WebPage), сайт целиком (WebSite), картинка, хлебные крошки, вопросы-ответы (FAQPage), пошаговая инструкция (HowTo), автор (Person) и организация (Organization). Часть про меня как автора несёт отдельный постоянный адрес и список моих профилей - это связывает все статьи сайта в одну сущность вместо того, чтобы на каждой странице описывать автора заново с нуля
Независимый разбор рынка подтверждает эту логику с другой стороны: с мая 2026 года Google больше не показывает специальные ячейки для FAQ-разметки прямо в результатах поиска, но сам FAQ-контент остаётся полезным - ИИ-ассистенты по-прежнему берут готовые ответы именно из него, просто уже не в виде отдельного визуального блока выдачи
Короткое определение вынесено в словарь Claude для текстов: что он реально делает с контентом
Шаг 4. Проверь результат бесплатным официальным инструментом
Куда нажать: открой в браузере страницу validator.schema.org - это официальный публичный валидатор от самой Schema.org, работает без регистрации. Вставь в поле адрес своей статьи и нажми кнопку запуска теста
Что увидишь: слева появится код твоей страницы, справа - список найденных типов разметки с числом ошибок и предупреждений напротив каждого. Зелёная колонка «0 ошибок» - хороший знак, красная - значит какое-то поле разметки заполнено неправильно и его стоит поправить
Что это даёт: это не гадание, а прямая проверка тем же словарём, которым пользуются сами поисковые и ИИ-системы. За минуту видно, действительно ли твоя разметка читается машиной так, как ты задумал, или где-то в коде закралась опечатка
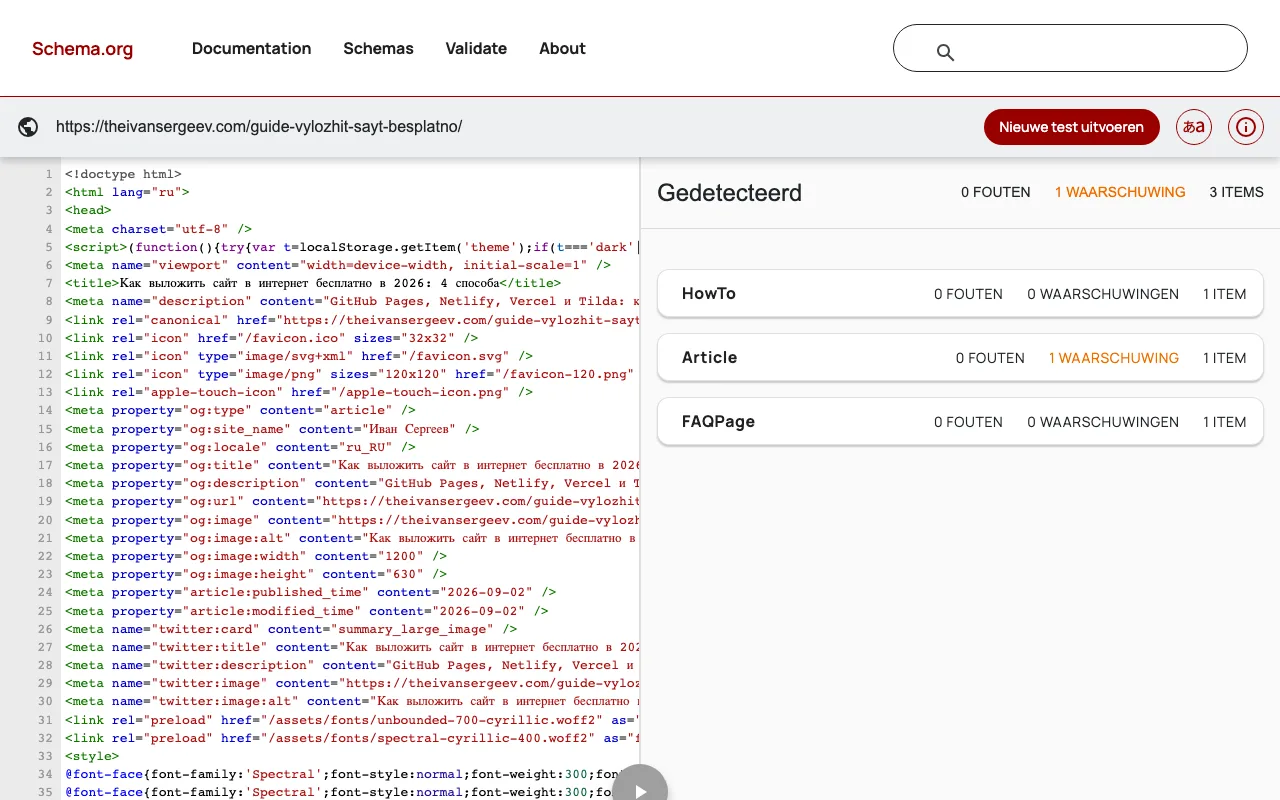
Я прогнал через этот валидатор свою же живую статью про бесплатную публикацию сайтов 3 сентября 2026 года: инструмент нашёл ровно три типа структурированных данных - HowTo (пошаговая инструкция), Article (сама статья) и FAQPage (частые вопросы), у каждого по одному найденному элементу, ошибок ноль, одно предупреждение. Это и есть честный способ проверить свою работу, а не поверить на слово, что разметка «где-то там есть»
Что это НЕ гарантирует
Важная честная оговорка, чтобы не продавать тебе волшебную кнопку. Google прямо пишет в своей документации: специальных требований для попадания в AI Overviews нет, а машиночитаемые файлы или отдельная разметка не обязательны - работает обычная индексация в поиске плюс полезный контент. Три шага этой статьи не покупают место в ответе нейросети - они снимают у машины неоднозначность и упрощают ей выбор между твоей страницей и десятком похожих. У Perplexity устройство похожее: по независимым разборам их системы, из примерно десяти прочитанных страниц в финальный ответ попадает три-пять, и выигрывает та, где факты легко привязать к источнику, а не спрятаны в сплошном тексте. У Google похожая логика лежит и в основе других бесплатных ИИ-инструментов - если тема интересна шире одного попадания в ответ, разбор восьми таких инструментов уже готов отдельно
Итог таким: настройка из трёх шагов - это не гарантия цитирования, а устранение технических барьеров, которые мешают тебе даже попасть в шорт-лист кандидатов на цитату
Чем GEO отличается от привычного SEO
Задача похожая, но результат читается по-разному, и путать их вредно - разная метрика успеха ведёт к разным действиям:
| Признак | Классическое SEO | GEO |
|---|---|---|
| Куда попадает страница | в список ссылок выдачи | в готовый текст ответа машины |
| Что считается победой | клик по твоей ссылке | твой факт процитирован в ответе |
| Что читает машина в первую очередь | заголовок и текст страницы | структуру: разметку-объяснение, файл-справочник, открытость для ботов |
| Что решает ранжирование | ссылки, поведенческие сигналы, скорость | те же сигналы плюс лёгкость извлечь факт из текста |
Таблица прокручивается вбок →
Отсюда практический вывод: три двери этой статьи не отменяют обычную SEO-работу, а достраивают её для нового канала - ответа нейросети вместо списка ссылок
Как понять, что твой сайт уже попадает в ответы нейросетей
Три простых проверки, каждая занимает меньше минуты:
- Прямой вопрос машине. Спроси у нейросети что-то по теме твоего сайта, не называя себя - если она процитирует твой факт или сошлётся на твой адрес, дело сделано
- Вопрос про себя лично. Спроси «что ты знаешь про [твоё имя или название бренда]» - пустой или неточный ответ значит, что машина твой сайт либо не нашла, либо не поняла
- Свежесть индекса. У Google AI Overviews работает та же индексация, что и у обычного поиска - если страницы твоего сайта не находятся обычным поиском по названию, ждать цитирования в ответе тоже не стоит
Если все три проверки дали пустой результат - причина почти всегда в одной из трёх дверей этой статьи, а не в качестве самого текста
Что делать, если сайту всего несколько дней
Частая ситуация: сайт только что опубликован, а настройка из этой статьи уже сделана, но результата пока нет. Три честные причины подождать, прежде чем что-то менять:
| Причина | Что это значит | Сколько обычно ждать |
|---|---|---|
| Индексации ещё не было | боты физически не успели зайти и прочитать страницу | несколько дней - неделя |
| Мало упоминаний в сети | у машины пока нет сигналов доверия к новому источнику | недели-месяцы, зависит от активности |
| Файл-справочник обновился, а кэш - нет | у части систем есть задержка обновления собственных данных | дни |
Таблица прокручивается вбок →
Три двери этой статьи убирают технические барьеры сразу, но доверие машины к новому источнику - это отдельный процесс во времени, который ни одна настройка не ускоряет мгновенно
Твой набор бесплатных инструментов
Три бесплатных инструмента для самопроверки, без установки чего-либо на компьютер:
| Инструмент | Что показывает | Нужна ли регистрация |
|---|---|---|
| validator.schema.org | найденные типы разметки-объяснения и ошибки в них | нет |
| твой собственный /robots.txt | список правил для всех ботов сразу, открывается прямо в браузере | нет |
| прямой вопрос нейросети о себе | знает ли машина уже про твой сайт или бренд | зависит от нейросети, часто нет |
Таблица прокручивается вбок →
Прямой вопрос задавай так: спроси у ChatGPT, Perplexity или Gemini «что ты знаешь про [твоё имя или бренд]» - если ответ пустой или неточный, это сигнал, что машина ещё не нашла или не поняла твой сайт
Частые грабли
Три вещи, которые чаще всего портят GEO-настройку новичку
- Файла robots.txt нет вовсе это не значит «всем можно» - часть хостингов и конструкторов сайтов по умолчанию закрывают часть страниц, отсутствие файла нужно проверять отдельно, а не считать безопасным по умолчанию
- Разметка-объяснение скопирована с чужого сайта без правки адреса, имя автора и даты остаются чужими - машина либо получит неверные данные, либо просто отбросит явно битую разметку
- Файл-справочник лежит не в корне, а во вложенной папке по стандарту его ищут по адресу сайт.ru/llms.txt - если он лежит глубже, во вложенной папке, машина по умолчанию его не найдёт
Ещё одна вещь, которую стоит проверить отдельно, если ты уже настраивал сайт для обычного поиска: у меня по факту тот же вопрос про правильную структуру страниц уже разбирался под другим углом в статье про SEO-скилл для Claude - там речь про план и семантику будущих страниц, а не про готовую техническую настройку, это дополняющий, а не повторяющий материал
Что ещё почитать про сайты и попадание в поиск
- Как сделать, чтобы нейросети советовали тебя клиентам - если задача не техническая настройка сайта, а личная рекомендация тебя как эксперта
- SEO-скилл для Клода: 5 шагов к плану страниц - если дальше нужен не только технический слой, а план и семантика будущих статей
- Как выложить сайт в интернет бесплатно в 2026 - если сайта для проверки ещё нет и его нужно сначала опубликовать
- Как создать сайт с помощью ИИ: 4 пути - если файлов сайта ещё нет вовсе
- Claude Code: что это и как пользоваться - если разметку и файлы для этой статьи будешь собирать в Claude Code
- Контент и продвижение на ИИ: разборы и гайды - если тема продвижения через нейросети интересна шире одной настройки
- Нейросети и ИИ-инструменты: разборы и гайды - если хочешь разобраться в самих нейросетях, которые упомянуты в этой статье
- Timeweb: купить домен и привязать сайт - если своего домена ещё нет, а без него часть настроек не имеет смысла
- Сколько стоит сделать сайт в 2026 - если считаешь бюджет сайта целиком, а не только техническую настройку
- No code в 2026: когда хватит конструктора, а когда нужен код - если сайт ещё только выбираешь, на чём собирать
- Как скачать файл с Гитхаба: 6 способов - если понадобится забрать чужой шаблон файла-справочника или разметки себе
- Бесплатные замены платным сервисам - если вся эта настройка делается на минимальном бюджете
- ChatGPT Plus 2026: цена и оплата из России - если хочешь сам проверять ответы ChatGPT про свой сайт на платном тарифе
- 8 бесплатных ИИ-инструментов Google - если интересны и другие инструменты Google, не только AI Overviews
Источники
Все источники проверены прямым запросом 3 сентября 2026 года; собственные файлы моего сайта (robots.txt, каталог для машины, разметка-объяснение) проверены живым запросом в тот же день
- llms.txt: официальное описание стандарта - структура файла, автор стандарта, назначение
- Google Search Central: AI features - официальная позиция Google про требования к попаданию в AI Overviews
- Schema.org: официальный валидатор структурированных данных - публичная проверка разметки-объяснения без регистрации
- Schema.org: словарь разметки - официальный список типов разметки (Article, FAQPage, HowTo, Person)
- Разбор изменений FAQ-разметки в выдаче Google, май 2026 - независимый анализ, почему FAQ-контент остаётся полезным для ИИ-ассистентов
- robots.txt самого https://theivansergeev.com - живой пример разрешения для 22 именованных ИИ-краулеров
- Файл-справочник самого https://theivansergeev.com - живой пример простого текстового каталога сайта для нейросетей
Памятка: три двери GEO-настройки
Пять строк, которые закрывают всю настройку
Сохрани себе
- Дверь 1: открой /robots.txt своего сайта, убедись, что там нет запрета напротив GPTBot, ClaudeBot, PerplexityBot и похожих имён
- Дверь 2: заведи файл-справочник в корне сайта (техническое имя - llms.txt) - короткое описание плюс список страниц с адресами
- Дверь 3: добавь на страницы разметку-объяснение с типом статьи, автором, датой и списком источников
- Проверка: прогони готовую страницу через официальный validator.schema.org, ноль ошибок - хороший знак
- Честная граница: это снимает технические барьеры, а не покупает место в ответе нейросети - решает ещё и качество самого текста
Порог входа
Три двери разобраны бесплатно, следующий шаг - тоже
Всё, что нужно, чтобы сайт технически мог попасть в ответ нейросети, ты только что прочитал бесплатно: открытость для ботов, разметку-объяснение и каталог для машины, а ещё способ всё это проверить. Следующий шаг - три дня разбора и сборки рабочего порядка вокруг твоего же сайта - тоже стоит ровно ноль
Это заявка в мой закрытый канал, не оплата. Впускаю сразу, дальше бот в личке отдаёт путёвку на три дня
Частые вопросы
Что такое GEO простыми словами?
GEO (generative engine optimization) - настройка сайта под генеративные ИИ-системы вроде ChatGPT, Perplexity и Google AI Overviews, чтобы они могли найти твою страницу и корректно её процитировать в своём ответе. В отличие от классического SEO, тут важно не только попасть в выдачу, но и дать машине лёгкий способ понять структуру страницы
Обязательно ли делать всё три шага, или достаточно одного?
Каждый шаг закрывает свою дверь и не заменяет остальные. Закрытый доступ в robots.txt перечёркивает пользу от идеальной разметки-объяснения - машина просто не дойдёт до страницы. А отсутствие файла-справочника не блокирует доступ полностью, но заставляет машину тратить больше усилий на понимание сайта целиком, а не одной статьи
Гарантирует ли эта настройка, что меня процитируют?
Нет, и это важно сказать прямо. Google официально пишет, что специальных требований для попадания в AI Overviews нет и работает обычная индексация с полезным контентом. Настройка из этой статьи убирает технические барьеры и снижает неоднозначность для машины, но финальный выбор источника решает ещё и качество самого текста
Как проверить, что нейросеть уже знает про мой сайт?
Самый простой способ - прямой вопрос в ChatGPT, Perplexity или Gemini о теме твоего сайта или о твоём имени. Если ответ есть и он точный - твой сайт уже засветился. Если ответ пустой или явно устаревший, вернись к шагам 1-3 и проверь каждую дверь по очереди
Нужно ли для этого нанимать разработчика?
Нет. Файл robots.txt редактируется как обычный текстовый файл, каталог для машины - точно так же, а разметку-объяснение в Claude Code можно попросить добавить на человеческом языке, без ручного написания кода - именно так собран пример на моём собственном сайте
Чем это отличается от статьи про то, чтобы нейросети советовали именно меня как эксперта?
Это разные задачи. Эта статья - про то, чтобы страница твоего сайта технически МОГЛА попасть в ответ нейросети: открытость для ботов, структура данных, каталог сайта. Если задача другая - чтобы нейросеть рекомендовала ЛИЧНО тебя как эксперта живому человеку, который спрашивает совета, это разбирается отдельно в гайде как сделать, чтобы нейросети советовали тебя клиентам