Grok 4.6 vs Claude Fable 5 · цена и доступ из России · сентябрь 2026
Grok 4.6 против Claude Fable 5 в 2026: цена и доступ из РФ
Grok 4.6 вышла 12 августа 2026 года, и первое, что бросается в глаза - цена. По официальному прайсу xAI модель стоит $2 за миллион входных токенов и $6 за выходных, у Claude Fable 5 - $10 и $50. Разница в 7,5 раза, и это не промо-акция, а базовый тариф на день публикации этой статьи
Я сверил свежий официальный анонс x.ai, документацию по ценам обеих моделей и независимую сверку через Artificial Analysis. Дальше - что показывают три реальных замера, сколько это стоит в рублях по курсу ЦБ и как открыть Grok из России, если ты ещё не пробовал

Сверь свою задачу с разделом «Что выбрать под свою задачу» ниже: если тебе важна цена за токен и агентные задачи с инструментами - открой сначала цифры CursorBench, где Grok 4.6 обходит Fable 5 при цене в 6 раз ниже. Если тебе нужен максимум по общему индексу интеллекта или ты уже платишь за Claude - смотри раздел про AA Intelligence Index, там Fable 5 на 1 балл впереди
Из практики
Разбор ниже собран той же моделью Claude, о которой статья
Все цифры я сверял вручную с официальных страниц xAI и Anthropic, а не пересказывал чужой обзор - методика в разделе про источники
Общий индекс интеллекта: разница в 1 балл, независимо подтверждена
Короткий ответ: на сводном Artificial Analysis Intelligence Index Grok 4.6 набирает 61 балл - столько же, сколько GPT-5.6 Sol Max. Claude Fable 5 Max - 62 балла, на один пункт выше. Разницу подтверждает сам xAI в официальном анонсе: «Grok 4.6 matches GPT-5.6 Sol on the Artificial Analysis Intelligence Index»
AA Intelligence Index - это сводный балл сразу из девяти разных тестов на рассуждение, код, работу с инструментами и знания. Одно число вместо десятка таблиц, удобно для быстрого сравнения, но за ним прячутся сильные и слабые стороны каждой модели по отдельности - ниже разберу их поштучно
Заявление вендора я не принимаю на веру просто так: независимый источник (llm-stats.com) сверил цифру напрямую и подтвердил её: «xAI claimed 61 on the Artificial Analysis Intelligence Index, and Artificial Analysis independently measured 60.92, making the claim clean». 60.92 округляется до 61, заявление чистое
Таблица восьми бенчмарков из официального анонса
Полная таблица, которую xAI опубликовала в день релиза 12 августа 2026 года, сверена мной напрямую на странице анонса:
| Бенчмарк | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| AA Intelligence Index | 61 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 73% | 70% |
| FrontierCode v1.1 | 61.3% | 60.6% | 63.6% |
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v3.0 | 26% | 34.6% | 34.1% |
| APEX-SWE | 56.4% | - | 58.8% |
Таблица прокручивается вбок →
Расклад честный, а не в пользу одной модели: Fable 5 впереди на пяти строках из семи, где есть обе цифры (CursorBench, DeepSWE, FrontierCode, APEX-Agents, APEX-SWE), Grok 4.6 обходит его только по GDPVal-AA v2. На Terminal-Bench v3.0 разрыв самый заметный - 26% против 34.1%, здесь Fable 5 явно сильнее
Этот кусок вынесен в отдельный гайд Claude Fable 5.1: 3 факта из первоисточника про обновление
Что стоит за этими названиями простыми словами
Восемь названий из таблицы выше звучат как абракадабра, если не работать с этим каждый день, поэтому переведу коротко. GDPVal-AA - тест на офисные задачи вроде подготовки документов и анализа данных, где важен не только код. CursorBench - агентная работа прямо в редакторе кода: модель сама открывает файлы, правит и проверяет результат, а не просто отвечает на вопрос текстом
DeepSWE и APEX-SWE - оба про починку реальных чужих ошибок в открытых проектах, только собраны разными командами независимо друг от друга: как два разных экзамена на одну и ту же профессию, с разными билетами. FrontierCode - более общий тест на программирование, не завязанный на конкретный редактор. APEX-Agents - способность модели держать в голове длинную цепочку из многих шагов, не теряя первоначальную задачу. Terminal-Bench - работа в командной строке компьютера: набрать команду, прочитать её результат, решить, что делать дальше
Дальше в статье эти же названия используются без расшифровки - если вернёшься к ним позже, объяснение всегда здесь, в этом разделе
Рядом по теме есть отдельный разбор: ИИ анализ данных
CursorBench: где Grok 4.6 реально обходит Fable 5
Здесь картина меняется. По данным независимого разбора (Хабр) в отдельном режиме CursorBench (Extra High) Grok 4.6 показывает 70.8% при средней стоимости $2.81 за задание, Fable 5 Max - 70.5% при $17.32 за задание
70.8 против 70.5 - разница в 0.3 процентных пункта, а вот цена отличается в 6.2 раза. Grok 4.6 получает чуть более высокий результат за существенно меньшие деньги на этом конкретном замере
| Модель | Результат CursorBench (Extra High) | Средняя цена за задание |
|---|---|---|
| Grok 4.6 | 70.8% | $2.81 |
| Claude Fable 5 Max | 70.5% | $17.32 |
| Claude Opus 5 Max | 70% | $8.23 |
| GPT-5.6 Sol Max | 67.2% | $5.69 |
Таблица прокручивается вбок →
Важная оговорка: это ДРУГОЙ снимок CursorBench, чем в таблице выше (там режим не уточнён, и там Fable 5 впереди - 70.5% против 69.9%). Разные режимы теста дают разные числа даже у одной пары моделей, это не ошибка и не подгонка - две грани одного и того же замера. В статье честно привожу оба, не смешиваю
SWE-bench: разные площадки, сравнивать напрямую нельзя
У Claude Fable 5 официальная цифра SWE-bench Pro - 80.0% (тот же источник, что использован в моём разборе GPT-5.6 против Claude Fable 5, где эта цифра сравнивалась с GPT-5.6 Sol). У Grok 4.6 в официальном анонсе x.ai цифры SWE-bench Pro нет вообще
Есть другая цифра - независимая площадка Vals AI даёт Grok 4.6 результат 95.60% на SWE-bench (Vals), рост на 9 пунктов к версии 4.5. Я проверил Vals.ai напрямую: это отдельный композитный индекс SWE-bench Verified, не SWE-bench Pro, и на их же индексе Claude Fable 5.1 (более новая версия) лидирует с 67.87%, а Grok 4.6 занимает пятое место с 59.17%
Честно раскладываю: SWE-bench Pro и SWE-bench через Vals - разные тесты одного семейства, с разной сложностью задач и разной методикой подсчёта. Сравнивать 80.0% и 95.60% напрямую как «кто выше» некорректно - это как сравнивать результат по разным экзаменам. Одну и ту же модель на одной площадке для честного сравнения версия-в-версию я не нашёл, и выдумывать её не буду
Кто дешевле: разница в 7,5 раза по официальному прайсу
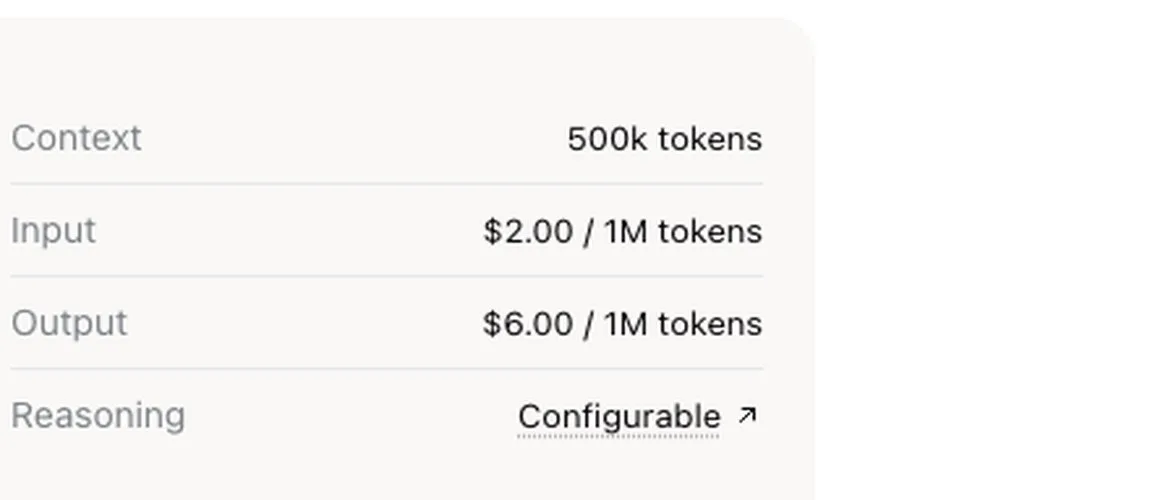
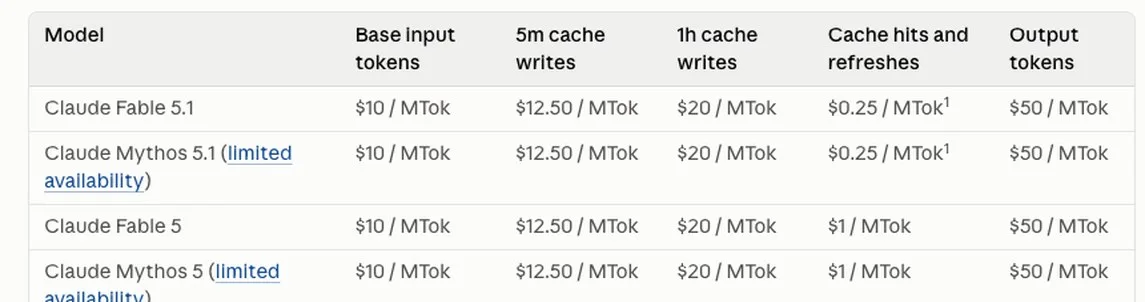
Официальные цены на 5 сентября 2026 года:
| Модель | Вход, за миллион | Выход, за миллион | Контекст |
|---|---|---|---|
| Grok 4.6 (запрос до 200к токенов) | $2 | $6 | 500 тыс. |
| Grok 4.6 (запрос от 200к токенов) | $4 | $12 | 500 тыс. |
| Claude Fable 5 | $10 | $50 | - |
Таблица прокручивается вбок →
Складываю вход и выход за короткий запрос (до 200 тысяч токенов): у Grok 4.6 получается $8 за миллион единиц текста туда-обратно, у Fable 5 - $60. Grok 4.6 обходится в 7,5 раза дешевле. Цена у Grok 4.6 не изменилась с версии 4.5 - это подтверждает независимый разбор Хабра
Сколько это в рублях по курсу ЦБ
Курс ЦБ РФ на день публикации этой статьи:
$ curl -s https://www.cbr-xml-daily.ru/daily_json.js | python3 -c "import json,sys; d=json.load(sys.stdin); print(d['Date'], d['Valute']['USD']['Value'])"
2026-09-05T11:30:00+03:00 86.5857
86,59 рубля за доллар на 5 сентября 2026 года. Пересчёт цены за миллион единиц текста (короткий запрос, вход+выход):
| Модель | Цена в долларах | Цена в рублях по курсу 86,59 |
|---|---|---|
| Grok 4.6 | $8 | 693 ₽ |
| Claude Fable 5 | $60 | 5195 ₽ |
Таблица прокручивается вбок →
Это цены API для разработчиков, не потребительской подписки. Потребительский тариф SuperGrok стоит $30 в месяц по прямому официальному прайсу - 2598 рублей по тому же курсу, если платишь зарубежной картой напрямую. Через маркетплейс или сервис-посредника цена другая: у меня в отдельном гайде про сам Grok собраны живые рублёвые цены посредников на день той публикации - там же полная инструкция по оплате и настройке доступа, здесь эту часть не повторяю
413 рублей разницы кажутся мелочью на одном запросе, но при регулярной работе агента - сотни прогонов в месяц - разница в 7,5 раза складывается в заметную сумму. Курс меняется каждый день, поэтому если читаешь эту статью не 5 сентября 2026 года - пересчитай сам по свежему курсу ЦБ, сама пропорция цены (7,5 раза) от даты не зависит
Доступ из России: сайт открыт, оплата - нет
Grok - редкий случай среди топ-моделей: официально его не блокируют по IP. Независимый разбор (Хабр) формулирует так: «По состоянию на июнь-июль 2026 года целенаправленной блокировки grok.com или xAI для российских IP-адресов не выявлено». Открыть сайт можно без VPN у большинства провайдеров. Для сравнения, у большинства других топ-моделей ситуация иначе - живой обзор доступа к Gemini и к DeepSeek из России я разбирал отдельно, там своя специфика по каждому сервису
Проблема не в доступе к сайту, а в оплате. Российские карты на x.ai не принимаются - нужна зарубежная карта, посредник или цифровой товар с маркетплейса. Бесплатный тариф даёт около 10 запросов за 2 часа, но флагманская модель на нём не работает: отвечает более лёгкая версия, класса Grok 3. Общий разбор способов оплаты нейросетей из России, когда своя карта не проходит ни на одном сервисе, у меня собран здесь
Если для тебя принципиален именно стабильный канал доступа без банов аккаунта на любой из моделей - отдельно писал про это здесь. А если бюджет ограничен и хочется для начала обойтись вообще без платной подписки - у меня есть обзор бесплатных нейросетей, туда входит и Grok на его бесплатном тарифе
Значит own-run прямо на Grok 4.6 для этой статьи я честно не проводил: бесплатный доступ даёт не ту модель, о которой статья, а заводить платную подписку ради одного сравнения не стал - цифры этой статьи официальные и независимо сверенные, а не мой личный прогон одной задачи в обеих моделях. Если тебе нужен полный маршрут - куда нажать, как настроить DNS, как оплатить из России пошагово - весь этот путь у меня разобран отдельно в гайде про сам Grok, здесь его не дублирую. Там же, кстати, разбор бесплатного включения модели прямо в редакторе Cursor - самый дешёвый путь для тех, кто пишет код
У Claude похожая история с доступом: Anthropic официально не работает с российскими номерами и картами при регистрации, вход требует VPN и зарубежные реквизиты - этот случай уже разбирал в сравнении продуктов ChatGPT и Claude, не открываю тему заново здесь
Тест на русских задачах: что реально проверено, а чего нет
Специализированного бенчмарка именно на русском языке или кириллице ни у одной из двух моделей я не нашёл ни в одном из источников - это честно, а не отговорка. Все восемь бенчмарков таблицы выше собраны на английских задачах
Что реально проверяемо: русскоязычные независимые обзоры (Хабр) не просто перевели пресс-релиз xAI, а самостоятельно сверили цифры анонса и подтвердили их независимо. Формулировка одной из статей дословная: «сводный индекс Grok 4.6 делит 61 балл с GPT-5.6 Sol и на один балл отстает от Fable 5» - число совпадает с моей проверкой первоисточника до балла
Живая связь с X (свежие посты и обсуждения прямо в ответе) - главное отличие Grok от конкурентов на задачах поиска. Если тебе важен именно поиск с проверкой источников, а не код, у меня есть отдельный разбор Perplexity - там другой подход к тому же классу задач
Что выбрать под свою задачу
- Важна цена за токен при похожем результате на агентных задачах Grok 4.6 дешевле в 7,5 раза по прайсу и обходит Fable 5 на CursorBench (Extra High) при цене в 6,2 раза ниже
- Нужен максимум по общему индексу и код в чужом большом проекте Claude Fable 5 впереди на пяти бенчмарках из семи в прямом сравнении, разрыв на Terminal-Bench самый заметный
- Работаешь без VPN и не готов платить за подписку зарубежной картой grok.com открывается без блокировки IP, но флагманская модель 4.6 доступна только на платном тарифе
- Уже платишь за Claude и не хочешь пересобирать процесс Разница в общем индексе - всего 1 балл, менять инструмент ради одной цифры смысла нет
Один тест не решает: своя задача честнее любого чужого процента
Ни один из восьми бенчмарков не проверяет конкретно твою задачу. CursorBench - агентная работа в редакторе, DeepSWE и SWE-bench - готовые баг-репорты в открытых проектах, Terminal-Bench - работа в командной строке. Твоя реальная работа может не совпасть ни с одним из них
Если у тебя уже есть доступ к обеим моделям - возьми одну свою настоящую задачу, прогони через Grok 4.6 и Fable 5, сравни результат глазами и расход - в личном кабинете каждого сервиса. Цифры этой статьи - официальные замеры вендора, независимая сверка Artificial Analysis и независимые русскоязычные обзоры, а не мой личный прогон одной и той же задачи в обеих моделях: этого прогона я не проводил и не выдаю его за то, чем он не является
Обе модели по API можно подключить и через агрегатор, без прямой карты на сайте вендора - разбирал этот путь отдельно в гайде по OpenRouter. А если задача - именно код, и хочется понять, что вообще меняется, когда часть работы за тебя пишет нейросеть, у меня есть отдельный разбор
Если результат вдруг покажется незавершённым у любой из моделей - есть отдельный разбор, как довести ситуацию до конца, а не поверить рапорту «готово» на слово: Агент говорит «готово»: 4 шага, чтобы доделать до конца
Три ошибки, на которых спотыкаются при выборе между Grok и Claude
Три вещи чаще всего сбивают с толку при таком сравнении, и каждую легко разложить по фактам. Первая ошибка - сравнивать общий индекс вместо конкретной задачи: разница в 1 балл AA Intelligence Index ничего не говорит о том, как модель справится именно с твоим кодом. Смотри на конкретный бенчмарк, ближе всего к твоей работе, а не на сводное число
Вторая ошибка - путать разные снимки одного и того же теста. В этой статье уже видно на примере CursorBench: один снимок даёт Fable 5 небольшое преимущество (70.5% против 69.9%), другой - преимущество Grok 4.6 при заметно меньшей цене (70.8% против 70.5% за $2.81 против $17.32). Оба снимка честные, просто разные режимы одного теста - проверяй, о каком именно режиме идёт речь, прежде чем делать вывод
Третья ошибка - сравнивать цифры с разных площадок как одну шкалу. SWE-bench Pro у Fable 5 (80.0%) и SWE-bench через независимый Vals у Grok 4.6 (95.60%) - это разные экзамены с разной сложностью вопросов, а не два результата одного теста. Высокий процент на более лёгкой площадке не значит превосходство над результатом на более сложной
Что почитать дальше на этом же сайте
- Grok AI: сколько стоит SuperGrok и как открыть его в России - полный установочный гайд про сам Grok: DNS, регистрация, оплата, Cursor, API
- GPT-5.6 против Claude Fable 5 в 2026: догнала ли OpenAI - тот же жанр сравнения, другая пара моделей
- Kimi K3 против Claude Code: 6 побед из 7 на вёрстке сайтов - ещё одна модель против Fable 5, другой бенчмарк
- ARC-AGI что это: 3 версии теста и взлёт Claude в 2026 году - у Grok карточки на этом тесте нет, но полезно понять сам тест
- Какая нейросеть лучше: вердикт по каждой задаче - более широкий обзор, не только код
- ChatGPT vs Claude 2026: 4 задачи, цены и проверка из России - сравнение продуктов и подписок, не версий моделей
- 4 модели Claude в 2026: какую выбрать и что доступно из России - разница между Sonnet, Opus и Fable внутри самого Claude
- Claude Opus 5: что нового и как переключиться за пару минут - соседняя модель Anthropic, не Fable 5
- Фронтир модели: что это простыми словами и как выбрать ИИ под задачу - что вообще значит слово «фронтир»
- Сравнение флагманских нейросетей: GPT, Claude, Gemini - более широкий обзор топовых моделей
- GPT-5.6 подешевела на 20%: цены и оплата из России в 2026 году - снижение цены третьего игрока этого же рынка
- Файл на 50+ нейросетей с раскладкой по задачам - карта всего рынка, если два инструмента - мало
- Вайбкодинг с нуля - что делать после выбора модели, чтобы она приносила деньги, а не лежала вкладкой
- Агент говорит «готово»: 4 шага, чтобы доделать до конца - частая ловушка на любой модели
- Нейросети и инструменты: полный раздел гайдов - все статьи про модели и сервисы на одной странице
Восемь бенчмарков сверены, цена сверена в рублях, доступ проверен живым фактом, а вывод честнее заголовка «Grok обошёл Claude» или наоборот: разница в общем индексе - один балл, а вот в цене за токен - в 7,5 раза, и это то, что реально стоит учитывать при выборе
Знать цифры - только начало. Дальше вопрос, который ни один бенчмарк не решает: как встроить любую из этих моделей в рабочий процесс так, чтобы результат не зависел от того, кто выиграл один тест на конкретный день
На Лагере я показываю, как из одного и того же навыка постановки задачи вырастает рабочий порядок, который переносится на любую модель - хоть на Grok, хоть на Fable 5, хоть на ту, что выйдет через месяц
Источники
:::sources :::
- x.ai: официальный анонс Grok 4.6 - полная таблица восьми бенчмарков против GPT-5.6 Sol Max и Claude Fable 5 Max, дата релиза 12 августа 2026
- docs.x.ai/docs/models - официальные цены xAI: Grok 4.6, контекст 500 тысяч токенов, тарификация по порогу 200к токенов
- llm-stats.com: разбор запуска Grok 4.6 - независимая сверка AA Intelligence Index (60.92) и цифра SWE-bench через Vals (95.60%)
- vals.ai - независимая площадка бенчмарков, живой Vals Index с обеими моделями
- Claude Platform Docs: Pricing - официальные цены Anthropic, Claude Fable 5
- cbr-xml-daily.ru - курс ЦБ РФ на дату публикации, использован для пересчёта цены в рубли
- Хабр: Grok 4.6 вышел - разбираем тесты и цену долгих задач - независимый разбор, цифры CursorBench с ценой за задание
- Хабр: как использовать Grok в России без VPN - независимая проверка доступа и оплаты из России :::
Памятка: Grok 4.6 против Claude Fable 5
Четыре цифры и честная оговорка про то, чего проверить нельзя
Сохрани себе
- AA Intelligence Index: Grok 4.6 - 61, Fable 5 - 62 (разница 1 балл, подтверждена независимо Artificial Analysis - 60.92)
- CursorBench (Extra High): Grok 4.6 - 70.8% за $2.81, Fable 5 Max - 70.5% за $17.32 (Grok 4.6 дешевле в 6,2 раза при чуть более высоком результате)
- Цена за миллион токенов туда-обратно: Grok 4.6 - $8 (693 рубля по курсу ЦБ 5 сентября 2026), Fable 5 - $60 (5195 рублей) - разница в 7,5 раза
- Доступ: grok.com не блокирован по IP из России, но флагманская модель 4.6 недоступна на бесплатном тарифе, а российские карты сайт не принимает
- Специализированного теста именно на русском языке ни у одной модели нет - честно не выдумываю такую цифру
Куда это ведёт
Восемь бенчмарков разобраны - а порядок постановки задач ещё нет
Ты уже знаешь, где Grok 4.6 реально дешевле, где Fable 5 сильнее и сколько это стоит в рублях
Но какую бы модель ты ни выбрал, результат всё равно зависит от того, как ты формулируешь задачу, а не от того, кто выиграл один тест
Кнопка ведёт в мой закрытый канал. Жмёшь «Подать заявку», впускаю сразу, бот пишет в личку и отдаёт путёвку. Бесплатно
Частые вопросы
Правда ли что Grok 4.6 дешевле Claude Fable 5?
Да. По официальному прайсу на 5 сентября 2026 года Grok 4.6 стоит $2 за миллион входных токенов и $6 за выходных (короткий запрос), Claude Fable 5 - $10 и $50. По сумме вход+выход разница в 7,5 раза в пользу Grok 4.6. В рублях по курсу ЦБ (86,59 за доллар) это 693 рубля против 5195 рублей за миллион единиц текста
Какая модель умнее: Grok 4.6 или Claude Fable 5?
По сводному Artificial Analysis Intelligence Index разница минимальная - 61 балл у Grok 4.6 против 62 у Fable 5, всего один пункт. На отдельных тестах картина разная: Fable 5 впереди на пяти бенчмарках из семи в прямом сравнении (DeepSWE, FrontierCode, APEX-Agents, APEX-SWE, Terminal-Bench), а на CursorBench в режиме Extra High Grok 4.6 обходит его при заметно меньшей цене
Можно ли пользоваться Grok из России без VPN?
Сайт grok.com официально не заблокирован по IP для российских адресов - это подтверждают независимые обзоры. Проблема не в доступе к сайту, а в оплате: российские карты x.ai не принимает, нужна зарубежная карта, посредник или цифровой товар с маркетплейса. Полная инструкция по доступу и оплате - в отдельном гайде про сам Grok
Почему в статье нет сравнения по ARC-AGI, как в других разборах моделей?
У Grok 4.6 нет опубликованной официальной карточки результатов на тесте ARC-AGI - я проверил это дважды, напрямую на живом лидерборде ARC Prize и отдельным поиском по домену arcprize.org, оба раза без единого совпадения. Выдумывать цифру, которой не существует, я не стал - вместо этого статья опирается на восемь других официальных бенчмарков, где у Grok 4.6 реальные цифры есть
Есть ли тест, который сравнивает модели именно на русских задачах?
Специализированного бенчмарка на русском языке или кириллице ни у одной из двух моделей на дату публикации нет ни в одном из проверенных источников. Есть независимые русскоязычные обзоры (Хабр), которые самостоятельно сверили и подтвердили официальные цифры вендора, а не просто перевели пресс-релиз - это ближайшее, что реально проверено, и честно отражено в статье без выдуманных цифр