
Нейросеть пишет код: что она реально умеет, а где ломается
Да, нейросеть пишет рабочий код по описанию на русском. Калькулятор чаевых у меня собрался из одной фразы за 23 секунды и посчитал верно. Ломается она на другом: решает не ту задачу, которую ты имел в виду, и отдаёт результат, который выглядит готовым
Ниже пять моих прогонов подряд с реальными выводами команд и скринами: что получилось, где сломалось и как проверять результат, если читать код ты не умеешь
Собрать первую рабочую вещь на ИИ и не застрять на третьем дне
Может ли нейросеть писать код вместо меня?
Нейросеть пишет рабочий код по описанию на русском языке, и результат запускается без единой строчки от тебя. Синтаксис учить не нужно, задачу ты ставишь словами. Вся оставшаяся работа - решить, что считать готовым: машина отдаёт правдоподобную версию задачи с полной уверенностью, а границы этой версии придумывает сама
Может. Ты описываешь словами, что должно получиться, нейросеть создаёт файл, файл открывается и работает. Никакого «выучи сначала синтаксис» на входе нет: команды ты не пишешь, ты объясняешь задачу как объяснил бы человеку
Дальше начинается то, о чём в рекламе не говорят. Нейросеть не видит твой экран и не знает, что ты имел в виду под словом «сохранять». Она делает правдоподобную версию задачи и отдаёт её с полной уверенностью. Код при этом запускается, кнопки нажимаются, надписи появляются. Сломано внутри
Поэтому весь гайд построен не на рассуждениях, а на прогонах: я поставил пять задач подряд, снял реальные выводы команд и скрины того, что получилось. Где сработало - показываю. Где сломалось - показываю тоже, с доказательством
Как выглядит «нейросеть написала код» на практике
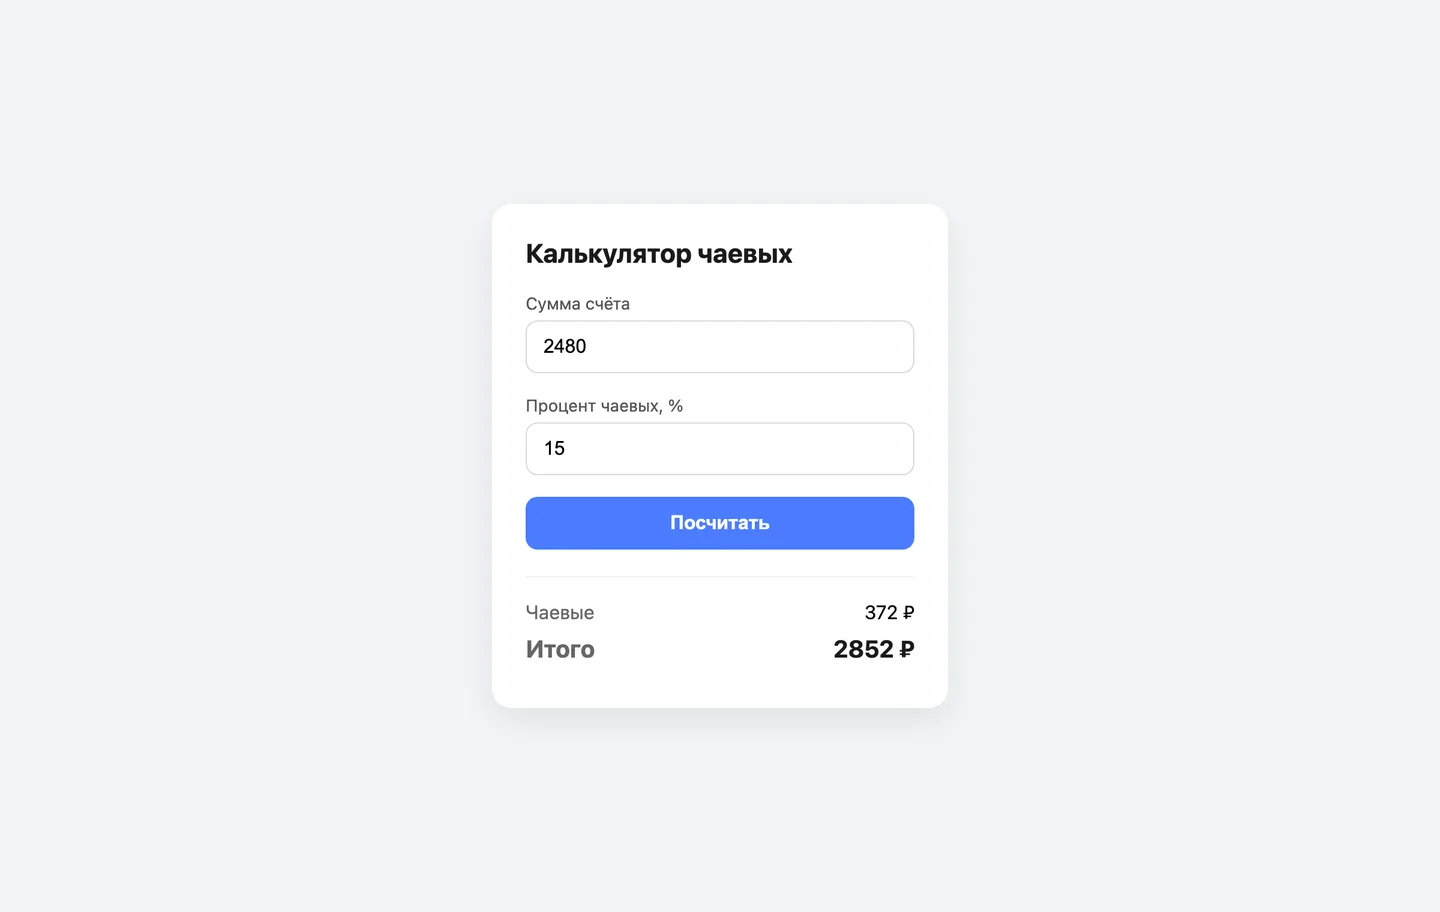
Один запрос в терминал - и через 23 секунды в папке лежит готовый файл на 154 строки. Я попросил калькулятор чаевых одной фразой, открыл результат в браузере, вбил счёт 2480 рублей и 15 процентов и получил верные 372 и 2852. Ни макета, ни редактора, ни заведённого проекта для этого не понадобилось
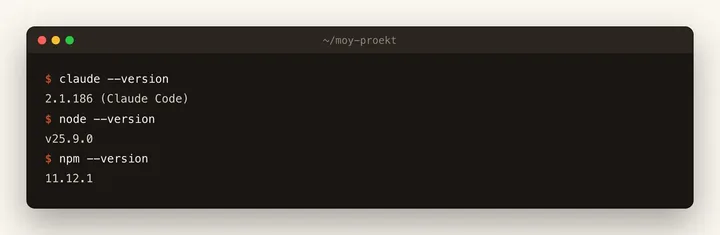
Вот моё окружение на момент прогонов. Три команды, три ответа, ничего больше на компьютере для этого не нужно
Задача первая, самая обычная: калькулятор чаевых. Я не рисовал макет, не заводил проект, не открывал редактор. Одна фраза в терминал
claude -p "Сделай файл index.html - калькулятор чаевых: поле «сумма счёта»,
поле «процент чаевых» (по умолчанию 10), кнопка «Посчитать», вывод суммы
чаевых и итога. Один файл, без внешних библиотек."
Через 23 секунды в папке лежал файл на 154 строки. Я открыл его в браузере, вбил счёт 2480 рублей и 15 процентов, нажал кнопку
Вот это и есть вайбкодинг в самом простом виде: ты сказал, машина собрала, ты проверил руками. Подробнее про сам подход и первый проект за вечер я разбирал в гайде по вайбкодингу, а установку инструмента по шагам - в гайде по Claude Code
Задача была типовая, границы понятные, проверять почти нечего. Дальше становится интереснее
Почему один и тот же запрос даёт разный код?
Нейросеть не помнит прошлый ответ и каждый раз собирает решение заново. Та же фраза во втором прогоне дала другой файл: 126 строк против 154, из 280 строк отличаются 222, совпало 29. Практический вывод: понравившийся результат сохраняй сразу, повторный запрос выдаст новую версию вместо исправленной
Я запустил ту же самую фразу второй раз, слово в слово, в соседней пустой папке. Получил другой файл
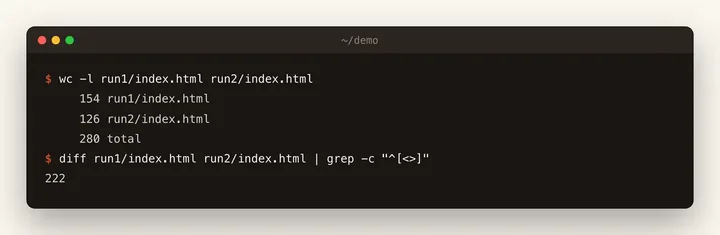
Обе версии работают и обе считают правильно. Но это разные файлы: из 280 строк отличаются 222, общих осталось 29. Разная вёрстка, разные проверки ввода, разные имена внутри
Что из этого следует практически. Первое: не жди, что «повторю запрос и починится» - получится не исправленная версия, а новая. Второе: если результат нравится, сохрани его сразу, иначе не воспроизведёшь. Третье: сравнивать два ответа между собой бесполезно, сравнивать надо каждый с задачей
И отсюда же вылезает более неприятная вещь. Раз машина каждый раз выбирает решение заново, значит и границы задачи она каждый раз додумывает заново
Сколько времени занимает один прогон?
Машинное время одного прогона - от 22,0 до 40,6 секунды, четыре задачи подряд заняли 112,7 секунды. Это меньше двух минут на то, на что у новичка без нейросети ушёл бы вечер. Секундомер при этом показывает только часть счёта: у третьего прогона на разбор и переделку постановки ушло ещё полчаса
Я засекал каждую задачу целиком: от нажатия Enter до момента, когда файл лежит в папке. Вот четыре замера подряд с одной машины
| Задача | Что просил | Время |
|---|---|---|
| Прогон 1 | Калькулятор чаевых, один файл | 23,1 с |
| Прогон 2 | Та же фраза второй раз | 22,0 с |
| Прогон 3 | Форма заявки с сохранением | 40,6 с |
| Прогон 4 | Функция деления счёта плюс проверки к ней | 27,0 с |
Таблица прокручивается вбок →
Четыре готовых файла за 112,7 секунды машинного времени. Меньше двух минут на то, на что без нейросети у новичка ушёл бы вечер
Только вот эти две минуты - не вся стоимость задачи. У третьего прогона я потом полчаса разбирался, куда делись заявки, и переделывал постановку. Машинное время короткое, а время приёмки живёт отдельно и его никто не считает. Именно на этом расходятся замеры продуктивности, о которых ниже
Что нейросеть в коде делает хорошо?
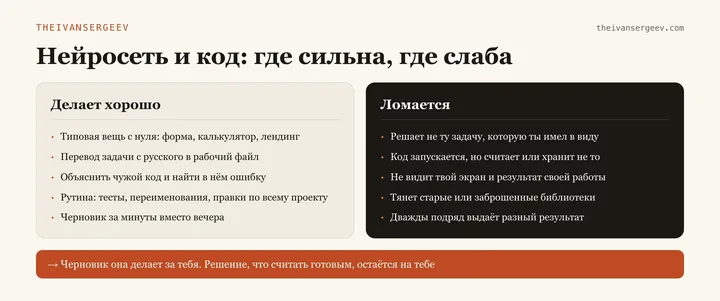
Сильная сторона у нейросети одна: перевод задачи с человеческого языка в работающий файл, и на наборе SWE-bench Verified лидеры к августу 2026 закрывают 95-97 процентов из 500 задач. Всё типовое, что в мире уже написано тысячу раз, она собирает быстрее, чем ты откроешь редактор. Сам набор собран из настоящих проблем открытых проектов, а зачёт ставится машинным прогоном тестов проекта
Речь именно про перевод задачи в файл, а не про изобретение нового. Калькулятор, форма, разбор выгрузки, бот на твоём тексте: такие вещи в мире написаны тысячу раз, и машина собирает их быстрее, чем ты успеешь открыть редактор. Чем типовее задача, тем меньше у машины поводов что-то додумывать за тебя
Насколько хорошо - можно померить. Есть набор задач SWE-bench Verified: 500 настоящих проблем из открытых проектов на GitHub, отобранных инженерами как решаемые. Модель получает описание проблемы и код проекта, а зачёт ставится не на глазок, а прогоном тестов проекта. Это уже не игрушечные задачки, а работа, за которую людям платят
Цифры на этом наборе к августу 2026 такие: в сводке Vals AI от 6 августа лидер закрывает 97 процентов из 500 задач, следом идут 96,2 и 95, то есть вся первая тройка укладывается в два пункта. В параллельной таблице BenchLM от 7 августа те же 95-96 процентов и приписка составителей, что набор подошёл к потолку и уже плохо различает сильные модели между собой. Спорить, умеет ли машина писать код, больше не о чем: вся разница уехала в постановку задачи и приёмку результата
Второй замер - опрос Stack Overflow за 2025 год, больше 49 000 ответов из 177 стран, из них 33 662 про ИИ. 84 процента используют ИИ-инструменты или собираются. То есть спор «пользоваться или нет» в индустрии закончился
А вот дальше в том же опросе начинается вторая половина картины, и она про доверие
Где она ломается: заявки, которых нет
Третий прогон выдал форму заявки, которая выглядит рабочей и при этом никуда ни одной заявки не отправляет. Обе тестовые заявки легли в память моего браузера: в чистом браузере список пуст, отправок наружу в файле ноль. Формально задача выполнена, слово «сохраняться» машина поняла самым дешёвым способом, и ошибка тут в границе задачи
Третья задача была такая, какую ставит человек без опыта. Дословно: «страница с формой заявки: имя, телефон, кнопка. Заявки должны сохраняться, чтобы я потом мог их посмотреть»
Через 40 секунд файл был готов. Я заполнил форму дважды, разными именами
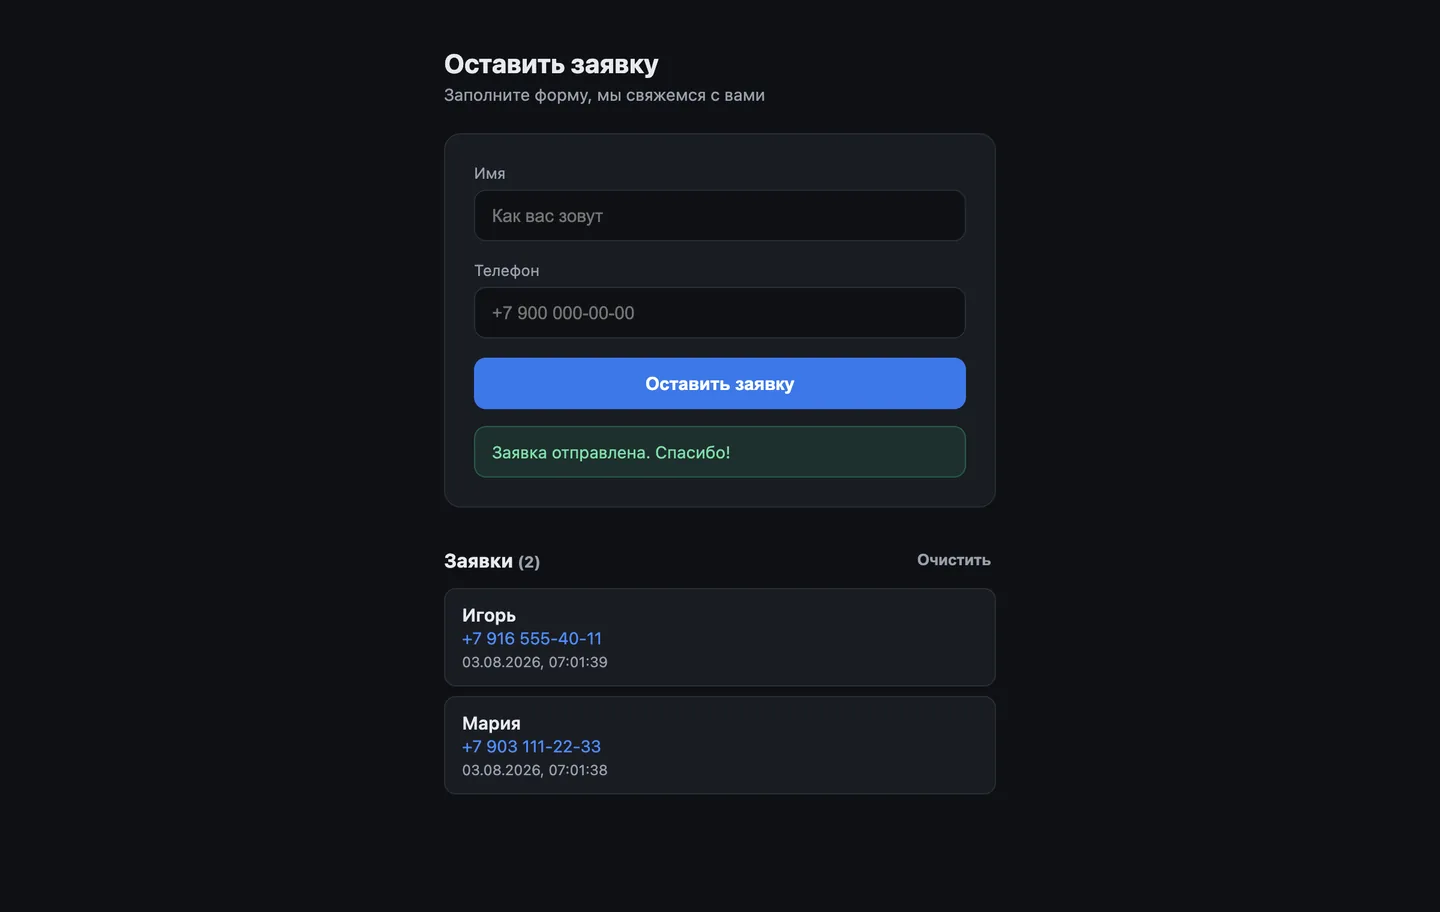
Всё зелёное, обе заявки на месте, счётчик показывает двойку. Человек без опыта на этом месте закрывает ноутбук и считает, что у него есть форма приёма заявок
Теперь то же самое, но я открываю ровно тот же файл в чистом браузере. Как открыл бы его клиент со своего телефона
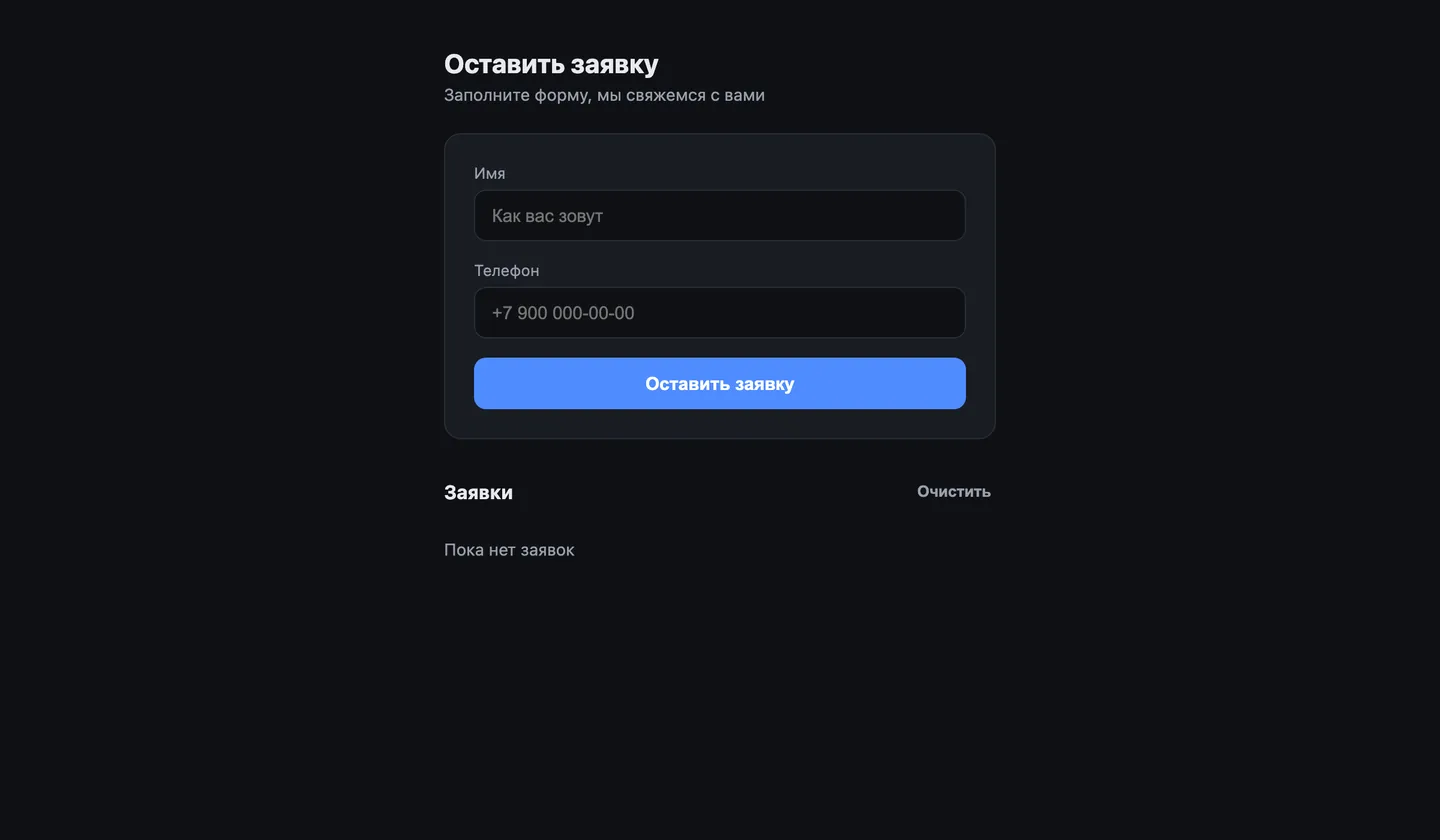
Внутри файла нет ни одной отправки наружу: заявки складываются в память самого браузера. Клиент оставил телефон, увидел «Заявка отправлена. Спасибо!» и ушёл. Ты об этом никогда не узнаешь
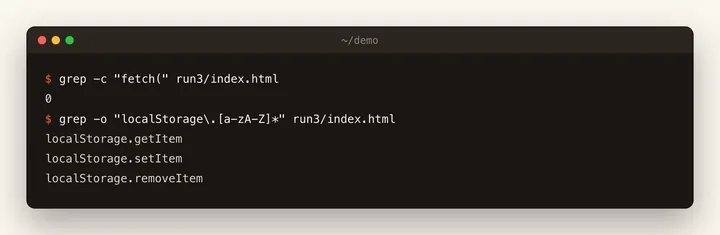
Две команды показывают всю картину, читать код для этого не надо. Отправок на сервер в файле ноль. Обращений к памяти браузера три: положить, достать, стереть. Это вся «база заявок»
Формально нейросеть выполнила задачу: заявки сохраняются, и ты их видишь. Она выбрала самое дешёвое понимание слова «сохраняться». Ошибка не в коде, а в границе задачи, которую я не проговорил
Почему код запускается, но работает неправильно?
Главный дефект нейросети выглядит как «почти правильно»: код запускается, кнопки нажимаются, а результат тихо расходится с задачей. В опросе Stack Overflow это назвали главной болью 66 процентов разработчиков, ещё 45,2 процента отметили, что отладка сгенерированного кода отнимает больше времени. Поймать такое можно только на своём результате
Это не моя личная невезучесть, это самая массовая жалоба индустрии. В том же опросе Stack Overflow 66 процентов разработчиков назвали главной болью «решения ИИ, которые почти правильные, но не совсем». Ещё 45,2 процента отметили, что отладка сгенерированного кода отнимает больше времени
Там же лежит цифра, от которой обычно поднимаются брови: точности ИИ-ответов сильно доверяют 3,1 процента опрошенных. Ещё 29,6 процента отвечают «скорее доверяю», а в сумме не доверяют 45,7 процента: 26,1 скорее нет и 19,6 твёрдо нет. При этом пользуются 84 процента, а каждый день инструмент открывает половина профессиональных разработчиков. Работать с машиной ежедневно и не верить ей на слово - это рабочий режим индустрии, а не противоречие
Причина простая. Когда код падает с ошибкой, ты об этом узнаёшь сразу и бесплатно. Когда код запускается и делает не то, тебе никто ничего не скажет: ни машина, ни браузер, ни клиент, который ушёл
По моим пяти прогонам «почти правильно» бывает четырёх видов, и полезно знать их в лицо:
- Дешёвое толкование. Слово из задачи понято самым простым способом: «сохранять» превратилось в память браузера
- Тишина на краю. На нормальных данных всё верно, на странных молчит и выдаёт бессмыслицу. У меня так прошёл отрицательный счёт
- Устаревшая опора. Подключается настоящая, но давно заброшенная библиотека, и это всплывает через месяц
- Своя проверка на свою работу. Машина пишет тесты ровно на то, что сама учла, и радостно показывает зелёное
Общее у всех четырёх одно: экран выглядит успешно. Именно поэтому нельзя принимать результат по признаку «открылось и не ругается»
Отсюда правило, которое стоит принять до первого проекта: сгенерированный код по умолчанию считается непроверенным. Не плохим, не хорошим - непроверенным. Дальше вопрос только в том, как ты его проверишь
Правда ли, что с нейросетью получается быстрее?
Ускорение зависит от того, кто и что делает: по отчёту DORA за 2025 год больше 80 процентов участников чувствуют рост продуктивности, а в эксперименте METR опытные разработчики вышли на 19 процентов медленнее и сами при этом были уверены, что ускорились. Новичку сравнивать не с чем: без нейросети результата у него не было бы вовсе
Смотря у кого и на какой задаче. Тут есть два больших замера, и они смотрят в разные стороны
Первый - отчёт DORA за 2025 год от Google, почти 5000 участников. 90 процентов используют ИИ в работе, медиана - два часа в день. Больше 80 процентов говорят, что продуктивность выросла, 59 процентов видят положительное влияние на качество кода. При этом высокое доверие к ИИ-коду только у 24 процентов, а низкое или нулевое - у 30
Второй замер интереснее, потому что он не про ощущения. Исследователи METR взяли 16 опытных разработчиков и 246 настоящих задач в проектах, которые эти люди вели годами. Половину задач делали с ИИ, половину без, случайным образом. Результат: с ИИ вышло на 19 процентов МЕДЛЕННЕЕ
Самое неудобное в этом исследовании даже не цифра. До начала участники ждали ускорения на 24 процента. После эксперимента, уже проработав медленнее, они всё равно считали, что ИИ их ускорил примерно на 20 процентов. Ощущение скорости и скорость разошлись почти на 40 процентов
Справедливости ради: сами авторы в обновлении от февраля 2026 года честно пишут, что новый заход дал ненадёжный сигнал: минус 18 процентов у вернувшихся участников при разбросе от минус 38 до плюс 9 и минус 4 у новых. Причину они называют прямо: из эксперимента стали массово отказываться те, кто не готов работать без ИИ, а такой отсев занижает оценку ускорения
В том же тексте авторы добавляют важное: по разговорам с участниками они считают, что в начале 2026 разработчики ускорены сильнее, чем показывал замер 2025, только их собственные данные слишком слабые, чтобы называть размер прибавки. Так что рабочий вывод из всей истории один: личное ощущение «я стал быстрее» доказательством не является, мерить надо по факту сделанного
И заметь, у кого мерили: у людей, которые пять лет знали свой проект наизусть. Новичку, который без ИИ не сделал бы вообще ничего, сравнивать не с чем - у него выигрыш стопроцентный по факту существования результата
Как проверить результат, если не умеешь читать код?
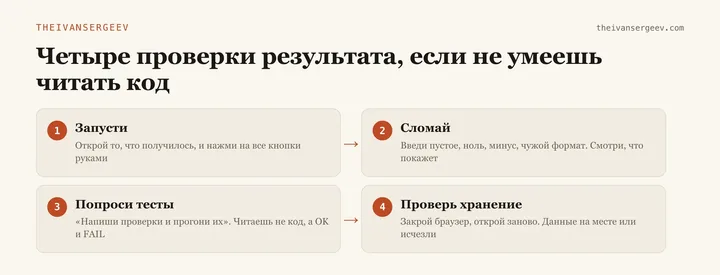
Читать код не нужно, проверяется поведение программы. Четыре шага подряд: запусти и понажимай все кнопки руками, скорми заведомо плохие данные, попроси написать проверки и прогони их, закрой браузер и посмотри, остались ли данные. К проверкам машины обязательно добавь свои случаи - она закрывает ровно то, что учла сама
Это ключевой навык всего подхода, и он не требует ни строчки синтаксиса. Ты проверяешь не текст программы, а то, как она себя ведёт
Третий пункт разберём подробнее, он выглядит сложным, а на деле это одна фраза. Я попросил функцию, которая делит счёт между людьми без потери копеек, и сразу проверки к ней
claude -p "Напиши split.js: функция splitBill(total, people) делит счёт так,
чтобы сумма частей была РОВНО равна счёту. И test.js: проверка на случаях,
которые делятся неровно, с выводом OK или FAIL по каждому."
Дальше ты не читаешь код. Ты запускаешь проверки одной командой и смотришь на слова OK и FAIL
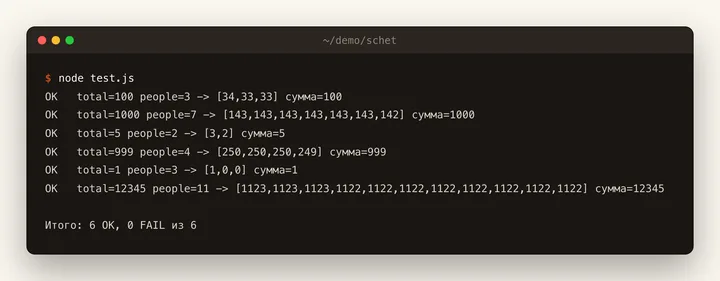
Шесть из шести. Только тут есть ловушка: проверки писала та же нейросеть, которая писала функцию. Она проверила ровно то, что сама и учла. Поэтому я добавил три своих случая, до которых она не додумалась
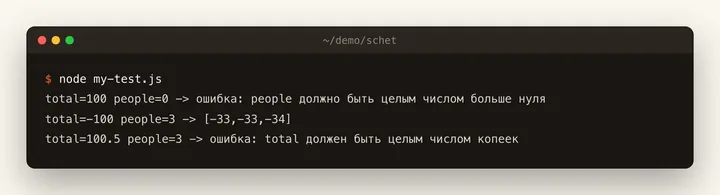
Два из трёх закрыты аккуратно, с понятным текстом ошибки. Третий - отрицательный счёт - прошёл без единого возражения. Ничего страшного не случилось, но именно так и выглядит дефект, который потом всплывает на живых данных
Вывод рабочий: проси тесты, гоняй тесты, и обязательно добавляй свои случаи. Твои случаи - это не про код, это про твой бизнес: пустое поле, ноль, минус, чужой формат телефона, две заявки подряд от одного человека
Можно ли доверять библиотекам, которые она подключает?
Каждое незнакомое имя пакета проверяй до установки командой npm view: в моём прогоне подсказанный пакет ofx оказался настоящим, но заброшенным с июня 2022 года. Бывает и хуже: в работе на 576 000 примеров кода нашлось 205 474 уникальных имени пакетов, которых в природе нет, и такие имена злоумышленники регистрируют специально
Пятая задача: разобрать банковскую выписку в формате OFX, взяв готовую библиотеку. Нейросеть предложила пакет с именем ofx. Я проверил его через магазин пакетов
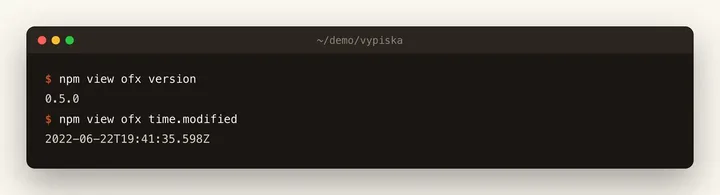
Пакет существует, но его не трогали четыре года. Для домашнего проекта это терпимо, для приёма чужих денег - уже нет
Бывает и хуже, и это измерено. В работе «We Have a Package for You!» исследователи сгенерировали 576 000 примеров кода и нашли 205 474 уникальных имени пакетов, которых не существует в природе. Доля выдуманных пакетов - от 5,2 процента у коммерческих моделей до 21,7 у открытых. Опасность не в том, что установка упадёт, а в том, что кто-то заранее зарегистрирует популярное выдуманное имя и положит туда вредоносный код
К 2026 году это перестало быть теорией и получило собственное имя - слопсквоттинг. В январе 2026 исследователь Aikido Security разобрал случай с пакетом react-codeshift: имя выдумала модель, склеив два настоящих инструмента, и ссылка на несуществующий пакет успела разойтись по 237 репозиториям через файлы инструкций для ИИ-агентов. Там же лежит разбор пакета unused-imports, который подменяет собой настоящий eslint-plugin-unused-imports: его уже пометили как вредоносный, а он всё равно набирал около 233 загрузок в неделю
Полезно знать, как устроены выдуманные имена, потому что на глаз они выглядят настоящими. По той же разборке 38 процентов - склейки двух реальных названий, 13 процентов - опечатки в реальном имени, 51 процент - чистая выдумка. Хуже всего ловится первая группа: имя собрано из настоящих кусков, читается знакомо, и рука сама тянется к установке
Проверка занимает десять секунд и делается одной командой на любой подсказанный пакет
npm view ofx version
npm view ofx time.modified
Правило: имя пакета, которое ты видишь впервые, проверяй до установки. Нет пакета или его бросили пять лет назад - проси другой
Что добавить в задачу, чтобы она не додумывала?
Дырки в постановке нейросеть закрывает сама, молча и самым дешёвым способом: слово «сохранять» она поймёт как ей удобнее, если границу ты не проговорил. Закрывают такие дырки четыре вещи: скажи, куда девается результат, назови, что считается провалом, попроси показать вывод и прогнать проверки, держи один шаг за раз. Чем яснее сформулирована задача, тем меньше разницы, каким инструментом ты её собираешь
Все мои поломки выше - это не поломки нейросети, это дырки в постановке. Она заполняет дырки сама, самым дешёвым способом, и делает это молча
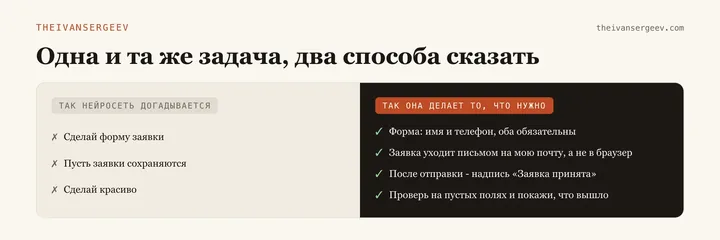
Четыре вещи, которые закрывают большинство дырок:
- Скажи, куда девается результат. Не «сохранять», а «письмом на почту», «в телеграм-бот», «в таблицу». Слово «сохранять» машина понимает как ей удобнее
- Назови, что считается провалом. «Если телефон пустой - не отправлять и показать красным». Без этого поведение на плохих данных придумывается на ходу
- Проси показать результат. «Запусти и покажи вывод», «сделай проверки и прогони их». Тогда машина сама себя ловит на части ошибок
- Держи один шаг за раз. Форма, потом отправка, потом красота. Задача из десяти требований чаще выходит криво, чем три задачи по три
И ещё одно, из сравнения инструментов между собой: чем яснее ты формулируешь, тем меньше разницы, каким именно инструментом собираешь. Терминал, редактор Cursor или что-то третье: расплывчатую задачу криво выполнят все
Какие задачи можно отдавать нейросети, а какие нельзя?
Отдавай нейросети то, что сам проверишь глазами за пять минут: лендинг, калькулятор услуги, форму сбора контактов с отправкой в Телеграм, таблицу учёта, скрипт для рутины. Держи при себе приём платежей, личные кабинеты с паролями и чужие персональные данные. Разница между списками измеряется ценой ошибки и тем, заметишь ли ты её сам
Честные границы, по опыту моих учеников и моих же прогонов
Отдавать спокойно можно: одностраничный сайт или лендинг, калькулятор под свою услугу, форму сбора контактов с отправкой в телеграм, таблицу учёта, бота, который отвечает по твоему тексту, скрипт, который перекладывает файлы или чистит выгрузку. Это всё вещи, где ты сам можешь глазами проверить результат за пять минут
Держать при себе стоит: приём платежей, личные кабинеты с паролями, работу с чужими персональными данными, всё, где ошибка стоит денег или репутации. Не потому что нейросеть не напишет код - напишет. Потому что проверить такой результат «нажми и посмотри» невозможно, а больше у тебя на старте инструментов нет
Разница между двумя списками не в сложности кода, а в цене ошибки. Кривой калькулятор чаевых ты заметишь в тот же вечер и переделаешь за минуту. Кривой приём платежей заметит банк, клиент или проверяющий, и заметит не сразу
Есть и промежуточная зона: интернет-магазин, запись на приём, личный кабинет учеников. Такие вещи собираются, но не за вечер и не первой задачей. Логика простая: сначала три-четыре мелких проекта, на которых ты набиваешь руку в приёмке, и только потом то, что держит чужие данные
Как это выглядит от идеи до готовой вещи за один вечер, я расписывал в гайде про первый продукт на ИИ. Там же про главную причину бросить на третьем дне
Есть и третий вариант, который в этом делении теряется: часть задач из первого списка кодом решать вообще не обязательно. Лендинг, простая запись на услугу и витрина иногда быстрее собираются в конструкторе, и разбор no-code против кода помогает понять, где какой путь дешевле по времени
Простой фильтр на старте: могу ли я проверить это сам за пять минут, не читая код. Да - бери. Нет - либо режь задачу мельче, либо не бери
Что нужно уметь, если код пишет нейросеть?
Синтаксис языка в этот список не входит, нужны три умения. Первое: запустить то, что получилось, и прочитать текст ошибки. Второе: понимать, где живут твои данные и куда они уходят - именно тут сломался третий прогон. Третье: поставить задачу так, чтобы машине нечего было додумывать. Это работа заказчика и приёмщика
Синтаксис языка в этот список не входит. Ты правда можешь собрать рабочую вещь, не запомнив ни одной команды, и мои прогоны выше это показывают
А вот три вещи выучить придётся, иначе упрёшься через неделю. Первое: как запустить то, что получилось, и как посмотреть текст ошибки. Второе: где у твоей задачи живут данные и куда они уходят - именно на этом сломался третий прогон. Третье: как объяснить машине задачу так, чтобы она не додумывала
Работа тут не программистская, а заказчицкая: поставить границы и принять результат. Судя по цифрам DORA, индустрия туда и переезжает - код всё чаще пишет машина
Проверить себя можно на одном вопросе. Возьми любую свою задачу и ответь: как я пойму, что она сделана правильно. Есть внятный ответ вроде «письмо придёт мне на почту за минуту» - задачу можно отдавать машине хоть сейчас. Ответа нет - сначала думай, потом проси код
Так что учить придётся одно: доводить свою задачу до проверяемого результата. Язык при этом машина возьмёт на себя
Источники
- Stack Overflow Developer Survey 2025, раздел AI - доля пользующихся ИИ, доверие к точности, «почти правильные» решения, время на отладку
- METR: Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity - эксперимент на 16 разработчиках и 246 задачах
- METR: обновление эксперимента, февраль 2026 - новые оценки и оговорка авторов о ненадёжности сигнала
- Google: отчёт DORA о разработке с ИИ за 2025 год - охват, время в день, влияние на продуктивность и доверие
- SWE-bench, официальный FAQ - что такое SWE-bench Verified и из чего состоят 500 задач
- We Have a Package for You! Анализ выдуманных пакетов в коде от языковых моделей - 576 000 примеров, 205 474 несуществующих имени пакетов
- Vals AI: таблица SWE-bench Verified и сводка BenchLM по тому же набору - результаты лидеров на 6 и 7 августа 2026 и оценка насыщения набора
- Aikido Security: разбор слопсквоттинга - случаи react-codeshift и unused-imports, доли склеек, опечаток и чистых выдумок
- Официальная документация Claude Code - что делает инструмент и как его поставить, раздел Setup - про отсутствие бесплатного тарифа
- Документация Gemini CLI: квоты и цены - лимит 1000 обращений к модели в сутки на личный гугл-аккаунт
- Собственные прогоны автора 3 августа 2026: пять задач, реальные выводы команд и скрины лежат в основе всех цифр про секунды, строки и проверки
- 800 учеников и больше 5 миллионов подписчиков, которые они собрали, - собственные данные автора по прошедшим потокам
Чек-лист: сохрани себе
Сохрани себе
- Опиши задачу словами и скажи, КУДА девается результат: почта, бот, таблица
- Проси один шаг за раз, а не десять требований в одной фразе
- Открой то, что получилось, и нажми все кнопки руками
- Сломай специально: пустое поле, ноль, минус, чужой формат
- Скажи «напиши проверки и прогони их» и смотри на OK и FAIL
- Добавь свои случаи к проверкам, машина закрывает только то, что учла сама
- Закрой браузер и открой заново: данные на месте или исчезли
- Проверь каждый подсказанный пакет: npm view имя version
- Понравился результат - сохрани файл сразу, второй прогон даст другой
- Деньги, пароли и чужие персональные данные на старте не трогай
Следующий шаг
Пять прогонов ты посмотрел. Дальше - свой первый проект
Повторить это у себя и довести до вещи, которую можно показать, - ровно тот маршрут, который разложен по дням в Лагере. Жми кнопку, бот выдаст путёвку сам и поведёт дальше в личке
Вступай в закрытый канал - бот сразу пришлёт путёвку в ИИ-Лагерь тебе в личку
Частые вопросы
Может ли нейросеть написать код без единой строчки от меня?
Да. Ты формулируешь задачу словами, она создаёт файлы и может сама их запустить. В моих прогонах рабочий калькулятор появился за 23 секунды, форма заявки за 40. Синтаксис языка при этом знать не нужно
Почему код от нейросети запускается, но работает неправильно?
Потому что она заполняет пробелы в задаче сама и самым дешёвым способом. В опросе Stack Overflow 2025 главной болью 66 процентов разработчиков назвали именно решения, которые почти правильные, но не совсем
Как проверить код, если я не умею его читать?
Проверяй поведение, а не текст. Запусти и понажимай кнопки, введи заведомо плохие данные, попроси написать проверки и прогони их, закрой браузер и посмотри, остались ли данные. Четырёх шагов хватает на подавляющую часть дефектов
С нейросетью я буду писать код быстрее?
Не обязательно. По отчёту DORA за 2025 год больше 80 процентов участников чувствуют рост продуктивности, а в эксперименте METR опытные разработчики на своих проектах вышли на 19 процентов медленнее, при этом были уверены, что ускорились. Новичку сравнивать не с чем: без ИИ у него результата не было бы вообще
Можно ли доверять библиотекам, которые предлагает нейросеть?
Проверять обязательно. В моём прогоне пакет оказался настоящим, но заброшенным с 2022 года. В исследовании на 576 000 примеров кода нашлось 205 474 уникальных имени несуществующих пакетов, и злоумышленники такие имена регистрируют специально
Нужно ли мне учить программирование?
Синтаксис нет. Нужны три вещи: уметь запустить результат и прочитать текст ошибки, понимать где живут твои данные, и ставить задачу без дырок. Это работа заказчика и приёмщика, а не программиста
Нейросеть сама записывает код в файл или мне копировать из чата?
Зависит от того, чем ты пользуешься. Чат в браузере отдаёт код текстом, и переносить его в файл придётся руками. Инструмент, который стоит у тебя на компьютере, создаёт и правит файлы сам: во всех пяти прогонах выше я не скопировал ни одной строчки, файл сразу лежал в папке. Перед первой правкой такой инструмент спрашивает разрешение, и это ровно тот момент, когда стоит посмотреть, что именно он собрался менять
Сколько стоит, чтобы нейросеть писала код?
Начать можно без оплаты. У Gemini есть бесплатный терминальный инструмент с лимитом 1000 обращений к модели в сутки на личный гугл-аккаунт, на первые проекты этого хватает с запасом. У Claude Code бесплатного тарифа нет: документация прямо требует платный аккаунт. Цены на редактор Cursor разобраны отдельно. На пробу денег не нужно, они появляются, когда ты гоняешь машину каждый день
Что успеешь собрать за вечер новичку?
Лендинг, калькулятор под свою услугу, форму сбора контактов с отправкой в телеграм, простой скрипт для рутины. Не стоит брать приём платежей, личные кабинеты и чужие персональные данные: проверить такой результат глазами за пять минут невозможно
Иван Сергеев
Вайбмаркетинг и вайбкодинг для тех, кто начинает с нуля. Вырастил свою аудиторию до сотен тысяч подписчиков на контент-заводе на ИИ и помог 800 людям собрать больше 5 миллионов подписчиков
Читайте также
Вайбкодинг: что это простыми словами и как начать с нуля в 2026
Термин, метод и первый проект за вечер с нуля
Как пользоваться Claude Code: установка и 9 шагов до проекта
Установка на Mac и Windows по шагам, первый запуск
Работа с Codex в VS Code: сравнение с Claude Code для новичка
Один промпт двум инструментам и честное сравнение
СИСТЕМА: первый продукт на ИИ за один вечер, по шагам (2026)
Система, которая доводит до готового результата