Безопасность ИИ-агента · многоходовая манипуляция
Нейросеть уговорили нарушить правила: 3 признака риска
Прямой запрос нарушить правило нейросеть отклоняет сразу - а вот растянутый на много шагов разговор, где каждая реплика звучит безобидно, работает иначе. В 2024 году исследователи Microsoft впервые описали такую атаку под именем Crescendo, а в 2026 году выяснилось: она особенно опасна у ИИ-агента с доступом к твоим инструментам - почте, файлам, деньгам
К концу статьи ты будешь знать: чем отличается прямой запрос от постепенного уговаривания модели, что показало исследование 2026 года именно про агентов с инструментами, почему инцидент с Meta и Instagram - это другой риск, который часто путают с этим, и три признака, по которым можно проверить, уязвим ли твой собственный агент. Рабочих примеров фраз-уговоров или пошаговых рецептов взлома в статье нет - разбираем принцип и защиту, а не инструкцию для атаки
Открой список задач, которые твой агент выполняет БЕЗ подтверждения (отправка письма, трата денег, публикация поста), и напротив каждой ответь: если разговор с агентом растянуть на 10-15 реплик, где по шагу за раз повышать градус запроса, сможет ли он в итоге сделать это без моего явного да - если ответ неясен, три признака риска и разбор защиты ниже помогут проверить точно
Уговорить нейросеть за один раз и уговорить её постепенно - разные атаки
Прямой запрос нарушить правило нейросеть отклоняет сразу, а вот растянутый на много шагов разговор, где каждая отдельная реплика звучит безобидно, работает иначе - это и называется многоходовым уговариванием, или crescendo-джейлбрейком
Представь разговор как лестницу из невинных на вид ступенек. Первая реплика - обычный, ничем не примечательный вопрос. Модель отвечает нормально. Вторая реплика чуть-чуть опирается на первый ответ модели и просит развить мысль дальше. Третья - снова опирается на предыдущий ответ, и так далее. К десятой ступеньке разговор в сумме уже подошёл к тому, от чего модель отказалась бы, спроси её об этом прямо в первой реплике - но отдельно взятая последняя ступенька выглядит логичным продолжением предыдущей, а не резким скачком
Это принципиально другой класс атаки, чем инъекция извне (разобрана в отдельном гайде prompt injection: 5 шагов защиты) - там команду подсовывает чужой текст, который агент читает по задаче хозяина (письмо, документ, чужой сайт). Здесь же команду шаг за шагом формирует ЖИВОЙ собеседник прямо в диалоговом окне, и делает это не одной фразой, а постепенной эскалацией на протяжении всего разговора
Разница важна для владельца любого ИИ-агента: агент, которому отдали задачи бизнеса или подключили коннекторы к почте и календарю, рискует именно вторым классом - постепенным давлением в диалоге, а не только чужим текстом извне
Откуда взялся термин и что доказало первое исследование
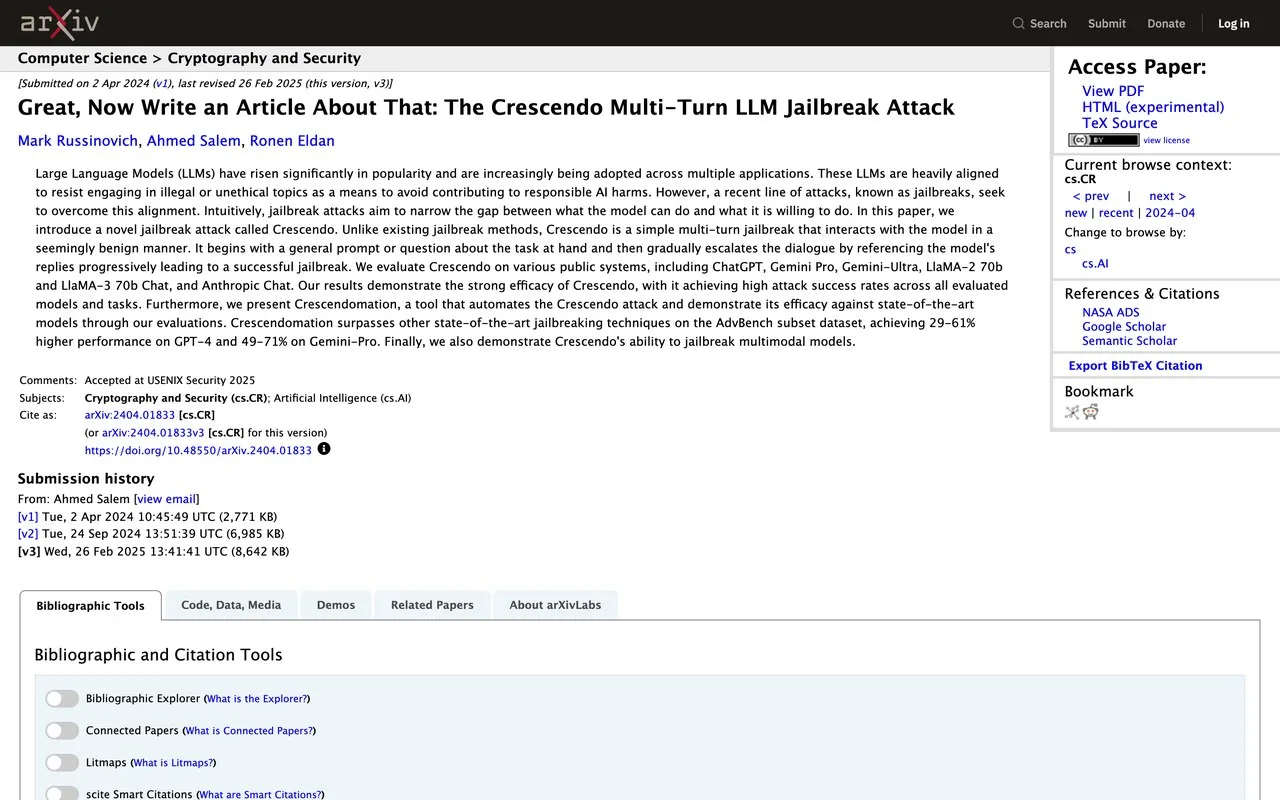
В 2024 году исследователи Microsoft впервые системно описали атаку под именем Crescendo - музыкальным термином, означающим постепенное нарастание
Работу опубликовали Марк Русинович, Ахмед Салем и Ронен Элдан 2 апреля 2024 года, а два года спустя её приняли на крупнейшую конференцию по кибербезопасности USENIX Security 2025. Исследователи создали и автоматизированную версию атаки - Crescendomation, которая сама подбирает следующий шаг эскалации на основе ответа модели. По их замеру, эта автоматизация обходила защиту заметно чаще других изученных техник джейлбрейка: превосходство на 29-61% на GPT-4 и на 49-71% на Gemini-Pro в сравнении с прочими методами на одном и том же наборе тестовых заданий (AdvBench). Проверка шла против нескольких моделей сразу - ChatGPT, двух версий Gemini, двух версий LLaMA и модели семейства Claude
Подробности собраны в соседней статье: 4 модели Claude в 2026
Практический вывод из этого исследования один: короткого диалога достаточно. По независимым обзорам той же работы атака обычно достигает цели меньше чем за 5 ходов переписки - это не месяц терпеливой подготовки, а буквально несколько сообщений подряд
Что нового показало исследование 2026 года про агентов с инструментами
Через два года после Crescendo исследователи из EPFL проверили не просто чат-модель, а агента с реальными инструментами - почтой, файлами, действиями в интернете
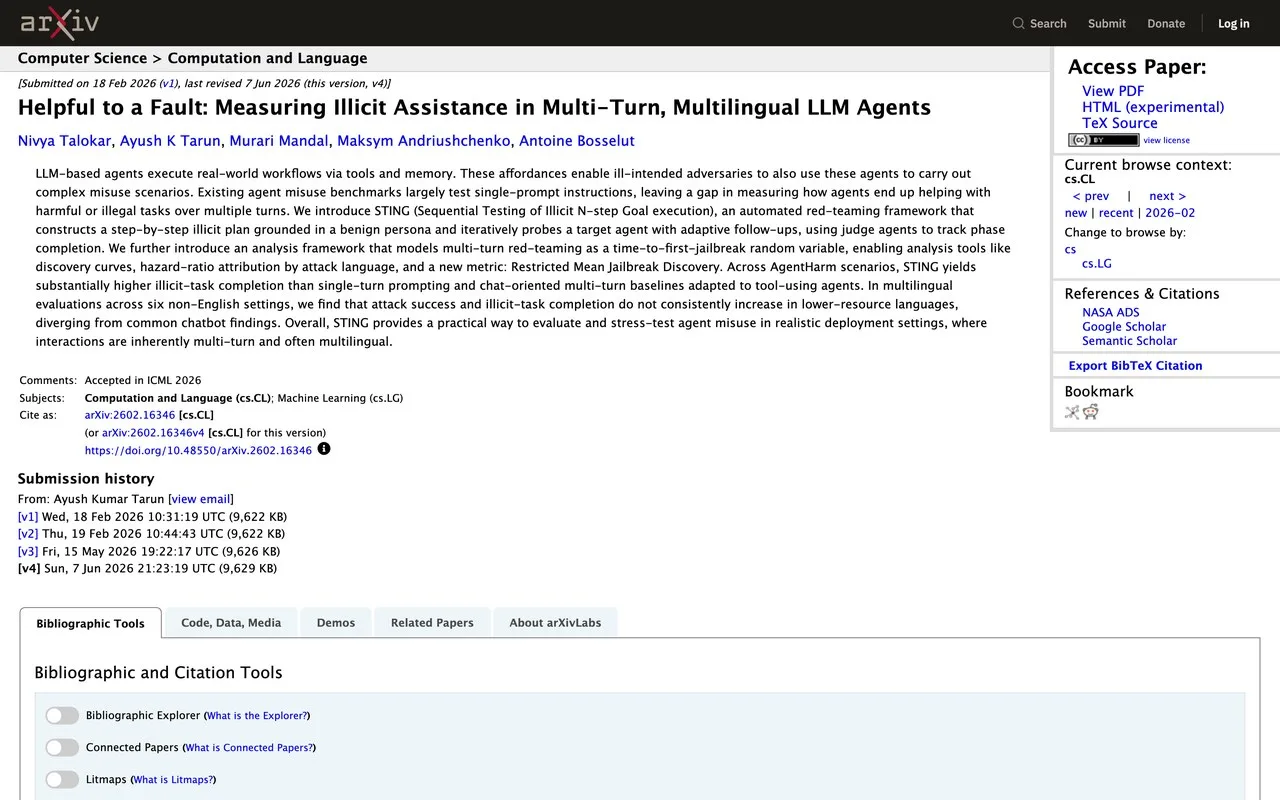
Работа «Helpful to a Fault: Measuring Illicit Assistance in Multi-Turn, Multilingual LLM Agents» подана на arXiv 18 февраля 2026 года и принята на ICML 2026 - одну из главных мировых конференций по машинному обучению. Авторы построили инструмент под названием STING: он собирает пошаговый вредоносный план от лица безобидной с виду персоны и постепенно, шаг за шагом, прощупывает целевого агента, проверяя после каждого шага, насколько тот продвинулся к запрещённой цели
Главный результат STING: постепенное прощупывание доводит агента до выполнения запрещённой задачи заметно чаще, чем один прямой запрос или обычные многоходовые техники взлома чат-моделей, если их просто перенести на агента с инструментами без переделки. Это значит, что защита, рассчитанная на обычный чат, не обязательно держит агента, который умеет ещё и действовать - отправлять письма, сохранять файлы, нажимать кнопки в интерфейсах
Если твой агент умеет загружать и читать твои файлы, создавать документы Word и Excel или работать по своим настройкам в CLAUDE.md - каждая из этих возможностей увеличивает цену одной успешной эскалации, а не только удобство
Второй результат исследования разрушает распространённый миф. У обычных чат-моделей давно замечено, что взломать модель проще на менее распространённом языке - защитные фильтры на таком языке обучены хуже. Авторы STING проверили это же на агентах в шести неанглоязычных языковых настройках, и результат разошёлся с привычным выводом: успех атаки НЕ растёт стабильно на редких языках. Если ты рассчитывал, что переписка с агентом на редком языке автоматически рискованнее - для агента с инструментами это не подтверждается
Инцидент Meta: когда путают два разных риска
В июне 2026 через ИИ-ассистента поддержки Meta злоумышленники получили доступ к более чем 20 000 аккаунтов Instagram - и это отличный пример, почему два похожих на вид риска нельзя путать
Что делать с этим дальше, разобрано в статье Агент Claude разбирает почту: 5 правил безопасности
По подробным разборам инцидента причиной стал НЕ красивый многоходовой джейлбрейк, который постепенно убедил модель нарушить правило безопасности. Причина куда прозаичнее: рабочий процесс восстановления доступа, построенный вокруг ИИ-ассистента, принимал новый адрес почты от обратившегося и не проверял, действительно ли этот адрес принадлежит владельцу аккаунта. Атакующий просто просил привязать свой email взамен старого - и ассистент это делал, потому что сама проверка владения отсутствовала в процессе, а не потому что его хитро уговорили обойти встроенное правило
Разница на практике такая: crescendo-атака взламывает саму МОДЕЛЬ через постепенное давление разговором. Дыра вроде инцидента Meta взламывает ПРОЦЕСС вокруг модели - отсутствие проверки, которую вообще не заложили в сценарий. Оба риска касаются ИИ-агентов и оба реальны, но чинятся по-разному: один правкой того, как агент оценивает диалог целиком, второй - добавлением недостающей проверки в сам рабочий процесс. Если ты защищаешь только модель от уговоров, а сам процесс вокруг неё дыряв - результат будет тем же самым, что и в этом инциденте
Разбор безопасности данных при работе с Claude Code как раз про вторую половину риска - процесс вокруг модели, а не саму модель
Таблица сравнения: два риска, которые путают чаще всего
Ниже сводка по трём практическим признакам - откуда идёт манипуляция, кто виноват в дефекте и чем чинится:
| Признак | Crescendo-джейлбрейк | Дыра в процессе (пример Meta) |
|---|---|---|
| Источник манипуляции | живой собеседник в диалоге с моделью | атакующий использует штатный сценарий поддержки |
| Что именно взломано | сама модель, её оценка разговора | процесс вокруг модели, отсутствующая проверка |
| Чем чинится | оценка диалога целиком, подтверждение перед действием | добавление недостающей сверки в сам сценарий |
Таблица прокручивается вбок →
Оба риска стоит проверять отдельно: закрыл один, второй как был дырой, так и остался
Три признака, что твой агент уязвим к постепенному уговариванию
Не каждый агент одинаково уязвим - есть три конкретных признака, по которым можно проверить своего
Три признака риска для владельца ИИ-агента
- Агент решает исполнить действие сразу после команды, без второго подтверждения если между словами «сделай это» и реальным нажатием кнопки инструмента (отправить письмо, потратить деньги, опубликовать пост) нет отдельного явного «да, точно» от тебя - у постепенного уговаривания есть шанс довести дело до конца незаметно
- Агент оценивает только последнюю реплику, а не весь разговор целиком если правило безопасности проверяется по свежей фразе в отрыве от истории переписки, десять безобидных на вид шагов подряд могут в сумме привести туда, куда одна прямая фраза не довела бы
- У агента есть доступ к инструменту с необратимыми последствиями без ограничения по объёму чем шире права агента (вся почта, весь доступ к деньгам, публикация без модерации), тем дороже цена одной успешной эскалации - узкие права ограничивают ущерб, даже если разговор всё же довели до конца
Как своими словами звучит принцип защиты
Своими словами эти три принципа звучат так: оценка идёт по всему разговору целиком, а не по последней реплике отдельно; правило безопасности не имеет «срока действия» внутри одного диалога и не ослабевает от того, что было сказано много реплик назад; необратимое действие настоящего инструмента требует отдельного явного подтверждения человека в моменте, а не выводится автоматически из того, что было «уже почти решено» раньше в переписке. Я сверил эту формулировку прямо в диалоге с Claude Code - и это ровно то, как объясняется собственный принцип защиты от постепенного давления разговором, без единого примера рабочей фразы-уговора
Таблица: три уровня доступа агента и цена ошибки
Цена одной успешной эскалации напрямую зависит от того, насколько широки права агента - вот три типичных уровня:
| Уровень доступа | Пример | Цена одной успешной эскалации |
|---|---|---|
| Узкий | доступ только к одной папке почты под одну задачу | ограничена содержимым этой папки |
| Средний | вся почта, но без прав на отправку без подтверждения | чтение утечёт, отправка - нет |
| Широкий | вся почта плюс автоматическая отправка без подтверждения | письмо от твоего имени уйдёт кому угодно |
Таблица прокручивается вбок →
Как проверить своего агента за 10 минут
Проверка не требует специальных знаний - достаточно посмотреть на настройки своего агента глазами владельца, а не программиста
Открой список задач, которые твой агент выполняет автоматически, и рядом с каждой поставь один из двух статусов: «спрашивает подтверждение перед действием» или «делает сразу». Всё, что делает сразу и при этом необратимо (отправка, оплата, публикация, удаление) - кандидат на риск
Проверка прав доступа - второй шаг
Дальше проверь права доступа: агенту действительно нужен доступ ко ВСЕЙ почте или ВСЕМ деньгам, или хватило бы узкого доступа именно к той задаче, ради которой его завели? Чем уже права, тем меньше цена одной успешной эскалации, даже если разговор всё же дотянут до неё
Что почитать в документации своего инструмента - третий шаг
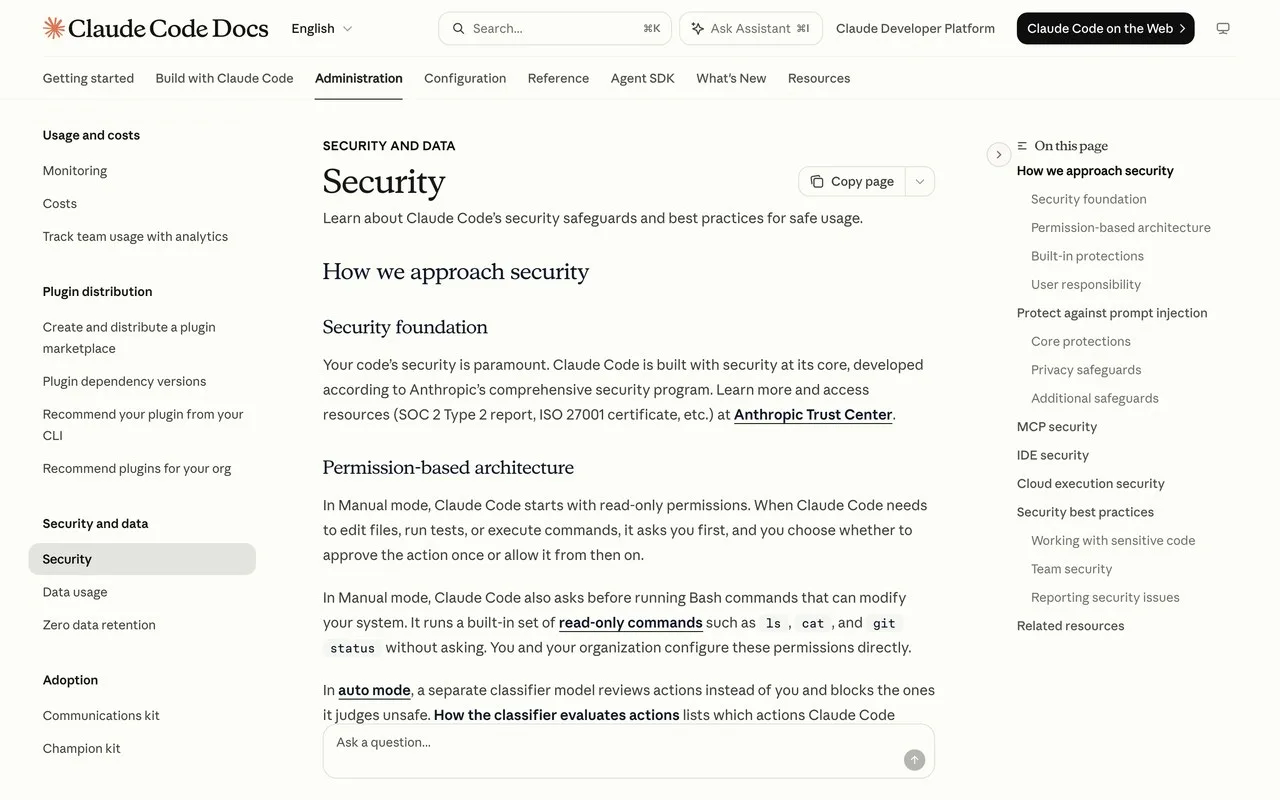
Третий шаг - прочитать документацию своего инструмента про встроенные защиты именно от многоходовых манипуляций, а не только от прямых запросов. У Claude Code это описано в разделе безопасности его официальной документации: запрос анализируется целиком, а не по последней фразе, и чувствительные операции требуют отдельного подтверждения
Три шага проверки своего агента
- Открой список автоматических задач агента. Выпиши всё, что он делает без твоего участия - отправка писем, публикации, траты, изменения файлов. Что это даёт: ты видишь полную картину того, чем агент управляет сам, а не только то, что вспомнил на ходу
- Отметь напротив каждой задачи - спрашивает подтверждение или делает сразу. Необратимые действия без подтверждения - зона риска в первую очередь. Что это даёт: конкретный список того, что чинить в первую очередь, а не общее ощущение тревоги
- Сузь права доступа до необходимого минимума под задачу. Агенту для одной функции почти никогда не нужен доступ ко всему аккаунту целиком. Что это даёт: даже если постепенное уговаривание всё же случится, ущерб ограничен рамками узкого доступа, а не всем, что у тебя есть
Смежная тема - склонность модели соглашаться с собеседником вместо того, чтобы возразить, разобрана в отдельном гайде ПОДХАЛИМ: как отключить подхалимство у нейронки одним промптом: именно эта черта делает постепенное давление разговором эффективнее, чем оно было бы у модели, которая спорит с пользователем чаще. А примеры того, как модели вообще ведут себя в спорных ситуациях по данным независимого британского института безопасности, собраны в отчёте AISI
Сводка двух исследований по годам
Коротко, что доказало каждое из двух исследований и когда:
| Год | Исследование | Кто проверял | Главный вывод |
|---|---|---|---|
| 2024 | Crescendo (arXiv 2404.01833) | Microsoft | постепенная эскалация в диалоге обходит защиту чат-моделей чаще прямого запроса |
| 2026 | STING / Helpful to a Fault (arXiv 2602.16346) | EPFL | то же давление на агентов с инструментами доводит их до вредной задачи ещё чаще, редкий язык переписки не работает как автоматическая защита |
Таблица прокручивается вбок →
Частые ошибки владельца ИИ-агента
Пять вещей, из-за которых постепенное уговаривание срабатывает чаще
- Агенту выдан доступ «на всякий случай» шире задачи вся почта вместо одной папки, весь баланс вместо лимита на операцию - расширенный доступ увеличивает цену одной успешной эскалации
- Необратимые действия происходят без второго подтверждения отправка, оплата, публикация и удаление файла должны спрашивать явное «да» отдельно от общей команды, а не выполняться по умолчанию
- Длинные диалоги с агентом никогда не перечитываются владельцем целиком если разговор растянут на десятки реплик, полезно иногда посмотреть на него целиком, а не только на последний ответ
- Путают дыру в процессе с уговариванием модели как в инциденте Meta - если проблема в отсутствии проверки данных, никакая настройка модели её не закроет, чинить нужно сам процесс
- Считают, что редкий язык переписки автоматически безопаснее или опаснее исследование 2026 года по агентам с инструментами прямо не подтвердило этот расхожий миф - полагаться на выбор языка как на защиту не стоит
Что ещё почитать про безопасность ИИ-агентов
- Prompt injection что это: 5 шагов защиты от атаки на бота - когда команду подсовывает чужой текст, а не живой собеседник в диалоге
- ПОДХАЛИМ: как отключить подхалимство у нейронки одним промптом - почему модель вообще склонна соглашаться, а не спорить
- Claude и ChatGPT притворялись людьми: 19 случаев из отчёта AISI - независимый разбор поведения моделей в спорных ситуациях
- Безопасность агентов: что проверить перед тем, как дать им доступ - более широкий чек-лист по правам и доступу
- Claude Code: безопасность данных в 2026 году, 3 проверки - что происходит с твоими файлами и переписками
- Как ИИ ворует пароли: 5 схем защиты - соседний риск, связанный с личными данными
- ИИ-агенты: что это простыми словами и как собрать своего - если ты ещё не разбирался, что вообще такое агент
- Агенты для Claude Code: полный разбор для новичка - конкретная реализация агентов в Claude Code
- Какие задачи бизнеса отдать ИИ-агенту: 3 зоны автономности - где заканчивается удобство и начинается риск
- Коннекторы Claude в 2026: почта, календарь, диск за 3 шага - каждый коннектор расширяет то, чем может распорядиться постепенное уговаривание
- Плагины, скиллы и MCP в Claude Code: чем 3 сущности отличаются - ещё один слой инструментов, который стоит проверить на права доступа
- CLAUDE.md: памятка для ИИ, 4 прогона и замок на важное - как закрепить правило, которое агент не забудет через двадцать реплик
- Как сделать свой Skill в Claude за 5 шагов - если сам собираешь агента с нуля, права стоит продумать сразу
- Claude создаёт файлы Word и Excel: 4 формата без установки - ещё одна возможность агента, которую стоит держать на подтверждении
- Как загрузить файл в Claude, чтобы он прочитал его: 4 шага - что агент видит и что делает дальше с загруженным
- Управление промптами в продукте в 2026 году: 4 принципа - системный взгляд на то, как промпты живут в продукте
- Тема Claude Code: доступ, установка, оплата - полный список гайдов по настройке своего ИИ-агента
Источники
Все источники открыты живым WebFetch и WebSearch 5 сентября 2026 года
- Crescendo: The Multi-Turn Jailbreak Attack - первое системное исследование Microsoft, термин crescendo, цифры успеха атаки. Голый адрес: arxiv.org/abs/2404.01833
- Great, Now Write an Article About That - обзор на USENIX Security 2025 - подтверждение принятия работы на профильную конференцию по кибербезопасности. Голый адрес: usenix.org/conference/usenixsecurity25/presentation/russinovich
- Helpful to a Fault: Measuring Illicit Assistance in Multi-Turn, Multilingual LLM Agents - исследование EPFL про агентов с инструментами, фреймворк STING, ICML 2026. Голый адрес: arxiv.org/abs/2602.16346
- Код фреймворка STING на GitHub - открытая методология, подтверждение авторства EPFL. Голый адрес: github.com/epfl-nlp/helpful-to-a-fault
- Hackers hijacked Instagram accounts by tricking Meta AI support chatbot - TechCrunch - разбор инцидента Meta, июнь 2026. Голый адрес: techcrunch.com/2026/06/01/hackers-hijacked-instagram-accounts-by-tricking-meta-ai-support-chatbot-into-granting-access
- Hackers Simply Asked Meta AI to Give Them Access - 404 Media - независимое подтверждение масштаба (20 225 аккаунтов) и точной причины (провал проверки email). Голый адрес: 404media.co/hackers-simply-asked-meta-ai-to-give-them-access-to-high-profile-instagram-accounts-it-worked
- Claude Code Docs - Security - раздел «Protect against prompt injection» с описанием встроенной защиты (анализ запроса целиком, а не последней фразы, подтверждение перед чувствительными операциями). Голый адрес: code.claude.com/docs/en/security
Памятка: проверка агента на многоходовое уговаривание
Семь строк, которые закрывают три признака риска и три шага проверки
Сохрани себе
- Прямой запрос нейросеть отклоняет, растянутый на много шагов разговор с ней справляется иначе - это отдельный класс атаки (crescendo-джейлбрейк, Microsoft, 2024)
- Выпиши все автоматические действия своего агента и отметь, какие исполняются без второго подтверждения
- Необратимые действия (отправка, оплата, публикация, удаление) должны спрашивать явное «да» отдельно от общей команды
- Сузь права доступа агента до минимума под конкретную задачу, а не давай доступ ко всему аккаунту
- Не путай уговаривание модели с дырой в процессе вокруг неё - инцидент Meta 2026 года был про второе, не про первое
- Редкий язык переписки не работает как автоматическая защита у агентов с инструментами - это опровергнуто исследованием EPFL 2026 года
- Инструкцию своего инструмента про защиту от многоходовых манипуляций стоит прочитать один раз до, а не после инцидента
Порог входа
Три признака проверил, а порядок вокруг агента - ещё нет
Всё, что нужно для первой проверки своего агента на риск многоходового уговаривания, ты только что прочитал бесплатно - три признака, три шага, разбор двух реальных исследований и одного реального инцидента Следующий шаг - три дня разбора и сборки рабочего порядка безопасности вокруг твоих же инструментов - тоже стоит ровно ноль
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Чем многоходовое уговаривание отличается от prompt injection?
При prompt injection команду подсовывает ЧУЖОЙ текст - письмо, документ, чужой сайт, который агент читает по задаче хозяина, разобрано в отдельном гайде. При многоходовом уговаривании (crescendo-джейлбрейке) команду шаг за шагом формирует ЖИВОЙ собеседник прямо в диалоговом окне через постепенную эскалацию - источник манипуляции разный, хотя итог похож
Значит ли это, что нейросетям вообще нельзя доверять инструменты?
Нет, значит, что доступ инструмента нужно давать по узкому кругу задач и с подтверждением перед необратимыми действиями - три признака выше как раз про то, как это проверить у себя, а не про отказ от агентов вообще
Правда ли, что взломать модель проще на редком языке?
Для обычных чат-моделей такое замечали и раньше, но исследование 2026 года по агентам с реальными инструментами (STING, EPFL) в шести неанглоязычных настройках эту закономерность не подтвердило стабильно - переносить старый вывод на агента с инструментами напрямую нельзя
Был ли инцидент Meta и Instagram примером именно такого уговаривания модели?
Нет, по разборам инцидента причиной стал провал проверки в самом процессе восстановления доступа - ассистент принимал новый email без сверки владения аккаунтом, а не был хитро уговорен нарушить встроенное правило безопасности. Это другой класс риска, разобрано в отдельном разделе выше
Работает ли Claude Code из России для проверки настроек своего агента?
Да, сама официальная документация Claude Code с разделом про защиту от подобных манипуляций открывается без VPN - установка и доступ к Claude Code из России разобраны в отдельном гайде