ScrapeGraphAI · сбор данных без парсера · сентябрь 2026
Скрапинг сайта без кода: собрать список словами за 4 шага
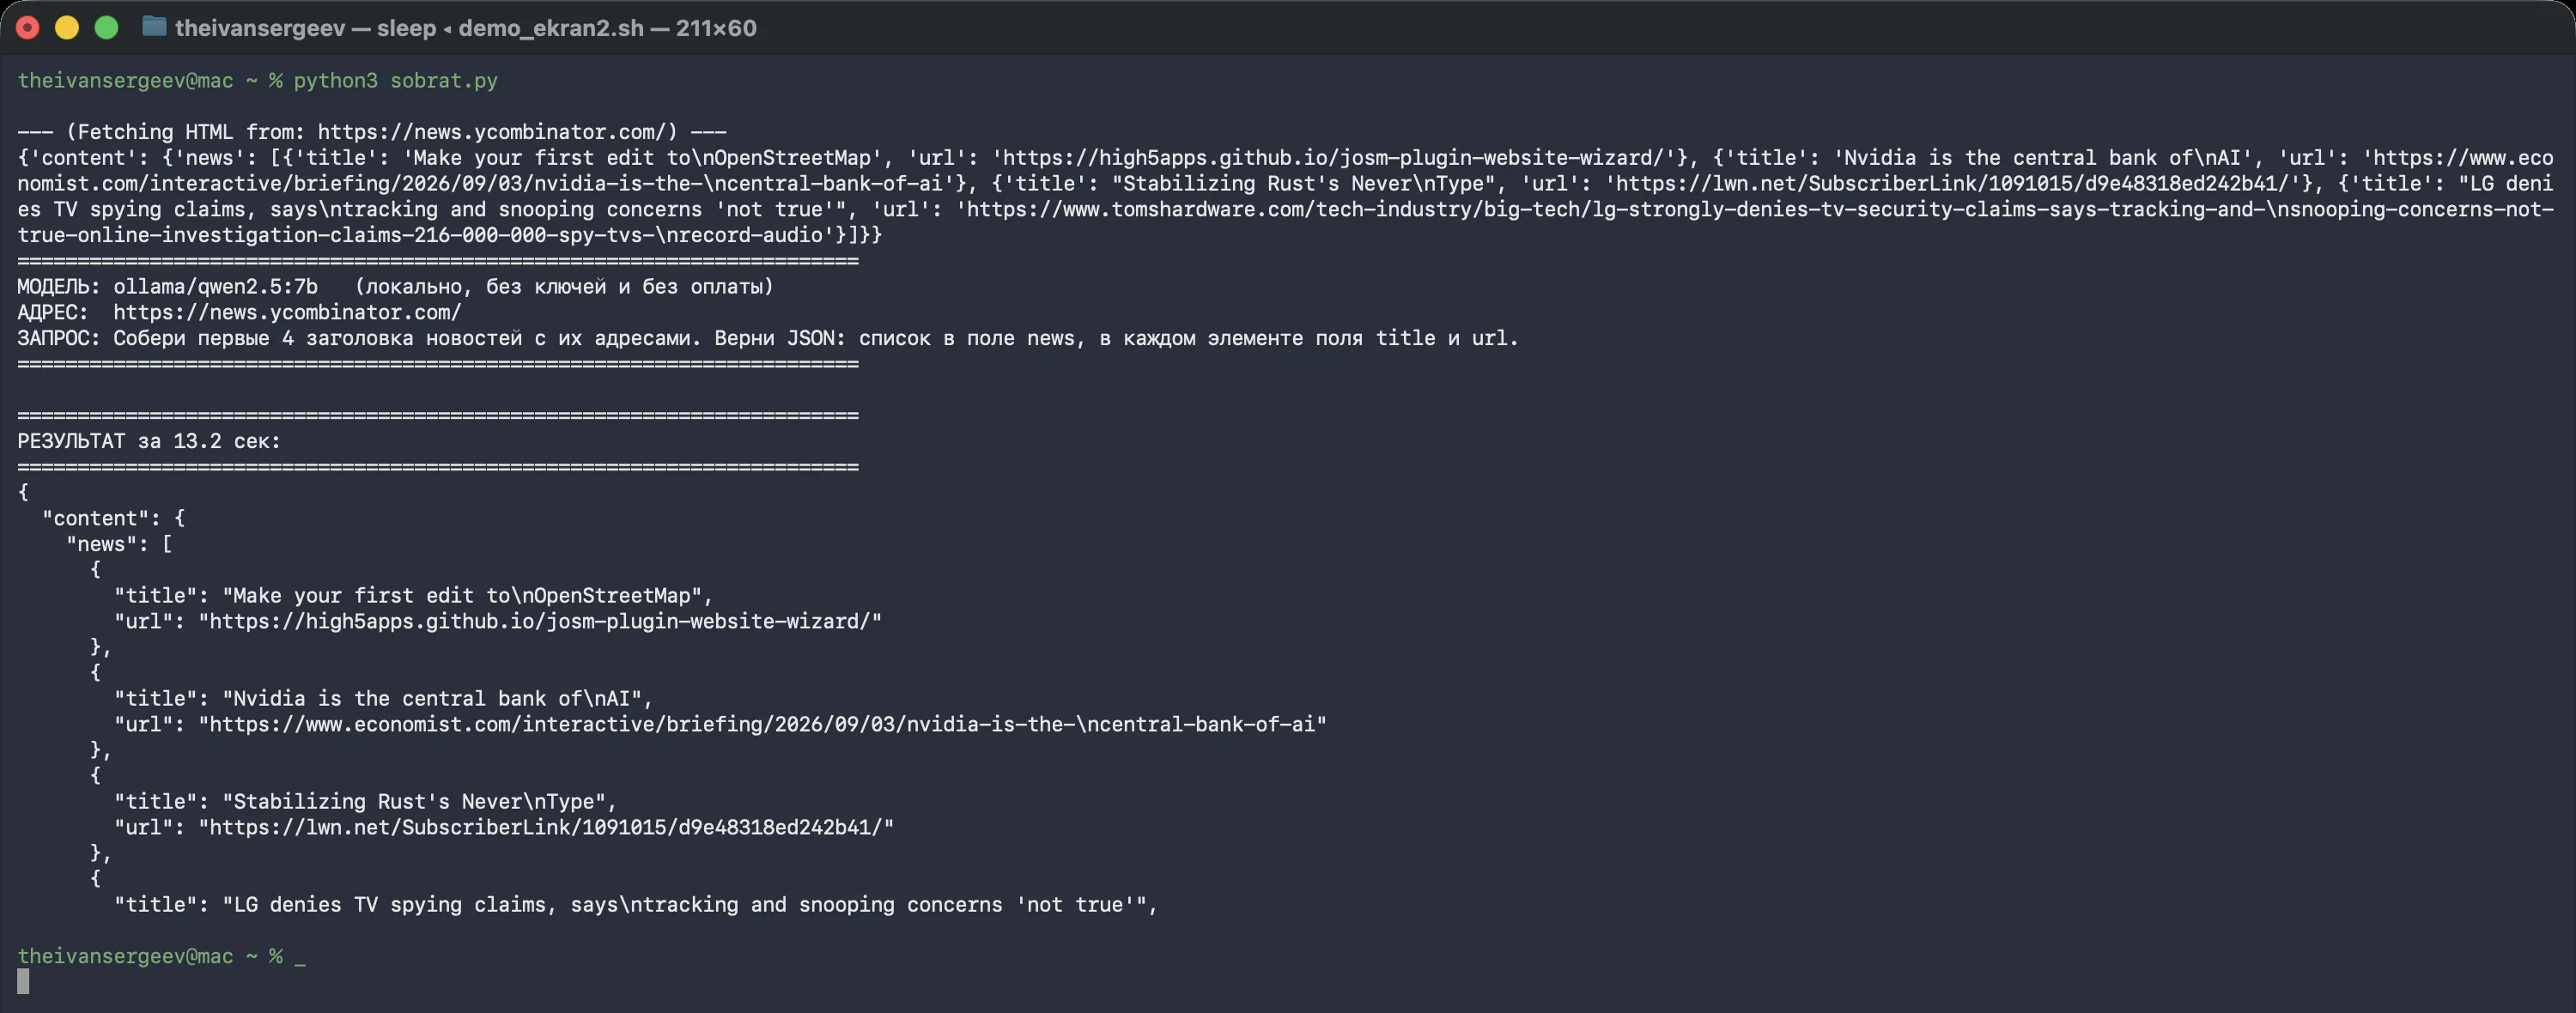
Собрать список с чужой страницы можно так: ставишь открытую библиотеку scrapegraphai, пишешь адрес и одну фразу обычными словами - «собери заголовки новостей с их адресами». Через 15-20 секунд на экране готовый список: заголовок и ссылка на каждой строке. Устройство страницы разбирает языковая модель. У меня сбор занял 13,2 секунды и не стоил ни копейки
Начни с проверки, а не с установки: набери в чёрном окне команд «python3 --version». Ответ 3.12 или выше - ставь пакет и работай по шагам ниже. Ответ 3.11 или меньше - сначала обнови Python, иначе установка откажет на первой же команде
Проверь за 20 секунд, пойдёт ли у тебя вообще
Прежде чем что-то ставить, открой чёрное окно команд (на маке оно называется «Терминал», на Windows - «Командная строка») и набери одну строку:
python3 --versionДальше два исхода, и они решают всё:
- число 3.12 или больше (у меня напечаталось
Python 3.14.7) - можешь идти дальше, всё сойдётся - число 3.11 или меньше - библиотека просто не встанет. В её карточке на PyPI стоит требование «не ниже 3.12», и установщик откажет. Сначала обнови Python, потом возвращайся
Здесь застревают чаще всего: команда установки печатает непонятную ошибку про версию, и человек решает, что дело в нём. Если Python у тебя вообще не стоит, у меня есть разбор Python с нуля для первой недели
Шаг 1. Поставь библиотеку и браузерный движок
Выполни в том же окне две команды подряд:
pip install scrapegraphai
playwright install chromium
Первая минуту-две качает нужные части списком и заканчивается строкой Successfully installed ... scrapegraphai-2.2.4. Вторая скачает браузер (это около сотни мегабайт) и молча вернёт тебя к приглашению для следующей команды
Понять, что всё встало, можно по одной строке: в выводе есть Successfully installed со словом scrapegraphai и номером версии. Нет этой строки - установка не прошла, читай последнюю ошибку сверху вниз
Зачем вторая команда. Библиотеке нужен настоящий браузер, чтобы открыть страницу как человек. Многие сайты дорисовывают содержимое уже после загрузки, и без браузера скачается пустой каркас. Команда кладёт этот браузер в свою отдельную папку, твой обычный браузер она не трогает
🔴 Смотри на имя пакета внимательно. Ставится scrapegraphai - одним словом, без дефиса. Рядом лежит пакет scrapegraph-py, и это ДРУГАЯ вещь: платный облачный сервис тех же авторов, он просит ключ и списывает деньги за каждый запрос. Ошибка в один дефис уводит с бесплатного пути на платный, и человек узнаёт об этом по счёту
Шаг 2. Поставь модель, которая работает бесплатно
Вот барьер, о котором не говорят ни в одном ролике про эту библиотеку. Сама библиотека читать страницу не умеет. Она умеет объяснить задачу языковой модели и разобрать её ответ. Модель надо привести свою, и путей ровно два:
| Путь | Что нужно | Сколько стоит |
|---|---|---|
| Ключ облачной модели (OpenAI, Groq, Gemini) | зарегистрироваться, привязать карту, скопировать ключ | платишь за каждый запрос по счётчику |
| Своя модель через Ollama | скачать программу и одну модель | ноль, всё крутится на твоём ноутбуке |
Таблица прокручивается вбок →
Авторы говорят об этом прямо, просто в таблице, которую мало кто дочитывает:
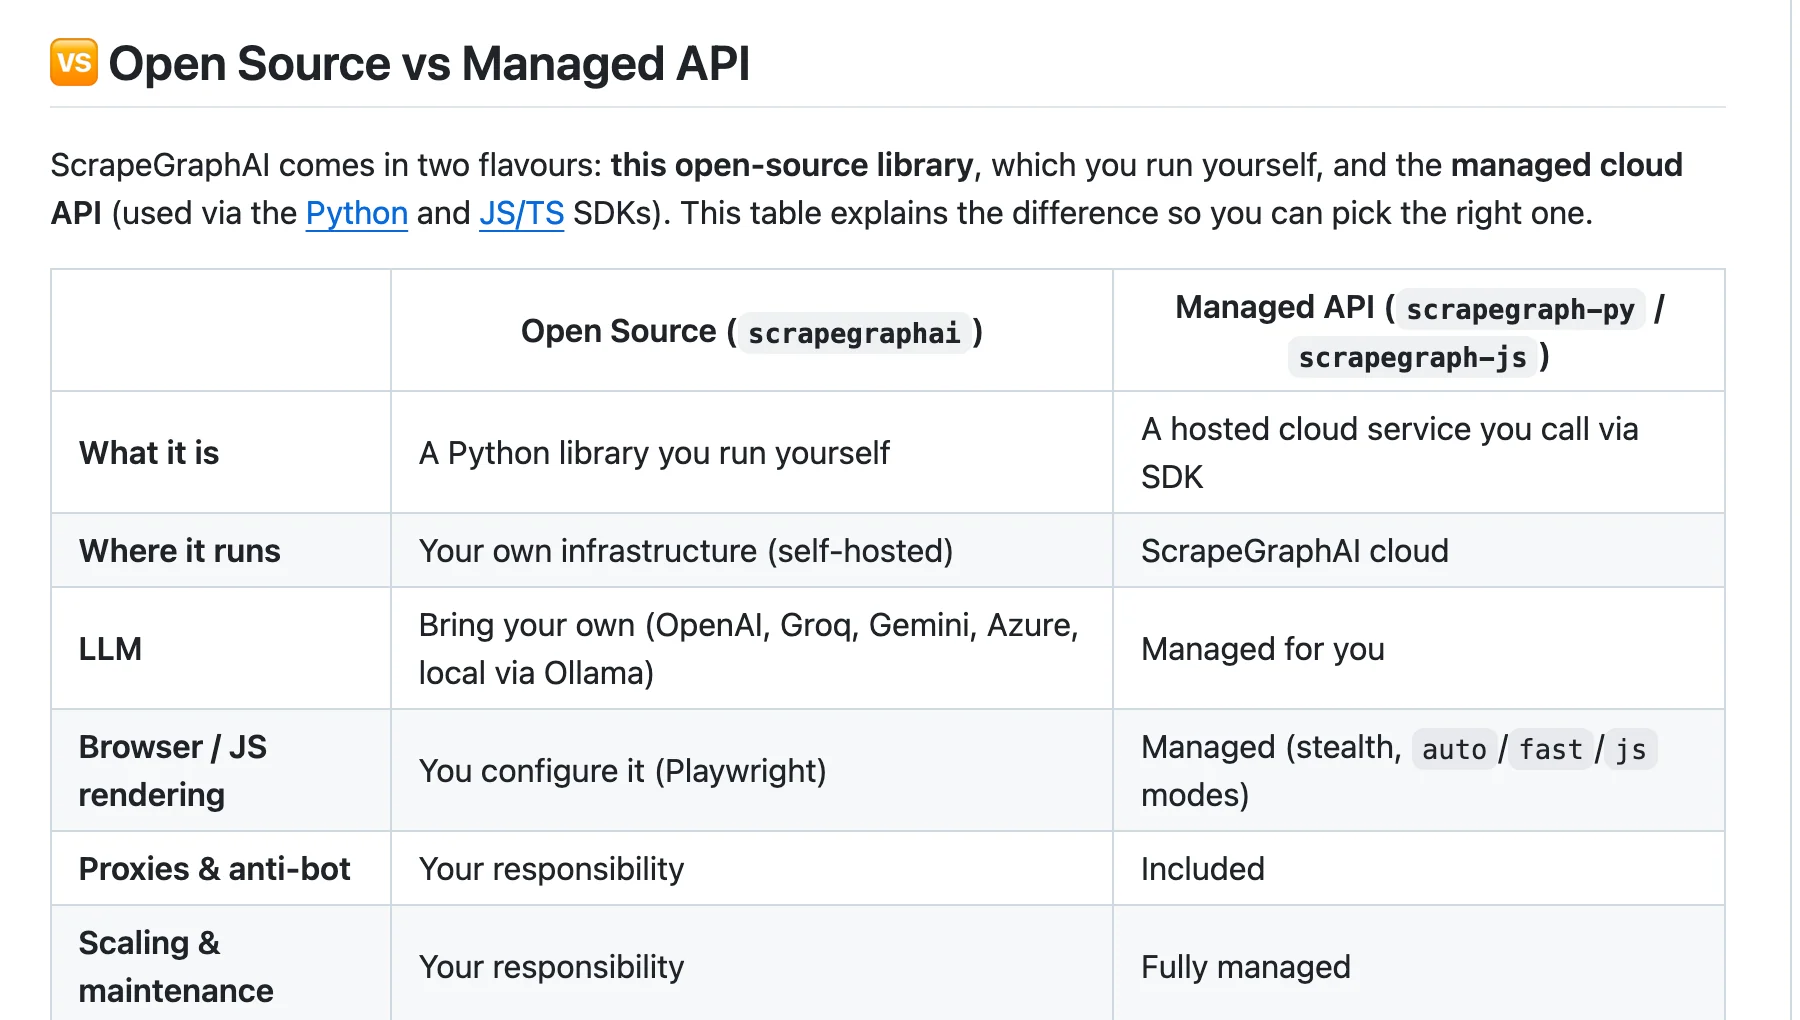
Мы идём вторым. Скачай Ollama с ollama.com как обычную программу, установи, потом одна команда:
ollama pull qwen2.5:7bПойдёт полоска загрузки примерно на 4-5 гигабайт, в конце появится слово success. Готово это или нет, покажет команда ollama list: она печатает табличку, и в ней должна стоять строка qwen2.5:7b
Почему именно эта модель, а не та, что в примере авторов. Я прогнал одну и ту же задачу тремя разными моделями, на одной странице, одним запросом. Результаты разошлись сильно:
| Модель | Время | Что вышло |
|---|---|---|
llama3.2 (стоит в официальном примере) | 23,6 сек | брак: вернула {"content": "["} и оборвалась на первой скобке |
qwen3:4b (модель, которая думает вслух) | 848 сек | брак: Response timeout exceeded, не уложилась во внутренний лимит |
qwen2.5:7b | 20,6 сек | 10 записей, у каждой заголовок и адрес |
Таблица прокручивается вбок →
Маленькая модель из примера не тянет разбор страницы: начинает список и теряет нить. Модель, которая думает вслух, размышляет так долго, что библиотека перестаёт её ждать на 480-й секунде. Работает обычная модель среднего размера, и это единственный практический вывод, который сэкономит тебе вечер
Вот как выглядел брак у маленькой модели, дословно с моего экрана:
МОДЕЛЬ: ollama/llama3.2   (локально, без ключей и без оплаты)
АДРЕС:  https://news.ycombinator.com/
РЕЗУЛЬТАТ за 23.6 сек:
{
  "content": "["
}
Одна открывающая скобка вместо десяти записей. Библиотека отработала честно и уложилась в 23,6 секунды, не справилась именно модель
Если Ollama у тебя ещё не стоит, вот отдельный разбор: как установить Ollama и выбрать модель под свою память. Про то, чем вообще хороши открытые инструменты вместо платных подписок, у меня тоже есть сводка
Шаг 3. Напиши, что тебе нужно, обычными словами
Создай рядом файл sobrat.py и положи в него двенадцать строк:
from scrapegraphai.graphs import SmartScraperGraph
import json

graph = SmartScraperGraph(
    prompt="Собери заголовки новостей с их адресами. Верни ответ списком: поле news, внутри поля title и url.",
    source="https://news.ycombinator.com/",
    config={"llm": {"model": "ollama/qwen2.5:7b",
                    "model_tokens": 8192,
                    "format": "json"},
            "headless": True},
)

print(json.dumps(graph.run(), indent=2, ensure_ascii=False))
Правишь здесь ровно две строки, остальное настройка и её оставь как есть:
prompt- что тебе нужно, своими словами. По-русски можно, я так и писалsource- адрес страницы, с которой собираем
После сохранения на экране ничего не произойдёт, это просто заготовка. Убедиться, что файл лежит там, где надо, поможет команда ls: она напечатает список файлов папки, и sobrat.py должен быть среди них
Как формулировать запрос, чтобы получилось с первого раза. Три вещи, которые реально влияют:
- назови поля - не «собери новости», а «собери заголовок и адрес каждой новости». Отдаётся ровно то, что названо
- скажи, как назвать список - «верни ответ списком, поле news». Тогда ответ приходит одинаковым от раза к разу, и его удобно разбирать дальше
- ограничь количество - «первые 10». Без ограничения модель может пойти по всей странице и упереться в лимит времени
Формулировка тут решает больше, чем кажется. У меня есть отдельный разбор приёмов переформулировки запросов, они работают и здесь
Шаг 4. Запусти и прочитай свой список
Одна команда:
python3 sobrat.pyСначала появится строка --- (Fetching HTML from: ...) - это библиотека открыла страницу браузером. Потом 15-20 секунд тишины, пока модель разбирает текст. Потом на экран печатается сам список
Опознать успех просто: в выводе есть фигурные скобки, а внутри строки вида "title": "..." и "url": "...". Каждая запись на своём месте, полей столько, сколько ты назвал в запросе
Вот как это выглядело у меня на десяти записях:
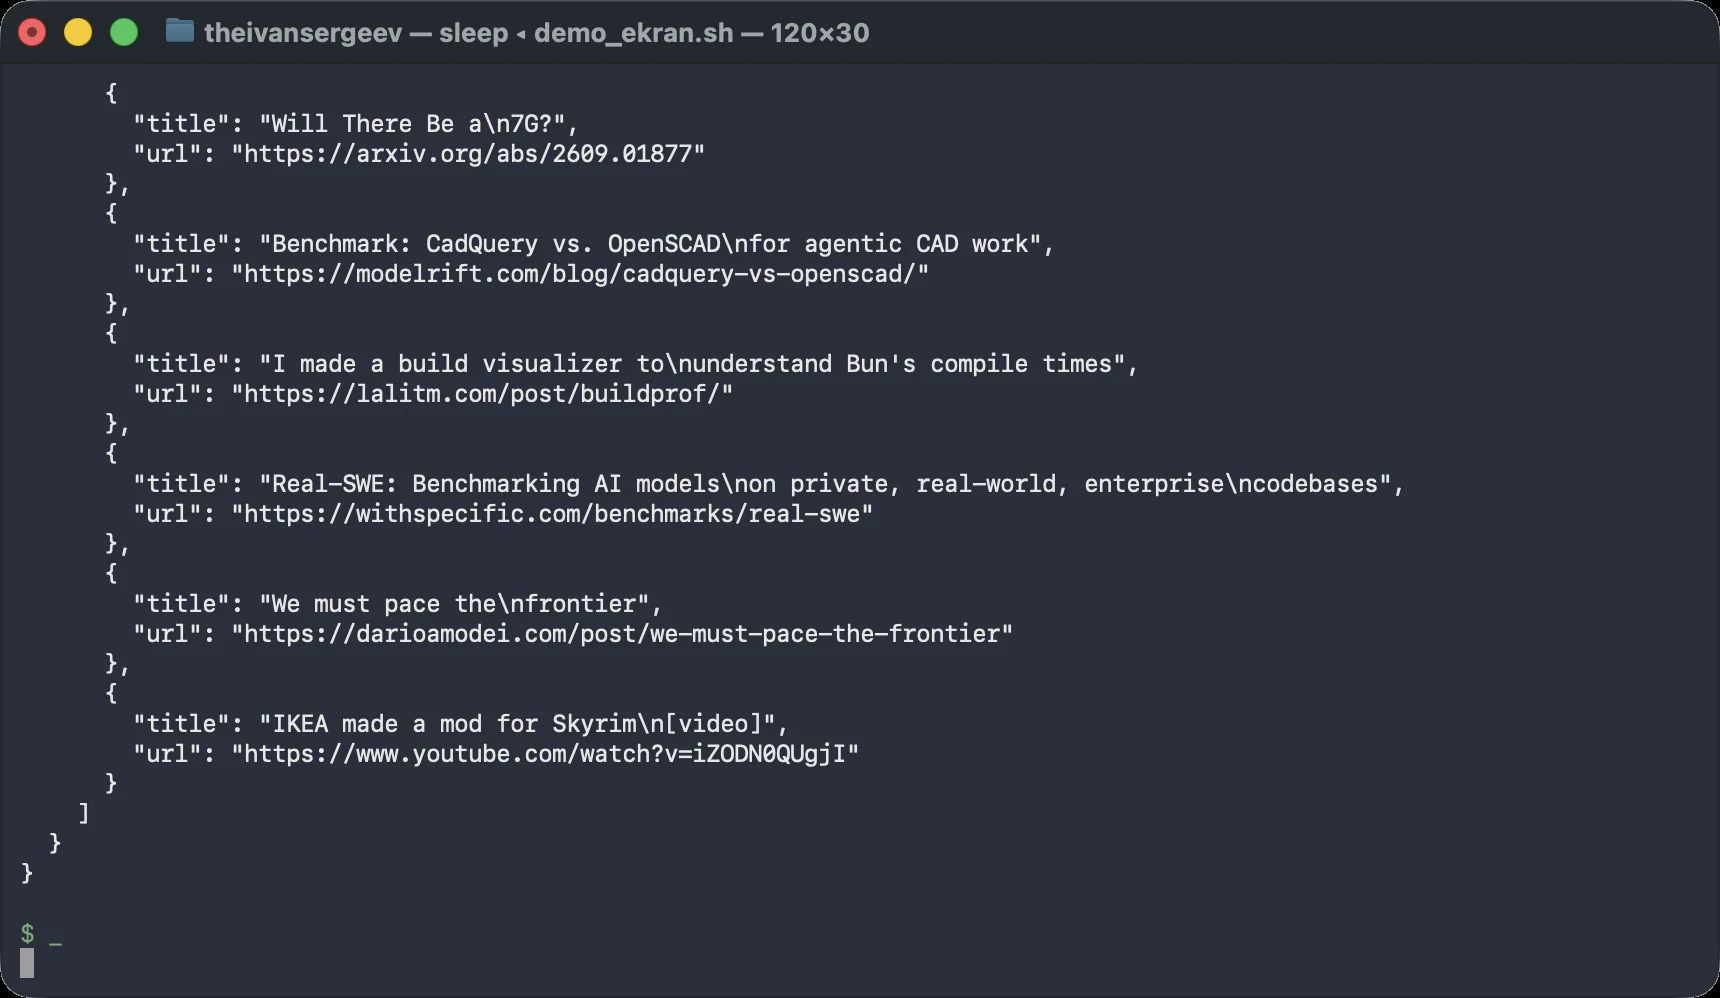
В итоге у тебя на экране готовый список, который дальше можно вставить в таблицу, отдать нейросети на разбор или сохранить файлом. Ты не открывал устройство страницы, не искал в ней разметку и не писал ни строчки разбора. Что делать с этим списком дальше, разобрано в гайде ИИ анализ данных: своя таблица до чисел и графика
А если у тебя другой случай
Четыре ветки, каждая названа твоим условием, а не номером способа
Тебе нужен не один адрес, а десяток. Скажем, собрать предложения у десяти конкурентов. Меняешь одну строку вверху файла: вместо SmartScraperGraph берёшь SmartScraperMultiGraph, а в source кладёшь не адрес, а список адресов. Запрос остаётся тот же, он применится к каждому
Ты не знаешь адресов, знаешь только тему. Берёшь SearchGraph. Он сам идёт в поисковик, забирает первые результаты и собирает с них. Адрес указывать не надо вовсе, только запрос словами
Гонять модель каждый раз долго и жалко. Берёшь ScriptCreatorGraph. Он отдаёт не данные, а готовую программку, которая собирает то же самое уже без модели. Один раз заплатил временем, дальше работает быстро
Страница огромная, и всё висит. Это не поломка, это устройство: длинная страница режется на куски, и каждый кусок отправляется модели отдельно. Я поймал это на своей же странице блога - в ней оказалось 223 929 знаков текста, библиотека нарезала 11 кусков и не уложилась в лимит ожидания. Выход простой: бери страницу поменьше или ту, где нужные данные лежат ближе к началу
Что ломается и что с этим делать
Реальные ошибки с их экранным текстом. Все четыре я поймал сам, а не придумал
{"content": "["} вместо списка. Модель начала ответ и оборвалась. Причина почти всегда одна: модель слишком маленькая. Поставь qwen2.5:7b вместо трёхмиллиардной
Response timeout exceeded. Модель не успела за 480 секунд. Две причины: либо взял модель, которая думает вслух (она тратит время на размышления), либо страница слишком длинная. Смени модель на обычную, страницу возьми покороче
None of the requested terms [...] appear in the parsed content. Библиотека честно предупреждает: слов из твоего запроса на странице она не нашла. Либо страница дорисовывает содержимое и без браузера пришёл пустой каркас (проверь, что команда с playwright прошла), либо ты просишь то, чего на странице нет
Установка отказывается на первой команде. Смотри на версию Python, требование пакета - не ниже 3.12
Второй путь: MCP-сервер Scrapling, когда сайт закрыт Cloudflare
Связка из шагов 1-4 держится на библиотеке scrapegraphai, и для обычной открытой страницы этого хватает. Для сайта, который встречает капчей или проверкой Cloudflare Turnstile, есть отдельный инструмент - открытая библиотека Scrapling, у неё есть готовый MCP-сервер: скрапер встраивается прямо в Claude Code или Codex и работает по одной фразе в чате, без отдельного файла с кодом
Установка
Две команды подряд в чёрном окне:
pip install "scrapling[ai]"
scrapling install
Первая ставит саму библиотеку вместе с MCP-сервером, вторая докачивает браузеры под неё. Готовность проверяется командой which scrapling-mcp - если в ответ пришёл путь вроде /Users/имя/.venv/bin/scrapling-mcp, сервер встал
Три способа достать страницу, одной таблицей
Внутри библиотеки за это отвечают три разных класса, и выбор между ними решает саму задачу:
| Класс | Инструмент MCP | Для чего |
|---|---|---|
| Обычный запрос | make_request | быстрый HTTP-запрос без браузера, для простых страниц без защиты |
| Браузер | fetch | полноценный браузер (Chromium/Chrome), для страниц с JavaScript |
| Обход защиты | stealthy_fetch | тот же браузер, но с подделкой отпечатка, проходит мимо Cloudflare Turnstile и похожих проверок |
Таблица прокручивается вбок →
У каждого из трёх есть пакетная версия для нескольких адресов разом: bulk_get, bulk_fetch, bulk_stealthy_fetch
Если сайт закрыт Cloudflare
Скажи об этом прямо в запросе, не жди, пока модель сама наткнётся на капчу: «собери цену с этой страницы, учти, что там стоит защита Cloudflare Turnstile». Тогда модель сразу берёт stealthy_fetch вместо обычного запроса, и связка проходит защиту за один заход вместо нескольких неудачных попыток
Подключить к Claude Code
Одна команда:
claude mcp add ScraplingServer "$(which scrapling-mcp)"Подключить к Codex
Тоже одна команда:
codex mcp add ScraplingServer -- scrapling-mcpПосле любой из команд помощник перезапускается, и сервер ScraplingServer появляется в списке подключённых инструментов
Про скорость авторы пишут прямо в описании проекта: на тесте разбора текста страницы инструмент обгоняет BeautifulSoup с Lxml в сотни раз - в разных редакциях README цифра стоит от ~700 до ~785 раз, в зависимости от версии библиотеки. Это заявление авторов бенчмарка на разборе уже скачанной страницы, не мой собственный замер и не скорость обхода защиты
Что забрать с собой
Твой рабочий предмет это файл sobrat.py из шага 3. Он универсальный: под любую новую задачу в нём правятся ровно две строки
А это таблица решений, по которой через неделю выберешь нужный вариант, не перечитывая статью:
| Что собираешь | Что брать | Что меняешь в файле |
|---|---|---|
| одну страницу, один раз | SmartScraperGraph | адрес и запрос |
| десять страниц одним запросом | SmartScraperMultiGraph | список адресов вместо адреса |
| не знаешь адресов, знаешь тему | SearchGraph | только запрос, адрес убираешь |
| собирать регулярно и быстро | ScriptCreatorGraph | получишь программку, дальше работаешь ей |
Таблица прокручивается вбок →
И четыре готовых запроса под частые задачи, вставляются в строку prompt как есть:
- конкуренты: «Собери все посты со страницы. Для каждого верни заголовок, первые два предложения текста и дату. Верни ответ списком, поле posts»
- вакансии: «Собери вакансии со страницы. Для каждой верни название компании, должность и вилку зарплаты. Верни ответ списком, поле jobs»
- товары: «Собери карточки товаров. Для каждого верни название, цену и наличие. Верни ответ списком, поле items»
- цены конкурента: «Собери тарифы со страницы. Для каждого верни название тарифа, цену и список того, что входит. Верни ответ списком, поле plans»
Две вещи, о которых честно стоит знать
Библиотека отправляет анонимную статистику использования. Отключается одной строкой перед запуском:
export SCRAPEGRAPHAI_TELEMETRY_ENABLED=falseАвторы сами очерчивают границу. В описании проекта написано, что инструмент сделан для исследования и разведки данных, и за неправомерное применение они ответственности не несут. Проще говоря: собирать открытые страницы для своей аналитики нормально, тащить чужие личные данные и лезть в закрытые разделы - нет. Про соседний риск, когда чужой текст начинает командовать твоим помощником, у меня есть разбор prompt injection
Что почитать дальше на этом же сайте
- Как установить Ollama - шаг 2 этой статьи целиком, с выбором модели под твою память
- Python с нуля - если команда с версией напечатала не то
- ИИ анализ данных - что делать со списком после того, как ты его собрал
- ИИ для таблиц Excel - куда положить собранное, чтобы считалось
- Отчёт из выгрузки нейросетью - превратить список в сводку на странице
- Нейросети для аналитика - соседние четыре задачи того же класса
- Загрузить данные в нейросеть и не слить лишнее - обратная сторона: что происходит с твоими файлами
- LangChain простыми словами - на чём эта библиотека стоит внутри
- 10 опенсорс-инструментов вместо платных подписок - соседний список бесплатных вещей
- MCP сервер простыми словами - как подключить такой сбор к своему помощнику
- ИИ-агент простыми словами - если термины попадались впервые
- Переформулировки запросов - приёмы, которые улучшают результат сбора
- Prompt injection - риск, который приходит вместе с чужим текстом
- Как пользоваться Claude Code - помощник, который живёт у тебя на компьютере
- Автоматизация бизнеса - куда сбор встраивается как один из процессов
- ИИ для маркетолога - разбор конкурентов как рабочая задача
- ИИ для продаж - что делать с собранными предложениями конкурентов
- ИИ для HR - разбор вакансий как рабочая задача
- ChatGPT в Google Таблицах - соседний способ тянуть данные, уже в таблицу
- ИИ помощник за вечер - следующий шаг после первого сбора
- ИИ для бизнеса - общая картина, куда всё это складывается
- Как сделать сайт самому без кода - соседняя задача из той же серии «без программиста»
- No code в 2026 - где конструктора хватит, а где нет
- Нейросети и инструменты: все гайды - весь мой стек статей по теме
- Скиллы и агенты: все гайды - соседний раздел про помощников
Все числа в статье я снял сам 12 и 13 сентября 2026 года: звёзды и лицензию с живой страницы репозитория, версию пакета с его карточки, а три времени прогона с собственного экрана. Ссылки лежат в источниках внизу
Источники
- Репозиторий ScrapeGraphAI на гитхабе - звёзды, форки, лицензия MIT
- README библиотеки - установка, пример кода, таблица вариантов сбора, разведение открытой версии и платного облака
- Карточка пакета на PyPI - версия 2.2.4, требование Python не ниже 3.12
- Документация облачного сервиса - как устроен платный близнец
- Ollama - бесплатный запуск моделей на своём компьютере
- Репозиторий Scrapling на гитхабе - три класса фетчеров, установка, бенчмарки скорости разбора
- Документация MCP-сервера Scrapling - список инструментов, команды подключения к Claude Code и другим клиентам
Памятка: сбор данных без кода коротко
Шесть строк, которые закрывают весь разбор
Сохрани себе
- Python должен быть не ниже 3.12, проверяется командой python3 --version
- Ставится пакет scrapegraphai одним словом; scrapegraph-py это платный близнец, не он
- Браузерный движок ставится отдельной командой playwright install chromium
- Модель нужна своя: бесплатно через Ollama, платно через ключ облака
- Модель из официального примера мала для задачи, рабочая связка qwen2.5:7b
- В файле правятся две строки: адрес страницы и запрос обычными словами
Куда это ведёт
Ты собрал данные словами, а не кодом
Пятнадцать минут на связку, и дальше каждая новая задача это правка двух строк. Тем же способом собирается всё остальное: свой помощник, свой сайт, приём заявок, разбор конкурентов на потоке
На Концентрате я веду через это за руку, от установки до работающей системы, на живых проектах
Регистрация на сайте до 14 октября, участие бесплатное
Частые вопросы
Сколько это стоит?
По маршруту из статьи ноль. Библиотека под лицензией MIT, Ollama бесплатная, модель скачивается один раз. Платить придётся только если пойдёшь по ветке с облачным ключом
Нужно ли уметь программировать?
Нет. Из кода здесь двенадцать строк, которые копируются целиком, и в них ты правишь две
Заработает на Windows?
Да, шаги те же. Разница только в том, как открывается окно команд и как ставится Python
Почему у меня список получился короче, чем я просил?
Обычно потому, что нужные строки оказались за границей куска, на который модель нарезала страницу. Попроси меньше записей или возьми страницу покороче
Насколько свежие цифры в статье?
Версия пакета 2.2.4 от 7 сентября 2026, звёзды и форки сняты 12 сентября 2026, все три прогона моделей - 13 сентября 2026