Гайд · локальные нейросети · август 2026
Как установить Ollama: 4 шага и выбор модели по памяти

Ollama запускает языковую модель прямо на твоём компьютере: без подписки, без чужого компьютера в интернете (то есть сервера, который считает за тебя) и без сети после скачивания. Ниже установка на три системы точными командами, размеры 17 моделей в гигабайтах, мой замер занятой памяти на четырёх моделях и правило, по которому понятно, что влезет именно в твою машину
Ollama ставится установщиком с сайта за 4 шага, дальше работает одна команда ollama run gemma3:4b. Модель выбирают по памяти: файл должен быть на 3-4 ГБ меньше, чем есть в машине. Мой замер 16 августа 2026: файл 3,4 ГБ занял 3,7 ГБ памяти, файл 7,6 ГБ занял 8,1 ГБ. Из России сайт и реестр моделей открываются без VPN, проверено с московского адреса
Что нужно проверить до установки Ollama?
Три вещи: система Windows 10 22H2 и новее либо macOS Sonoma 14 и новее, минимум 10 ГБ свободного диска и то самое окно для команд текстом. В мире программ его называют терминалом, то есть окном, куда печатаешь короткие команды словами - как будто пишешь сообщение другу, только вместо друга отвечает компьютер. Требования вендор публикует на страницах документации, и они мягче, чем принято думать: видеокарта не обязательна, модель поедет и на процессоре, просто медленнее
Свою версию Windows смотришь так: нажми Win+R, напечатай winver, нажми Enter - появится окошко, где номер версии стоит прямо под названием системы. На Mac то же самое лежит в меню Apple → «Об этом Mac», первой же строкой
| Система | Минимум по документации | Место под установщик |
|---|---|---|
| Windows | Windows 10 22H2 и новее, Home или Pro | 4 ГБ |
| macOS | macOS Sonoma 14 и новее, Apple M-серии или x86 | около 1 ГБ |
| Linux | ядро с поддержкой systemd | около 1 ГБ |
| Видеокарта NVIDIA | драйвер 550 и новее | не обязательна |
Таблица прокручивается вбок →
Место под сами модели считается отдельно и это главная статья расхода: у меня после пяти скачиваний каталог моделей весил 31 ГБ. Заложи минимум 10 ГБ сверх установщика, если собираешься пробовать больше одной модели
То самое окно для команд понадобится на каждом шаге. Никогда его не открывал - начни с разбора что такое терминал и как в нём работать, там же про первые команды. Если планируешь потом связывать Ollama с рабочим редактором, пригодится гайд по установке Claude Code: окно там то же самое
Как установить Ollama на Windows?
Через установщик OllamaSetup.exe со страницы загрузки: прав администратора он не просит, ставится в домашнюю папку и просит под себя 4 ГБ места. Открой страницу загрузки для Windows, выбери вкладку Windows и нажми кнопку - появится файл в папке «Загрузки», и с этого момента установка идёт как у любой другой программы. На странице лежит и второй путь, однострочник для PowerShell (системной программы Windows, куда тоже можно печатать команды словами)
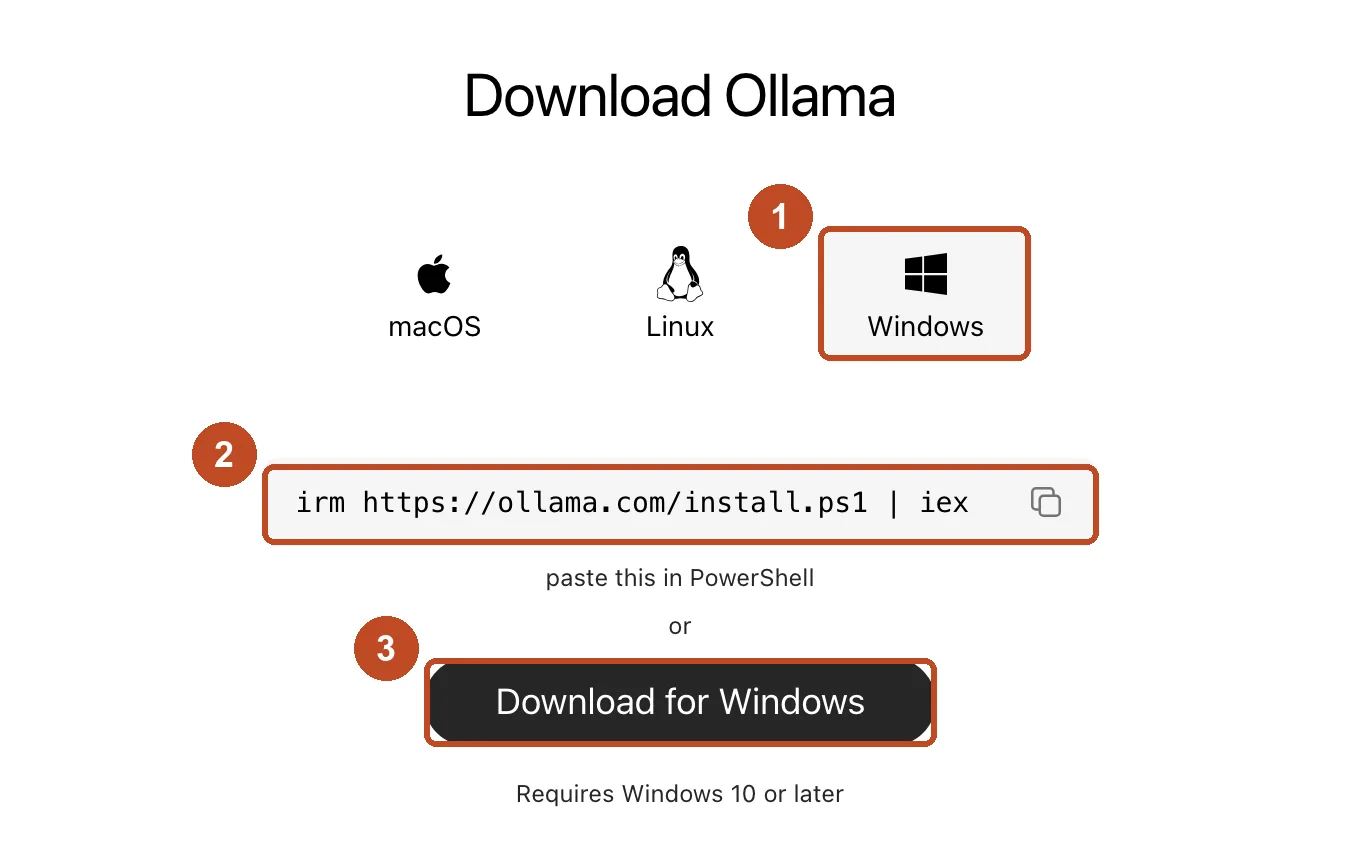
Однострочник вендор публикует такой:
irm https://ollama.com/install.ps1 | iexНовичку советую кнопку, а не эту строку: если её скопировать и запустить, команда скачает скрипт (короткую программу-инструкцию) и тут же его исполнит, а посмотреть содержимое ты не успеваешь. Кнопка делает то же самое, только файл сначала лежит у тебя на диске, и ты можешь на него взглянуть
Дальше две настройки, о которых обычно узнают поздно. Сразу скажу: обе необязательные. По умолчанию Ollama ставится в домашнюю папку на системном диске, и для большинства это нормально, шаги ниже нужны только тем, у кого там мало места
Первая настройка - поставить саму программу на другой диск. Открой то же окно для команд, перейди в папку со скачанным установщиком и запусти его с припиской /DIR= и своим путём. В инструкциях такую добавку к команде называют флагом: она меняет поведение команды, как «без сахара» в заказе кофе. Скопируй строку, поменяй путь в кавычках на свой и нажми Enter:
OllamaSetup.exe /DIR="d:\some\location"Что увидишь: то же обычное окно установщика, только папкой установки будет стоять указанная тобой, а не домашняя. Что это даёт: программа не занимает место на системном диске
Вторая настройка - хранить на другом диске сами модели, а они весят в разы больше программы. Переезжают они не припиской к команде, а через OLLAMA_MODELS - это личная записка для программ: ты пишешь в неё, какая папка где лежит, а программа читает записку при запуске и идёт по указанному пути. В инструкциях такую записку называют переменной среды, а заводится она в настройках Windows за пять нажатий:
Как перенести папку с моделями на другой диск
- Нажми «Пуск» и напечатай «переменные среды» что увидишь: в результатах поиска появится пункт «Изменение переменных среды для вашей учётной записи»
- Открой этот пункт и нажми кнопку «Создать» что увидишь: маленькое окно с двумя полями - имя переменной и значение
- В имя впиши
OLLAMA_MODELS, в значение - путь к папке на другом диске напримерD:\ollama-models, саму папку создай заранее как любую другую - Нажми ОК, а потом ОК ещё раз, чтобы сохранить что увидишь: новая строка в списке переменных твоей учётной записи
- Выйди из значка Ollama возле часов и запусти программу заново из «Пуска» что это даёт: без этого шага модели поедут по старому пути, потому что настройку программа читает один раз при старте
шаги по документации Ollama, раздел про смену папки для моделей
После установки команда доступна в cmd, PowerShell и любом другом таком окне, а сама Ollama поднимает фонового помощника (то есть сервер: невидимую программу, которая слушает команды и отвечает) на http://localhost:11434
Как установить Ollama на macOS и Linux?
На macOS перетаскиванием файла Ollama.dmg в папку «Программы», на Linux одной командой install.sh из официальной документации. Разберём по очереди
На macOS: скачиваешь Ollama.dmg, монтируешь и кладёшь программу в «Программы». При первом запуске она спросит разрешение создать ссылку на команду ollama в системном пути, соглашайся, иначе система её не найдёт. Есть и путь через менеджер пакетов (программу, которая сама скачивает и обновляет другие программы одной командой): brew install ollama
На Linux вендор даёт один способ - скопируй команду целиком:
curl -fsSL https://ollama.com/install.sh | shВставь в своё окно для команд и нажми Enter: программа скачается и установится сама, в конце появится строка с готовой версией Ollama. Не любишь исполнять скачанное вслепую - у документации есть раздел с ручной установкой: там ты сам распаковываешь архив (упакованный файл-коробка, как zip: внутри лежат готовые файлы программы) и руками включаешь автозапуск, без единой команды-однострочника
Отдельная грабля, на которую я наступил сам 16 августа 2026. Обновление через Homebrew (менеджер пакетов для Mac) прошло, версия сменилась с 0.31.1 на 0.32.6, а команда ollama --version продолжала печатать старый номер и предупреждение Warning: client version is 0.32.6. Причина простая: обновился файл программы, а в памяти висел старый фоновый помощник. Помогает одна команда, которая гасит старого помощника и поднимает нового
Что делать, если версия не обновилась после Homebrew
- Набери
ollama --versionв своём окне для команд если там всё ещё старый номер и предупреждение о несовпадении версий - это не сбой: программа на диске обновилась, а старый фоновый помощник остался висеть в памяти - Скопируй команду
brew services restart ollama, вставь в то же окно и нажми Enter она выключает старого фонового помощника и запускает нового, после этогоollama --versionпокажет новый номер честно - мой прогон 16 августа 2026 занял пару секунд
Второе про этот менеджер: он немного отстаёт от сайта, и это нормально. На 16 августа 2026 он отдавал 0.32.6, а в ленте релизов проекта уже лежала 0.32.13 от 14 августа - отставание на несколько мелких обновлений, на установку и работу оно не влияет. Нужна ровно самая свежая версия - тогда ставь установщиком с сайта
Как проверить установку и запустить первую модель?
Двумя командами: сначала ollama --version печатает номер версии и этим доказывает, что программа в системе, потом ollama run gemma3:4b: команда скачивает модель на 3,3 ГБ и сразу открывает чат прямо в этом же окне - можно печатать вопрос и получать ответ
ollama --version
ollama run gemma3:4b
Первый запуск идёт дольше остальных: сначала скачивание, потом подъём модели с диска в память. У меня на модели qwen3.5:4b скачивание заняло 1 минуту 58 секунд, а первая загрузка в память ещё 16,9 секунды. Второй и последующие ответы приходят сразу, пока модель висит в памяти
Выход из чата - команда /bye. Модель после этого ещё несколько минут остаётся в памяти, чтобы следующий запуск был мгновенным
Если команда ollama не находится, закрой это окно и открой заново. Почему так происходит, разобрано ниже, в разделе «На чём спотыкается новичок в первый час»
Что делают команды pull, run, list, ps и rm?
Каждая отвечает за один шаг жизни модели: pull скачивает, run запускает и открывает чат, list показывает скачанное, ps показывает занятую память, rm удаляет. Ниже все 7 команд, которые пригодятся новичку, а полное описание каждой - в справочнике команд
| Команда | Что делает | Когда нужна |
|---|---|---|
ollama pull gemma3:4b | скачивает модель, не запуская её | заранее скачать на ночь, чтобы утром не ждать |
ollama run gemma3:4b | запускает модель и открывает чат | обычная работа |
ollama list | показывает скачанные модели и их вес на диске | понять, чем занято место |
ollama ps | показывает, какие модели сейчас в памяти | проверить, влезла ли модель |
ollama rm gemma3:4b | удаляет модель с диска | освободить место |
ollama serve | поднимает фонового помощника вручную | когда нужен свой порт или свои переменные |
ollama signin | вход в аккаунт для облачных моделей | только для облака |
Таблица прокручивается вбок →
Отдельно: если набрать ollama без аргументов, откроется меню с выбором модели и списком инструментов, которые к ней можно подключить
Где физически лежат модели и сколько места они съедают?
В скрытой папке .ollama внутри домашнего каталога, и это единственное место на диске, которое растёт от каждой скачанной модели. Точные пути из документации
| Система | Путь |
|---|---|
| macOS | ~/.ollama/models |
| Linux | /usr/share/ollama/.ollama/models |
| Windows | C:\Users\%username%\.ollama\models |
Таблица прокручивается вбок →
Переезд на другой диск делается переменной OLLAMA_MODELS, на Linux каталогу дополнительно нужен доступ на чтение и запись у пользователя ollama
Сколько весит конкретная модель, я не стал брать на глаз: написал маленькую программу, которая забирает из реестра Ollama карточку модели с размерами её частей и складывает их. Замер 16 августа 2026, цифры сходятся с карточками моделей на сайте
| Модель | Файл на диске |
|---|---|
| gemma3:270m | 0,29 ГБ |
| gemma3:1b | 0,82 ГБ |
| llama3.2:3b | 2,02 ГБ |
| qwen3.5:2b | 2,74 ГБ |
| gemma3:4b | 3,34 ГБ |
| qwen3.5:4b | 3,39 ГБ |
| qwen2.5-coder:7b | 4,68 ГБ |
| deepseek-r1:8b | 5,23 ГБ |
| qwen3.5:9b | 6,59 ГБ |
| gemma4:12b | 7,56 ГБ |
| gemma3:12b | 8,15 ГБ |
| gpt-oss:20b | 13,79 ГБ |
| qwen3.5:27b | 17,42 ГБ |
| gemma4:26b | 17,99 ГБ |
Таблица прокручивается вбок →
Скачиваются они не мгновенно. Мои замеры: 0,29 ГБ пришли за 18 секунд, 3,39 ГБ за 1 минуту 58 секунд, 7,56 ГБ за 4 минуты 31 секунду, 17,99 ГБ за 9 минут 43 секунды. На моём канале это вышло около 27 мегабайт в секунду, у тебя цифра будет своя
Сколько памяти съедает модель сверх размера файла?
На 7-50% больше, чем весит файл, и это главная причина, по которой люди берут модель не по размеру. Модель целиком поднимается в память, а сверху ложится окно контекста - место в памяти, куда помещается твой разговор с моделью целиком, от первого вопроса до последнего ответа. Проверяется одной командой ollama ps: набери её в своём окне и увидишь примерно то же, что вышло у меня 16 августа 2026 - модель gemma4:12b, занятая память 8,1 ГБ, видеокарта тянет её на 100%, окно контекста 32768 кусочков текста, ещё 4 минуты до выгрузки из памяти. Кусочки текста - это мелкие части, на которые модель дробит любую фразу, а 32768 таких кусочков это несколько десятков страниц разговора
Разница видна в двух командах: ollama list показывает вес файла, ollama ps - занятую память. Я прогнал так четыре модели на своём MacBook Pro с Apple M4 Max и 36 ГБ объединённой памяти
| Модель | Файл | В памяти | Скорость ответа (кусочков текста в секунду) |
|---|---|---|---|
| gemma3:270m | 0,29 ГБ | 402 МБ | 229 |
| qwen3.5:4b | 3,39 ГБ | 3,7 ГБ | 69,9 |
| gemma4:12b | 7,56 ГБ | 8,1 ГБ | 22,0 |
| gemma4:26b | 17,99 ГБ | 17 ГБ | 63,8 |
Таблица прокручивается вбок →
Модель печатает ответ не целыми словами, а маленькими кусочками текста - как будто собирает фразу из отдельных слогов, и чем больше таких кусочков успевает за секунду, тем быстрее выглядит ответ на экране. Надбавка по памяти гуляет: от 7% у крупных моделей до полутора раз у мелких, потому что окно контекста у всех примерно одинаковое, а сама модель разная. Отсюда рабочее правило, а не формула: бери модель, чей файл на 3-4 ГБ меньше объёма твоей памяти
Сколько памяти в твоей машине, узнаёшь за два клика. На Mac: меню Apple в левом верхнем углу → «Об этом Mac» → в окошке строка «Память», там и стоит число в гигабайтах. На Windows: нажми Ctrl+Shift+Esc → вкладка «Производительность» → пункт «Память», общий объём написан справа сверху. Это и есть то число, из которого вычитаешь 3-4 ГБ, чтобы понять предельный размер файла модели для себя
Размер контекста Ollama подбирает сама по объёму памяти видеокарты: до 24 ГиБ это 4 тысячи таких кусочков, от 24 до 48 ГиБ - 32 тысячи, от 48 ГиБ - 256 тысяч. Мой ollama ps показал 32768, что для 36 ГБ ровно по документации
Последняя строка таблицы ломает интуицию: модель 26b отвечает втрое быстрее, чем 12b. Так бывает у моделей с внутренним разделением на эксперты, где на каждый ответ работает не вся сеть. Вывод для читателя простой: «крупнее значит медленнее» больше не работает, скорость надо мерить, а не предполагать
Какая модель влезет в 8, 16 и 36 ГБ памяти?
Ориентир такой: до 4 ГБ файла на восьми гигабайтах, до 10 ГБ на шестнадцати, до 24 ГБ на тридцати шести. Ниже таблица с именами моделей и тем, что каждый класс вывозит
| Память машины | Файл модели | Что брать | Что она тянет |
|---|---|---|---|
| 8 ГБ | до 4 ГБ | gemma3:4b, qwen3.5:4b, llama3.2:3b | переписать текст, перевести, разобрать письмо, короткий код |
| 16 ГБ | до 10 ГБ | qwen3.5:9b, gemma4:12b, gemma3:12b | связный текст на страницу, код с объяснением, разбор документа |
| 36 ГБ | до 24 ГБ | gpt-oss:20b, qwen3.5:27b, gemma4:26b | длинный диалог, работа с большим файлом, задачи в несколько шагов |
| меньше 8 ГБ | до 1 ГБ | gemma3:270m, gemma3:1b | простые ответы, черновые формулировки |
Таблица прокручивается вбок →
Две оговорки, без которых таблица врёт. Первая: у меня Apple Silicon, где память общая для процессора и встроенной видеокарты. На Windows или Linux с отдельной видеокартой считать надо по её собственной памяти, а не по оперативной: восьмигигабайтная карта в машине с 32 ГБ оперативной даёт восьмигигабайтный потолок. Вторая: модель влезет и впритык, но тогда система начнёт вытеснять остальное, и тяжело станет всему сразу
Как понять, что модель не влезла, и что делать?
Смотреть колонку PROCESSOR в выводе ollama ps: значение 100% GPU (GPU - это видеокарта, она считает быстро) означает, что модель поместилась целиком и будет отвечать быстро, а появившаяся доля CPU (обычный процессор, он медленнее) означает, что часть модели считается на нём и ответ замедляется в разы. Это прямая рекомендация вендора:
«For best performance, use the maximum context length for a model, and avoid offloading the model to CPU. Verify the split under
документация Ollama, раздел о длине контекста, проверено 16.08.2026PROCESSORusingollama ps»
Я попробовал добиться этой картинки на своей машине и не смог: раздувал окно контекста до 262 тысяч кусочков текста, потом держал в памяти три модели сразу. Ollama повела себя иначе, чем я ждал: вместо дележа между видеокартой и процессором она выгрузила самую крупную модель, чтобы вместить остальные. То есть на 36 ГБ модель либо влезает целиком, либо исчезает из ollama ps
Что делать, когда упёрся. Взять модель на ступень младше - gemma4:12b вместо gemma4:26b. Уменьшить контекст, запустив фонового помощника командой OLLAMA_CONTEXT_LENGTH=8192 ollama serve. Закрыть браузер: два десятка вкладок легко съедают те самые 3-4 ГБ, которых не хватило
Как позвать Ollama из своей программы?
Через локальный адрес http://localhost:11434, он поднимается сам вместе с программой и отвечает тем же движком, что и то самое окно с командами, только запрос к нему можно слать из любого языка программирования. Готовый пример ниже, и в нём две незнакомые вещи. Первая - слово curl в начале: это встроенная в систему программа-курьер, она отправляет запрос по адресу и приносит ответ. Вторая - всё, что в фигурных скобках: это просто формат записи запроса, где сказано, какая модель отвечает и на какой вопрос, разбираться в нём не нужно
Скопируй блок целиком, вставь в то же окно для команд и нажми Enter:
curl http://localhost:11434/api/generate -d '{
  "model": "gemma3:4b",
  "prompt": "Столица Франции? Одно слово.",
  "stream": false
}'
Что увидишь: короткий ответ модели текстом. Мой прогон 16 августа 2026 занял 0,24 секунды и вернул слово «Париж»
На Windows та же проверка делается в PowerShell - это второе окно для команд, которое уже стоит в системе. Готовый вызов вендор публикует прямо в документации, вот он целиком:
(Invoke-WebRequest -method POST -Body '{"model":"llama3.2", "prompt":"Why is the sky blue?", "stream": false}' -uri http://localhost:11434/api/generate ).Content | ConvertFrom-jsonСкопируй строку целиком, вставь в окно PowerShell и нажми Enter. Что увидишь: ответ модели текстом, разложенный по строчкам. Модель в примере вендора называется llama3.2, у тебя скачана другая - подставь её имя вместо него. Список скачанных моделей отдаёт адрес /api/tags, а формат запросов совместим с готовыми наборами кода для программистов, поэтому многие готовые программы подключаются к Ollama одной сменой адреса
Важное для безопасности: порт слушается только на самой машине. Наружу он не смотрит, пока ты сам это не разрешишь
Ollama Cloud: что бесплатно и за что просят деньги?
Локальный запуск бесплатен и не лимитирован вообще, деньги берут только за облачные модели: план Pro стоит 20 долларов в месяц, план Max - 100. Формулировка вендора на странице тарифов однозначная:
«Running models on your own hardware is always unlimited»
Ollama, страница тарифов, раздел вопросов об ограничениях, проверено 16.08.2026
Облачные модели - это те, что не влезут ни в какую домашнюю машину: их считают на компьютерах Ollama в интернете, а команда остаётся та же, ollama run с суффиксом -cloud. Тарифы на 16 августа 2026
| План | Цена | Облако | Моделей одновременно |
|---|---|---|---|
| Free | 0 $ | лёгкое использование | 1 |
| Pro | 20 $ в месяц или 200 $ в год | в 50 раз больше Free | 3 |
| Max | 100 $ в месяц | в 5 раз больше Pro, новые подписки приостановлены | 10 |
| Team | 25 $ за место, минимум 5 мест | входит в место | по местам |
Таблица прокручивается вбок →
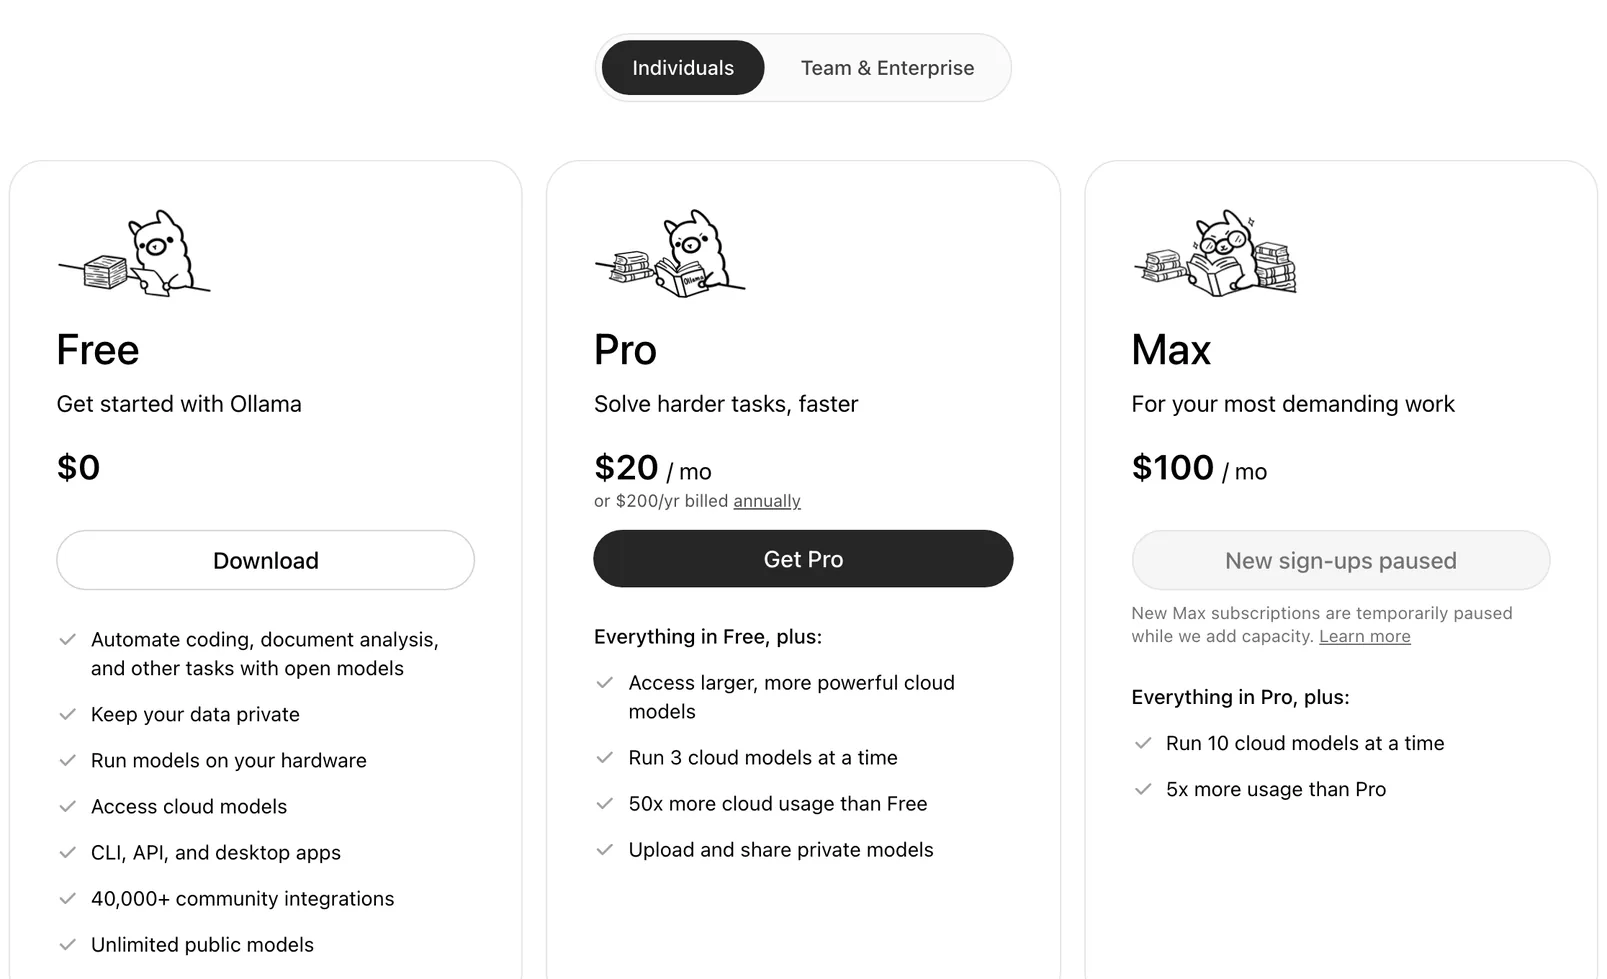
Точных чисел по лимитам вендор не публикует принципиально: сказано лишь, что у каждого плана есть лимит сессии со сбросом раз в 5 часов и недельный лимит со сбросом раз в 7 дней, а остаток смотрят в личном кабинете. Про оплату честно: бесплатный план карту не просит вовсе, а страница апгрейда без аккаунта перекидывает на вход, так что до формы оплаты дело не доходит. Проверять приём карты российского банка я не стал и утверждать про неё ничего не буду
Практический вывод: для установки и локальной работы аккаунт вообще не нужен. Команда ollama signin нужна ровно тогда, когда захочешь облачную модель
Работает ли Ollama из России и без интернета?
Из России на 16 августа 2026 работает без VPN, а после скачивания модель отвечает и с выключенной сетью. Проверял и то, и другое, и по первому пункту сразу оговорка про метод. Мой рабочий компьютер стоит не в России, поэтому проверять доступ с него нечестно: он показал бы турецкий канал, а не российский. Поэтому все запросы ниже ушли с арендованного компьютера в Москве, провайдер Timeweb
| Адрес | Ответ с московского адреса |
|---|---|
ollama.com | 200 |
ollama.com/download и /download/windows | 200 |
ollama.com/library | 200 |
ollama.com/pricing | 200 |
docs.ollama.com | 200 |
ollama.com/search?c=cloud | 200 |
ollama.com/signin | 303 на страницу входа, она тоже открылась |
registry.ollama.ai (реестр моделей) | 200, карточка модели с размерами отдана |
Таблица прокручивается вбок →
Коды ответов главной страницы ничего не доказывают: заблокировать могут именно загрузку. Поэтому я догнал проверку до конца и с того же московского адреса потянул сами файлы. Установщики OllamaSetup.exe и Ollama.dmg физически качаются, хотя лежат они не на сайте Ollama, а на файлах релизов GitHub. Слой модели gemma3:4b из реестра тоже пошёл: первый мегабайт пришёл за полсекунды, около 1,9 мегабайта в секунду. Ни разу не отказали и ни разу не перебросили на другой адрес из-за страны
Чего эта проверка не доказывает, скажу честно: она про загрузку файлов, а не про оплату. Регистрация в Ollama Cloud уходит на внешний сервис входа, и приём карты российского банка я не проверял. Для установки и локальной работы это и не нужно: аккаунт там не спрашивают
Теперь про работу без интернета: она правда для запуска и неправда для скачивания. Я поднял вторую копию Ollama, у которой весь исходящий трафик заведён в тупик, и сравнил поведение двух команд: запуск уже скачанной модели qwen2.5-coder:3b и попытку скачать новую, gemma3:270m
Уже скачанная модель ответила как ни в чём не бывало и напечатала дату, а попытка скачать новую упала сразу с ошибкой соединения. Значит правило такое: качай модели, пока сеть есть, дальше они твои. Именно поэтому локальную модель имеет смысл держать как запасной вариант, а чем открытые модели отличаются от флагманских, разобрано в гайде про фронтир открытых моделей
На чём спотыкается новичок в первый час?
На четырёх вещах, и все четыре я собрал сам за один вечер 16 августа 2026. Ни одна не описана на видном месте
Первое: команда ollama не находится сразу после установки. Это нормально и ожидаемо, ничего не сломалось: окно для команд ты открыл раньше, чем поставил программу, поэтому оно про неё пока не знает. Закрой это окно, открой заново - команда найдётся
Второе: после обновления версия не меняется. Программа обновилась, а фоновый помощник в памяти старый. Лечится одной командой, которая гасит старого помощника и поднимает нового: у меня это brew services restart ollama
Третье: диск кончается незаметно. Те самые 31 ГБ из первого раздела набежали за один вечер, потому что скрытую папку не видно, а ollama list показывает вес каждой модели, только если про него вспомнить. Уборка одной строкой: ollama rm имя-модели
Четвёртое: модель молча исчезает из ollama ps. Это не сбой, а вытеснение: Ollama выгружает старую модель, когда не хватает памяти под новую. Смотри список, а не жди сообщения об ошибке
Что делать после того, как модель заработала?
Определиться, зачем она тебе: чат в этом окне это ещё не инструмент, а ollama run без конкретной задачи превращается в игрушку на один вечер. Модель на своей машине сильна ровно там, где важна приватность и отсутствие лимитов: разбор личных документов, черновики, код, работа в самолёте. Флагманские облачные модели пока сильнее в сложных рассуждениях, и локальная их не заменяет
Дальше развилка: хочешь собрать рабочее место вокруг локальной модели - это отдельная тема, она разобрана в гайде про локальный ИИ-воркспейс. Хочешь подключить модель к редактору кода - в списке команд есть ollama launch, который поднимает связку с популярными инструментами
А вот превратить установленную модель в инструмент под конкретную задачу, с промптами, файлами и повторяемым результатом, за один вечер по инструкции не получается. Это уже система, и её мы собираем отдельно
Источники
- Страница загрузки Ollama и вкладка Windows - установщики, однострочники, требование Windows 10 и новее, проверено 16.08.2026
- Документация Ollama: Windows - Windows 10 22H2, 4 ГБ под установку, установка без прав администратора, переменная OLLAMA_MODELS, вызов API (обращения к программе кодом) из PowerShell
- Документация Ollama: macOS - macOS Sonoma 14 и новее, Apple M-серии или x86, путь
~/.ollama - Документация Ollama: Linux - команда установки и раздел ручной установки без однострочника
- Документация Ollama: FAQ - пути хранения моделей на трёх системах и переменная OLLAMA_MODELS
- Документация Ollama: справочник команд - описания pull, run, ls, ps, rm и полный список команд
- Документация Ollama: длина контекста - контекст по объёму памяти 4k/32k/256k и цитата про колонку PROCESSOR
- Документация Ollama: поддержка железа - драйвер NVIDIA 550 и новее, список карт NVIDIA и AMD
- Тарифы Ollama - цены Free, Pro, Max и Team, лимиты сессии и недели, цитата про неограниченный локальный запуск
- Лента релизов ollama/ollama - версия 0.32.13 от 14.08.2026 против 0.32.6 в Homebrew
- Каталог моделей Ollama - перечень моделей и сверка размеров с моим замером по реестру
- Проверка доступа из России - мои запросы с арендованного компьютера в Москве (провайдер Timeweb) к страницам Ollama, установщикам и реестру моделей, 16.08.2026
Памятка: Ollama от установки до первой модели
Семь строк, по которым всё проверяется
Сохрани себе
- Система подходит: Windows 10 22H2 и новее, macOS Sonoma 14 и новее или Linux
- Свободно минимум 10 ГБ: 4 ГБ под программу и остальное под первую модель
- Установщик скачан со страницы загрузки, а не с чужого зеркала
- Команда
ollama --versionпечатает номер версии в новом окне для команд - Первая модель выбрана по правилу «файл на 3-4 ГБ меньше объёма памяти»
ollama psпоказывает100% GPU(модель целиком на видеокарте), а не долю CPU (обычного процессора)- Лишние модели удалены командой
ollama rm, место на диске проверено
Модель стоит, дальше система
От установленной модели к рабочему инструменту
Установка занимает вечер и разобрана выше целиком. Что с этой моделью делать дальше, как ставить ей задачи и получать повторяемый результат - в ИИ-Лагерь
Частые вопросы
Сколько места на диске нужно под Ollama?
Под саму программу около 4 ГБ на Windows и около 1 ГБ на macOS и Linux, дальше всё зависит от моделей. Самая маленькая gemma3:270m весит 0,29 ГБ, рабочая gemma3:4b - 3,34 ГБ, крупная gemma4:26b - 17,99 ГБ, полный список размеров - в каталоге моделей Ollama. У меня после пяти скачиваний каталог моделей занимал 31 ГБ
Работает ли Ollama без интернета?
Уже скачанная модель работает полностью офлайн, я проверял это с наглухо закрытой сетью. А вот ollama pull без интернета падает сразу: новые модели скачиваются только из реестра
Нужна ли видеокарта, чтобы запустить модель?
Нет, модель поедет и на процессоре, только медленнее. Видеокарта нужна для скорости: Ollama поддерживает NVIDIA с драйвером 550 и новее и часть карт AMD. На компьютерах Apple с чипами M-серии отдельная карта не нужна, там память общая
Как удалить модель и освободить место?
Командой ollama rm имя-модели, можно перечислить несколько через пробел. Посмотреть, что вообще скачано и сколько весит, помогает ollama list. Программа при этом остаётся, удаляются только файлы модели
Ollama платная?
Локальный запуск бесплатен и не ограничен, это прямая формулировка вендора на странице тарифов. Платят только за облачные модели: Pro стоит 20 долларов в месяц, Max - 100. Бесплатный план карту не просит
Какую модель выбрать для работы с кодом?
На 8 ГБ памяти - qwen2.5-coder:7b весом 4,68 ГБ, на 16 ГБ - qwen3.5:9b или gemma4:12b, на 36 ГБ - gpt-oss:20b. Правило то же: файл на 3-4 ГБ меньше объёма памяти
Что делать, если терминал не находит команду ollama?
Закрыть то самое окно и открыть заново: старое окно не знает про программу, установленную после его запуска. Если не помогло, на macOS проверь, что при первом запуске программа получила разрешение создать ссылку на команду, а на Windows - что установка завершилась без ошибки