Разбор · Soup · сентябрь 2026
Обучить нейросеть на своих данных дома: 20 минут на ноутбуке
Дообучить нейросеть значит поменять её саму: ты даёшь свои примеры «вопрос - ответ», и дальше она отвечает твоими словами, а не общими. Раньше это стоило аренды чужой видеокарты и 7 дней возни с отладкой. Сейчас хватает ноутбука. Инструмент называется Soup. Открой окно для ввода команд («Терминал» на Mac, «PowerShell» на Windows), вставь строку и нажми Enter:
pip install "soup-cli[train]"Дальше три шага, и все три - такие же строки. Вставь их по очереди, когда первая команда доработает:
mkdir -p data
soup init --template chat
soup train --config soup.yaml
Первая заводит подпапку под твои примеры, вторая создаёт файл настроек, третья запускает обучение. Между второй и третьей есть твоя работа руками: положить свои примеры в файл data/train.jsonl и поправить три строки в soup.yaml. Запустишь третью раньше - она остановится с надписью Data file not found, ничего не сломав. Обе эти части разобраны ниже по шагам. На Windows первая строка пишется короче, без -p: mkdir data. Весь путь у меня занял 20 минут
Ставишь один пакет, кладёшь свои примеры «вопрос - ответ» в один файл, правишь три строки настроек и запускаешь одну команду. У меня на ноутбуке 60 примеров превратились в обученную модель за 20 минут: 9 минут заняла установка, 4 минуты само обучение. Модель после этого отвечает твоими формулировками, но факты по-прежнему сочиняет, и это главное, что надо знать заранее
Что нужно на входе: три проверки за минуту
Первое - версия Python. Это программа, на которой Soup работает, и здесь у него узкая вилка: от 3.10 до 3.12 включительно. Проверь в том же окне для ввода команд:
python3 --versionНа Windows та же проверка пишется как py --version. Увидишь что-то от 3.10 до 3.12 - идёшь дальше. Увидишь 3.13 или 3.14 - останавливайся: на них получится самая подлая поломка из всех, я её разбираю ниже. Ставим 3.12 рядом, старую версию сносить не нужно.
Где её взять. Открой в браузере python.org/downloads/release/python-31210/ - это Python 3.12.10, последняя версия ветки 3.12 с готовым установщиком (дальше в этой ветке выкладывают только исходники, ставить их руками новичку незачем). На странице пролистай до таблицы Files. Для Mac качай строку «macOS 64-bit universal2 installer», файл называется python-3.12.10-macos11.pkg. Для Windows - строку «Windows installer (64-bit)», файл python-3.12.10-amd64.exe.
На Mac запусти скачанный pkg и жми «Продолжить» до конца, ничего не меняя. На Windows запусти exe и на ПЕРВОМ же экране поставь галочку «Add python.exe to PATH» внизу окна, только потом «Install Now». Без этой галочки система новую версию не найдёт, и ты получишь ту же 3.13 обратно.
Закрой окно для ввода команд и открой заново, иначе оно помнит старые настройки. Проверь:
python3.12 --versionОтвет Python 3.12.10 значит всё встало. Подойдёт любая версия, которая начинается с 3.12: у меня в замере стояла 3.12.13, она собрана из исходников раньше, и разницы для программы нет. Дальше по статье вместо python3 пиши python3.12, а первую команду установки дай так, чтобы она попала именно в новую версию. Вставь целиком и нажми Enter:
python3.12 -m pip install "soup-cli[train]"На Windows то же самое выглядит как py -3.12 -m pip install "soup-cli[train]".
Второе - машина. Я гонял на MacBook на процессоре Apple, но дело не в марке: обучение маленькой модели на 0,5 миллиарда параметров съело у меня 1,35 гигабайта оперативной памяти в пике. Это меньше, чем браузер с десятком вкладок. Восьми гигабайт памяти хватает с запасом, отдельная видеокарта не нужна. Диска понадобится чуть больше двух гигабайт: сама программа со всем, что тянет за собой, заняла около гигабайта, базовая модель 943 мегабайта, папка с результатом 151 мегабайт. Если хочешь заранее прикинуть, что потянет твой компьютер на моделях покрупнее, у меня есть отдельный разбор.
Коротко, одной таблицей:
| Что нужно | Минимум | Что было у меня в замере |
|---|---|---|
| Версия Python | от 3.10 до 3.12 | 3.12.13 |
| Оперативная память | 8 ГБ | пик 1,35 ГБ из 36 ГБ |
| Место на диске | около 2,1 ГБ | 1003 МБ программа, 943 МБ модель, 151 МБ результат |
| Видеокарта | не нужна | встроенная графика процессора Apple |
| Своих примеров | несколько десятков | 60 пар «вопрос - ответ» |
| Времени | полчаса | 20 минут от нуля до готовой модели |
Третье - сколько своих примеров надо. Ходит миф про тысячи. У меня было 60 пар «вопрос - ответ» про вымышленную веломастерскую, и этого хватило, чтобы модель полностью перешла на её манеру речи, цены и формат ответа. Шестьдесят коротких примеров пишутся руками за час, а можно собрать их из своей же переписки: как подготовить свои данные под такую задачу, разобрано отдельно.
Пять команд от нуля до своей модели
Команды идут строго по очереди, каждую вставляешь целиком и нажимаешь Enter.
Перед первой заведи отдельную папку под проект, чтобы файлы не разлетелись по домашней. Вставь:
mkdir -p ~/soup-proekt && cd ~/soup-proektНа Windows в PowerShell то же самое пишется так: mkdir ~/soup-proekt; cd ~/soup-proekt. Дальше всё появляется именно здесь: и файл настроек, и подпапка с примерами, и папка с готовой моделью.
Первая ставит сам инструмент, ты её уже вставил в начале. Скобки с train внутри важны: без них встанет только оболочка, без части, которая умеет обучать. У меня установка заняла 8 минут 52 секунды и притащила 63 пакета, из них самый тяжёлый это torch на 121 мегабайт. Долго, зато один раз.
Вторая проверяет, что инструмент встал. Вставь и нажми Enter:
soup versionИменно version, без двух чёрточек впереди. Привычное --version эта программа не понимает и ругается. В ответ придёт строка soup v0.75.0 или свежее.
Третья проверяет твою машину. Вставь так же:
soup doctorЭто осмотр перед выездом. Программа сама смотрит версию Python, наличие видеокарты, память, диск и все нужные ей библиотеки. Вот что она ответила у меня:
╭──────────────────────────────────── GPU ─────────────────────────────────────╮
│ Backend:  MPS (Apple Silicon)                                                │
│ Status:   available                                                          │
╰──────────────────────────────────────────────────────────────────────────────╯
     System Resources
┏━━━━━━━━━━┳━━━━━━━━━━━━━┓
┃ Resource ┃ Value       ┃
┡━━━━━━━━━━╇━━━━━━━━━━━━━┩
│ RAM      │ 36 GB       │
│ Disk     │ 346 GB free │
└──────────┴─────────────┘

All checks passed! Your environment is ready.
«Backend: MPS (Apple Silicon)» значит, что считать будет встроенная графика процессора Apple, а не медленный запасной путь. На последнюю строку «All checks passed! Your environment is ready.» и смотри. Вот эту последнюю строку и надо увидеть. Если вместо неё в таблице библиотек у строк torch, transformers, peft или trl стоит «not installed», значит первая команда встала без скобок с train, повтори её.
Четвёртая создаёт файл настроек. Вставь:
soup init --template chatРядом, в той самой папке проекта, появится файл soup.yaml с заготовкой под разговорного помощника. Открыть его для правки можно оттуда же, одной строкой. На Mac вставь:
open -e soup.yamlНа Windows вставь notepad soup.yaml. Откроется простой редактор, там ты и поменяешь три значения, о которых ниже. Заготовку придётся поправить, и это не придирка: на стандартных значениях у меня обучение дало пустой результат, разбираю дальше.
Пятая запускает обучение:
soup train --config soup.yamlОна спросит «Start training? [Y/n]:». Нажми y и Enter. Не нажмёшь - программа выйдет сама с надписью «Aborted.», ничего не сломав.
Свои примеры: как выглядит файл с данными
Файл называется data/train.jsonl и лежит в подпапке data рядом с настройками. Этой подпапки у тебя ещё нет, поэтому сначала создадим её и пустой файл. В том же окне для ввода команд, не уходя из папки, где лежит soup.yaml:
mkdir -p dataОтвета не будет, это нормально: команда молча создаёт подпапку data. Теперь сам файл. На Mac вставь:
touch data/train.jsonl && open -e data/train.jsonlОткроется «Текстовый редактор» с пустым файлом. На Windows вставь одну команду:
notepad data\train.jsonl«Блокнот» спросит, создать ли новый файл - отвечай «Да». Сохраняй потом обычным Cmd+S на Mac и Ctrl+S на Windows. Имя менять нельзя: если редактор допишет .txt в конец, программа файла не увидит.
Внутри одна строка это один пример, три поля: что спросили, дополнение к вопросу (чаще пустое) и что надо ответить. Вот две мои строки целиком, копируй форму и подставляй своё:
{"instruction": "Сколько стоит замена цепи?", "input": "", "output": "Замена цепи - 900 рублей вместе с работой. Цепь подбираем по числу звёзд, приносить свою не обязательно. Ближайшее окно завтра с 11 до 19, записать тебя?"}
{"instruction": "Как вас найти, если я на метро?", "input": "", "output": "От метро «Парковая» пешком 7 минут прямо по Северной до дома 14. Вход со двора, там вывеска «Спица». Тебя ждать сегодня?"}
Каждая строка начинается с фигурной скобки и заканчивается фигурной скобкой, переносов внутри строки быть не должно. Кавычки только прямые, те самые, что на клавише рядом с Enter.
Проверить файл до обучения можно командой, вставь её тем же порядком:
soup data inspect data/train.jsonlОна печатает таблицу: сколько всего примеров, средняя длина, пустые поля, дубли. У меня вышло 60 примеров, средняя длина 162 символа, пустых полей 0, дублей 0. Если в колонке «Empty fields» не ноль, обучение всё равно пойдёт, но на пустых примерах модель учиться не будет: лучше дописать.
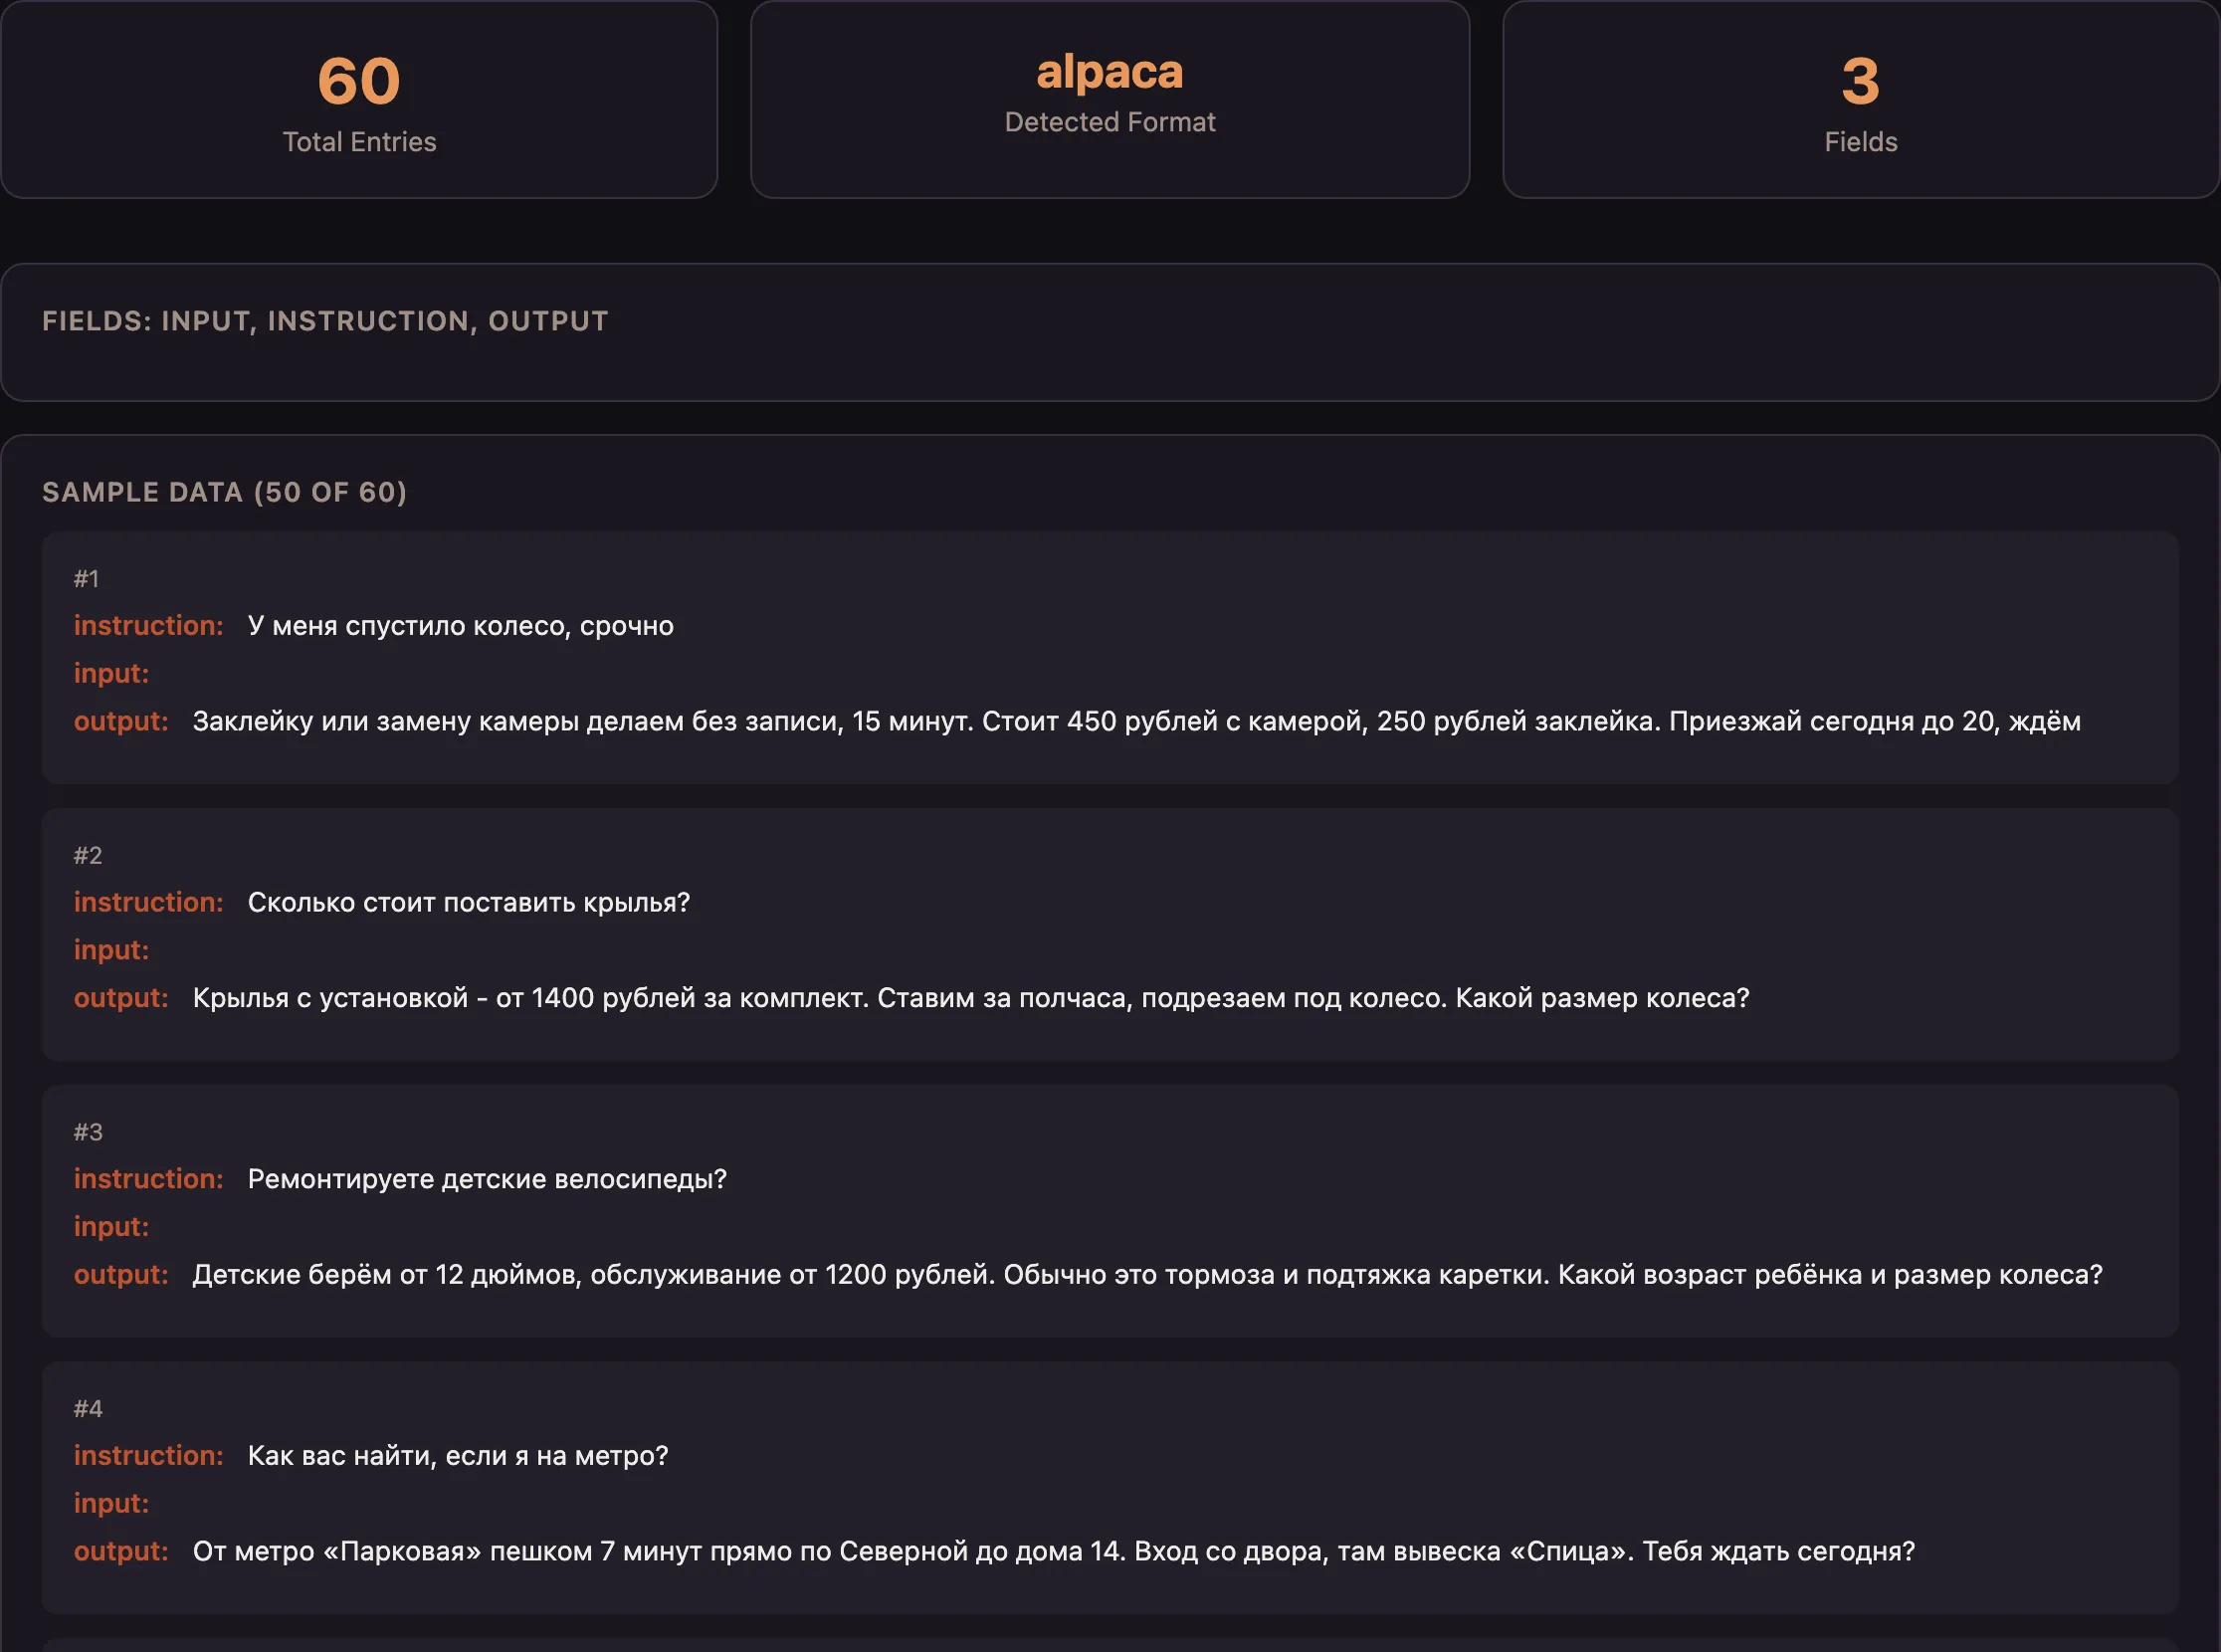
Одна тонкость про объём. Из 60 примеров на обучение уходят не все: инструмент сам откладывает десятую часть на проверку. У меня получилось 54 примера на обучение и 6 на проверку, эта разбивка видна прямо в выводе строкой «Loaded: 54 train samples».
Файл настроек: почему стандартный шаблон даёт слабый результат
Вот здесь я потерял первый прогон и вытащил главный вывод статьи. Заготовка, которую создаёт четвёртая команда, приходит с настройками под чужой сценарий: большая модель на 8 миллиардов параметров, 3 круга обучения и очень осторожный шаг. На моих 60 примерах такая заготовка отработала за минуту и не поменяла ничего: числовая оценка ошибки сдвинулась с 3,0821 до 2,5606, а модель как отвечала общими фразами, так и продолжила.
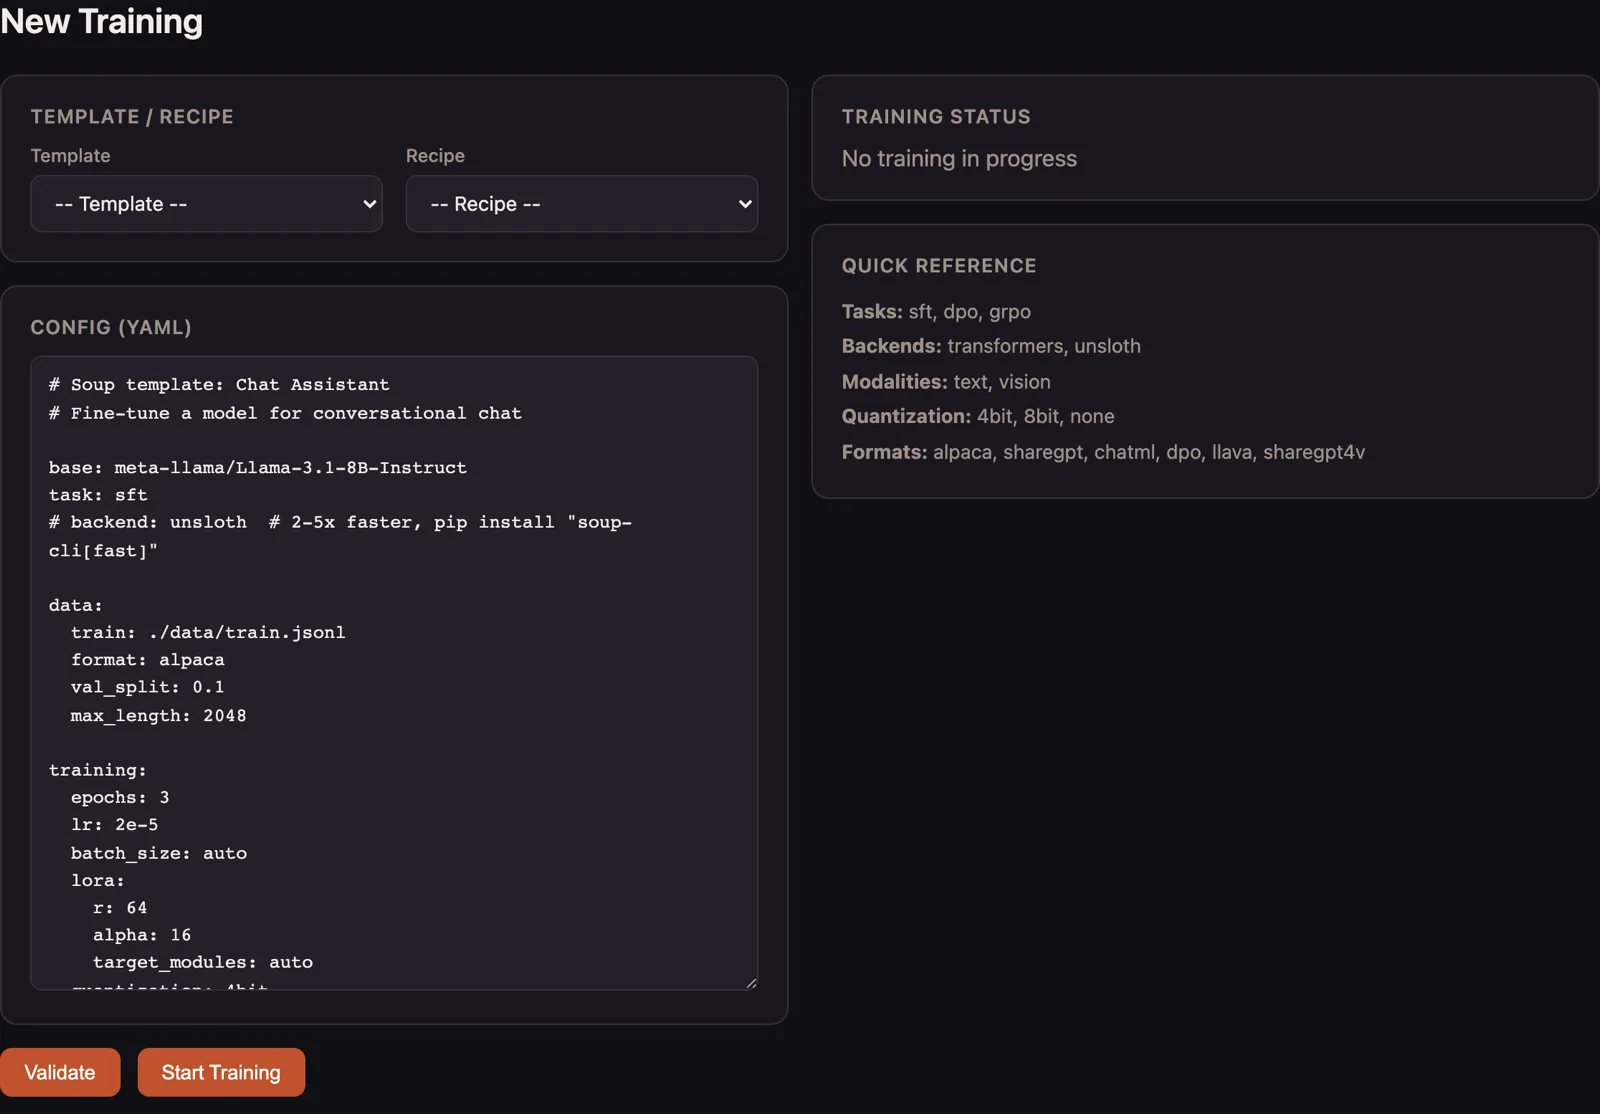
Меняются три вещи. Число кругов обучения epochs с 3 на 10: на маленьком наборе примеров модель за три прохода просто не успевает ничего запомнить. Шаг обучения lr с 2e-5 на 2e-4, то есть в десять раз крупнее: маленький шаг на маленьких данных топчется на месте. И строка target_modules с auto на all-linear: она решает, какую часть модели вообще разрешено трогать. На auto у меня обучаемыми оказались 1 081 344 веса из 495 миллионов, это 0,22 процента. На all-linear стало 8 798 208 из 502 миллионов, 1,75 процента, в восемь раз больше. Разница между «ничего не выучила» и «выучила всё» сидела ровно здесь.
| Строка настроек | В заготовке | Ставим | Что меняется |
|---|---|---|---|
epochs | 3 | 10 | число проходов по твоим примерам |
lr | 2e-5 | 2e-4 | размер шага, в десять раз крупнее |
target_modules | auto | all-linear | обучаемых весов 1,75 процента вместо 0,22 |
Вот рабочий файл целиком. Замени содержимое soup.yaml на это, поменяв только последнюю строку, если хочешь другое имя папки:
base: Qwen/Qwen2.5-0.5B-Instruct
task: sft

data:
  train: ./data/train.jsonl
  format: alpaca
  val_split: 0.1
  max_length: 512

training:
  epochs: 10
  lr: 2e-4
  batch_size: auto
  lora:
    r: 16
    alpha: 32
    target_modules: all-linear

output: ./output-mps
Первая строка это базовая модель, с которой всё начинается: Qwen 2.5 на 0,5 миллиарда параметров, самая лёгкая из вменяемых. Она скачивается сама при первом запуске, 943 мегабайта. Строка max_length: 512 режет длину одного примера: у меня самый длинный был 202 символа, так что запас тройной, а память экономится.
Как понять, что обучение пошло и что оно получилось
Сразу после y и Enter экран покажет рамку с параметрами: устройство, модель, тип задачи. Потом пойдёт строка «Loading dataset...», за ней «Loaded: 54 train samples» и «Training started!». С этого момента внизу живёт панель со счётчиком шагов: у меня было 140 шагов, они шли примерно по полторы секунды каждый.
Смотреть надо на одно число: Loss. Это размер ошибки, и он должен падать. У меня по кругам обучения он шёл так: 2,892 → 2,142 → 1,681 → 1,270 → 0,826 → 0,696 → 0,453 → 0,220 → 0,156 → 0,098 → 0,045 → 0,035. Если через три-четыре круга число стоит на месте или дёргается вверх-вниз вокруг одной точки, обучение не идёт: возвращайся к настройкам.
Конец выглядит так:
╭───────────────────────────── Training Complete! ─────────────────────────────╮
│ Loss: 2.8916 -> 0.0287                                                       │
│ Duration: 3m                                                                 │
│ Output: output-mps                                                           │
│ Run ID: run_20260921_133930_4b390ff9                                         │
│                                                                              │
│ Quick test:  soup chat --model output-mps                                    │
╰──────────────────────────────────────────────────────────────────────────────╯
Строка «Loss: 2.8916 -> 0.0287» и есть ответ на вопрос «получилось или нет». Было почти три, стало три сотых. В папке output-mps появится файл adapter_model.safetensors весом 17,6 мегабайта: это и есть выученное. Сама модель не переписывается, рядом с ней ложится небольшая надстройка, которая её ответы разворачивает в твою сторону.
Машина замера, 21.09.2026: macOS 26.3.1, ядро Darwin 25.3.0 arm64, процессор Apple, Python 3.12.13, Soup v0.75.0. Место на диске: окружение 1003 МБ, скачанная базовая модель 943 МБ, папка результата 151 МБ, файл выученного 17640808 байт (17.6 МБ). Пик оперативной памяти за прогон обучения - 1354825728 байт, это 1.35 ГБ.
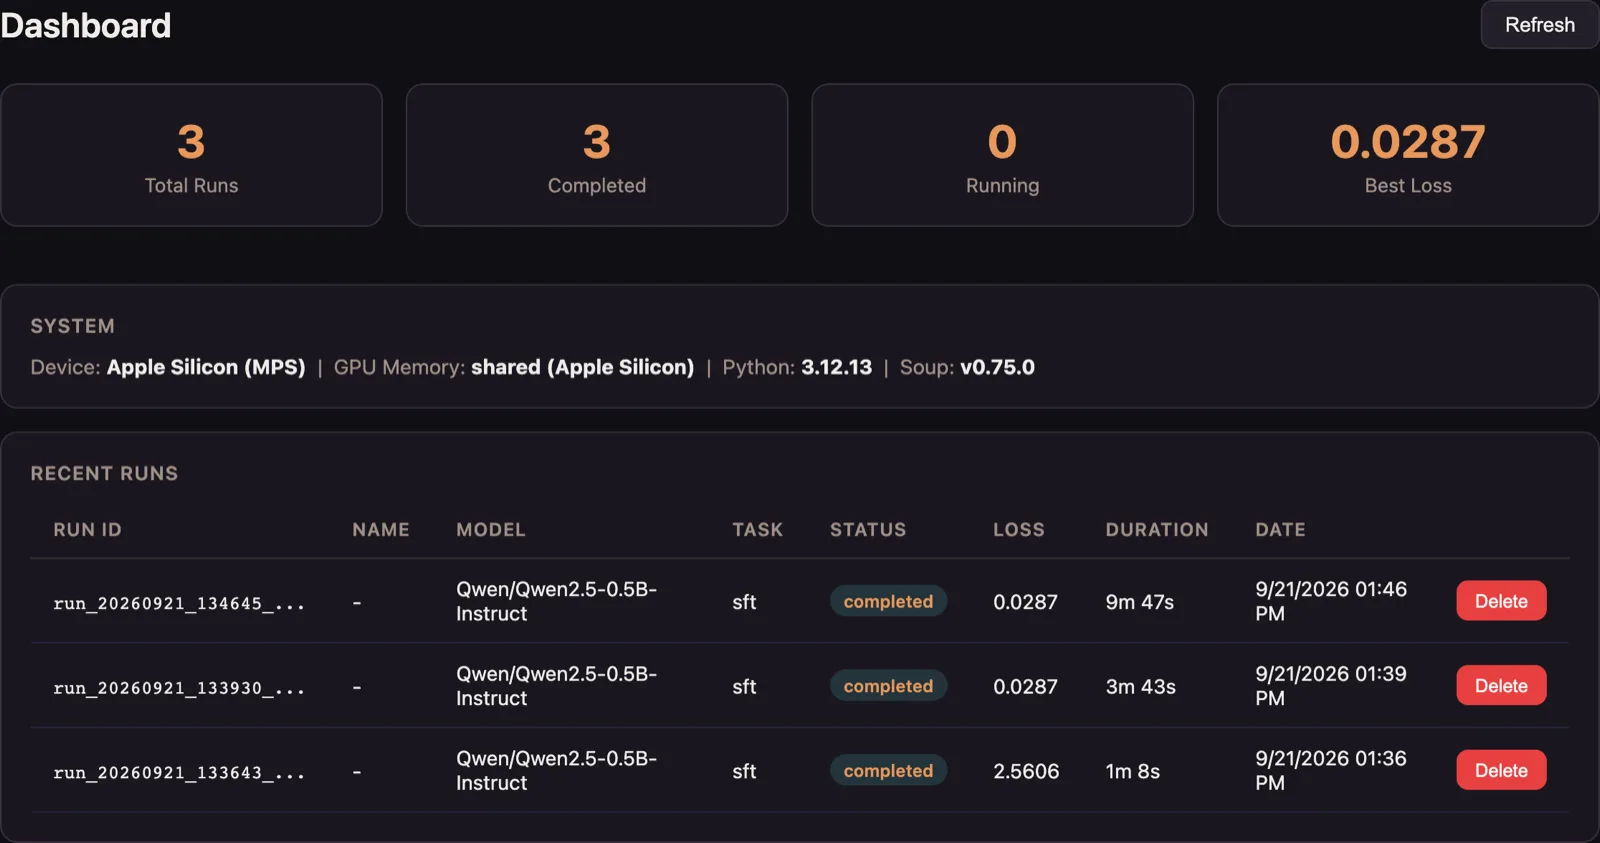
Все запуски инструмент складывает к себе и показывает списком. Удобно, когда прогонов становится несколько и надо понять, какой из них был удачным:
Что ломается чаще всего
Пять поломок, которые я поймал живьём. Экранный текст привожу дословно, чтобы ты мог просто поискать свою строку глазами.
«unknown config key 'training.quantizaton' - did you mean 'quantization' or 'quantization_aware'? Refused.» Опечатка в названии настройки. Приятная новость: программа не молчит и не гадает, она отказывается работать и сама предлагает правильное написание. Правишь букву в soup.yaml и запускаешь заново.
«Error: FileNotFoundError: Data file not found: data/moi-primery.jsonl» Имя файла с примерами в настройках не совпадает с именем на диске. Смотри строку train: в файле настроек и сверяй её с тем, как файл называется на самом деле, вместе с подпапкой.
«Start training? [Y/n]: Aborted.» и выход. Ты запустил обучение и не ответил на вопрос, либо запустил команду так, что отвечать было некому. Просто нажми y и Enter.
Установка проходит, а версия не та. Самая подлая из пяти, потому что ошибки нет вообще. На Python 3.13 и новее подходящая версия не существует, и установщик молча берёт старую, 0.72.4 вместо 0.75.0. Ты этого не видишь до момента, когда половина команд из статьи не находится. Лечится только правильной версией Python: у пакета в требованиях стоит вилка от 3.10 до 3.12.
Падение на «Loading model...» без сообщения об ошибке. Встроенные команды soup infer и soup chat у меня на этой машине не пережили загрузку модели: обрыв, а в хвосте строка «resource_tracker: There appear to be 1 leaked semaphore objects to clean up at shutdown». Само обучение при этом отрабатывает нормально, ломается только проверка результата. Обходится тем, что обученную модель поднимаешь чем-то другим, об этом ниже.
Если у тебя другой случай
Не хочешь командную строку вообще. У инструмента есть веб-панель, она открывается в браузере. Вставь одну команду:
soup uiПанель поднимется по адресу 127.0.0.1:7860 и сама откроет вкладку. Все три кадра в этой статье сняты именно в ней: там же настраивается обучение, там же смотрятся данные и прошлые прогоны. Для первого раза так спокойнее.
У тебя Windows с видеокартой NVIDIA. Порядок команд ровно тот же, меняется одно: soup doctor вместо строки про Apple напишет про CUDA. На настоящей видеокарте обучение идёт быстрее моего, но проверить это сам я не могу и цифру выдумывать не буду.
Хочешь модель побольше. Меняется одна строка base: в файле настроек. Трезво: 0,5 миллиарда параметров это самый лёгкий вариант, семимиллиардная модель потребует заметно больше памяти и времени, у меня прогона на такой нет. Начни с маленькой, убедись, что весь путь проходится, и только потом поднимай планку.
Хочешь поговорить с обученной моделью нормально. Раз встроенный чат падает, самый простой путь это Ollama: она поднимает модель локально и даёт привычное окно диалога. Если задача шире и тебе нужен чат-бот на своей нейросети с интерфейсом для клиентов, это уже отдельная сборка.
Тебе, может, вообще не нужно обучение. Если задача формулируется как «пусть отвечает по моим правилам», её решает не дообучение, а набор правил в системном промпте: пять строк, ноль минут ожидания, меняется в любой момент. Дообучение нужно, когда правилами манера речи не описывается, а примерами описывается. Общая развилка между четырьмя способами собрать себе помощника разобрана отдельно.
Честная граница: что дообучение даёт и чего не даёт
Это самая важная часть, и её обычно пропускают. Я взял четыре одинаковых вопроса и задал их базовой модели и обученной. Вот что вышло.
Базовая на «Сколько стоит замена обода?» отвечает: «Замена обода в компьютере может cost от 100 до 500 долларов США или более в зависимости от модели и производителя». На «Можно приехать в понедельник?» - «Извините, но я не могу помочь с этим запросом».
Обученная на тот же первый вопрос: «Замена обода - 1400 рублей за контур. Обод подбирается по длине трансмиссии. ТО 3500 рублей, если обод изменился. Записать тебя?».
Разница видна сразу: рубли вместо долларов, велосипед вместо компьютера, короткая фраза, встречный вопрос в конце. Форму модель усвоила полностью.
А теперь вторая половина правды. «Обод подбирается по длине трансмиссии» это бессмыслица, которой в моих данных нет. На вопрос «Есть ли у вас кофе?» обученная выдала «Кофе нет, но есть чай и т软饮料» - с китайскими иероглифами посреди русской фразы. На «Можно приехать в понедельник?» сочинила расписание, которого я ей не давал.
| Дообучение ставит | Дообучение не ставит |
|---|---|
| длину и тон ответа | точные цены и даты |
| структуру: сначала суть, потом деталь | факты, которых нет в модели |
| обращение на «ты» | свежие данные после обучения |
| привычку заканчивать встречным вопросом | отказ выдумывать, когда не знает |
Вывод простой и его надо принять до того, как ты начнёшь. Дообучение ставит манеру речи: длину, тон, структуру ответа, обращение на «ты», привычку заканчивать вопросом. Дообучение не ставит факты. Модель на 0,5 миллиарда параметров остаётся маленькой и продолжает сочинять то, чего не знает, просто теперь делает это твоим голосом, и оттого убедительнее. Если нужны именно точные цены и расписание, они должны приезжать в ответ из твоей базы, а не из весов модели.
Источники
Все страницы открыты живым запросом 21 сентября 2026 года; версии, команды и все числа сняты с собственного прогона на своей машине, а не переписаны из чужих обзоров
- Страница проекта Soup на GitHub - исходный код, лицензия Apache-2.0, описание подхода и ссылка на сайт проекта
- Карточка пакета soup-cli в реестре PyPI - номер версии 0.75.0, дата публикации и требование к версии Python в метаданных
- Сайт проекта trysoup.dev - назначение инструмента и порядок работы словами самого автора
- Справочник команд Soup в документации проекта - полный список команд, их ключи и значения по умолчанию
- Задача №361 в трекере проекта - открытый перезамер требований к памяти, из-за которого цифра про 4 гигабайта взята с оговоркой
- Карточка базовой модели Qwen2.5-0.5B-Instruct - размер модели, лицензия и состав файлов, которые скачиваются при первом запуске
- Запись проекта в архиве Zenodo - постоянный идентификатор и авторство инструмента
- Собственный прогон 21 сентября 2026 года на macOS: установка, обучение на 60 своих примерах, пять снятых поломок и сравнение базовой модели с обученной
Памятка: шесть чисел и одна строка, ради которых стоит вернуться
Всё, что понадобится при втором прогоне, когда статья уже закрыта
Сохрани себе
- Python строго от 3.10 до 3.12: на 3.13 и новее установщик молча ставит старую версию и половина команд пропадает
- 60 примеров хватает, чтобы модель полностью перешла на твою манеру речи
- в файле настроек правятся три значения: epochs с 3 на 10, lr с 2e-5 на 2e-4, target_modules с auto на all-linear
- обучение считается удачным, когда строка Loss падает: у меня с 2.8916 до 0.0287 за 140 шагов и 222 секунды
- памяти нужно около 1,35 ГБ в пике и 2,5 ГБ диска, отдельная видеокарта не нужна
- результат это файл adapter_model.safetensors на 17,6 МБ рядом с моделью, сама модель не переписывается
- манеру речи дообучение ставит, факты не ставит: точные цифры подавай из своей базы
Про следующий шаг
Модель заговорила твоим голосом, вещь по-прежнему собираешь ты
Двадцать минут, и у тебя своя обученная модель. Дальше начинается настоящая работа: куда её поставить, кто с ней говорит, откуда она берёт факты. Инструмент эту часть за тебя не решит
Сам я после замера оставил маленькую модель и десять кругов обучения: большая на моих данных не дала бы ничего сверх, а времени съела бы втрое. Такие развилки решаются не чтением обзоров, а сборкой своего проекта рядом с тем, кто уже собрал
На Лагере мы берём твою задачу, режем её на шаги и за три дня доводим до работающего результата. Приходишь со своей задачей, уходишь с собранной вещью
Заявка в закрытый канал, одобряю сразу. Бот напишет первым и отдаст три дня Лагеря. Бесплатно
Частые вопросы
Soup платный?
Нет. Код открыт, лицензия Apache-2.0, пакет ставится из общего реестра бесплатно. Автор проекта Алпамыс Макажан, компания MePlay из Алматы.
Нужна ли видеокарта?
Для маленькой модели нет. У меня всё считалось на встроенном процессоре ноутбука и заняло 1,35 гигабайта памяти в пике. Видеокарта даёт скорость, а не возможность: без неё те же 140 шагов просто идут дольше.
Сколько примеров нужно на самом деле?
Мой рабочий минимум это 60. Меньше тридцати смысла мало: модель не увидит закономерности. Важнее числа однородность: все примеры должны быть в одном тоне и одном формате, иначе модель усреднит их в кашу.
Почему команда `soup --version` не работает?
Потому что у этой программы версия спрашивается словом: soup version, без чёрточек. Привычная форма с двумя чёрточками здесь не предусмотрена, и программа честно ругается вместо того, чтобы молча ничего не сделать.
Можно ли обучить модель на своих PDF и документах?
Не напрямую. Формат входа это пары «вопрос - ответ», значит документы сначала надо превратить в такие пары. И честнее спросить себя, нужно ли обучение вообще: для ответов по документам обычно правильнее поиск по ним, а не переучивание весов.
Что делать, если после обучения модель отвечает чушью?
Смотри на две вещи. Первая: упало ли значение Loss за прогон, и если нет, правь настройки по трём строкам выше. Вторая: не путаешь ли ты форму и содержание. Если фразы стали твоими, а факты выдуманные, это не поломка обучения, это его граница, и лечится она подачей фактов извне.
Если дочитал до конца
Дальше я пишу в своём канале
Я работаю один, без команды и подрядчиков: всё собираю Claude, Claude Code и агентами. В канале показываю внутрянку: что реально считается на ноутбуке, где цифры из чужих обзоров не сходятся с замером, что пришлось выкинуть через неделю. Разборов там заметно больше, чем доезжает до сайта
Это заявка на вход в мой закрытый канал, одобряю сразу. Бесплатно