Гайд · локальные нейросети · август 2026
Локальные нейросети: 4 шага и что потянет твой компьютер

Облачный ИИ берёт с тебя двумя способами: деньгами за подписку и временем на ожидание в чужой очереди. На своей машине счёт другой: файл модели весит 1,9 ГБ, ответ приходит за 2,6 секунды, и после скачивания платить больше некому. Ниже 4 шага до такой же модели у тебя и правило, по которому сразу видно, потянет её твоё железо или нет
Локальная нейросеть - это модель, которая целиком лежит файлом у тебя на диске и считает ответ силами твоего же железа, без интернета и без подписки. Порог входа ниже, чем принято думать: рабочие модели начинаются с 292 МБ, а главное правило одно - в памяти модель занимает примерно вдвое больше, чем весит её файл
Что такое локальная нейросеть и почему она никуда не звонит
Локальная нейросеть - это файл с моделью, который лежит у тебя на диске, плюс программа, которая этот файл открывает и считает ответ силами твоего же компьютера. Больше в этой схеме никого нет
Разница с привычным чатом в браузере примерно как между книгой на полке и звонком в справочную. Справочная знает больше и отвечает бодрее, но она чужая, платная и иногда занята. Книга скромнее, зато всегда на месте, работает в самолёте и никому не рассказывает, что именно ты в ней искал
Слово «модель» тут значит одну конкретную вещь: большой файл с числами, в которых записано всё, чему нейросеть научилась. Скачал файл - знания у тебя. Откуда эти файлы берутся и почему их раздают бесплатно, разобрано отдельно в материале про открытые инструменты ИИ
Две схемы одной и той же работы
- Чат в браузере твой вопрос уходит на чужие мощности, там считается и возвращается ответом. Нужен интернет, нужна подписка, очередь общая на всех
- Модель на своём компьютере вопрос никуда не уходит: файл модели читается с твоего диска, считает твой же процессор или видеокарта. Интернет нужен один раз, чтобы скачать файл
- Что из этого следует скорость зависит только от твоего железа, лимитов на число вопросов нет вообще, а переписка физически не покидает машину
Последний пункт я проверил руками, а не поверил на слово
Во время работы модели я снял все сетевые соединения обеих программ, которые в этот момент считали ответ. Наружу не ушло ни одного: все соединения вели на адрес самой машины, то есть компьютер разговаривал сам с собой. Это и есть техническая причина, по которой локальная модель работает в самолёте и в поезде без связи
Потянет ли твой компьютер: правило, которое считается за минуту
Смотри на два числа: сколько у тебя оперативной памяти и сколько весит файл модели. Модель займёт примерно в полтора-два раза больше, чем весит её файл, и если эта величина влезает в свободную память - модель поедет
Правило выведено не из головы, а из своего прогона 20 августа 2026 года на MacBook с 36 ГБ памяти. Файл модели qwen3:4b весит 2,5 ГБ, а в памяти она заняла 5,3 ГБ. Файл модели qwen2.5-coder:3b весит 1,9 ГБ, в памяти получилось 2,8 ГБ. Обе модели целиком легли на видеокарту
Получается разброс от полутора до двух раз, и закладываться разумнее на верхнюю границу. Отсюда таблица, по которой можно прикинуть свою машину, ничего не устанавливая
| Сколько памяти в машине | Какой файл модели брать | Что реально получится |
|---|---|---|
| 8 ГБ | до 3 ГБ | короткие ответы, переписка, простые письма и переводы |
| 16 ГБ | до 6 ГБ | рабочий помощник на каждый день, разбор документов |
| 32 ГБ и больше | до 15 ГБ | длинные тексты, код, картинки в соседнем окне без тормозов |
Таблица прокручивается вбок →
Оперативная память - это рабочий стол компьютера: чем он больше, тем больше бумаг помещается разом. Файл модели на этот стол нужно выложить целиком, кусками она не работает. Память решает, КАКАЯ модель поедет, а вот поедет ли программа вообще - решает чип, и тут есть жёсткая отсечка, а не только рекомендация
Размеры моделей не секрет, они написаны прямо на странице каждой модели. Вот как это выглядит на примере семейства Gemma 3
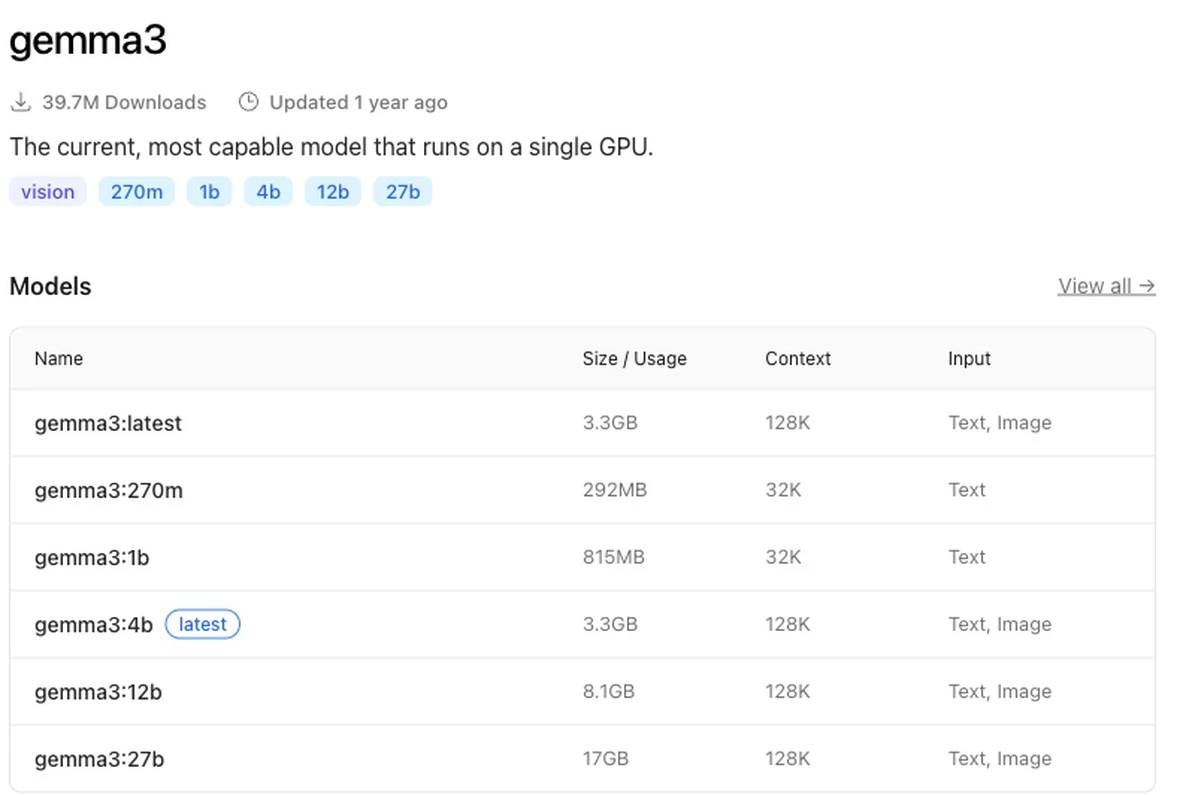
Самая маленькая рабочая версия весит 292 МБ, это меньше одной серии сериала. Средняя, с которой обычно начинают, - 3,3 ГБ. Крупная - 17 ГБ, и вот она уже требует серьёзной машины
Производители программ пишут требования мягче, чем принято думать - но одна отсечка жёсткая. LM Studio, самая простая программа для запуска, работает только на чипе Apple - M1 и новее, Intel-Маки программа не поддерживает вовсе, и это не вопрос мощности, а вопрос архитектуры. Дальше уже мягче: macOS нужна 14 и новее, памяти рекомендуют 16 ГБ. На Windows нужен x64 с поддержкой набора инструкций AVX2 (у процессоров младше 2013 года его может не быть) или ARM, и те же рекомендованные 16 ГБ. Видеокарта помогает, но не обязательна: без неё модель считает медленнее, а не отказывается работать
Шаг 0. Что проверить до первого клика
До установки нужны три вещи, и все три видны на одном и том же экране за пару минут
1. Чип и версия системы. Куда нажать: на Маке - меню Apple в левом верхнем углу → «Об этом Mac»; на Windows - Win+I → «Система» → «О системе». Что увидишь: строку «Чип» на Маке (там должно быть «Apple M1», M2, M3 или M4) или «Тип системы» на Windows, и версию ОС рядом. Что это даёт: сразу ясно, пойдёт ли программа вообще - LM Studio не ставится на Маки с процессором Intel, для Мака нужна macOS 14 и новее, для Windows x64 - поддержка набора AVX2
2. Объём памяти. Куда нажать: то же самое окно, строка «Память» на Маке или «Оперативная память» на Windows. Что увидишь: число с буквами ГБ - 8, 16, 32 или больше. Что это даёт: свою верхнюю планку по таблице выше, чтобы не качать 17 гигабайт, которые всё равно не запустятся
3. Свободное место на диске. Куда нажать: на Маке вкладка «Хранилище» в том же окне, на Windows - «Система» → «Память устройства». Что увидишь: сколько гигабайт свободно прямо сейчас. Что это даёт: уверенность, что файл модели физически поместится
Свободного места закладывай минимум 10 ГБ. Одна модель столько не займёт, но пробовать одной обычно не выходит: у меня после нескольких скачиваний каталог с моделями разросся до 4,2 ГБ, и это ещё скромно
Если позже захочешь связать локальную модель с рабочим местом для кода, пригодится отдельный гайд по установке помощника. Для сегодняшних четырёх шагов он не нужен: всё делается мышкой в обычном окне
Шаг 1. Поставь окно, в котором живут модели
Ставим LM Studio - бесплатную программу, которая выглядит как обычный мессенджер и берёт на себя всю техническую часть. Никаких чёрных окон с командами не будет
Установка программы
- Открой lmstudio.ai и нажми синюю кнопку Download сайт сам определит твою систему и предложит нужный файл: для Мака это ARM64, для Windows - x64. Что увидишь: файл появится в папке «Загрузки». Что это даёт: нужный файл уже подобран под твою систему, гадать с выбором не придётся
- Запусти скачанный файл и подтверди установку что увидишь: на Маке значок программы нужно перетащить в папку «Программы», на Windows установщик пройдёт сам и положит ярлык на рабочий стол. Что это даёт: программа легла на диск как любое другое приложение, ничего в системе не поменялось
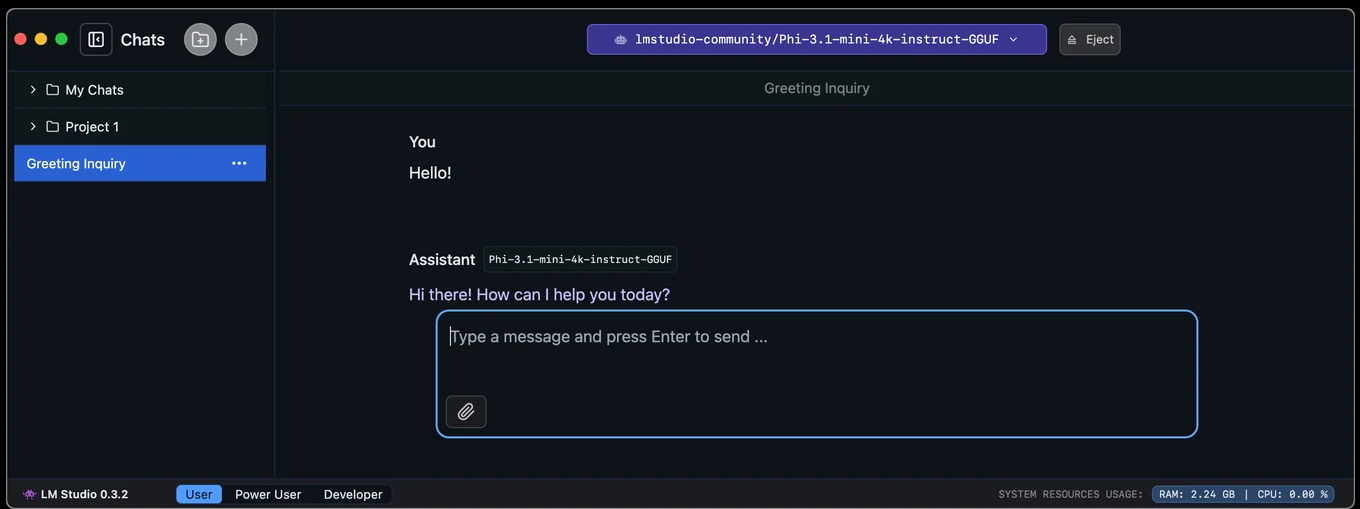
- Открой программу что увидишь: окно с боковым меню слева и большим пустым полем справа. Что это даёт: у тебя на компьютере появилось место, куда будут складываться модели и где ты будешь с ними разговаривать
Вот так это окно выглядит в работе: официальный вид приложения, модель уже загружена и отвечает
Программа бесплатна для личного использования: на странице тарифов прямо написано «$0» за локальный запуск моделей на своей машине. Деньги там берут только за облачные мощности, а они нам не нужны совсем
Есть и второй путь, без окна: движок Ollama, который живёт фоном и не показывает интерфейс вовсе. Он удобнее, когда модель нужна другим программам, а не тебе лично, и разобран в гайде по установке Ollama. Для первого раза бери программу с окном, она прощает больше ошибок
Шаг 2. Скачай первую модель под свою память
Модели не идут в комплекте с программой, их выбирают и качают отдельно - как книги для читалки. Внутри программы для этого есть свой каталог
Выбор и загрузка модели
- Нажми
⌘и2на Маке илиctrlи2на Windows что увидишь: откроется вкладка Discover, то есть встроенный магазин моделей с поиском вверху. Что это даёт: ты на месте, где выбирают и качают модели, дальше только искать по имени - Впиши в поиск название модели, например gemma что увидишь: список подходящих моделей, у каждой свой размер файла в гигабайтах. Сверься с таблицей из раздела про железо и выбирай ту, что влезет. Что это даёт: видно заранее, поместится ли модель в твою память, ещё до скачивания
- Выбери вариант сжатия и нажми Download что увидишь: метки вроде
Q4_K_Mрядом с названием и полоску загрузки. Официальная рекомендация - брать вариант на 4 бита или выше. Что это даёт: файл ляжет на твой диск и станет твоим навсегда
Метки со странными буквами - это степень сжатия. Модель, как фотографию, можно ужать: она станет легче и чуть проще, зато поместится в память обычной машины. Четыре бита - золотая середина, которую и советует документация программы: ниже начинает заметно глупеть, выше почти не выигрывает
Если загрузка идёт медленно - это нормально, ничего не сломалось: качаются гигабайты, а не мегабайты. Если вместо полоски загрузки появилась ошибка сети, проверь интернет и запусти загрузку заново, недокачанный файл программа подхватит с того же места
Шаг 3. Загрузи модель и задай первый вопрос
Скачанная модель ещё не работает: файл лежит на диске, но на рабочий стол компьютера его надо выложить. Это и делает загрузчик модели одной кнопкой
Первый разговор
- Перейди во вкладку Chat и открой загрузчик модели вверху окна что увидишь: выпадающий список со всеми моделями, которые ты скачал. Что это даёт: отсюда выбирают, какая из скачанных моделей начнёт отвечать
- Выбери скачанную модель что увидишь: полоску загрузки на несколько секунд, потом название модели закрепится вверху окна. Что это даёт: модель разложена в памяти и готова отвечать
- Напиши в поле внизу любой вопрос и нажми Enter что увидишь: ответ начнёт печататься по словам, как в обычном чате. Что это даёт: у тебя на компьютере работает собственный ИИ, и за этот ответ никто не выставит счёт
Половина пути позади: программа стоит, модель скачана, первый ответ получен. Осталось убедиться, что всё это действительно твоё, а не хитрая обёртка над чужими мощностями
Первый ответ приходит чуть медленнее следующих, и это тоже нормально: модель в этот момент раскладывается в памяти. Дальше она уже там и отвечает сразу
В моём прогоне у одной из моделей холодный старт стоил 2,249 секунды - почти всё время ушло на подъём файла в память. У другой модели, которая к этому моменту уже лежала в памяти, тот же этап занял 150 миллисекунд, то есть в пятнадцать раз меньше - это два разных файла, а не одна модель до и после. Смысл общий: если первый ответ пришёл с задержкой, а второй мгновенно - всё в порядке, так и должно быть, дело в том, лежит модель в памяти или нет
Шаг 4. Отключи интернет и убедись, что ничего не сломалось
Самая убедительная проверка занимает десять секунд: выключи Wi-Fi и задай модели ещё один вопрос. Ответ придёт точно так же
Проверка на честность
- Выключи Wi-Fi в верхней панели или в настройках сети что увидишь: значок сети погаснет, браузер перестанет открывать страницы. Что это даёт: честные условия для проверки - если модель ответит без сети, значит она правда твоя
- Вернись в окно программы и напиши новый вопрос что увидишь: ответ печатается как ни в чём не бывало. Что это даёт: ты своими глазами убедился, что модель считает на твоём железе
- Открой Activity Monitor: на Маке через Программы → Утилиты, на Windows - через Ctrl+Shift+Esc что увидишь: список процессов и занятую память в реальном времени, найди строку с работающей моделью. Что это даёт: понятно, сколько ресурсов машины уходит на ИИ прямо сейчас
Вот как это выглядит у меня во время работы модели, в программе Activity Monitor - на Маке она же «Мониторинг системы»
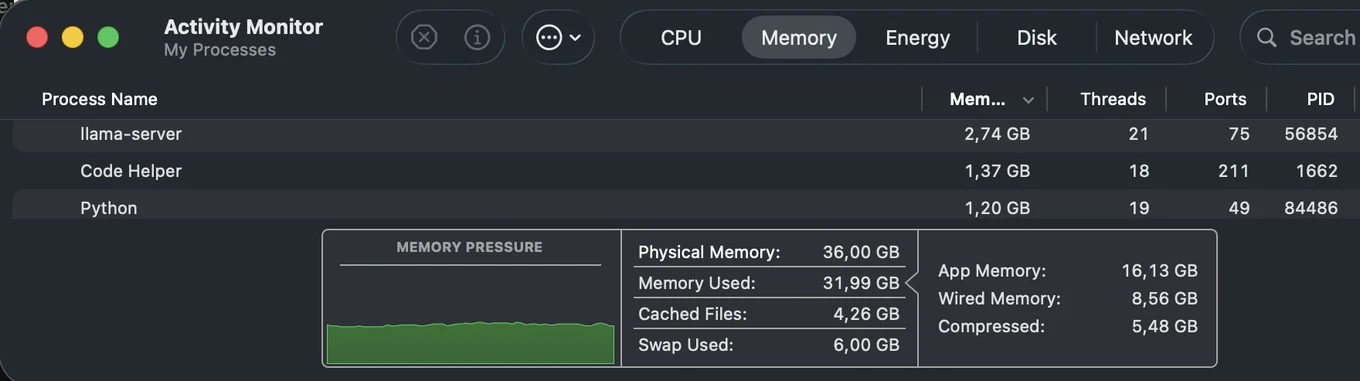
llama-server держит 2,74 ГБ, полоса давления памяти зелёная. Своп 6 ГБ на снимке - след долгого рабочего дня с другими программами, не самой модели: она целиком в оперативной памятиНе всё работает без сети, и честно сказать об этом важнее, чем красиво пообещать. По документации программы без интернета работают скачанные модели, разбор своих документов и внутренний обмен между программами на одной машине. Интернет нужен ровно для трёх вещей: искать новые модели в каталоге, скачивать их и обновлять саму программу
Мои замеры: сколько памяти и времени ест каждая модель
Цифры ниже сняты на одной машине в один день, поэтому их можно сравнивать между собой. Машина - MacBook на чипе M4 Max с 36 ГБ памяти, дата замера 20 августа 2026 года. Сам замер я снял через Ollama, а не через LM Studio - движок внутри тот же самый (llama.cpp), поэтому цифры честно переносятся на программу из шагов выше. Если будешь искать те же модели во вкладке Discover, они там подписаны иначе
| Модель | Файл на диске | Заняла в памяти | Скорость ответа |
|---|---|---|---|
| Qwen3 4B | 2,5 ГБ | 5,3 ГБ | 32,33 в секунду |
| Qwen2.5 Coder 3B | 1,9 ГБ | 2,8 ГБ | 90,18 в секунду |
Таблица прокручивается вбок →
Скорость меряют в токенах в секунду. Токен - это кусочек слова примерно в два-три знака, то есть 30 токенов в секунду читаются глазом как «печатает чуть быстрее человека»
Развёрнутый ответ на 751 токен модель qwen3:4b выдала за 23,226 секунды, полный прогон занял 23,619 секунды. Модель поменьше на коротком ответе уложилась в 2,641 секунды целиком. Обе шли на видеокарте на сто процентов, окно памяти было 32 768 - этого хватает на разговор длиной с небольшую статью
Место на диске расходуется быстрее, чем ожидаешь. После нескольких скачиваний каталог моделей у меня весил 4,2 ГБ, крупнейшие файлы внутри - 2,3 ГБ и 1,8 ГБ. Свободного места на диске оставалось 59 ГБ, и это тот запас, при котором можно спокойно пробовать разные модели, не выбирая между ними
Практический вывод из обеих строк таблицы простой. Модель поменьше отвечает втрое быстрее и занимает вдвое меньше памяти, но заметно проще в рассуждениях. Для коротких задач - переписать письмо, объяснить незнакомое слово, разобрать таблицу - маленькой хватает с запасом, и именно её стоит ставить первой
Картинки на своём компьютере: с чего начать
Картинки локально рисуются так же буднично, как пишется текст, и на Маке это вообще одно приложение из магазина. Программа называется Draw Things, и она бесплатная
Первая картинка на Маке
- Найди Draw Things в App Store и нажми «Загрузить» что увидишь: обычная установка из магазина, приложение весит 279,2 МБ. Что это даёт: рисовалка появится в списке программ, ничего настраивать не нужно
- Открой программу и выбери модель в поле Model что увидишь: список моделей, часть скачается при первом выборе. Что это даёт: ты решаешь, в каком стиле и с каким качеством будут кадры
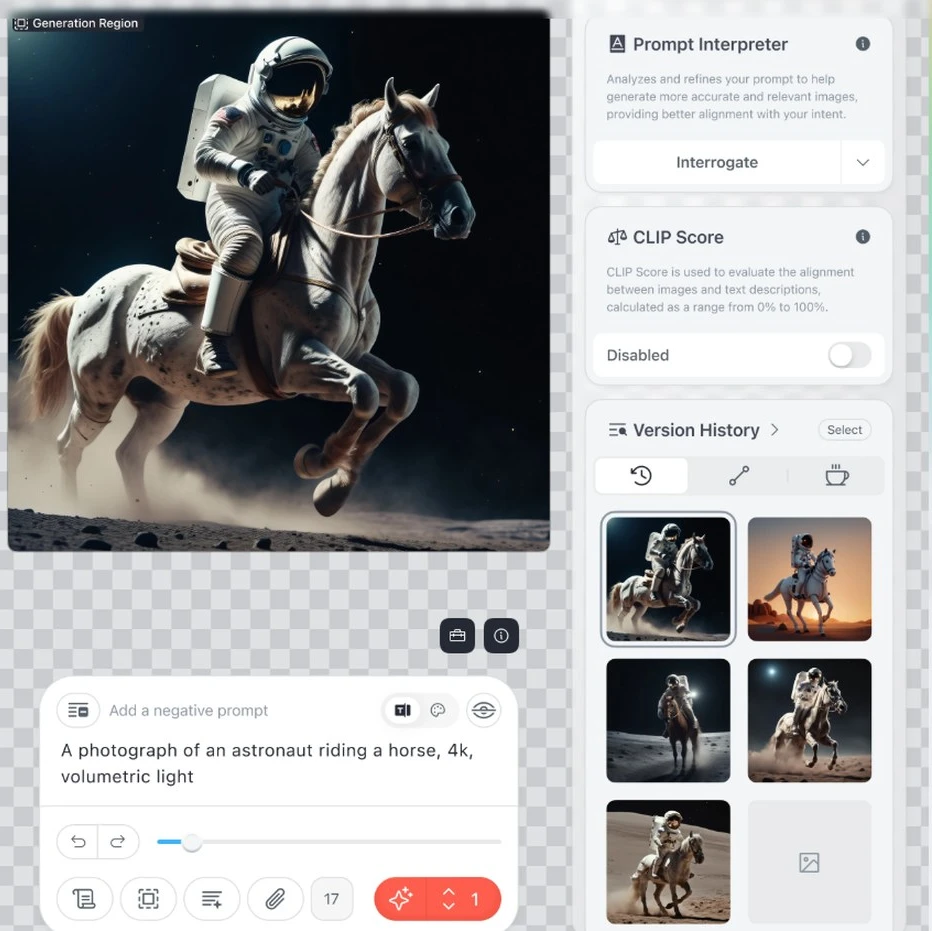
- Опиши картинку словами в поле внизу и нажми кнопку генерации что увидишь: кадр появится в центре окна через несколько секунд, а его копия уйдёт в ленту справа. Что это даёт: своя картинка без подписки и без лимита на число попыток
Разработчик обещает офлайн прямым текстом: в описании приложения написано «Create art 100% offline», то есть картинки создаются полностью без интернета, а описания и результаты остаются на устройстве. Требования тоже скромные: macOS 12.4 и новее
На Windows одной кнопкой не обойдётся, но и там путь стал человеческим. Программа Stability Matrix ставит нужные рисовалки за тебя: в её описании это названо «One click install and update», установка в один клик. Отдельно ставить язык программирования и служебные части не надо, они уже вшиты внутрь - для новичка это главный пункт, потому что именно на этом месте люди обычно и бросают
Какие модели рисуют картинки локально. Их три поколения, и разница ощутимая
| Модель | Что даёт | Чем расплачиваешься |
|---|---|---|
| Stable Diffusion 1.5 | пойдёт почти на любой машине, море готовых стилей | качество заметно уступает свежим моделям |
| Stable Diffusion XL | картинка крупнее и чище, 3 миллиарда параметров | нужна машина покрепче |
| FLUX.1 schnell | лучший результат из свободных, хватает 1-4 проходов | 12 миллиардов параметров, файл тяжёлый |
Таблица прокручивается вбок →
У FLUX.1 schnell лицензия apache-2.0, и это важнее, чем кажется: она разрешает и личное, и коммерческое использование, то есть картинки для своего магазина или клиента делать можно. Мелкие модели вроде Stable Diffusion 1.5 остаются рабочим вариантом для слабых машин, а на совсем скромном железе спасает выгрузка части расчёта на обычный процессор - способ описан в карточке самой модели
Тем, кто хочет собрать себе цепочку посложнее (взял кадр, дорисовал деталь, поменял фон), стоит смотреть в сторону ComfyUI: там есть настольное приложение, а список поддерживаемых моделей для картинок и видео - самый длинный на рынке
Видео на своём компьютере: где проходит честная граница
Видео локально уже делается, но именно здесь домашняя машина упирается в потолок первой. Цифры лучше знать заранее, чем разочароваться после трёх часов установки
Лучшая свободная модель для видео сегодня - Wan 2.2. У неё есть облегчённая версия на 5 миллиардов параметров, и разработчики прямо пишут, чего она требует
«This command can run on a GPU with at least 24GB VRAM (e.g, RTX 4090 GPU)»
Wan-Video, README проекта Wan 2.2, раздел про запуск на одной видеокарте, обращение 20.08.2026
24 гигабайта видеопамяти - это отдельная дорогая видеокарта уровня RTX 4090, а не встроенная графика ноутбука. И скорость соответствующая: пятисекундный ролик в разрешении 720p та же модель считает меньше девяти минут на такой карте. Старшие версии этой же модели требуют 80 гигабайт видеопамяти, то есть дома их нет ни у кого
| Задача | Домашняя машина | Что делать |
|---|---|---|
| Текст, переписка, разбор документов | тянет почти любая | ставить локально, это решённый вопрос |
| Картинки | тянет средняя и выше | ставить локально, на Маке вообще одним приложением |
| Короткое видео | нужна отдельная видеокарта на 24 ГБ | считать заранее, стоит ли игра свеч |
| Длинное видео в высоком качестве | не тянет никакая домашняя | делать в облаке поштучно |
Таблица прокручивается вбок →
Вывод по видео честный: если у тебя нет мощной игровой видеокарты, локальную генерацию видео стоит отложить и не тратить вечер на установку. Текст и картинки при этом работают у всех, и начинать имеет смысл именно с них
Сколько это экономит: тот же объём работы в облаке
Экономия считается не подпиской, а поштучно, и так честнее: локально ты платишь один раз электричеством и временем скачивания, в облаке - за каждый результат
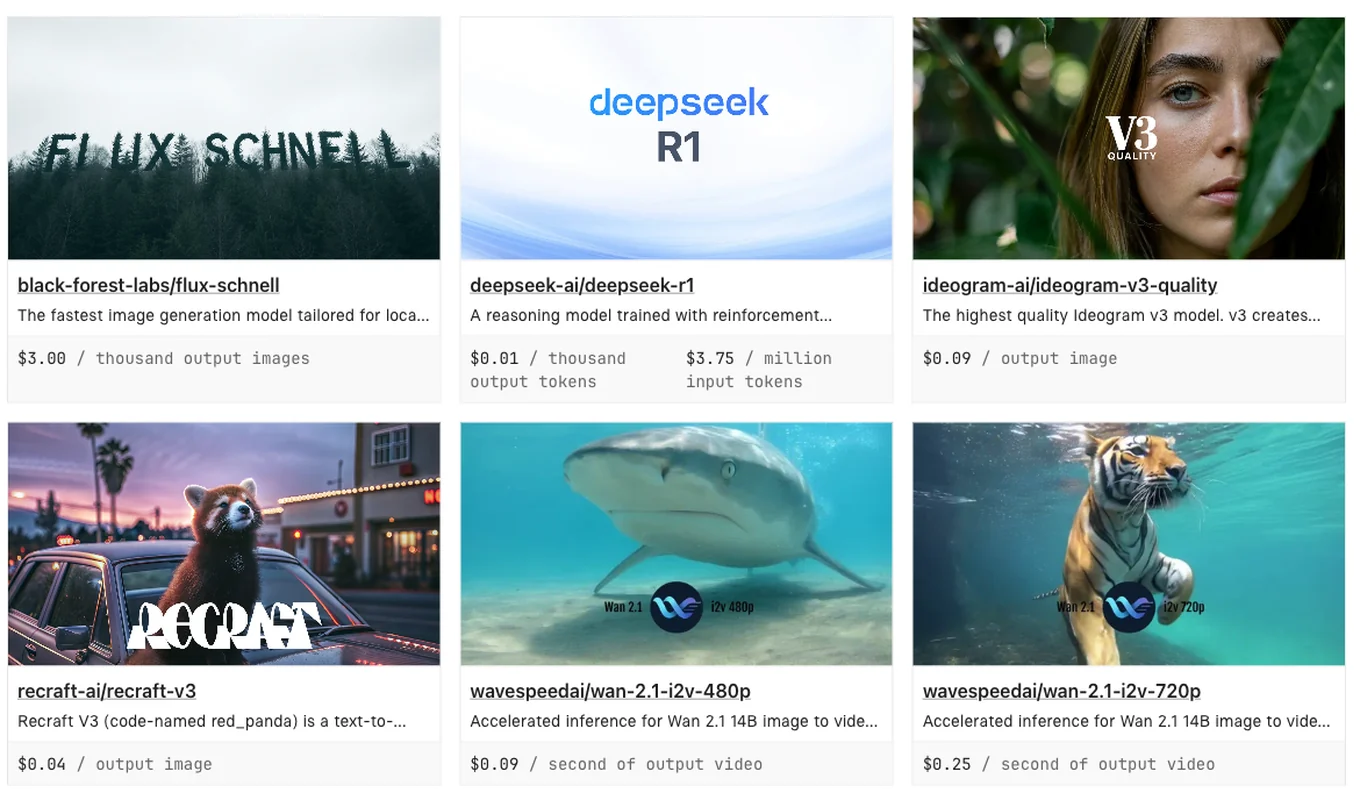
Возьмём открытый прайс площадки, где та же модель FLUX.1 schnell - та самая, которую я советую ставить локально, - крутится на чужих мощностях. Картинка обходится в 3 доллара за тысячу штук, то есть 0,003 доллара за один кадр. Ideogram v3 Quality возьмёт 0,09 доллара за штуку, Recraft V3 - 0,04 доллара. Секунда готового видео моделью Wan 2.1 в разрешении 480p обойдётся в 0,09 доллара, в 720p - в 0,25 доллара
Личного счёта за месяц по картинкам у меня нет: полного журнала генераций в Draw Things я не вёл, а придумывать цифру за месяц - нечестнее, чем её не иметь. Зато есть точный счёт по конкретному прогону, а не оценка на глаз: кадр с космонавтом на коне для этой же статьи (скриншот рисовалки выше) я сгенерировал ровно 5 раз, и все 5 версий видны в ленте истории на самом скриншоте - ни одна не выброшена и не пересчитана задним числом. По прайсу flux-schnell 0,003 доллара за кадр эти же 5 кадров в облаке стоили бы 1,5 цента, локально - ровно ноль. И по тексту счёт тоже есть, потому что оба диалога дня замера залогированы построчно: 20 августа 2026 года у qwen3:4b вышло 39 токенов на входе и 751 на выходе, у qwen2.5-coder:3b - 58 на входе и 28 на выходе, полный разбор по секундам - в разделе с замерами выше
Перевожу эти же токены в доллары, чтобы получился настоящий счёт, а не только «локально бесплатно»: по прайсу LM Studio на облачные кредиты модель DeepSeek V4 Flash берёт 0,13 доллара за миллион входных токенов и 0,26 доллара за миллион выходных. Оба диалога дня замера вместе обошлись бы в облаке в 0,02 цента. Локально - ровно ноль, потому что счётчика нет вообще
Дальше - уже не свой счёт, а голая арифметика по прайсу другой модели, той, что сам советую ставить локально для картинок: 0,003 доллара за картинку означают, что двести кадров стоят 60 центов, а не пять долларов, как выходило бы по более дорогой FLUX Dev. Локально те же двести кадров стоят ровно ноль, потому что счётчика нет вообще. Для масштаба, не как замер: дизайнер, который перебирает варианты обложки, легко делает такие двести кадров за один вечер - половина уходит в мусор, из остального выбирают. По прайсу модели, что рекомендую, это 60 центов за вечер, и так каждый раз заново
С видео разрыв нагляднее в любом случае. Минута готового ролика - это шестьдесят секунд, и по цене 0,09 доллара за секунду выходит 5,4 доллара за минуту в низком разрешении. В 720p та же минута по 0,25 доллара за секунду стоит 15 долларов. Правда, здесь и оговорка честная: чтобы считать это дома, нужна видеокарта, которая сама стоит как несколько лет такой подписки
Когда локальная модель проигрывает облаку
Проигрывает она в трёх местах, и делать вид, что этого нет, бессмысленно
Качество на сложных задачах. Модель на 4 миллиарда параметров и модель на несколько сотен миллиардов - это разные весовые категории. Локальная отлично перепишет письмо и объяснит термин, но на длинном юридическом разборе или сложном коде разница станет заметной сразу
Знание свежих событий. Файл модели зафиксирован в момент выпуска. Что случилось на прошлой неделе, он не знает и знать не может, пока ты не скачаешь новую версию
Скорость на слабом железе. Если модель не помещается в память целиком, компьютер начинает подкладывать её кусками с диска, и ответ вместо секунд занимает минуты. Тут не помогает ничего, кроме модели поменьше
Разумный расклад - держать оба варианта. Мелочь, черновики, личные документы и всё, что не хочется отдавать наружу, - на своей машине. Сложное и срочное - в облаке. Если платить за облако пока не хочется совсем, есть отдельный разбор про бесплатные замены платному софту, там собраны варианты без карты
Частые затыки новичка
Четыре места, где чаще всего спотыкаются, и что делать в каждом
- Модель скачалась, но не запускается. Почти всегда дело в размере: файл больше свободной памяти. Если в окне появилась ошибка загрузки модели - выбери версию поменьше, разница в качестве на простых задачах почти не чувствуется
- Ответы приходят по одному слову в несколько секунд. Это признак того, что модель не влезла целиком и считается урывками. Если после смены на модель поменьше скорость выросла - причина была именно в этом, ничего чинить не надо
- Диск неожиданно кончился. Модели копятся незаметно, каждая по несколько гигабайт. Загляни в раздел «My Models» внутри программы и удали те, которыми не пользуешься: файлы удаляются оттуда же, где скачивались
- Картинки получаются мутными и кривыми. У локальных рисовалок за качество отвечает число проходов и выбранная модель. Если после смены на FLUX.1 schnell картинка стала чище - дело было в модели, а не в описании. Если не стала - подробнее опиши сцену словами, короткая фраза даёт случайный результат
Что меняется, когда модель живёт у тебя
Меняется не цена, а поведение. Пока каждый вопрос стоит денег, ты его взвешиваешь: точно ли надо переспрашивать, точно ли стоит пробовать пятый вариант формулировки
Когда счёта нет, взвешивание пропадает. Ты гоняешь двадцать вариантов подряд, выбрасываешь восемнадцать и оставляешь два, и рука набивается на порядок быстрее. Это работает и с текстом, и с картинками: цена ошибки падает до нуля, а вместе с ней падает страх пробовать
Есть и вторая перемена, менее очевидная. Документы, договоры, личные заметки и переписку становится не страшно показывать модели, потому что показывать их некому: файл лежит на твоём диске и отвечает твой же процессор
Источники
- LM Studio, системные требования приложения - версии систем, рекомендованный объём памяти и видеопамяти. Обращение 20.08.2026
- LM Studio, как найти и скачать модель - вкладка Discover, сочетания клавиш, рекомендация про 4 бита. Обращение 20.08.2026
- LM Studio, работа без интернета - что работает офлайн, а для чего нужна сеть. Обращение 20.08.2026
- LM Studio, страница тарифов - бесплатный локальный запуск «$0», облачные кредиты DeepSeek V4 Flash по 0,13 доллара за миллион входных и 0,26 доллара за миллион выходных токенов. Обращение 20.08.2026
- Ollama, страница модели Gemma 3 - размеры файлов от 292 МБ до 17 ГБ. Обращение 20.08.2026
- Draw Things, карточка приложения в App Store - цена, размер 279,2 МБ, требование macOS 12.4, обещание полного офлайна. Обращение 20.08.2026
- LykosAI, описание проекта Stability Matrix - установка рисовалок в один клик, вшитые служебные части. Обращение 20.08.2026
- Wan-Video, описание проекта Wan 2.2 - 24 ГБ видеопамяти на облегчённую версию, 80 ГБ на старшие, пять секунд видео меньше чем за девять минут. Обращение 20.08.2026
- Black Forest Labs, карточка модели FLUX.1 schnell - лицензия apache-2.0, 12 миллиардов параметров, 1-4 прохода на картинку. Обращение 20.08.2026
- Stability AI, карточка модели Stable Diffusion XL - 3 миллиарда параметров, выгрузка расчёта на процессор для слабых машин. Обращение 20.08.2026
- Replicate, публичный прайс - цена за картинку и за секунду видео у открытых моделей. Обращение 20.08.2026
- Comfy, страница проекта ComfyUI - настольное приложение и список поддерживаемых моделей. Обращение 20.08.2026
Памятка: локальная нейросеть за вечер
Семь строк, по которым видно, что всё действительно стоит и работает
Сохрани себе
- Объём памяти машины посмотрен, верхняя планка по размеру файла модели известна
- Свободного места на диске не меньше 10 ГБ под файлы моделей
- Программа с окном установлена и открывается, чёрных окон с командами не понадобилось
- Модель выбрана по своей памяти, вариант сжатия 4 бита или выше, файл скачан
- Модель загружена в память, первый вопрос задан, ответ получен
- Wi-Fi выключен, второй вопрос задан, ответ пришёл так же - значит всё считается локально
- Для картинок выбрана своя дорожка: приложение из магазина на Маке или установщик в один клик на Windows
Порог входа
Три дня, бесплатно, начать можно сегодня
Ставить ничего не надо: всё, что нужно для старта, у тебя уже стоит после этой статьи
Заходить можно прямо сегодня, ждать набора и даты не нужно
Это заявка в мой закрытый канал, не оплата. Впускаю сразу, дальше бот в личке отдаёт путёвку на три дня
Частые вопросы
Можно ли запустить нейросеть на слабом ноутбуке без видеокарты?
Да, и это самый частый случай. Без видеокарты модель считает обычным процессором - медленнее, но работает. Бери самые лёгкие модели: рабочие версии начинаются с 292 МБ, а на 8 ГБ памяти спокойно живёт файл до 3 ГБ. Ответ будет приходить не мгновенно, зато бесплатно и без интернета
Какая локальная нейросеть лучше для генерации изображений?
Из свободных моделей лучший результат сегодня даёт FLUX.1 schnell: ей хватает от одного до четырёх проходов на кадр, а лицензия apache-2.0 разрешает и коммерческое использование. Если машина слабая, начинай со Stable Diffusion 1.5 - она пойдёт почти везде и к ней собрано больше всего готовых стилей
Можно ли делать видео нейросетью на домашнем компьютере?
Можно, но только на отдельной мощной видеокарте. Облегчённой версии Wan 2.2 нужно 24 ГБ видеопамяти, и на такой карте пять секунд ролика в 720p считаются меньше девяти минут. Старшим версиям той же модели требуется 80 ГБ, дома столько не бывает. Без игровой видеокарты видео проще делать в облаке поштучно
Сколько места на диске занимают локальные модели?
Одна текстовая модель - от 292 МБ до 17 ГБ в зависимости от размера. У меня после нескольких скачиваний каталог моделей занимал 4,2 ГБ. Закладывай минимум 10 ГБ свободного места: пробовать одной моделью обычно не выходит, а модели для картинок весят ещё больше
Локальная нейросеть правда ничего не отправляет в интернет?
Правда, и это проверяется за десять секунд: выключи Wi-Fi и задай вопрос, ответ придёт как обычно. Я проверял глубже - снял все сетевые соединения работающих программ во время генерации, наружу не ушло ни одного. Интернет нужен только чтобы найти и скачать модель, дальше она твоя
Это бесплатно совсем или где-то есть подвох?
Совсем. Программа для запуска бесплатна для личного использования, модели с открытой лицензией раздаются бесплатно, лимита на число вопросов нет. Платишь только электричеством и местом на диске. Деньги начинаются там, где ты сознательно уходишь на облачные мощности за качеством, которого домашняя машина не даёт
Читайте также
Как установить Ollama: 4 шага и выбор модели по памяти
Движок для локальных моделей без окна, установка по шагам и выбор модели по памяти
10 опенсорс-инструментов вместо платных ИИ-подписок
Откуда берутся свободные модели и чем они заменяют платные подписки
Claude Code бесплатно: 11 находок вместо платного софта
Что ставить, когда своя машина не тянет задачу, а платить пока не хочется