Разбор · нейросети · август 2026
Галлюцинации нейросетей 2026: почему ИИ выдумывает и 5 признаков
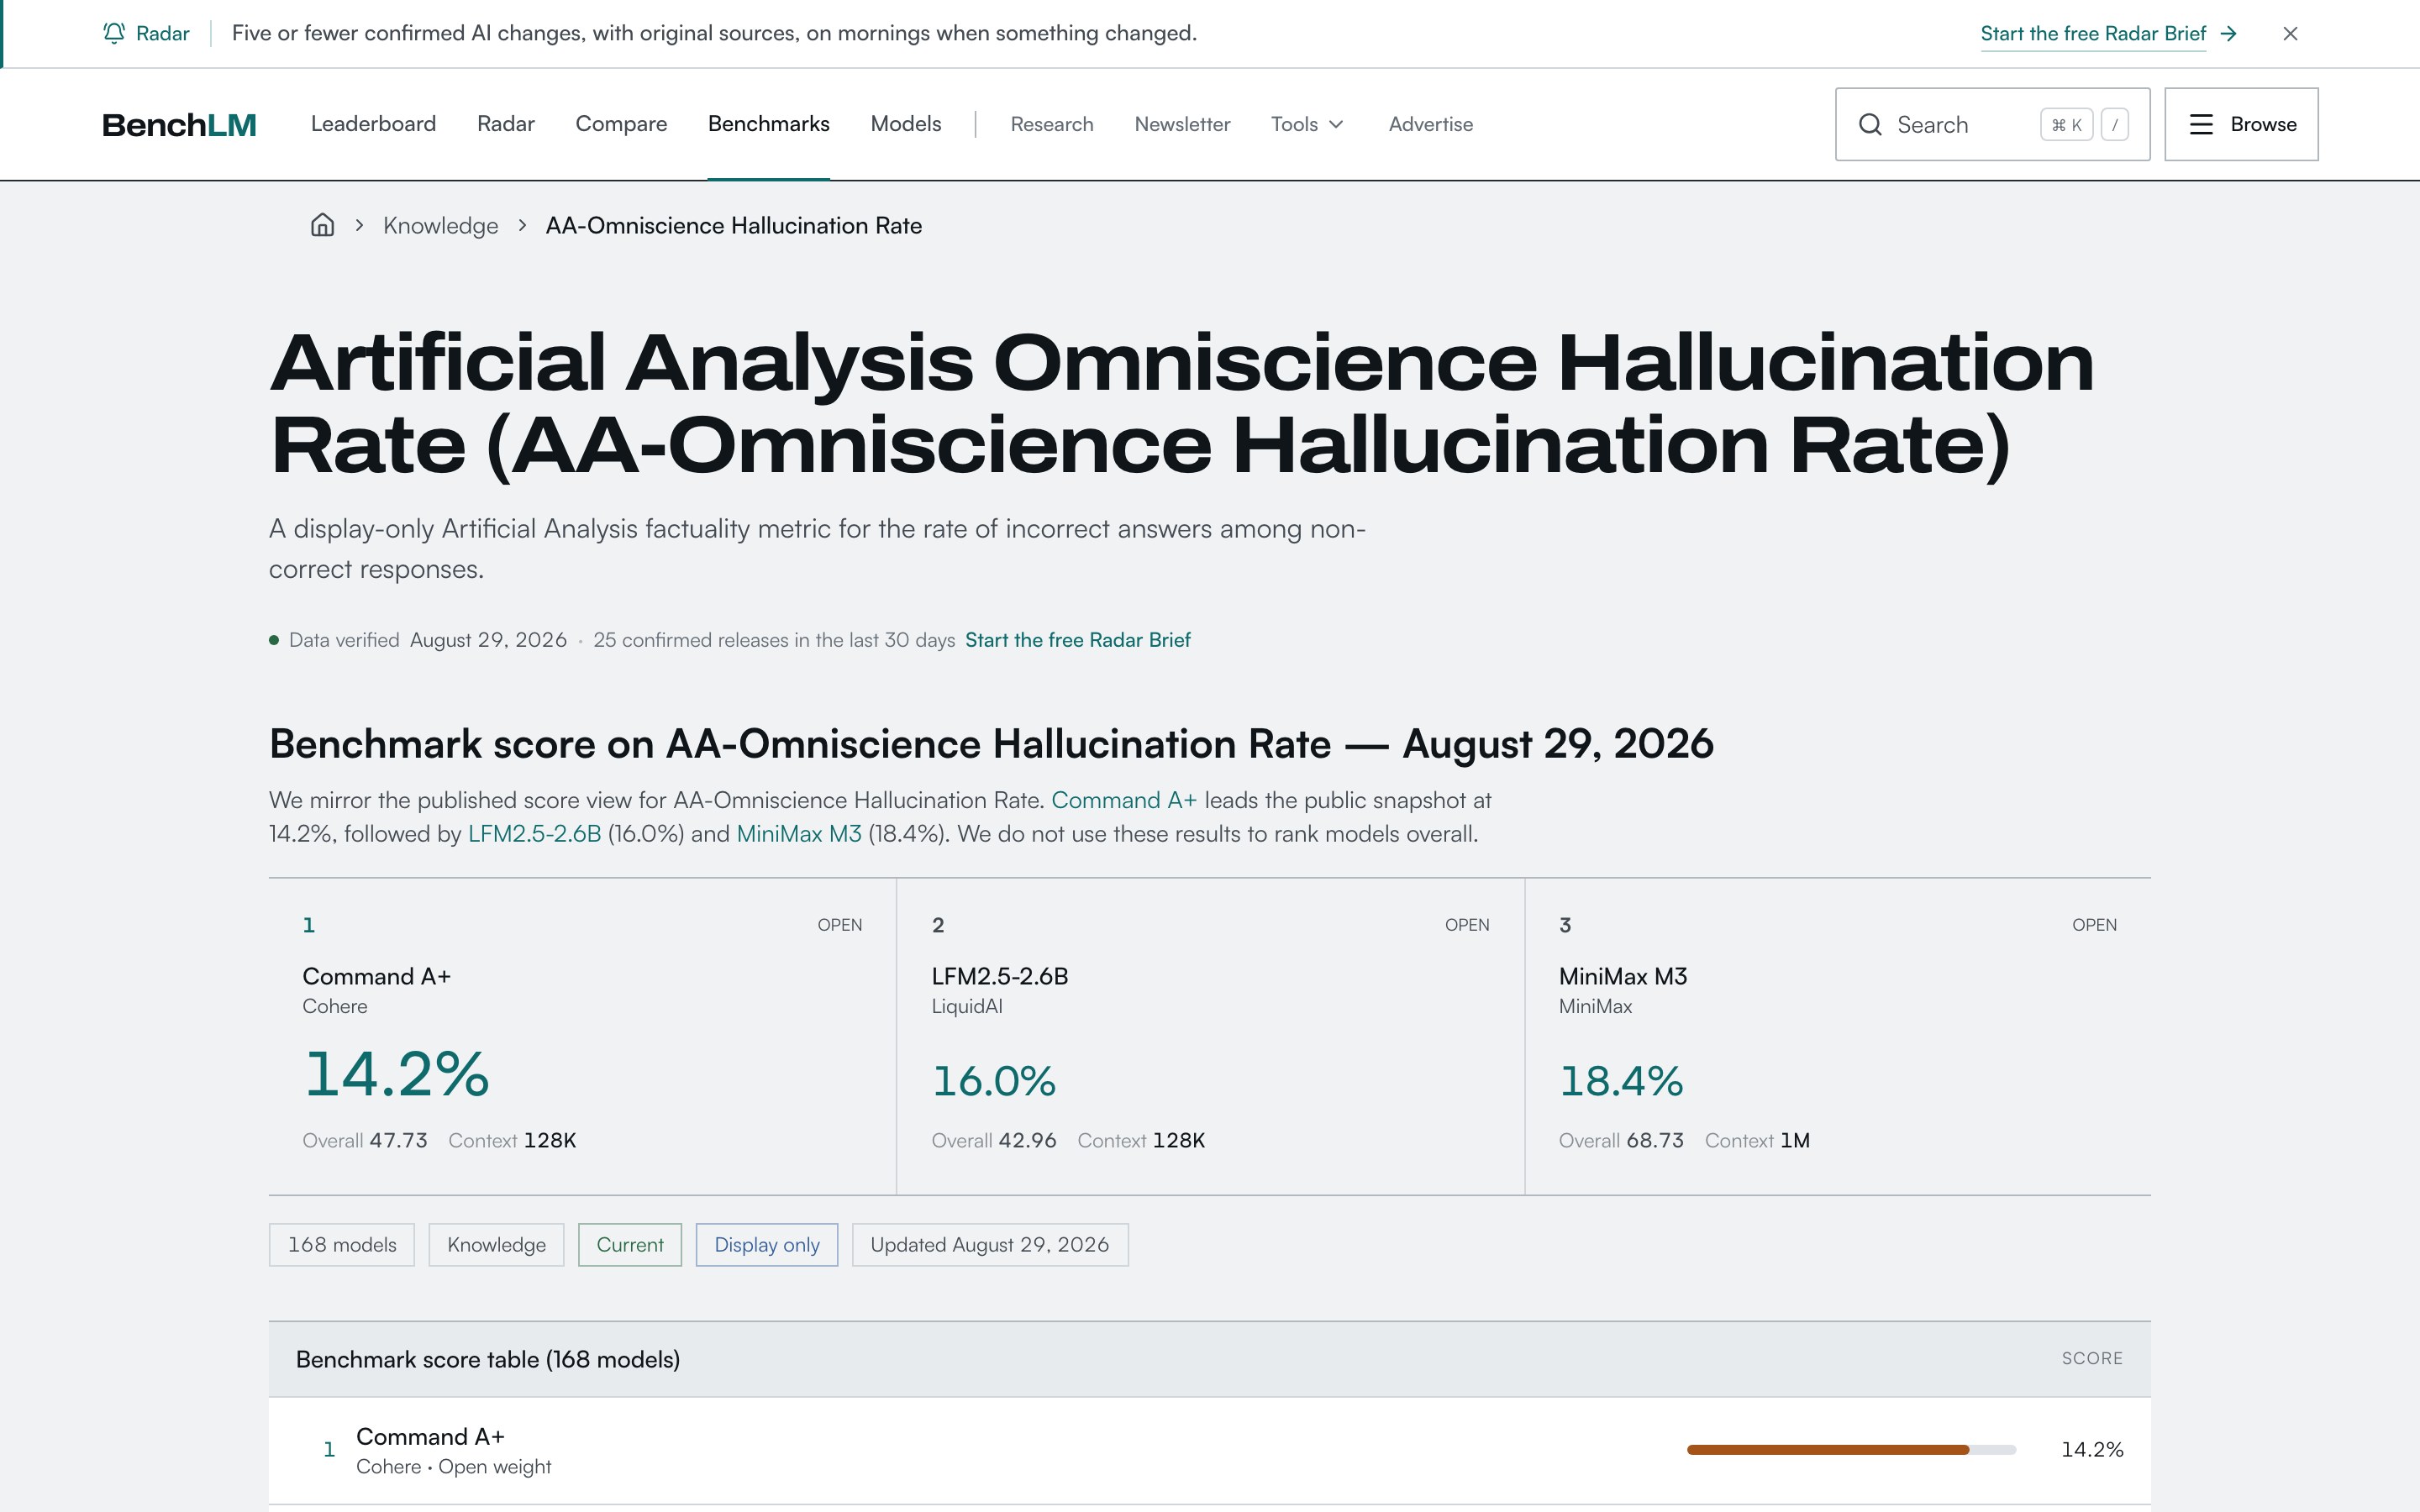
29 августа 2026 года открытый лидерборд обновил замер по 168 моделям: у первого места доля уверенных выдумок 14,2 процента, у второго 16,0, у третьего 18,4. Считается доля неверных ответов среди тех, где машина не ответила правильно, и даже у лучшей это примерно каждый седьмой случай
Дальше разбираю не устройство моделей, а то, что из этих чисел следует для человека, который просто спрашивает у нейросети и хочет пользоваться ответом. Пять признаков выдумки и шесть приёмов проверки, каждый на две минуты
Открой ответ, которым собираешься пользоваться, и найди в нём три вещи: имя источника, дату и ссылку, по которой можно перейти. Нет хотя бы одной - пиши в тот же чат «откуда это, дай ссылку» и открывай сам. Две минуты такой проверки закрывают почти все случаи, где машина сочинила
Что случилось 29 августа 2026 года
Открытый замер, который сравнивает модели по честности, обновил таблицу. Первое место занял Command A+ компании Cohere с показателем 14,2 процента, второе LFM2.5-2.6B с 16,0, третье MiniMax M3 с 18,4. Всего в таблице 168 моделей
Что именно измеряют: долю неверных ответов среди тех случаев, где модель не дала правильный ответ. Проще так: машина либо отвечает верно, либо честно говорит «не знаю», либо уверенно выдаёт неправду. Процент в таблице - про третью корзину. Чем он ниже, тем чаще машина молчит вместо того, чтобы сочинять
Что отдала страница замера на моём прогоне 30.08.2026
- Data verified August 29, 2026 - дата, на которую сверены числа
- Command A+ (Cohere) 14.2% - первое место
- LFM2.5-2.6B (LiquidAI) 16.0% - второе
- MiniMax M3 (MiniMax) 18.4% - третье
- Benchmark score table (168 models) - размер таблицы
Что это тебе даёт: цифра «каждый седьмой» перестаёт быть страшилкой из интернета и становится основанием для привычки проверять. Причём проверять не иногда, а каждый раз, когда ответом собираешься пользоваться
Что такое галлюцинация простыми словами
Галлюцинация - это уверенный ответ, который звучит правильно, а фактам не соответствует. Не ошибка в вычислении и не опечатка: машина выдаёт несуществующее так же спокойно, как существующее
Ближайшая житейская аналогия - человек, который не хочет выглядеть глупо. Ему задали вопрос при свидетелях, точного ответа он не знает, но молчать неловко, и он говорит уверенным тоном первое правдоподобное. Разница в том, что у человека при этом бегают глаза, а у машины интонация ровно та же, что и в правильном ответе
Поэтому опасна не сама выдумка, а её упаковка. Ответ приходит гладким, с подробностями, иногда с номерами и датами. Именно подробности и создают ощущение, что это проверенное знание
Что это тебе даёт: перестаёшь читать уверенность как признак правоты. Уверенный тон в ответе машины не значит ничего, это просто её обычная манера речи
Почему машина выдумывает: три причины
Причина первая, устройство. Языковая модель не хранит факты как справочник. Она подбирает следующее слово, которое статистически хорошо продолжает предыдущие. Правдоподобие и правда для такой сборки - не одно и то же, и там, где данных не хватило, правдоподобие побеждает
Причина вторая, поощрение. Разбор OpenAI 2025 года объясняет это прямо: обучение и тесты вознаграждают угадывание больше, чем честное «не знаю». В таблицах результатов уверенный неверный ответ и признание незнания стоят одинаково - ноль баллов. При таком счёте рациональная стратегия для модели одна: всегда стрелять, даже когда данных мало
Причина третья, вопрос. Формулировка, которая содержит ложную предпосылку, почти гарантирует выдумку. Спросишь «в каком году этот сервис ввёл бесплатный тариф», а тарифа не было никогда - машина назовёт год, потому что вопрос уже утверждает, что событие было
| Причина | Что происходит внутри | Что делать читателю |
|---|---|---|
| Устройство | подбирается правдоподобное продолжение, а не факт из справочника | не спрашивать то, что проверяется одним поиском |
| Поощрение | угадывание оценивается выше честного «не знаю» | прямо разрешить ответ «не знаю» в самом вопросе |
| Ложная предпосылка в вопросе | машина достраивает событие, которого не было | спрашивать «было ли», а не «когда было» |
Таблица прокручивается вбок →
Что это тебе даёт: три причины дают три разные привычки, и ни одна из них не требует разбираться в устройстве моделей
Дальше по этой теме идёт разбор Свой сервис вместо подписки в 2026 году
Как это выглядит в живом ответе
Ниже кадр открытого ИИ-поиска, снятый 30.08.2026. Вопрос обычный, про цену подписки. Смотри не на текст ответа, а на мелкие номера в квадратных скобках прямо в предложениях и на блок источников под ним
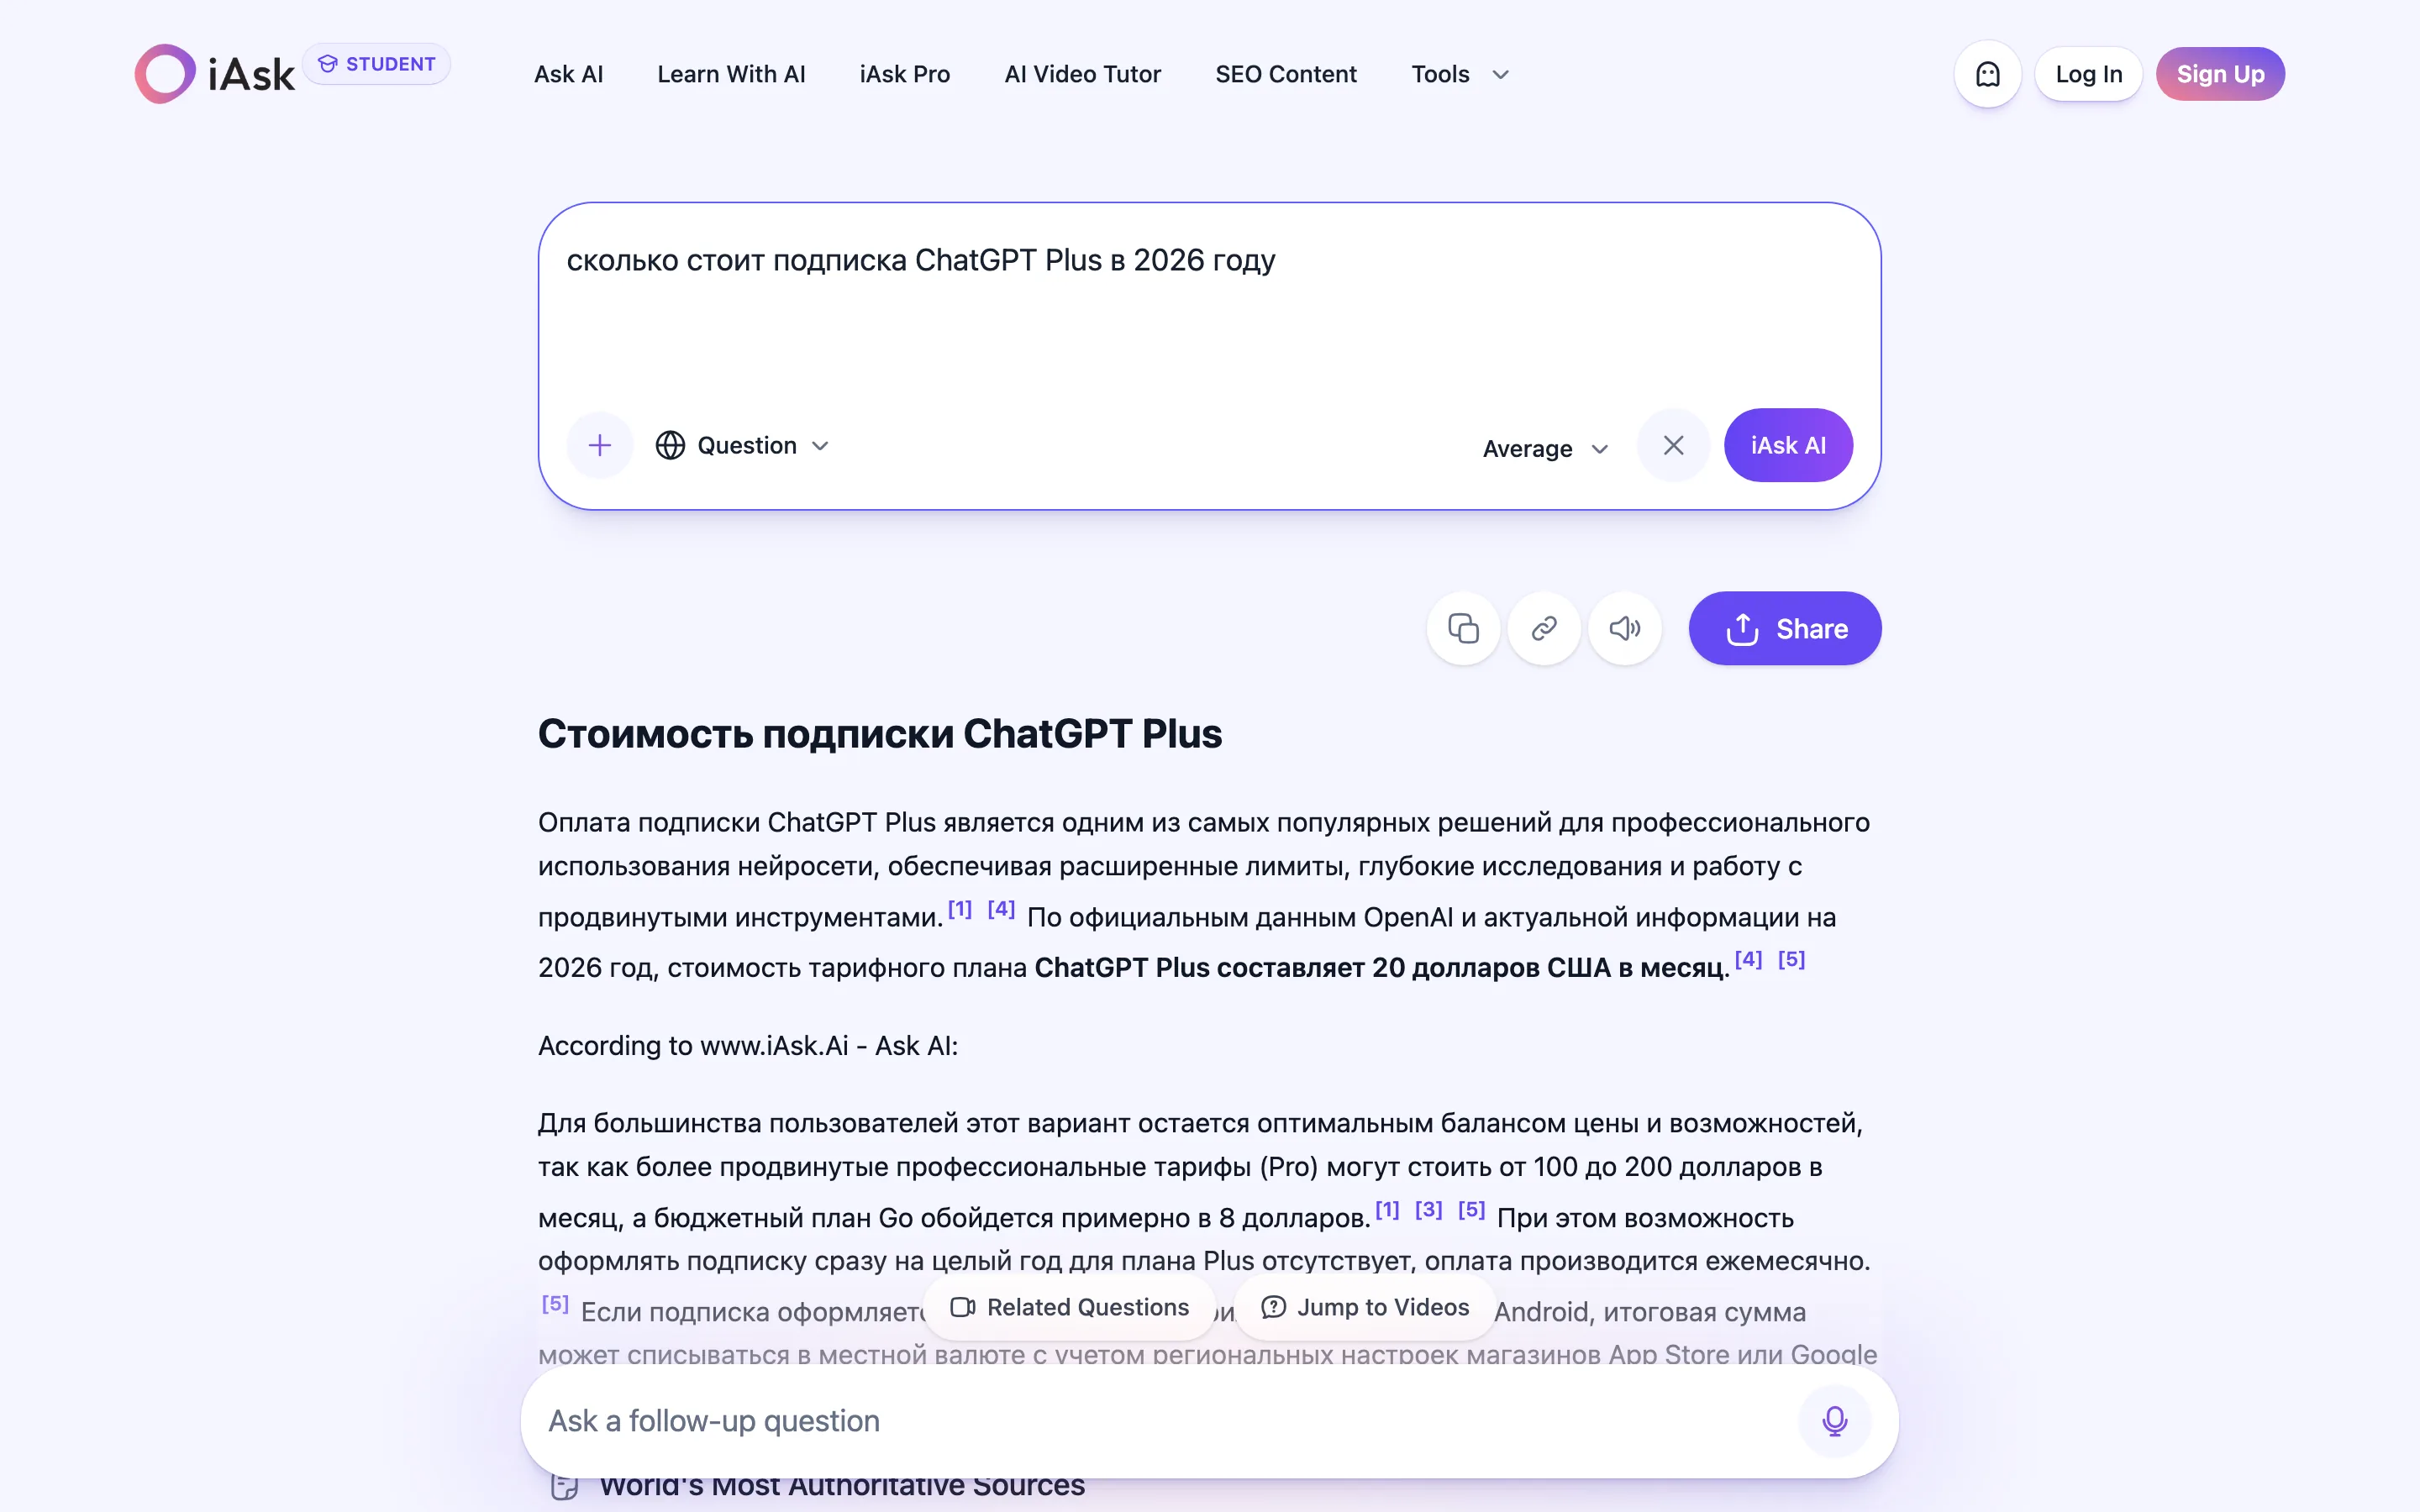
Куда нажать: на любой такой номер. Что увидишь: адрес страницы, откуда взято утверждение. Что это тебе даёт: возможность за десять секунд убедиться, что источник существует и говорит то же самое
Ответ без ссылок не означает, что он неверный. Он означает другое: у тебя нет способа отличить его от выдумки, кроме собственной памяти
Мой прогон: спросил про то, чего не существует
Проверку из пятого признака я прогнал сам 30.08.2026 и показываю результат как есть, а не как хотелось бы. Вопрос был про нейросеть «ГлюкоГПТ 7 Turbo» - такой модели не существует, я её выдумал прямо в строке запроса
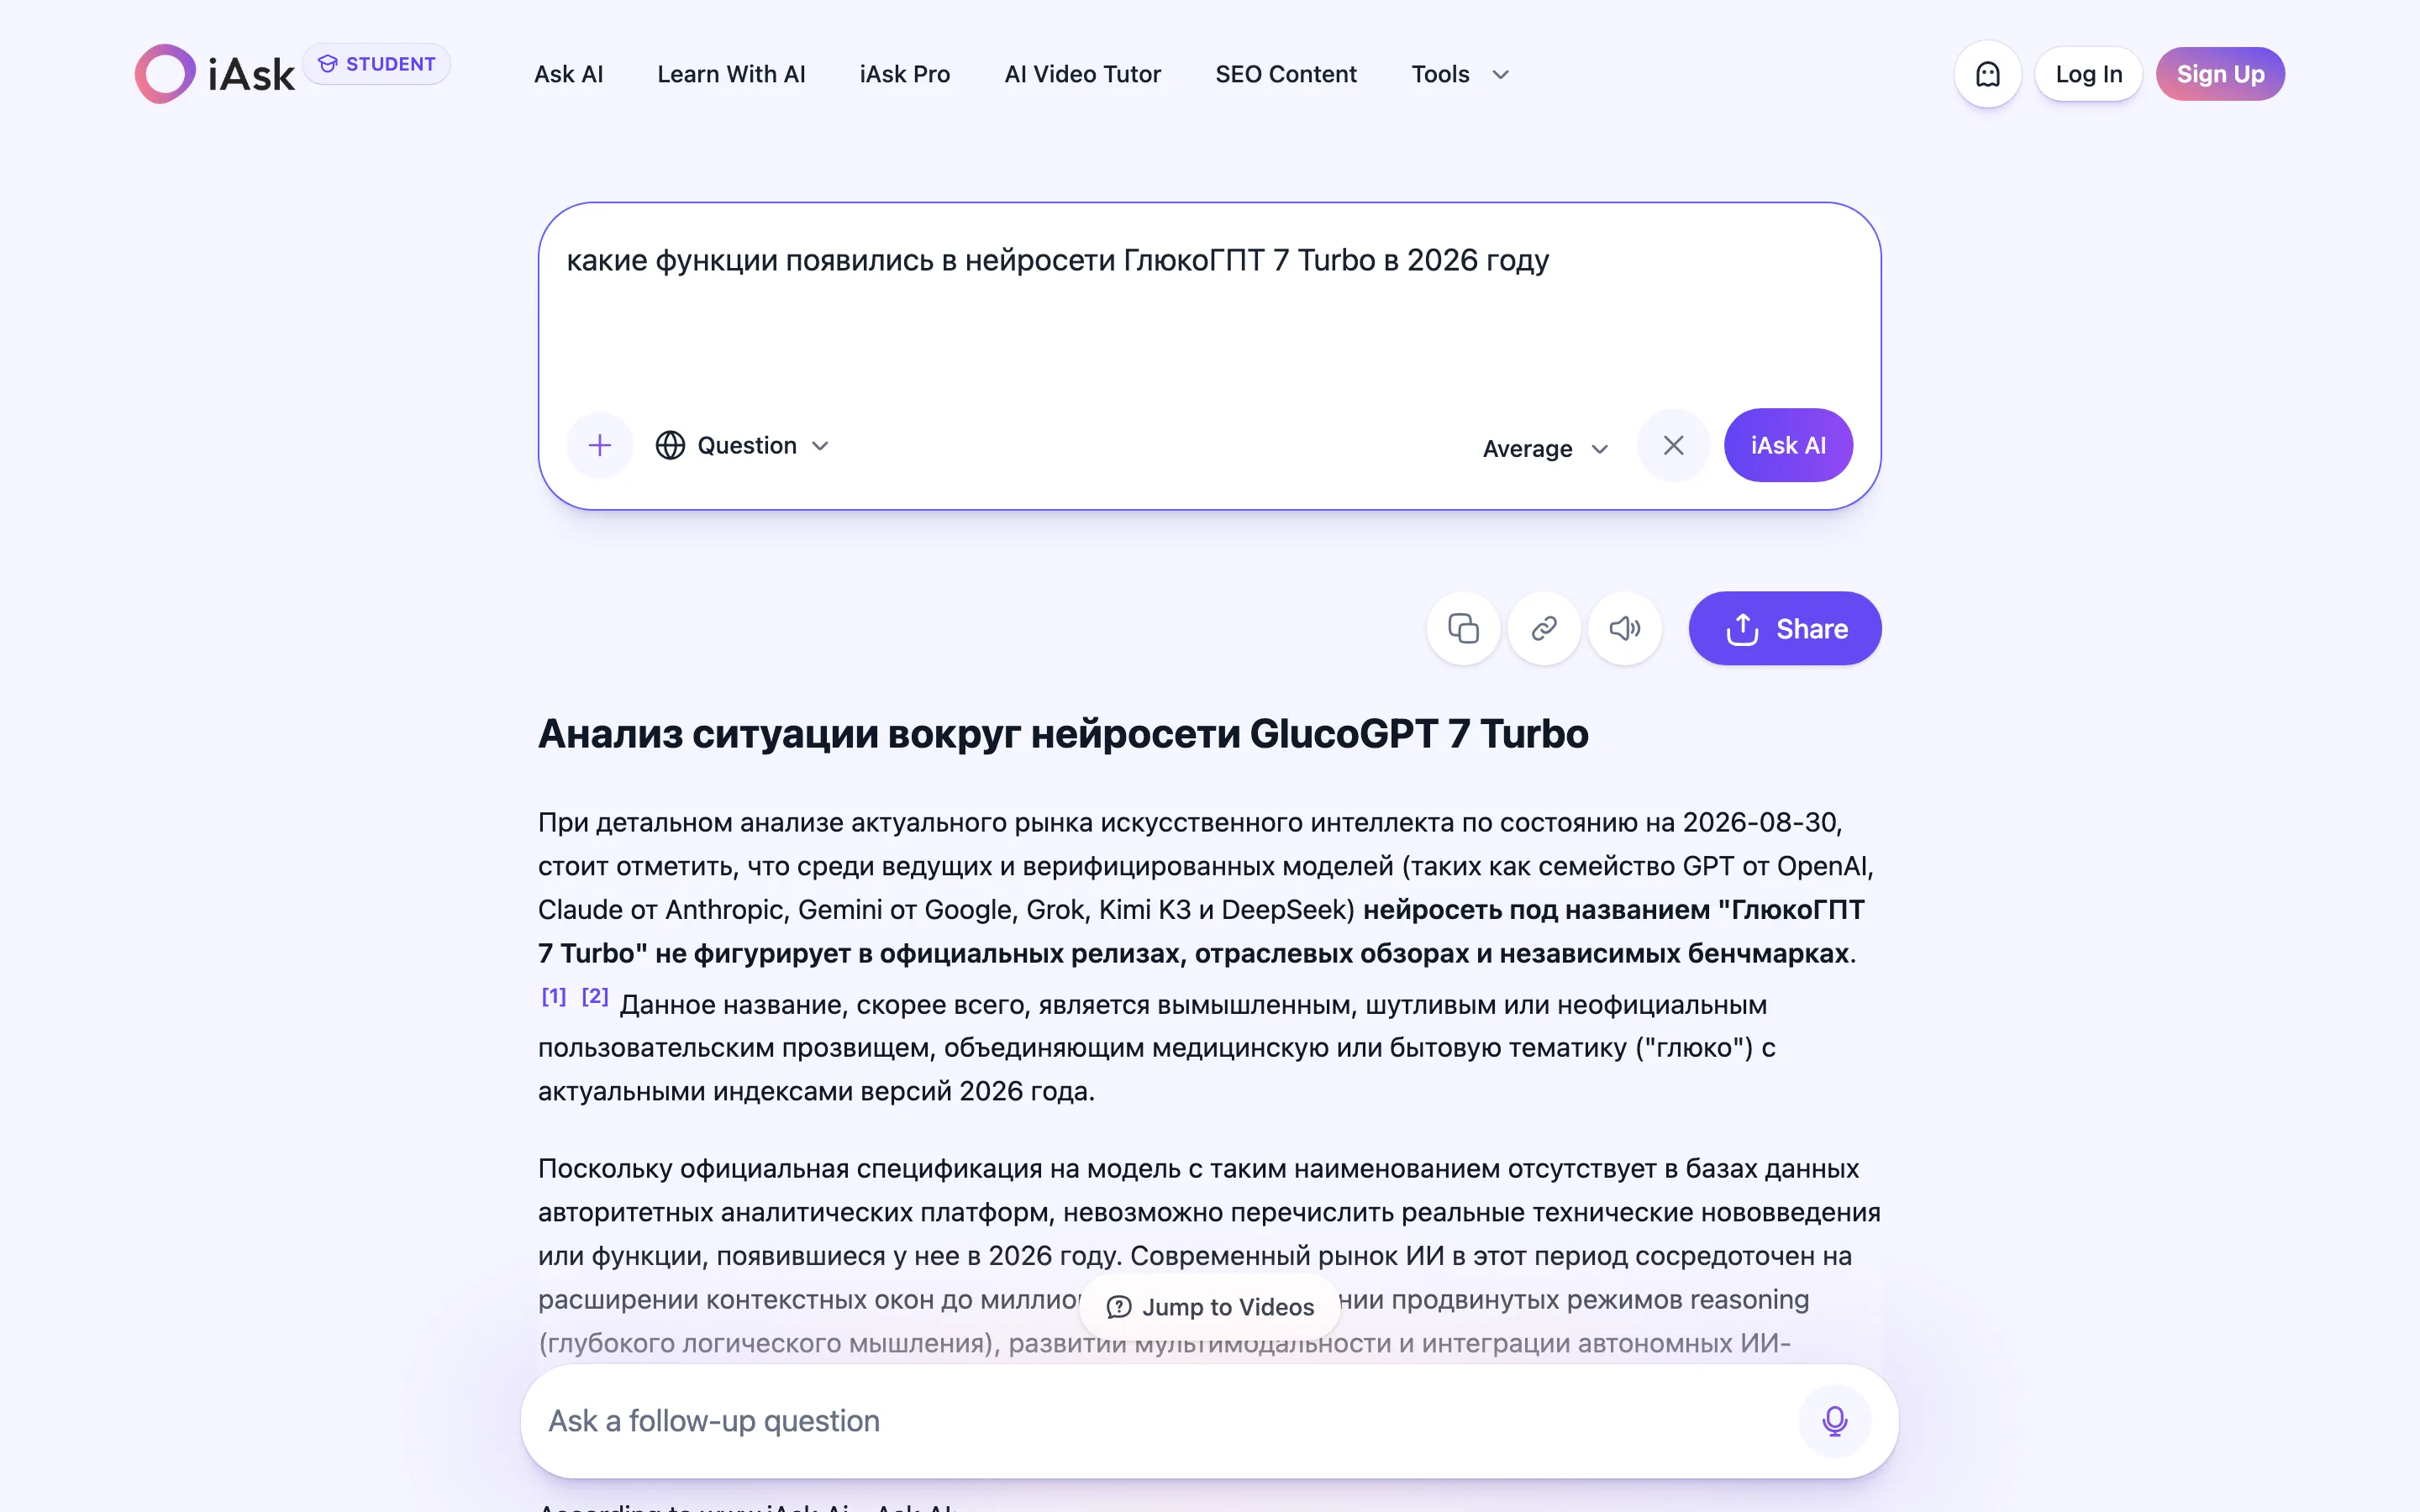
Что вернул мой прогон 30.08.2026, дословно с экрана
- вопрос: какие функции появились в нейросети ГлюкоГПТ 7 Turbo в 2026 году
- ответ: нейросеть под названием «ГлюкоГПТ 7 Turbo» не фигурирует в официальных релизах, отраслевых обзорах и независимых бенчмарках
- дальше: данное название, скорее всего, является вымышленным
- рядом с утверждением стоят номерные ссылки на источники
Куда нажать: открыть любой чат и вписать название, которого нет. Что увидишь: либо честное «такого не существует», либо связный рассказ про несуществующее. Что это тебе даёт: за минуту понимаешь, как ведёт себя конкретный инструмент, которым ты пользуешься каждый день
Важная деталь этого прогона: инструмент, который ходит в поиск и ставит ссылки, выдумывать не стал. Тот же вопрос в обычном чате без поиска чаще заканчивается связным рассказом про несуществующую модель, и именно на этой разнице стоит выбирать, чем пользоваться для фактов
Пять признаков, что перед тобой выдумка
Признаки работают без специальных знаний. Достаточно перечитать ответ один раз
| Признак | Как выглядит | Что делать |
|---|---|---|
| Нет источника | ни одной ссылки, ни одного имени издания | спросить «откуда это, дай ссылку» |
| Слишком круглое число | «около 40 процентов», «примерно вдвое» без даты замера | спросить дату и источник числа |
| Идеально подходящая цитата | точная фраза известного человека прямо под твой запрос | проверить фразу поиском в кавычках |
| Название, которого не гуглится | сервис, закон, книга, которых нет в поиске | искать точное название отдельно |
| Ответ на несуществующее | ты спросил про то, чего нет, а машина рассказала | переспросить «а это вообще существует» |
Таблица прокручивается вбок →
Пятый признак самый показательный и проверяется за минуту: задай вопрос о том, чего заведомо не существует. Если получишь развёрнутый ответ вместо «такого нет», ты только что увидел механизм своими глазами
Что это тебе даёт: пять быстрых фильтров вместо общего недоверия. Общее недоверие обесценивает инструмент, фильтры оставляют его полезным
Шесть приёмов проверки за две минуты
| Приём | Куда нажать или что написать | Что увидишь |
|---|---|---|
| Требовать ссылки | «дай ссылки на источники к каждому пункту» | список адресов, которые можно открыть |
| Открыть хотя бы одну | нажать на ссылку из ответа | живую страницу либо пустоту там, где источник обещан |
| Разрешить незнание | «если не знаешь точно, так и напиши» | честное «не знаю» вместо выдумки |
| Спросить дважды | тот же вопрос в новом чате | разные ответы у выдумки, одинаковые у факта |
| Проверить в поиске | скопировать точное название в поисковую строку | есть ли эта сущность вообще |
| Сверить дату | «на какую дату эти данные» | дату либо признание, что даты нет |
Таблица прокручивается вбок →
Четвёртый приём стоит объяснить отдельно. Открой новый чат, задай тот же вопрос другими словами и сравни. Факт машина повторит почти дословно, выдумку соберёт заново и по-другому. Расхождение в деталях между двумя ответами - самый простой сигнал, что проверять надо всё утверждение целиком
Что это тебе даёт: шесть действий, ни одно из которых не требует ни платной подписки, ни знания устройства моделей
Как спросить, чтобы выдумок стало меньше
Формулировка вопроса влияет на честность ответа сильнее, чем выбор модели. Четыре правила, каждое проверяется в одном чате
Первое: разреши «не знаю» вслух. Одна фраза в конце вопроса - «если данных нет, напиши, что не знаешь» - убирает часть выдумок, потому что снимает у машины необходимость закрывать пустоту
Второе: не подсказывай ответ в вопросе. «Почему этот сервис закрылся» заставляет объяснять закрытие, даже если сервис работает. Спрашивай «работает ли этот сервис сейчас»
Третье: проси источник вместе с ответом, а не после. Требование «с ссылками на страницы» в самом вопросе меняет и способ сборки ответа
Четвёртое: сужай вопрос до одного факта. Один вопрос - одно утверждение, которое можно проверить. Пять вопросов в одном сообщении дают ответ, где верное и выдуманное перемешаны в один абзац
Что это тебе даёт: те же приёмы работают в любом чате, потому что описывают не кнопки конкретного сервиса, а способ ставить вопрос. Подробнее про формулировки есть разбор промптов и три промпта для работы
Где выдумка стоит дороже всего
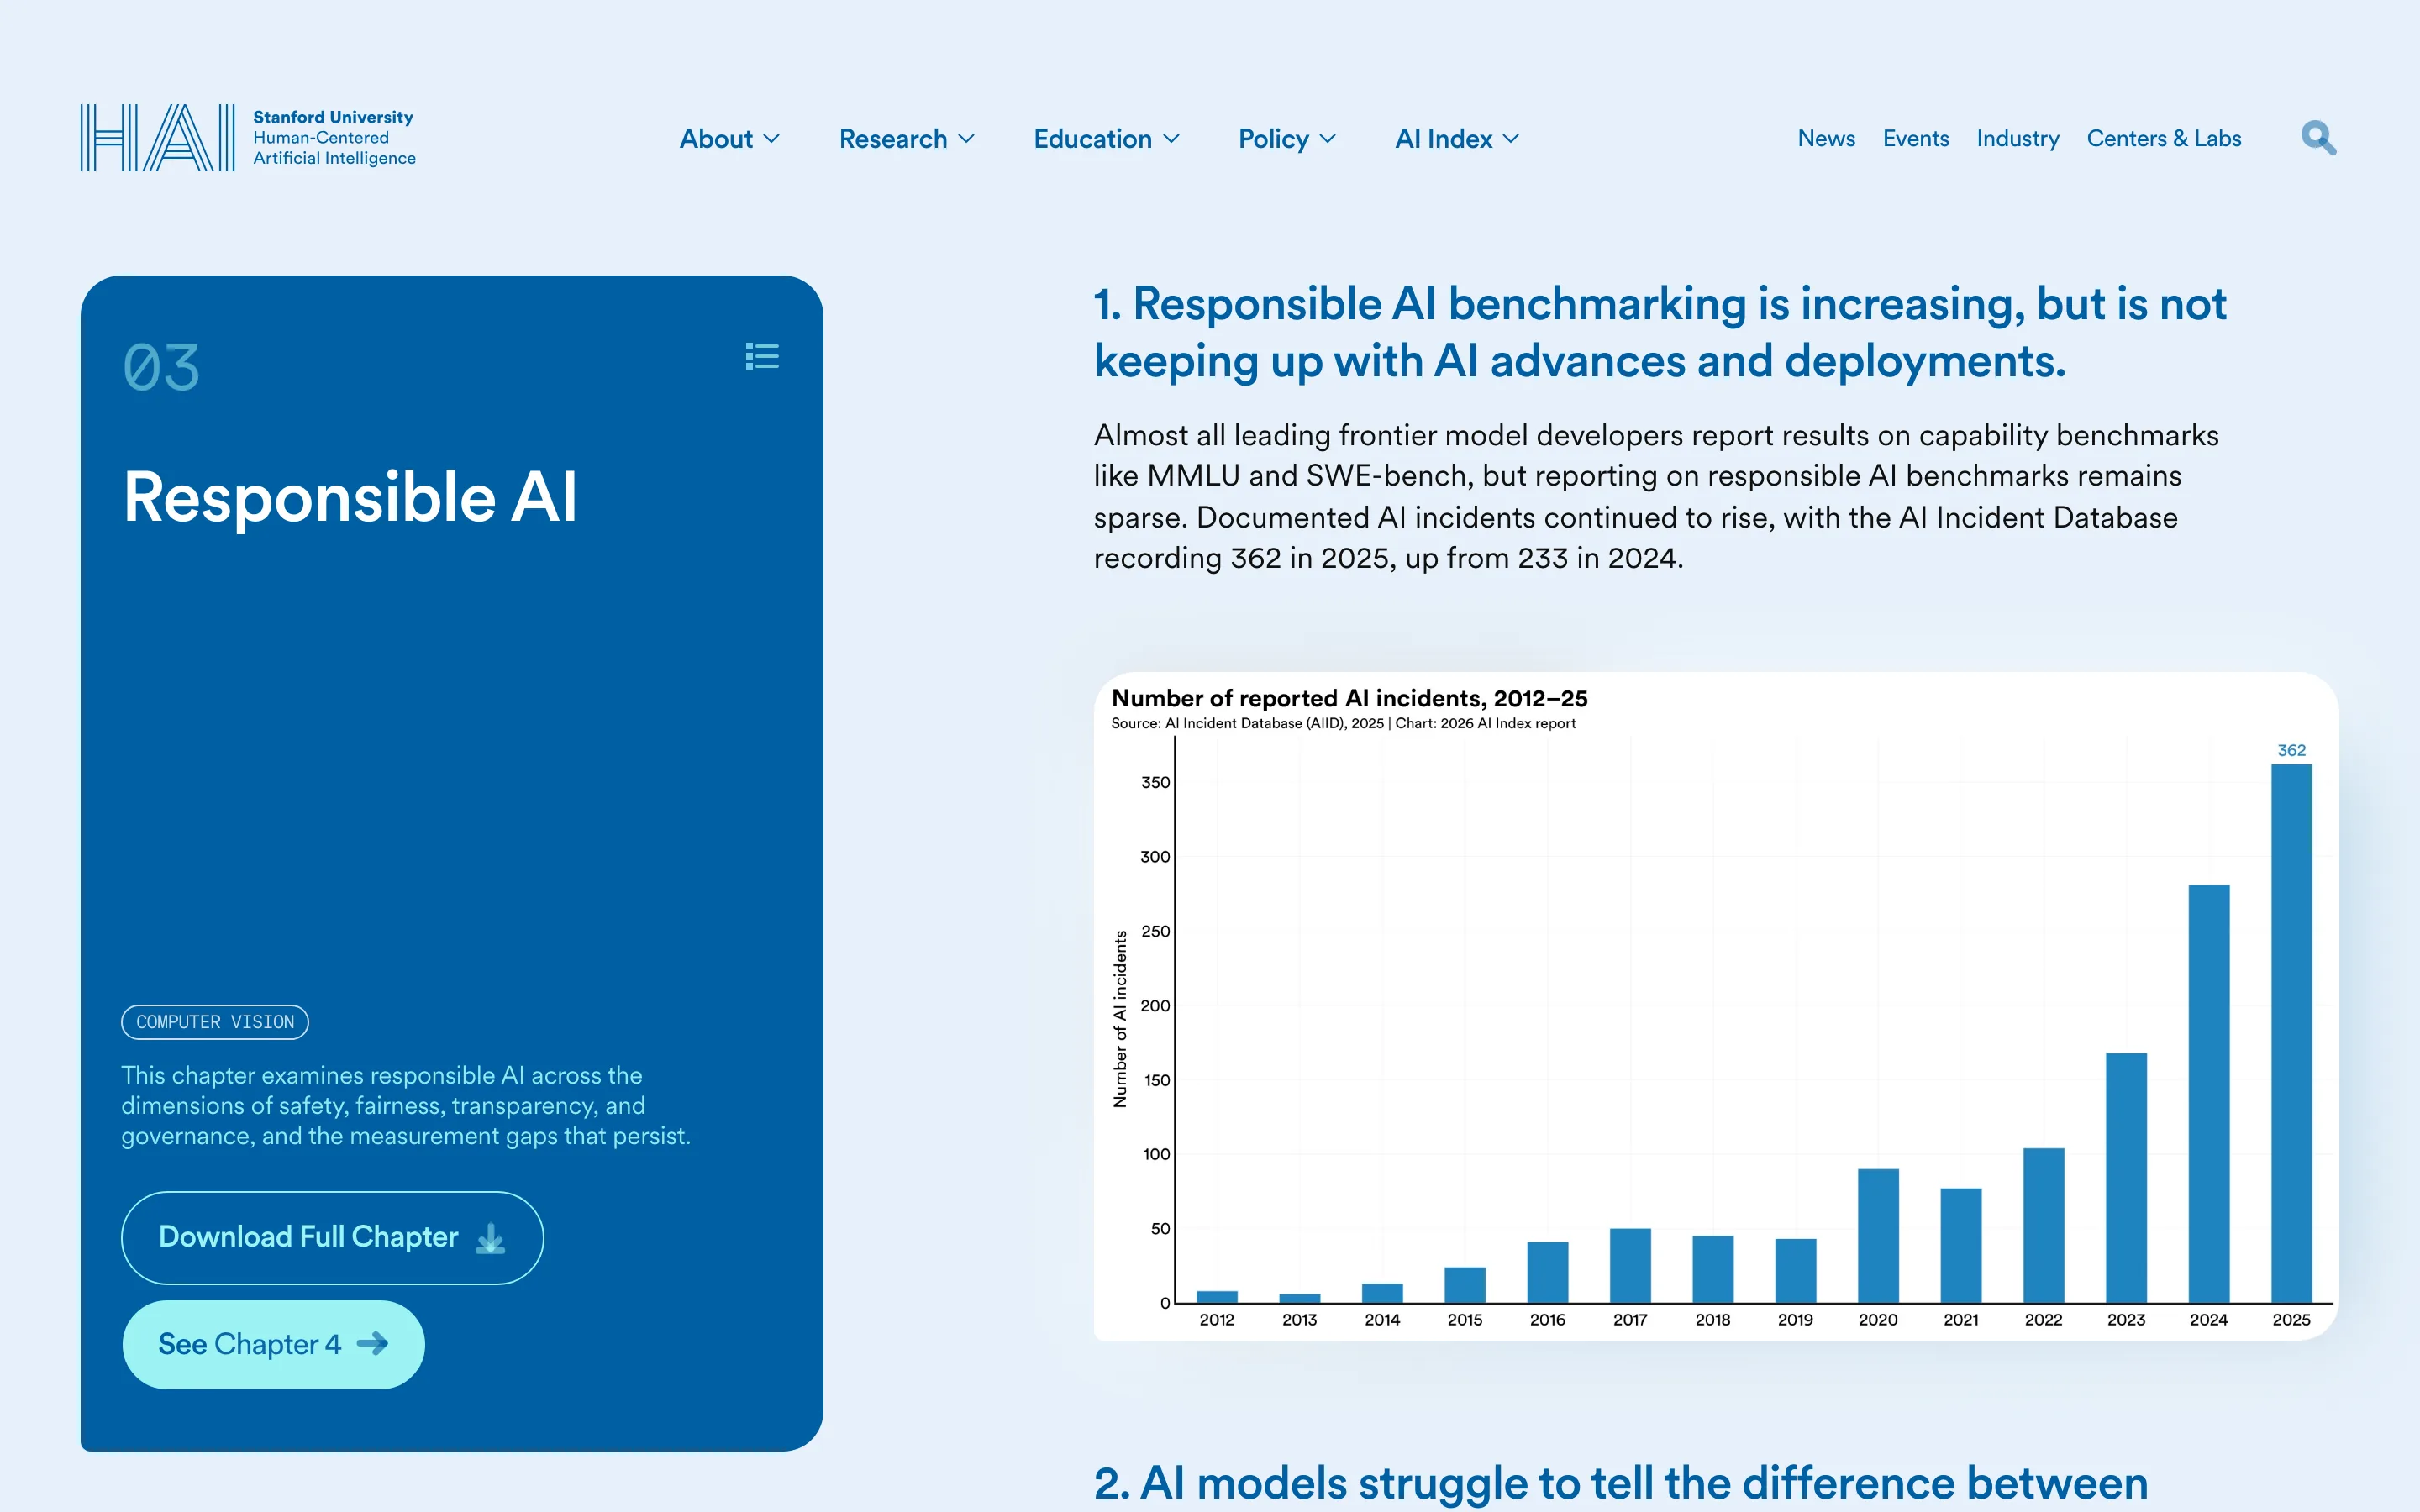
Отчёт AI Index за 2026 год приводит два числа рядом. Первое: база зафиксированных инцидентов с ИИ выросла с 233 случаев в 2024 году до 362 в 2025. Второе: на новом тесте разброс частоты неверных ответов по 26 сильным моделям составил от 22 до 94 процентов в зависимости от задачи
Три области, где цена выдумки максимальная:
Учёба. Реферат или диплом с выдуманными источниками проверяется преподавателем за пять минут: он открывает список литературы и не находит там половину. Про то, как этим пользоваться аккуратно, есть разбор для студентов и про рефераты
Деньги и документы. Цена, условие тарифа, пункт договора, названные машиной, стоят ровно столько, сколько стоит их проверка на сайте продавца. Ноль проверки - ноль стоимости
Медицина и право. Здесь ответ машины - это повод задать вопрос человеку, а не заменитель человека. Отдельно про юридические тексты есть разбор для юриста, и там та же логика: черновик да, решение нет
Что это тебе даёт: понятную границу. Чем дороже последствие, тем короче должна быть цепочка между ответом машины и твоим действием
Чем модели различаются по частоте выдумок
Разница между моделями реальная, но она не отменяет проверку. Даже верхняя строка замера от 29.08.2026 держит 14,2 процента, а это каждый седьмой случай из тех, где модель не ответила правильно
| Место в замере | Модель | Доля выдумок |
|---|---|---|
| 1 | Command A+ (Cohere) | 14,2% |
| 2 | LFM2.5-2.6B (LiquidAI) | 16,0% |
| 3 | MiniMax M3 (MiniMax) | 18,4% |
Таблица прокручивается вбок →
Второй ориентир из того же отчёта AI Index: на сложном тесте разброс по 26 моделям от 22 до 94 процентов. Разница между «лучшая модель» и «худшая модель» огромная, но нижняя граница всё равно далека от нуля
Что это тебе даёт: выбор модели снижает частоту выдумок, но не отменяет их. Сравнить инструменты между собой помогает разбор, какая нейросеть лучше, а посмотреть на цены - обзор цен
Что с этим будет дальше
Честный ответ: полностью это не чинится. Пока сборка ответа остаётся вероятностной, остаётся и вероятность правдоподобной неправды
Что реально меняется. Первое: модели чаще получают доступ к поиску и отдают ответ со ссылками, а ссылку можно открыть. Второе: разбор OpenAI предлагает менять сам способ оценки - давать частичный балл за честное «не знаю» и штрафовать уверенный неверный ответ. Третье: появились открытые замеры вроде того, с которого начинается эта статья, и их можно смотреть перед выбором инструмента
Что не изменится: ответственность за опубликованное остаётся на человеке. Ни один замер и ни одна модель эту часть на себя не берут
Что это тебе даёт: ожидание, которое не разочарует. Инструмент будет ошибаться и через год, вопрос только в том, ловишь ты это за минуту или не ловишь вовсе
Частые ошибки новичка
Первая: доверять длинному ответу больше, чем короткому. Длина ответа не связана с его правдивостью никак, а подробности как раз и создают ощущение достоверности
Вторая: спрашивать «ты уверен» и успокаиваться. На такой вопрос машина почти всегда извинится и переделает ответ, иногда заменив одну выдумку другой. Проверка - это открытая ссылка, а не переспрашивание
Третья: копировать ответ в работу целиком. Если из ответа взяты числа и названия, проверять надо их поимённо, а не текст в среднем
Четвёртая: считать, что платная подписка отменяет выдумки. Не отменяет, что видно по замеру: в верхних строках стоят и открытые модели тоже. Что даёт платный доступ, разобрано отдельно в разборе про ChatGPT Plus
Что это тебе даёт: четыре типовые ловушки, в которые попадают почти все на первом месяце работы с нейросетями
Что почитать рядом на сайте
Соседние разборы, которые закрывают шаги вокруг этой темы:
- Что такое нейросеть - если слова выше звучат непривычно
- Что такое GPT - как устроена сборка ответа
- Как пользоваться нейросетью - первые шаги без теории
- Промпт простыми словами - из чего состоит хороший вопрос
- Проверить текст на ИИ - обратная задача, проверка текста
- ИИ-поиск - когда ответ собирается из живых страниц
- Нейропоиск - как работает поиск с ответом
- Контекст - почему длинный разговор ухудшает ответы
- Бесплатные нейросети - с чего начать без оплаты
- Какая нейросеть лучше - как сравнивать инструменты
- Цены нейросетей - сколько это стоит
- Данные в нейросети - что нельзя отправлять в чат
- ИИ для студентов - учёба без выдуманных источников
- Нейросеть для реферата - где чаще всего попадаются
- Нейросеть для юриста - цена ошибки в документах
- ChatGPT Plus - что даёт платный доступ
- Claude бесплатно - соседний инструмент без оплаты
- DeepSeek - ещё один вариант для сравнения
- Gemini - чем отличается ответ со встроенным поиском
- Промпты - готовые формулировки вопросов
- Три промпта - минимальный набор на каждый день
- Локальные нейросети - когда данные не уходят наружу
Источники
Все страницы открыты живьём 30 августа 2026 года, числа сняты с самих страниц, а не из чужих пересказов. Кадры этих страниц стоят выше в статье
- Открытый замер доли выдуманных ответов, данные сверены на 29.08.2026: первые три места и таблица на 168 моделей - benchlm.ai, снимок 30.08.2026
- Первоисточник самой метрики, площадка сравнения моделей - artificialanalysis.ai
- Глава «Ответственный ИИ» отчёта AI Index 2026: база инцидентов 362 случая за 2025 против 233 за 2024, разброс частоты неверных ответов по 26 моделям от 22 до 94 процентов - hai.stanford.edu, снимок 30.08.2026
- Разбор причин: обучение и тесты поощряют угадывание больше, чем признание незнания - openai.com, сентябрь 2025
- Кадр живого ответа со ссылками на источники, открытый ИИ-поиск - iask.ai, снимок 30.08.2026
Памятка: как не поймать выдумку
Восемь строк, по которым проходит весь разбор
Сохрани себе
- Уверенный тон ответа не значит ничего, это обычная манера машины
- В замере от 29.08.2026 у лучшей модели 14,2 процента выдумок из 168 проверенных
- Машина не хранит факты, она подбирает правдоподобное продолжение
- Тесты поощряют угадывание больше, чем честное «не знаю»
- Пять признаков: нет источника, круглое число, идеальная цитата, ненаходимое название, ответ про несуществующее
- Шесть приёмов: ссылки, открыть ссылку, разрешить незнание, спросить дважды, поиск, дата
- Ложная предпосылка в вопросе почти гарантирует выдумку в ответе
- Чем дороже последствие, тем короче путь от ответа машины до проверки человеком
Что останется после
Что остаётся, когда следующая модель выйдет ещё точнее
Проценты в замерах будут падать, а привычка проверять останется полезной ровно столько же, сколько ты работаешь с машиной
Этот навык не зависит от того, чья модель сегодня стоит первой в таблице
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Почему нейросеть выдумывает, если она умная?
Ум тут ни при чём. Модель собирает ответ по вероятности следующего слова, а не достаёт факт из справочника. Там, где данных не хватило, побеждает правдоподобие. Разбор OpenAI 2025 года добавляет вторую причину: тесты поощряют угадывание больше, чем честное «не знаю»
Как быстро проверить ответ нейросети?
Найти в ответе три вещи: имя источника, дату и ссылку. Нет хотя бы одной - написать в тот же чат «откуда это, дай ссылку». Дальше открыть эту ссылку самому и убедиться, что страница живая и говорит то же самое
У какой нейросети меньше всего галлюцинаций?
По открытому замеру от 29.08.2026 верхнюю строку держит Command A+ с 14,2 процента, дальше LFM2.5-2.6B с 16,0 и MiniMax M3 с 18,4. Числа меняются с каждым обновлением таблицы, поэтому смотреть надо живой замер, а не статью. Сравнение инструментов по другим осям есть в разборе какая нейросеть лучше
Помогает ли платная подписка?
Сама по себе нет. В верхних строках открытого замера стоят и модели со свободным доступом. Платный доступ обычно даёт лимиты и скорость, а не честность. Что именно даёт оплата, разобрано в статье про ChatGPT Plus
Что делать, если нейросеть придумала источник?
Проверить точное название поиском в кавычках. Не нашлось - вернуться в чат и написать прямо: «такого источника нет, дай существующий или скажи, что данных нет». Такой ответ чаще заканчивается честным признанием, чем вторая выдумка
Можно ли вообще доверять нейросети?
Доверять стоит черновику, а не факту. Машина хорошо переписывает, структурирует и подсказывает ход мысли. Числа, названия, цитаты и цены проверяются отдельно, и это занимает пару минут
Правда ли, что чем длиннее ответ, тем он надёжнее?
Нет. Длина и правдивость не связаны. Подробности создают ощущение достоверности, поэтому длинную выдумку заметить труднее, чем короткую