Локальные нейросети · распознавание фото
Локальная нейросеть и картинки: 1 модель читает фото без сети
Сфотографировал чек и не хочешь вручную перепечатывать сумму. Или прислали скриншот таблицы, а читать мелкий текст лень. Для этого не нужен облачный сервис и подписка: нейросеть с "глазами" ставится на свой компьютер одной командой, весит 3,2 гигабайта и с этого момента читает любое твоё изображение без интернета
К концу статьи у тебя будет рабочая модель, которая по одной команде отвечает текстом на вопрос про любую картинку - что на чеке, что написано на скриншоте, что изображено на фото. Я прогнал это на своей машине и показываю кадрами, что модель реально увидела, а не пересказываю чужую документацию
Открой Ollama, скачай vision-модель весом 3,2 ГБ и одной командой спроси её про свой скриншот или фото чека - дальше в статье разобрано, какую модель брать под свою память и что реально видит модель на кадре
Что вообще умеет "видеть" нейросеть на компьютере
Обычная текстовая модель читает только буквы, которые ты ей напечатал. Модель с "глазами" - её называют vision-моделью или мультимодальной - получает на вход ещё и файл картинки, разбирает её на кусочки, как разбирает слова в предложении, и может ответить на вопрос про содержимое
Официальное описание модели, которую я использую в этой статье, прямо перечисляет, что она умеет: "не только профессиональна в распознавании обычных объектов, но высокопроизводительна в анализе текстов, диаграмм, иконок в изображениях" (страница модели qwen2.5vl в каталоге Ollama, обращение 03.09.2026). То есть три вещи из заголовка статьи - чек, скриншот, фото - это ровно её профиль: чек и скриншот - это "текст в изображении", фото документа - тоже он же
Обработка и распознавание - разные глаголы
- Обработка фото меняет картинку: убрать фон, стереть объект, улучшить качество. Результат - новый файл изображения
- Распознавание фото картинку не меняет: отвечает текстом на вопрос про содержимое. Результат - строка текста, файл фото остаётся прежним
- Что дальше в статье как поставить и спросить модель, которая делает именно распознавание, полностью на своём компьютере
Поставь vision-модель весом 3,2 гигабайта
Движок для локальных моделей называется Ollama, и если он у тебя ещё не стоит - установка по шагам разобрана в отдельном гайде, займёт несколько минут. Дальше в этой статье Ollama уже считается установленной
Обычные модели, которые ставят для переписки и текста, "глаз" не имеют вовсе - им можно показать только слова. Нужна отдельная модель именно с поддержкой изображений, и у неё, как и у текстовых моделей, есть несколько размеров под разную память компьютера
Понадобится окно для команд текстом - в мире программ его называют так же, как и обычную программу для набора текста, только вместо текста ты печатаешь короткие фразы-команды, и компьютер сразу их выполняет. Если такое окно у тебя открывать ещё не приходилось, короткий разбор с картинками лежит в отдельном гайде про это самое окно - там же объяснено, где его искать на Маке и на Windows
Установка vision-модели
- Открой окно для команд (на Маке ищи по имени в поиске, на Windows - через меню "Пуск") что увидишь: тёмное окно с курсором, готовое принимать текст. Что это даёт: место, куда впечатать одну строку - больше ничего технического дальше не потребуется
- Впиши строку
ollama pull qwen2.5vl:3bи нажми Enter что увидишь: полоску загрузки и цифры в мегабайтах - файл весит 3,2 гигабайта по официальному каталогу Ollama (обращение 03.09.2026). Что это даёт: модель с "глазами" скачивается на твой диск целиком, потом сеть для её работы больше не нужна - Дождись, когда окно снова покажет приглашение для новой строки что увидишь: та же тёмная строка ожидания, полоска загрузки исчезла - значит файл скачан и распакован. Что это даёт: модель готова отвечать на вопросы про картинки прямо сейчас
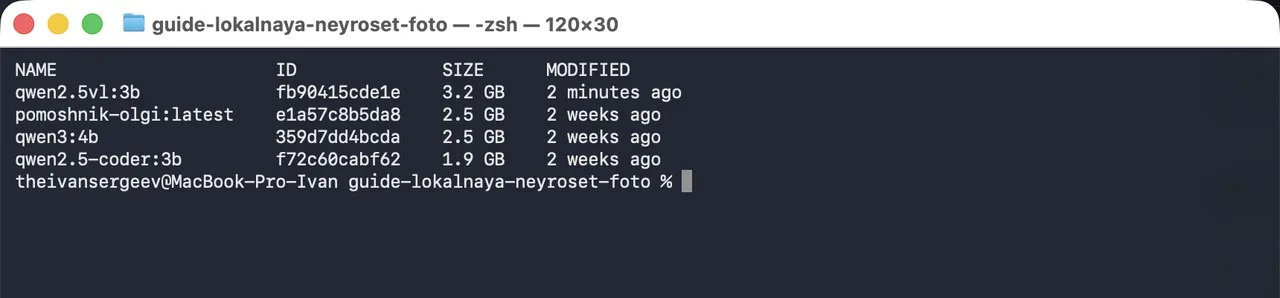
Почему именно эта модель и именно этот размер. У модели qwen2.5vl четыре размера в официальном каталоге Ollama: 3,2 ГБ, 6,0 ГБ, 21 ГБ и 49 ГБ (обращение 03.09.2026) - чем больше файл, тем точнее и медленнее ответ. Для чтения чека или скриншота хватает младшей версии с большим запасом: задача простая, текст на кадре крупный и контрастный, а не рукописный черновик
Для сравнения, ближе к теме памяти компьютера: у семейства LLaVA, второй по распространённости vision-модели в каталоге Ollama, младшая версия весит уже 4,7 ГБ (обращение 03.09.2026) - на треть тяжелее при сравнимой задаче, поэтому в статье она не первый выбор
| Модель | Вес файла | Когда брать |
|---|---|---|
| qwen2.5vl:3b | 3,2 ГБ | первая модель, хватает для чека, скриншота, простого фото |
| qwen2.5vl:7b | 6,0 ГБ | точнее на мелком и рукописном тексте, машина посвежее |
| llava:7b | 4,7 ГБ | альтернатива, если qwen2.5vl не понравился по стилю ответов |
Таблица прокручивается вбок →
По объёму памяти компьютера действует то же правило, что и для текстовых моделей: в оперативной памяти модель занимает примерно в полтора-два раза больше, чем весит её файл на диске. Официальные системные требования той же программы для локальных моделей называют ориентир 16 ГБ оперативной памяти на Маке с чипом Apple Silicon (M1 и новее) или на Windows с процессором, поддерживающим набор инструкций AVX2 (документация LM Studio, обращение 03.09.2026) - для младшей vision-модели в 3,2 ГБ этого запаса хватает с большим отрывом
Спроси модель про свой чек, скриншот или документ
Дальше - главное действие статьи: одна команда с картинкой вместо тысячи слов объяснения
Первый вопрос про свою картинку
- Положи файл фото или скриншота в удобную папку что увидишь: обычный файл jpg или png у себя на диске. Что это даёт: модели нужен путь до файла - не важно, откуда он взялся, главное, что он у тебя на компьютере
- Впиши вопрос и через пробел полный путь к файлу картинки, например
ollama run qwen2.5vl:3b "что написано на этом чеке /Users/имя/Desktop/chek.jpg"что увидишь: строку "Added image" с именем файла, потом через несколько секунд ответ прямо в этом же окне. Что это даёт: ты своими словами спросил про конкретную картинку и получил конкретный ответ, а не общую инструкцию - Смени вопрос под свою задачу что увидишь: тот же файл, но другой ответ - "сколько денег на чеке", "что написано в правом верхнем углу скриншота", "переведи текст с картинки". Что это даёт: одна и та же модель отвечает на любой вопрос про один и тот же кадр, перезапускать и переустанавливать ничего не нужно
Я проверил этот способ на своей машине 03.09.2026: путь к файлу вписывается прямо в вопрос, отдельного флага для картинки версия программы на моём компьютере не приняла. Официальная документация Ollama описывает похожий приём с отдельным флагом изображения, но у меня сработал именно путь внутри строки вопроса - если твоя версия новее, можешь встретить любой из двух вариантов, программа сама подскажет ошибкой, если флаг не распознан
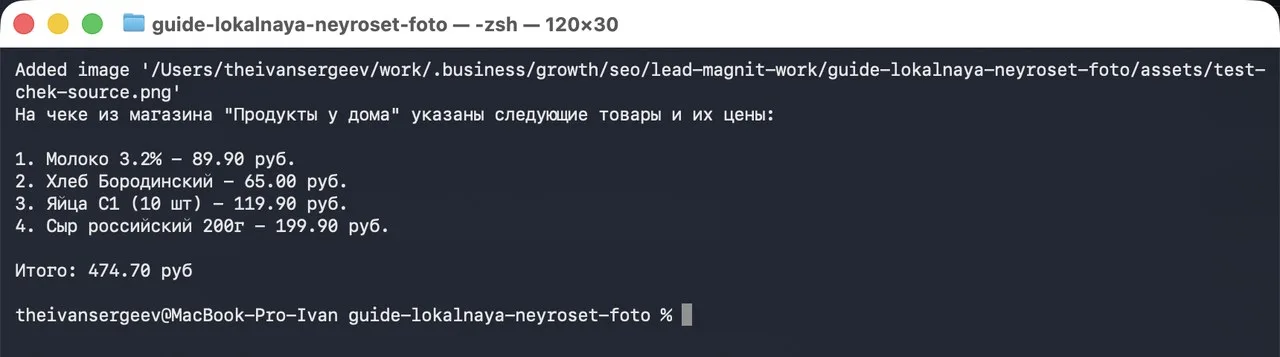
Если своих чеков или скриншотов под рукой нет прямо сейчас - подойдёт любой файл с текстом: скриншот переписки, фото рецепта из кулинарной книги, страница из документа. Модель одинаково честно опишет содержимое любого из них
Три бытовых случая - одна и та же команда
Три задачи из заголовка статьи технически устроены одинаково: модель получает картинку и текстовый вопрос, разница только в формулировке вопроса
| Задача | Какой вопрос задать | Что получишь в ответ |
|---|---|---|
| Прочитать чек | "перечисли товары и цены с этого чека" | список позиций и сумма текстом |
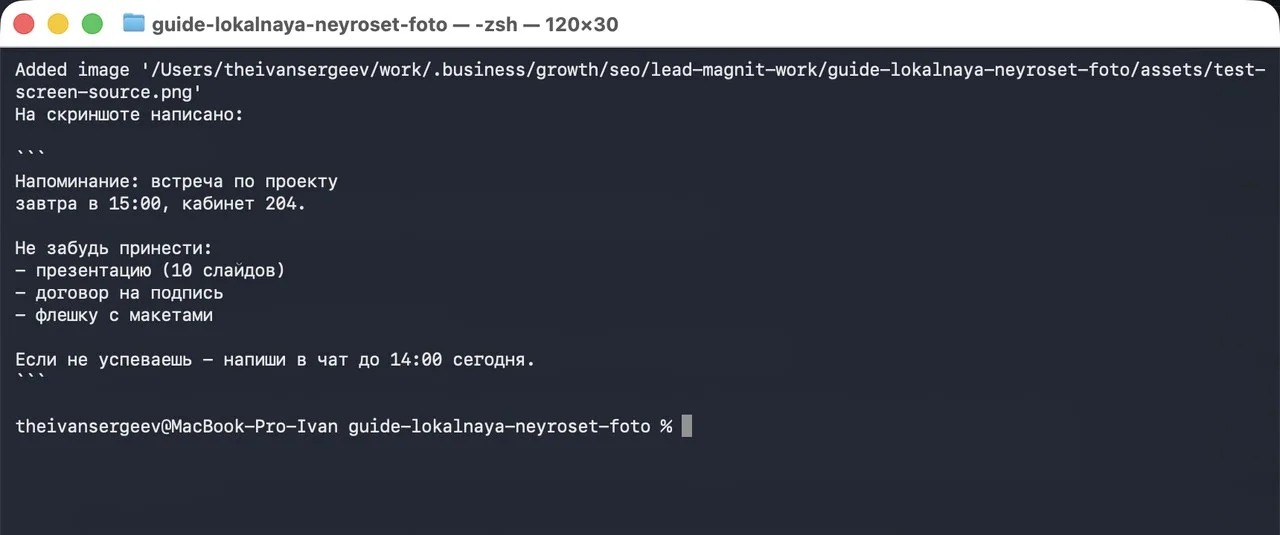
| Разобрать скриншот | "что написано на этом скриншоте" | пересказ видимого текста своими словами |
| Понять фото документа | "переведи и перескажи текст с этой фотографии" | связный текст вместо кривого снимка |
Таблица прокручивается вбок →
Разница в качестве ответа между этими тремя случаями будет заметна, и вот честная причина. Чек часто снят криво, под углом, с бликами от кассовой ленты - для модели это самый сложный случай из трёх. Скриншот - самый простой: текст на нём ровный, крупный и контрастный, потому что он изначально цифровой, а не сфотографированный. Фото документа - где-то посередине, зависит от освещения и угла съёмки
Отключи интернет и сравни с ценой облака
Проверка на честность та же, что и с текстовыми моделями: выключи Wi-Fi и повтори вопрос про ту же картинку
Проверка на офлайн
- Выключи Wi-Fi в верхней панели или в настройках сети что увидишь: значок сети погаснет, браузер перестанет открывать страницы. Что это даёт: честные условия проверки - если ответ придёт без сети, модель точно твоя
- Повтори ту же строку с тем же файлом картинки что увидишь: ответ появится так же, как в первый раз, с той же скоростью. Что это даёт: подтверждение своими глазами, что распознавание считает твой же компьютер, а не чужая машина в интернете
Экономия здесь считается не абстрактно, а по прайсу конкретного облачного конкурента. У Google Cloud Vision, одного из крупных облачных сервисов распознавания, базовая цена - 1,50 доллара за 1000 изображений, то есть 0,15 цента за одно фото, и это ещё по минимальному тарифу до 5 миллионов запросов в месяц (данные страницы тарифов, обращение 03.09.2026). Важная деталь того же прайса: там платят ПО ФУНКЦИИ, а не по фото - если попросить у сервиса и распознать текст, и определить объекты на одном снимке, это уже две оплаченные единицы, а не одна
На практике 0,15 цента за фото звучит копеечно, пока не умножишь на объём. Сто чеков за месяц бизнес-расходов - это 15 центов в облаке, а локально - те же 3,2 ГБ, скачанные один раз, и дальше счётчика нет вообще, сколько бы фото ты ни спросил. Для разового чека разница не критична, для потока в несколько снимков каждый день - это уже вопрос привычки платить за то, что можно делать бесплатно на своей же машине
Когда точности локальной модели не хватит
Честно о границе, а не только о плюсах. Младшая модель на 3,2 гигабайта справляется с ровным печатным текстом уверенно, а на рукописном почерке, сильно размытом кадре или тексте на редком языке иногда ошибается или додумывает недостающее
Если результат выглядит подозрительно - следующий шаг простой: возьми модель покрупнее (6,0 ГБ версия точнее на сложных кадрах) или, для разовой задачи, сверь результат с оригиналом глазами. Модель не заменяет здравый смысл, она экономит время на переписывании текста руками
Если задача противоположная - не прочитать существующее фото, а нарисовать или улучшить его - это уже другой инструмент и другая статья, обработка фото нейросетью. А если хочется понять локальные модели шире, не только для картинок - общий обзор с правилом выбора по памяти компьютера лежит в гайде локальные нейросети: что потянет твой компьютер
Что ещё стоит знать перед установкой
Если апгрейдишь машину под локальные модели, а не только под эту задачу - актуальный разбор нового железа Apple лежит в гайде про Mac mini, там же ориентиры по памяти под разные задачи с ИИ
Сравнение двух программ-оболочек для локальных моделей, Ollama и LM Studio, у кого только окно для команд текстом, а у кого готовое окно с кнопками - в отдельном гайде, если печатать строки кажется неудобным и хочется окно с историей переписки, как в обычном мессенджере
Модель qwen2.5vl, которую я использую в этой статье, распространяется с открытой лицензией - что это значит на практике и откуда вообще берутся бесплатные модели, разобрано в гайде про открытые инструменты ИИ. Если своей локальной модели пока нет вообще ни одной, самый быстрый путь начать - установить Claude Code, помощник тоже открывает окно для команд, только команды в нём словами, а не строгим синтаксисом
Частые ошибки новичка
Что чаще всего идёт не так с первого раза
- Скачали текстовую модель без "глаз" обычная модель для переписки картинку в вопросе просто проигнорирует - нужна отдельная vision-модель, например qwen2.5vl, а не любая из уже стоящих
- Путь до файла указан неверно если написать только имя файла без полного пути, модель ответит, что не видит никакой картинки - я проверил на своей машине: сработал только полный путь вида
/Users/имя/Desktop/chek.jpg, короткий вариант картинку не подхватил - Ждут идеальной точности на кривом кадре чек, сфотографированный под острым углом или с бликом на сумме, модель прочитает с ошибками - переснять кадр ровнее почти всегда быстрее, чем гадать по нечитаемому оригиналу
- Путают эту задачу с обработкой фото если нужно убрать фон или дорисовать - это другой инструмент из отдельного гайда, распознавание картинку не меняет
Что ещё почитать про локальные нейросети
- Локальные нейросети: что потянет твой компьютер - общий обзор, если ещё ничего не установлено
- Как установить Ollama - установка движка по шагам, если его ещё нет
- Что такое окно для команд и как в нём работать - если само это окно видишь впервые
- Ollama или LM Studio - какую программу-оболочку выбрать
- Открытые инструменты ИИ - откуда берутся бесплатные модели вроде той, что в этой статье
- Установка Claude Code - похожее окно для команд, только словами, а не строгим синтаксисом
- Обработать фото нейросетью - если задача обратная: не прочитать фото, а изменить его
- ChatGPT на телефоне - лимиты и подписка мобильной альтернативы для сравнения
- Бесплатные нейросети без карты - подборка того, что работает без единой оплаты
- Бесплатные замены платным нейросетям - чем закрыть задачу, если бесплатного лимита не хватает
- Mac mini на новом чипе - если апгрейдишь железо под локальные модели
- Нейросети и инструменты: все разборы - полный список гайдов по инструментам на сайте
Источники
Все страницы проверены прямым запросом 3 сентября 2026 года
- Ollama: модель qwen2.5vl - официальный каталог, размеры файлов 3,2-49 ГБ, объём памяти под один разговор 125 тысяч слов, описание возможностей распознавания текста и объектов на изображениях
- Ollama: модель llava - официальный каталог, размеры файлов для сравнения 4,7-20 ГБ
- LM Studio: системные требования - минимальная память и поддерживаемые чипы для локальных моделей
- Simon Willison: qwen2.5vl in Ollama - независимое подтверждение похожего приёма запуска модели с картинкой
- Google Cloud: тарифы Vision API - официальная цена облачного распознавания, 1,50 доллара за 1000 изображений, тарификация по функции
Памятка: распознать фото офлайн за 10 минут
Шесть строк, по которым видно, что всё стоит и работает
Сохрани себе
- Ollama установлена, обычная текстовая модель уже отвечает
- Команда ollama pull qwen2.5vl:3b выполнена, файл 3,2 ГБ на диске
- Свой файл (чек, скриншот, фото) лежит в известной папке, путь до него понятен
- Вопрос задан вместе с путём к файлу картинки в одной строке
- Ответ модели сверен с оригиналом глазами хотя бы один раз
- Wi-Fi выключен, тот же вопрос задан снова - ответ пришёл так же
Порог входа
Модель читает фото бесплатно, следующий шаг - тоже
Всё, что нужно для распознавания своих фото офлайн, ты только что прочитал бесплатно: команда, выбор модели, три практических случая
Следующий шаг - три дня, чтобы вокруг твоих же инструментов собрать рабочий порядок, который не приходится каждый раз собирать заново - тоже стоит ровно ноль
Кнопка ведёт в мой закрытый канал. Жмёшь «Подать заявку», впускаю сразу, бот пишет в личку и отдаёт путёвку. Бесплатно
Частые вопросы
Что такое vision-модель простыми словами?
Обычная текстовая модель понимает только напечатанные слова. Vision-модель, её ещё называют мультимодальной, дополнительно понимает файл картинки: ты показываешь ей фото или скриншот, а она отвечает текстом, что на нём видит
Сколько весит модель для распознавания фото?
Младшая рабочая версия - 3,2 ГБ (официальный каталог Ollama, модель qwen2.5vl, обращение 03.09.2026). Есть более точные и тяжёлые версии до 49 ГБ, но для чтения чека или скриншота хватает младшей с большим запасом
Можно ли распознать рукописный текст?
Да, но с меньшей уверенностью, чем печатный. Ровный печатный текст на чеке или скриншоте модель читает уверенно, аккуратный рукописный почерк - чаще всего тоже, а неразборчивый почерк может прочитать с ошибками. Сверяй результат с оригиналом на важных цифрах
Чем это отличается от обработки фото нейросетью?
Обработка меняет саму картинку - убирает фон, стирает объект, улучшает качество. Распознавание картинку не трогает вообще, оно отвечает текстом на вопрос про содержимое. Если нужна именно обработка, это отдельный гайд про обработку фото
Сколько это стоит по сравнению с облачным распознаванием?
У одного из крупных облачных сервисов, Google Cloud Vision, цена около 0,15 цента за одно фото по официальному прайсу (обращение 03.09.2026), и оплата идёт по каждой отдельной функции распознавания. Локально после разовой закачки модели в 3,2 ГБ счётчика нет вообще, сколько бы фото ты ни спросил
Работает ли это совсем без интернета?
Да, и это легко проверить: выключи Wi-Fi и задай модели вопрос про уже открытую картинку - ответ придёт так же, как при включённом интернете. Сеть нужна только один раз, чтобы скачать саму модель