Гайд · Как работают нейросети · октябрь 2026
Как устроен ChatGPT: лекция Стэнфорда, главное за 50 минут
Янн Дюбуа из Стэнфорда в лекции курса CS229 (2024 год, 1 час 44 минуты) объясняет, как на самом деле делают ChatGPT и Claude. Коротко: нейросеть сначала учится угадывать следующий кусочек текста на очищенном интернете, потом её доучивают на ответах и оценках людей
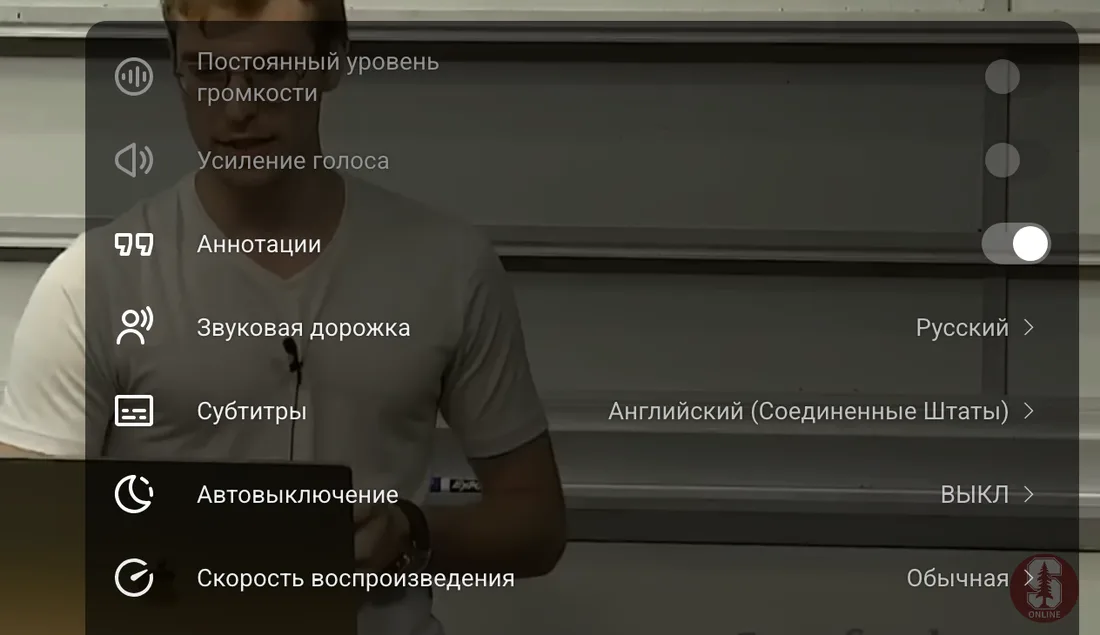
Открой лекцию на YouTube. В браузере на русском она сразу заговорит по-русски: YouTube сделал к ней автоматическую озвучку. Заговорила по-английски - шестерёнка «Настройки», «Звуковая дорожка», «Русский». Пока идёт видео, проверь вывод лекции в своём чате. Вставь в ChatGPT, Claude или Алису перед вопросом:
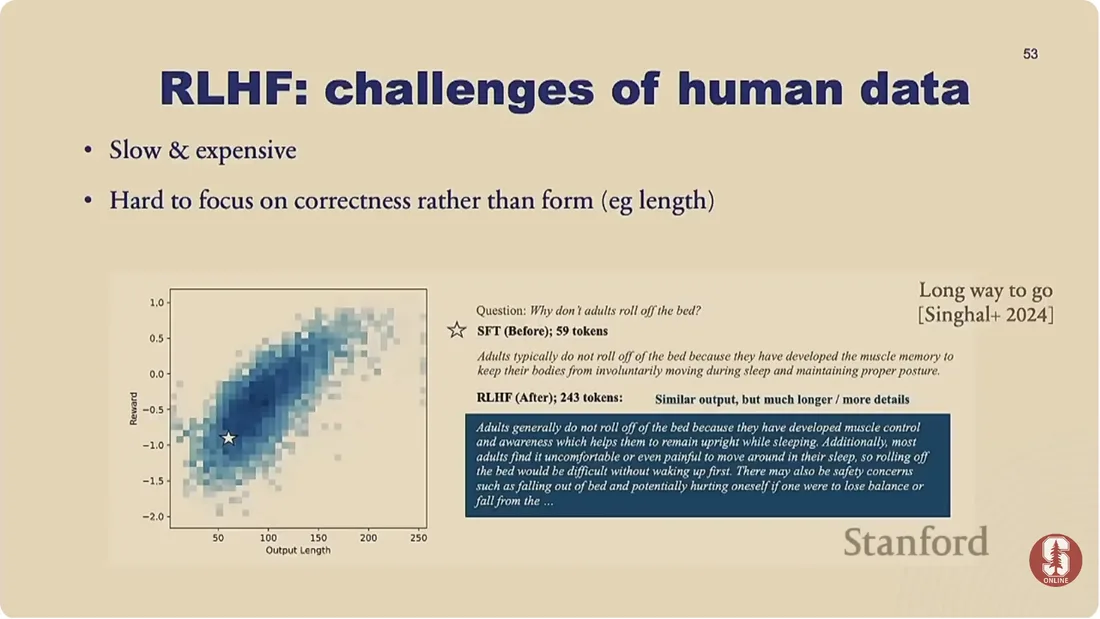
Отвечай коротко: не больше трёх предложений, без вступления и без повторения вопроса. Длина ответа для меня не признак качества. Если точно не знаешь, так и напиши. Вопрос:Я задал Claude вопрос из самой лекции «почему взрослые не падают с кровати во сне». Без этой строки пришло 202 слова, с ней 59, у тебя числа выйдут другими. Почему, объясняет лекция: люди, оценивавшие ответы при обучении, чаще выбирали длинные
Не смотри подряд: начни с 59:40, где из угадывателя текста делают ассистента, и держи рядом таблицу таймкодов ниже. А строку про короткий ответ добавь в начало следующего вопроса своему чату: на ней видно, что длинные ответы чат-бота это привычка от обучения, а не старание
Как понять, что всё сработало
Признаков два. Первый: в меню шестерёнки напротив пункта «Звуковая дорожка» стоит «Русский». Второй: чат на твой вопрос ответил тремя предложениями, а не простынёй с подзаголовками
Если чат всё равно ответил длинно, значит строка потерялась: вставь её в начало нового чата, а не в середину старого разговора
Лекция по таймкодам: что говорят и что взять себе
Лекция идёт в аудитории Стэнфорда, студенты перебивают вопросами, и это полезно: они спрашивают то же, что спросил бы ты. Если времени мало, смотри два отрезка: 03:00-18:50 (как модель угадывает текст) и 59:40-1:33:40 (как из неё делают ассистента и проверяют), вместе около 50 минут
| Время | О чём | Что взять себе |
|---|---|---|
| 00:00-03:00 | план: из чего состоит работа над нейросетью. Лектор говорит, что на практике важнее всего данные, проверка и железо, а не устройство самой модели | можно пропустить |
| 03:00-10:50 | предобучение: модель угадывает следующее слово, как подсказка в телефоне, только на всём интернете | главная идея всей лекции |
| 10:50-18:50 | токены: на какие кусочки нейросеть режет текст | почему чат-бот путается в числах |
| 18:50-28:20 | как мерить качество: перплексия (из скольких слов модель «колеблется» при выборе следующего, у хороших моделей меньше 10) и экзамен MMLU с вопросами по медицине, физике, астрономии | цифры в рейтингах зависят от способа замера |
| 28:20-40:30 | данные: как чистят интернет перед обучением | откуда у модели знания и почему она ошибается |
| 40:30-59:40 | законы масштабирования и цена обучения Llama 3: около 70 дней и порядка 75 млн долларов по прикидке лектора | можно пропустить, если не интересны деньги |
| 59:40-1:09:30 | дообучение на ответах людей: так из угадывателя текста делают ассистента | почему чат-бот отвечает, а не продолжает текст |
| 1:09:30-1:27:30 | обучение на оценках людей, так сделан ChatGPT | почему ответы длинные и откуда выдумки |
| 1:27:30-1:33:40 | как сравнивают чат-ботов: живые люди вслепую выбирают лучший ответ | как читать рейтинги нейросетей |
| 1:33:40-1:44:30 | видеокарты и ускорение обучения, советы, какие курсы смотреть дальше | для программистов |
Таблица прокручивается вбок →
Шесть мыслей лекции простыми словами
Ниже конспект в том порядке, как его даёт Янн Дюбуа. Термины перевожу сразу, цифры привожу так, как их называет лектор на лето 2024 года
1. Нейросеть угадывает следующий кусочек текста (03:00-10:50). В основе ChatGPT и Claude модель, которая на каждом шаге решает одно: какое слово вероятнее всего идёт дальше. Пример лектора: после «она, скорее всего, предпочитает» модель взвешивает варианты и может выбрать «собак». Выбрала, приписала к тексту и снова угадывает следующее. Отсюда простое следствие, которое лектор называет вслух: чем длиннее ответ, тем дольше он печатается, потому что каждый кусочек считается отдельно
2. Текст режется не на слова, а на токены (10:50-18:50). Это кусочек текста, в среднем 3-4 буквы английского. Слово целиком нельзя: опечатка сломала бы его, а в тайском языке вообще нет пробелов. По буквам тоже плохо: текст станет слишком длинным. Поэтому модель заранее склеивает частые сочетания букв в один кусочек:
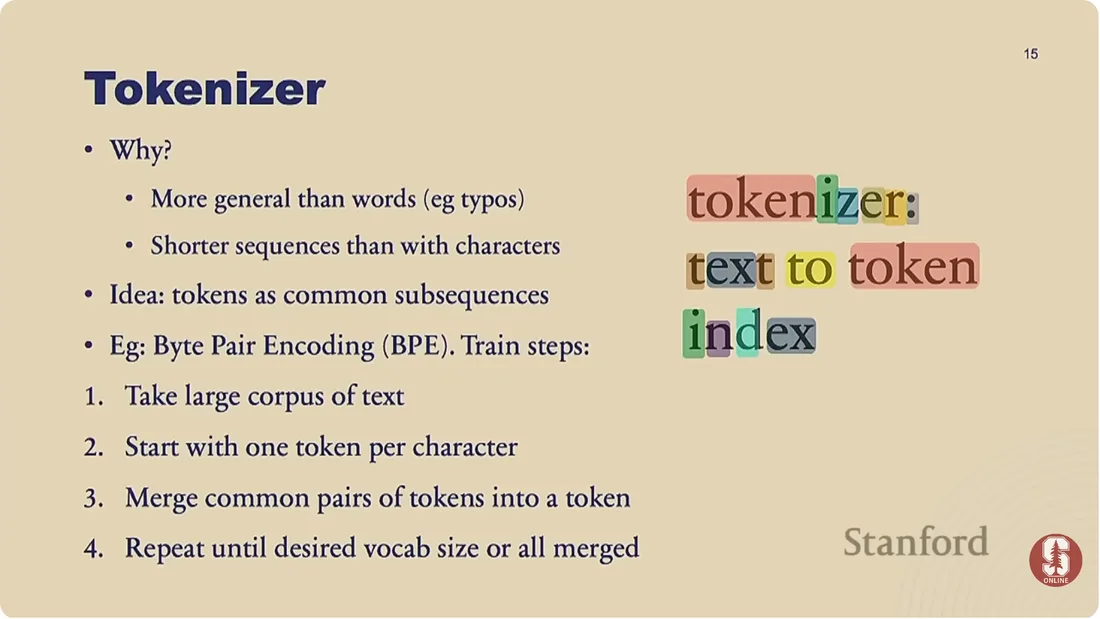
Я проверил это на словаре, которым пользуются новые модели OpenAI:
| Что режем | Сколько кусочков | Какие |
|---|---|---|
| tokenizer | 2 | token, izer, так же режет токенизатор GPT, который лектор показывает на 14:00 |
| токенизатор | 5 | т, ок, ен, из, атор |
| The mouse ate the cheese. | 6 | по слову на кусочек плюс точка |
| Мышь съела сыр. | 7 | русский текст режется мельче |
| 327 | 1 | число целиком |
| 1234567 | 3 | 123, 456, 7 |
Таблица прокручивается вбок →
Отсюда два вывода. Русский текст дробится мельче английского, поэтому тот же разговор на русском съедает больше кусочков. А числа модель видит не по цифрам, как мы, и лектор прямо говорит, что из-за этого ей трудно с арифметикой
3. Знания модели это очищенный интернет (28:20-40:30). Сначала скачивают почти весь открытый интернет, около 250 млрд страниц и примерно петабайт данных. Потом долго чистят: вытаскивают текст из разметки, выкидывают вредное и личные данные, удаляют повторы, отсекают мусорные страницы. Хорошие страницы ищут хитро: учат простую модель отличать сайты, на которые ссылается Википедия, от случайных. Код и книги добавляют больше, потому что после кода модель лучше рассуждает, развлекательное берут меньше. Llama 3, лучшую открытую модель на момент лекции, учили примерно на 15 трлн токенов. Как компании собирают данные, они не рассказывают: это их главный секрет и риск судов за авторские права
4. Больше данных и больше модель дают предсказуемо лучший результат (40:30-59:40). Это называется законы масштабирования: по маленьким моделям заранее считают, насколько лучше станет большая. Параметры это числа внутри модели, которые подкручиваются при обучении, у больших моделей их сотни миллиардов. Исследование Chinchilla вывело пропорцию около 20 токенов текста на каждый параметр. Прикидка лектора по Llama 3 на 405 млрд параметров: около 70 дней на 16 000 видеокартах, примерно 52 млн долларов за аренду железа и 25 млн на зарплаты команды. Его совет из этой части: не усложняй, делай простые вещи хорошо
5. Ассистентом модель делают дообучением на ответах людей (59:40-1:09:30). Голая модель после интернета не отвечает, а продолжает текст. Пример из лекции: на просьбу объяснить высадку на Луну шестилетнему старая GPT-3 выдавала похожие вопросы, как в списке вопросов в интернете. Чтобы она отвечала, её доучивают на парах «вопрос и правильный ответ», написанных людьми. Знаний это почти не добавляет, только учит формату: в работе LIMA рост с 2 000 до 32 000 примеров почти ничего не дал. В Стэнфорде так сделали Alpaca: из 175 примеров людей старая модель OpenAI нагенерировала 52 000 похожих
Отсюда же, по гипотезе, которую приводит лектор (1:10:30-1:12:05), растут выдумки. Если человек в обучающем ответе сослался на книгу, которую модель никогда не видела, модель учится не «вспоминать источник», а «писать правдоподобную ссылку». Так появляются уверенные несуществующие цитаты и книги, подробнее в разборе почему нейросети выдумывают
6. ChatGPT доучили на оценках людей, и от этого ответы длиннее (1:09:30-1:33:40). Людям трудно написать идеальный ответ, но легко выбрать лучший из двух. Поэтому модели дают два ответа на один вопрос, человек выбирает, а модель учится чаще выдавать то, что выбирают. Ровно так OpenAI сделала ChatGPT из GPT-3:
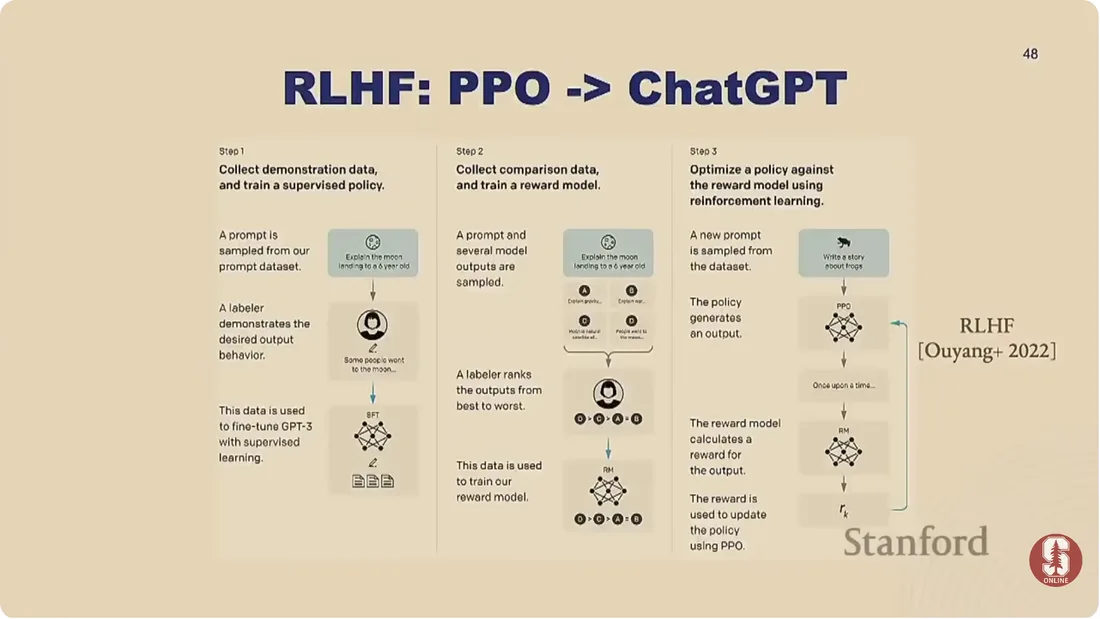
Подвох в том, что люди при выборе смотрят на форму. Из двух похожих ответов большинство выберет более длинный, даже если короткий точнее. Модель это выучивает, и после такого дообучения ответы растут. Лектор говорит прямо: если тебя раздражают длинные ответы ChatGPT, причина в этом
Проверяют готовых ассистентов тоже людьми. В ChatBot Arena обычные пользователи вслепую говорят с двумя чат-ботами и выбирают, кто ответил лучше. У дешёвого заменителя такого суда AlpacaEval, где судит другая модель, рейтинг моделей на 98% совпадает с рейтингом ChatBot Arena, но любит многословие: у GPT-4 с просьбой «отвечай подробно» доля побед над самой собой росла с 50% до 64,4%, а с просьбой «отвечай кратко» падала до 20%. Как читать такие рейтинги без самообмана, есть в разборе бенчмарков ИИ
Что из лекции применить в своём чате
Лекция для студентов-программистов, но три вывода работают у любого, кто пишет в ChatGPT, Claude или Алису. Все три фразы мои: я перевёл мысли лекции в текст, который можно вставить в чат
Приём 1. Короткий ответ. Строка из начала статьи. Она снимает привычку к длине, которую модели дало обучение на оценках людей. Что даёт: читаешь суть, а не вступление и повтор вопроса
Приём 2. Отметка уверенности. Когда просишь книги, исследования или цитаты, попроси модель саму пометить, в чём она не уверена:
Назови 3 книги на русском о том, как устроены нейросети, с автором и годом издания. Про каждую честно отметь: «уверен, что такая книга есть» или «не уверен, проверь». Не придумывай ссылки и названия, которых не знаешь точно.Что увидишь: рядом с каждой книгой пометку уверенности. Что это даёт: сразу видно, что проверить в поиске перед тем, как кому-то пересылать. Пометка не гарантия: модель может ошибиться и в ней, поэтому названия и годы всё равно сверяй
Приём 3. Числа по шагам. Модель видит число кусками, поэтому большие числа в уме она считает ненадёжно. Проси расписать:
Сколько будет 4738 умножить на 2961? Не считай в уме одним махом: распиши умножение столбиком по шагам и в конце проверь результат обратным действием.Что увидишь: умножение по разрядам и проверку делением, итог 14 029 218. Что это даёт: ошибка, если она есть, видна на конкретном шаге, а не прячется в итоговой цифре
Токены считают и в лимитах: как растянуть лимит Claude Code, разобрано в статье как экономить лимит. А если нужна основа совсем с нуля, без лекций, начни с разбора что такое нейросеть
Сколько это стоит и устарела ли лекция
Смотреть лекцию бесплатно, вход в аккаунт YouTube не нужен. Для трёх приёмов выше хватит любого чат-бота, чем ChatGPT отличается от Claude, есть в сравнении ChatGPT и Claude
Лекция записана в 2024 году. Названные в ней модели и цифры (GPT-4, Llama 3, цены аренды видеокарт) с тех пор устарели, а устройство, которое она объясняет, то же самое: и ChatGPT, и Claude по-прежнему угадывают текст по кусочкам и доучиваются на ответах и оценках людей
Как смотреть по-русски: три пути
Нужен русский голос. Автоматическая озвучка уже есть у самой лекции. В браузере на русском она включается сама, иначе: шестерёнка «Настройки», «Звуковая дорожка», «Русский»
Нужен английский голос и русский текст. Выбери в «Звуковой дорожке» пункт «Английский (US) (оригинальная)», потом «Субтитры», «Перевести» и в списке из 156 языков «Русский»
Нужен другой перевод голосом. Любой ролик на английском Яндекс Браузер умеет переводить голосом поверх оригинала. Как это включить, показано в разборе перевода видео нейросетью. Похожий конспект доклада, только про ИИ-агентов, лежит в разборе доклада Лорен Тан
Что ломается и что делать
Окно cookie и пункт «Перевести» я видел на своём прогоне плеера, остальные строки это подсказки на случай, если увидишь такое у себя:
| Что видишь | Что случилось | Что делать |
|---|---|---|
| окно про cookie закрывает плеер, кнопки не нажимаются | YouTube просит согласие без входа в аккаунт | нажми «Отклонить все», плеер освободится |
| лектор говорит по-английски | браузер или приложение на английском, YouTube выбрал оригинал | шестерёнка, «Звуковая дорожка», «Русский» |
| в «Субтитрах» нет русского | готовых русских субтитров у записи нет | «Перевести», затем «Русский» |
| в меню нет пункта «Звуковая дорожка» | открыта копия лекции с чужого канала, у неё озвучки может не быть | открой оригинал по ссылке из начала статьи, канал Stanford Online |
| чат ответил длинно, хотя строка вставлена | строка потерялась в длинном разговоре | вставь её в начало нового чата |
Таблица прокручивается вбок →
Источники
Страницы открыты 3 октября 2026 года. Метаданные и английская расшифровка лекции сняты с YouTube, меню плеера пройдено мной без входа в аккаунт, токены посчитаны библиотекой OpenAI tiktoken, приёмы проверены в Claude
- Лекция «Building Large Language Models (LLMs)» на YouTube - канал Stanford Online, 1:44:31, главы, английские субтитры и автоматическая озвучка
- Курс CS229 Machine Learning - страница курса Стэнфорда
- Сайт Янна Дюбуа - лектор, его работы и Alpaca
- Scaling Laws for Neural Language Models - работа OpenAI о законах масштабирования, 2020
- Training Compute-Optimal Large Language Models - работа Chinchilla, около 20 токенов на параметр
- LIMA: Less Is More for Alignment - дообучение на малом числе примеров
- Alpaca - блог Стэнфорда, 52 000 примеров из 175 написанных людьми
- Direct Preference Optimization - метод DPO, упрощение обучения на оценках людей
- AlpacaEval - автоматическое сравнение моделей и поправка на длину ответа
- Arena AI (бывшие LMArena и ChatBot Arena) - люди вслепую сравнивают два чат-бота
- Собственный прогон 3 октября 2026 года: меню плеера YouTube на русском без входа, список звуковых дорожек лекции, токены фраз и чисел в словарях o200k_base и cl100k_base, три фразы для чата в Claude
Памятка: лекция Стэнфорда о том, как устроен ChatGPT
Вернуться к лекции без статьи под рукой
Сохрани себе
- запись youtube.com/watch?v=9vM4p9NN0Ts, канал Stanford Online, 1:44:31, лектор Янн Дюбуа, курс CS229
- по-русски: шестерёнка, Звуковая дорожка, Русский
- главные отрезки 03:00-18:50 и 59:40-1:33:40
- модель угадывает следующий кусочек текста, кусочек это токен, в среднем 3-4 буквы английского
- знания из очищенного интернета, манеры из дообучения на ответах людей
- длинные ответы от оценок людей: проси «не больше трёх предложений»
- книги и цитаты: проси пометку «уверен / не уверен» и проверяй
- числа: проси считать по шагам с проверкой
Что дальше
Как устроен чат-бот, ты разобрался, дальше вопрос, что ему поручить
У тебя есть запись с русской озвучкой, таймкоды, шесть мыслей лекции и три фразы для чата. Строку про короткий ответ можно вставить уже сегодня, и разница видна с первого вопроса
Трудность в другом. Знать, как устроена нейросеть, не значит понимать, какие задачи в твоей работе она закроет. Тексты, таблицы, рассылки, ролики: для каждой задачи придётся найти свою связку и свой способ проверки
Я работаю один: тексты, карусели, ролики и статьи вроде этой делает связка нейросетей, а я выбираю и проверяю. На ИИ-Лагере за три дня показываю её изнутри, и ты собираешь свою под свою нишу
Это заявка в мой закрытый канал, не оплата. Впускаю сразу, путёвку на три дня бот пришлёт в личку
Частые вопросы
Где посмотреть лекцию Стэнфорда про ChatGPT?
На YouTube, канал Stanford Online: «Stanford CS229 I Machine Learning I Building Large Language Models (LLMs)», 1 час 44 минуты, выложена 27 августа 2024 года. Смотреть бесплатно, без входа в аккаунт
Есть ли лекция на русском?
Есть автоматическая русская озвучка от YouTube. В браузере на русском она включается сама, иначе: Настройки, Звуковая дорожка, Русский. Ещё можно включить английские субтитры с переводом на русский
Кто читает лекцию?
Янн Дюбуа, на момент лекции аспирант Стэнфорда. Его руководители Перси Лян и Тацунори Хасимото, он работал в команде Alpaca. Это гостевая лекция курса CS229 «Машинное обучение», лето 2024 года
Как устроен ChatGPT, если коротко?
Сначала модель учат угадывать следующий кусочек текста на очищенном интернете, от этого у неё знания. Потом её доучивают на ответах людей и на их выборе лучшего из двух ответов, от этого у неё манера ассистента
Нужно ли знать математику, чтобы понять лекцию?
Для главных мыслей нет: шесть пунктов выше пересказаны без формул. Формулы в лекции есть в частях про обучение и видеокарты, их можно пропустить
Если дочитал до конца
Больше разборов в моём канале
Я соло-предприниматель и веду всю работу на Claude, ChatGPT и агентах. В канале рассказываю, какие лекции и инструменты пробую сам, что прижилось в работе и где я ошибся
Это заявка на вход в мой закрытый канал, одобряю сразу. Бесплатно