Нейросети для кода · Разбор метрик
Как читать бенчмарки ИИ для кода: 41 пункт разницы у одной модели
Про новую модель пишут «решает 79% задач», и рядом сразу вторая новость - «а эта 76%». Выглядит как готовый ответ, кого брать. Я открыл официальные лидерборды и посчитал: у одной и той же модели разброс между наборами задач доходит до 41 процентного пункта, а строка, которая выигрывает один пункт, стоит в одиннадцать раз дороже соседней
Дальше по порядку: что именно считает процент, из-за чего он так пляшет, где на лидерборде лежит колонка, переворачивающая вывод, и почему разница в пару процентов между моделями обычно шум
Открой лидерборд и первым делом посмотри не на верхнюю строку, а на три вещи рядом с ней: имя вкладки с набором задач, номер версии обвязки и колонку со средней ценой прогона. Цифры с разных вкладок не сравниваются между собой, а строка на пункт выше соседней бывает дороже её в десять раз
Что вообще означает процент в бенчмарке
Начать стоит с того, что именно считают, иначе спорить не о чем
Бенчмарк для кода устроен просто: есть набор задач, у каждой задачи есть тесты, модель пишет решение, тесты его прогоняют. Процент - это доля задач, где тесты прошли. Не «красиво написано» и не «мне понравилось», а проверка запуском
Самый старый из живых наборов называется HumanEval, и он маленький: 164 задачи. Это видно прямо в карточке набора у OpenAI. Его придумали вместе с моделью Codex, той самой, что стояла за первым GitHub Copilot
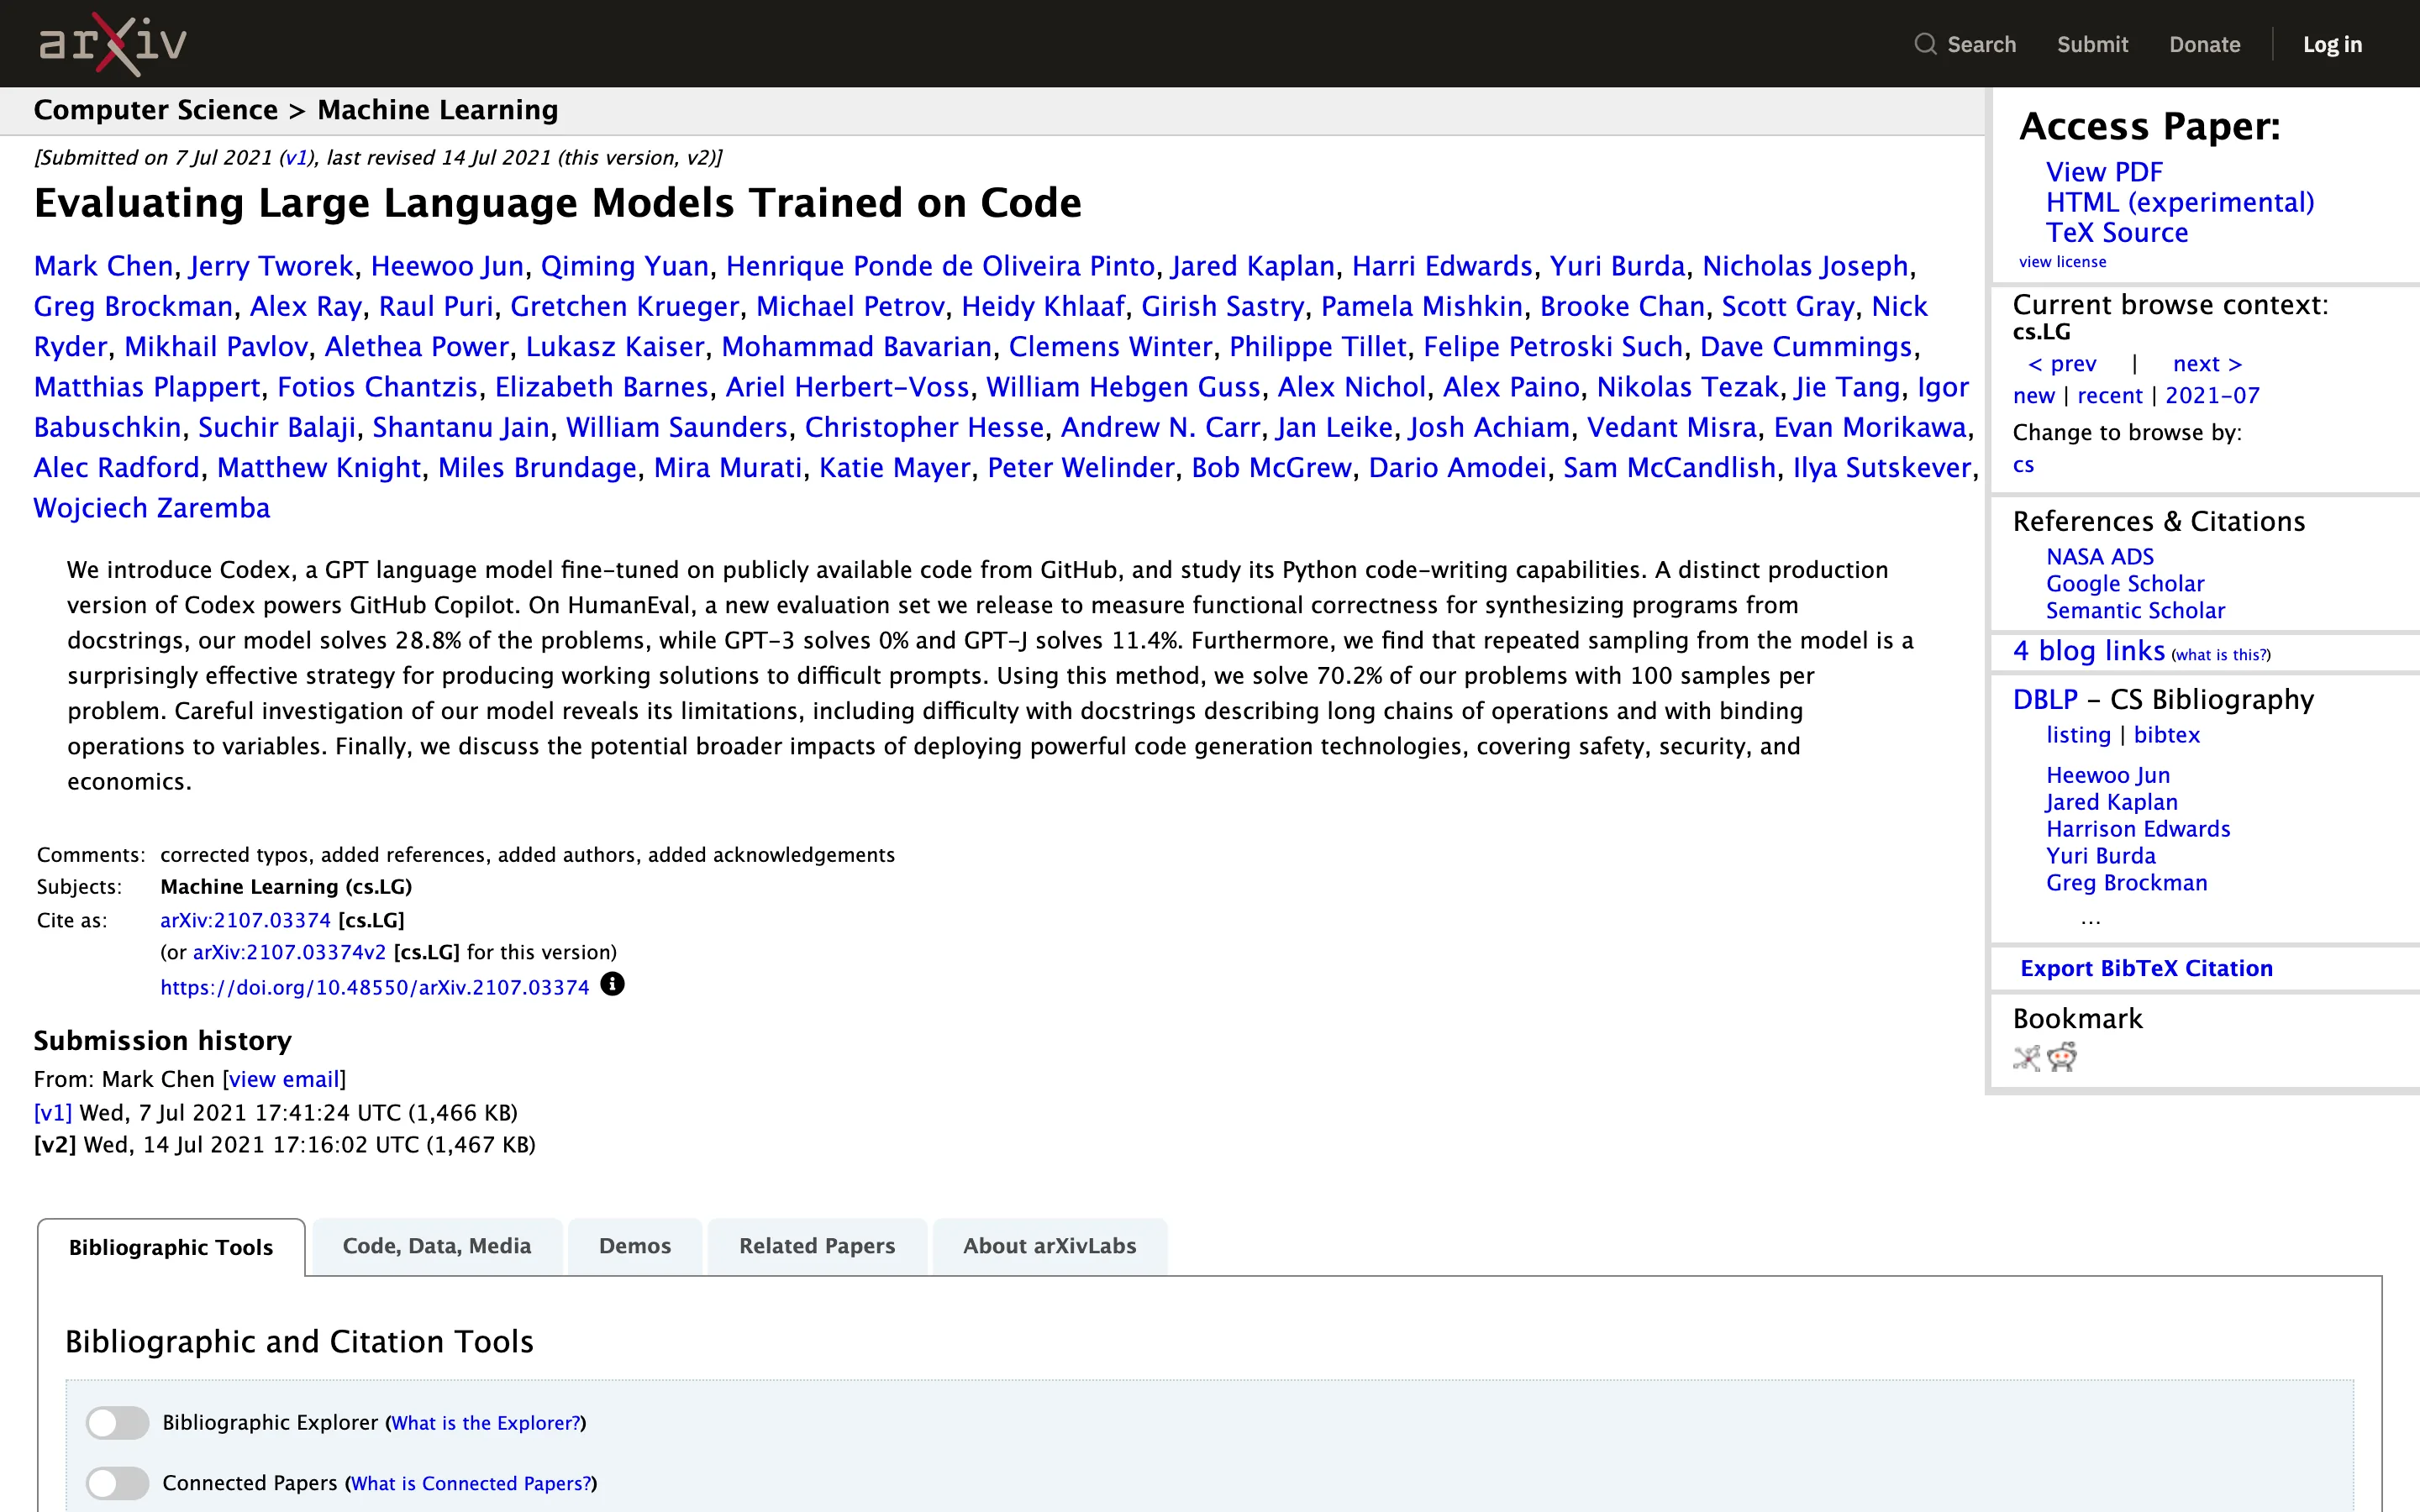
И вот первая ловушка, которая живёт в теме с 2021 года. В той же аннотации авторы пишут: модель решает 28,8% задач. А через две строки - что при ста попытках на задачу решается 70,2%. Один набор, одна модель, разница больше чем вдвое. Отличается только протокол: сколько раз модели дают попробовать
Отсюда правило, которое пригодится дальше везде: процент без протокола не число. Когда в рекламе модели стоит голая цифра без объяснения, как её получили, читать её нельзя
Почему одна и та же модель показывает разные проценты
Здесь я перестал верить на слово и посчитал сам
У SWE-bench не один набор задач, а пять: Verified, Test, Lite, Multilingual и Multimodal. Это разные наборы разной сложности, и результат одной модели на них разный. Насколько - нигде на сайте не написано, потому что таблицы лежат по отдельным вкладкам и рядом их никто не ставит
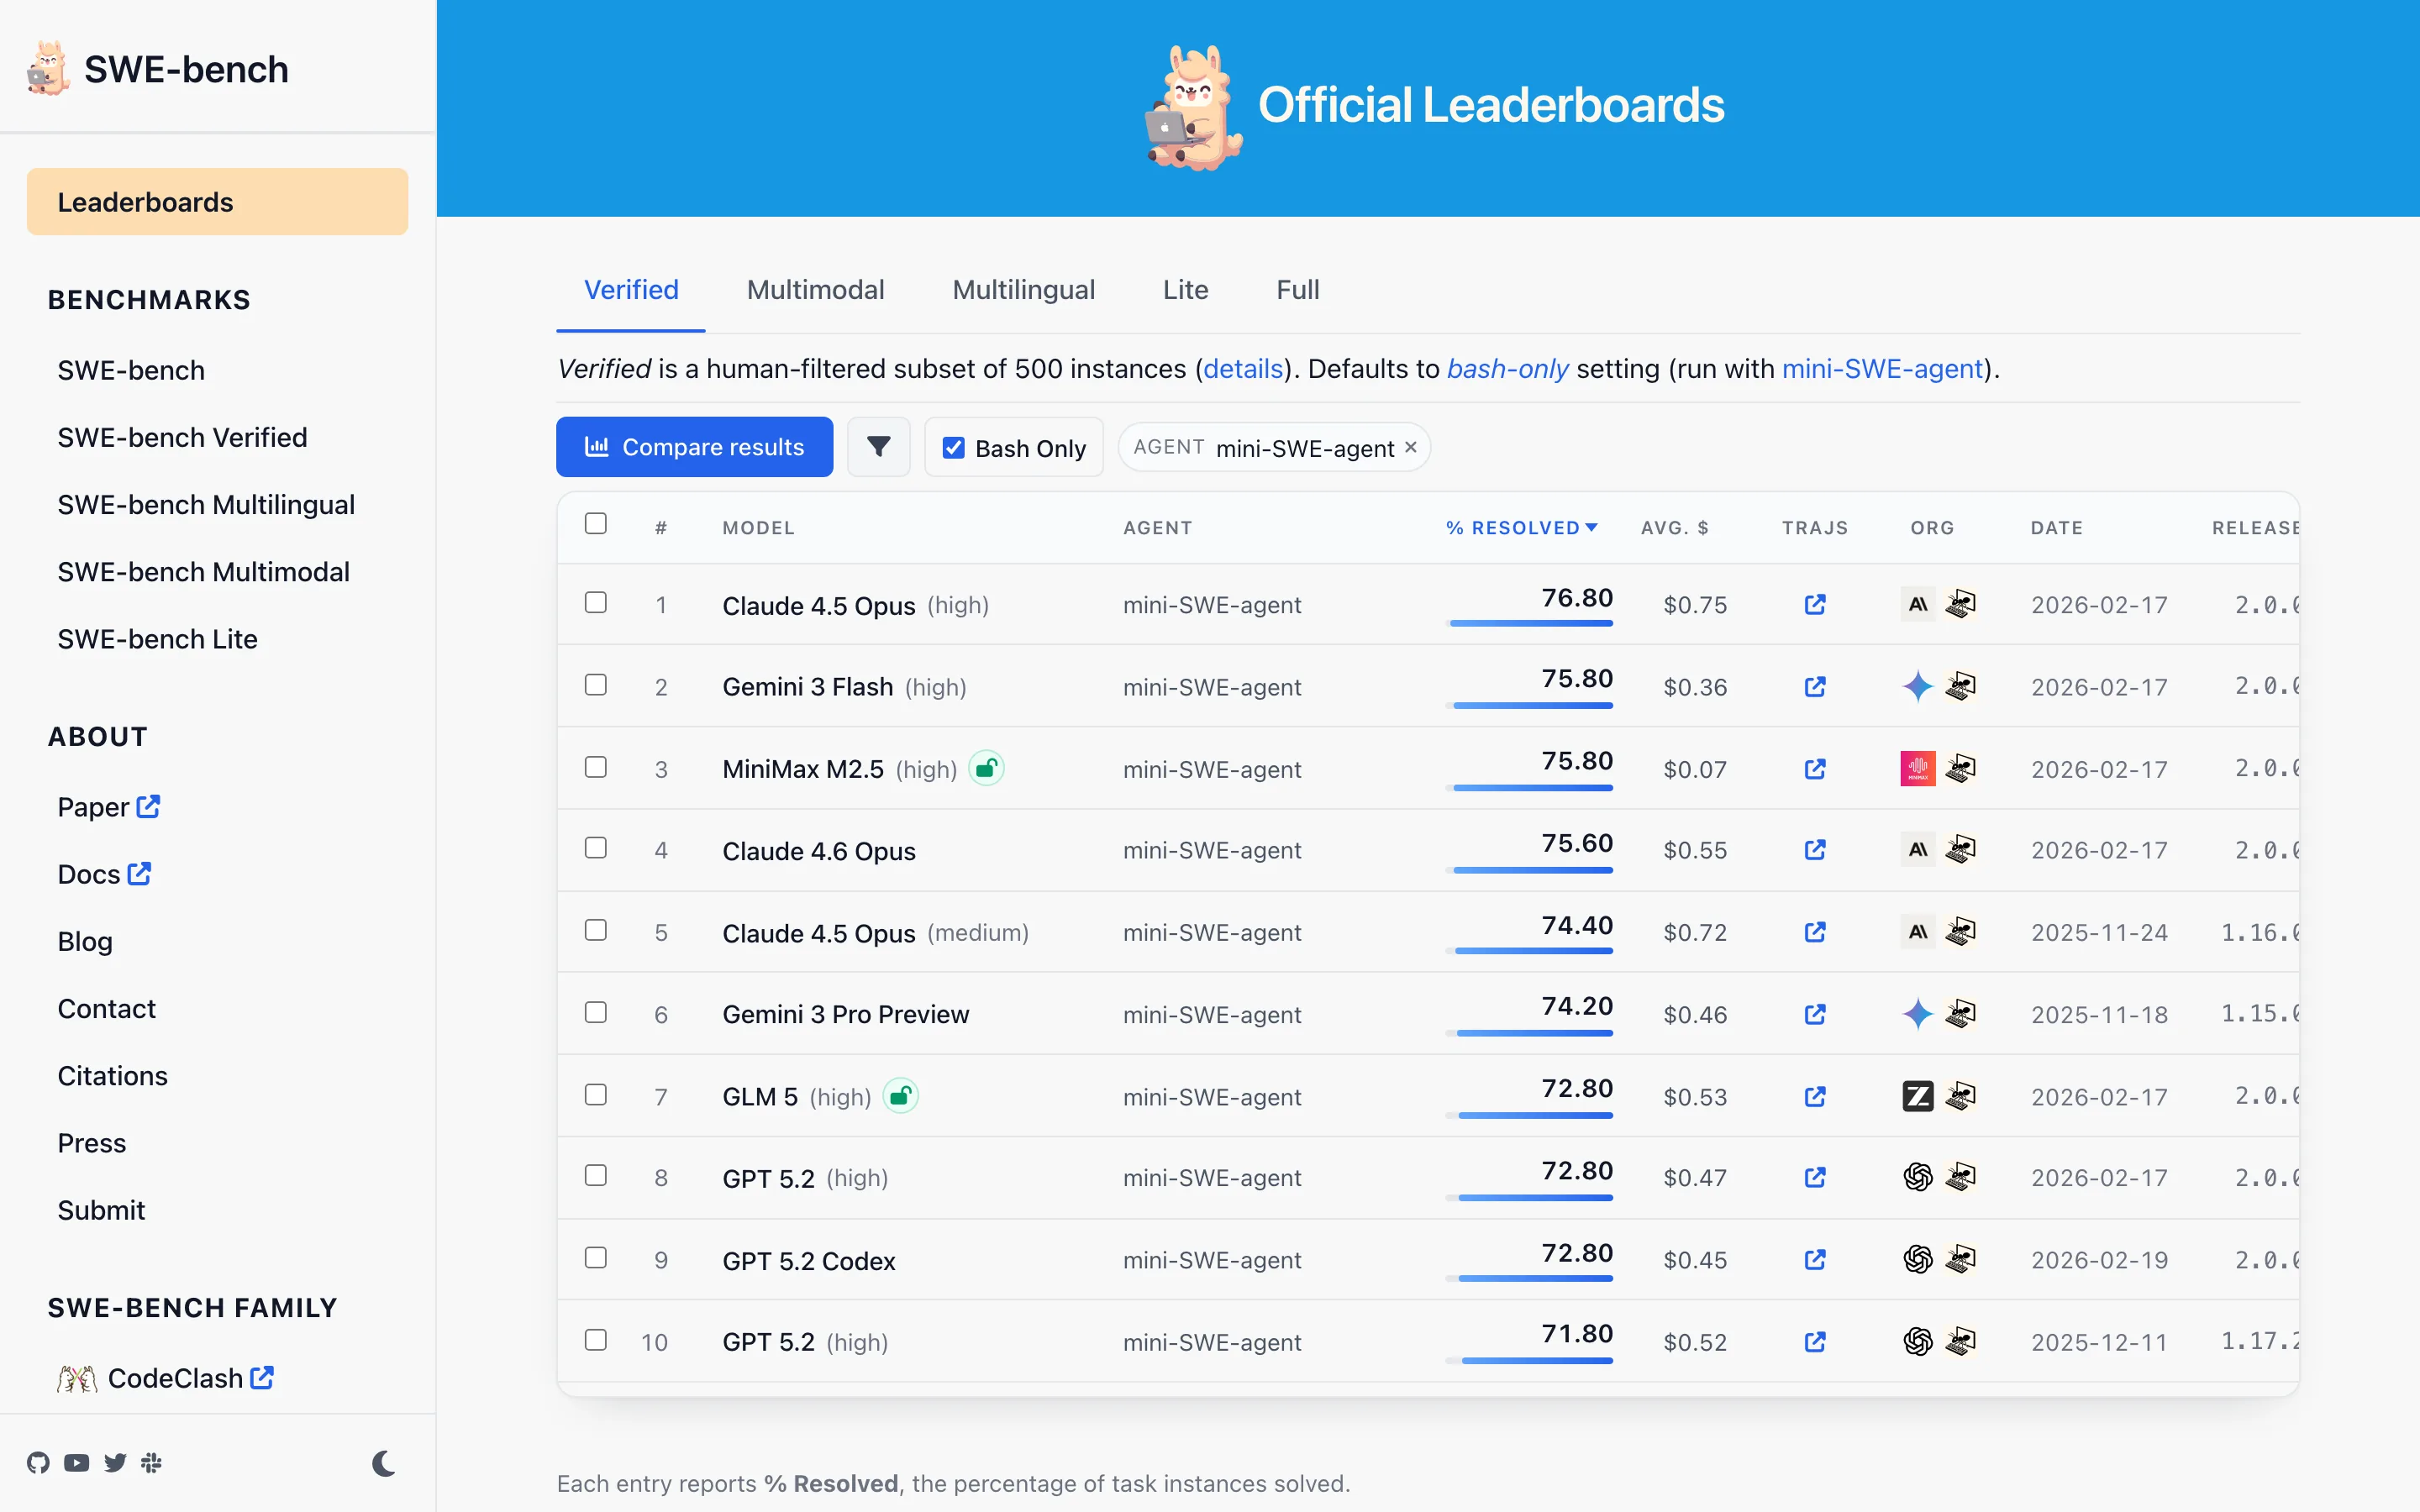
Я взял данные лидерборда как есть и посчитал разброс у одной модели между наборами. Вышло так:
| Модель | Лучший набор | Худший набор | Разброс |
|---|---|---|---|
| Claude 4 Sonnet | Verified 76,8% | Multimodal 35,59% | 41,21 п.п. |
| Claude 4.5 Opus | Verified 79,2% | Test 52,62% | 26,58 п.п. |
| Gemini 3 Pro | Verified 69,6% | Multilingual 68,7% | 0,90 п.п. |
Сорок один процентный пункт у одной модели. Не между моделями - у одной и той же, только на разных наборах задач. Если взять её лучшую цифру и чужую худшую, «победу» можно нарисовать в любую сторону
Обрати внимание и на третью строку: у Gemini 3 Pro разброс меньше процента. То есть беда не в том, что наборы всегда врут, а в том, что сравнивать можно только цифры с одной вкладки. Две цифры из разных наборов не сравниваются вообще никак
Почему Verified почти всегда самый щедрый набор, понятно из его описания: это 500 задач, отобранных людьми совместно с OpenAI - там проверили, что условие понятное, тесты корректные, а задача в принципе решаема. Остальные наборы такой чистки не проходили
Один набор, но разная обвязка: почему цифры всё равно не сходятся
Даже внутри одной вкладки есть развилка, о которой говорят мелким шрифтом
Модель не работает с задачей напрямую. Между ними стоит обвязка - программа, которая даёт модели доступ к файлам, командам и результатам тестов. Одна и та же модель с хорошей обвязкой решает заметно больше
Организаторы это понимают и держат отдельный режим сравнения: Bash Only. В нём всем моделям дают одинаковую минимальную обвязку - простой цикл и доступ к командной строке, без особых инструментов. Это единственное место, где сравниваются именно модели, а не чужие изобретения вокруг них
И там же, на странице набора, стоит предупреждение, которое переворачивает половину чужих сравнений: результаты версий обвязки 1.x и 2.x несравнимы между собой. Во второй версии модель зовёт инструменты напрямую, в первой её действия вылавливали разбором текста ответа. Плюс в первой версии температуру принудительно ставили в ноль, а во второй не задают вовсе
Практический вывод: в таблице есть колонка с номером версии, и она не украшение. Две строки с разными версиями - это два разных замера, даже если набор один
Цена, которой не бывает в заголовках новостей
Самая полезная колонка лидерборда почти никогда не попадает в пересказы
Рядом с процентом на лидерборде стоит средняя стоимость прогона одной задачи. В пересказах её не показывают - а она меняет вывод целиком
Вот три строки из режима Bash Only, снятые в один день с одной вкладки:
| Модель | Решено | Цена задачи |
|---|---|---|
| Claude 4.5 Opus | 76,80% | $0,75 |
| Gemini 3 Flash | 75,80% | $0,36 |
| MiniMax M2.5 | 75,80% | $0,07 |
Две нижние строки решают поровну, а стоят по-разному в пять раз. Верхняя выигрывает у нижней ровно один процентный пункт и стоит дороже почти в одиннадцать раз
На одной задаче эта разница не видна. На тысяче задач это $750 против $70. Поэтому вопрос «какая модель лучше» без слова «за какие деньги» бессмысленный, и это ровно та развилка, которую разбирает материал про выбор фронтир-модели под задачу: лидер таблицы и разумный выбор - обычно разные строки
Загрязнение: когда модель не решает задачу, а вспоминает её
Это единственная проблема темы, которую нельзя увидеть в самой таблице
Задачи бенчмарков лежат в открытом доступе. Модели учат на открытых данных. Дальше понятно: если задача с тестами попала в обучение, модель на экзамене не решает её, а воспроизводит знакомое. Процент растёт, польза нет
Слово для этого - загрязнение данных. Проверить его по самой таблице невозможно: снаружи видно только итог
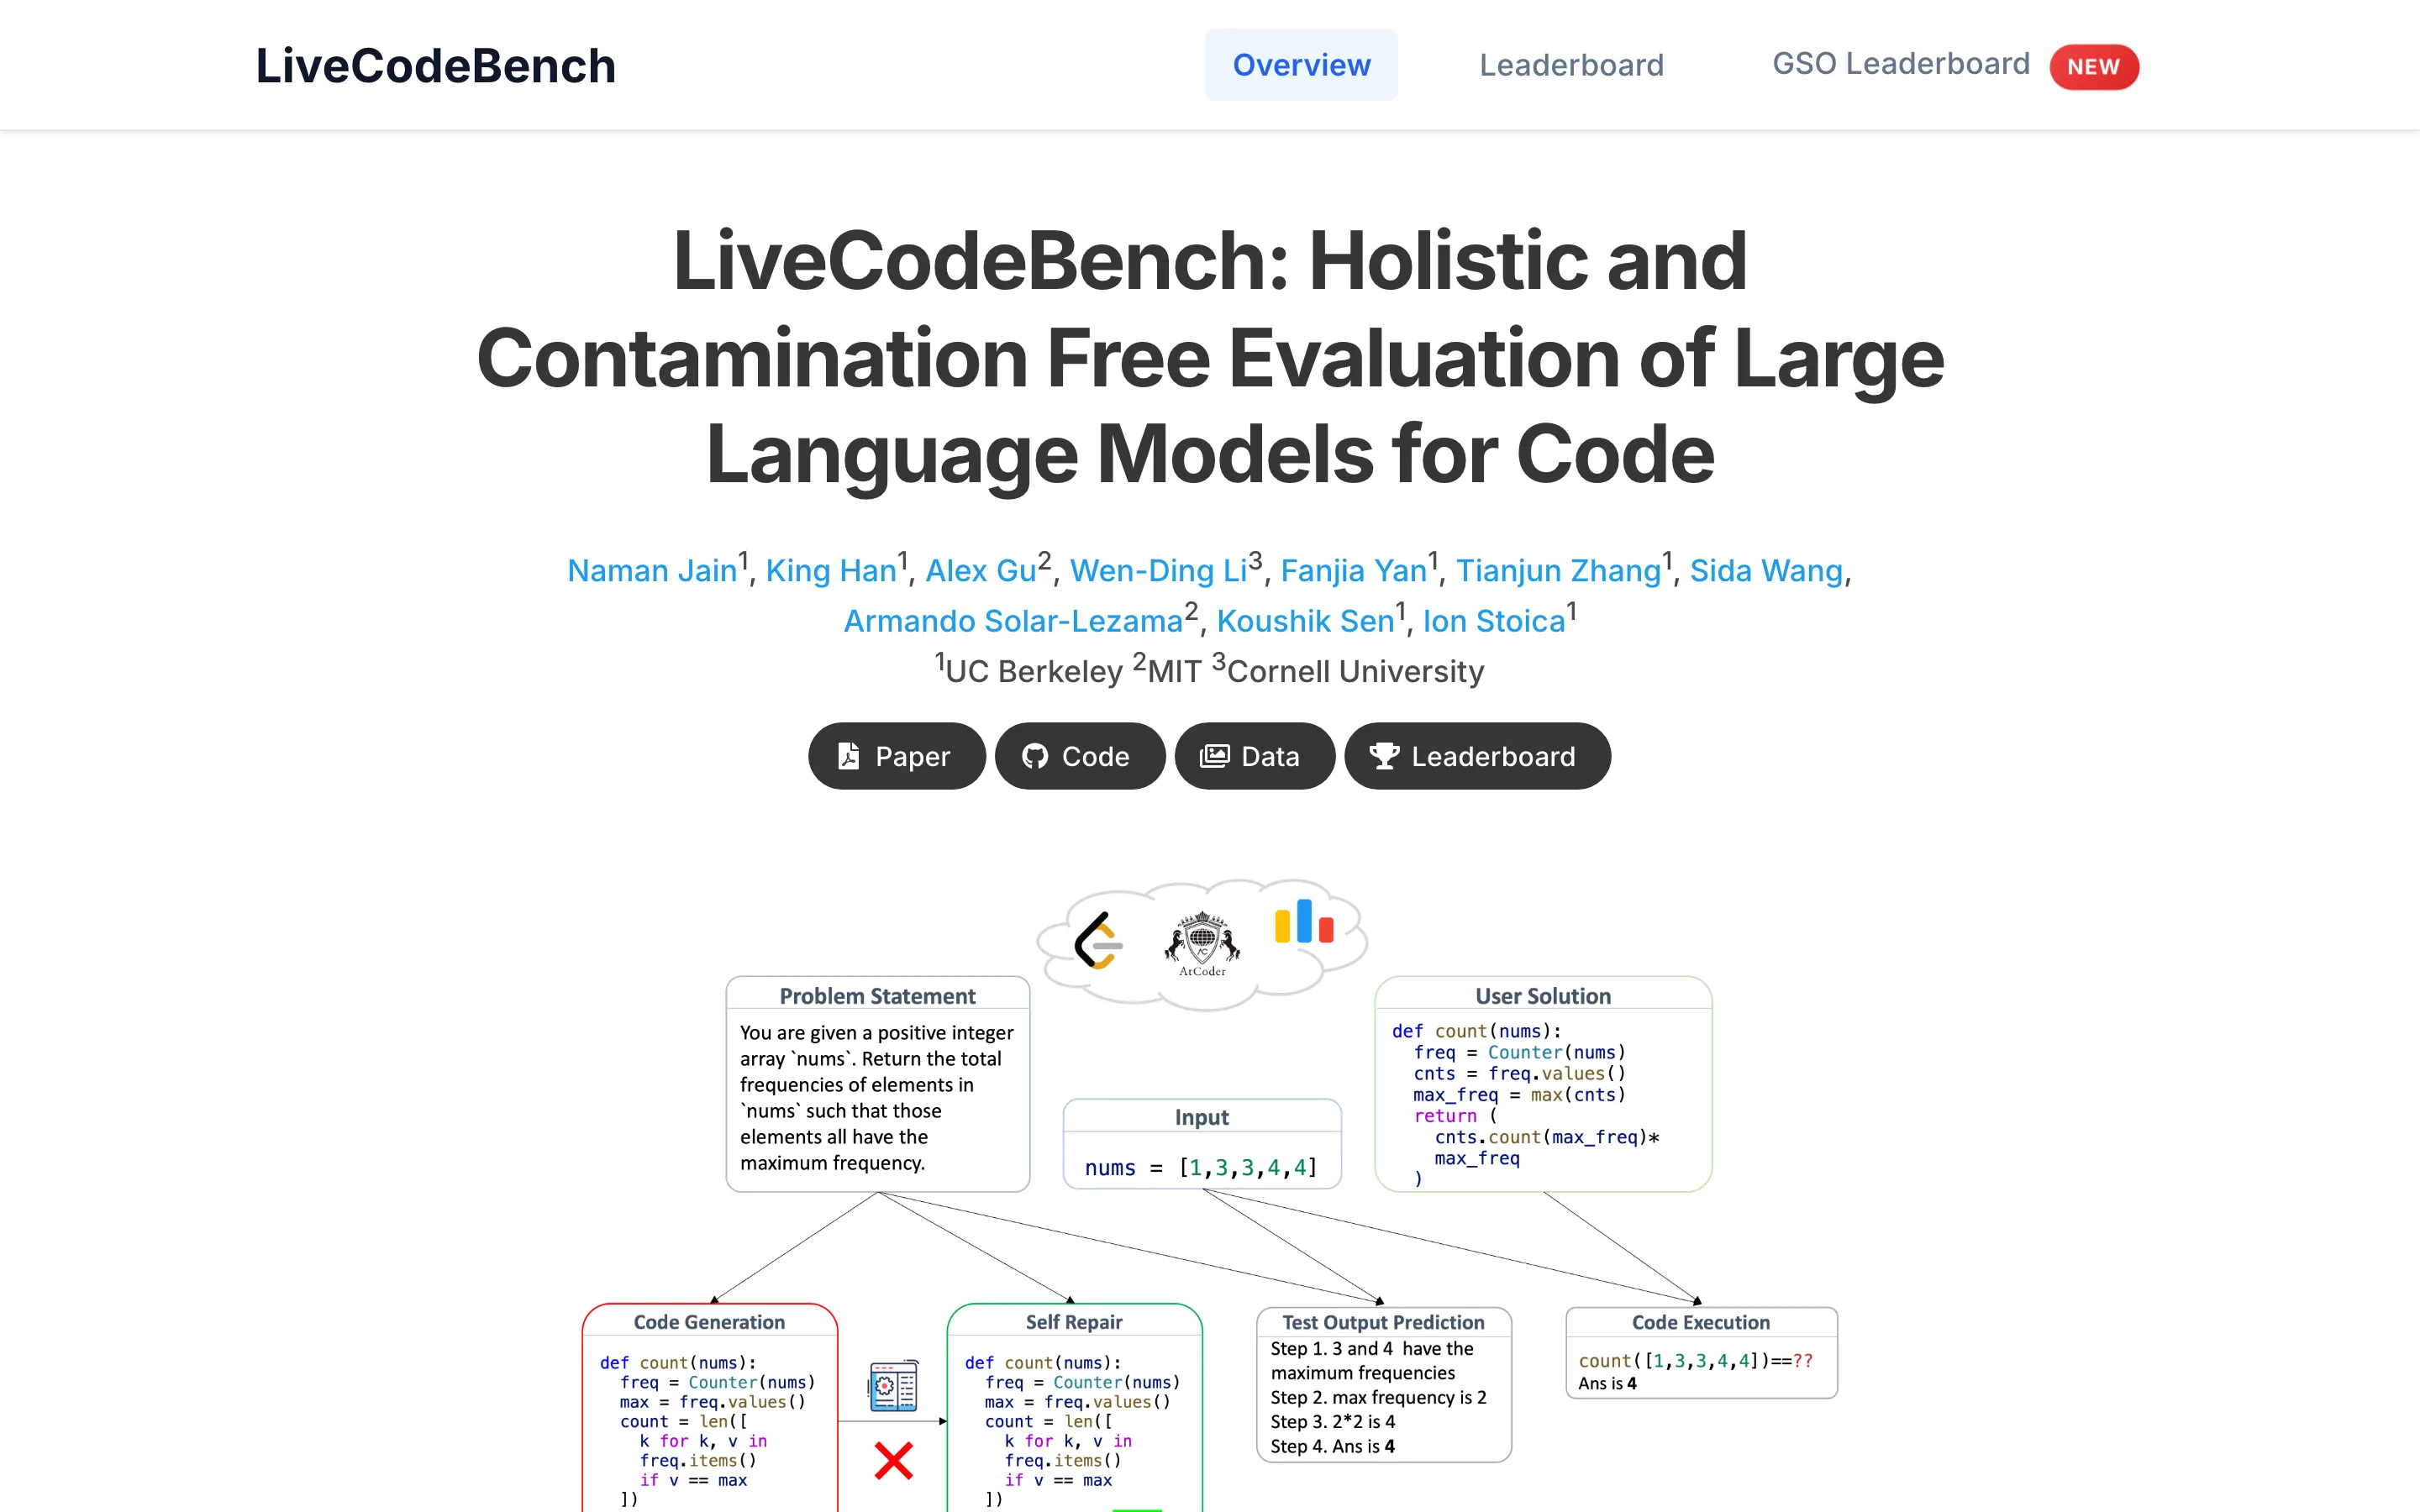
Есть набор, который построен вокруг этой проблемы - LiveCodeBench. Он собирает задачи с живых соревнований и размечает каждую датой публикации. Дальше делается ход, который стоит запомнить: модель проверяют только на задачах, вышедших после даты, на которой её обучение закончилось. Всё, что было раньше, она могла видеть, поэтому не считается
Авторы приводят живой пример, а не рассуждение. У моделей DeepSeek результат резко падает на задачах LeetCode, опубликованных начиная с сентября 2023 - месяца их выхода. У моделей GPT результат по месяцам держится ровно. Первое похоже на память, второе на умение
Второе полезное наблюдение с той же страницы: там проверяют не только написание кода, но и самопочинку, предсказание вывода теста и исполнение кода - четыре разных сценария. И порядок моделей между ними меняется. Модель, первая в написании кода, может оказаться не первой в предсказании результата
Почему разница в пару процентов обычно ничего не значит
Самый частый способ обмануться на ровном месте
Возьми набор Verified: 500 задач. Один процент там - это пять задач. Разница в «полтора процента» между двумя моделями - это семь-восемь задач из пятисот
Теперь вспомни всё, что уже набралось выше и что влияет на исход: версия обвязки, наличие инструментов, температура, число попыток, случайность самой генерации. Каждый пункт двигает результат на сопоставимую величину
Поэтому читать таблицу стоит группами, а не строчками. Верхние строки, где разница в один-два пункта, - это одна группа «примерно одинаковых», и выбирать внутри неё надо по цене, скорости и доступности, а не по месту. Разница начинает что-то значить, когда она в разы, а не в процентах
Проверить это на себе дешевле, чем читать таблицы: берёшь одну свою реальную задачу и прогоняешь её в двух моделях подряд. Как это делается пошагово, я разбирал отдельно - свой тест двух моделей за 10 минут
Я перепроверил эти цифры через неделю, и вот что изменилось
Числа выше сняты 12.09.2026. Бенчмарк - живая таблица, строки в ней приезжают и уезжают, поэтому 19.09.2026 я открыл те же вкладки заново и сверил каждое число, на котором держится статья
| Что проверял | Было 12.09 | Стало 19.09 | Вкладка |
|---|---|---|---|
| Claude 4 Sonnet, верхний результат | 76,80% | 76,80% | Verified |
| Claude 4 Sonnet, тот же набор поменьше | 60,33% | 60,33% | Lite |
| Claude 4 Sonnet, задачи с картинками | 35,59% | 35,59% | Multimodal |
| Разрыв у одной модели | 41,21 п.п. | 41,21 п.п. | три вкладки |
| MiniMax M2.5, цена задачи | $0,07 | $0,07 | Verified, Bash Only |
Все пять значений совпали до знака после запятой. Это и есть практический вывод про срок годности таких цифр: верхние строки лидерборда меняются быстро, а разрывы между наборами держатся неделями, потому что их создаёт устройство наборов, а не свежесть модели
Заодно за эту неделю в таблице Verified появилась новая верхняя строка - 79,20% у связки Claude 4.5 Opus с чужой обвязкой Sonar Foundation Agent. На вкладке Full та же модель с той же обвязкой даёт 52,62%. Одна модель, один агент, две вкладки, разрыв 26,58 пункта - ровно та ловушка, о которой весь этот разбор. Про то, где подобные разрывы вылезают у теста ARC-AGI, есть отдельный материал, а общий разбор того, что нейросеть в коде умеет и где ломается, стоит читать до, а не после выбора модели
Как прочитать любую таблицу бенчмарка за минуту
Короткий порядок действий, который снимает почти все ошибки чтения
Порядок такой, и он один и тот же для любого лидерборда
- Найди имя набора. Оно почти всегда во вкладках сверху. Цифры с разных вкладок не сравниваются - это первое и главное
- Найди колонку обвязки и версии. Если у двух строк разные версии, это два разных замера
- Проверь, есть ли режим честного сравнения. У SWE-bench это галочка Bash Only, она уравнивает условия
- Посмотри на цену. Если колонки с ценой нет, вывод «эта лучше» неполный по построению
- Сгруппируй верх таблицы. Всё, что в пределах двух пунктов, считай одинаковым и выбирай по деньгам
- Посмотри дату строки. Замер годовой давности рассказывает про прошлую версию модели
Шесть шагов занимают меньше минуты и снимают ровно те ошибки, из-за которых человек берёт модель в десять раз дороже ради одного процентного пункта
Источники
- swebench.com - официальные лидерборды пяти наборов, столбцы процента и средней цены прогона, 323 системы на 12.09.2026
- swebench.com, страница набора Verified - 500 задач, отобранных людьми совместно с OpenAI, описание режима Bash Only и предупреждение о несравнимости версий 1.x и 2.x
- arXiv 2107.03374, «Evaluating Large Language Models Trained on Code» - исходная работа про HumanEval, цифры 28,8% с одной попытки и 70,2% со ста
- huggingface.co, карточка набора openai_humaneval - размер набора: 164 задачи
- livecodebench.github.io - метод разметки задач датами публикации, четыре сценария проверки и пример падения результата DeepSeek на задачах после сентября 2023
Шесть проверок перед тем, как поверить таблице
Пробегаешь по ним сверху вниз, занимает меньше минуты
Сохрани себе
- Нашёл имя набора задач и не сравниваю цифры с разных вкладок
- Посмотрел версию обвязки: разные версии - это разные замеры
- Включил режим честного сравнения моделей, если он есть (у SWE-bench это Bash Only)
- Нашёл колонку с ценой прогона и посчитал, во сколько обходится лишний пункт
- Сгруппировал верх таблицы: разница внутри двух пунктов - это одинаковые строки
- Проверил дату замера, чтобы не читать результат прошлой версии модели
Таблицы читаются
Осталось выбрать модель под свою задачу, а не под чужую таблицу
Ты знаешь, где на лидерборде лежит подвох, почему один процент бывает дороже в десять раз и как проверить загрязнение. Дальше начинается работа: взять свою задачу и собрать на ней результат Три дня ИИ-Лагеря стоят ноль, и ставить для них ничего не нужно
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Какой бенчмарк считать главным для кода?
Главного нет, и это не отговорка. SWE-bench Verified ближе к реальной работе: там задачи из настоящих проектов с настоящими тестами. LiveCodeBench честнее по части загрязнения, потому что меряет модель на задачах, вышедших после её обучения. HumanEval - исторический набор на 164 задачи, по нему сегодня выбирать нечего
Почему в одной новости модель 79%, а в другой та же модель 52%?
Скорее всего, взяты разные наборы задач. У SWE-bench их пять, и у Claude 4.5 Opus между Verified и Test разница 26,58 процентного пункта - я считал это по данным официального лидерборда 12.09.2026. Сравнивать можно только цифры с одной вкладки
Что такое загрязнение данных простыми словами?
Задача из бенчмарка попала в обучение модели, и на экзамене модель её вспоминает, а не решает. Снаружи это выглядит как высокий процент. Признак загрязнения виден, когда результат резко падает на задачах, опубликованных после даты обучения модели
Стоит ли брать модель из верхней строки лидерборда?
Сначала посмотри на цену. В режиме Bash Only на 12.09.2026 верхняя строка решала 76,80% при $0,75 за задачу, а третья - 75,80% при $0,07. Один процентный пункт обходился почти в одиннадцать раз дороже, и на объёме это решает
Можно ли вообще доверять этим процентам?
Им можно доверять ровно как экзаменационной оценке: она про экзамен, а не про человека. Проценты полезны, чтобы отсечь совсем слабые варианты, а выбор между близкими строками делается своей задачей, прогнанной в двух моделях подряд
Почему организаторы сами пишут, что версии несравнимы?
Потому что между ними поменялся способ работы модели с инструментами: во второй версии она зовёт их напрямую, в первой действия вылавливали разбором текста ответа. Плюс поменялись настройки температуры. Это честное предупреждение, и оно стоит прямо на странице набора
Если дочитал до конца
Дальше я пишу в своём канале
Я работаю один, без команды и подрядчиков: всё собираю Claude, Claude Code и агентами. В канале выкладываю внутрянку своих проектов по отдельности: что строю прямо сейчас, чем именно, что сработало, а что развалилось и почему. Разборов там заметно больше, чем доезжает до сайта
Это заявка на вход в мой закрытый канал, одобряю сразу. Бесплатно