n8n · локальные нейросети
Локальная модель в n8n: 1 тумблер, без которого нет ответа
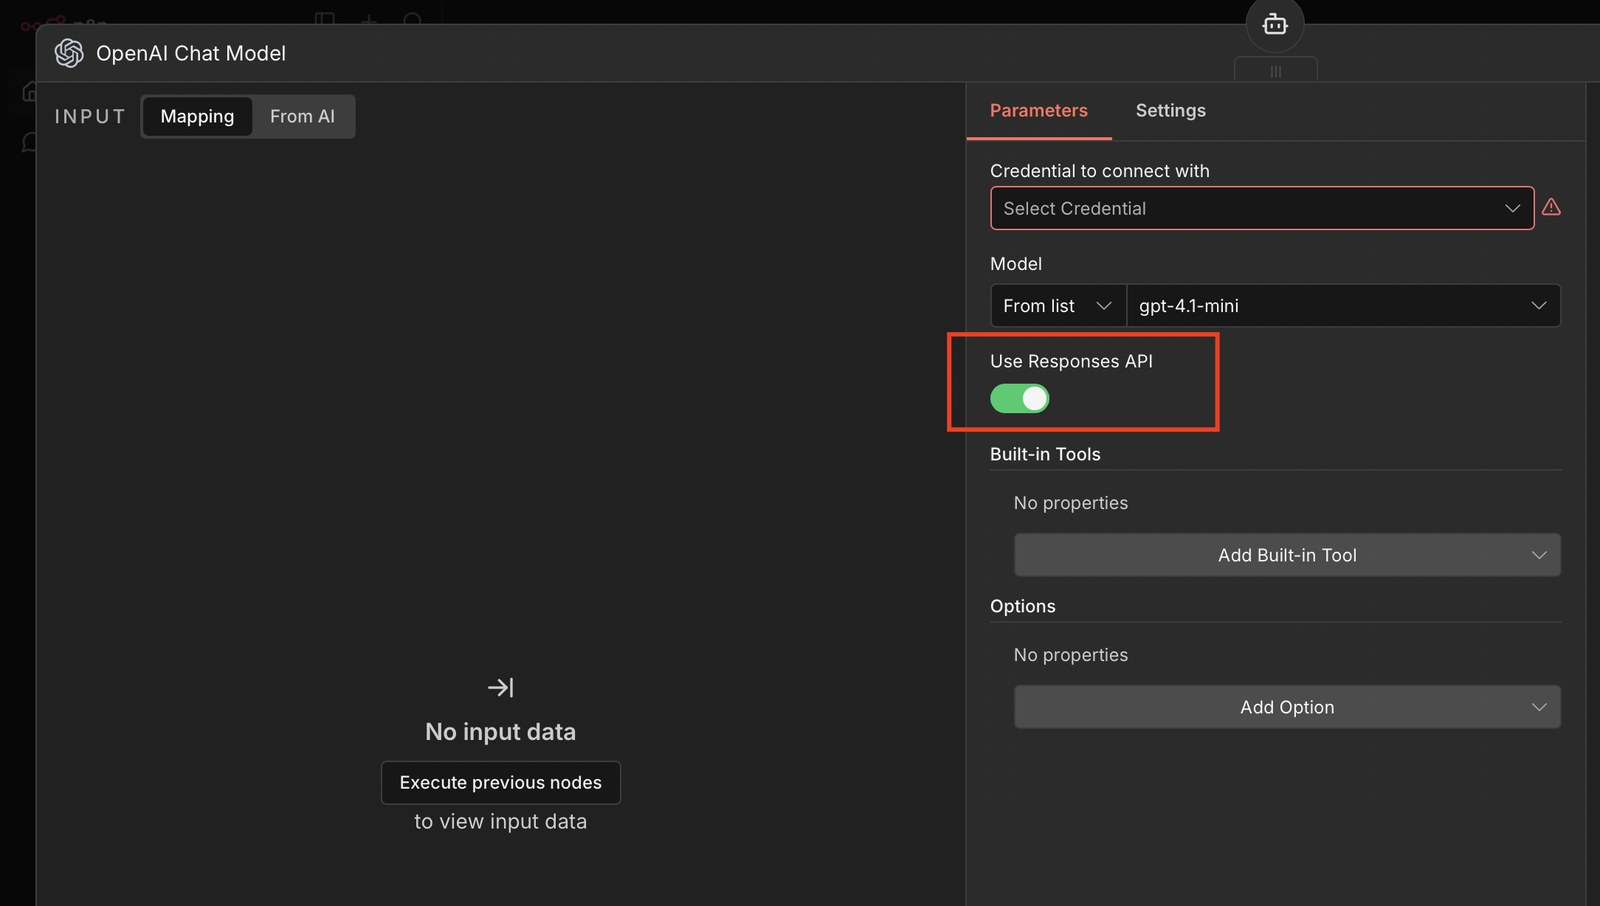
19 октября 2026 года n8n выпустил в своём блоге разбор, как запускать сценарии на своих моделях без облака. Главное в нём для тебя - одна строка: нода OpenAI Chat Model с версии 1.3 сама включает переключатель Use Responses API. Локальная модель, которая этот новый формат запросов не понимает, такой ноде не отвечает
Открой в сценарии ноду OpenAI Chat Model. Под полем Model найди этот переключатель: он зелёный. Нажми на него, он станет серым. Теперь нажми Execute step: справа в выводе появится ответ модели вместо ошибки «Bad request - please check your parameters». Если ответа всё равно нет, открой учётку ноды (поле Credential to connect with, там хранятся адрес и ключ модели) и проверь в ней поле Base URL: там адрес программы, в которой работает модель, с /v1 на конце:
Ollama на этом же компьютере:     http://localhost:11434/v1
LM Studio на этом же компьютере:  http://localhost:1234/v1
n8n запущен в Docker:             http://host.docker.internal:11434/v1
Для LM Studio в последней строке вместо 11434 ставь 1234
Когда модель ответила, пройди по остальным нодам OpenAI Chat Model в своих сценариях: у каждой новой ноды этот переключатель включён заново. Нода, в которой переключателя нет вовсе, старая и работает как раньше, её не трогай
Почему ломается только новая нода
Переключатель появился у ноды версии 1.3. Ноды, которые ты добавил в сценарий раньше, остались на старой версии: переключателя у них нет, и они ходят к модели по прежнему формату. Поэтому картина обычно такая: старый сценарий с локальной моделью работает, а новый, собранный вчера, молчит
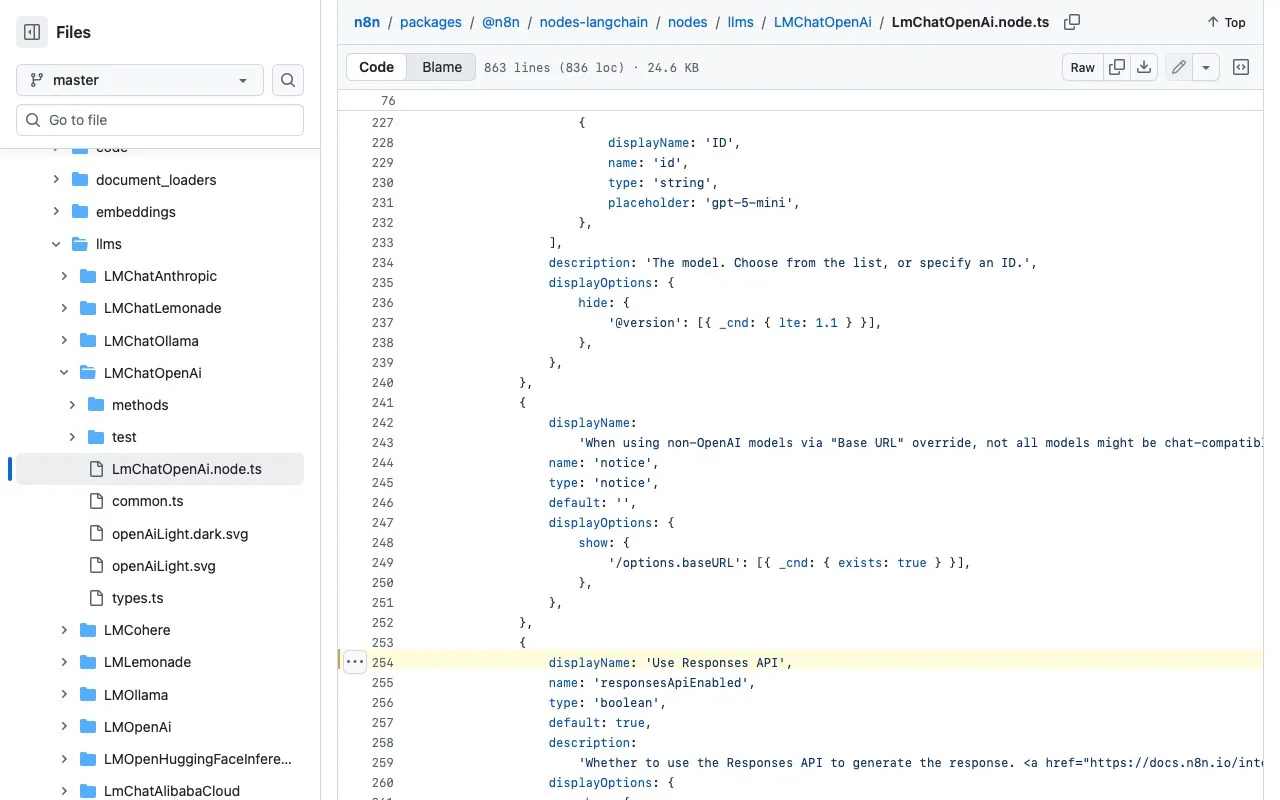
Я скачал свежий набор нод n8n, который сейчас раздаётся для установки, и открыл в нём файл ноды OpenAI Chat Model. Вот что в нём стоит:
229:                    displayName: 'Use Responses API',
230-                    name: 'responsesApiEnabled',
231-                    type: 'boolean',
232-                    default: true,
Последняя строка значит «включено по умолчанию». Набор нод версии 2.44.3, свежий n8n на 21 октября версии 2.44.5. То же видно и в исходнике на GitHub:
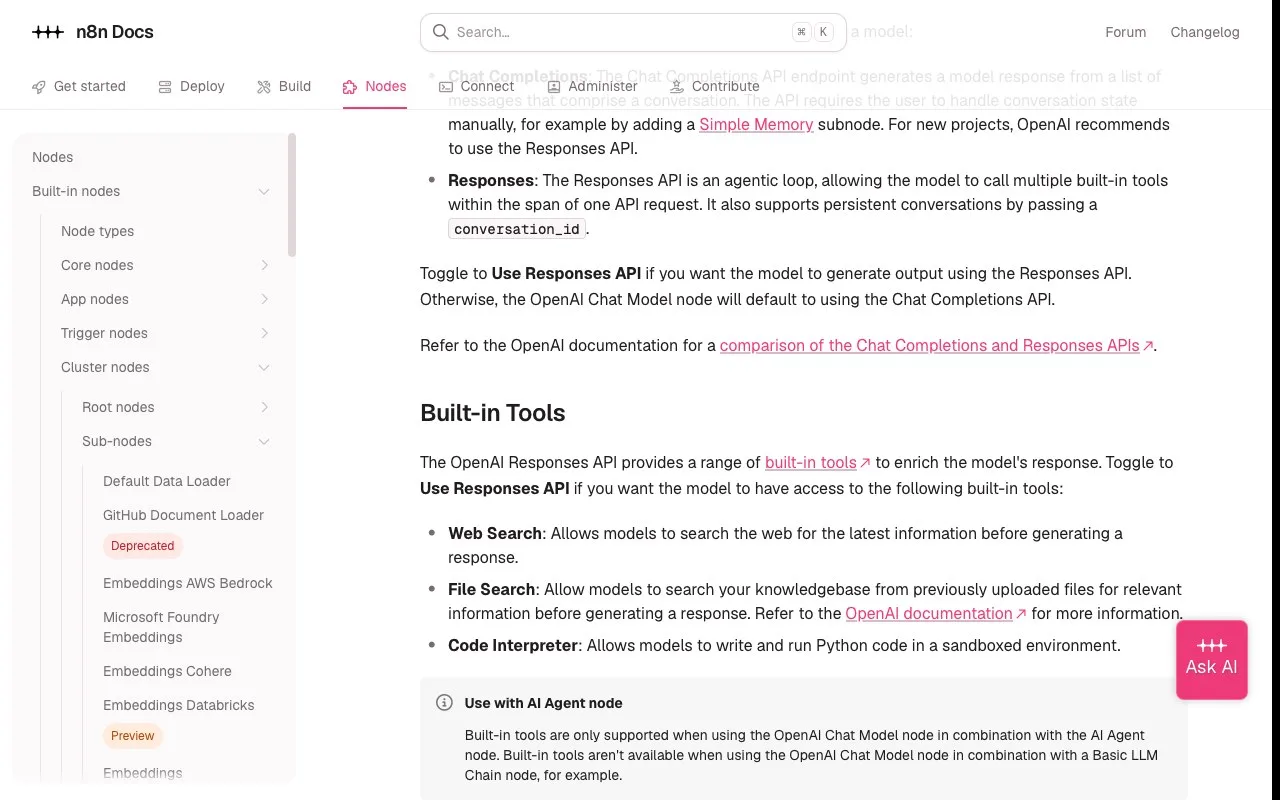
Справке n8n в этом месте не верь. На странице ноды написано, что без переключения она работает по старому формату Chat Completions, а в коде всё наоборот. Ориентируйся на окно ноды: что видишь там, то и работает
У тебя Ollama: можно вообще без переключателя
В n8n есть отдельная нода Ollama Chat Model со своей учёткой Ollama. Переключателя у неё нет, путать нечего. Если сценарий новый, бери его: в учётке укажи адрес Ollama, а модель выбери в поле Model. Как поставить саму Ollama и выбрать модель по памяти компьютера, я разбирал в гайде по установке Ollama
Через ноду OpenAI Chat Model Ollama тоже работает, и с включённым переключателем свежая Ollama даже ответит: новый формат она понимает с версии 0.13.3. Но понимает не целиком: продолжать разговор по его номеру на своей стороне она не умеет. Чтобы не ловить это на втором сообщении, переключатель всё равно выключай
У тебя LM Studio: где увидеть, что виноват переключатель
В LM Studio каждый запрос видно в её журнале, и по нему причина находится за секунду. Открой журнал и запусти ноду ещё раз. Если в журнале появилась строка с адресом /v1/responses и ошибкой про text.format, n8n отправил запрос в новом формате, а LM Studio его не приняла. Выключи переключатель и запусти снова: в журнале будет адрес /v1/chat/completions, а в n8n ответ модели. Этот случай описан на форуме n8n целиком, с журналом до и после
Свежие версии LM Studio по справке уже понимают и новый формат. Если у тебя такая, ошибки может и не быть. Правило от этого не меняется: старый формат понимают все программы для локальных моделей, а новый не все и не целиком
| Где работает модель | Прежний формат (переключатель выключен) | Новый формат (переключатель включён) |
|---|---|---|
| Ollama | понимает | понимает с версии 0.13.3, но без продолжения разговора на своей стороне |
| LM Studio | понимает | свежие версии понимают; на версиях постарше ошибка про text.format |
| Общий компьютер команды через посредник LiteLLM, как в разборе n8n | понимает | разбор n8n велит выключать; в функции Agents второе сообщение падает |
Таблица прокручивается вбок →
Модель нужна всей команде сразу
Разбор n8n от 19 октября как раз про этот случай. Автор собрал на одном офисном компьютере NVIDIA DGX Spark семь моделей сразу: для ответов, распознавания речи, чтения документов, поиска по своим файлам и картинок. Все семь заняли 108 ГБ из 121 ГБ, которые видела система. Спереди стоит одна программа-посредник LiteLLM: у всех моделей один адрес, а у каждой команды свой ключ. В учётке n8n этот адрес идёт в Base URL, и тот самый переключатель автор выключает
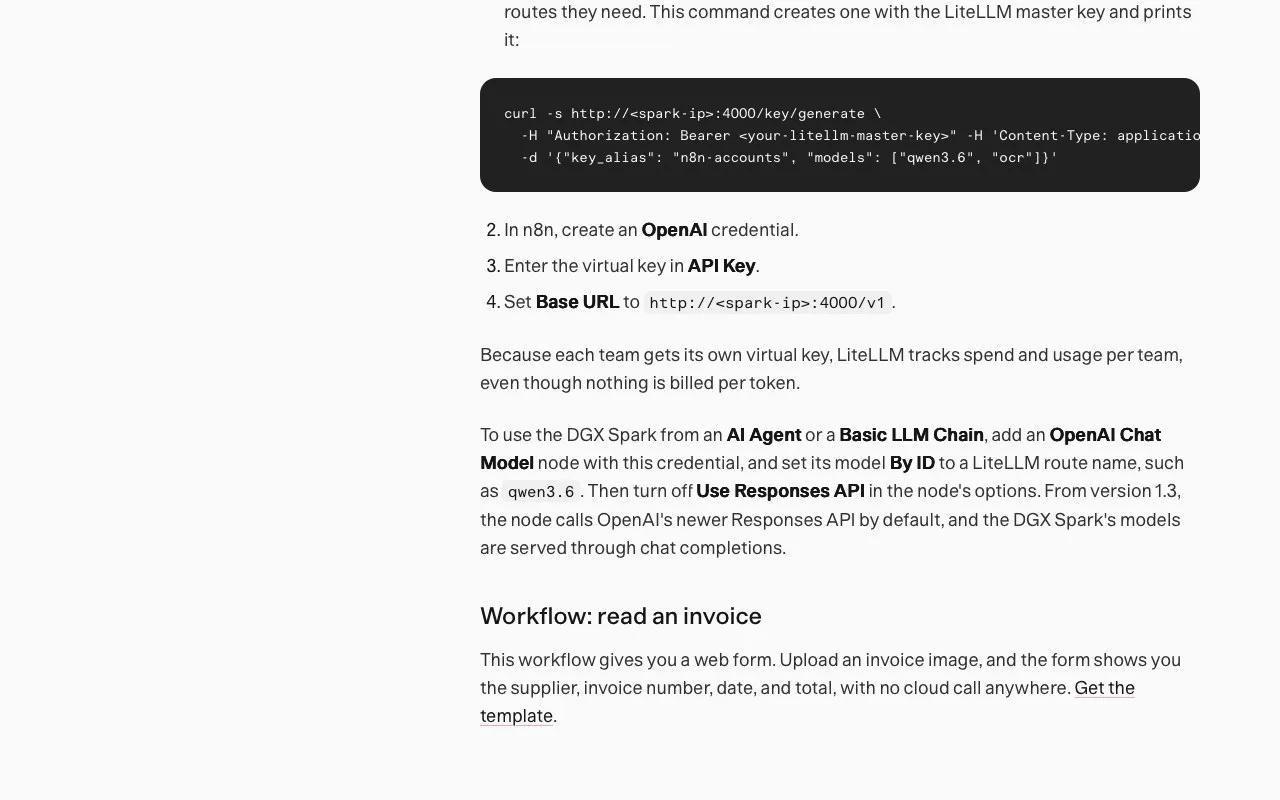
Из того же разбора стоит забрать три вещи, даже если у тебя обычный компьютер, а не такая коробка:
| Что заметили в разборе | Цифра | Что делать у себя |
|---|---|---|
| Картинка рисуется, пока люди ждут ответов | ответы одному человеку замедлились втрое, со 122 до 38 кусочков слова в секунду: видеокарта у всех задач одна | рисование ставить в очередь на нерабочее время |
| Модель размышляет над бланком, у которого одна форма | разбор счёта 12,1 секунды с размышлениями и 0,59 без них, все пять полей верны | на таких задачах размышления выключать |
| Картинка по умолчанию рисуется дольше нужного | около 48 шагов и 72 секунды вместо 8 шагов и 12,2 секунды | число шагов задавать самому |
Таблица прокручивается вбок →
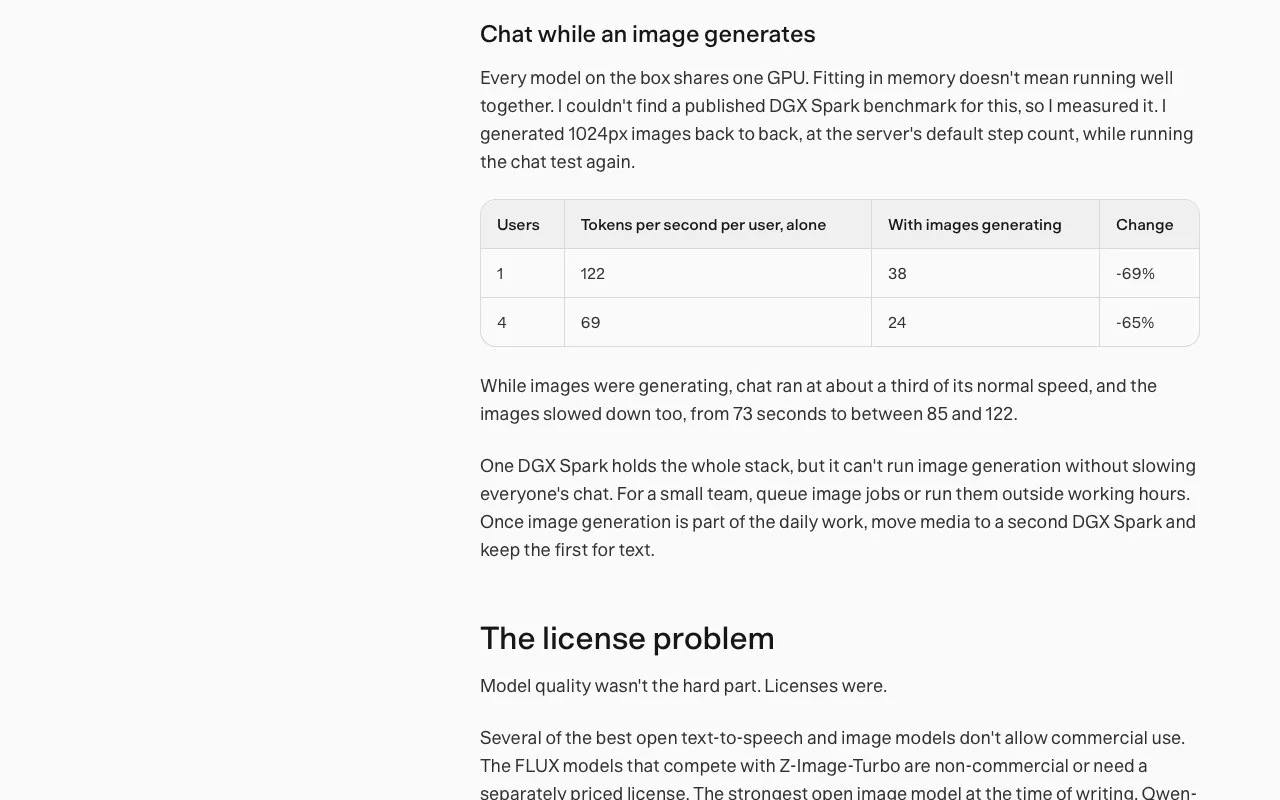
Ещё одна деталь оттуда пригодится любому: программа распознавания речи Whisper на тишине в конце записи сама дописала «Thank you.». Обрезай тишину в конце записи, прежде чем отдавать её модели
Что ломается и что делать
| Что видишь | Что это значит | Что делать |
|---|---|---|
| В n8n ошибка «Bad request - please check your parameters» | нода отправила запрос в новом формате, программа модели его не поняла | выключить переключатель в ноде и запустить снова |
| В журнале LM Studio адрес /v1/responses и ошибка про text.format | то же самое, только видно со стороны LM Studio | выключить переключатель; после этого в журнале будет /v1/chat/completions |
| Первое сообщение проходит, второе падает с «Unsupported Responses API input item type: 'item_reference'» | новая функция Agents в n8n ходит в новом формате, а посредник LiteLLM не хранит историю разговора | на 21 октября переключателя в Agents нет, ошибка открыта в GitHub n8n; бери сценарий с нодами AI Agent и OpenAI Chat Model, где переключатель выключается |
| Ошибка соединения, хотя модель запущена | в Base URL полный адрес с /chat/completions на конце либо n8n работает в Docker | оставить адрес до /v1; во втором случае адрес http://host.docker.internal:11434/v1 |
| Модель в списке не находится | у Ollama и LM Studio свой список моделей, не как у OpenAI | в поле Model выбрать By ID и вписать имя модели так, как его показывает программа |
Таблица прокручивается вбок →
Что ещё почитать про n8n и свои модели
- n8n и нейросеть: цепочка из 6 нод - первый сценарий от заявки до строки таблицы
- Как установить Ollama - четыре шага и выбор модели по памяти компьютера
- Ollama или LM Studio - чем отличаются и что поставить себе
- Локальные нейросети - что потянет твой компьютер
- ИИ без интернета: что ставить первым - если локальной модели ещё нет вовсе
- Автоматизация бизнеса - как выбрать первый процесс, который отдать сценарию
Источники
- Блог n8n: сценарии на своих моделях без облака на NVIDIA DGX Spark - разбор от 19 октября 2026 года: шаг подключения n8n с выключением переключателя, семь моделей на одном компьютере, замеры скорости
- Исходник ноды OpenAI Chat Model на GitHub - переключатель со значением по умолчанию true для версий ноды от 1.3
- Справка n8n по ноде OpenAI Chat Model - описание переключателя и двух форматов запросов
- Ollama: совместимость с OpenAI - адрес localhost:11434/v1 и поддержка нового формата без продолжения разговора с версии 0.13.3
- LM Studio: совместимость с OpenAI - адрес localhost:1234/v1 и список поддерживаемых адресов запросов
- Форум n8n: LM Studio и n8n, рабочая связка - ошибка «Bad request», журнал LM Studio до и после выключения переключателя
- GitHub n8n, ошибка 40392 - функция Agents и LiteLLM: падение на втором сообщении с item_reference
- Справка Docker Desktop: связь программы в контейнере с компьютером - особое имя компьютера для программ в контейнере
Памятка: модель в n8n не отвечает
Сохрани себе, пригодится при каждом новом сценарии с локальной моделью
Сохрани себе
- Новая нода OpenAI Chat Model → выключить Use Responses API, он включён сам
- Переключателя в окне ноды нет → нода старая, работает по прежнему формату, не трогать
- Ollama → можно взять ноду Ollama Chat Model, переключателя у неё нет
- Base URL для Ollama → http://localhost:11434/v1
- Base URL для LM Studio → http://localhost:1234/v1
- n8n в Docker, модель на этом же компьютере → host.docker.internal вместо первой части адреса
- В Base URL только адрес до /v1, без /chat/completions
- Модель указывать By ID, именем, которое показывает программа модели
- Ошибка непонятна → открыть журнал программы модели и посмотреть, на какой адрес пришёл запрос
Что дальше
Связка работает. Осталось решить, что через неё пропускать
Переключатель выключен, модель отвечает. На этом шаге застревает большинство: ошибка в n8n не говорит, что дело в формате запроса, и люди меняют модели, адреса и версии, пока не бросят
Но сценарий из одной ноды с ответом пока ничего не делает за тебя. Пользу даёт цепочка: заявка пришла, модель её разобрала, строка легла в таблицу, человек получил ответ
Я так работаю каждый день, на Claude и агентах. На Концентрате показываю, как выбрать задачу, отдать её помощнику и проверять результат, а не переделывать за ним
Откроется в Telegram
Частые вопросы
Почему локальная модель не отвечает в n8n?
Чаще всего из-за переключателя Use Responses API в ноде OpenAI Chat Model. С версии ноды 1.3 он включён сам и отправляет запросы в новом формате, а многие программы для локальных моделей понимают только прежний формат Chat Completions. Выключи переключатель и запусти ноду снова
Где в n8n переключатель Use Responses API?
В окне ноды OpenAI Chat Model, на вкладке Parameters, сразу под полем Model. Если его там нет, нода старой версии и ходит по прежнему формату
Какой адрес вписать в Base URL для Ollama и LM Studio?
Для Ollama на этом же компьютере http://localhost:11434/v1, для LM Studio http://localhost:1234/v1. Если n8n запущен в Docker, возьми третий адрес из блока в начале статьи
Что нового n8n показал 19 октября 2026 года?
Разбор, как собрать на одном компьютере NVIDIA DGX Spark семь открытых моделей и подключить к ним сценарии n8n без облака. В нём же совет выключать этот переключатель и замер: пока рисуется картинка, текстовые ответы замедляются втрое
Нужен ли DGX Spark, чтобы n8n работал с локальной моделью?
Нет. Для одного человека хватает Ollama или LM Studio на обычном компьютере, это сказано и в самом разборе n8n. Отдельный компьютер вроде DGX Spark нужен, когда моделью пользуется вся команда сразу
Читать дальше
Я соло-предприниматель на Claude, ChatGPT и агентах
Всё, что не влезает в статью, лежит у меня в канале: как я работаю с нейросетями каждый день, новости ИИ с разбором, что они меняют для тебя, и внутрянка моих проектов
Открытый канал, подписка в одно нажатие