Гайд · локальные нейросети · сентябрь 2026
Muse Glimmer от Meta: 5 шагов запуска на своём компьютере
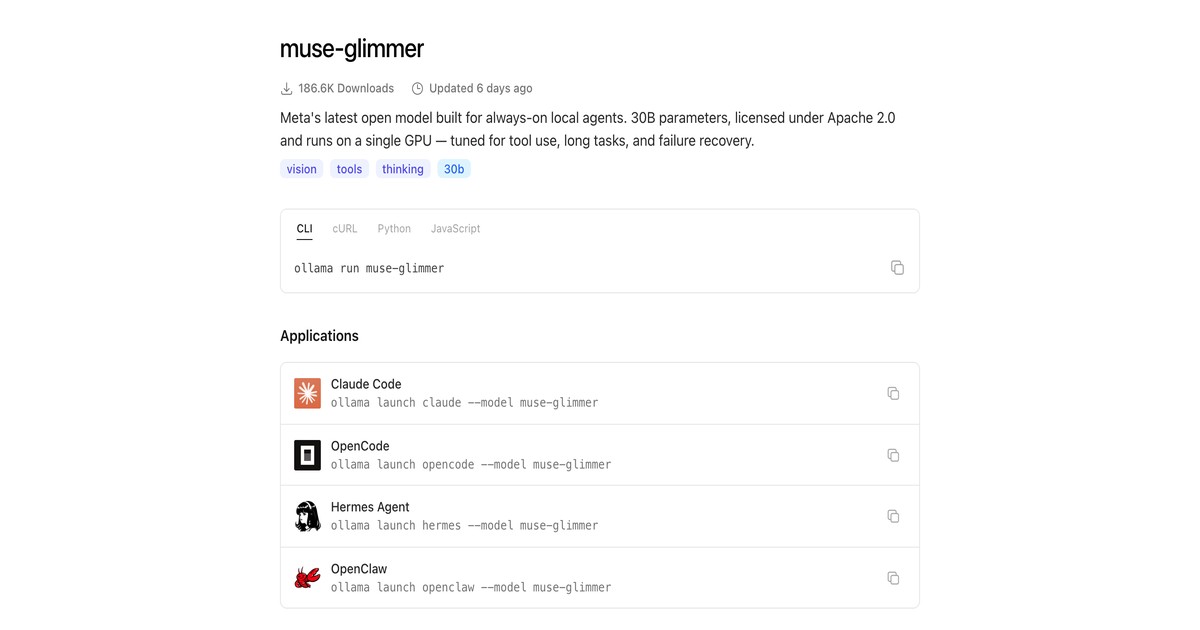
10 августа 2026 Meta выпустила Muse Glimmer - языковую модель на 30 миллиардов параметров с открытыми весами, которую можно скачать и запустить на своём компьютере без подписки и без сервера в интернете. Ниже - что это за модель, сколько памяти она просит и как поставить её через Ollama за 5 шагов
Открой окно команд и впиши строку ollama run muse-glimmer. Файл весит около 18 ГБ и качается один раз, дальше модель отвечает без сети. Прежде чем нажимать Enter, проверь, что в компьютере минимум 20 ГБ свободной памяти - меньше собьёт скорость до одного слова в несколько секунд
Что такое Muse Glimmer и откуда взялось это название?
Muse Glimmer - открытая версия внутренней модели Meta Superintelligence Labs, выпущенная 10 августа 2026 года под лицензией Apache 2.0. Это значит, что веса (файл с «мозгом» модели) можно скачать бесплатно, изменять и использовать даже в платных проектах - лицензия такое разрешает прямо, никаких скрытых условий вроде разового платежа за коммерческое применение в ней нет
Название состоит из двух частей. «Muse» - имя целой линейки моделей Meta: рядом с Glimmer существует закрытая флагманская модель Muse Spark, которая работает только через облако Meta и веса которой не выложены. «Glimmer» - младшая открытая модель той же линейки, обученная быть компактной и работать на одном обычном компьютере, а не на ферме серверов
| Модель | Статус | Где работает |
|---|---|---|
| Muse Spark | закрытая, флагманская | только облако Meta |
| Muse Glimmer | открытая, компактная | свой компьютер (эта статья) |
| Muse Image | закрытая, генератор картинок | облако Meta |
Таблица прокручивается вбок →
Дальше в статье слова «Meta» и «модель» относятся только к Glimmer: возможности Muse Spark, Muse Image и других продуктов Meta здесь не разбираются, это отдельная тема
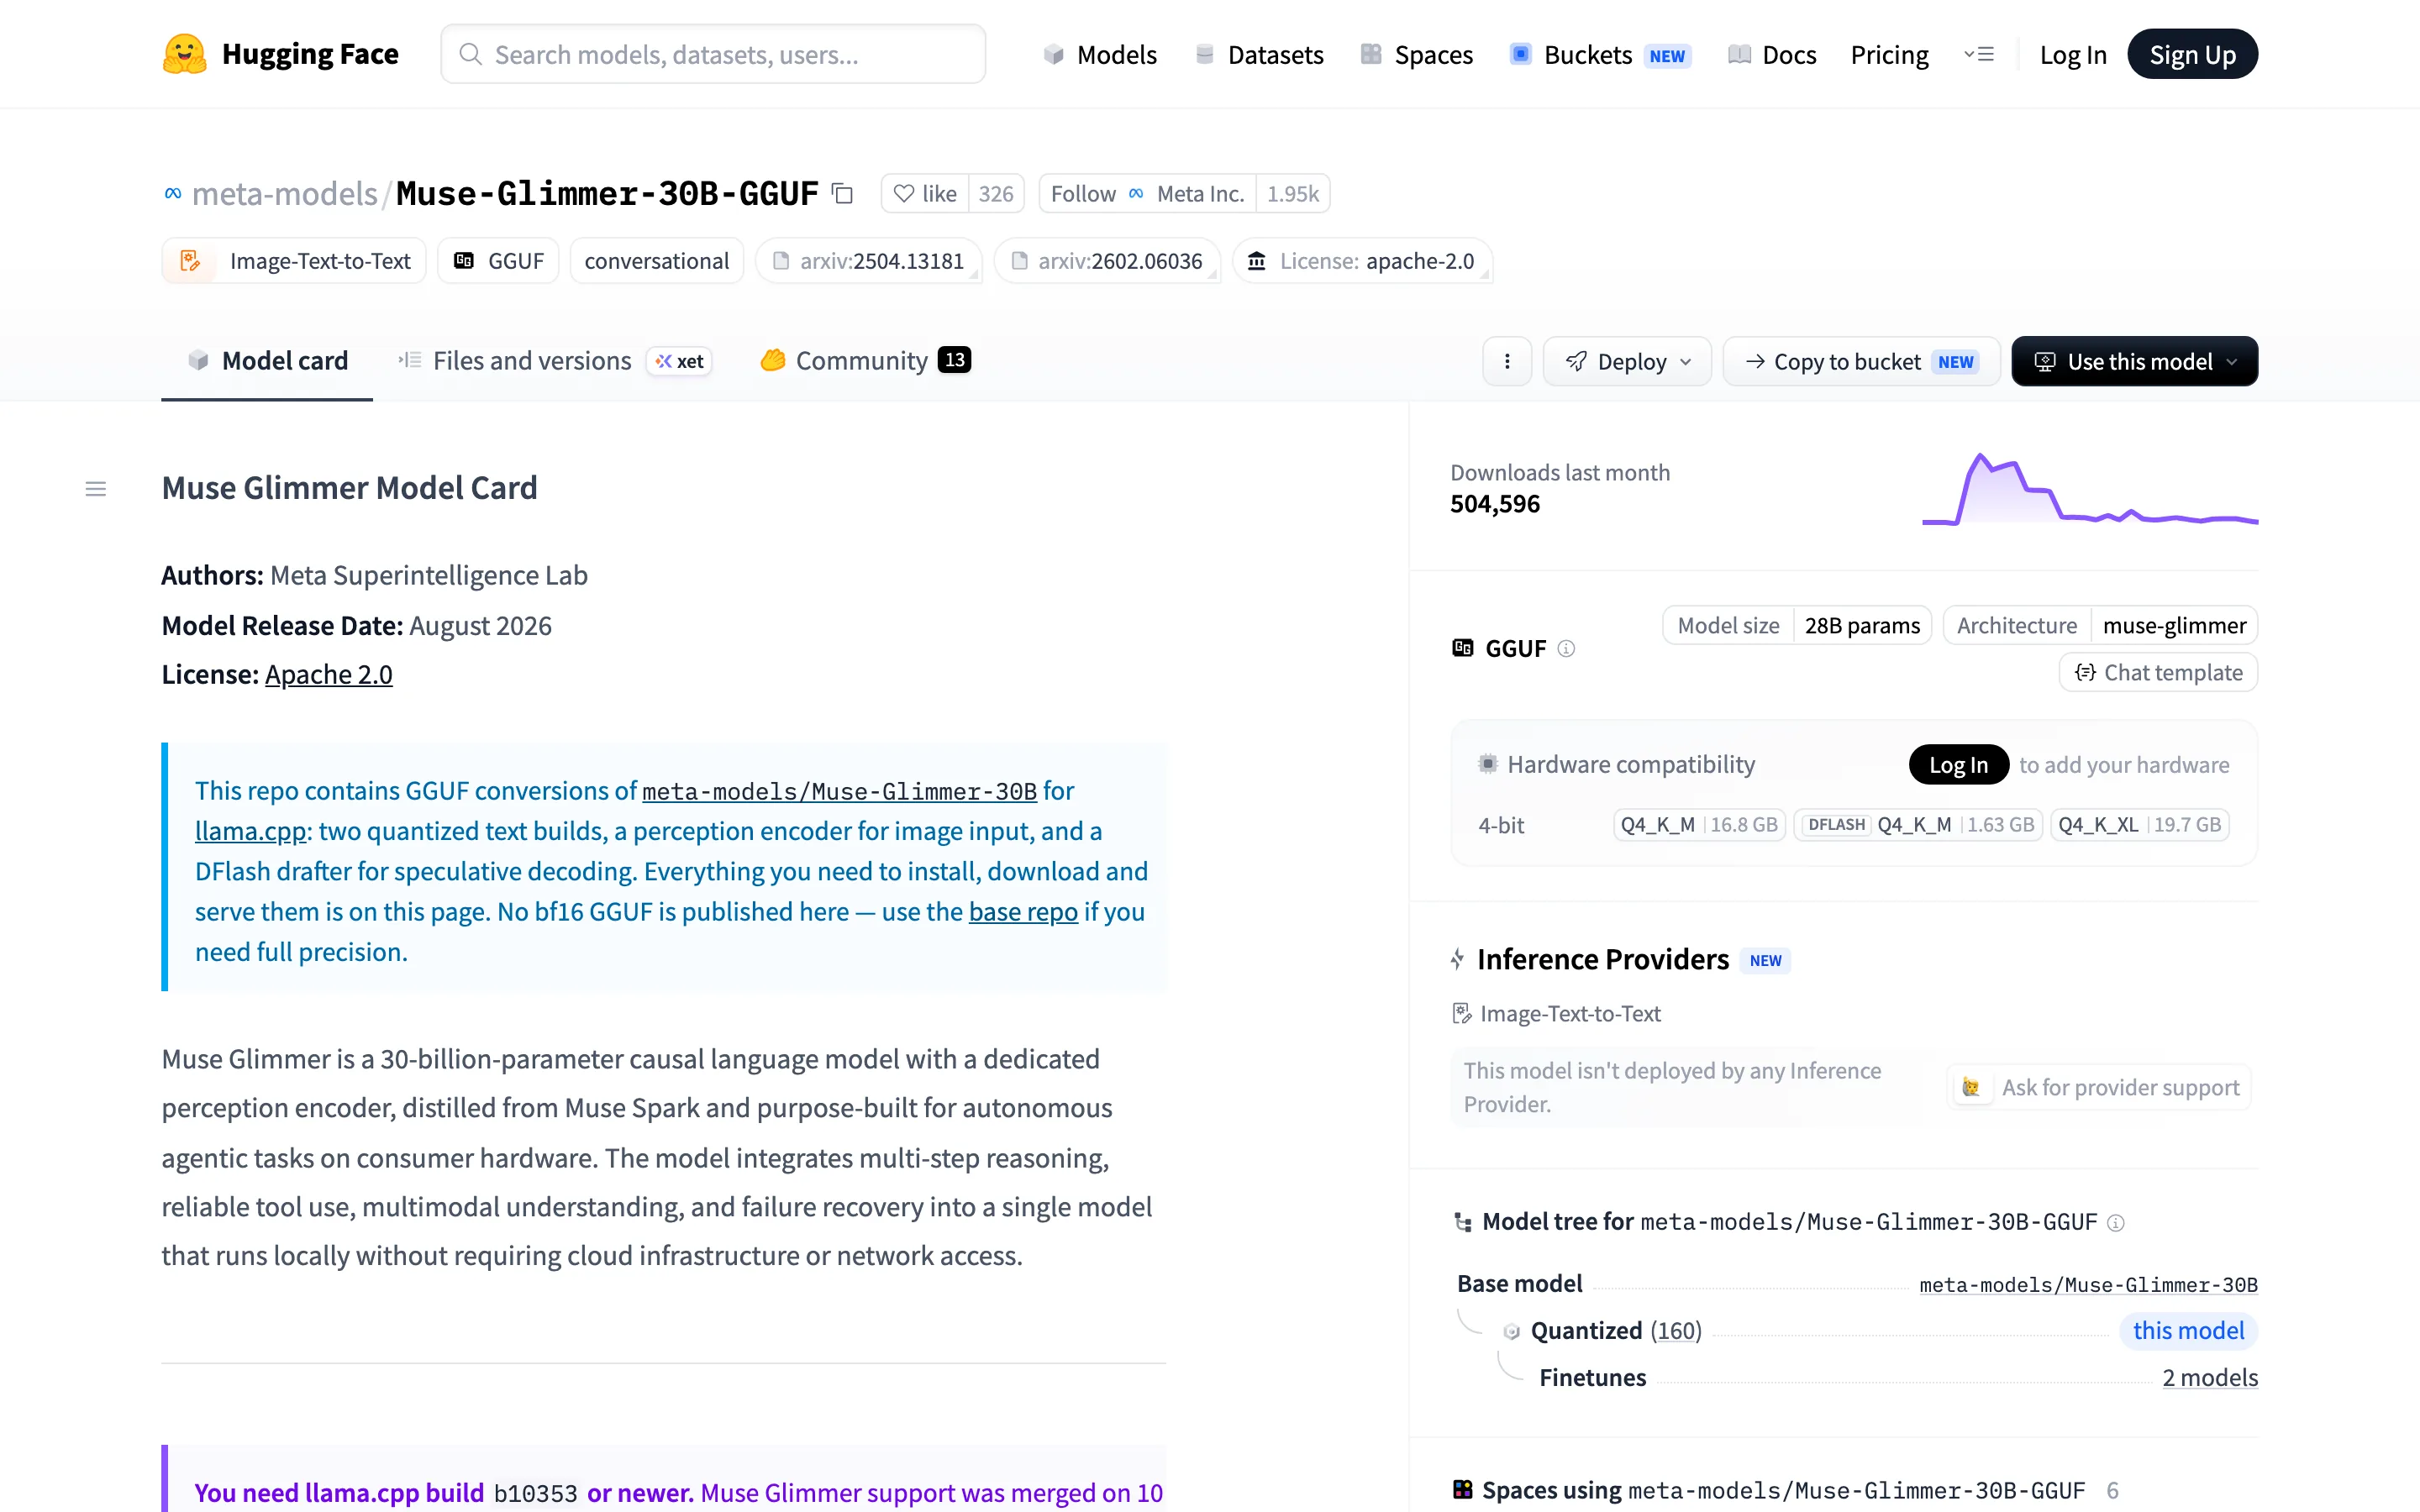
По размеру 30 миллиардов параметров - это средний вес: не игрушка на пару вопросов, но и не тяжеловес, для которого нужна отдельная видеокарта за несколько тысяч долларов. Модель обучена на данных из более чем 100 языков и умеет работать не только с текстом, но и с картинками - можно показать ей скриншот и спросить, что на нём
Для чего вообще нужна такая модель?
Она отвечает на вопросы прямо на компьютере, без интернета после скачивания и без ограничений по числу запросов в день. Meta прямо называет её целевую задачу: локальные помощники, которые работают с файлами, пишут и проверяют код, выполняют многошаговые задачи и не отправляют данные на чужой сервер
Практическая причина выбрать именно её - приватность и отсутствие лимитов. Если работаешь с личными документами, черновиками или кодом, который не хочешь показывать облачным сервисам, локальная модель решает это одним фактом: файлы не покидают компьютер. Обратная сторона честно называется здесь же: в сложных многошаговых рассуждениях топовые облачные модели пока сильнее, и Glimmer их не заменяет один в один - она занимает свою нишу, а не отменяет остальные. Где именно топовые модели обгоняют локальные по задачам, разобрано в отдельном сравнении «Какая нейросеть лучше в 2026»
Если хочется сравнить локальный путь с облачным чат-ботом в браузере, полезен обзорный гайд про чем локальная нейросеть отличается от облачной - там разобрано поле целиком, не одна конкретная модель. Если вопрос шире одной модели и интересен целый рабочий стол вокруг локальных нейросетей, есть отдельный разбор «ИИ-верстак на своём компьютере»
Сколько памяти нужно, чтобы модель заработала?
Официальные цифры разработчика: полная версия модели просит от 55 ГБ памяти, а сжатая (квантованная) версия помещается в 18-20 ГБ. Разница в том, что сжатие немного округляет числа внутри модели, экономя место почти без потери качества ответов - это стандартный приём для локального запуска, а не урезание функций
| Вариант модели | Память | Кому подходит |
|---|---|---|
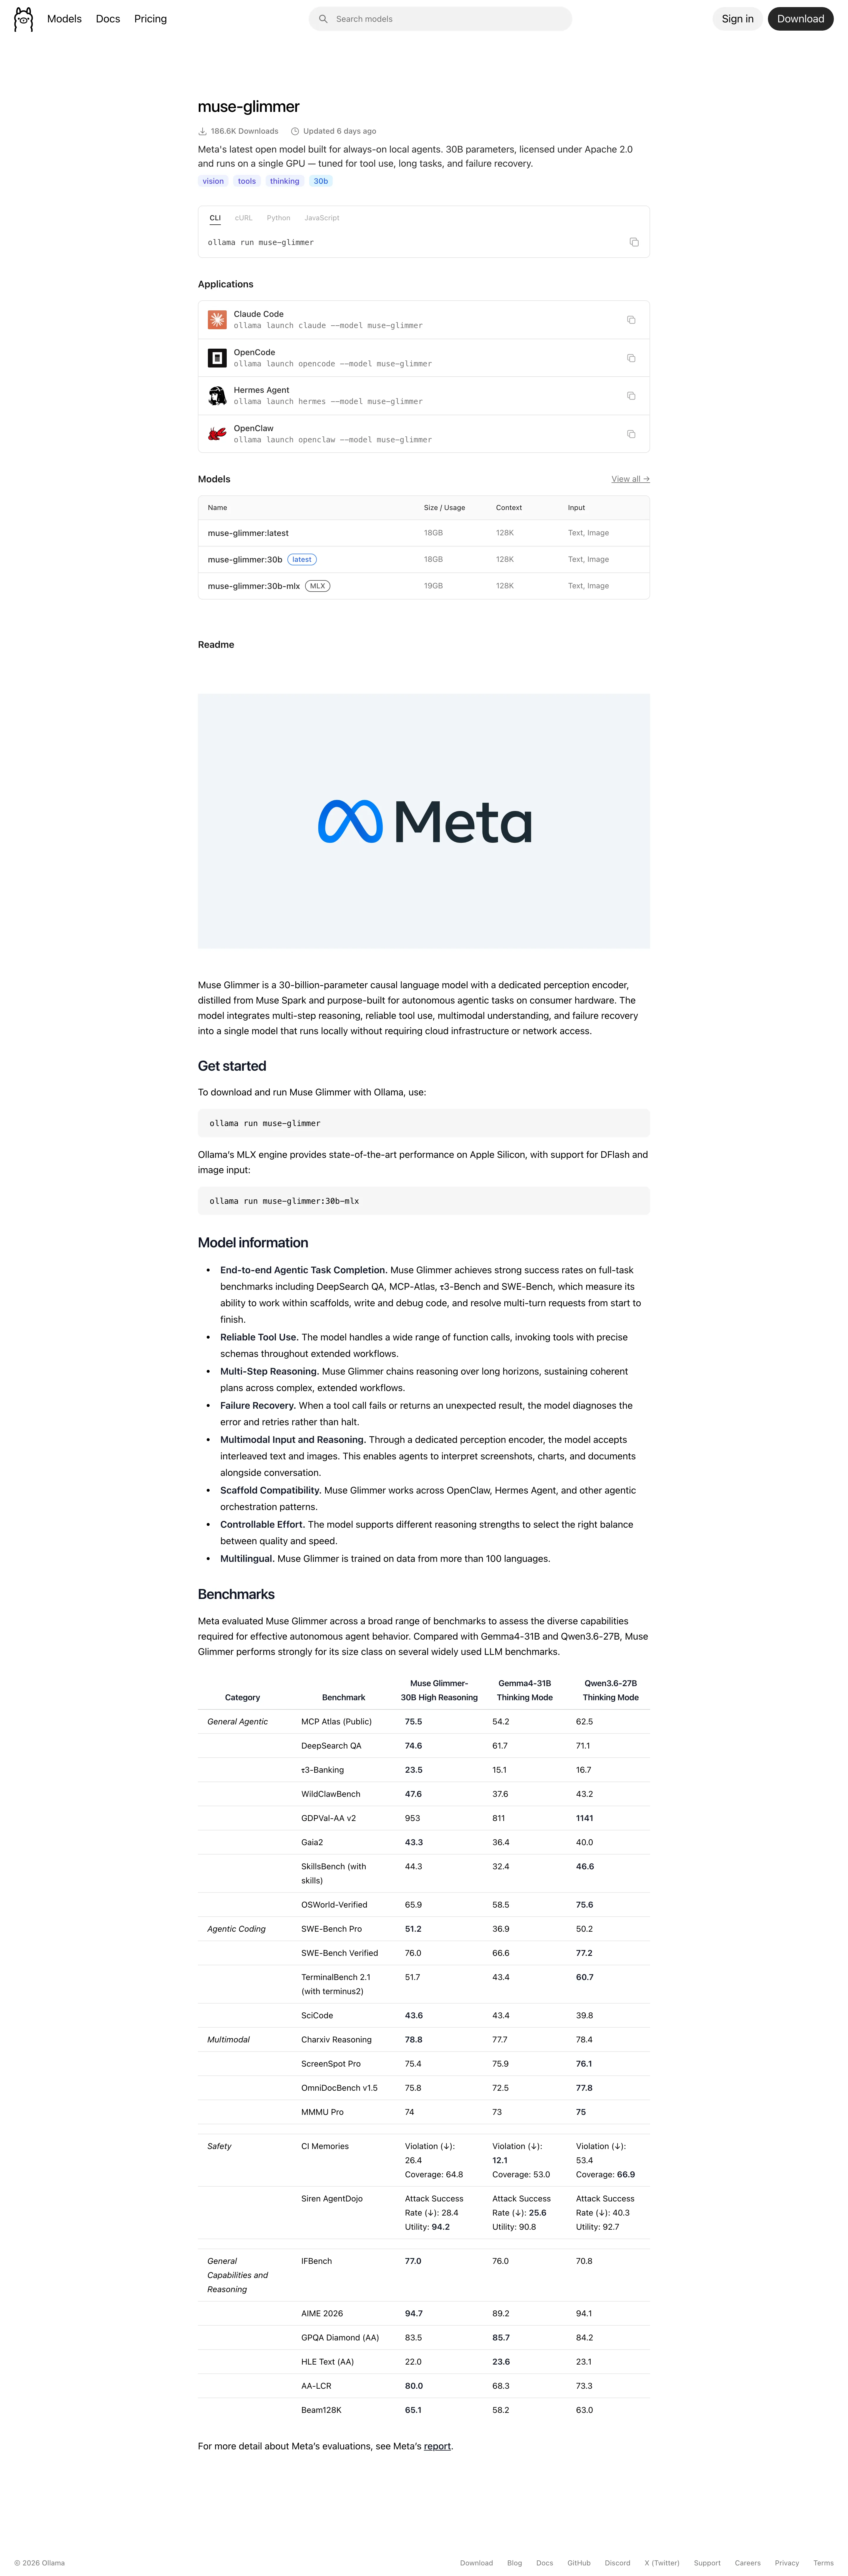
| Квантованная (по умолчанию в Ollama) | около 18 ГБ | компьютер с 24-36 ГБ оперативной памяти |
| Квантованная под Apple Silicon (MLX) | около 19 ГБ | Mac на чипах M-серии |
| Полная точность | 55+ ГБ | рабочая станция или сервер с большим объёмом памяти |
Таблица прокручивается вбок →
Правило простое: свободной оперативной памяти должно быть на 3-5 ГБ больше, чем весит файл модели, иначе она либо не запустится, либо будет выгружать часть данных на диск и отвечать заметно медленнее. Официально протестированные конфигурации - MacBook на чипах M4-Max и M5-Max, а также видеокарта RTX 5090: они прогоняют модель полностью в памяти без задержек
Свою свободную память смотришь так: на Mac - меню Apple → «Об этом Mac», на Windows - Диспетчер задач → вкладка «Память» (открывается сочетанием Ctrl+Shift+Esc). Если общей памяти компьютера меньше 24 ГБ, квантованная версия скорее всего не поместится с запасом - тогда смотри в сторону моделей меньшего размера
Шаг 1. Проверить память компьютера
Нужен минимум 20 ГБ свободной оперативной памяти под квантованную версию модели. Свою свободную память смотришь так: на Mac - меню Apple, на Windows - Диспетчер задач
Что это тебе даёт: понимание, поедет ли модель на конкретно твоём железе, ещё до того, как начнётся многоминутная загрузка файла весом 18 ГБ
Шаг 2. Поставить Ollama, если её ещё нет
Официальная страница загрузки - ollama.com/download, там установщики для Windows, macOS и Linux. Ollama - программа-проводник, через которую модель качается и запускается одной командой, без ручной установки библиотек и без работы с исходным кодом
Полная инструкция по установке с шагами под каждую систему и выбором первой модели по памяти разобрана в отдельном гайде «Как установить Ollama» - если программа уже стоит, переходи сразу к шагу 3
Проверка, что Ollama установлена и готова: открой то самое окно для команд (на Mac - Терминал, на Windows - PowerShell) и напечатай ollama --version. Что увидишь: если появился номер версии - всё готово, если команда не найдена - установка не завершилась или окно открыто раньше, чем программа встала на место
Если вместо Ollama интересен путь с готовой программой без единой команды, есть отдельное сравнение «Ollama или LM Studio» - обе программы решают одну задачу разными интерфейсами
Шаг 3. Скачать модель командой ollama pull muse-glimmer
Программа скачает файл весом около 18 ГБ. Время загрузки зависит от скорости интернета. Модель уже опубликована в официальной библиотеке Ollama, поэтому отдельно искать файлы на Hugging Face не нужно - Ollama сама скачает нужный формат. Общий принцип, как локальная нейросеть попадает на компьютер и почему это не один файл, а несколько, разобран отдельно в гайде «Как скачать нейросеть на компьютер». Команда одна:
ollama pull muse-glimmerЧто произойдёт: программа скачает дефолтный тег muse-glimmer:latest, он же muse-glimmer:30b. У меня на канале около 25-30 Мбит/с ушло чуть больше 8 минут. Что увидишь: прогресс-бар с процентами и скоростью в мегабайтах в секунду, по завершении - строка success
Свой прогон 04.09.2026: команда ollama pull muse-glimmer на Mac с чипом M4 Max и 36 ГБ памяти. Первая попытка вернула ошибку «требуется новая версия Ollama» - на машине стояла версия 0.32.6, а модели нужна 0.33 и новее. Обновление через brew upgrade ollama заняло около двух минут, следующая попытка скачала файл без ошибок и завершилась строкой success
Шаг 4. Запустить модель командой ollama run muse-glimmer
Появится приглашение ввести сообщение прямо в том же окне, модель отвечает текстом построчно. После скачивания запускаешь чат командой:
ollama run muse-glimmerЧто увидишь: приглашение ввести сообщение прямо в том же окне. Печатаешь вопрос, нажимаешь Enter - модель отвечает текстом построчно, без открытия браузера и без входа в аккаунт. Выход из чата - команда /bye
Если у тебя Mac на чипе серии M, для чуть более быстрой работы есть отдельный тег, оптимизированный под архитектуру Apple:
ollama run muse-glimmer:30b-mlxОба варианта отвечают на одни и те же вопросы, разница только в скорости на конкретном железе
Свой прогон 04.09.2026: я спросил модель «Что такое Muse Glimmer и для чего он нужен?» - и она не смогла ответить про саму себя, перебрав версии «плагин для Figma», «наушники Muse», «фича Adobe Muse». Это ожидаемо, а не поломка: данные, на которых училась модель, собраны до её собственного релиза 10 августа 2026 - она физически не могла прочитать новости о самой себе. Полезный вывод для практики: свежие события после даты обучения локальная модель не знает и додумывает правдоподобные, но неверные версии, поэтому такие вопросы стоит проверять поиском, а не спрашивать модель напрямую
Шаг 5. Проверить память командой ollama ps
Значение 100% GPU означает, что вся модель легла на видеочасть компьютера и будет отвечать быстро. Команда ollama ps в отдельном окне (пока чат с моделью открыт в первом) показывает, где физически считает модель
| Значение PROCESSOR | Что это значит | Что делать |
|---|---|---|
| 100% GPU | модель целиком в быстрой памяти | ничего, всё хорошо |
| доля CPU (например 40%/60%) | часть модели не поместилась | закрыть другие программы или взять более сжатый тег |
| ошибка запуска | памяти не хватает совсем | освободить память или выбрать модель меньшего размера |
Таблица прокручивается вбок →
На Mac это единая память, разделения на «видеокарту» и «обычную» там нет - колонка PROCESSOR всё равно показывает распределение честно. Что это тебе даёт: одну строку, по которой сразу понятно, работает модель на пределе своих возможностей или уже упёрлась в нехватку памяти - не нужно гадать по скорости ответов на глаз
Какую первую задачу дать модели?
Три задачи, на которых видно, для чего вообще нужна именно эта модель, а не облачный чат в браузере:
- Разбор личного документа. Скопируй в чат текст письма, договора или заметки и попроси кратко пересказать суть или найти конкретный пункт. Файл при этом никуда не отправляется - весь разбор идёт на твоей машине
- Проверка кода. Вставь фрагмент кода и попроси найти ошибку или объяснить, что он делает. Модель заявлена как подходящая для функций работы с кодом и вызовом инструментов, это одна из целевых задач разработчика
- Работа со скриншотом. Сделай скриншот экрана и, если твой интерфейс к Ollama поддерживает картинки, покажи его модели с вопросом «что здесь происходит» - модель понимает не только текст, но и изображения через встроенный модуль восприятия
Первый час обычно уходит не на саму модель, а на привыкание к формату: ответ приходит не мгновенно, как в облаке, а с той скоростью, которую тянет твоё железо. Это ожидаемо, а не поломка
Что модель НЕ делает и где её граница?
Три честных ограничения, которые стоит знать до того, как строить на модели что-то серьёзное:
- Она не замена топовым облачным моделям в сложных рассуждениях. Разработчик сам подаёт её как компактный локальный инструмент, а не как конкурента флагманским моделям в трудных многошаговых задачах
- Она не знает событий после даты обучения. Мой прогон выше это подтвердил напрямую: модель не смогла определить даже саму себя, потому что данные обучения собраны раньше её собственного релиза
- Разбирать остальные продукты Meta я здесь не буду. Тема статьи - конкретная открытая модель Glimmer, а не компания в целом. Это отдельный вопрос, к которому эта статья не относится
Работает ли всё это из России?
Да, с одной оговоркой про метод проверки. Ollama (программа, через которую скачивается модель) доступна из России без VPN - это уже проверено отдельно с арендованного компьютера в Москве при подготовке гайда про установку Ollama 16 августа 2026, и с тех пор доступ не менялся. Сама модель Muse Glimmer качается через серверы Ollama, а не напрямую с сайтов Meta, поэтому блокировка продуктов Meta в России (Facebook, Instagram) на загрузку модели не влияет: путь идёт в обход них
Прямые страницы research.meta.ai и huggingface.co, которые я использовал для проверки фактов в этой статье, открываются с обычного рабочего компьютера без VPN. Но эта проверка сделана не с российского адреса, поэтому даю её только для факта, а не как гарантию для читателя из России. Для самого запуска модели эти страницы читателю и не понадобятся: весь путь идёт через Ollama, а её доступность уже подтверждена отдельно
Чем этот путь отличается от других способов запуска локальных моделей?
Ollama - не единственный способ запустить модель на своём компьютере, но самый короткий для новичка. Модель доступна и напрямую в форматах для llama.cpp, MLX и ExecuTorch, а также через LM Studio - но эти пути требуют либо ручной сборки, либо отдельной программы со своим интерфейсом
| Способ запуска | Сложность для новичка | Когда выбирать |
|---|---|---|
| Ollama (эта статья) | одна команда в окне для команд | первый запуск, минимум настройки |
| LM Studio | программа с окнами, чуть больше кликов | нужен графический интерфейс без команд |
| llama.cpp напрямую | сборка из исходников | уже работаешь с этим инструментом |
Таблица прокручивается вбок →
Разница между Ollama и LM Studio подробно разобрана в отдельном гайде «Ollama или LM Studio», если хочется сравнить оба пути до выбора
Что делать после того, как модель заработала?
Определиться, зачем она тебе нужна каждый день, а не один раз. Модель на своём компьютере сильна там, где важны приватность и отсутствие лимитов: разбор личных документов, черновики, код, работа без интернета. Разовый вопрос в чате это ещё не инструмент - вопрос в том, встроишь ли ты её в задачу, которая повторяется
Если модель понравилась и хочется собрать вокруг неё что-то большее одной команды в терминале, дальше два пути. Посмотреть на всё поле локальных моделей целиком - в этом помогает гайд «Локальные нейросети: что потянет твой компьютер». Сравнить Ollama с другим инструментом запуска - разбор в гайде «Ollama или LM Studio». Если Ollama ещё не стоит вовсе - начни с установки Ollama с нуля
Грабли ты обошёл, файл модели у тебя на диске работает
Источники
- Официальный анонс Muse Glimmer на research.meta.ai (research.meta.ai/blog/introducing-muse-glimmer-open-agentic-model) - дата релиза 10.08.2026, параметры, лицензия Apache 2.0, требования к памяти, список интеграций, проверено 04.09.2026
- Карточка модели Muse-Glimmer-30B-GGUF на Hugging Face (huggingface.co/meta-models/Muse-Glimmer-30B-GGUF) - квантованные сборки и их точные размеры, README с инструкциями llama.cpp, проверено 04.09.2026
- Страница модели в библиотеке Ollama (ollama.com/library/muse-glimmer) - доступные теги (latest, 30b, 30b-mlx), размеры файлов, число загрузок, проверено 04.09.2026
- Официальный блог Ollama о добавлении Muse Glimmer (ollama.com/blog/muse-glimmer) - команда запуска, контекст 128K, лицензия, проверено 04.09.2026
- Материал TechCrunch о релизе Glimmer (techcrunch.com/2026/08/10/metas-new-glimmer-ai-model-offers-a-hint-at-zuckerbergs-personal-intelligence-vision) - независимое подтверждение даты и параметров, связь с закрытой Muse Spark, проверено 04.09.2026
- Официальная страница загрузки Ollama (ollama.com/download) - установщики для Windows, macOS и Linux, требования к системе, проверено 04.09.2026
- Свой прогон 04.09.2026:
ollama pull muse-glimmerиollama run muse-glimmerна Mac с чипом M4 Max и 36 ГБ памяти - ollama.com/library - общий каталог моделей Ollama, из которого ставится и Muse Glimmer
Памятка: Muse Glimmer от установки до первого ответа
Шесть строк, по которым всё проверяется
Сохрани себе
- Свободно минимум 20 ГБ оперативной памяти - смотри в меню Apple или диспетчере задач
- Ollama установлена, команда
ollama --versionпечатает номер версии - Модель скачана командой
ollama pull muse-glimmer, файл около 18 ГБ - Чат открыт командой
ollama run muse-glimmer, ответ приходит текстом в том же окне ollama psпоказывает100% GPU- модель легла в память целиком- На Apple Silicon для скорости выбран тег
muse-glimmer:30b-mlx
Модель стоит, дальше система
От установленной модели к рабочему инструменту
Установка занимает вечер и разобрана выше целиком. Что с этой моделью делать дальше, как ставить ей задачи и получать повторяемый результат - в ИИ-Лагерь
Частые вопросы
Muse Glimmer - это то же самое, что и Muse Spark?
Нет, это разные модели одной линейки Meta. Muse Spark - закрытая флагманская модель, работает только через облако Meta, веса не выложены. Muse Glimmer - младшая открытая модель с весами в свободном доступе, её можно скачать и запустить на своём компьютере
Сколько стоит Muse Glimmer?
Ничего, модель бесплатна и распространяется по лицензии Apache 2.0 - она разрешает и личное, и коммерческое использование без оплаты. Платить придётся только за электричество своего компьютера, если считать совсем строго
Нужна ли видеокарта, чтобы запустить модель?
Официально протестированы конфигурации с видеокартой (RTX 5090) и с единой памятью Apple Silicon (чипы M4-Max и M5-Max). Отдельная мощная видеокарта не обязательна на Mac, но на Windows и Linux без неё модель будет считать заметно медленнее, используя обычный процессор
Что делать, если 18 ГБ модели не помещается в память?
Проверить реальный объём свободной (не общей) оперативной памяти: другие открытые программы тоже её занимают. Если общей памяти компьютера меньше 24 ГБ, квантованная версия скорее всего не поместится с запасом - в этом случае стоит смотреть на модели меньшего размера, например через каталог Ollama library
Можно ли запустить Muse Glimmer без Ollama?
Да, модель доступна и напрямую в форматах для llama.cpp, MLX и ExecuTorch, а веса лежат на Hugging Face. Но это путь для тех, кто уже работает с этими инструментами - для первого запуска Ollama проще, разница разобрана в разделе про способы запуска выше
Как обновить модель до новой версии, если Meta выпустит апдейт?
Той же командой, что и первая загрузка: ollama pull muse-glimmer. Программа сама проверит, есть ли новая версия тега, и скачает только изменившуюся часть, а не весь файл заново