Гайд · открытая модель решений · сентябрь 2026
Лайя (Laya) на своём компьютере: 3 минуты до ответа и дообучение
Лайя, в оригинале Laya, - открытая модель решений от Convai Innovations. Ты даёшь ей текст обращения и вопрос с вариантами, она выбирает вариант и пишет свою уверенность. Текст она не сочиняет, зато на моём Mac отвечает за 19,7 миллисекунды и бесплатно, лицензия Apache 2.0. Поставить проще всего через Claude Code: открой его в пустой папке и вставь этот запрос целиком
Поставь на этот компьютер открытую модель Laya: отдельное окружение Python в этой папке, потом pip install laya. Бери многоязычную версию: laya.load("convaiinnovations/laya", subfolder="multilingual"). Напиши скрипт razbor.py, который по тексту обращения клиента отвечает, какой отдел его разбирает: оплата, доступ, техника, содержание или другое, и грозит ли человек уйти. Запусти на обращении «Списали деньги два раза, верните лишнее, иначе отменю подписку» и покажи ответ и время в миллисекундахЧерез три минуты Claude покажет строку отдел: oplata и время ответа. У меня установка шла 91 секунду, первый запуск со скачиванием модели ещё 83 секунды
Если ставить пока не хочется, открой демо Laya на Hugging Face, вкладку Support triage, вставь своё обращение и нажми Ask. Понравилось - ставь многоязычную версию: английская на русских обращениях у меня угадала 9 из 20. И сразу готовь таблицу из 40 своих обращений: без дообучения модель ошибается почти в каждом втором
Как понять, что Лайя встала и работает
Смотри на три строки в ответе Claude. Первая - отдел: на моём обращении модель дала «оплате» 0,779, остальным четырём отделам меньше 0,11 на всех. Вторая - время: на Mac с чипом M4 Max ответ шёл 19,7 миллисекунды, а когда я заставил её работать без графического ускорителя, 72 миллисекунды. Третья - папка модели: 647 МБ легли в скрытую папку .cache/huggingface в твоей домашней, второй запуск их уже не качает
Для сравнения, Джев, закрытая модель TypeSafe, по сторонним замерам отвечает за 236-276 миллисекунд, потому что запрос летит в облако и обратно. Здесь облака нет: обращения не уходят с твоего компьютера, и за каждый ответ никто не берёт денег
Если вместо ответа видишь ошибку, листай к разделу «Что ломается» ниже, там экранный текст дословно
Не хочешь ничего ставить: попробуй в браузере
Открой демо Laya на Hugging Face, это сайт, где модели выкладывают и дают погонять в окне браузера. Что увидишь: заголовок «Laya: Decisions, Not Text», ниже ряд вкладок, первая Support triage. В поле customer message вставь своё обращение по-русски и нажми фиолетовую кнопку Ask внизу. Справа появится таблица answers и строка с маршрутом. Что это даёт: за минуту понимаешь, стоит ли тратить время на установку
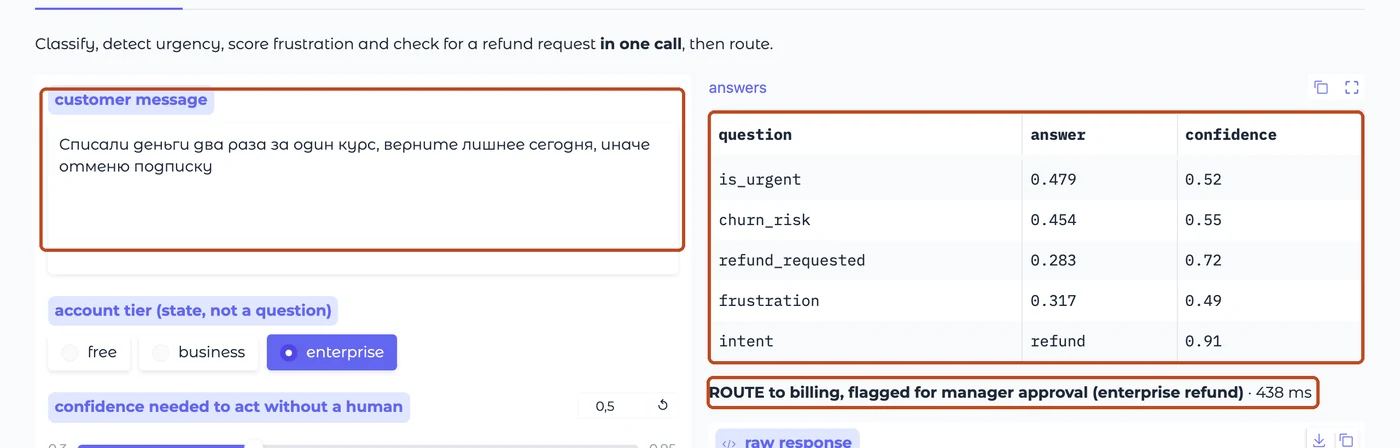
Демо собрано на английских примерах и спрашивает свои вопросы, а не твои. Поэтому правильный отдел ещё не значит, что модель поняла твоих клиентов: вероятность ухода меньше половины при прямой фразе «иначе отменю подписку» говорит, что без дообучения она такое пропускает
Где взять Лайю и какую версию брать
Всё лежит в двух местах. Веса модели - на странице convaiinnovations/laya на Hugging Face, код и инструкции - в репозитории NandhaKishorM/laya на GitHub. Сама команда pip install laya тянет пакет с PyPI, а при первом запуске пакет сам скачивает веса с Hugging Face. Руками ничего качать не надо
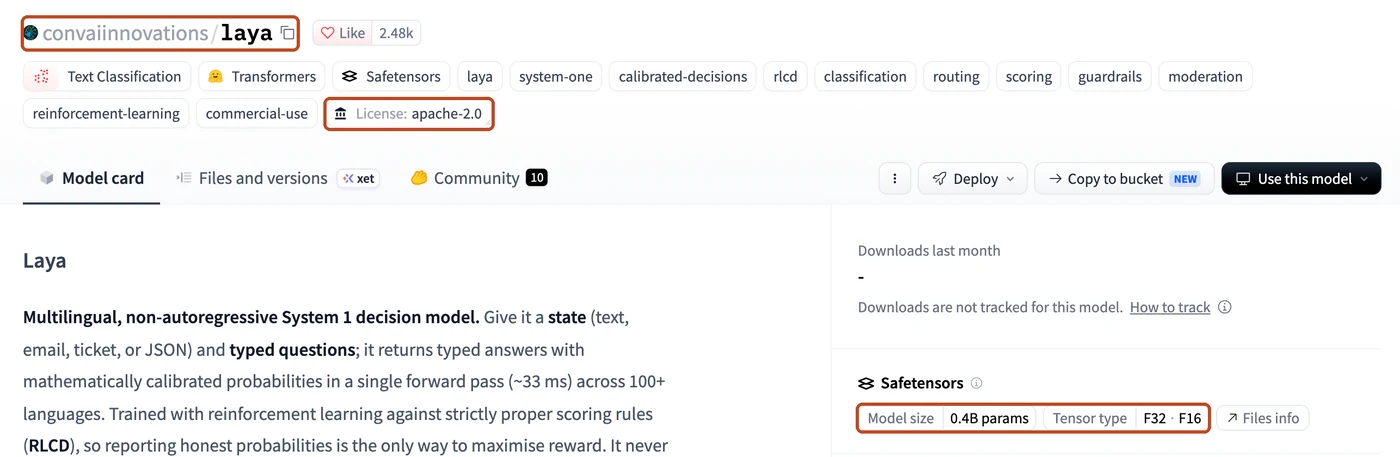
В одной папке на Hugging Face лежат три версии, и выбор решает, будет ли толк на русском тексте
| Версия | Как позвать | Кому |
|---|---|---|
| laya, основная | laya.load("convaiinnovations/laya") | обращения только на английском |
| laya-multilingual | subfolder="multilingual" | русский и ещё сотня языков, 322 млн параметров |
| laya-typed-decisions | subfolder="typed-decisions" | четыре готовых сценария авторов: счета, инциденты безопасности, поддержка, логи агентов |
Таблица прокручивается вбок →
Здесь живёт первая ошибка новичка, и на экране она ничем не выдаёт себя. Основная версия русский текст читает, ошибок не пишет, но на моих 20 русских обращениях угадала отдел 9 раз со средней уверенностью 0,23. Многоязычная на тех же двадцати - 11 раз и 0,67. Поэтому в запросе выше стоит subfolder="multilingual", не убирай его
Дообучить под свою задачу: 40 обращений и 18 секунд
11 верных из 20 - уровень подброшенной монетки. Авторы сами пишут об этом в разделе Honest limits: базовая версия - быстрая заготовка под дообучение, а не готовый судья. Дообучить значит показать ей твои обращения с правильными ответами, чтобы она подстроилась под твоих клиентов и твои отделы
Собери таблицу в две колонки и сохрани как obrashcheniya.csv в той же папке: в первой текст обращения, во второй отдел. Минимум по 8 на каждый отдел, лучше больше. Вот начало моей учебной таблицы, её можно взять за образец
text,otdel
"Списали деньги два раза за один курс, верните лишнее",oplata
"Не приходит письмо с доступом к курсу после покупки",dostup
"Видео в уроке не грузится, крутится колесо и всё",tehnika
"Какой промпт лучше взять для постов, в уроке их три?",soderzhanie
"Можно ли подарить курс другу?",drugoe
Потом дай Claude Code второй запрос. Он опирается на официальный ноутбук дообучения, который лежит в папке notebooks репозитория
Дообучи Лайю на моих обращениях в поддержку. Таблица obrashcheniya.csv в этой папке, колонки text и otdel. Возьми цикл обучения из ноутбука notebooks/laya_finetune_typed_decisions_2xT4_kaggle.ipynb репозитория NandhaKishorM/laya и переделай под один компьютер без двух видеокарт. Из каждого отдела четверть обращений отложи на проверку и в обучение не давай. Покажи, сколько проверочных обращений модель угадывала до дообучения и сколько после, сохрани новую модель в папку laya-moi-obrashcheniya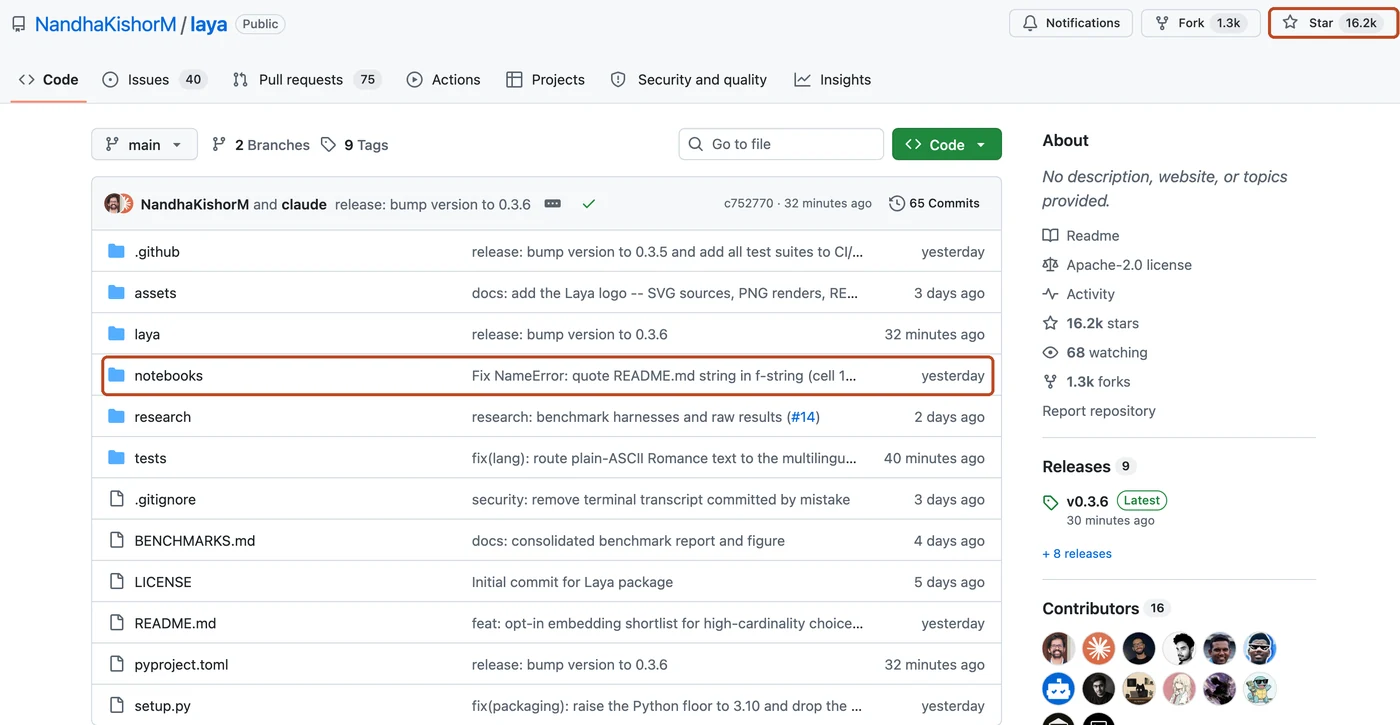
Что увидишь: две строки «ДО дообучения» и «ПОСЛЕ дообучения» и разбор каждого проверочного обращения. На моих 60 учебных обращениях, 40 на обучение и 20 на проверку, было 11 верных из 20, стало 14 из 20. Само обучение шло 18 секунд, весь скрипт с загрузкой и проверкой - 73 секунды. Что это даёт: папка laya-moi-obrashcheniya на 647 МБ, которую дальше зовут той же строкой, только с путём к папке вместо имени с Hugging Face
Проверь одну вещь, которую легко проглядеть. После дообучения на маленькой таблице модель стала самоуверенной: на пяти из шести ошибок она ставила 1,00, то есть «уверена полностью». Порог вроде «отдаём человеку всё, где уверенность ниже 0,85» такие ошибки не поймает. Лечится двумя способами: больше примеров в таблице, особенно похожих между отделами, и подгонка уверенности на твоих данных, её делает последний шаг того же ноутбука авторов
Если обращений тысячи, а не десятки, дообучай не на своём компьютере, а на бесплатных видеокартах Kaggle: ноутбук авторов рассчитан ровно на это, у них 4 эпохи по 30 тысячам вопросов шли 4-5 часов на двух видеокартах T4
Что ломается и что делать
Разбираю то, что видел на своём экране, плюс одну поломку, о которой предупреждают сами авторы
| Что видишь | Что случилось | Что делать |
|---|---|---|
| Строка «Fetching 5 files» стоит на месте полминуты | первый запуск качает 647 МБ весов, у меня это заняло 41 секунду | ждать: второй запуск берёт веса с диска за доли секунды |
| «RuntimeWarning: laya: this checkpoint ships temperatures outside [0.5, 5] which would distort confidence» | ты позвал основную английскую версию, её уверенность откалибрована криво | для русского текста бери subfolder="multilingual", у многоязычной этого предупреждения нет |
| Отдел верный, а уверенность 0,5-0,6 | базовая версия не знает твоих клиентов | дообучить на своей таблице, раздел выше |
| После дообучения везде 1,00, даже где модель ошиблась | таблица маленькая, модель выучила её наизусть | добавить примеров и подогнать уверенность на своих данных |
| Запуск молча висит и ничего не печатает | по словам авторов в README, так бывает, если на компьютере стоит TensorFlow | попроси Claude запустить скрипт с USE_TF=0 в начале команды |
Про системные требования одной строкой: нужен Python 3.10 или новее. У меня стоял 3.14, и окружение со всеми зависимостями заняло 922 МБ. На Windows я не ставил, команды те же, но проверять их там не буду
Шпаргалка: какую Лайю брать и сколько ей нужно
Таблица, к которой возвращаешься, когда захочешь подключить модель к новой задаче: модерации комментариев, сортировке заявок или маршруту писем
| Если у тебя | Бери | Сколько примеров | Где учить |
|---|---|---|---|
| Обращения на русском | laya-multilingual | от 8 на каждый вариант ответа, лучше 50 | свой компьютер, секунды |
| Только английский текст | основная laya | так же | свой компьютер |
| Больше 20 вариантов ответа в одном вопросе | Лайю не бери или дроби вопрос на два шага: общий раздел, потом точный | - | - |
| Нужен ответ «да или нет» (грозит ли уйти, спам ли это) | вопрос типа noul, он у модели самый сильный | от 20 на «да» и на «нет» | свой компьютер |
| Тысячи обращений и нужна точность выше 70% | laya-multilingual + ноутбук авторов | тысячи | Kaggle, бесплатные видеокарты |
| Нужен ответ-текст клиенту, а не выбор | не Лайя, она текст не пишет | - | локальная чат-модель |
Про «больше 20 вариантов» - не моя догадка, авторы сами показывают: на наборе с 77 вариантами Лайя угадала 0,425 против 0,870 у Джева. Про текстовые ответы клиенту: для них нужна модель, которая пишет, например локальная нейросеть через Ollama, а Лайя может стоять перед ней и решать, кому вообще отвечать
Что ещё почитать
Если Claude Code ещё не стоит, начни с установки Claude Code: все шаги этой статьи идут через него. Хочешь локальную модель, которая пишет текст, а не выбирает вариант - локальные нейросети: что потянет твой компьютер и Ollama или LM Studio. Разбор обращений чаще всего подключают к боту - как создать телеграм-бота с нуля. И перед тем как запускать чужой код, прочитай 7 правил защиты от чужого репозитория
Источники
Страницы открыты 22 сентября 2026 года; звёзды репозитория сняты через API GitHub в тот же день, время ответа и точность - собственным прогоном
- Код Laya на GitHub - установка, раздел Honest limits, раздел Fine-Tuning
- Карточка модели convaiinnovations/laya - три версии, замеры скорости, сравнение с Jev
- Многоязычная версия laya-multilingual - 100+ языков
- Демо Laya в браузере - вкладка Support triage
- Пакет laya на PyPI - версия 0.3.6
- Ноутбук дообучения от авторов - цикл обучения и подгонка уверенности
- Отчёт о замерах Laya - где Jev сильнее
- Сторонний замер Jev, AbdelStark - скорость облачной модели
- Сторонний замер моделей решений, nibzard - второй независимый замер
- Собственный прогон 22 сентября 2026 года на Apple M4 Max: установка 91 с, первый запуск 83 с, ответ 19,7 мс, без ускорителя 72 мс; 60 учебных обращений, до дообучения 11 из 20, после 14 из 20, обучение 18 с
Памятка: Лайя за один вечер
Повторить без статьи под рукой
Сохрани себе
- попробовать своё обращение в демо Laya на Hugging Face, вкладка Support triage, кнопка Ask
- в пустой папке открыть Claude Code и дать первый запрос: установка и скрипт razbor.py
- проверить, что в запросе стоит subfolder="multilingual"
- собрать obrashcheniya.csv: колонки text и otdel, от 8 обращений на отдел
- дать второй запрос: дообучение, четверть обращений на проверку
- сравнить строки ДО и ПОСЛЕ, посмотреть, где модель ошиблась с уверенностью 1,00
- если обращений тысячи - дообучать на Kaggle по ноутбуку авторов
Про следующий шаг
Модель у тебя, а обращения всё ещё разбирает человек
Ты поставил Лайю, увидел её ответ за 20 миллисекунд и дообучил на своих обращениях. У тебя есть два запроса для Claude и таблица, какую версию брать под какую задачу
Дальше упираешься в связку: ответ модели надо куда-то отправить. Обращение из бота или почты должно само дойти до Лайи, её решение само попасть к нужному человеку, а сомнительные случаи лечь отдельной стопкой. Без этого ты просто быстрее угадываешь отдел в терминале
Я сам каждый день работаю на Claude и агентах, один, без команды: ботов, разбор заявок и контент собираю ими. На Лагере за три дня мы берём твой поток обращений и доводим его до связки, которая работает без тебя, на твоих клиентах и твоих отделах
Это заявка в мой закрытый канал, не оплата. Впускаю сразу, дальше бот в личке отдаёт путёвку на три дня
Частые вопросы
Лайя правда бесплатная?
Да. Веса и код лежат в открытом доступе под лицензией Apache 2.0, она разрешает использовать модель в работе и в продукте. Платить придётся только за железо, если его не хватит, но на обычном Mac модель работает, я проверял
Чем Лайя отличается от ChatGPT или Claude?
Она не пишет текст. Ты задаёшь вопрос и варианты, она выбирает вариант и говорит, насколько уверена. Поэтому она быстрая и ей нечего выдумывать, но письмо клиенту она не составит
Нужна ли видеокарта?
Для разбора обращений нет. На обычном Mac она работает и со встроенным ускорителем, и совсем без него, и в обоих случаях быстрее облачного Джева. Дообучение на десятках обращений тоже идёт на обычном компьютере, видеокарты Kaggle нужны, когда обращений тысячи
Мои обращения куда-то отправляются?
Нет. После первого скачивания весов модель работает у тебя на диске, и текст обращений с компьютера не уходит. Это отличие от Джева и других облачных сервисов, куда каждый запрос летит через интернет
Почему после дообучения модель всё равно ошибается?
Потому что 40 примеров мало, а границы между отделами размыты: «Где найти бонусные уроки» у меня модель отнесла к содержанию, хотя это доступ. Добавляй в таблицу именно такие спорные обращения, и она начнёт их различать
Если дочитал до конца
Дальше я пишу в своём канале
Я соло-предприниматель, всю работу делаю на Claude, Claude Code и агентах, без команды. В канале показываю, какие открытые модели прижились у меня в работе, какие я снёс через неделю и почему
Это заявка на вход в мой закрытый канал, одобряю сразу. Бесплатно