Свежий отчёт · доля ИИ-текста в интернете
Сколько интернета пишут нейросети: 2 факта из отчёта PewResearch
20 августа 2026 года Pew Research Center опубликовал отчёт «How Much of the Internet Is Written With AI?»: более трети страниц, опубликованных в интернете с момента выхода ChatGPT, несут признаки ИИ-авторства. Это не догадка и не с потолка - методология исследования и её границы разобраны ниже
К концу статьи будет понятно: что именно измерил Pew Research и чего эта цифра НЕ говорит, почему разные исследования называют разные проценты (иногда втрое больше), что это значит для тебя как для читателя, который ищет надёжную информацию, и что это значит для тебя как для автора, который сам пишет тексты
Открой любую статью, которую собираешься процитировать или взять за источник, и проверь два признака - есть ли у автора личный опыт по теме и указана ли методология там, где приводятся цифры; если обоих нет, перед тобой типовой пересказ, а не первоисточник
Что именно выяснил Pew Research 20 августа 2026
Исследователи взяли архив Common Crawl - открытую базу снимков интернета - и собрали почти полмиллиона англоязычных страниц за период с января 2021 по июль 2026. Это значит, что в выборке есть страницы ДО выхода ChatGPT (конец 2022) и ПОСЛЕ, и разницу между ними можно увидеть напрямую
Для определения авторства использовали открытую модель Pangram - программу, которая ищет статистические отпечатки в тексте: какие слова, обороты и построения фраз чаще встречаются у нейросети, чем у живого человека. Метафора для понимания: это как эксперт-графолог, только вместо почерка он смотрит на речевые привычки
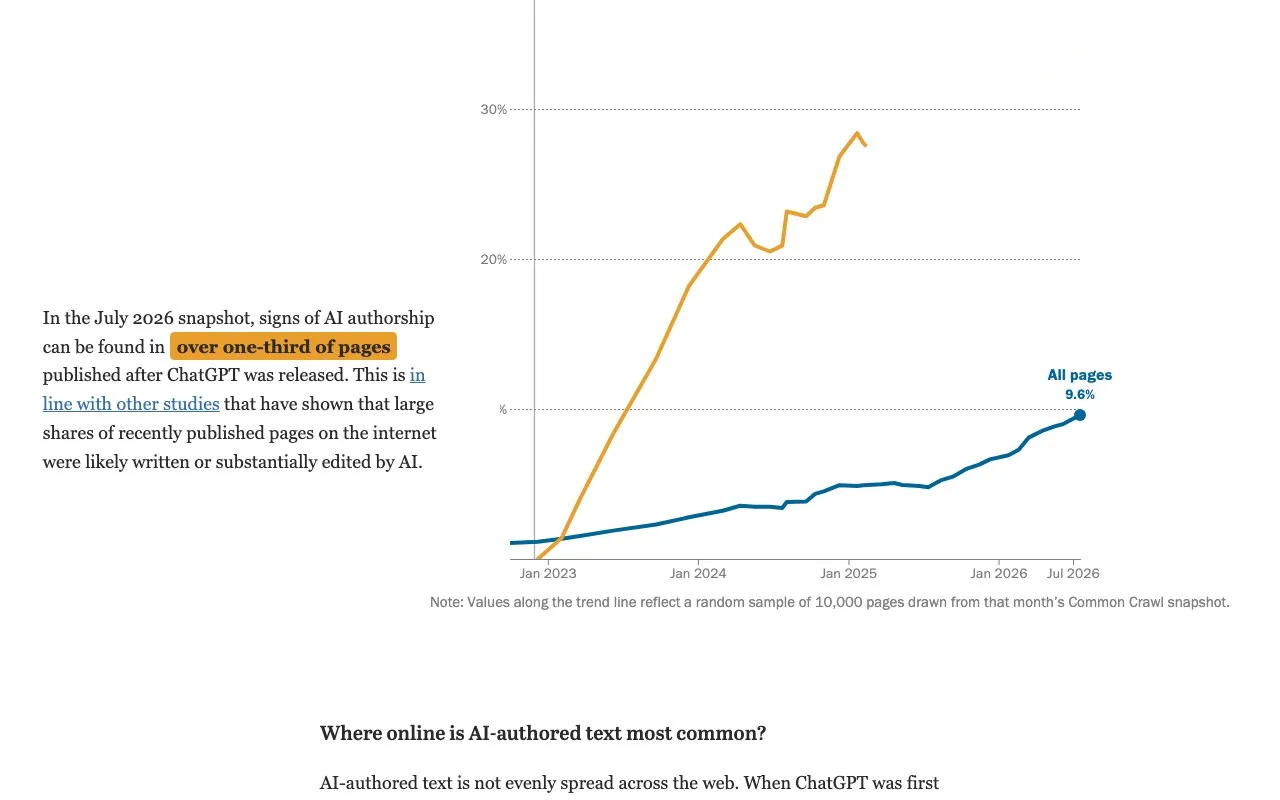
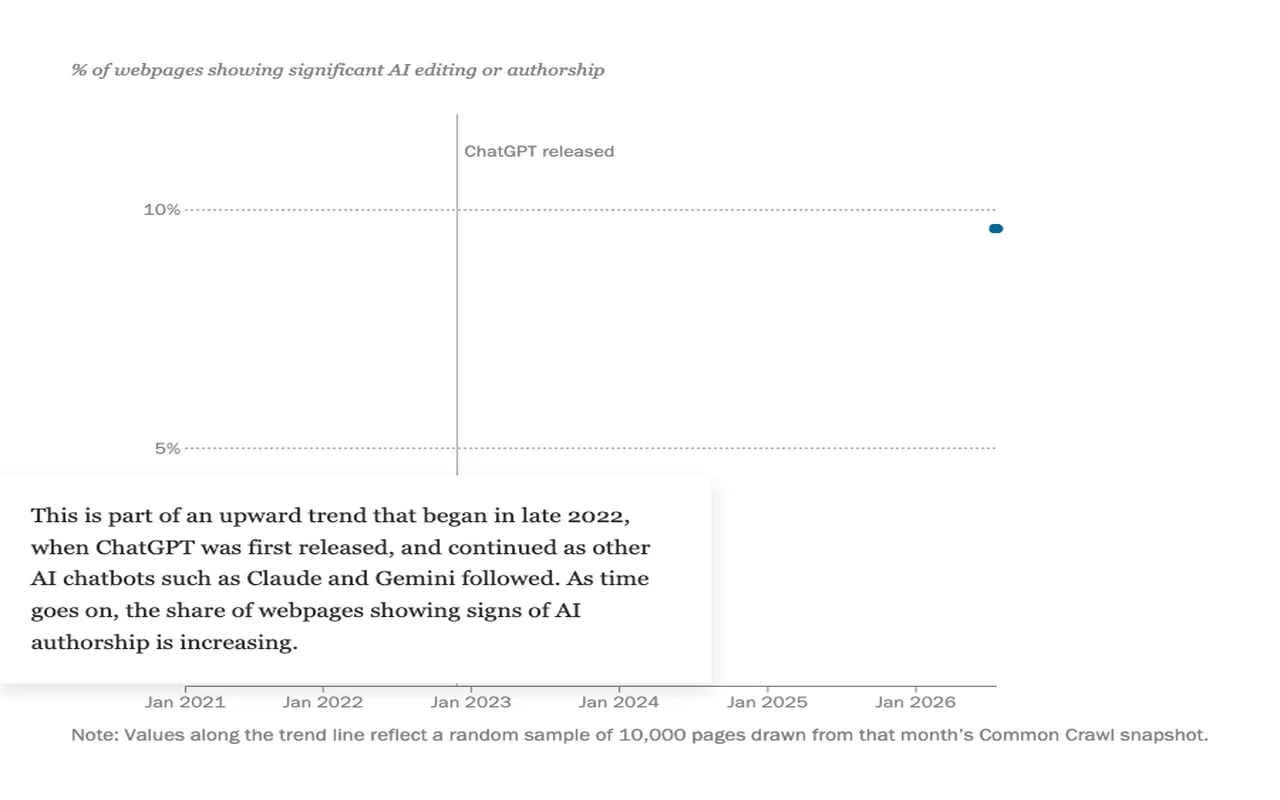
Результат по срезу июля 2026: среди ВСЕХ страниц выборки (включая написанные до ChatGPT) признаки ИИ-авторства несут 9,6% - почти каждая десятая. Но если смотреть только на страницы, опубликованные ПОСЛЕ выхода ChatGPT, доля намного выше - более трети. Разница объясняется просто: старые страницы физически не могли быть написаны нейросетью, которой ещё не существовало, а новые страницы всё активнее пишутся с её участием
Откуда взялась «треть» и что она НЕ означает
Дословная формулировка отчёта - «более трети страниц, опубликованных после выхода ChatGPT, несут признаки ИИ-авторства». Три уточнения, без которых цифру легко понять неправильно
Во-первых, треть - это доля НОВОГО контента за определённый период, а не треть всего интернета целиком. Весь массив вместе со старыми страницами даёт куда меньшую цифру - 9,6%
Во-вторых, сами авторы исследования прямо предупреждают: «модели обнаружения ИИ не идеальны - они иногда неправильно классифицируют написанные человеком документы как содержащие признаки ИИ-авторства, и наоборот». То есть это оценка программы-детектора, а не подсчёт по факту авторства каждой страницы
В-третьих, доля сильно разная по типам сайтов. На доменах .com признаки ИИ-текста нашли примерно у каждой десятой страницы, на .org - у 4,6%, а на .edu и .gov (сайты университетов и государственных органов) - только около 1%. Разница логичная: у коммерческих сайтов больше стимула публиковать много контента быстро
Почему у разных исследований разные цифры
Если поискать тему дальше, найдутся и другие числа - иногда вдвое больше трети. Причина не в том, что кто-то ошибся, а в том, что каждое исследование считает своё
Ahrefs в апреле 2025 проверил около 900 000 новых страниц собственным детектором и получил 74,2%. Но эта цифра считает ЛЮБУЮ примесь ИИ - даже если человек написал текст сам, а нейросетью только поправил пару абзацев, страница попадает в статистику. Внутри этих 74,2% только 2,5% страниц написаны ИИ полностью без правки человека, а 71,7% - это смесь человека и нейросети
Graphite в начале 2026 проверил 55 400 статей по более строгим фильтрам и получил почти половину - 49,9% статей, где ИИ признан ОСНОВНЫМ автором, а не просто участвовал
Pew Research считает иначе: не примесь и не преобладание, а статистический отпечаток авторства по всему тексту целиком через модель Pangram. Отсюда и цифра «треть» - она про признаки авторства, а не про долю правки
| Исследование | Что именно мерили | Период | Результат |
|---|---|---|---|
| Pew Research | статистический отпечаток ИИ-авторства, страницы после выхода ChatGPT | 2021-2026, снимок июль 2026 | более трети новых страниц |
| Ahrefs | любая примесь ИИ-текста на странице | апрель 2025 | 74,2% страниц (из них 2,5% - целиком ИИ) |
| Graphite | ИИ признан ОСНОВНЫМ автором статьи | 1 квартал 2026 | 49,9% статей |
Таблица прокручивается вбок →
Практический вывод из этой таблицы: когда встречаешь заголовок «столько-то процентов интернета пишет ИИ», первым делом ищи не саму цифру, а что именно за ней измерили - примесь, преобладание или статистический отпечаток. Это три разных вопроса с тремя разными ответами
Где именно в интернете ИИ-текста больше всего
Доля ИИ-текста распределена по интернету неровно, и разница по типам сайтов видна прямо в том же отчёте Pew Research по срезу июля 2026
| Тип сайта | Доля страниц с признаками ИИ-авторства |
|---|---|
| .com (коммерческие сайты) | около 10% |
| .org (некоммерческие организации) | 4,6% |
| .edu (университеты) | около 1% |
| .gov (государственные органы) | около 1% |
Таблица прокручивается вбок →
Разница логичная: у коммерческого сайта прямой стимул публиковать много материала быстро, а у университета или ведомства текст чаще пишет конкретный человек под своим именем, и скорость публикации не так важна. Практический вывод: если источник - университетский или государственный сайт, вероятность наткнуться на типовой ИИ-пересказ ниже примерно в десять раз, чем на обычном коммерческом сайте
Как отличить ИИ-текст на слух - и почему это больше не работает надёжно
Тот же отчёт Pew Research отдельно посчитал, как изменились лингвистические привычки текста в интернете с 2023 по 2026 год - это тоже практический сигнал, хотя и менее надёжный, чем два признака из раздела выше
| Языковая привычка | Изменение 2023 → 2026 |
|---|---|
| Длинное тире в тексте | встречается вдвое чаще |
| Оксфордская запятая (запятая перед «и» в перечислении) | на 63% чаще |
| Характерный «словарь ИИ» (особые обороты и связки) | вырос больше чем вдвое |
| Конструкция «это не просто X, это Y» | почти втрое чаще |
Таблица прокручивается вбок →
Проблема в том, что эти признаки легко подделать намеренно и так же легко убрать редактурой - причёсанный ИИ-текст сегодня звучит совершенно живо, а живой человек иногда пишет с длинным тире и оксфордской запятой просто по привычке. Поэтому лингвистические маркеры - это дополнительная подсказка, а не замена двум главным признакам: личному опыту автора и названной методологии у цифр
Что это значит для тебя, если ты ищешь информацию
Если каждая третья новая страница пишется с участием нейросети, растёт шанс наткнуться не на первоисточник, а на пересказ пересказа - типовой текст, собранный из уже известных фактов без нового наблюдения
Два признака, по которым стоит проверять источник, работают надёжнее, чем попытка «на слух» отличить робота от человека - современный ИИ-текст после правки часто звучит совершенно живо
Смежная часть работы разобрана в гайде что известно, а что слух - факты на 06.09.2026
Два признака первоисточника, а не пересказа
- Личный опыт автора указано, что автор лично проверил, протестировал или пережил описанное - не «специалисты считают», а «я сделал так и получил вот это»
- Названная методология у цифр если в тексте есть статистика, рядом написано, кто и как её посчитал - выборка, период, инструмент; голая цифра без этого - красный флаг
Если оба признака отсутствуют - перед тобой, вероятнее всего, типовой текст, обобщающий уже известное, и его стоит перепроверить по другому источнику, прежде чем на него опираться
Это касается и того, как ты сам ищешь ответы. Если для поиска информации ты уже используешь не только строку поисковика, а нейросеть вроде ChatGPT или Gemini - разница между ними в том, откуда каждая берёт факты и насколько прозрачно называет источник, разобрана в сравнении Gemini и ChatGPT для поиска. Отдельная особенность ChatGPT - как именно он показывает, откуда взял ответ, и почему эта прозрачность не всегда одинаковая, в гайде про источники ChatGPT. А общий обзор того, как устроен ИИ-поиск и чем он отличается от привычной выдачи ссылок, - в отдельном разборе ИИ-поиска
Если чаще сравниваешь ответы Claude и ChatGPT между собой, у меня есть прямое сопоставление - Claude или ChatGPT: что выбрать, а для учебных и рабочих задач, где важно не спутать пересказ с фактом, - как использовать нейросеть для учёбы, не потеряв критическое мышление
Что это значит для тебя, если ты сам пишешь тексты
Здесь у роста доли ИИ-текста есть обратная сторона, которая работает в пользу живого автора. Google прямо говорит, что не наказывает контент за то, что он написан с помощью нейросети, но опускает в выдаче контент, который автоматизирован, не оригинален и не приносит реальной пользы. При этом в обновлении марта 2026 компонент «личный опыт» (Experience) из формулы E-E-A-T стал главным различителем в конкурентных темах: тексты с проверяемым личным опытом и конкретными деталями обгоняют исчерпывающие, но безличные страницы
Логика простая: нейросеть умеет обобщать информацию в промышленных масштабах, но не может произвести настоящий личный опыт - она не проверяла сервис своими руками и не наступала на грабли за тебя. Значит, чем больше в интернете типовых пересказов, тем заметнее на их фоне текст, где есть твой собственный случай, твоя цифра из своего замера, твоя ошибка и то, что после неё исправил
Если задача - научиться самому писать так, чтобы текст не читался как обобщение, у меня есть отдельные разборы: пять умений, которые убирают роботный голос из текста и восемь промптов, которые чистят ИИ-текст от воды и канцелярита. Если нужно быстро прогнать готовый текст через детектор и посмотреть, что он покажет - три бесплатных детектора ИИ-текста и как они работают на практике. А если только учишься писать текст нейросетью с нуля, начать стоит с базового гайда, как написать текст нейросетью
Соцсети и поиск - разные правила игры
Правила выше касаются в первую очередь поиска и статей, а не соцсетей - там своя механика демонетизации за неоригинальный контент, и она устроена иначе. Если работаешь с видео или постами в соцсетях, а не со статьями для поиска, разбор конкретных правил YouTube и Meta лежит в отдельном гайде про то, как соцсети режут ИИ-контент - там же честная граница мифа и реальной демонетизации
Что с этим делают сами поисковики
Google официально заявляет, что не наказывает контент только за то, что он написан с помощью нейросети - позиция названа прямо в блоге Google Search Central. Наказание идёт за другое: контент, который автоматизирован, не оригинален и не приносит пользы конкретному читателю, независимо от того, кто его написал
Это значит, что рост доли ИИ-текста в интернете не превращается автоматически в рост доли текста, который хорошо ранжируется. Поисковик отдельно оценивает пользу и оригинальность, и именно эта оценка в марте 2026 сместилась в сторону личного опыта автора - то есть в сторону ровно того, чего у типового ИИ-пересказа нет
Куда движется доля ИИ-текста дальше
По графику из отчёта Pew Research рост не линейный, а ускоряющийся: с начала 2023 по июль 2026 линия «страницы после ChatGPT» прошла путь от нуля до отметки выше 28%, и на последнем участке (конец 2025 - середина 2026) рост заметно круче, чем в середине пути
Прямого прогноза сам отчёт не даёт - это было бы домыслом поверх чужих данных, а не фактом. Но практический вывод из формы графика такой: доля вряд ли начнёт снижаться сама по себе, пока не появится встречная сила - либо более строгий фильтр поисковика по пользе контента, либо изменение экономики самого производства текста в интернете. Обе силы уже действуют (раздел выше про позицию Google), но пока не разворачивают линию вниз, а только замедляют её на отдельных типах сайтов вроде .edu и .gov
Частые ошибки при чтении новости про «треть интернета»
Четыре вещи, которые чаще всего путают в этой теме
- Путают «треть новых страниц» с «третью всего интернета» это разные числа - весь массив вместе со старыми страницами даёт 9,6%, а не треть
- Берут цифру без методологии за абсолют «74% интернета - ИИ» и «треть интернета - ИИ» из разных заголовков считают совершенно разное, и оба по-своему верны
- Считают, что ИИ-текст всегда плохой текст Google прямо говорит, что не наказывает за сам факт использования ИИ - наказывает за отсутствие пользы и оригинальности, независимо от того, кто написал
- Пытаются определить авторство «на слух» причёсанный нейросетевой текст сегодня звучит живо - надёжнее искать личный опыт и методологию у цифр, чем полагаться на стиль
Что ещё почитать про ИИ-контент и текст
- Детекторы ИИ-текста в 2026: 3 сервиса против ChatGPT - если нужно проверить конкретный текст прямо сейчас
- Соцсети режут ИИ-контент: 2 правила YouTube, как публиковать - отдельные правила для видео и постов, не для статей
- Текст от нейросети пахнет ИИ: 5 умений, которые это чинят - как самому писать без роботного голоса
- Как очеловечить текст нейросети: 8 промптов - готовые промпты для чистки уже написанного текста
- Как написать текст нейросетью с нуля - базовый гайд для тех, кто ещё не пробовал
- ИИ-поиск: чем отличается от привычной выдачи - как устроен поиск ответов через нейросеть
- Gemini или ChatGPT: что выбрать для поиска - сравнение двух самых частых вариантов
- Откуда ChatGPT берёт источники своих ответов - прозрачность конкретного сервиса
- Claude или ChatGPT: что выбрать - прямое сравнение для разных задач
- Нейросеть для учёбы: как не потерять критическое мышление - если используешь ИИ для учебных задач
- Бесплатные нейросети без карты - подборка того, что работает без единой оплаты
- Контент и продвижение: все разборы темы - полный список гайдов по текстам и продвижению на сайте
Источники
Все источники открыты прямым запросом 5 сентября 2026 года; у отчёта Pew Research дополнительно сняты собственные кадры живым Playwright headless
- Pew Research Center: How Much of the Internet Is Written With AI? - главный источник цифры «треть», методология Pangram и Common Crawl, опубликован 20.08.2026
- Ahrefs: What percentage of new content is AI-generated - сравнительная цифра 74,2% с другой методологией подсчёта (любая примесь ИИ)
- Google Search Central: Google Search's guidance about AI-generated content - официальная позиция Google про наказание не за ИИ-авторство, а за отсутствие пользы
- Slashdot: One-Third of Web Pages are Now Written With AI, Says Pew Research - независимое подтверждение цифры и даты публикации отчёта
- Pensito: Pew - One-Third of Content on the Internet Is Produced by AI - второе независимое подтверждение
Памятка: как жить с третью интернета на нейросетях
Шесть строк - что проверять как читателю и что менять как автору
Сохрани себе
- Встретил цифру про долю ИИ-контента - сначала ищи методологию, а потом верь числу
- «Треть интернета» - это треть НОВЫХ страниц после ChatGPT, а не всего интернета целиком
- Проверяй источник по двум признакам - личный опыт автора и названная методология у цифр
- Три статьи с одной и той же мыслью разными словами могут быть одним пересказанным текстом
- Пиши то, что видел и делал сам - это ровно то, что нейросеть обобщить не может
- Финальная правка своими словами и добавление личного опыта - не формальность, а конкурентное преимущество в поиске
Порог входа
Прочитал бесплатно - следующий шаг тоже бесплатный
Всё, что нужно, чтобы правильно читать статистику про ИИ-контент и писать тексты, которые не тонут в потоке пересказов, ты только что прочитал бесплатно
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Правда ли, что треть интернета написана нейросетями?
Точнее - треть НОВЫХ страниц, опубликованных после выхода ChatGPT в конце 2022 года, несёт признаки ИИ-авторства по данным отчёта Pew Research от 20.08.2026. Если считать весь интернет целиком, включая страницы, написанные до появления ChatGPT, доля намного меньше - 9,6%
Почему разные источники называют разные проценты?
Потому что каждое исследование измеряет своё. Pew Research ищет статистический отпечаток ИИ-авторства через модель Pangram. Ahrefs считает любую примесь ИИ-текста на странице, даже если человек написал текст сам и только поправил нейросетью - отсюда цифра 74,2%. Graphite засчитывает страницу только там, где ИИ признан основным автором - отсюда 49,9%
Как понять, что передо мной пересказ, а не первоисточник?
Ищи два признака: указан ли у автора личный опыт по теме («я проверил», «я сделал так и получил вот это»), а не «специалисты считают», и названа ли методология там, где приводится статистика - выборка, период, способ подсчёта. Оба признака отсутствуют - перед тобой, вероятнее всего, обобщение уже известного
Наказывает ли Google сайты за ИИ-текст?
Нет, не за сам факт использования нейросети. Google прямо говорит, что не наказывает контент только за то, что он написан с помощью ИИ, но понижает в выдаче то, что автоматизировано, не оригинально и не приносит реальной пользы - независимо от того, кто автор
Что мне как автору делать с этой новостью?
Писать то, что видел и делал сам - конкретный случай, свою цифру, свою ошибку и то, что после неё исправил. Это ровно то, что нейросеть не может произвести за тебя, и именно личный опыт стал главным различителем в обновлении поиска марта 2026