Разбор · Scrapling · сентябрь 2026
Scrapling: сборщик данных, который проходит Cloudflare, 4 строки
Открой окно для ввода команд (на Mac это Терминал в папке Программы, Утилиты; на Windows PowerShell, там вместо ~/scrapling/bin/ пишется ~\scrapling\Scripts\, а скрипт создаёшь в Блокноте) и вставь четыре строки подряд. Первые две ставят Scrapling с браузерами, третья пишет скрипт из четырёх строк, четвёртая открывает им сайт, который обычный запрос не пускает
python3 -m venv ~/scrapling && ~/scrapling/bin/pip install "scrapling[fetchers,ai]"
~/scrapling/bin/scrapling install
printf '%s\n' 'from scrapling.fetchers import StealthyFetcher' 'page = StealthyFetcher.fetch("https://www.glassdoor.com/", headless=True, solve_cloudflare=True, network_idle=True)' 'print("status:", page.status, "· заголовков:", len(page.css("h1, h2")), "· ссылок:", len(page.css("a")))' 'print(page.css("h1::text, h2::text").getall()[:5])' > stels.py
~/scrapling/bin/python stels.py
Последняя строка напечатает status: 200, число заголовков и ссылок и первые пять заголовков страницы. У меня установка заняла 100 секунд, браузеры к ней ещё 3, сама страница открылась за 5,19 секунды: 193 ссылки, пять заголовков. Это и есть скрапер из ролика: инструмент на Python, который приносит страницу оттуда, куда обычный запрос не пускают, и достаёт из неё то, что ты назвал
Проверь одно сразу после первого блока: в окне строка «status: 200» и список заголовков сайта, который обычному запросу отдаёт заглушку. Есть - Scrapling стоит и проходит Cloudflare, у меня это заняло 5 секунд, дальше выборка в файл и Claude Code. Вместо этого ModuleNotFoundError на scrapling.fetchers - пакет поставлен без хвоста [fetchers], повтори первые две строки. Заглушка Just a moment вместо страницы - в скрипте стоит Fetcher вместо StealthyFetcher
Сайт с защитой: что ты только что прошёл
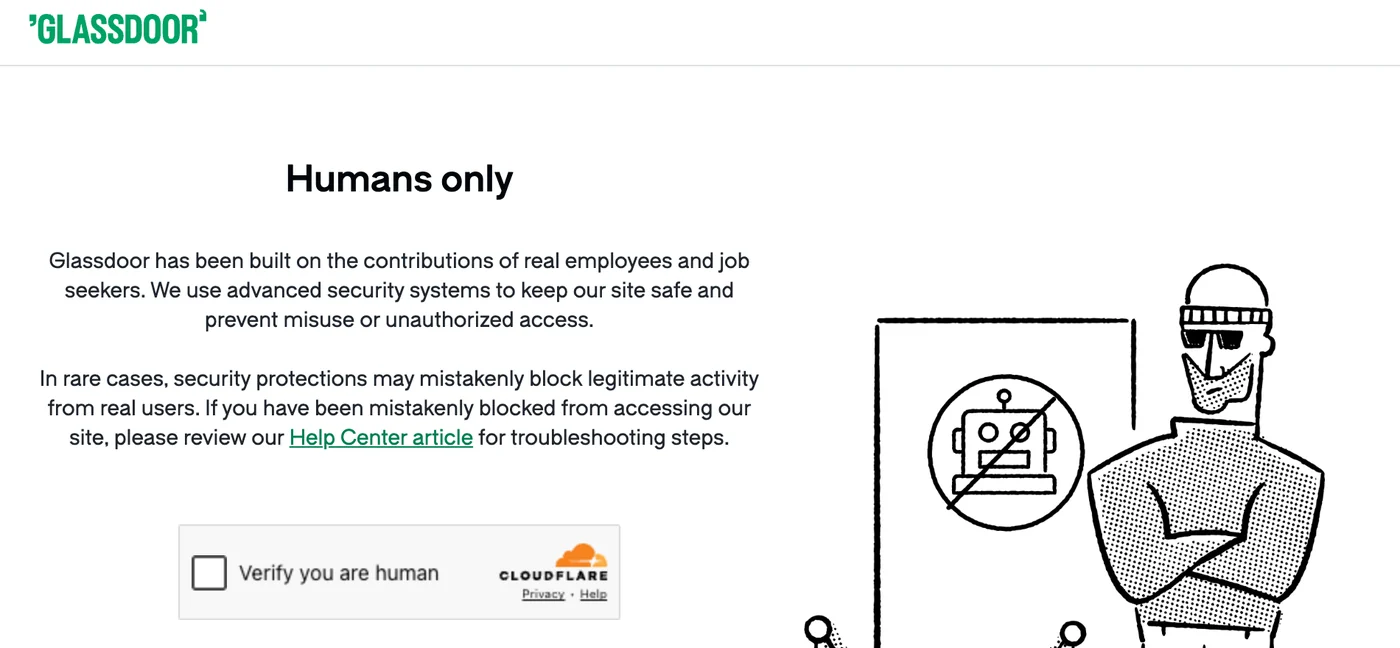
В ролике главное было не про скорость, а про блокировки. Тот же адрес я открыл тремя способами. Обычный Fetcher.get получил вместо страницы заглушку «Authenticating...», данных за ней нет. Обычный браузер без стелса, класс DynamicFetcher, простоял 101 секунду и упёрся в заглушку «Just a moment...»: на экране надпись «Humans only» и галочка Cloudflare «Verify you are human»
StealthyFetcher с флагом solve_cloudflare=True из твоего первого блока открыл ту же страницу за 5,19 секунды. Никаких платных посредников и ключей, тот же ноутбук и тот же сетевой адрес. Замени адрес в stels.py на свой и запусти ещё раз
Что именно делает стелс: браузер Scrapling маскирует признаки автоматизации, по которым Cloudflare отличает робота, и если проверка всё равно появилась, сам жмёт галочку. В README проекта написано, что он проходит Cloudflare Turnstile и Interstitial. Не любую защиту: g2.com у меня не открылся ни обычным запросом, ни стелсом: та же заглушка и строка No Cloudflare challenge found, там стоит другая система. Это честная граница инструмента, и в таблице ошибок ниже она есть
Первая выборка в файл: коробки и хвосты
Разбор первого блока для тех, кто открыл Терминал впервые. Первая строка заводит отдельную папку scrapling в домашнем каталоге и ставит туда Scrapling: хвост [fetchers,ai] тянет загрузчики страниц и модуль для агентов, без него Scrapling умеет только разбирать уже скачанный текст. Вторая строка докачивает браузеры, они нужны для сайтов с защитой. Третья записывает скрипт в файл stels.py, четвёртая его запускает
Теперь заберём со страницы не счётчики, а данные в файл. Вставь ещё две строки: скрипт снимает десять цитат с авторами со страницы-тренажёра и пишет их в citaty.csv
printf '%s\n' 'from scrapling.fetchers import Fetcher' 'import csv' 'page = Fetcher.get("https://quotes.toscrape.com/")' 'rows = [{"цитата": q.css("span.text::text").get(), "автор": q.css("small.author::text").get()} for q in page.css("div.quote")]' 'w = csv.DictWriter(open("citaty.csv", "w", newline=""), fieldnames=["цитата", "автор"]); w.writeheader(); w.writerows(rows)' 'print("status:", page.status, "· строк собрано:", len(rows))' > proba.py
~/scrapling/bin/python proba.py
В окне появится строк собрано: 10, рядом файл citaty.csv, у меня страница пришла за 1,13 секунды. Внутри скрипта одна идея. Fetcher.get(адрес) приносит страницу, для открытых сайтов стелс не нужен. page.css("div.quote") находит на ней все блоки с цитатами: div.quote это «коробка с меткой quote», такие метки стоят у любого сайта, и подсмотреть их можно правой кнопкой в браузере, пункт «Просмотреть код». Хвост ::text забирает текст из коробки, .get() отдаёт первый найденный, .getall() все сразу. Дальше обычная запись в CSV, который открывается Numbers, Excel и Google Таблицами
Подключаем к Claude Code, чтобы агент ходил по сайтам сам
В ролике я говорил про подключение к Claude Code или Codex. У Scrapling есть свой модуль MCP: так агенту отдают инструмент, чтобы он сам звал его по ходу задачи. В Claude Code подключение одна команда, путь к модулю лежит в той же папке, куда ты ставил Scrapling
claude mcp add ScraplingServer ~/scrapling/bin/scrapling-mcp
claude mcp get ScraplingServer
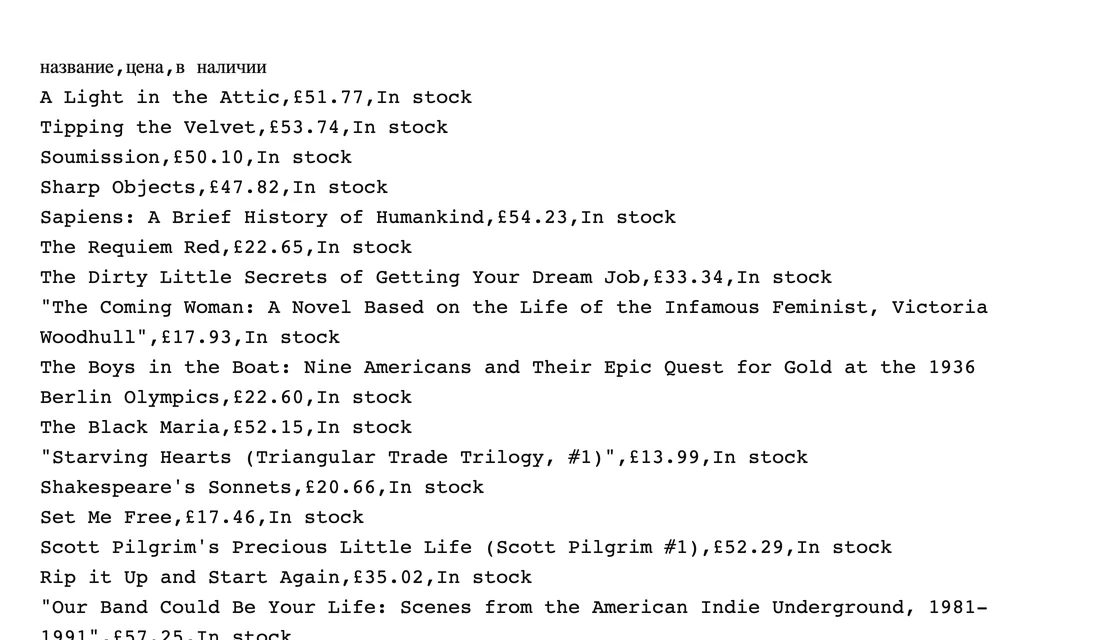
Вторая строка должна напечатать Status: ✔ Connected. Дальше запускаешь claude в любой папке и пишешь обычными словами: «Используй инструменты ScraplingServer. Забери страницу https://books.toscrape.com/ и выпиши названия и цены первых пяти книг списком. Сохрани в файл knigi-ot-agenta.md»
У меня агент за 36 секунд и четыре хода сам выбрал инструмент make_request, скачал каталог и записал файл с пятью строками: «A Light in the Attic - £51.77» и дальше по списку. Ни строчки кода я при этом не писал. Инструментов у модуля тринадцать, для начала хватает пяти, и агент выбирает их по твоей фразе:
| Инструмент модуля | Что делает | Когда просить |
|---|---|---|
make_request | обычный быстрый запрос без браузера | открытые сайты, каталоги, таблицы |
fetch | открывает страницу в браузере | страницы, которые дорисовываются скриптами |
stealthy_fetch | стелс-браузер с проходом Cloudflare | сайты с заглушкой «Just a moment» |
open_session и session_fetch | держат один браузер на несколько страниц | ходить по разделам сайта подряд |
screenshot | снимок открытой страницы | проверить глазами, что агент видит |
Для сайта с защитой скажи прямо: «используй stealthy_fetch», сам он по умолчанию берёт самый быстрый make_request. Про Codex в документации Scrapling отдельной команды нет, там сказано «Claude, Cursor и другие агенты с поддержкой MCP»: смотри, как в твоём агенте добавляется модуль MCP, и подставь тот же путь к scrapling-mcp. Как устроены такие модули и зачем они агенту, я разбирал в отдельной статье про MCP
Одна деталь про безопасность. Модуль по умолчанию отдаёт модели только основной текст страницы: вырезает скрытые элементы, комментарии и невидимые символы, через которые сайт мог бы подсунуть агенту чужую команду. Это написано в документации модуля, и ради одного этого его стоит предпочесть «скачай страницу и вставь в чат»
Что забирать: список с ценами и готовая таблица
Два случая закрывают почти всё, за чем приходят к скраперу. Список карточек с ценой: у каждой карточки своя коробка, внутри название и цена. Готовая таблица: строки tr, ячейки td. Вот оба на страницах-тренажёрах, у меня каталог пришёл за 0,98 секунды, таблица из 9 колонок и 25 строк за 0,88
printf '%s\n' 'from scrapling.fetchers import Fetcher' 'import csv' 'page = Fetcher.get("https://books.toscrape.com/")' 'knigi = [{"название": k.css("h3 a::attr(title)").get(), "цена": k.css("p.price_color::text").get()} for k in page.css("article.product_pod")]' 'w = csv.DictWriter(open("knigi.csv", "w", newline=""), fieldnames=["название", "цена"]); w.writeheader(); w.writerows(knigi)' 'page = Fetcher.get("https://www.scrapethissite.com/pages/forms/")' 'tabl = page.css("table.table")[0]' 'stroki = [[c.strip() for c in tr.css("td::text").getall()] for tr in tabl.css("tr.team")]' 'csv.writer(open("tablica.csv", "w", newline="")).writerows([[h.strip() for h in tabl.css("th::text").getall()]] + stroki)' 'print("книг:", len(knigi), "· строк таблицы:", len(stroki))' > sbor.py
~/scrapling/bin/python sbor.py
Новое здесь одно: ::attr(title) забирает не текст, а атрибут, в каталоге название книги лежит именно там. Остальное те же коробки и тот же CSV. Чтобы подставить свой сайт, открой его страницу, правой кнопкой по нужной цене, «Просмотреть код», и перепиши имена классов в кавычках
Теперь про «в 700 раз быстрее» из ролика. В README у проекта таблица: BeautifulSoup с lxml медленнее в 785 раз. Я прогнал их же метод у себя, 5000 вложенных элементов: Scrapling 1,70 миллисекунды, BeautifulSoup 749, в 441 раз. На плоской странице из 5000 карточек разница уже 86 против 109 миллисекунд, в 1,3 раза. И это время разбора уже скачанной страницы, а сама загрузка по сети у меня шла около секунды при любом разборщике. Так что число из ролика честное для того замера, который делают авторы, а на твоей задаче выигрыш будет в том, что страницы приходят, а не в миллисекундах. Своё число снимается одной командой: скачай benchmarks.py из репозитория и запусти его тем же ~/scrapling/bin/python
| Замер | Scrapling | BeautifulSoup + lxml | Во сколько раз |
|---|---|---|---|
| README проекта, 5000 вложенных элементов | 1,99 мс | 1562 мс | ~785 |
| у меня, тот же метод | 1,70 мс | 749 мс | 441 |
| у меня, плоская страница из 5000 карточек | 86 мс | 109 мс | 1,3 |
| загрузка страницы по сети (любой парсер) | 0,9-1,3 с | 0,9-1,3 с | 1 |
Что ломается и что делать
| Что на экране | Что это значит | Что сделать |
|---|---|---|
ModuleNotFoundError: No module named 'scrapling.fetchers' | пакет поставлен без хвоста [fetchers] | повторить первую строку с "scrapling[fetchers,ai]" в кавычках, потом scrapling install |
в окне Just a moment... вместо страницы, строк собрано 0 | сайт закрыт проверкой Cloudflare, обычный Fetcher.get её не проходит | взять StealthyFetcher.fetch с solve_cloudflare=True из первого блока |
command not found: python3 или окно на Windows | Python не стоит либо путь другой | поставить Python с python.org; на Windows пути вида ~\scrapling\Scripts\python, скрипт создать в Блокноте вместо printf |
No Cloudflare challenge found и всё равно заглушка | защита не Cloudflare, стелс её не решает; у меня так ответил g2.com | этот сайт Scrapling не откроет, ищи у него открытый API или другой источник тех же данных |
Connection timed out сразу после Cloudflare captcha is solved | проверка пройдена, а сам сайт за ней не ответил; так три раза подряд вёл себя тренажёр из README | повторить позже или взять другой адрес, Scrapling тут ни при чём |
Status: ✗ Failed to connect у claude mcp get | путь к scrapling-mcp неверный или пакет ставился без [ai] | ls ~/scrapling/bin/scrapling-mcp, файла нет - повторить первую строку установки |
| агент отвечает, но файл не сохраняет | Claude Code ждёт разрешения на запись | подтвердить в диалоге либо запустить с --permission-mode acceptEdits |
| страница открылась не на том языке | сайт выбрал язык по адресу выхода в сеть, у меня glassdoor пришёл на нидерландском | передать extra_headers={"Accept-Language": "ru"} либо принять как есть, данные те же |
Первая и вторая строки таблицы стоили мне двух заходов: без [fetchers] Scrapling ставится, но загрузчиков в нём нет, а заглушку на обычном запросе легко прочитать как «инструмент не работает», хотя работает ровно так, как обещал ролик, просто нужен другой класс
Что ещё почитать
Пришёл с ролика за сбором списка словами, без кода и без установки: скрапинг сайта без кода, тот разбор здесь. Нужны не цены, а адреса и телефоны: скрапинг контактов. Хочешь понять, что за модуль ты только что подключил к Claude Code и какие ещё бывают: MCP-сервер простыми словами. Тянет собрать не скрипт, а целую систему из агентов: мультиагентные системы
Источники
Все страницы открыты живым запросом 21 сентября 2026 года; числа, команды и тексты ошибок сняты собственным прогоном на своей машине
- Страница проекта Scrapling на GitHub - код, лицензия BSD-3-Clause, описание загрузчиков и версия прогона 0.4.15
- Описание проекта Scrapling - таблица замеров скорости разбора, примеры Fetcher, StealthyFetcher и DynamicFetcher, установка с хвостами [fetchers] и [ai]
- Файл замеров benchmarks.py - метод, которым авторы получили свои числа: 5000 вложенных элементов, среднее по 100 прогонам
- Модуль MCP в документации Scrapling - команда подключения к Claude Code, список инструментов make_request, fetch, stealthy_fetch, screenshot, очистка страницы от скрытого текста
- Документация Scrapling - селекторы css, хвосты ::text и ::attr, методы get и getall
- Собственный прогон 21 сентября 2026 года на macOS: установка 100 секунд, первая страница 1,13 секунды, glassdoor.com через стелс открылся за 5,19 секунды, запрос агенту Claude Code 36 секунд
Памятка: Scrapling одной страницей
Повторить на втором компьютере без статьи
Сохрани себе
- поставить: python3 -m venv ~/scrapling и pip install "scrapling[fetchers,ai]" в кавычках, потом scrapling install
- первая страница: Fetcher.get(адрес), page.css("коробка"), хвост ::text для текста, ::attr(имя) для атрибута
- проверить: файл csv на диске и строка «строк собрано: 10»
- сайт с защитой: StealthyFetcher.fetch(адрес, headless=True, solve_cloudflare=True)
- подключить к Claude Code: claude mcp add ScraplingServer ~/scrapling/bin/scrapling-mcp
- позвать агента: «Используй инструменты ScraplingServer, забери страницу ... и выпиши ...»
- Just a moment на обычном запросе: не поломка, нужен StealthyFetcher
- No Cloudflare challenge found и снова заглушка: защита другая, этот сайт не откроется
Про следующий шаг
Скрапер, который не блокируют, полезен ровно настолько, насколько ты знаешь, что с данными делать
Установка занимает две минуты, и на этом лёгкая часть заканчивается. У себя после каталога книг я упёрся в то, что список на диске лежит, а сигнала из него нет: кто сравнит сегодняшний файл со вчерашним и кому напишет про разницу
Это и есть разница между скриптом и рабочей вещью: сбор, хранение, сравнение, отправка. Scrapling закрывает первый пункт из четырёх
На Лагере мы берём твою задачу, режем её на шаги и за три дня доводим до работающего результата. Приходишь с адресом сайта, уходишь с собранной вещью
Заявка в закрытый канал, одобряю сразу. Бот напишет первым и отдаст три дня Лагеря. Бесплатно
Частые вопросы
Scrapling бесплатный?
Да. Код открыт, лицензия BSD-3-Clause, ставится обычным pip. Платных частей внутри нет, сторонние сервисы для прохода Cloudflare в моём прогоне не понадобились
Это законно?
Scrapling скачивает то, что сайт и так показывает любому браузеру. Что с этим делать дальше, решают правила конкретного сайта и закон твоей страны: чужие персональные данные и платный контент собирать нельзя вне зависимости от инструмента. Для своих задач я беру открытые каталоги, цены и таблицы
Обязательно ставить браузеры через scrapling install?
Для первого блока нет: Fetcher.get работает без браузера. Для сайтов с защитой да: StealthyFetcher и DynamicFetcher открывают настоящий браузер, и без scrapling install они упадут с ошибкой про отсутствующий исполняемый файл
Почему в ролике 700 раз, а у тебя 441?
Потому что число зависит от машины и от того, что меряют. У авторов в README 785 на их железе, у меня тем же методом 441, а на плоской странице 1,3. Все три числа про разбор уже скачанной страницы, сама загрузка по сети идёт около секунды у любого инструмента. Своё число снимается их же benchmarks.py
Агент через MCP может открыть сайт с защитой?
Да, у модуля есть инструмент stealthy_fetch, тот же стелс-браузер. Скажи агенту прямо: «используй stealthy_fetch». По умолчанию он берёт самый быстрый make_request, и на сайте за Cloudflare получит ту же заглушку, что и ты обычным запросом
Если дочитал до конца
Дальше я пишу в своём канале
Я работаю один, без команды и подрядчиков: всё собираю Claude, Claude Code и агентами. В канале показываю внутрянку: какие инструменты из роликов прижились, где обещания расходятся с прогоном, что пришлось выкинуть через неделю. Разборов там заметно больше, чем доезжает до сайта
Это заявка на вход в мой закрытый канал, одобряю сразу. Бесплатно