Нейросети · Фото
Реставрация старых фото нейросетью: 4 шага без подмены лица

Половина того, что называют реставрацией фото нейросетью, реставрацией не является: модель не проявляет утраченное, а дорисовывает похожее. Я взял стеклянный негатив около 1914 года, прогнал его через два разных движка - апскейлер Real-ESRGAN x4plus и восстановитель лиц GFPGAN v1.4 - и померил, насколько каждый сдвинул лицо. Разрыв вышел в 3,9 раза
Дальше по порядку: чем эти движки отличаются, что вытянется наверняка, чего не будет никогда, куда идти бесплатно и какой один переключатель решает, останется на снимке ваш прадед или похожий на него человек
Бесплатно это делается на официальной демонстрации CodeFormer: загрузить копию скана не крупнее 4 мегапикселей, поставить ползунок Codeformer_Fidelity ближе к единице, нажать Enhance Image. Заводское значение 0,5 стоит посередине между «красиво» и «похоже». Цена вопроса видна по замеру на движке того же класса: на архивном негативе восстановитель лиц GFPGAN v1.4 сдвинул черты в 3,9 раза сильнее апскейлера Real-ESRGAN x4plus
Один снимок вы сейчас восстановите за пару минут. Собрать из этого работающий порядок для целого архива - задача другого размера, и ровно ей учит ИИ-Лагерь
Что происходит со старым снимком внутри нейросети?
Она не «проявляет» то, что скрыто под царапинами, а достраивает недостающее по тому, как обычно выглядят лица и ткани. Разница принципиальная. Реставратор с кисточкой работает с тем, что осталось на бумаге. Модель работает с тем, что она видела на миллионах других снимков, и подставляет похожее в те места, где данных не хватило
Отсюда растёт всё остальное в этой статье. Если снимок выцвел и запылился, подстановка почти не понадобится, и результат будет честным. Если у человека на лице сохранилось три десятка различимых точек вместо трёх сотен, модель дорисует остальное сама. И дорисует убедительно: без зерна, с ресницами, с чёткой линией губ. Только это будут уже не его ресницы
Я не пересказываю чужие статьи по этому поводу. Я взял архивный стеклянный негатив, прогнал через него два разных движка и померил линейкой, насколько именно каждый из них сдвинул лицо. Числа ниже - из моего собственного прогона 19 августа 2026 года, каждое снято программой, а не прикинуто на глаз. Если само устройство таких моделей вам пока незнакомо, начните с разбора что такое нейросеть, тут я это второй раз не объясняю
Чем апскейлер отличается от восстановителя лиц?
Апскейлер тянет то, что уже есть в пикселях, а восстановитель лиц рисует лицо заново по своему представлению о лицах. Это два разных инструмента, и почти вся путаница в теме начинается с того, что их называют одним словом «реставрация»
Первый тип обучен превращать мелкое изображение в крупное: он достраивает края, убирает шум сжатия, вытягивает контраст. Про лица он ничего не знает и специально их не трогает. В карточке одного из самых известных таких проектов прямо сказано, что он «is trained with pure synthetic data», то есть обучен на искусственно испорченных картинках, а не на настоящих архивных снимках
Второй тип обучен только лицам. Он находит лицо, разбирает его на признаки и собирает обратно, уже своими деталями. Авторы такого движка сами пишут про минусы одной из версий: «have a slight change on identity», то есть узнаваемость слегка уезжает. Про следующую версию говорят мягче: она «produces slightly more details and better identity than V1.3». Обратите внимание на формулировку: не «сохраняет», а «лучше, чем в прошлой версии»
| Что сравниваем | Апскейлер | Восстановитель лиц |
|---|---|---|
| Откуда берёт детали | из самих пикселей снимка | из того, как выглядят лица вообще |
| Что делает с лицом | увеличивает как есть | собирает заново |
| Риск подмены человека | почти нулевой | основной риск всей затеи |
| Где силён | общий кадр, фон, одежда, текст | портрет крупным планом |
| Где бесполезен | выбитая эмульсия, вырванный угол | всё, что не лицо |
Таблица прокручивается вбок →
Дальше в статье я называю их короткими словами: апскейлер и генеративный восстановитель. В интерфейсах бесплатных сервисов они часто работают вместе, и человек об этом не догадывается. Если вопрос стоит шире, чем старые снимки, и вы вообще выбираете, с чего начать, у меня есть отдельный разбор, какая нейросеть лучше под задачу
Что показал мой замер на архивном негативе?
Генеративный восстановитель сдвинул черты лица в 3,9 раза сильнее апскейлера, и это на одном и том же кадре. Вот как я это мерил
Взял стеклянный негатив около 1914 года из открытого архива: 2796 на 3803 точки, снимок пары, у мужчины над головой чёрный вылет эмульсии. Автоматический поиск нашёл на нём семь лиц. Я вырезал два самых крупных, женское 392 на 392 и мужское 412 на 412, и отдельно кусок кителя и рукава, где лица нет вообще. Каждый кусок привёл к одному размеру 512 на 512 и прогнал через два движка
Движки называю поимённо, чтобы число можно было проверить. Апскейлер - Real-ESRGAN x4plus, генеративный восстановитель лиц - GFPGAN v1.4. Оба с открытыми весами, оба крутились у меня локально на своей машине, никакого онлайн-сервиса в замере нет. Веса открытые как раз потому, что именно такие движки и стоят внутри бесплатных онлайн-реставраторов, только там их прячут за одной кнопкой
Дальше померил три вещи: средний сдвиг яркости в зоне глаз, носа и рта, долю точек, ушедших больше чем на 32 уровня из 255, и резкость. Ниже сырые строки прогона, читать их построчно не нужно, разбор идёт сразу под ними:
[мужчина]
  апскейлер    : сдвиг  1.85 | >32 у  0.04% пикселей | резкость    76.2 ->   115.1
  генеративка  : сдвиг  7.13 | >32 у  1.56% пикселей | резкость    76.2 ->   228.3
  во сколько раз генеративка двигает лицо сильнее апскейлера: 3.9x
  тёмный вылет эмульсии в кадре: исходник 10.09% -> апскейлер 10.17% -> генеративка 10.85%
Читается это так. Апскейлер тронул лицо на 1,85 уровня яркости и сильно переписал 0,04% точек, на глаз это вообще незаметно. Генеративный восстановитель тронул на 7,13 и сильно переписал 1,56% точек, то есть в десятки раз больше. При этом чёрное пятно эмульсии никуда не делось: было 10,09% кадра, стало 10,85%
Отдельно скажу про повторяемость, потому что это само по себе ответ на вопрос статьи. Я перегнал оба движка заново на тех же файлах. Апскейлер выдал результат побайтово тот же, до последнего пикселя. Восстановитель лиц - нет: сдвиг вышел 7,14 вместо 7,13, сильно переписанных точек 1,58% вместо 1,56%. Разрыв в 3,9 раза не сдвинулся, а вот само лицо получилось чуть другое. Он не достаёт спрятанное, он каждый раз рисует заново
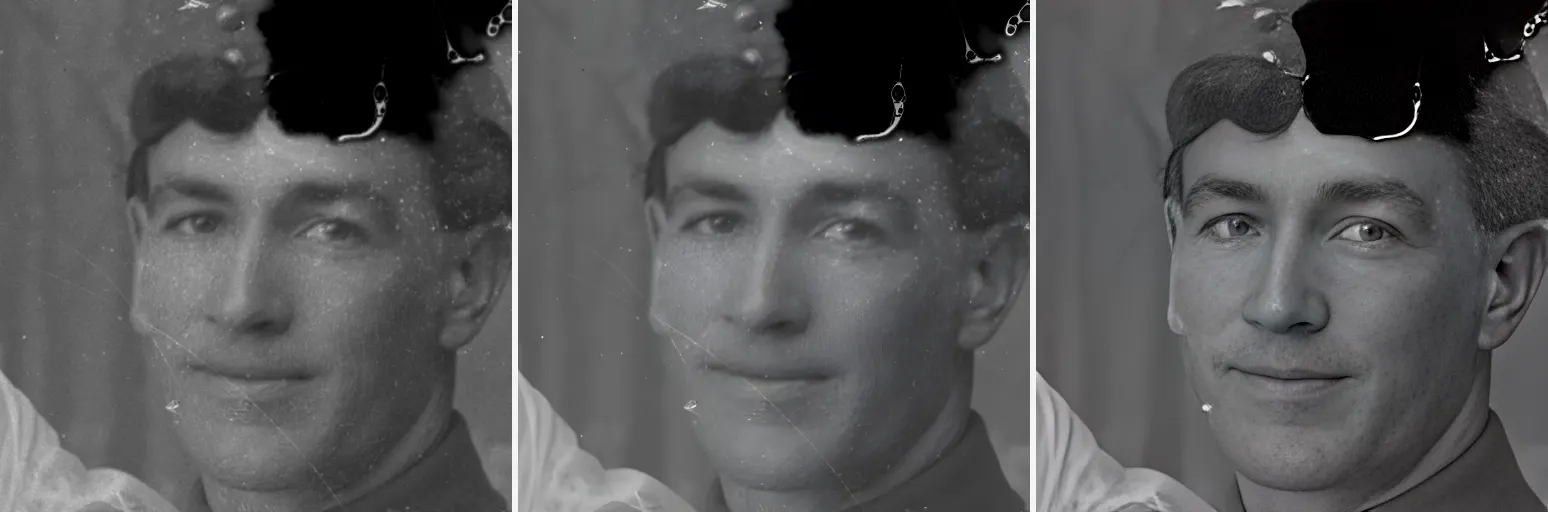
Посмотрите на правый кадр внимательно. Лицо стало чётким, появилась щетина, прорисовались веки. Ни одной из этих деталей в исходнике не было, их там физически нет, кадр слишком мелкий. Модель их придумала, опираясь на то, как обычно выглядят мужские лица
Почему лицо после обработки кажется чужим?
Потому что модель ставит на место утраченных деталей самые вероятные, а не те, что были у конкретного человека. Родинку она сотрёт, кривоватый зуб выровняет, тяжёлые веки поднимет. Всё это в её представлении шум, от которого надо избавиться
На женском лице с того же негатива видно ещё одну вещь, которую редко называют вслух
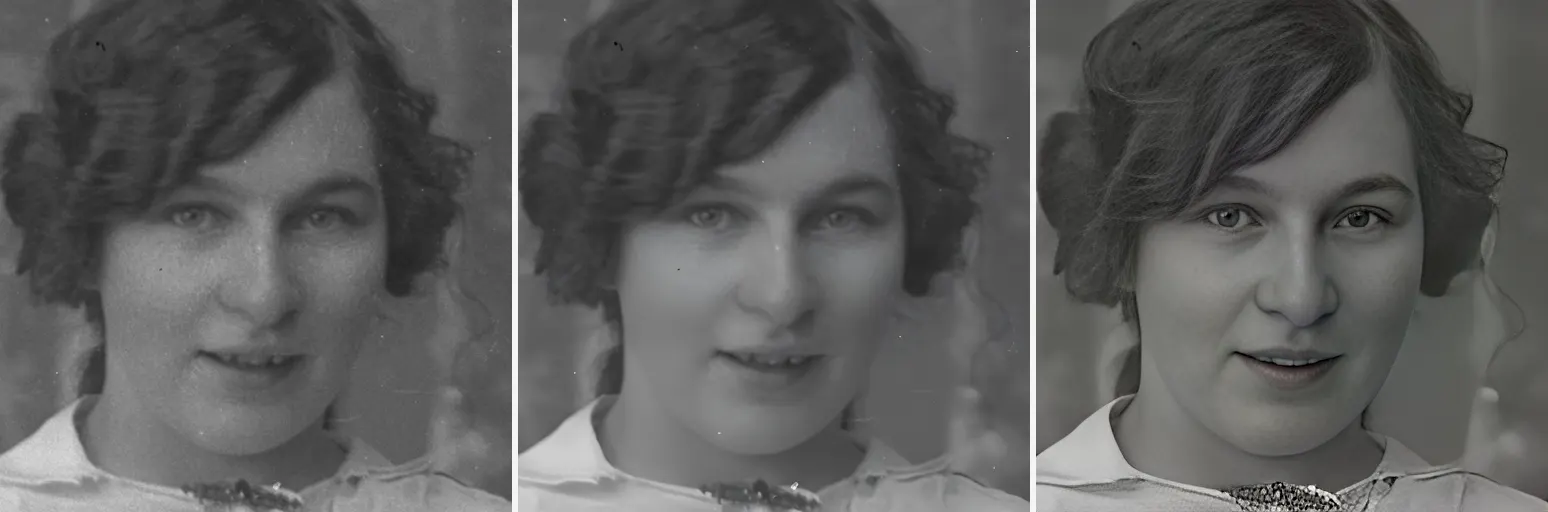
Апскейлер сделал её лицо мягче исходника: резкость упала с 49,7 до 16,2, то есть втрое. Так бывает, когда снимок уже крупный, но зернистый: модель принимает зерно за грязь и вычищает его вместе с настоящей фактурой кожи. Это тот случай, когда «улучшение» ухудшает
А справа хорошо виден механизм подстановки. В исходнике рот это смазанное пятно, отдельных зубов в нём не различить. В обработанном варианте зубы есть, у них есть форма и промежутки. Никакого способа узнать настоящую форму её зубов у модели не было: она подставила типовую. Механизм тут ровно тот же, из-за которого ИИ-картинки уже не отличить от фотографии, только в реставрации он работает против вас
Что модель делает с той частью кадра, где лица нет?
Зависит от того, какая именно модель туда добралась, и тут проходит граница, которую в статьях по теме обычно стирают. Сеть, обученная лицам, перепишет и ткань, если подать ткань прямо ей. А официальная демонстрация ткань прямо ей не подаёт: фон и одежду там увеличивает апскейлер. Разбираю по очереди, начну со своей контрольной проверки: я взял кусок кителя и рукава с того же негатива и прогнал его теми же двумя движками
| Что меряли | Апскейлер | Восстановитель лиц |
|---|---|---|
| сдвиг яркости на лице мужчины | 1,85 | 7,13 |
| сдвиг яркости на лице женщины | 2,01 | 7,41 |
| сдвиг яркости на ткани без лица | 3,53 | 6,92 |
| сильно переписанных точек на ткани | 0,05% | 1,78% |
Таблица прокручивается вбок →
Нижние две строки тут главные. На ткани сеть лиц переписала 1,78% точек, больше, чем на любом из двух лиц. Никакого внутреннего чутья «тут лицо, а тут не лицо» у неё нет: что подали, то и перерисовала своими деталями
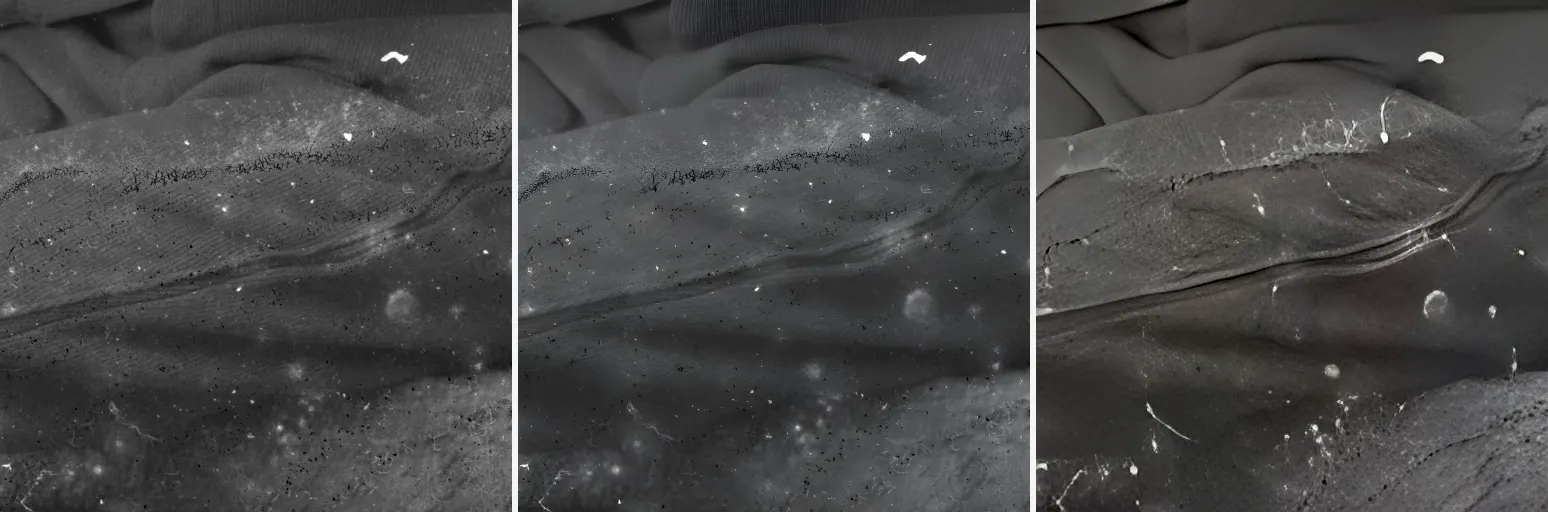
Честная граница этого замера, иначе я выдам одно за другое. Кусок ткани я подавал сети напрямую, минуя её штатный поиск лица: так видно характер самой сети, а не поведение готового сервиса. Для лиц мой прогон со штатным маршрутом почти совпадает, там сеть в любом случае получает выровненный кусок 512 на 512, поэтому главные числа статьи (1,85 против 7,13 и разрыв в 3,9 раза) остаются в силе
А в самой демонстрации маршрут другой, и он лежит открытым в её исходнике. Сначала она находит на снимке лица и вырезает их, потом прогоняет через генеративную модель только эти вырезанные куски, потом вклеивает их обратно в кадр. Всё остальное поле увеличивает Real-ESRGAN, тот же апскейлер, которому таблица выше ставит почти нулевой риск подмены. Версия там младше, чем в моём замере: демонстрация грузит веса RealESRGAN_x2plus, я мерил на x4plus. Семейство и характер одни, дорисовывать лицо ни та, ни другая не умеет. Комментарий авторов в коде на этом самом месте: «Now only support RealESRGAN for upsampling background»
Практический смысл такой. На официальной демонстрации складки, пуговицы и обстановку заново не рисуют, там обычное увеличение. Риск подмены сидит в трёх других местах: на самом лице, на границе вклейки, где обработанный кусок стыкуется с нетронутым полем, и на любом сервисе, который гонит весь кадр одной генеративной моделью. Последнее снаружи не видно вообще: кнопка называется так же, «восстановить фотографию», а внутри ткань поедет ровно как в моём контрольном замере
Что реставрация нейросетью вытянет наверняка?
Вытянет всё, что связано с качеством носителя, а не с утраченным содержимым. Список короткий и честный
| Задача | Чем закрывается | Насколько можно доверять |
|---|---|---|
| Мелкий и мутный скан | апскейлер | высоко: детали берутся из самих точек снимка |
| Зерно, пыль, мелкие точки | апскейлер | высоко, но следите за резкостью, её могут срезать |
| Общая вялость и серость | апскейлер | высоко: это работа с контрастом, не с содержимым |
| Мягкое, нерезкое лицо среднего плана | восстановитель лиц | средне: чем крупнее лицо в кадре, тем меньше домысла |
| Совсем мелкое лицо на групповом снимке | восстановитель лиц | низко: там додумывается почти всё |
Таблица прокручивается вбок →
Отдельно про то, как это выглядит в работе. Хороший результат получается, когда снимок в целом целый, а мешает именно техника съёмки и хранения: слабый объектив, дешёвая печать, выцветание, пыль. Тогда нейросеть возвращает то, что было записано на бумаге, но читалось плохо
Для семейного архива этого обычно хватает. Лицо бабушки на летней веранде становится различимым, вы видите выражение, узнаёте черты. Дальше вопрос только в том, где вы остановитесь. Задачи соседнего класса, вроде смены фона или удаления лишнего объекта, решаются другими инструментами: про них у меня отдельный разбор, как нейросетью обработать фото
Чего она не сделает, сколько ни жми кнопку?
Не восстановит того, чего на снимке не осталось физически. Ни один движок не читает мысли фотографа и не знает, что было под чёрным пятном
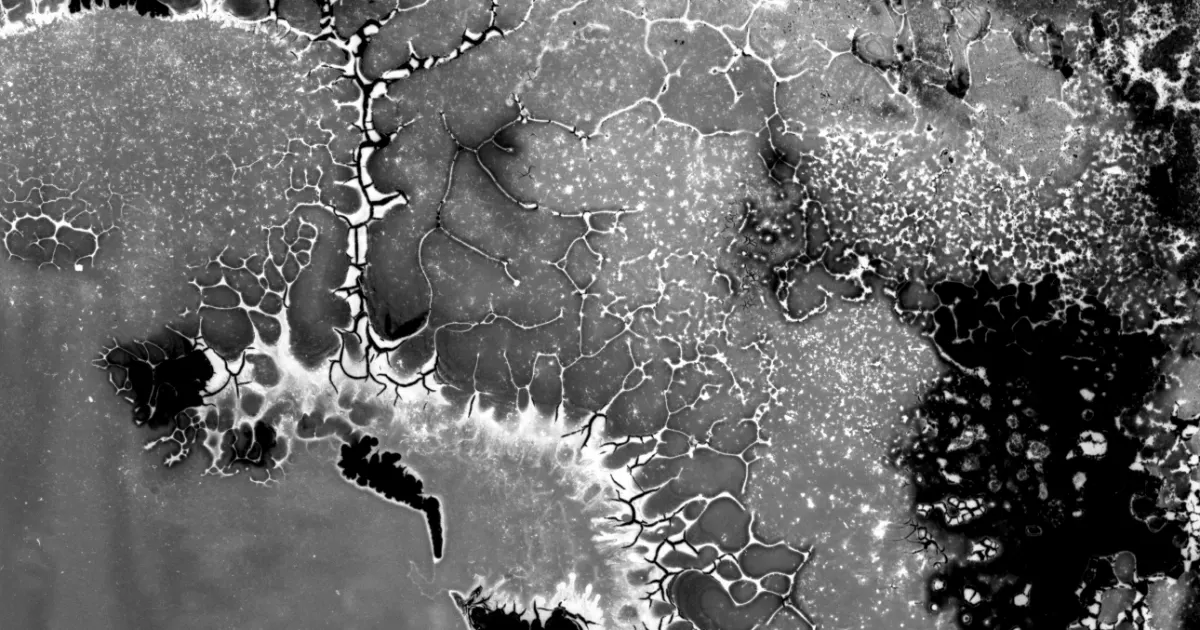
Четыре вещи, которых ждут зря:
- Выбитая эмульсия и вырванные куски. Мой замер: доля тёмного на мужском кадре была 10,09%, после генеративной обработки стала 10,85%. Не уменьшилась, а выросла. На женском кадре тёмных участков не было вовсе, 0,00%, а после обработки появилось 0,55%
- Подлинные черты того самого человека. Модель выдаёт вероятное лицо, а не его лицо. Чем хуже исходник, тем дальше результат от оригинала
- Надписи, номера, вывески. Буквы восстанавливаются хуже всего: модель уверенно нарисует похожие на буквы завитки, и прочитать их будет нельзя
- Доказательная сила снимка. Обработанный кадр не годится туда, где важна подлинность: архивная справка, спорное наследство, установление личности. Оригинал для таких задач надо сохранить нетронутым
Если задача звучит как «хочу красивый портрет прадеда, а не точный», это уже не реставрация, а генерация нового изображения по образцу. Делается она другими инструментами и по другим правилам, и начинается не с ползунка, а с текстового описания кадра
Как оцифровать снимок, чтобы модель меньше домысливала?
Дайте ей больше исходных точек, это единственное, что в ваших руках. Всё остальное решает уже модель
Ориентир я беру из руководства по оцифровке Библиотеки штата Вашингтон: она собрала свои нормы на основе федеральных рекомендаций FADGI и задаёт их не в привычных «300 точках на дюйм», а через длинную сторону кадра. Для отпечатков до 8 на 10 дюймов это 4 000 пикселей по длинной стороне, для более крупных - 6 000 и 8 000. Пример расчёта стоит в той же строке таблицы: «4000 pixels across the long edge (e.g., 3.5x5" would be scanned at 800 ppi)»
Перевожу на обычный язык. Норма задана в точках на весь кадр, а не на дюйм, поэтому нужное разрешение сканера каждый считает под свой размер сам: делите 4 000 на длинную сторону отпечатка в дюймах. Карточка 10 на 15 сантиметров это примерно 4 на 6 дюймов, значит сканировать её надо примерно в 670 точках на дюйм, а не в 300, которые стоят в сканере по умолчанию. Разница в итоговом файле почти впятеро по площади, и она решает, будет модель работать с реальными деталями лица или домысливать их
И сразу оговорка, без которой следующий шаг упрётся в стену. Эти 4 000 точек про хранение, а не про загрузку. Карточка, отсканированная по норме, весит 2 640 на 3 960 точек, то есть 10,4 мегапикселя, а бесплатная демонстрация, на которую я отправляю дальше, файлы такого размера просто не принимает. Поэтому порядок двухслойный: полноразмерный скан убираем в архив как оригинал, а на обработку отдаём уменьшенную копию. Насколько уменьшенную и почему именно так, разбираю в следующем разделе
Перед сканированием закройте три вещи:
- Снимите отпечаток из рамки и со стекла: блики и муар потом не убираются
- Сканируйте без автоматических улучшений, шумоподавления и «восстановления цвета»: все эти галочки уже удаляют детали, которые нужны модели
- Сохраните исходный файл отдельно и работайте с копией. Дальше по тексту будет видно, зачем
Если сканера нет, снимайте телефоном при ровном рассеянном свете, держа камеру параллельно снимку. Современный телефон даёт достаточно точек, проблема обычно не в них, а в бликах и перекосе
Куда идти бесплатно и что там нажимать?
Идите на официальную демонстрацию авторов модели, а не на сайт-перепродажу. Это бесплатно, регистрации и карты не спрашивают, работает в браузере на компьютере и на телефоне
Почему именно официальную. Авторы CodeFormer держат список своих площадок и предупреждают про остальные дословно: «Only demos on Hugging Face Space, Replicate, and OpenXLab are official deployments maintained by the authors. All other demos, APIs, apps, websites, and integrations listed below are third-party (non-official) and are not affiliated with the CodeFormer authors. Please verify their legitimacy to avoid potential financial loss». Всё, что за пределами этого списка, это чужие обёртки вокруг той же бесплатной модели, часто с подпиской и водяным знаком
Проверил доступ 20 августа 2026 года с московского адреса, по три захода на каждую страницу. Мерил ровно тот адрес, куда ведёт ссылка отсюда: страница открылась во всех трёх заходах, полное время 0,25-0,28 секунды. Рабочее окно демонстрации, которое в эту страницу встроено, - тоже 200, 0,42-0,48 секунды. Честная граница этой проверки: то, что страница открылась, говорит лишь об этом, и ничего не говорит про очередь на бесплатных мощностях. В час пик придётся подождать, а если очередь уже набрала десять человек, одиннадцатому вместо ожидания прилетит отказ: в исходнике очередь ограничена десятью местами. Лечится это повтором через минуту-другую
Теперь про размер файла, потому что на нём спотыкаются раньше, чем доходят до настроек. В исходнике демонстрации стоит жёсткая проверка: если в картинке больше 4 мегапикселей, она отказывается работать и выводит красную плашку «Image resolution is too large (>4 megapixels)». Отсканированная по норме карточка 10 на 15 весит 10,4 мегапикселя, то есть в 2,6 раза больше потолка. Правило одно и годится для любой пропорции: перемножьте стороны в точках и держитесь ниже четырёх миллионов. Мерить надо именно площадь, а не длинную сторону, потому что одно и то же число по длинной на разных форматах весит по-разному. Копия 2 400 на 1 600 для карточки 3:2 даёт 3,84 миллиона и проходит. Те же 2 400 по длинной у квадратного кадра 6 на 6 превращаются в 2 400 на 2 400, это 5,76 миллиона и красная плашка. У формата 9 на 12 выходит 2 400 на 1 800, это 4,32 миллиона, тоже отказ
Второй порог мягче, но о нём на экране не сказано ни слова. Если у загруженного файла длинная сторона больше 1 500 точек или короткая больше 1 100, демонстрация сама ставит увеличение в единицу и выключает две галочки: Background_Enhance и Face_Upsample перестают работать, хотя на экране остаются включёнными. Отсюда правило на два случая. Нужен максимум настоящих деталей на лице - гоните копию по площади, лишь бы произведение сторон было ниже четырёх миллионов, и знайте заранее, что обе галочки в этом режиме погаснут сами. Лицо от этого почти не страдает, его всё равно вырезают и обрабатывают отдельно, а теряете вы увеличение фона и финальное укрупнение готового лица перед вклейкой. Хотите, чтобы панель работала целиком, вместе с фоном и увеличением, - держите обе стороны разом: длинную не выше 1 500 точек и короткую не выше 1 100. Одной длинной тут мало: у форматов 9 на 12, 18 на 24 и у квадратного кадра при длинной 1 500 короткая уходит за 1 100, и настройки сбрасываются молча. Проще всего ужимать до тех пор, пока короткая не станет 1 000 точек, тогда обе границы выполняются на любом привычном формате. Оригинал в обоих случаях остаётся у вас нетронутым, уменьшенная копия нужна только демонстрации
Третий стоп прячется там же, в исходнике, и про него на экране тоже ни слова: если демонстрация насчитает на снимке больше пятнадцати лиц, а короткая сторона файла при этом выше 1 000 точек, она отказывается работать и пишет «Too many faces detected (>15)». Это про групповые снимки: школьный класс, свадебный стол, полковое фото. Перевалить за пятнадцать легче, чем кажется. На моём негативе снята пара, два человека, а автоматический поиск нашёл там семь лиц, потому что зерно и трещины он местами принимает за лицо. Лечится это двумя способами. Первый: ужать копию так, чтобы короткая сторона стала 1 000 точек или меньше, тогда ограничение просто не включается. Второй: разрезать групповой снимок на несколько кусков и прогнать по очереди, по три-четыре человека за заход
Под окном загрузки лежит панель настроек, и выглядит она так: три галочки подряд, под ними поле с числом, ниже ползунок со шкалой от нуля до единицы, в самом низу широкая кнопка запуска. Все три галочки включены заранее, в поле стоит цифра 2, бегунок ползунка ровно посередине. Крупно я показываю только ползунок, в следующем разделе: остальная панель это подписи на белом поле, и смотреть там не на что. Разбираю каждый переключатель словами, сверху вниз:
- Pre_Face_Align - найти лицо на снимке и выровнять его перед обработкой. Оставьте включённой: если снять, демонстрация примет весь ваш кадр за уже вырезанное лицо и сожмёт его в квадрат 512 на 512
- Background_Enhance - что делать с полем вокруг лица: с фоном, одеждой, руками. Включённая, она отдаёт это поле апскейлеру Real-ESRGAN, а не генеративной модели, так в исходнике и написано
- Face_Upsample - увеличить готовое лицо тем же апскейлером перед тем, как вклеить его обратно в кадр
- Rescaling_Factor (up to 4) - во сколько раз увеличить весь снимок, по умолчанию 2, максимум 4. На файлах длиннее 1 000 точек демонстрация сама срезает его до 2. А до единицы она срезает по двум условиям сразу: и когда длинная сторона больше 1 500 точек, и когда короткая больше 1 100. Вместе с ним в этот момент гаснут две галочки выше
- Codeformer_Fidelity - главный переключатель этой статьи, про него следующий раздел
- Enhance Image - кнопка запуска, результат появится справа
Одна деталь, которую легко пропустить: на странице висит предупреждение «Please download the output within 30 seconds». Готовый файл надо скачать сразу, иначе он пропадёт и придётся гнать заново. Другие бесплатные инструменты под соседние задачи собраны у меня в отдельной подборке
Один ползунок, который решает судьбу лица
Ползунок Codeformer_Fidelity это выбор между «красиво» и «похоже», и по умолчанию он стоит ровно посередине
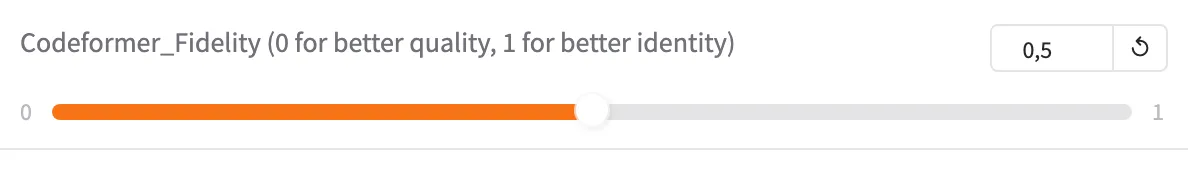
Полная подпись под ним в интерфейсе такая: Codeformer_Fidelity (0 for better quality, 1 for better identity). Авторы объясняют смысл так:
«Fidelity weight w lays in [0, 1]. Generally, smaller w tends to produce a higher-quality result, while larger w yields a higher-fidelity result»
CodeFormer, описание проекта на GitHub, страница открыта 19 августа 2026 года
Переведу без потерь. Ближе к нулю модель свободнее выдумывает, картинка получается глаже и эффектнее. Ближе к единице модель жёстче держится исходных точек, картинка выходит грубее, зато человек на ней остаётся тем же
Тут нужна честная оговорка про мой замер, иначе выйдет подмена. Мерил я не CodeFormer, а GFPGAN v1.4, и регулятор точности у него только на бумаге. Настройка с тем же заводским значением 0,5 в программе авторов лежит, я её открывал. Но до самой модели это значение не доезжает: в версии 1.4 оно падает в мешок необязательных аргументов и остаётся там неиспользованным, лицо всё равно собирается в одном режиме. Значит 7,13 против 1,85 - это число про класс инструмента, а не про конкретное положение бегунка
Перенос держится вот на чём. Оба движка решают одну задачу: находят лицо и собирают его заново генеративной моделью, подставляя на место утраченных деталей самые вероятные. Мой замер показывает, чем такой движок отличается от простого увеличения, и это одинаково верно для обоих. Граница переноса тоже понятная: сколько именно сдвигает черты CodeFormer на значении 0,5, я не мерил и выдумывать не стану. Смысл ползунка берите из описания авторов, а не из моих 7,13
Практический вывод от этого не меняется. Заводское значение 0,5 означает, что вы забираете лицо, наполовину собранное моделью, и вас об этом никто не спросил
Рабочий порядок такой:
- Первый прогон сделайте на значении 0,7-0,8 и посмотрите на результат
- Если лицо всё ещё мутное, спускайтесь к 0,5 маленькими шагами
- Ниже 0,4 опускайтесь только тогда, когда вам нужна красивая картинка, а не тот самый человек
- Сохраняйте каждый вариант отдельным файлом с понятным именем
Как проверить, что человека на снимке не подменили?
Сравните две картинки в упор на одном экране, а не по памяти. Память подстраивается под свежий яркий вариант за пару минут, и дальше вы уже не увидите разницы
Проверка занимает минуту и делается без всяких инструментов:
- Откройте исходник и результат рядом и посмотрите на асимметрию. Настоящие лица несимметричны: один глаз чуть выше, улыбка чуть косая. Если результат стал ровным, модель выправила человека
- Найдите на исходнике особые приметы: родинку, шрам, форму брови, залом на щеке. Проверьте, остались ли они. Приметы уходят первыми
- Посмотрите на границы: волосы у лба, край уха, воротник. Именно там модель обычно оставляет размытые или неестественно гладкие места
- Покажите результат тому, кто помнит этого человека живым, и не говорите заранее, что снимок обработан
Если пропала хоть одна примета, поднимайте ползунок точности ближе к единице и гоните заново. Это не про перфекционизм: приметы и есть то, по чему человека узнают родственники
Что можно делать с готовым файлом, а что нельзя?
Тут два разных вопроса, и путать их нельзя: люди на снимке и лицензия модели. Первый решается согласием, второй текстом лицензии
Про людей коротко. Свой архив - ваше дело, прадеды возражать не будут. Но в семейной коробке лежат и живые: родители, дети, соседи по двору, чужие гости на свадьбе. Снимок, по которому человека можно узнать, это его персональные данные, а загрузка на чужой сервис это передача их третьему лицу. Поэтому чужие лица я на публичную демонстрацию не таскаю, а на публикацию обработанного портрета живого человека спрашиваю разрешение у него самого. Если случай чувствительный, ставьте движок локально на свой компьютер: тогда файл никуда не уходит
Теперь лицензии. У трёх основных движков они разные, и именно они решают, что вам можно делать с готовым файлом за деньги
| Модель | Лицензия | Что это значит на практике |
|---|---|---|
| Real-ESRGAN, увеличение | BSD-3 | свободно, включая работу за деньги |
| GFPGAN, восстановление лиц | Apache 2.0, кроме заимствованных кусков | за деньги под вопросом: часть кода взята под некоммерческими условиями |
| CodeFormer, восстановление лиц | S-Lab License 1.0 | только некоммерческое использование |
Таблица прокручивается вбок →
Средняя строка выглядит безобиднее, чем есть, и я сам сначала прочитал её неправильно. В шапке файла стоит «GFPGAN is licensed under the Apache License Version 2.0 except for the third-party components listed below», и взгляд цепляется за «Apache 2.0». А в том же файле ниже перечислены заимствованные куски. StyleGAN2 взят у NVIDIA с условием «may be used or intended for use non-commercially», и там же расшифровано: «non-commercially» значит «for research or evaluation purposes only». Ещё часть кода пришла из проекта DFDNet под лицензией Creative Commons Attribution-NonCommercial-ShareAlike. Свободная лицензия покрывает не всё содержимое репозитория
Лицензия CodeFormer сформулирована прямо: «Redistribution and use for non-commercial purpose in source and binary forms, with or without modification, are permitted». Про коммерческое использование там же сказано, что нужно связаться с авторами работы
Вывод честный и скучный. Из трёх движков чистая коммерческая лицензия только у Real-ESRGAN: слова «non-commercial» в её тексте нет ни разу. Но он умеет ровно одно, увеличивать, и лица не восстанавливает. Собираетесь брать деньги за реставрацию чужих снимков - это разговор с юристом, у которого перед глазами лежат сами тексты лицензий, а не абзац из блога. Обещание сервиса «результат ваш» юридической силы не имеет: он перепродаёт вам чужую модель
Отдельно про этику, без морализаторства. Обработанный кадр честно называть обработанным, когда вы отдаёте его в семейный чат или в архив. Одна строка подписи снимает все будущие вопросы: сделано нейросетью, оригинал сохранён
Три ошибки, после которых оригинал уже не вернуть
Первая и главная - переписать исходный файл результатом. Дальше сравнивать будет не с чем, а несоответствие всплывёт через месяц, когда родственники скажут «а нос был другой». Держите исходники в отдельной папке и никогда не работайте с единственной копией
Вторая - гнать снимок через несколько сервисов подряд. Каждый прогон достраивает поверх уже достроенного, и на третьем круге от оригинального лица не остаётся почти ничего. Мой замер показывает масштаб одного прохода: 1,56% точек переписаны сильно. Следующий сервис получит эти дорисованные точки уже как оригинал и будет достраивать от них
Третья - принять красивую картинку за восстановленную. Гладкая кожа, чёткие ресницы и ровные зубы на снимке столетней давности означают ровно одно: модель поработала от души. Настоящая реставрация выглядит скромнее: чуть чётче, чуть чище, с сохранённым зерном и всеми неровностями лица
Источники
Внешние страницы открыты 19 августа 2026 года, тексты лицензий и нормы оцифровки перепроверены заново 20 августа 2026 года
- Wikimedia Commons: стеклянный негатив «A soldier with a girl», фотограф Alexander Galloway, хранитель Coalfields Local History Association - снимок для прогона, годы жизни фотографа 1876-1945, снимок около 1914 года, общественное достояние
- CodeFormer, описание проекта на GitHub - смысл регулятора точности и список официальных площадок демонстрации
- CodeFormer, текст лицензии S-Lab 1.0 - ограничение на коммерческое использование
- CodeFormer, исходник официальной демонстрации - точные подписи галочек, поля и ползунка со значениями по умолчанию
- Официальная демонстрация CodeFormer - страница, на которую попадает читатель
- GFPGAN, описание проекта на GitHub - оговорки авторов про узнаваемость лица у версий 1.3 и 1.4
- GFPGAN, текст лицензии - оговорка «except for the third-party components» и некоммерческие условия NVIDIA и Creative Commons на заимствованные куски
- Real-ESRGAN, описание проекта на GitHub - назначение апскейлера и обучение на синтетических данных
- Real-ESRGAN, текст лицензии BSD-3 - чистая коммерческая лицензия, слова про некоммерческое использование нет
- Библиотека штата Вашингтон, руководство по оцифровке - отсюда взяты пиксели по длинной стороне и пример расчёта; страница сама говорит, что её нормы собраны на основе федеральных рекомендаций FADGI и программы совместной оцифровки CDP
- FADGI, головная страница технических рекомендаций - федеральные рекомендации, на которых построено руководство Библиотеки штата Вашингтон
Памятка: старый снимок без подмены лица
Восемь строк, по которым проходишь сам
Сохрани себе
- Снять отпечаток из рамки, отсканировать без автоулучшений, около 4000 точек по длинной стороне: это архивный оригинал
- Убрать исходный файл в отдельную папку и дальше трогать только копию
- Уменьшить копию для загрузки: перемножить стороны и держаться ниже 4 миллионов точек, а чтобы работала вся панель - короткую сторону увести к 1000 точкам
- Открыть официальную демонстрацию модели, а не первый сайт из выдачи
- Поднять Codeformer_Fidelity с заводских 0,5 до 0,7-0,8 и запустить
- Скачать результат в течение 30 секунд, иначе прогон придётся повторить
- Сверить с оригиналом: родинки, форма бровей, асимметрия, границы волос
- Выбитую эмульсию и вырванные куски не ждать: их не чинит ни один движок
Порог входа
Три дня, бесплатно, зайти можно сегодня
Люди приходят ко мне с нуля, без опыта в нейросетях, и к третьему дню показывают в чате собранные штуки. Меня это до сих пор радует сильнее, чем собственные запуски
Ждать даты и что-то доустанавливать не нужно, вход открывается сразу
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и отдаст путёвку. Бесплатно
Частые вопросы
Можно ли реставрировать старое фото нейросетью бесплатно?
Да. Официальная демонстрация CodeFormer на Hugging Face работает без регистрации, без карты и без подписки, прямо в браузере. Плата за это одна: очередь на общих мощностях в час пик, причём мест в очереди всего десять, и одиннадцатому вместо ожидания приходит отказ с предложением повторить. Плюс предупреждение «Please download the output within 30 seconds», то есть результат надо скачать сразу
Почему после обработки лицо похоже на другого человека?
Потому что модель не проявляет утраченные черты, а подставляет вероятные. Мой замер на архивном негативе: восстановитель лиц GFPGAN v1.4 сдвинул черты на 7,13 уровня яркости против 1,85 у апскейлера Real-ESRGAN x4plus, разрыв 3,9 раза. На демонстрации, куда я отправляю в этой статье, стоит другой восстановитель того же класса, CodeFormer, и у него силу домысла регулируют ползунком Codeformer_Fidelity. Авторы пишут, что ближе к единице результат ближе к исходнику - там и держите
Уберёт ли нейросеть трещины, пятна и вырванные куски?
Мелкие точки, пыль и зерно уберёт. Выбитую эмульсию и вырванные куски нет. В моём прогоне доля тёмных провалов на мужском кадре была 10,09%, после обработки стала 10,85%, то есть выросла. На женском кадре тёмных участков не было вовсе, а после обработки появилось 0,55%
В каком качестве сканировать старую фотографию?
Ориентир из руководства по оцифровке Библиотеки штата Вашингтон, собранного на основе норм FADGI, задан по длинной стороне: около 4 000 пикселей для отпечатков до 8 на 10 дюймов. Для карточки 10 на 15 сантиметров это примерно 670 точек на дюйм вместо привычных 300. Автоматические улучшения сканера при этом надо выключить. Только учтите, что эта норма про архивный оригинал: бесплатная демонстрация не принимает картинки крупнее 4 мегапикселей, поэтому на загрузку делают уменьшенную копию. Размер копии считают по площади, а не по длинной стороне: перемножьте стороны в точках и держитесь ниже четырёх миллионов. Одно число по длинной стороне тут не работает, потому что зависит от пропорции: у карточки 3:2 в потолок укладывается копия 2 400 на 1 600, а у квадратного кадра те же 2 400 дают 5,76 миллиона и отказ
Можно ли брать восстановленные снимки в работу за деньги?
Смотря какой моделью восстановлено, и ответ тут менее радостный, чем принято писать. Чистая свободная лицензия только у апскейлера Real-ESRGAN: BSD-3, слова «non-commercial» в тексте нет. У GFPGAN шапка Apache 2.0, но с оговоркой «except for the third-party components», и среди этих компонентов есть куски под некоммерческими условиями NVIDIA и Creative Commons NonCommercial. У CodeFormer лицензия S-Lab 1.0 прямо разрешает только некоммерческое использование. Собираетесь работать за деньги - несите тексты лицензий юристу
Стоит ли раскрашивать чёрно-белый снимок той же кнопкой?
Раскраска это отдельная задача и отдельный класс моделей, и делать её надо после реставрации, а не вместе с ней. Цвет модель тоже выдумывает: настоящий цвет платья или глаз она узнать не может, поэтому раскрашенный вариант хранят рядом с чёрно-белым, а не вместо него
Вайбмаркетинг и вайбкодинг для тех, кто начинает с нуля. Разбираю ИИ-инструменты по шагам и показываю на своих проектах