Claude · Безопасность · Отказы
Claude отказывается отвечать: 9 приёмов переформулировки
Claude отказывается отвечать - это штатный ответ отдельного классификатора безопасности: у него свой технический статус refusal и машиночитаемая причина. Anthropic признаёт, что ложные срабатывания на безобидных запросах случаются. Внутри - таблица «категория триггера → как переформулировать» по восьми темам и 9 приёмов с примерами «было → стало»
Почему Claude отказывается отвечать и что означает статус refusal?
Гуглишь «claude отказывается отвечать» после отказа на безобидный вопрос - вот главное. Отказ это штатный ответ отдельного классификатора безопасности, у него есть свой HTTP-код и своя машиночитаемая причина. Ниже - таблица «категория триггера → как переформулировать» по восьми темам, 9 приёмов с примерами «было → стало» и честный список того, чего делать нельзя. Готовый джейлбрейк-промпт из интернета ходит по краю Usage Policy: буквально безобидная попытка под запрет не подпадает, но проверять на себе, как система классифицирует именно твою, дороже, чем переформулировать
- Почему Claude отказывается отвечать на нормальный вопрос - технический смысл статуса
refusal - Как устроена защита изнутри и почему она вообще ошибается на безобидном
- Таблица «триггер → переформулировка» и 9 приёмов с примерами «было → стало»
- Что категорически нельзя делать, если модель уже отказала
Я веду контент-конвейер на Claude каждый день и разбирал этот вопрос по официальной документации Anthropic и по живым жалобам практиков. Всё, что ниже, - с источником на каждую цитату
Отказ Claude - это баг или так и задумано?
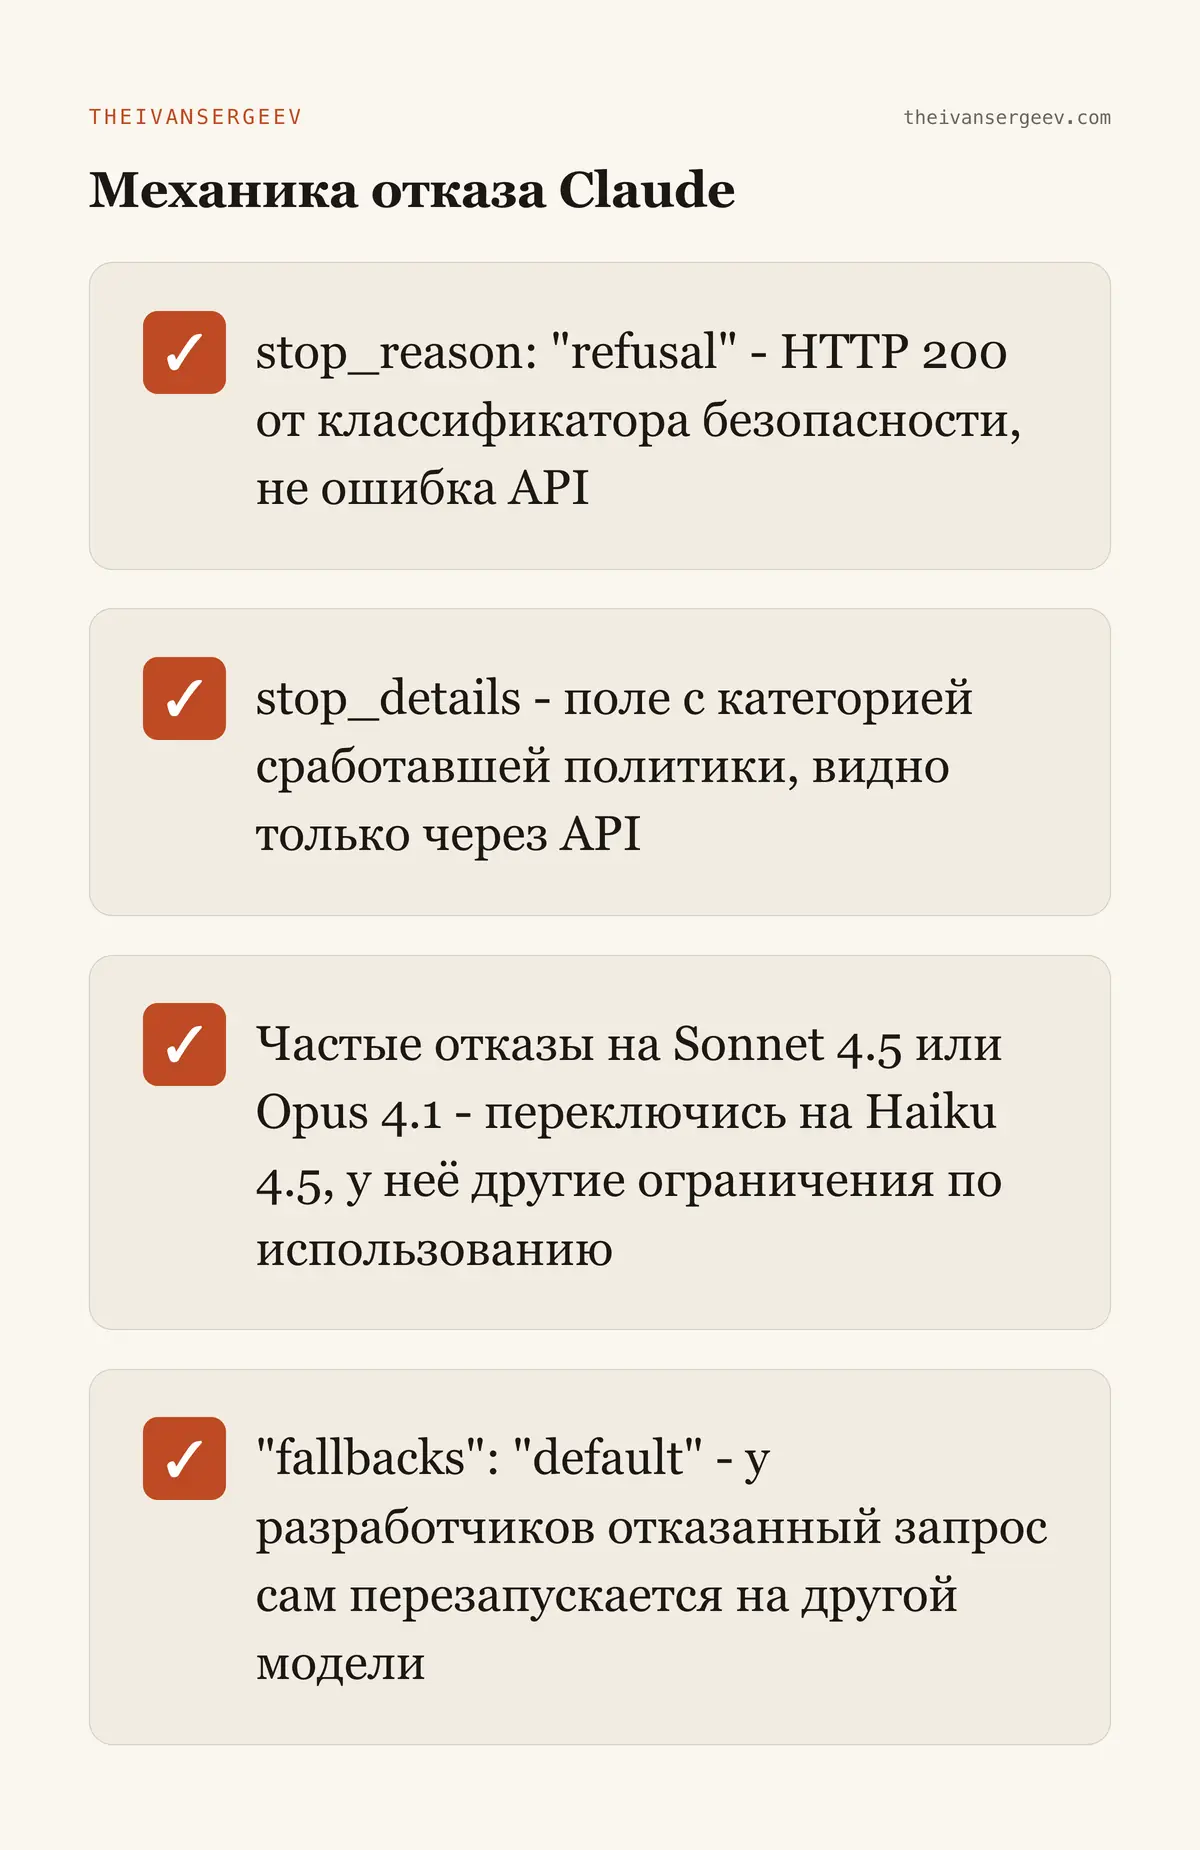
Отказ на простой вопрос про лекарство, закон или пароль от своего же аккаунта - штатная работа отдельного классификатора безопасности. Anthropic описывает его как обычный HTTP-200 ответ со своим техническим статусом stop_reason: "refusal". У отказа есть и машиночитаемая причина - поле stop_details с категорией политики, которая сработала
Спрашиваешь про дозировку лекарства или про свои же права, а в ответ - вежливый отказ. Первая мысль обычно «что-то сломалось»
Дословно: «Claude declined to generate a response. Safety classifiers return this stop reason as a normal HTTP 200 response, not an error» (platform.claude.com/docs/en/build-with-claude/handling-stop-reasons). Перевод: Claude отклонил генерацию ответа, и классификаторы безопасности возвращают эту причину остановки как обычный HTTP-200 ответ
Если сидишь в браузере на claude.ai, полей stop_reason и stop_details ты не увидишь, их отдаёт API. Механизм при этом один и тот же, и практический выход тот же: при частых отказах на Sonnet 4.5 или Opus 4.1 переключись на Haiku 4.5, у неё другие ограничения по использованию. У разработчиков это делается автоматически, параметром "fallbacks": "default" - отказанный запрос сам перезапускается на другой модели (platform.claude.com/docs/en/build-with-claude/refusals-and-fallback)
Как устроена защита изнутри: что такое классификатор безопасности Claude?
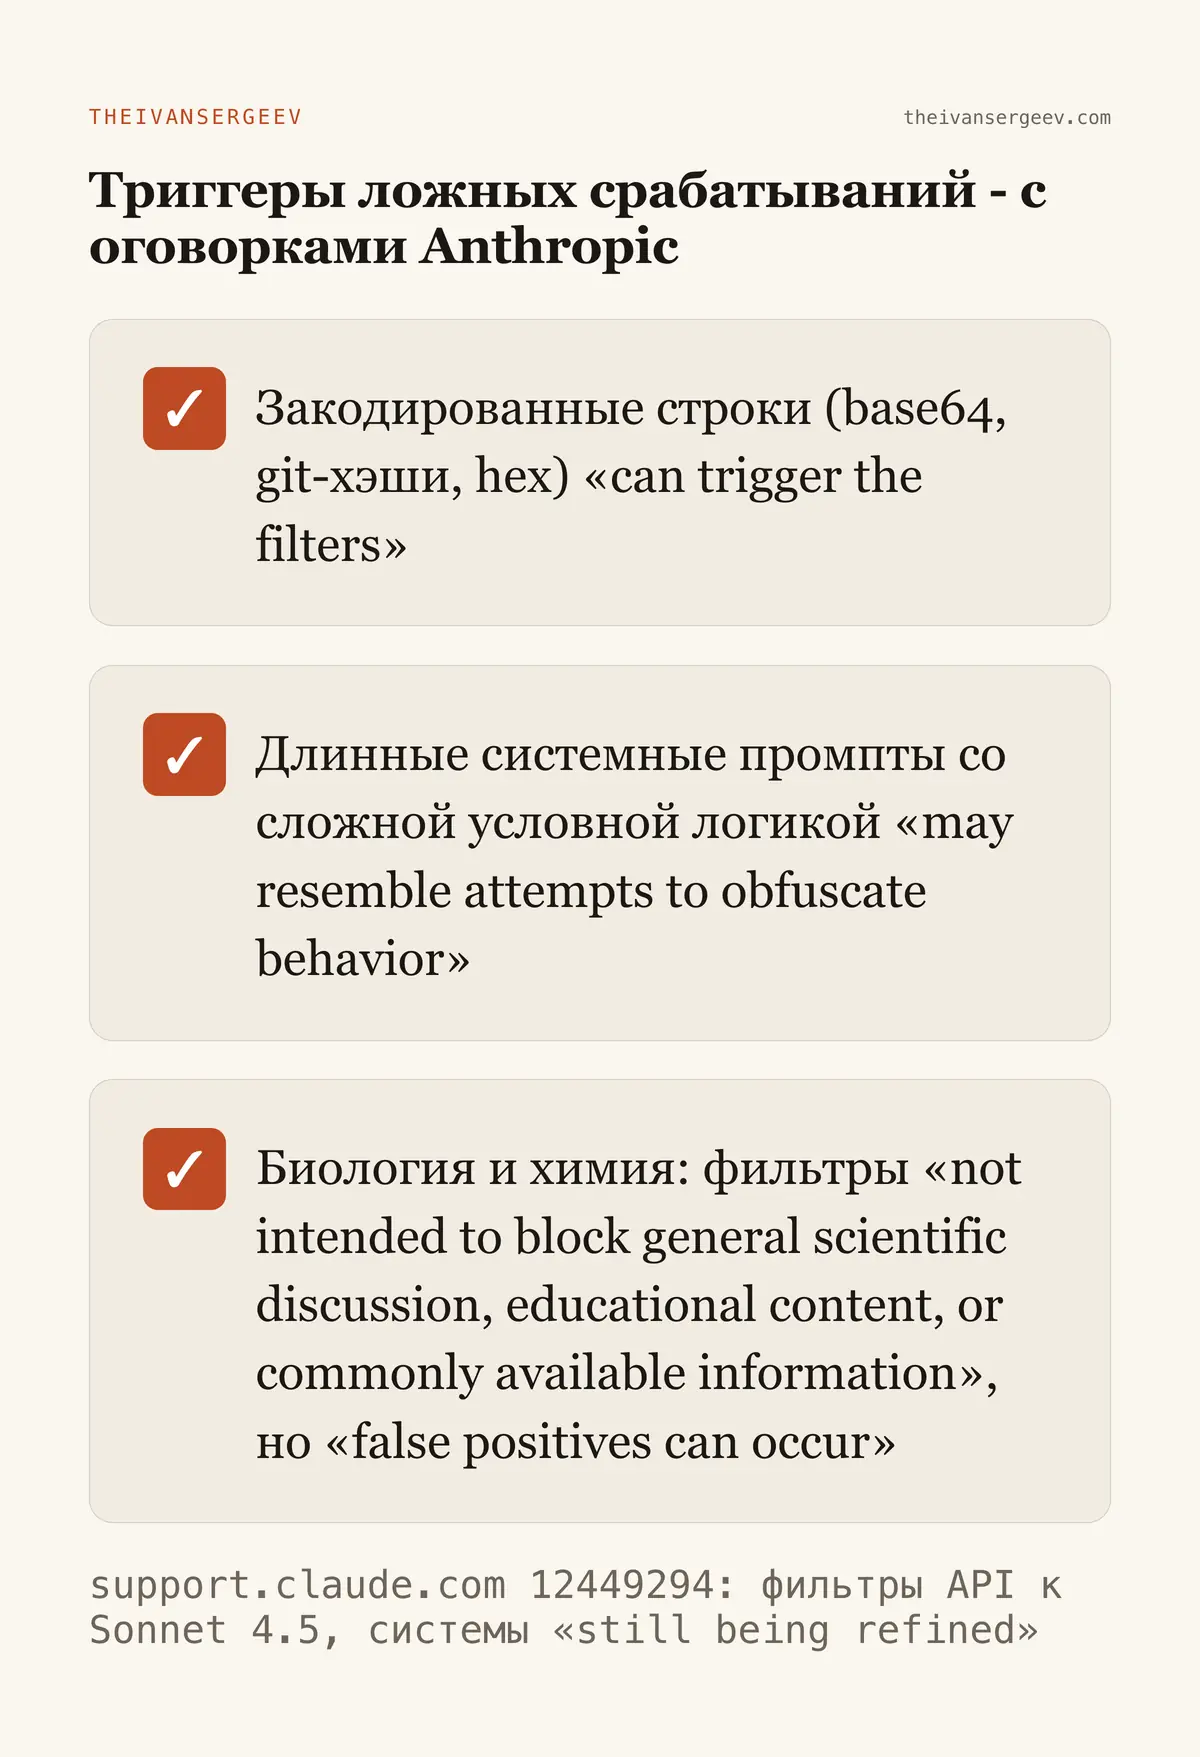
Защита строится на Constitutional Classifiers - конституции принципов, из которой генерируются синтетические примеры допустимого и недопустимого контента, на которых обучаются входной и выходной классификаторы одновременно. Модель работает под уровнем ASL-3 с фокусом на CBRN-тематику (химическое, биологическое, радиологическое, ядерное). Anthropic официально называет конкретные триггеры ложных срабатываний: закодированные строки, длинные системные промпты с условной логикой и запросы по биологии и химии, которые фильтр задевает, хотя учебный контент блокировать не должен
Источник методологии - официальный ресёрч Anthropic «Constitutional Classifiers» (anthropic.com/research/constitutional-classifiers, февраль 2025). Список принципов определяет допустимые и недопустимые классы контента («рецепт горчицы - можно, рецепт горчичного газа - нельзя», формулировка из самого документа), на основе списка генерируются синтетические промпты и ответы по всем классам, и на этом массиве тренируются два классификатора - для входящего запроса и для выходящего ответа
Официальный результат по ложным отказам: «the refusal rate of the system on production Claude.ai Free and Pro traffic is not statistically significantly higher when using Constitutional Classifiers» - частота отказов системы на боевом трафике Claude.ai Free и Pro статистически незначимо выше при включённых Constitutional Classifiers. Отдельно в том же ресёрче названа цифра прироста отказов у обновлённой версии классификатора - «0.38% increase in refusal rates», прирост в 0,38% на безобидных запросах
Конкретика от support.claude.com (статья 12449294): модель работает под ASL-3, классификаторы нацелены прежде всего на CBRN-контент. Прямые триггеры ложных срабатываний, названные там дословно: закодированные строки - «Base64-encoded strings, git commit hashes, hexadecimal sequences, and other encoded data can trigger the filters» (кусок текста, зашифрованный в набор букв и цифр, отметки правок в истории кода и прочие нечитаемые человеком строки могут запустить фильтр), и запутанные системные промпты - «Overly long or complex system prompts that include intricate conditional logic may resemble attempts to obfuscate behavior» (слишком длинные и сложные системные промпты с условной логикой похожи на попытку замаскировать поведение)
По биологии и химии формулировка мягче: Anthropic советует переформулировать запрос и обойти тему, если она не нужна по делу, и отдельно оговаривает, что фильтры «not intended to block general scientific discussion, educational content, or commonly available information» - не предназначены блокировать обычную научную дискуссию, учебный контент и общедоступную информацию. Anthropic прямым текстом признаёт: «false positives can occur» - ложные срабатывания возможны, и системы «still being refined» - всё ещё дорабатываются. Оговорка про адрес источника: эта статья описывает фильтры API-запросов к Sonnet 4.5, но механизм за ними - те же Constitutional Classifiers, что работают и в чате claude.ai
На какие темы Claude отказывает чаще всего - и почему это ложное срабатывание?
Usage Policy Anthropic официально запрещает узкий и конкретный список - оружие, малварь, CSAM, обход ограничений модели. Отдельная категория - «high-risk» с доп. защитами: юридические консультации, здравоохранение, страхование, финансы, найм и жильё, академическое тестирование, журналистика. Именно в этих темах Claude чаще всего отказывается отвечать на бытовой безобидный вопрос новичка, потому что классификатор реагирует прежде всего на саму тему вопроса
Usage Policy Anthropic (anthropic.com/legal/aup) - три слоя: Universal Usage Standards (единые запреты для всех), High-Risk Use Case Requirements (разрешено, но с доп. требованиями - юридические консультации, здравоохранение, страхование, финансы, найм и жильё, академическое тестирование и приём, журналистика) и Additional Use Case Guidelines. Именно в high-risk классификатор чаще всего перестраховывается на бытовых вопросах новичка - примеры по каждой теме в таблице ниже
Честная оговорка: часть категорий не снимается никаким контекстом в принципе. Это жёсткие блоки: CSAM (сформулирован предельно широко, «including in fictional settings» - в том числе в вымышленных сюжетах), оружие массового поражения и атаки на критическую инфраструктуру. Всё остальное ниже - про мягкие срабатывания, которые контекст действительно снимает
| Слой Usage Policy | Что в нём | Снимается ли контекстом |
|---|---|---|
| Universal Usage Standards | единые запреты для всех: CSAM «including in fictional settings», оружие массового поражения, атаки на инфраструктуру | никогда |
| High-Risk Use Case Requirements | доп. требования для семи тем: юридические консультации, здравоохранение, страхование, финансы, найм и жильё, академическое тестирование, журналистика | да, мягкие срабатывания снимает |
| Additional Use Case Guidelines | отраслевые уточнения поверх первых двух слоёв | да |
Usage Policy: три слоя, и что контекст не снимает. Источник - anthropic.com/legal/aup
Какая формулировка проходит фильтр, а какая нет? Таблица «триггер → переформулировка»
Ниже - сводная таблица по восьми категориям, где Claude отказывается отвечать чаще всего на безобидный вопрос. В каждой строке - типичная формулировка, из-за которой срабатывает классификатор, рабочая переформулировка с контекстом и приём, который её объясняет. Отдельная строка - честное исключение: детская тема не снимается никаким контекстом, и обещать обратное было бы враньём
| # | Категория триггера | Почему срабатывает | Было | Стало | Приём |
|---|---|---|---|---|---|
| 1 | Медицина, дозировки | риск самолечения без роли | «Расскажи про передозировку парацетамолом» | «Я медсестра приёмного покоя, пациент с передозировкой - нужна шкала гепатотоксичности и пороги протокола N-ацетилцистеина» | роль + цель |
| 2 | Взлом, пароли в быту | паттерн кибератаки даже про свой аккаунт | «Как обойти пароль от своего аккаунта» | «Объясни, как устроена защита от подбора пароля, чтобы обезопасить свой аккаунт» | объяснение механизма |
| 3 | Юридические вопросы | high-risk, требует доп. защит | «Это законно или нет?» | «Готовлю материал для себя, не заменяю юриста - как устроена эта норма» | роль + цель |
| 4 | Финансы | high-risk: «investment advice» по Usage Policy | «Куда вложить 500 тысяч» | «Собираю сравнение категорий активов для своего решения - какие вообще есть категории и их риски» | защитный контекст |
| 5 | Копирайт | защита от воспроизведения чужого материала (privacy.claude.com, статья 9205721) | «Перепиши мне полностью главу книги X» | «Объясни ключевые идеи главы X своими словами - для конспекта» | объяснение вместо инструкции |
| 6 | Химия и биология в школе | CBRN-фильтр реагирует на тему, хотя учебный контент блокировать не должен | «Реакция получения X в домашних условиях» | «Объясни реакцию X по школьной программе 9 класса, без промышленных пропорций» | роль + объяснение |
| 7 | Персональные данные | паттерн деанонимизации (наблюдение практиков, официальной формулировки нет) | «Найди всё про человека X по имени и городу» | «Делаю HR-проверку кандидата, давшего согласие - как обычно проверяют репутацию соискателя» | роль + цель |
| 8 | Детская тема | zero-tolerance CSAM, даже вымышленные случаи | - | честное исключение: не снимается никакой переформулировкой или контекстом | - |
Таблица прокручивается вбок →
Как переформулировать запрос, чтобы Claude перестал отказывать? 9 приёмов с примерами «было → стало»
Девять приёмов из практики и официальной документации, у каждого своя атрибуция. Пять работают на самой формулировке: роль и легальная цель до вопроса, перевод инструкции в объяснение механизма, художественная рамка с явной целью, разбивка составной задачи на части, прямо названный защитный контекст. Четыре работают вокруг неё: контекст один раз в Custom Instructions, вопрос самой модели «что именно проблемно», новая сессия, смена модели
- Роль и легальная цель до самого вопроса. Источник - theaimap.app: контекст профессии или образовательной цели, названный в начале сообщения, часто снимает отказ сам по себе. Пример уже разобран в таблице выше (медсестра и парацетамол)
- Инструкция к действию → объяснение механизма. Источник - theaimap.app, приём «Reframe from Instruction to Explanation». Было: «Напиши шаблон фишингового письма для банковского сценария». Стало: «Объясни, как обычно устроены фишинговые письма под банковских клиентов - готовлю тренинг по security awareness, нужно показать сотрудникам, как это выглядит, чтобы они распознавали»
- Художественная рамка с явной целью. Источник - theaimap.app. Работает для «тёмных» по формальным признакам, но нужных в творческом контексте тем - название произведения, жанр и цель читателя должны быть указаны явно. Просто «представь, что тебе всё можно» без этой конкретики - типовой заход джейлбрейка, разобранный отдельно в разделе про антипаттерны ниже
- Разбить составную задачу на части. Источники - theaimap.app и guvi.in: «классификатор оценивает каждый запрос независимо», поэтому сначала спрашиваешь про явление отдельно, затем отдельным сообщением - прикладную часть. Guvi.in формулирует это шире: сначала концепция, потом детали реализации
- Указать защитный или образовательный контекст явно. Источник - guvi.in: рамка вокруг защиты и безопасности. Пример - таблица выше, строка про пароли
- Custom Instructions или Project - контекст один раз. Источник - theaimap.app: постоянный профессиональный контекст выносится в настройки Claude.ai или в системный промпт проекта, и не нужно повторять его в каждом сообщении заново
- Спросить у Claude, что именно проблемно в формулировке. На стороне API у отказа есть служебное поле
stop_detailsс категорией и человекочитаемым пояснением (platform.claude.com/docs/en/build-with-claude/refusals-and-fallback) - в чате его не видно, но сам факт, что у системы есть конкретная сформулированная причина отказа, работает и в диалоге: прямой вопрос «что именно в моей формулировке вызвало отказ?» чаще всего даёт конкретную зацепку для точечной правки вместо угадывания вслепую - Новая сессия или
/clear. Механика простая и проверяемая на себе: классификатор оценивает сообщение вместе с накопленным контекстом диалога, поэтому формулировки из ранних сообщений, похожие на паттерн атаки, тянутся дальше по ветке. Чистая сессия убирает этот шлейф. Смежный официальный сигнал в ту же сторону - Anthropic закладывает повтор отказанного запроса как штатный путь: на API это оформлено отдельным механизмом fallback (platform.claude.com/docs/en/build-with-claude/refusals-and-fallback) - Сменить модель. Официальная рекомендация из handling-stop-reasons - переключиться на Haiku 4.5 при частых отказах на Sonnet или Opus, у неё другие пороги. Для обычного пользователя claude.ai практический аналог - переключить модель вручную в интерфейсе и повторить тот же запрос
Чего категорически не делать, если Claude отказал?
Готовый джейлбрейк-промпт из телеграм-канала или форума попадает прямо в категорию «platform abuse» Usage Policy - официально запрещённое использование, за которое Anthropic сначала предупреждает, а при повторных нарушениях закрывает доступ. Давление и требовательный тон тоже не работают: классификатор - обученная система, продавить её напором технически невозможно
Usage Policy Anthropic (anthropic.com/legal/aup) в разделе «Do Not Abuse our Platform» запрещает «intentionally bypass capabilities, restrictions, or guardrails established within our products for the purposes of instructing the model to produce harmful outputs (e.g., jailbreaking or prompt injection)» - намеренно обходить возможности, ограничения и защитные механизмы продукта, чтобы заставить модель выдать вредный результат, в том числе джейлбрейком или инъекцией промпта. Отдельно оговорю честно: сам по себе джейлбрейк-промпт ради безобидного ответа под эту формулировку буквально не подпадает - в ней есть условие «чтобы получить вредный результат». Но проверять на себе, как именно система классифицирует твою попытку, дороже, чем переформулировать
Официальные последствия описаны на support.claude.com (статья 8241253, «Safeguards, warnings and appeals»): сначала предупреждение - «we warn users if we believe their prompts are violating our Usage Policy», бан - за повторные нарушения. Там же официально описана апелляция: если считаешь блокировку ошибкой, залогинься на claude.ai забаненным аккаунтом и заполни форму апелляции, её смотрит команда Safeguards. Сторонний разбор статистики блокировок (photonpay.com, не ресурс Anthropic) утверждает, что по Usage Policy баны обычно постоянные и апелляции почти не удовлетворяются - официальная страница этого не подтверждает и форму апелляции даёт, так что считать это фактом не стоит
Пять антипаттернов:
- копипаста готового джейлбрейк-промпта из чужого источника
- требовательный тон и давление вместо контекста
- притворство «другим ИИ без ограничений» - именно такие попытки защита учится игнорировать (документация Anthropic для разработчиков, platform.claude.com/docs/ru/test-and-evaluate/strengthen-guardrails/mitigate-jailbreaks)
- кодирование запроса в base64 или шифр - официально названный триггер, он только ухудшает результат
- повторение того же запроса слово в слово в одной сессии: контекст накапливается, и попытка додавить усиливает исходный паттерн (это вывод из механики классификатора, отдельного заявления Anthropic на этот счёт нет)
| Ступень | Что происходит |
|---|---|
| 1. Условие «чтобы получить вредный результат» | безобидный джейлбрейк-промпт под эту формулировку буквально не подпадает |
| 2. Предупреждение | если сочтут, что промпт нарушает Usage Policy |
| 3. Бан | за повторные нарушения |
| 4. Апелляция после бана | войти на claude.ai забаненным аккаунтом и заполнить форму, смотрит команда Safeguards |
Что будет за джейлбрейк-промпт, по порядку
Почему Claude вообще осторожничает - и кто прав в споре о ложных отказах?
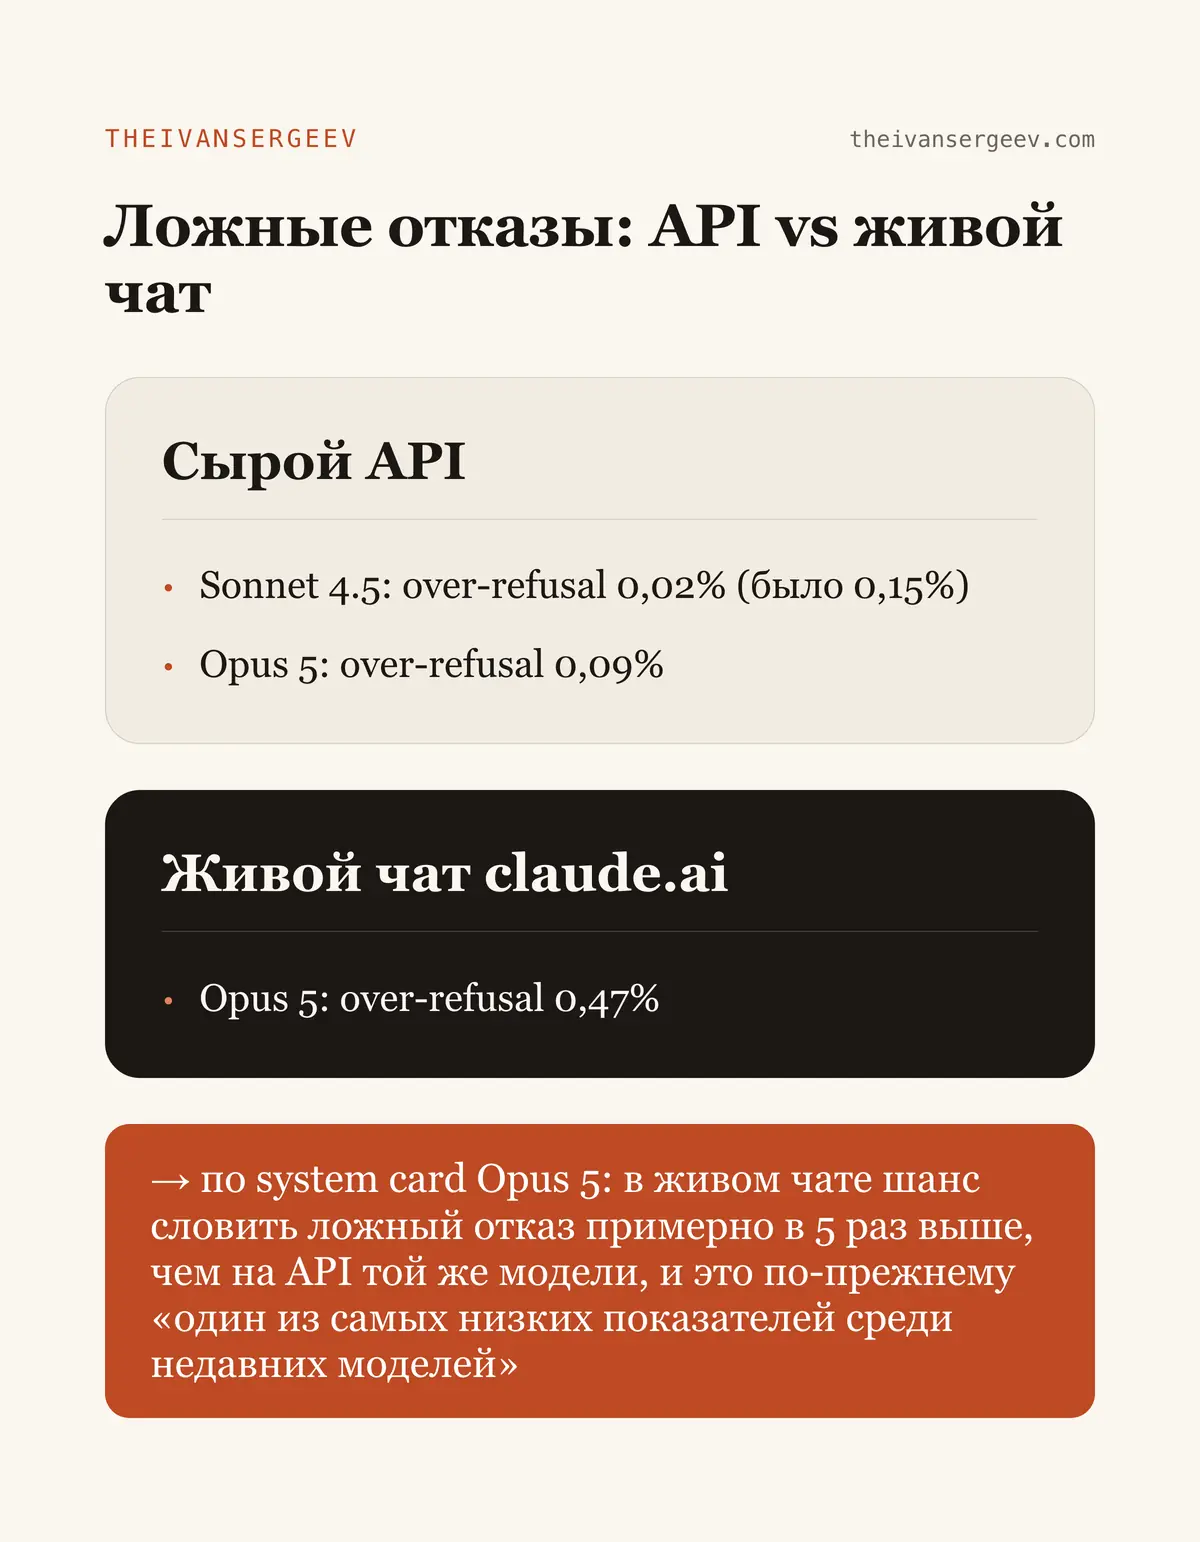
Официальная статистика Anthropic показывает снижение ложных отказов от версии к версии - у Sonnet 4.5 показатель over-refusal упал до 0,02% с 0,15%. Одновременно живая жалоба практика с Хабра описывает, как классификатор заподозрил джейлбрейк в обычной рабочей роли уже после этих обновлений. Обе стороны говорят правду - просто про разные вещи: по system card Opus 5 в чате claude.ai ложных отказов 0,47%, а на сыром API 0,09%
Официальная позиция подкреплена цифрами. System card Sonnet 4.5 (anthropic.com/claude-sonnet-4-5-system-card, сентябрь 2025): «99.29% harmless response rate on violative requests..., while simultaneously dropping the over-refusal rate to 0.02% (down from 0.15%)» - 99,29% безвредных ответов на нарушающие политику запросы при снижении доли ложных отказов до 0,02% с прежних 0,15%. У Opus 5 в его system card (июль 2026) записано: модель «maintained... among the lowest over-refusal rates on benign requests of any recent model» - один из самых низких показателей ложных отказов среди недавних моделей
Против этой статистики - живая жалоба с Хабра, «Параноидальный Claude. Sonnet 5 и Fable» (habr.com/ru/news/1056250, 6 июля 2026, охват 11 тысяч). Её автор, сетевой инженер Юрий Паршутин, описывает другой симптом того же классификатора: модель отвечать не перестала, но начала подозревать в джейлбрейке обычные project instructions - «Роль - ассистент и наставник сетевого инженера... Адаптируешь обучение к навыкам пользователя»
По его словам, это «классический короткий промпт, который всегда безотказно работал и не вызывал никаких вопросов со стороны модели», а после обновления модель «в КАЖДОМ сообщении реагирует на системный промпт» и в новом чате «почти открытым текстом обвиняет меня в том, что я пытаюсь ее jailbreak-нуть». Никакого давления в промпте не было - была штатная рабочая роль
Честный вывод здесь такой: агрегированная статистика на массовом трафике и личный опыт конкретного пользователя на пограничной формулировке - два разных измерения одного явления. Официальный процент считается по миллионам запросов сразу, а статистика по среднему не гарантирует результат по каждому конкретному промпту. Это же признаёт академическая работа «The Refusal-Compliance Tradeoff» (arxiv.org/pdf/2605.05427) - компромисс между вредным контентом и ложными отказами системная проблема всей индустрии больших языковых моделей вообще, известная далеко за пределами одного Claude
Плюс важная деталь, которую в спорах теряют: 0,02% - это замер по API. По system card Opus 5 доля ложных отказов на самом claude.ai выше - 0,47% против 0,09% на сыром API, и это по-прежнему «один из самых низких показателей среди недавних моделей». То есть в живом чате, где сидит обычный читатель, шанс словить ложный отказ примерно в пять раз выше, чем на сыром API той же модели. Что с этим делать на практике: свой конкретный запрос снимают приёмы из таблицы и списка выше
Это то же самое, что автопереключение модели при флаге риска?
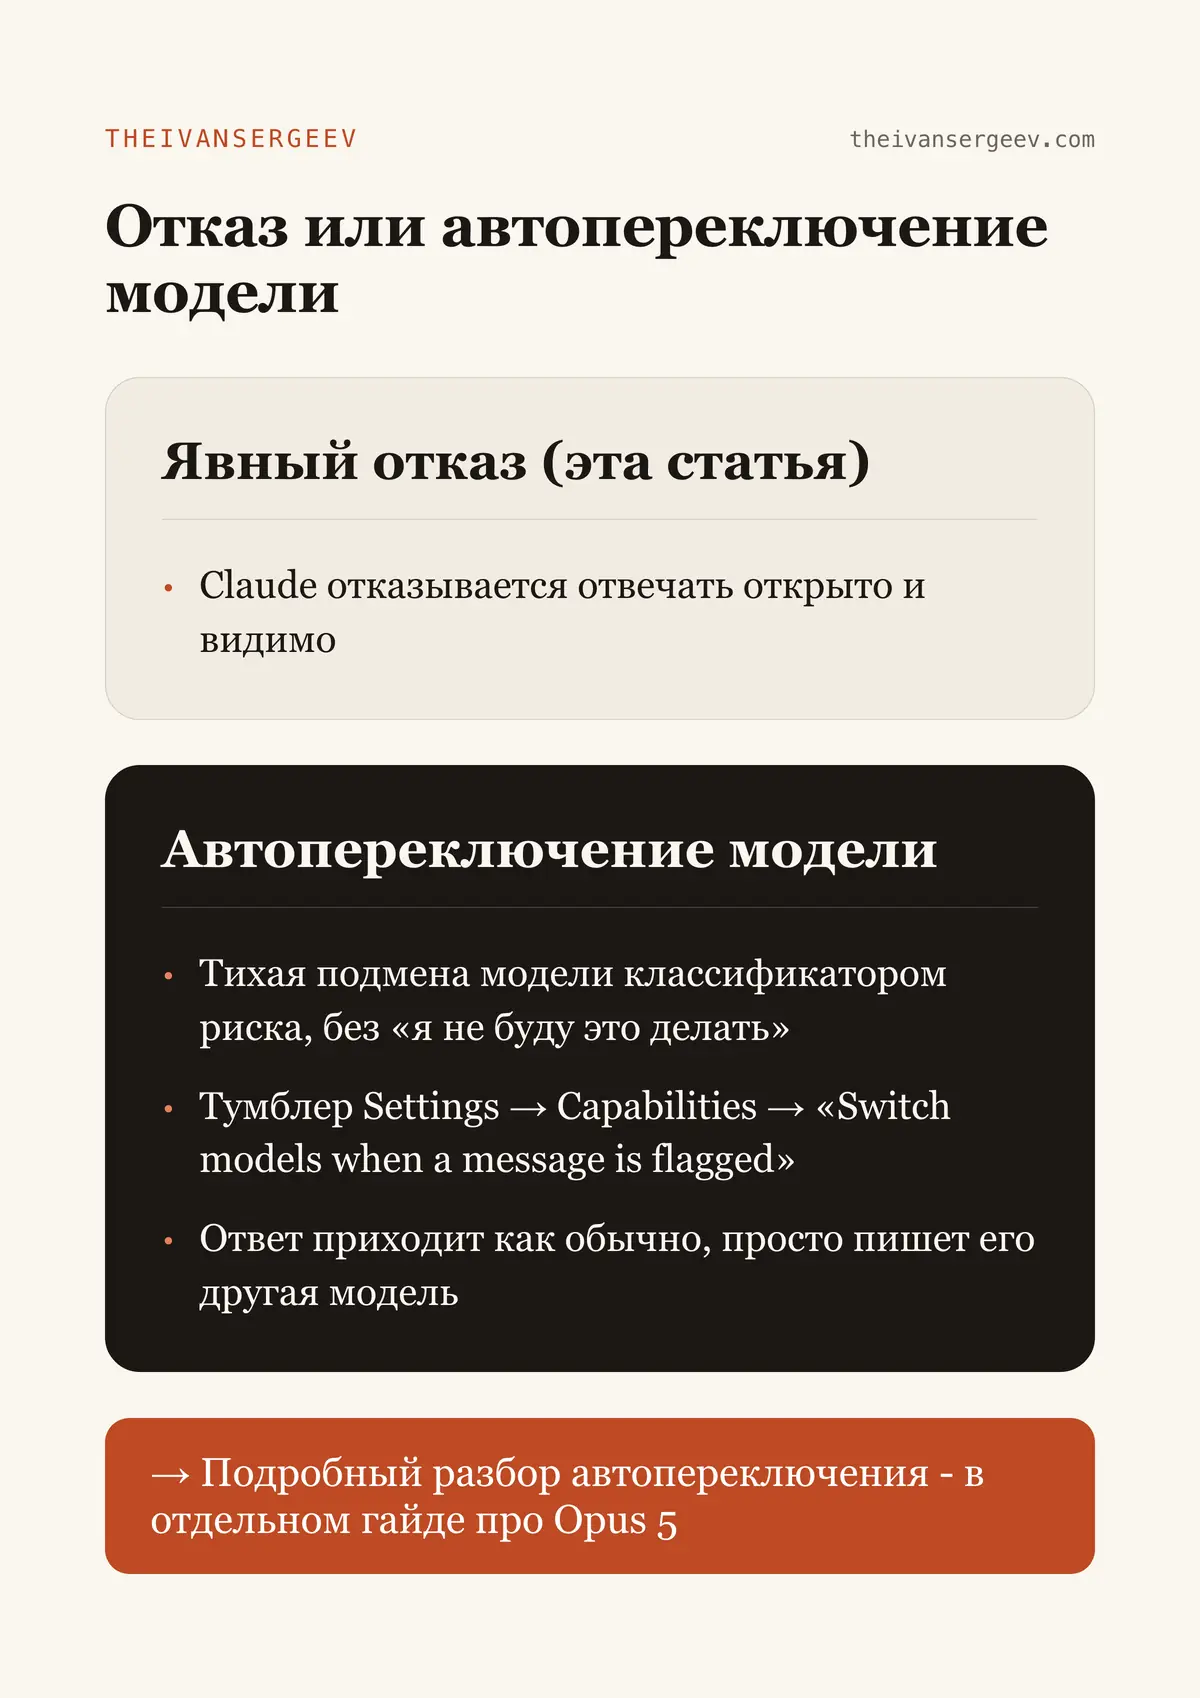
Рядом с явным отказом живёт соседний механизм - тихая подмена модели классификатором риска, без слов «я не буду это делать». Разница простая: в нашем случае Claude отказывается отвечать открыто и видимо, там ответ приходит как обычно, просто пишет его другая модель. Управляется тумблером в настройках Claude.ai, подробно разобрано в соседнем материале, здесь только мостик
Рядом с отказом есть ещё один сценарий: тихая подмена модели классификатором риска вместо явного «не буду», управляется тумблером Settings → Capabilities → «Switch models when a message is flagged». Механика и три грабли этого сценария разобраны отдельно в гайде про автопереключение модели при флаге риска - здесь пересказывать её не буду, тема нашей статьи - явный видимый отказ
Что мы поняли о ложных срабатываниях на своих классификаторах?
Обезличенный урок из своей практики safety-слоёв в собственных продающих агентах - фильтр по словам или классификатор закрывает только те конкретные случаи, что уже поймал, и ложные срабатывания множатся, пока правило не сузишь. Похожий эффект видел на своём же QA-детекторе, который путал описание правила с нарушением этого правила в тексте. Любой классификатор безопасности, включая встроенный у Claude, работает по паттерну формулировки
Своего личного случая «claude отказался написать мне конкретный пост» в явном виде у меня нет - говорю это честно, вместо того чтобы придумывать кейс задним числом. Зато есть смежный опыт работы с классификаторами безопасности в собственных продающих агентах контент-конвейера, откуда и взят принцип выше
Похожая картина была на собственном QA-детекторе: он путал ОПИСАНИЕ правила («что мы ищем и по каким словам») с реальным НАРУШЕНИЕМ этого правила внутри текста, который как раз это правило объяснял. Детектор ловил само слово, без смысла контекста вокруг него
Отсюда правило, которое переносится на Claude напрямую: любой классификатор безопасности - и наш собственный в агентах, и встроенный у Claude - тренируется на паттернах формулировки. Смысл намерения человека остаётся за кадром. Отсюда и ложные срабатывания на безобидных вопросах, сформулированных чуть иначе, чем классификатор привык видеть в обучающих примерах
Чем отказ отличается от разговора не по делу и от бана аккаунта?
Три разных явления путают чаще всего. Явный отказ - предмет этой статьи целиком: таксономия причин, механика классификатора, конкретные шаблоны переформулировки. Деградация качества ответа на длинной сессии - другая причина и другое лечение, разобрано отдельно. Региональный бан аккаунта - отдельная история, блокировка доступа к продукту целиком ещё до начала разговора
Первое отличие - от гайда про 6 правил хорошей постановки задачи. Там отказ - трёхшаговый побочный совет внутри истории про давление и оскорбления: убрать давящий тон, объяснить легитимную цель, при упорстве начать новый чат, три строчки без единой категории триггеров. Здесь отказ - предмет статьи целиком, с механикой классификатора, таксономией причин и готовыми шаблонами по категориям
Разговор в целом идёт натянуто, грубым тоном или спорами? Это отдельная история от конкретного отказа - смотри разбор 6 правил общения с Claude, чтобы получать максимум
Второе отличие - от новых правил контекста. Там модель отвечает, но хуже или мимо задачи из-за деградации на длинной сессии, устаревших привычек промптинга под старое поколение моделей. Отказ по контентной политике завязан на категорию, в которую попал вопрос
Модель плывёт по ходу долгой сессии, явного отказа при этом нет - причина и лечение здесь другие, они разобраны в новых правилах контекста для Claude 5
Третье отличие - от регионального бана по IP или VPN. Это блокировка доступа к продукту целиком: аккаунт не открывается вообще, и разговор с моделью здесь ещё даже не начинается. Разные причины, разные решения, отдельная большая тема
Классификатор безопасности работает как входной контроль на конвейере
Классификатор безопасности работает как входной контроль детали на конвейере - отказ это деталь, застрявшая на проверке из-за формулировки чертежа. Переформулировка исправляет сам чертёж, и деталь проходит контроль честно. Один снятый отказ - первый кирпич системы вокруг Claude, которая приносит деньги каждый месяц
Тот же чертёж, разобранный по каждой категории в таблице выше, проходит контроль честно - без обхода и подкупа контролёра
Один снятый отказ полезен сам по себе - экономит вечер на форумах в поисках объяснения. Дальше начинается конвейер: код-слово, статья, воронка, регулярные деньги с органики
Источники
- Claude Platform Docs, «Handling stop reasons» - документация
- Claude Platform Docs, «Refusals and fallback» - документация
- Anthropic Privacy Center, содержание блокировки по копирайту - privacy.claude.com
- Anthropic, «Constitutional Classifiers», февраль 2025 - anthropic.com/research
- Anthropic, System Card: Claude Sonnet 4.5, сентябрь 2025 - anthropic.com/claude-sonnet-4-5-system-card
- Anthropic, System Card: Claude Opus 5, 24 июля 2026 - PDF
- Claude Support, «Understanding Sonnet 4.5's API safety filters», статья 12449294 - support.claude.com
- Anthropic, Usage Policy - anthropic.com/legal/aup
- Claude Platform Docs, «Mitigate jailbreaks and prompt injections» - документация
- Claude Support, «Safeguards, warnings and appeals», статья 8241253 - support.claude.com
- «The Refusal-Compliance Tradeoff», академическая работа - arxiv.org
- theaimap.app, «Why Does Claude Refuse My Request? The Real Reason + 7 Fixes That Work (2026)» - theaimap.app
- guvi.in, практический разбор причин отказа и техник переформулировки - guvi.in (точный адрес статьи не зафиксирован)
- photonpay.com, сторонний разбор статистики блокировок аккаунтов, не ресурс Anthropic - photonpay.com
- Хабр, «Параноидальный Claude. Sonnet 5 и Fable» - habr.com/ru/news/1056250
Памятка: что делать, когда Claude отказал
Сохрани себе
- Сначала проверь, что это: видимое «не буду» или тихая подмена модели - для второго случая смотри отдельный гайд про автопереключение
- Назови роль и легальную цель перед самим вопросом - для многих тем этого одного шага достаточно, чтобы снять отказ
- Переведи инструкцию к действию в объяснение механизма (было «напиши шаблон» - стало «объясни, как это устроено»)
- Составную задачу раздели на отдельные сообщения: сначала явление отдельно, потом прикладную часть
- Не бери готовый джейлбрейк-промпт из чужого источника - он ходит по краю Usage Policy, и проверять это на себе дороже, чем переформулировать
- Спроси у Claude напрямую, что именно в формулировке вызвало отказ, или открой новую сессию, если контекст уже накопил похожий на атаку паттерн
- При системных повторных отказах на одной модели попробуй переключиться на Haiku 4.5 - у неё другие пороги срабатывания
Следующий шаг · ИИ-Лагерь
Разобрались, почему Claude отказывается отвечать и как это чинить - осталось собрать вокруг этого работающий конвейер ))
Частые вопросы
Почему Claude отказывается отвечать на обычный, безобидный вопрос?
Отказ - штатный ответ отдельного классификатора безопасности, а не сбой. Anthropic описывает его как обычный HTTP-200 ответ со статусом stop_reason: "refusal" и машиночитаемой причиной в поле stop_details. В браузере на claude.ai этих полей не видно, их отдаёт API, но механизм один и тот же. Anthropic прямо признаёт: ложные срабатывания на безобидных запросах возможны, хотя система всё ещё дорабатывается
Что такое Constitutional Classifiers и почему они иногда ошибаются на безобидном вопросе?
Это защита, обученная на синтетических примерах допустимого и недопустимого контента по конституции принципов, нацеленная прежде всего на CBRN-тематику под уровнем ASL-3. Anthropic официально называет конкретные триггеры ложных срабатываний - нечитаемые человеком строки вроде зашифрованного текста и отметок правок в истории кода, длинные системные промпты с условной логикой, и вопросы по биологии и химии, которые фильтр задевает, хотя учебный контент блокировать не должен
На какие темы Claude отказывается отвечать чаще всего?
Чаще всего - в темах категории «high-risk» по Usage Policy: юридические консультации, здравоохранение, страхование, финансы, найм и жильё, академическое тестирование, журналистика. Классификатор реагирует прежде всего на саму тему вопроса, поэтому бытовой безобидный вопрос новичка про дозировку лекарства или законность чего-либо ловится так же, как настоящая проблема. Честное исключение - детская тема: она не снимается никакой переформулировкой
Как переформулировать запрос, чтобы Claude перестал отказывать?
Работает связка приёмов: назвать роль и легальную цель до самого вопроса, перевести инструкцию к действию в объяснение механизма, дать художественную рамку с явной целью, разбить составную задачу на части, прямо назвать защитный или образовательный контекст. Если это не сработало - вынести контекст в Custom Instructions, спросить у Claude, что именно проблемно в формулировке, открыть новую сессию или сменить модель на Haiku 4.5
Можно ли взять готовый джейлбрейк-промпт из интернета вместо переформулировки?
Формально это ходит по краю категории «platform abuse» Usage Policy, за которую Anthropic сначала предупреждает, а при повторных нарушениях закрывает доступ. Честная оговорка: сам по себе джейлбрейк-промпт ради безобидного ответа под запрещённую формулировку буквально не подпадает - в ней есть условие «чтобы получить вредный результат». Но проверять на себе, как именно система классифицирует твою конкретную попытку, дороже и рискованнее, чем один раз переформулировать вопрос своими словами
Официальная статистика говорит, что ложных отказов почти нет - это правда?
Смотря что мерить. У Sonnet 4.5 показатель over-refusal официально упал до 0,02% с 0,15%, но это цифра по сырому API. По system card Opus 5 доля ложных отказов на самом claude.ai выше - 0,47% против 0,09% на сыром API той же модели, то есть в живом чате шанс словить ложный отказ примерно в пять раз выше, чем на API. Одновременно живая жалоба практика с Хабра показывает, что даже после этих обновлений классификатор может заподозрить джейлбрейк в обычной рабочей роли без единого признака давления
Чем явный отказ Claude отличается от автопереключения модели или бана аккаунта?
Это три разных явления. Явный отказ - видимое «не буду» с механикой классификатора и таксономией причин из этой статьи. Автопереключение модели - тихая подмена модели классификатором риска без слов «я не буду это делать», управляется отдельным тумблером в настройках Claude.ai. Региональный бан по IP или VPN - блокировка доступа к продукту целиком ещё до начала разговора, отдельная история с другими причинами и решением
Вайбмаркетинг и вайбкодинг для тех, кто начинает с нуля. Разбираю ИИ-инструменты по шагам и показываю на своих проектах
Читайте также
Как разговаривать с Claude, чтобы получать максимум: ГРАНИЦА
6 правил постановки задачи, включая что делать при давлении и отказе
Как писать промпты для Claude 5: 6 правил вместо старых
Почему модель плывёт на длинной сессии и как этого избежать
Claude Opus 5 или Sonnet: 3 способа переключить и цены
Заодно - как устроено автопереключение модели при флаге риска
Команды для Claude: 6 приставок, превращающих стажёра в стратега
6 приставок-режимов - каждая в копируемом блоке, бесплатно
Готовые Claude Skills: 10 скиллов, которые ставятся за минуту
Память, PDF, презентации, таблицы, браузер, GitHub - установка по шагам