Тесты моделей · разбор таблицы ARC-AGI-3 · сентябрь 2026
Как читать тесты ИИ: 4 шага по таблице arcprize.org в 2026
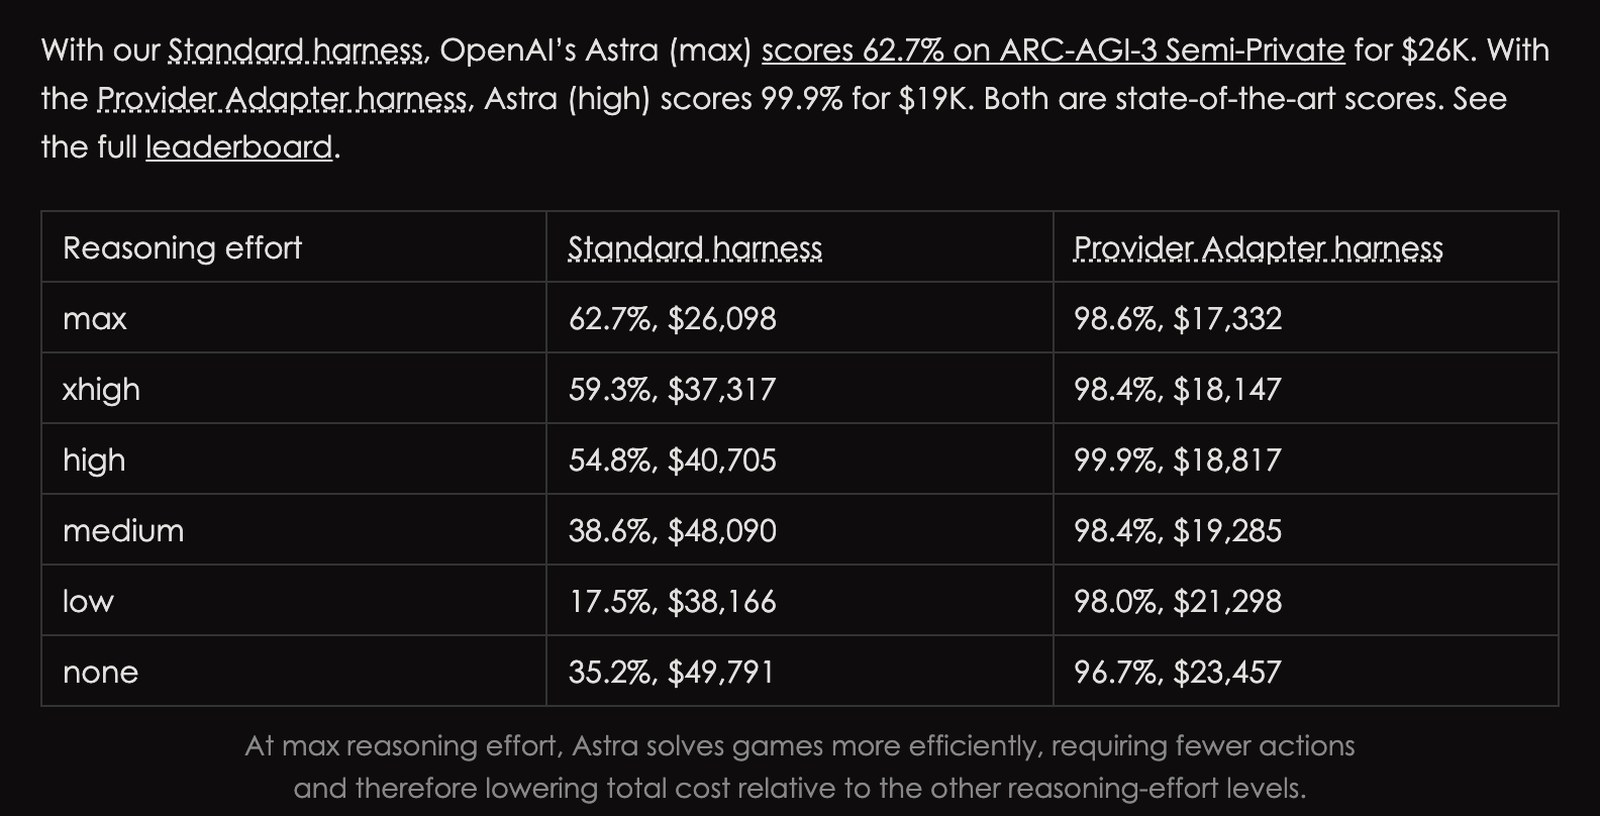
Бенчмарк, то есть тест для сравнения моделей, отдаёт не одно число, а таблицу. 3 сентября 2026 года в официальной таблице GPT-6 Astra на тесте ARC-AGI-3 встали рядом 62.7% и 98.6%. Одна модель, один день, разница 36 пунктов - и взялась она из оснастки прогона, а не из модели. Ниже четыре шага, после которых ты читаешь такую таблицу сам
Смотри не на процент, а на подпись под ним. Проверь четыре вещи: номер версии теста, чья оснастка прогона, с чем сравнивают и открытый ли набор задач. Числа из разных колонок между собой не сравнимы
Что случилось с цифрой 98.6%
3 сентября 2026 года ARC Prize опубликовал разбор прогона новой модели OpenAI на своём тесте. Первая же строка поста: модель набирает 62.7% на их собственной оснастке и 99.9% на оснастке производителя
В ленте разошлось третье число, 98.6%. Оно тоже настоящее и тоже стоит в этой таблице. Но это одна ячейка из двенадцати, и взята она из правой колонки при уровне усилия max
К концу статьи ты будешь уметь четыре вещи: находить версию теста рядом с процентом, отличать оснастку производителя от независимой, видеть несравнимую пару чисел до того, как в неё поверил, и читать формулу замера в первоисточнике, а не в пересказе
Шаг 1. Найди номер версии теста рядом с процентом
Открой arcprize.org/leaderboard. Это общая страница результатов
Что увидишь: три раздела вместо одного списка. Reasoning Systems, Base LLMs, Kaggle Systems. Внутри каждого строки моделей, и у каждой строки в подписи стоит номер версии теста
Зачем это первое действие. У теста ARC-AGI три версии, и они меряют разное:
| Версия | Что за задачи | Сколько уходит у человека |
|---|---|---|
| версия 1 (2019) | статичные картинки-сетки, правило выводится из пары примеров | около 30 секунд на задачу |
| версия 2 (март 2025) | тот же формат сеток, но в несколько шагов рассуждения | около 300 секунд на задачу |
| версия 3 (2026) | пошаговые игры, правил не сообщают вовсе | интерактивная сессия до 20 минут |
Таблица прокручивается вбок →
Числа времени взяты из официального техотчёта, раздел 1.1-1.3. Разница между версиями не в сложности одних и тех же задач, а в самом формате: первые две дают картинку, третья даёт игру
Признак успеха шага: рядом с процентом, который ты смотришь, стоит номер версии. Нет номера - число не сравнимо ни с чем, и это уже ответ
Процент «на ARC-AGI» без номера версии означает ровно то же, что «выиграл соревнование» без названия дисциплины. Про сам тест и чем версии отличаются внутри у меня есть отдельный разбор: ARC-AGI что это. Если сначала хочется понять, что вообще называют передовой моделью, это здесь: фронтир-модели простыми словами
Шаг 2. Открой официальный разбор самого замера
Число из ленты почти никогда не лежит в общей таблице. Оно живёт в отдельном посте про конкретный прогон
Куда идти: arcprize.org/blog/astra, пост от 3 сентября 2026 года, автор Greg Kamradt
Что увидишь на экране: таблицу из шести строк и двух колонок с числами. Слева Standard harness, то есть штатная оснастка ARC Prize. Справа Provider Adapter harness, оснастка от производителя модели. Шесть строк это уровни усилия, от none до max
Вот она целиком, дословно с той страницы:
| Уровень усилия | Оснастка ARC Prize | Оснастка производителя |
|---|---|---|
| max | 62.7%, 26 098 $ | 98.6%, 17 332 $ |
| xhigh | 59.3%, 37 317 $ | 98.4%, 18 147 $ |
| high | 54.8%, 40 705 $ | 99.9%, 18 817 $ |
| medium | 38.6%, 48 090 $ | 98.4%, 19 285 $ |
| low | 17.5%, 38 166 $ | 98.0%, 21 298 $ |
| none | 35.2%, 49 791 $ | 96.7%, 23 457 $ |
Таблица прокручивается вбок →
Признак успеха шага: ты видишь ДВЕ колонки, а не одну. Двенадцать чисел разброса от 17.5% до 99.9% у одной модели
Чем отличаются колонки по сути. Штатная оснастка ARC Prize разрешает модели вести заметки и тащить их дальше по игре. Оснастка производителя вместо этого сохраняет между запросами своё внутреннее состояние рассуждения, непрозрачное для ARC Prize, и сжимает длинные разговоры. То есть модель переиспользует прежнюю работу способом, который проверяющая сторона не видит
Шаг 3. Сравнивай только внутри одной колонки
Здесь ломается девять новостей из десяти, и здесь же лежит весь навык
Заголовок, который разошёлся: «98.6% против 7.8% у прошлой модели». Числа оба настоящие. Сравнение между ними - нет
Разбери его по колонкам:
- 98.6% и 99.9% у новой модели сняты на оснастке производителя, то есть в правой колонке
- 7.8% у прошлой модели снято на штатной оснастке ARC Prize, то есть в левой
Это разные колонки. Сравнивать их между собой то же самое, что сравнить время бегуна по шоссе со временем другого по пересечённой местности и объявить второго слабым
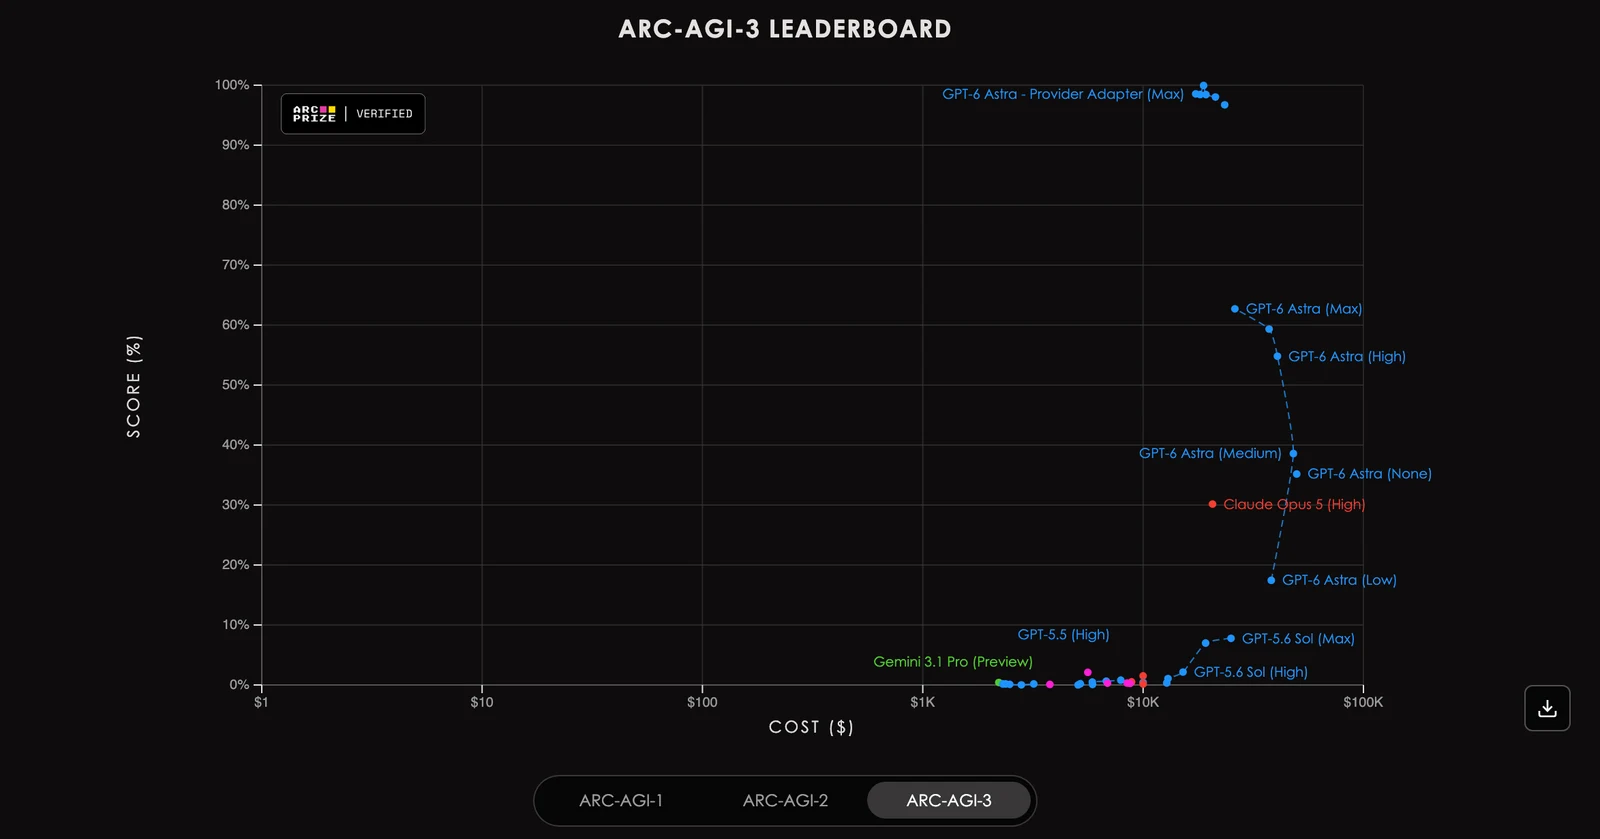
Сравнимая пара внутри одной колонки: 62.7% против 7.8%. Тоже огромный скачок, потому что до этого замера передовые модели брали на третьей версии теста меньше одного процента. Но выглядит он уже не как «почти человек»
И тут есть деталь, которую видно, только если открыть страницу самому. Я прогнал по её живому тексту поиск всех чисел из заголовков новостей:
ЧТО ИЩУ В ЖИВОМ ТЕКСТЕ официальной страницы arcprize.org/blog/astra

  62.7%                        вхождений: 4
  98.6%                        вхождений: 1
  99.9%                        вхождений: 4
  17.5%                        вхождений: 1
  Standard harness             вхождений: 8
  Provider Adapter harness     вхождений: 11
  7.8%                         вхождений: 0
Числа 7.8% на официальной странице нет ни одного раза. Оно пришло из пересказа, а не от держателя теста. Это и есть третий признак несравнимой пары: одно число из первоисточника, второе из чужого текста
Признак успеха шага: ты можешь пальцем показать в таблице, какие два числа сравнимы, и сказать словами, почему другая пара нет
Дальше рабочее правило на любую таблицу. Прежде чем поверить в сравнение двух процентов, найди у каждого подпись с оснасткой. Совпали подписи - сравнение живое. Не совпали или подписи нет вовсе - сравнения нет, есть два отдельных числа рядом. Та же осторожность нужна с ценой прогона: в правой колонке она ниже, и это тоже часть картины, а не мелочь. Как читать цену у моделей в обычной жизни, разобрано отдельно: модели Claude и их цены
Шаг 4. Проверь формулу в техотчёте
Формула замера в пересказах всегда обрезана, и обрезают её в одном и том же месте
Куда идти: техотчёт ARC_AGI_3_Technical_Report.pdf, раздел 4.1, страницы 11-12. Открывается без регистрации
Что увидишь: метрику называют RHAE, и формул там не одна, а три
Первая, на один уровень игры:
S = min(1.15, (h / a)²)Здесь a это сколько действий сделала модель, h это человеческий базовый показатель по тому же уровню. Пример из самого отчёта: человек прошёл уровень за 10 действий, модель за 100, получается (10/100)² то есть 1%
Смотри на слово min слева. Это потолок: выше 115% один уровень не даёт, даже если модель прошла его быстрее человека. В пересказах потолка нет никогда
Вторая, внутри одной игры: результаты уровней складываются с весами, и вес уровня равен его номеру. Поздние уровни тяжелее ранних. Плюс отдельное ограничение: нельзя получить сто процентов за игру, не пройдя в ней все уровни
Третья, по всему тесту: простое среднее по всем играм
Признак успеха шага: ты нашёл в первой формуле слово min и число 1.15
Я скачал этот отчёт и открыл страницы 11-12 сам, вот что там стоит дословно:
ОТКРЫЛ СТРАНИЦЫ 11-12 ТЕХОТЧЁТА. Что в оригинале:

  формула (1), стр.12:   S(l,e) = min( 1.15, (h(l,e)/a(l,e))^2 )
  формула (2), стр.12:   E(e)   = min( сумма весов пройденных / сумма всех,
                                       взвешенное среднее по уровням )
  формула (3), стр.12:   T      = среднее E(e) по всем играм набора

  про потолок, стр.11, дословно:
  «Each individual level will get a score between 0% (very inefficient)
   and 115% (surpasses human level efficiency)»

  таблица 1, стр.11 - состав наборов задач:
     Public Demo     25 игр   витрина формата
     Semi-Private    55 игр   закрытый набор для замера моделей
     Fully Private   55 игр   закрытый набор для соревнования
Обрати внимание на последние три строки: витрина это 25 игр, а замеряют по закрытым наборам из 55. Это пригодится в четвёртом вопросе ниже
Версия из ленты («результат человека делить на действия модели, и в квадрат») описывает только первую формулу из трёх. Для объяснения на пальцах это честно. Как «формула теста» целиком - уже нет: пропали и потолок, и два уровня сборки итога
Что говорят сами авторы теста
Вывод «это почти человеческий уровень» сделали не авторы теста. Авторы от него отказались
ARC Prize заявил прямо, что не называет результат общим искусственным интеллектом. Со-основатель Mike Knoop написал дословно:
we lack evidence to call this AGI yet Mike Knoop, со-основатель ARC Prize, 6 сентября 2026 года
То есть доказательств для такого вывода пока нет. И объявлено, что дальше результаты обеих оснасток будут публиковаться рядом
Там же лежит деталь, которая хорошо показывает, зачем открывать первоисточник. François Chollet, автор теста, назвал в своём посте 66% для штатной оснастки, а в опубликованной таблице стоит 62.7%. Запись в блоге и есть основной документ, пост в ленте нет. Даже внутри команды теста число в пересказе разошлось с числом в таблице
Четыре вопроса к любой таблице результатов
Это переносится на любой другой тест, не только на этот:
| Вопрос | Где смотреть | Красный флаг |
|---|---|---|
| 1. Какая версия теста | подпись рядом с процентом | номера версии нет вовсе |
| 2. На чьей оснастке прогон | шапка колонки в таблице замера | оснастка не названа, колонка одна |
| 3. С чем сравнивают | обе цифры пары | числа взяты из разных колонок |
| 4. Набор задач открытый или закрытый | слово public или semi-private рядом с результатом | хвалятся результатом на публичном наборе |
Таблица прокручивается вбок →
Про четвёртый вопрос отдельно: у третьей версии публичный набор из 25 игр сделан заметно легче закрытого и служит витриной, а оценку ведут по закрытым наборам. Результат на публичном наборе это не результат экзамена
Пятый вопрос держу отдельно, потому что он не проверяется по таблице: не утекали ли задачи теста в обучение модели. Это общая болезнь замеров, и у третьей версии ARC-AGI против неё встроена защита - в играх нет ни слов, ни культурных символов, и есть отдельная проверка на новизну. Конкретных чисел по утечкам именно здесь я не нашёл ни в одном первоисточнике, поэтому цифр не привожу
Отдельно про выбор модели под свою работу: процент на тесте это намёк, а не гарантия. Что с чем сравнивать на практике, разобрано тут - ChatGPT против Claude и какая нейросеть лучше под задачу
Где посмотреть всё своими руками
Тест открытый, и его можно пройти самому:
- сыграть глазами и руками, без регистрации: arcprize.org/arc-agi/3, кнопка Play для людей и публичный набор игр
- человеческая таблица результатов отдельно от машинной: arcprize.org/arc-agi/3/leaderboard
- описание методики замера: docs.arcprize.org/methodology
- соревнование 2026 года, где лежат конкурсные решения: arcprize.org/competitions/2026/arc-agi-3
Сыграть полезнее, чем читать про тест. В играх нет подсказок: ты видишь поле и несколько кнопок, а что такое победа, приходится выводить самому. Ровно этим и заняты модели в замере
В итоге у тебя
На выходе ты держишь не пересказ новости, а четыре вопроса, которые задаёшь любой таблице результатов за пару минут: версия теста, оснастка прогона, сравнимость пары, открытый или закрытый набор задач
Проверить это на себе можно прямо сейчас. Возьми любой процент про модели из своей ленты и пройди по четырём вопросам. Если у числа не находится ни версии, ни оснастки, ни пары для сравнения из той же колонки - это не результат, а картинка с цифрой
Источники
Цифры в таблице сверены не по пересказам, а по живой странице: я открыл arcprize.org/blog/astra сам 13 сентября 2026 года и снял её кадром, который стоит в начале статьи
- Официальный разбор прогона GPT-6 Astra - та самая таблица двух оснасток, 3 сентября 2026 года
- Техотчёт ARC-AGI-3 (PDF) - формулы RHAE, раздел 4.1, страницы 11-12
- Анонс запуска ARC-AGI-3 - формат теста, отличие от прошлых версий
- Описание методики замера - как считается итог
- Общая страница результатов ARC Prize - три раздела и номера версий
- Разбор истории с оснастками в The Next Web - откуда пара 62.7% против 7.8% и слова Mike Knoop, 6 сентября 2026 года Цифры в таблице сверены не по пересказам, а по живой странице: я открыл arcprize.org/blog/astra сам 13 сентября 2026 года и снял её кадром, который стоит в начале статьи
Памятка: как читать таблицу результатов
Сохрани себе
- Версия теста стоит рядом с процентом, иначе число ни с чем не сравнимо
- Оснастка прогона решает: у Astra 62.7% против 98.6% на одной модели
- Сравнимы только числа из ОДНОЙ колонки, остальное это два числа рядом
- Заголовочная цифра берётся из колонки повыгоднее, это норма индустрии
- Формула из ленты обрезана: в оригинале потолок 1.15 и три уровня сборки
- Публичный набор задач легче закрытого и служит витриной, а не экзаменом
- Авторы теста от вывода «это AGI» отказались публично
Куда это ведёт
Ты научился проверять чужие цифры, и это отдельный навык
Читать таблицы честно полезно не только про модели. Тот же приём работает на чужих кейсах, на обещаниях сервисов и на любых «выросли в три раза»: ищешь, из какой колонки взята цифра
На Лагере я веду через это за руку, на живых проектах, от первой проверки до собранной системы
Кнопка ведёт в мой закрытый канал. Жмёшь «Подать заявку», впускаю сразу, бот пишет в личку и отдаёт путёвку. Бесплатно
Частые вопросы
Так какая модель всё-таки умнее?
Ответ зависит от колонки. На независимой оснастке ARC Prize лучший результат GPT-6 Astra это 62.7%, и это рекорд теста. На оснастке производителя у неё же 99.9%. Оба числа настоящие, но меряют они разное: первое - работу модели в равных для всех условиях, второе - работу модели вместе со сборкой от её же создателя
Почему 98.6% нельзя просто сравнить с прошлой моделью?
Потому что 7.8% у прошлой модели снято на другой оснастке. Внутри одной оснастки сравнение получается 62.7% против 7.8%, и это по-прежнему огромный скачок. Просто он не выглядит как «человеческий уровень»
Что вообще меряет этот тест?
Не факт победы, а эффективность в незнакомой игре. Модели дают поле и кнопки, не сообщая ни правил, ни условия победы, и считают, за сколько действий она разберётся, по сравнению с человеком. Ста процентов там нет даже у людей в среднем: один уровень упирается в потолок 115%, а за игру нельзя получить максимум, не пройдя все уровни
Можно ли сыграть самому?
Да, и это занимает пару минут. Публичный набор игр открыт на arcprize.org/arc-agi/3 без регистрации: жмёшь Play, попадаешь в игру и разбираешься в правилах сам, как модель
Где смотреть, не устарели ли эти числа?
На общей странице результатов arcprize.org/leaderboard. Она обновляется, и у каждой строки там стоит номер версии теста. Числа этой статьи сняты 13 сентября 2026 года