API нейросетей · честная смета 2026
Как посчитать расход токенов API: 3 приёма и смета в 2026
Расход по счётчику нейросети списывается со счёта после каждого запроса к программному входу, и у большинства новичков нет способа узнать эту цифру заранее - платёж приходит по факту, а не по прогнозу. Я разобрал официальную формулу расчёта, живые цены на 06.09.2026 и бесплатный способ Anthropic узнать точное число заранее, до того как запрос вообще отправлен
К концу статьи будет ясно: что такое кусочек текста, из которого складывается счёт, сколько стоит обработка реального текста на цифрах Claude, как экономить на повторном использовании одного и того же текста без ошибки, которую делает большинство новичков, и как проверить точную смету своего запроса бесплатно. Если вопрос у тебя шире - не «как считается счёт», а «сколько вообще стоит агент или подписка» - это разбирает отдельный гайд про 3 класса цен на ИИ-агента, там же полная таблица официальных тарифов. А если пока непонятно, как вообще устроен доступ к Claude Code и его оплата - весь путь от установки до счёта собран в разделе про Claude Code
Открой раздел «Бесплатный способ узнать точное число» ниже и проверь свой запрос через официальный счётчик до отправки - это не будущий счёт, а точное число прямо сейчас, без единого потраченного цента. Дальше умножь результат на цену модели из таблицы, чтобы получить смету в долларах и рублях
Из чего складывается счёт
Каждый запрос к нейросети режется на маленькие кусочки текста, обычно в несколько символов, и именно эти кусочки видит счётчик - официально их называют словом «токен». Не слово целиком и не отдельная буква, а что-то среднее: иногда часть слова, иногда слово целиком, иногда знак препинания отдельно
Для английского текста официальное правило простое: один кусочек текста примерно равен четырём символам. Для русского текста точной официальной цифры от разработчика нет, но кириллица режется мельче - один и тот же смысл на русском стабильно занимает больше кусочков, чем на английском
Разница считается не только по буквам, но и по деньгам, и здесь начинается формула расхода
Формула расхода: вход и выход считаются раздельно
Официальная формула Anthropic одна: расход равен цене входа, умноженной на число входных кусочков текста, плюс цена выхода, умноженная на число выходных кусочков текста. Вход - это то, что ты отправил (вопрос, файл, история переписки), выход - это то, что нейросеть вернула тебе в ответ
Ключевая деталь, которую пропускают почти всегда: выход у любой модели дороже входа в несколько раз - обычно в 5 раз у Claude. Значит короткий вопрос с длинным ответом стоит заметно дороже, чем длинный вопрос с коротким ответом, при одинаковом общем объёме текста
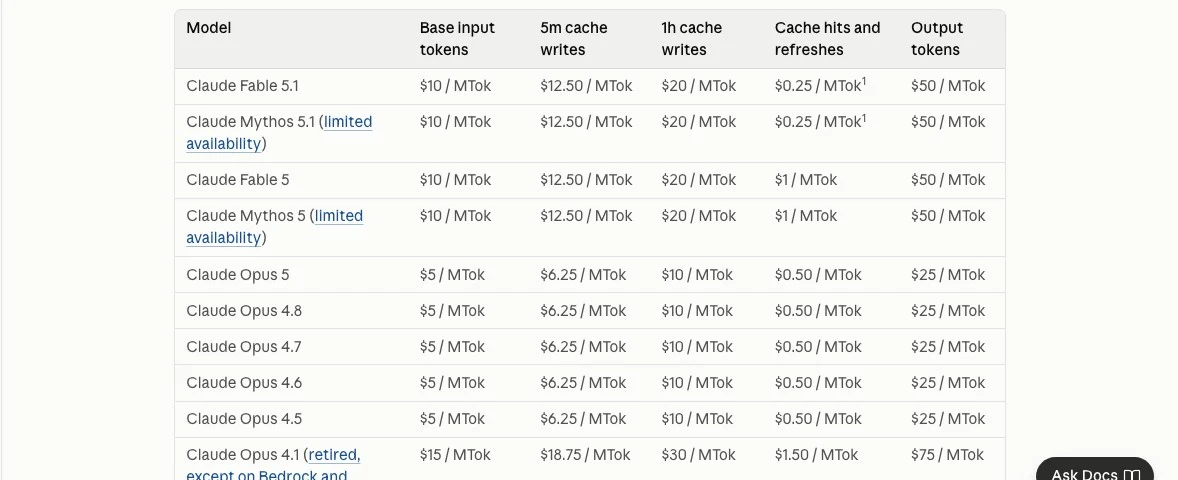
По официальной документации на 06.09.2026 у трёх моделей Claude такие цены за миллион кусочков текста:
| Модель | Вход, за 1 млн кусочков | Выход, за 1 млн кусочков |
|---|---|---|
| Claude Haiku 4.5 (самая быстрая и дешёвая) | 1 $ | 5 $ |
| Claude Sonnet 5 (баланс цены и качества) | 2 $ | 10 $ |
| Claude Opus 5 (самая мощная) | 5 $ | 25 $ |
Таблица прокручивается вбок →
Важная деталь по Sonnet 5: цена 2 доллара за вход и 10 за выход была объявлена как временная скидка при запуске модели, а повышение до 3 и 15 долларов планировалось на 1 сентября 2026 года. Официально это повышение отменено - вводная цена стала постоянной, платить по старым (более низким) цифрам можно и дальше без ограничения по времени
Сохранённый текст экономит деньги только со второго обращения - ошибка, которую делают почти все
Сохранение уже обработанного текста, чтобы не платить за него заново, звучит как способ всегда сэкономить, но официальная механика устроена не так просто, как кажется на первый взгляд
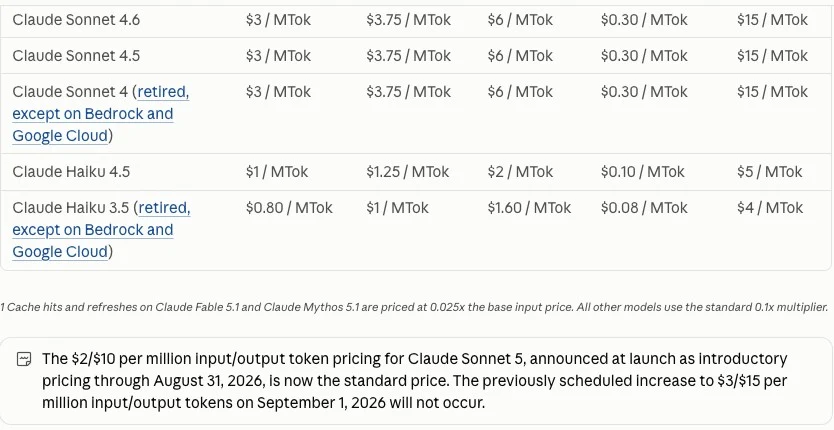
Есть два разных действия с этим сохранением, и они стоят по-разному:
- Первая запись (первое обращение к тексту) стоит ДОРОЖЕ обычного входа - на 25% дороже при коротком пятиминутном сроке хранения, вдвое дороже при часовом
- Повторное чтение (обращение к уже сохранённому тексту) стоит В ДЕСЯТЬ РАЗ ДЕШЕВЛЕ обычного входа - это и есть реальная экономия
Значит такое сохранение выгодно только если один и тот же большой текст (документ, длинная история переписки, инструкция) используется МИНИМУМ дважды в течение того же окна времени. Одноразовый запрос с включённым сохранением не экономит ничего - наоборот, немного переплачивает за саму запись
Ещё одна деталь без исключений: скидка распространяется только на входную часть счёта. На то, что нейросеть тебе отвечает, скидки за повторное использование нет вообще, ни при каких условиях
Бесплатный способ узнать точное число заранее
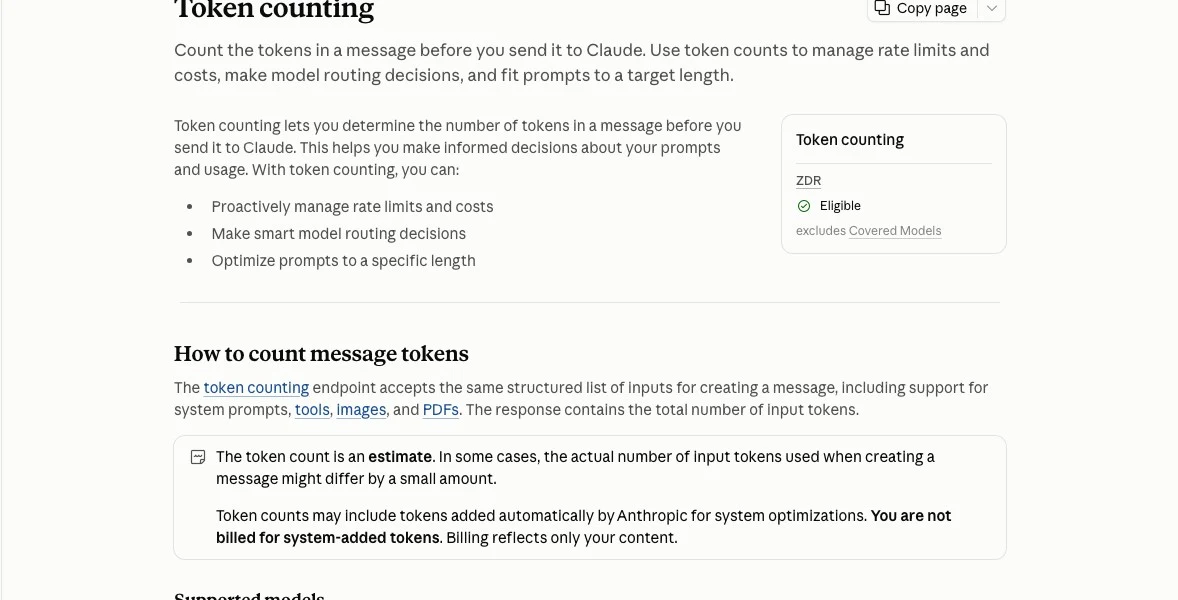
Прямой ответ на вопрос «до того, как придёт счёт»: у Anthropic есть отдельная функция подсчёта (официальное название - Token Counting API), которая считает точное число кусочков в запросе и не берёт за это ни цента
Что это показывает и что это даёт:
- Функция принимает тот же текст, что пошёл бы в обычный запрос - твой вопрос, системную инструкцию, вложенный файл. Что увидишь: в ответ приходит одно число - сколько кусочков текста насчитала нейросеть. Что это даёт: точную цифру ДО того, как деньги списаны, а не после
- Ограничение только по частоте обращений, не по деньгам. У каждого аккаунта есть лимит - сколько раз в минуту можно спросить счётчик, но сам подсчёт бесплатен всегда. Что увидишь: если сильно превысить лимит по частоте, придёт отказ на минуту, но не счёт. Что это даёт: можно проверять сколько угодно текстов подряд без риска случайно потратить деньги
- Результат - оценка, а не абсолютная гарантия. Официально указано, что реальное число при отправке запроса может отличаться на небольшую величину. Что увидишь: цифра близкая к финальному счёту, но не байт в байт. Что это даёт: достаточную точность, чтобы спланировать бюджет заранее, не дожидаясь факта
Ещё одна вещь, которую легко упустить: с моделей поколения Claude Opus 4.7 и новее нейросеть режет тот же самый текст мельче, чем раньше - примерно на 30% больше кусочков на тех же словах. Если переходишь на новую модель, старая смета расхода занижена почти на треть, и стоит пересчитать заново, а не переносить старую цифру
Мой расчёт: сколько стоит обработать текст на реальных цифрах
Чтобы цифры не остались абстрактными, я взял официальную формулу выше и посчитал честную смету на конкретном объёме - без установки чего-либо нового, только арифметика на публично известных ценах
За основу взят живой замер: одна страница русского текста (примерно 1800 знаков) занимает около 800 кусочков текста - такую цифру даёт замер на реальных файлах в соседней заметке про подсчёт токенов, и я использую именно её вместо приблизительной формулы для английского языка, которая для кириллицы систематически занижает результат
| Объём | Кусочков на входе | Кусочков на выходе (краткий ответ) | Итого через Claude Sonnet 5 |
|---|---|---|---|
| 100 страниц русского текста | 80 000 | 16 000 | 0,32 $ (около 28 рублей) |
Таблица прокручивается вбок →
В рублях по курсу ЦБ на 05.09.2026 (86,5857 рубля за доллар) обработка 100 страниц через Sonnet 5 обходится примерно в 28 рублей. На бюджет десять тысяч рублей (около 115 долларов) при том же сценарии хватает примерно 36 тысяч страниц обработки текста - разброс огромный, и это ровно то место, где становится видно, что «дорого» и «дёшево» без точного числа кусочков - просто ощущение, а не смета
Три шага честной сметы перед оплатой
- Прогони свой реальный текст через бесплатный счётчик не выдуманный пример, а именно тот файл или вопрос, который собираешься отправлять каждый день
- Умножь результат на цену модели из таблицы выше отдельно для входа и отдельно для выхода - выход всегда дороже, не забывай его в расчёте
- Переведи в рубли по свежему курсу ЦБ на день оплаты курс меняется каждый день, старая цифра через месяц может ощутимо разойтись с фактом
Почему разные модели стоят по-разному
У Anthropic три семейства моделей на выбор, и разница в цене между ними не случайна - она отражает разницу в объёме вычислений на каждый ответ
Haiku 4.5 - самая быстрая и дешёвая, подходит для простых задач: короткий ответ, классификация, извлечение фактов из текста. Sonnet 5 - золотая середина, справляется с большинством повседневных задач без переплаты. Opus 5 - самая мощная, но и самая дорогая - её смысл в сложных многошаговых рассуждениях, где точность важнее экономии
Разница в цене между Haiku 4.5 и Opus 5 доходит до 5 раз и на входе, и на выходе за один и тот же объём текста - выбор модели по привычке, а не по сложности задачи, самый частый способ переплатить
Как формула расхода выглядит у других поставщиков
Формула «цена входа умножить на объём плюс цена выхода умножить на объём» - не изобретение Anthropic, а общий стандарт индустрии. У других крупных поставщиков нейросетей она устроена так же, просто с другими цифрами
| Поставщик | Вход, за 1 млн кусочков | Выход, за 1 млн кусочков |
|---|---|---|
| Claude Sonnet 5 | 2 $ | 10 $ |
| OpenAI gpt-5.6-terra | 2 $ | 12 $ |
| DeepSeek V4 Pro (обычные часы) | 0,66 $ | 1,98 $ |
| DeepSeek V4 Pro (пиковые ночные часы) | 1,32 $ | 3,96 $ |
Таблица прокручивается вбок →
Модель OpenAI стоит в одной ценовой категории с Claude Sonnet 5 - разница только в цене выхода. DeepSeek заметно дешевле обоих в обычное время, но у него есть деталь, которую легко упустить: в часы пиковой нагрузки цена ровно удваивается. Разбор этого поставщика и рабочие способы оплаты - в отдельном гайде про DeepSeek API
Практический вывод для выбора: если задача не требует именно Claude, честное сравнение идёт через одну и ту же формулу на разных ценах, а не через ощущение «этот сервис дороже»
Мотивация экономить: разброс цены между приёмами
Три приёма выше не равнозначны по силе экономии, и стоит понимать разницу заранее, прежде чем тратить время на настройку каждого
Выбор более дешёвой модели снижает смету сразу в разы - это самый сильный рычаг из всех. Сохранение текста экономит только на повторяющихся крупных кусках и почти не влияет на разовые короткие запросы. Пакетная обработка снижает смету ровно вдвое, но требует, чтобы задача терпела задержку в несколько часов - не любой сценарий это позволяет
Приём 1: включай сохранение текста только там, где оно окупится
Из механики выше следует практический вывод: сохранение текста стоит включать только для того, что отправляешь минимум дважды за короткое время. Системная инструкция, которая повторяется в каждом запросе - хороший кандидат. Разовый вопрос - плохой, там дешевле обойтись без сохранения вообще
Проверка простая: если один и тот же большой кусок текста (документ, длинная инструкция, история переписки) отправляется в нейросеть повторно хотя бы один раз за 5 минут или два раза за час - сохранение окупает и запись, и последующие чтения
Приём 2: держи историю переписки короче, а не длиннее
Каждое новое сообщение в длинном диалоге тащит с собой ВСЮ предыдущую переписку как входную часть счёта - расход растёт с каждым новым сообщением, даже если сам новый вопрос короткий
Практический вывод: если диалог с нейросетью растянулся на десятки сообщений и стал самостоятельным проектом, дешевле начать новый разговор с кратким пересказом сути, чем тащить всю историю дальше. У большинства инструментов есть отдельная команда для сжатия истории без потери смысла - у Claude Code это команда /compact
Приём 3: считай пакетами, если ответ не нужен мгновенно
Отдельный официальный способ снизить смету - пакетная обработка запросов, когда результат не нужен прямо сейчас. Если задача допускает ответ не мгновенно, а в течение нескольких часов (например, обработка большого списка файлов ночью), пакетный режим у Anthropic даёт скидку 50% на вход и на выход одновременно - вдвое ниже обычной цены за тот же объём
Эта скидка складывается с остальными приёмами экономии: пакетная обработка с включённым сохранением текста снижает смету сильнее, чем каждый способ по отдельности
Что ещё почитать про цены нейросетей
- Сколько стоит ИИ-агент в 2026: 3 класса цен и суммы - если вопрос шире, чем расход по счётчику, а про полную цену подписки или готового агента
- Claude Code: доступ, установка, оплата - весь путь от установки до оплаты, если ещё не начал работать с инструментом
- Как оплатить Claude из России в 2026 году - рабочие способы фактически провести платёж, если карта не проходит
- Как оплатить DeepSeek API из России в 2026 году: 3 способа - если считаешь расход не у Claude, а у более дешёвого поставщика
- Как пополнить баланс Claude Console из России: 3 шага в 2026 - если уже выбрал оплату по счётчику и нужно завести деньги на счёт
- Gemini API key из России в 2026: 3 шага без VPN и карты - тот же вопрос доступа у другого поставщика
- Как получить API-ключ Qwen Code в 2026 году: 5 шагов - ещё один вариант получить программный доступ к нейросети
- Как пользоваться Claude Code: установка и 9 шагов до проекта - инструмент, у которого счёт по объёму работы растёт незаметно быстрее всего
- Агенты Claude вышли из терминала: полный разбор для новичка - как выглядит самостоятельная работа, из-за которой и растёт расход
- Claude и PDF: как скормить документы без лишних кусочков текста - отдельный приём экономии на файлах, если работаешь с документами
- Сколько токенов в странице текста и в PDF - подсчёт объёма готового текста, а не сметы расхода API
- 5-часовой лимит ChatGPT Plus вернулся: как проверить квоту - если у тебя готовая подписка, а не оплата по счётчику
- Лимиты Claude Code с 14 сентября: плюс 25% к базе и минус 17% - свежие изменения лимитов у самого частого инструмента
- Как пользоваться Claude 8 часов в день и не упираться в лимиты - что делать, если готовой подписки не хватает по объёму
- GPT-5.6 подешевела на 20%: цены и оплата из России в 2026 году - если сравниваешь расход у конкурирующей модели
- Сколько стоит подписка на нейросеть: 12 ценников в рублях - широкий список тарифов помимо расчёта по счётчику
- Claude бесплатно: все рабочие способы 2026 - если платить за расход пока не готов вообще
- Контекст-инжиниринг: карта из 6 слоёв в Claude Code - как устроен расход контекста внутри самого инструмента
- ChatGPT vs Claude: 4 задачи, цены и проверка из России - прямое сравнение двух главных чатов по цене и задачам
Источники
- Anthropic: официальная цена API по моделям и кешу - Claude Opus 5, Sonnet 5, Haiku 4.5, prompt caching, снято 06.09.2026
- platform.claude.com/docs/en/about-claude/pricing
- Anthropic: Token Counting API - бесплатный подсчёт токенов до отправки запроса, снято 06.09.2026
- platform.claude.com/docs/en/build-with-claude/token-counting
- DeepSeek: официальная цена API - модели V4 Pro и V4 Flash, обычные и пиковые часы, снято 06.09.2026
- api-docs.deepseek.com/quick_start/pricing
- OpenAI: официальная цена API - модель gpt-5.6-terra, снято 06.09.2026
- platform.openai.com/docs/pricing
- Сколько токенов в странице текста и в PDF - живой замер коэффициента для русского текста, использован в расчёте выше
- Курс ЦБ РФ - 86,5857 рубля за доллар на 05.09.2026
Памятка: как посчитать расход при работе с нейросетью
Пять строк, которые закрывают вопрос сметы до счёта
Сохрани себе
- Расход = цена входа × число входных кусочков + цена выхода × число выходных кусочков - считаются раздельно
- Выход дороже входа в 5 раз у большинства моделей Claude - не забывай его в прикидке
- Повторное использование текста экономит только со второго обращения, первая запись дороже обычного входа
- Бесплатный официальный счётчик даёт точное число ДО отправки запроса, без единого потраченного цента
- Модели поколения 4.7 и новее режут тот же текст примерно на 30% мельче - старую смету нужно пересчитать
Порог входа
Формула разобрана бесплатно, следующий шаг - тоже
Всё, что нужно для честной сметы расхода - формула расчёта, официальные цены и бесплатный счётчик до отправки - ты только что прочитал бесплатно. Следующий шаг - собрать вокруг этой цифры рабочий порядок за три дня Лагеря - тоже стоит ровно ноль
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Что такое токен в API нейросети?
Небольшой кусочек текста, обычно в несколько символов, на которые модель делит и вопрос, и ответ. Не слово и не буква, а промежуточная единица: примерно четыре символа на английском, для русского текста кусочков на тот же смысл выходит заметно больше
Как посчитать стоимость запроса заранее?
Через бесплатную официальную функцию подсчёта - она принимает тот же текст, что пошёл бы в обычный запрос, и возвращает точное число кусочков без списания денег. Дальше это число умножается на цену модели за вход и отдельно на ожидаемый объём ответа по цене выхода
Почему выход стоит дороже входа?
Потому что генерация нового текста требует от модели больше вычислений, чем чтение уже готового. У большинства моделей Claude выход дороже входа ровно в 5 раз - эта пропорция заложена в саму цену, а не случайное совпадение у конкретной модели
Повторное сохранение текста правда экономит деньги?
Да, но только при повторном использовании одного и того же текста. Первая запись стоит дороже обычного входа, а не дешевле. Экономия появляется только со второго обращения к тому же тексту - тогда чтение стоит в 10 раз дешевле обычной цены входа
Сколько стоит обработать сто страниц текста нейросетью?
При среднем русском тексте (около 800 кусочков на страницу) и модели Claude Sonnet 5 - около 28 рублей по курсу ЦБ на начало сентября 2026 года, если считать краткий ответ на выходе. Итоговая цена зависит от модели, объёма ответа и того, включено ли повторное использование