Тексты · разбор исследования StoryScope · сентябрь 2026
Почерк ИИ в тексте: 4 правки, после которых он не читается
Слова править бесполезно. Исследователи специально переписали тексты, убрав стилевые приметы, и детектор всё равно узнал машину: точность упала с 93.2 до 93.9 процента, то есть не упала вовсе. Почерк сидит не в оборотах, а в том, как собрана сама история, и чинится он четырьмя правками конструкции
Ниже разбор работы, где 61 608 историй разложили на 304 признака, и главное - что из этого делать со своим текстом сегодня. У тебя будет проверка, которую можно запустить прямо на своём файле
Первая правка занимает минуту, поэтому начни с неё, не дочитывая. Открой свой текст и поищи предложения вроде «и в этом была главная мысль», «именно тогда он понял», «это научило её». Вычеркни их целиком, ничего не дописывая взамен. Дальше объясню, почему это самая дорогая фраза в тексте
Перестань править слова и открой конструкцию текста. Проверь у себя четыре вещи: проговариваешь ли ты мысль прямо, есть ли побочная линия, идёт ли время строго по порядку и сомневается ли герой в своём выборе. Начни с первой: найди в тексте предложения вида «и в этом была главная мысль» и вычеркни их целиком
Что именно измеряли
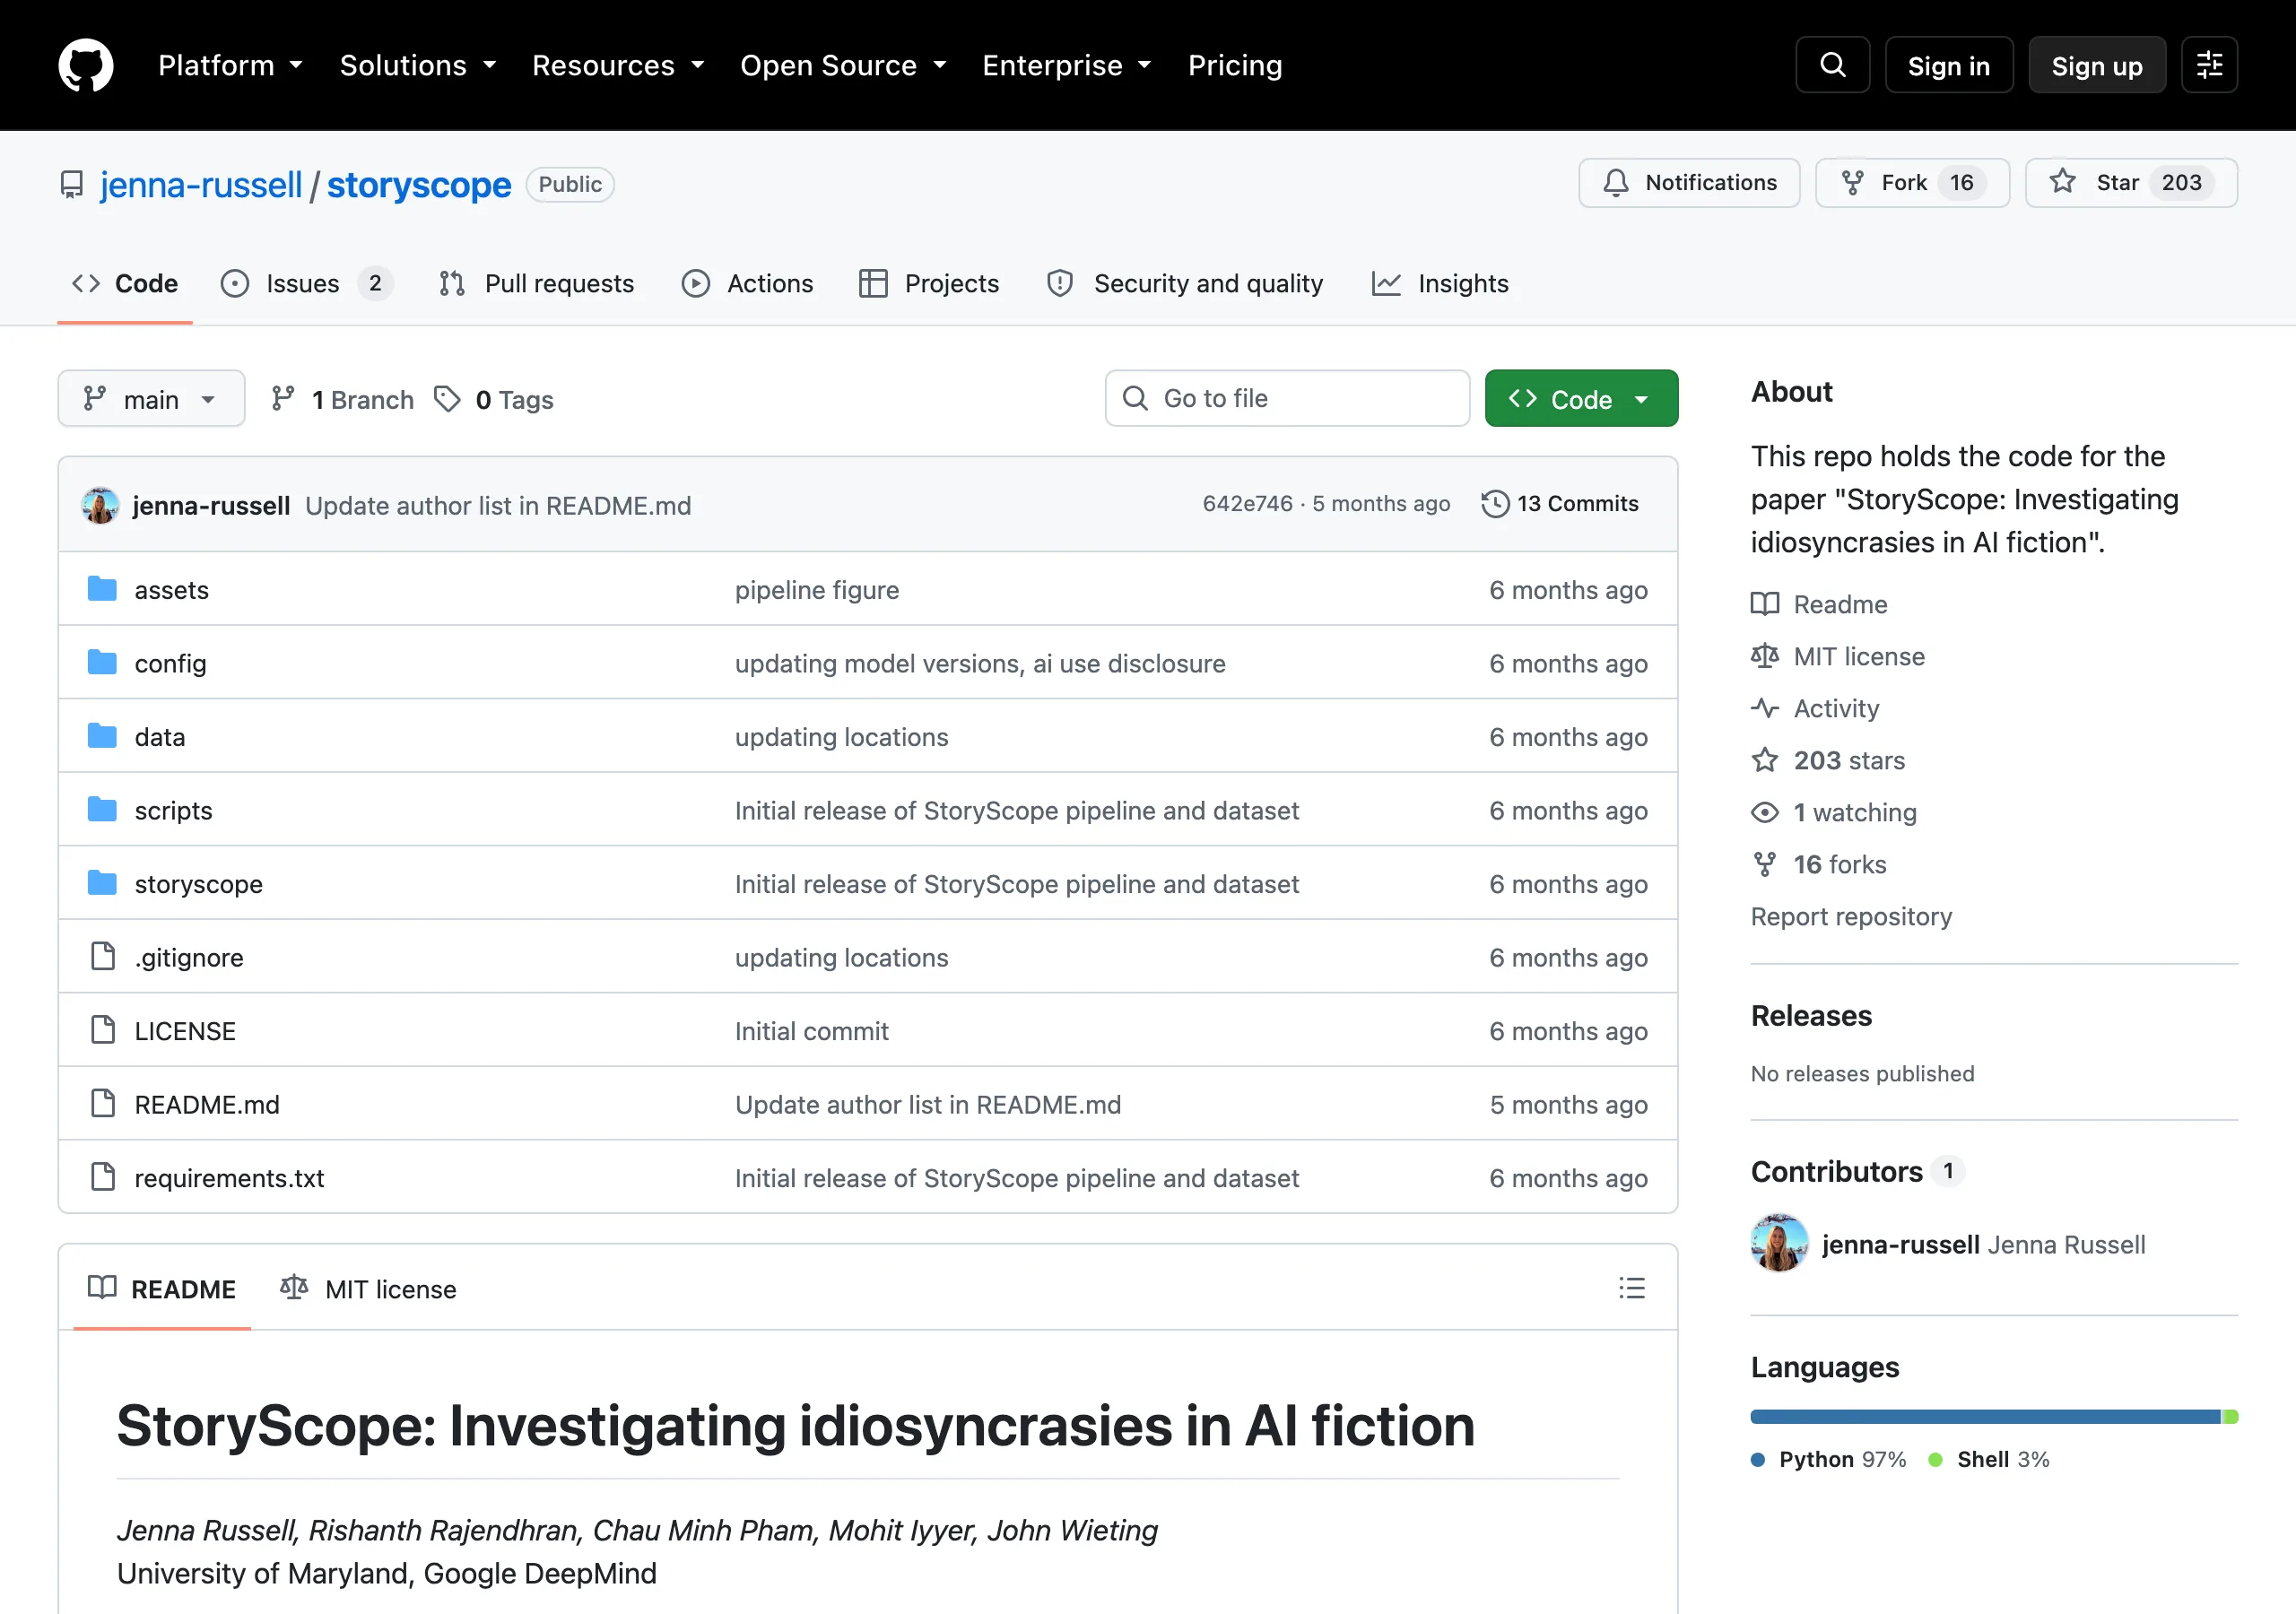
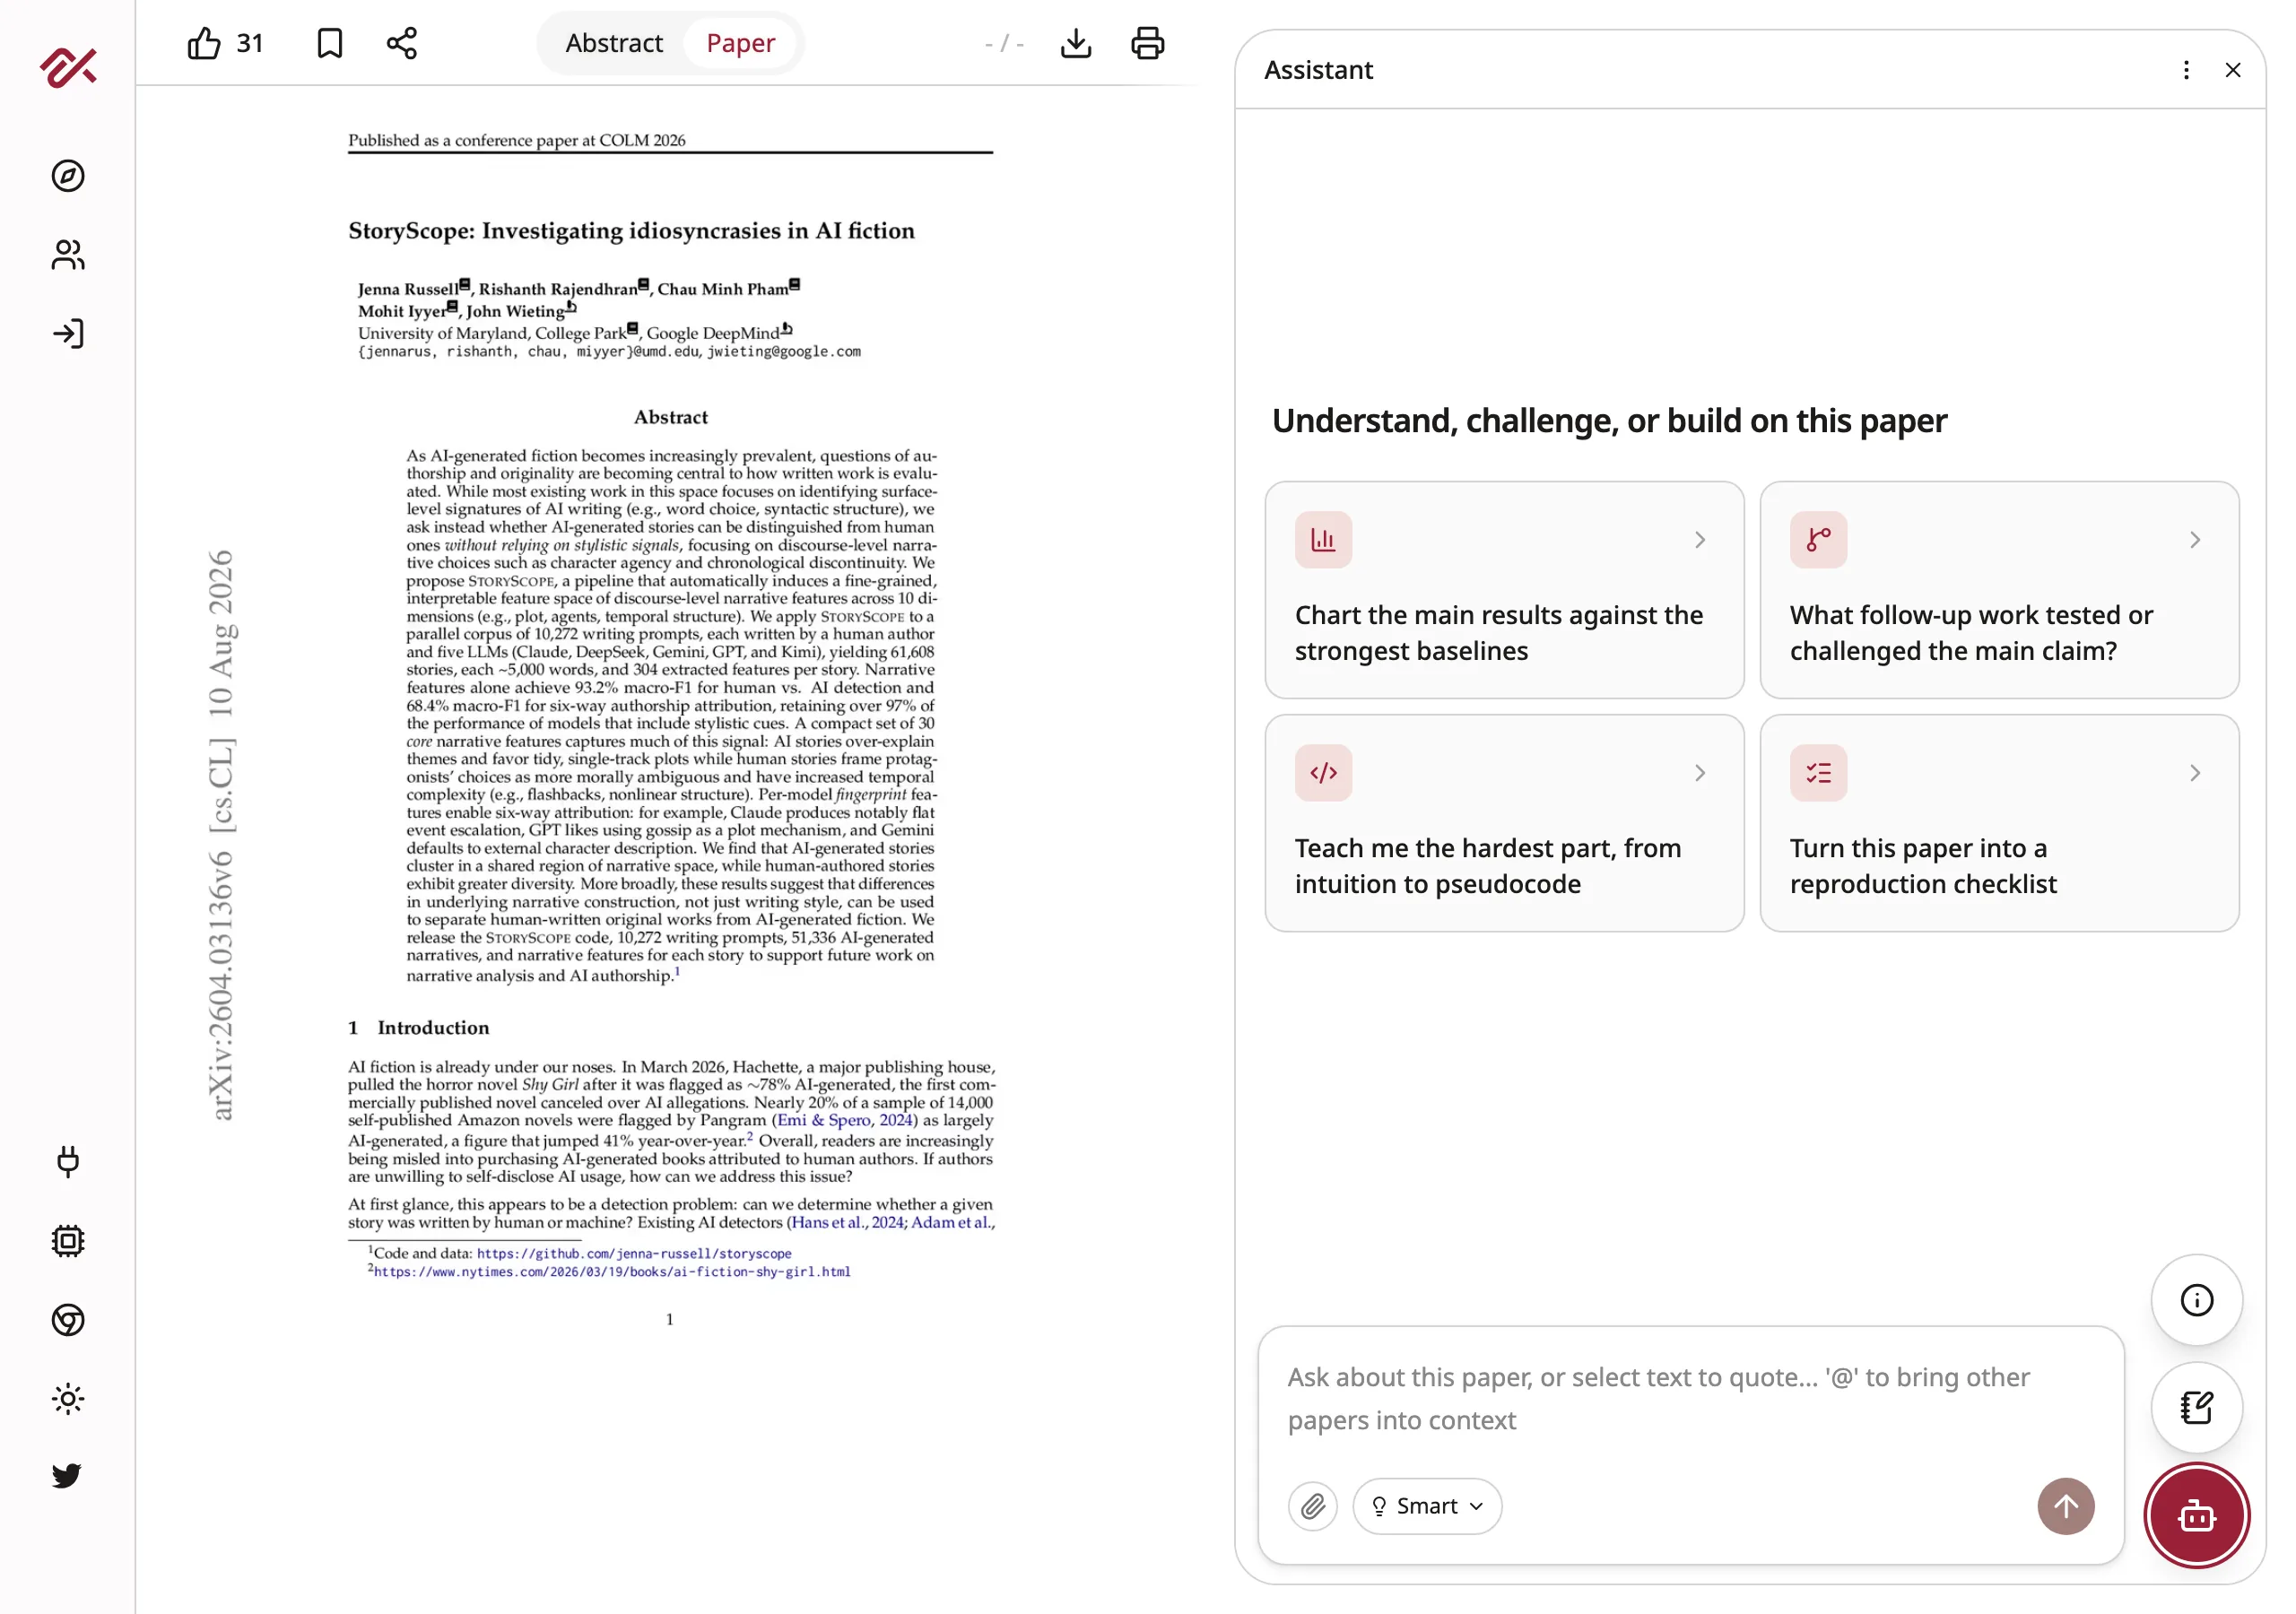
Работа называется StoryScope, её сделали в Университете Мэриленда вместе с Google DeepMind и представили на конференции COLM 2026. Идея простая до наглости: взяли 10 272 задания и по каждому попросили написать рассказ человека и пять разных нейросетей. Получилось 61 608 текстов примерно по пять тысяч слов, и каждый разобрали на 304 признака
Важно, что искали. Не любимые слова и не длину предложений, а вещи уровня устройства истории: кто принимает решения, в каком порядке идут события, есть ли линия помимо главной
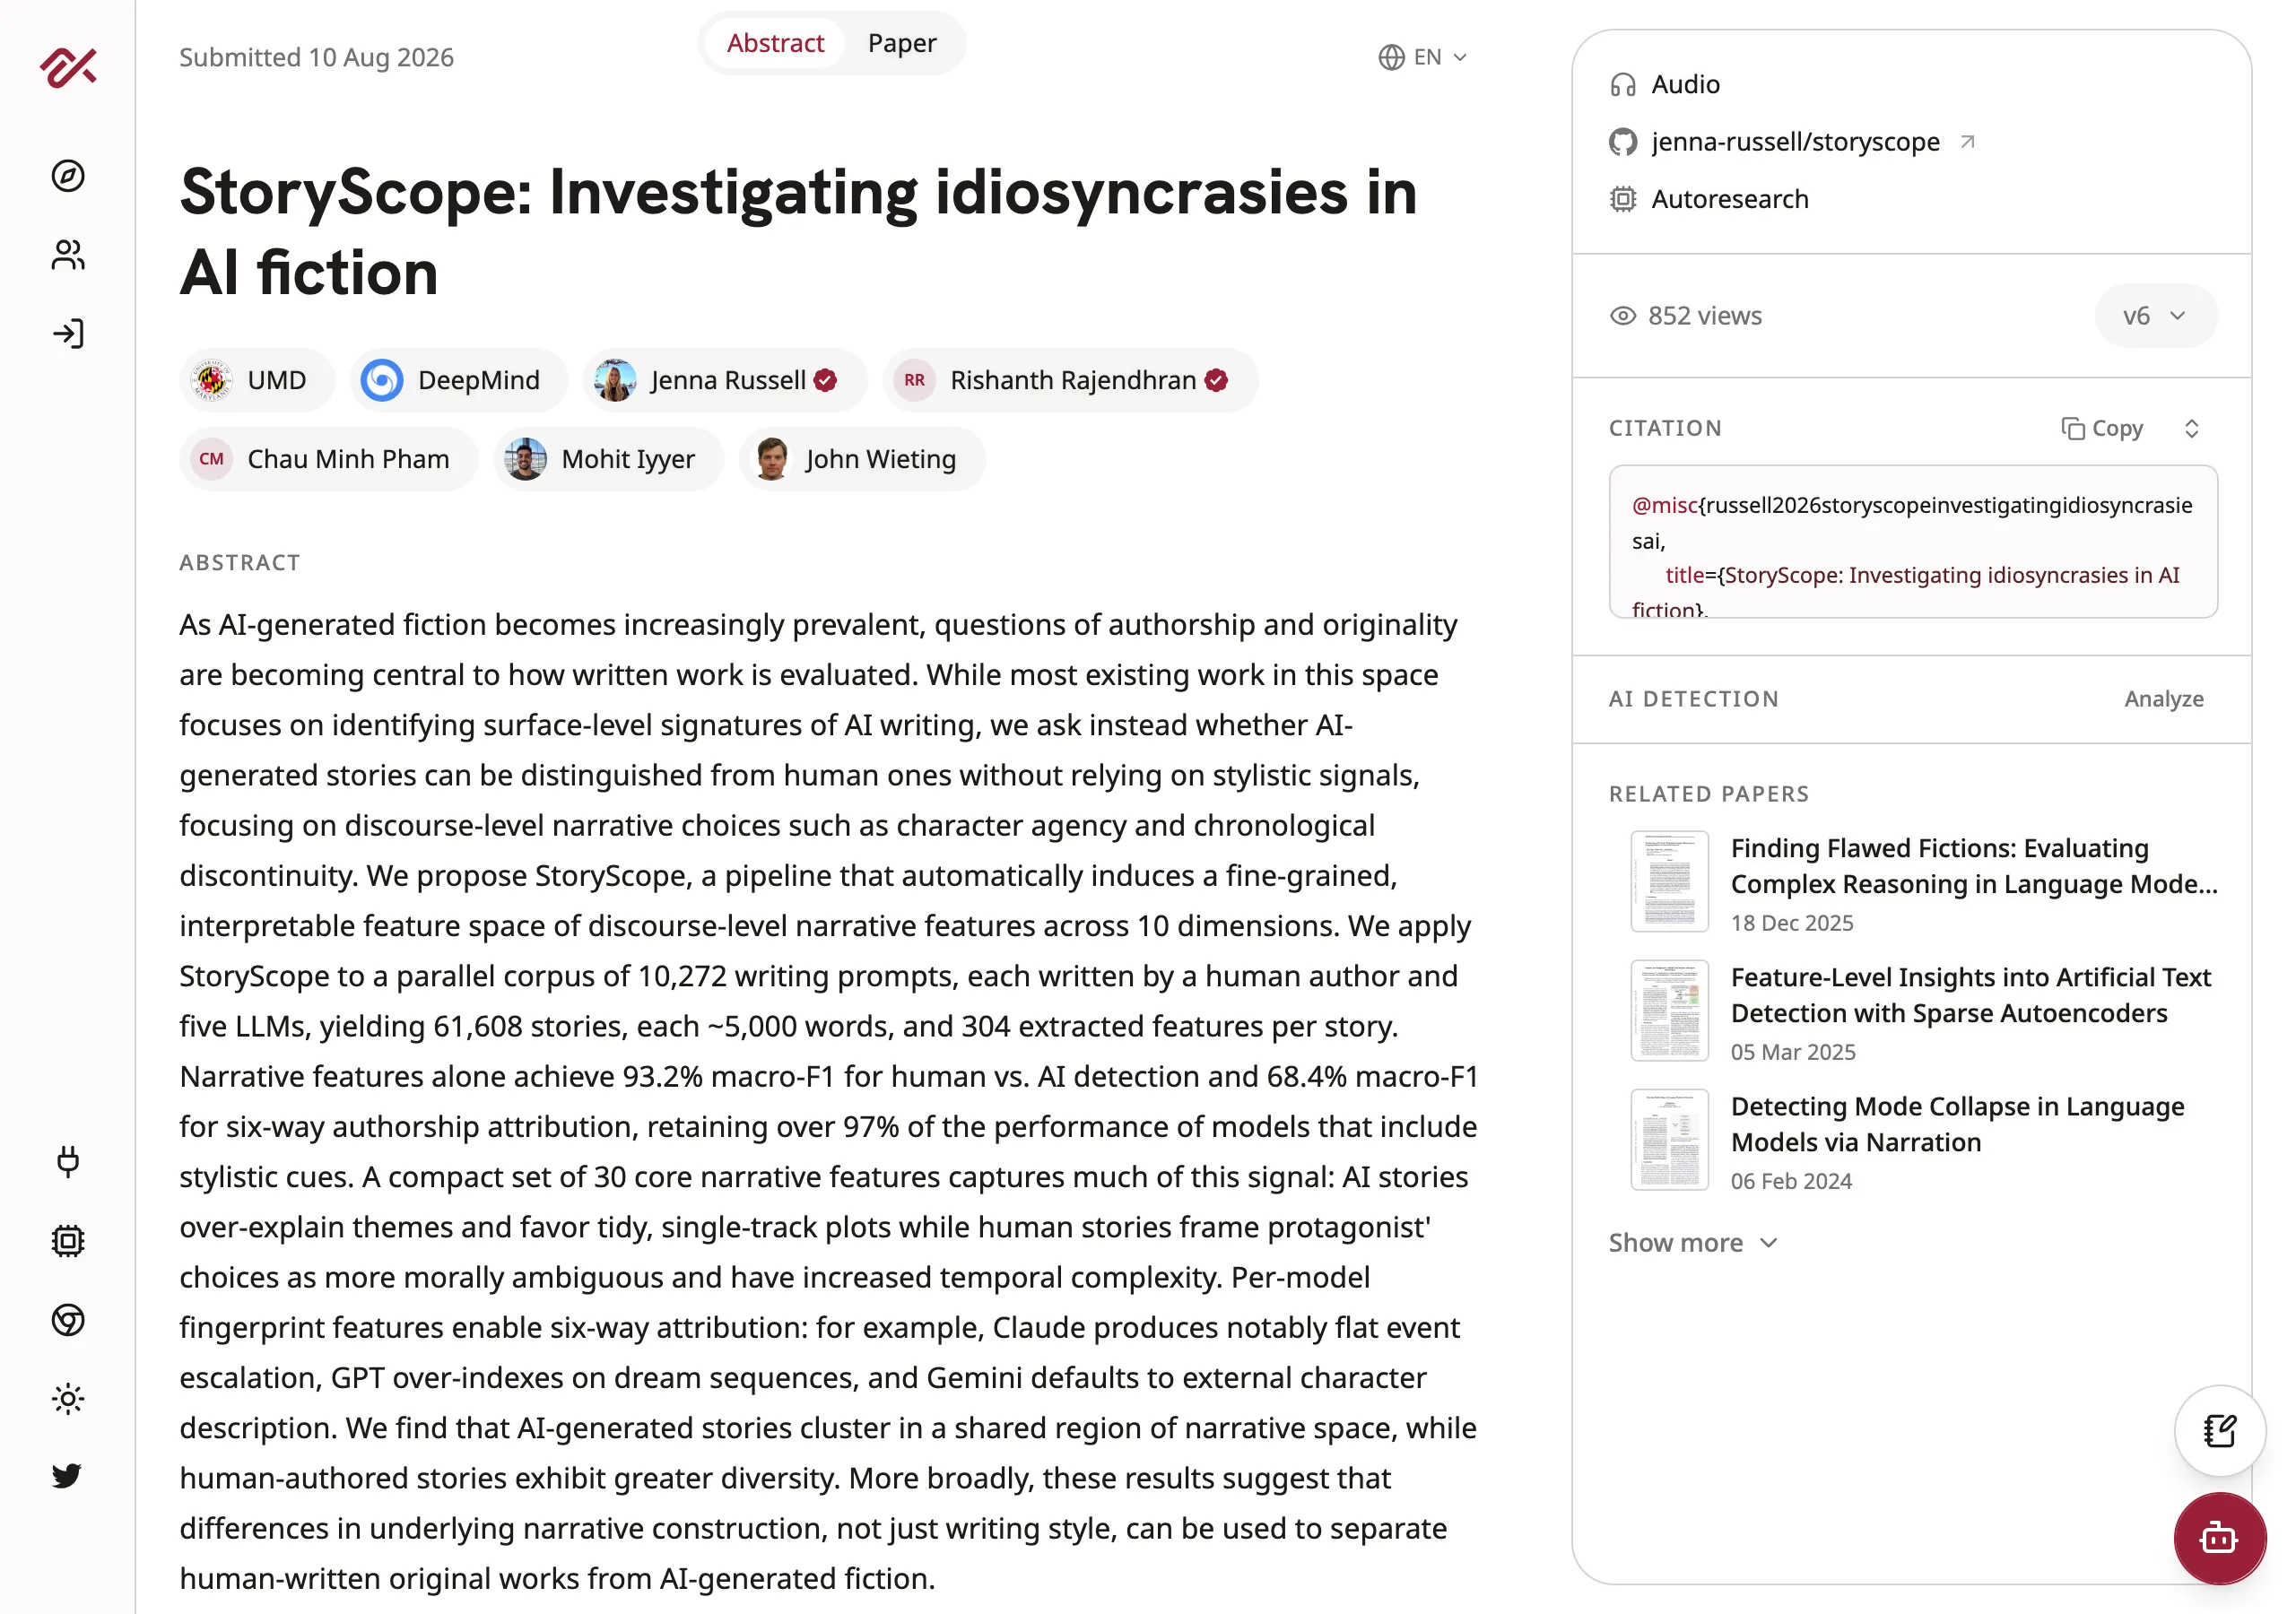
По этим признакам машину от человека отличают с точностью 93.2 процента. А конкретную модель из пяти угадывают в 68.4 процента случаев, то есть у каждой нейросети ещё и свой личный почерк поверх общего
Почему правка слов не работает
Тут самое интересное, и это то, ради чего стоит читать дальше. Авторы прогнали тексты через переписывание: убрали стилевые приметы, поменяли обороты, сгладили любимые словечки моделей. Ровно то, что делает человек, когда «причёсывает» текст после нейросети
Детектор после этого дал 93.9 процента. Он не просто устоял, он показал практически то же число
Вывод звучит неприятно, но экономит месяцы: список запрещённых слов не решает задачу. Можно вычистить все «неотъемлемые части» и «в современном мире», и текст всё равно будет опознан, потому что опознаётся не лексика. Я разбирал списки слов в проверке текста на ИИ, и они полезны, но это косметика поверх конструкции
Семь признаков, по которым расходятся машина и человек
Вот часть тех самых признаков, парами. Слева доля историй, где признак встретился у нейросетей, справа у людей. Все числа из работы
| Признак | У нейросетей | У людей |
|---|---|---|
| рассказчик прямо называет мысль текста | 77% | 52% |
| диалог превращается в спор о смысле жизни | 59% | 34% |
| герой решает проблему в лоб | 69% | 46% |
| побочной линии нет вовсе | 79% | 57% |
| образы через запах | 82% | 57% |
| чувства показаны через тело | 81% | 38% |
| отсылки к другим книгам и фильмам | 24% | 47% |
Таблица прокручивается вбок →
Обрати внимание на последнюю строку: она перевёрнута. Тут больше у людей, и это важно для понимания. Речь не про «у машины всего много», а про разный набор привычек
И ещё одна деталь, которая многих успокаивает: у людей эти признаки тоже есть. Человек проговаривает мысль в 52 процентах случаев, то есть в половине текстов. Разница не в том, что у человека признака нет, а в том, насколько он частый
Шаг 1. Вычеркни предложения, которые объясняют смысл
Это первая правка, ты её уже сделал, если начал сразу. Теперь объясню механику
Нейросеть пишет историю и в конце добавляет фразу, которая называет вывод: «и в этом была главная мысль», «так он понял, что дружба важнее денег». Модель делает это, потому что обучена быть полезной: она боится, что читатель не поймёт, и подстраховывается
Человек так делает вдвое реже. Не потому что умнее, а потому что доверяет читателю и часто просто не знает сам, какая там мысль. Тем же грешат и готовые промпты «сделай текст живым»: они правят слова, а не эту привычку, я показывал их разбор в подборке про очеловечивание текста
Что увидишь: после вычёркивания текст кажется незаконченным. Это нормальное ощущение и ровно то, что нужно. Смысл никуда не делся, он остался в событиях
Признак успеха: в тексте не осталось ни одной фразы, которая называет мысль вместо того, чтобы её показать
Шаг 2. Заведи вторую линию
У нейросетей побочной линии нет вовсе в 79 процентах историй, у людей в 57. Машина ведёт одну прямую: герой хочет, герой преодолевает, герой получает
Не рассказ, а пост, письмо или разбор? Второй линией тут работает не сюжет, а второй угол на ту же тему: побочный случай, который не подтверждает твою мысль, а осложняет её. В посте это абзац «а вот тут так не сработало», в письме - оговорка про клиента, у которого вышло иначе
Что делать руками: возьми любой абзац в середине и вставь рядом кусок про то, что происходило в это же время где-то ещё. Необязательно связывать его с главным сюжетом сразу, а иногда и вообще не надо связывать. Если текст пишется через модель, вторую линию проще заказать отдельным запросом, чем вычитывать готовое, про сами запросы есть разбор написания текста нейросетью
Что увидишь: текст станет менее «гладким». Появится ощущение, что мир больше, чем эта история
Признак успеха: в тексте есть хотя бы один абзац, где происходит что-то параллельное главному
Шаг 3. Сломай порядок времени
Работа прямо говорит: у людей больше временной сложности, у машины плотная причинная цепочка. Событие, следствие, следующее событие, и всё строго по порядку
Не рассказ, а пост или письмо? Шаг делается короче: начни не с начала истории, а с её середины или с результата, а как ты к нему шёл, расскажи следом. «Три месяца назад я советовал обратное» в начале абзаца это уже слом порядка. В пошаговой инструкции шаг пропускается целиком: там порядок и должен быть прямым, иначе человек не соберёт
Что делать руками: перенеси одну сцену из середины в начало, а на её место поставь воспоминание. Или просто начни абзац словами «за семь лет до этого»
Что увидишь: читателю придётся собирать порядок самому. Это работа для него, и она держит внимание лучше ровной ленты
Признак успеха: читатель хотя бы раз попадает в прошлое и возвращается обратно
Шаг 4. Оставь выбор спорным
Самая сложная правка и самая заметная. У машины герой решает проблему напрямую в 69 процентах против 46 у людей, и решение почти всегда правильное
Что делать руками: добавь цену. Герой получил своё, но что-то потерял, и непонятно, стоило ли. Не пиши, стоило или нет: в этом вся суть
Что увидишь: текст перестанет утешать. Многим авторам тут страшно, потому что «а вдруг подумают, что я оправдываю плохое». Именно этот страх и делает тексты машинными
Признак успеха: после текста непонятно, был ли герой прав, и это ощущение намеренное
Проверь свой текст: готовая проверка
Проверить можно двумя путями, и первый вообще без программ
Путь 1, руками, три минуты. Открой свой текст и включи поиск по странице (Ctrl+F на Windows, Cmd+F на Маке). Ищи по очереди четыре набора и считай, сколько раз нашлось:
| Ось | Что искать поиском | Как читать результат |
|---|---|---|
| тема названа прямо | «и в этом», «он понял, что», «это научило», «главный урок» | нашлось 2 и больше - ты в облаке ИИ |
| побочная линия | «тем временем», «а в это время», «параллельно» | не нашлось ни разу - ты в облаке ИИ |
| скачки во времени | «вспомнил», «за» + число + «лет до», «когда-то», «позже» | не нашлось ни разу - ты в облаке ИИ |
| спорный выбор | «не уверен», «сомневался», «жалел», «цена этого решения» | не нашлось ни разу - ты в облаке ИИ |
Таблица прокручивается вбок →
Сложи, по скольким осям попал. Четыре из четырёх - текст собран ровно так, как собирает машина
Путь 2, скриптом, если дружишь с командной строкой. Тот же счёт, но автоматом. Создай файл proverka.py и вставь в него это:
import re, sys

OSI = {
 "тема названа прямо": [r"\bи в этом", r"\bпон(ял|яла|яли), что", r"\bэто научило",
                        r"\bглавный урок", r"\bмораль (этой |)истории", r"\bсмысл был в том"],
 "побочная линия":     [r"\bтем временем", r"\bа в это время", r"\bпараллельно",
                        r"\bсовсем в другом месте"],
 "скачки во времени":  [r"\bвспомнил", r"\bза \w+ (лет|года|год) до\b", r"\bкогда-то",
                        r"\bмного лет спустя", r"\bгодом раньше"],
 "спорный выбор":      [r"\bне уверен", r"\bсомнева(лся|лась)", r"\bжалел",
                        r"\bцена (этого|такого) решения", r"\bмог(ла|) поступить иначе"],
}

text = open(sys.argv[1], encoding="utf-8").read()
v_oblake = 0
for name, patterns in OSI.items():
    n = sum(len(re.findall(p, text, re.I)) for p in patterns)
    if name == "тема названа прямо":
        plohо = n >= 2
    else:
        plohо = (n == 0)
    print(f"{name:22} : {n} мест   {'<- в облаке ИИ' if plohо else ''}")
    v_oblake += 1 if plohо else 0
print(f"\nосей в облаке ИИ = {v_oblake} из 4")
Сохрани свой текст рядом файлом moy-tekst.txt и запусти в том же окне команд:
python3 proverka.py moy-tekst.txtЕсли команда отвечает «python3 не найден», значит Python не стоит, и это нормально: путь 1 даёт тот же ответ руками
Что увидишь: четыре строки с числами и итог вида «осей в облаке ИИ = N из 4»
Я прогнал его на двух текстах примерно одной длины. Первый попросил написать нейросеть, второй написал сам, специально применив все четыре правки
Мой прогон 14 сентября 2026: текст нейросети, 149 слов, дал «осей в облаке ИИ = 4 из 4» (тема проговорена прямо 3 раза, побочной линии нет, время линейное, выбор без сомнений). Мой текст, 144 слова, дал «осей в облаке ИИ = 0 из 4» (тема 0 раз, побочная линия 1, скачок во времени 1, неоднозначность выбора 1). Логи обоих прогонов лежат рядом со статьёй
Вот оба вывода рядом, дословно как их напечатала проверка:
1. тема названа прямо : 3 мест
2. побочная линия : 0 мест
3. скачки во времени : 0 мест
4. неоднозначность выбора : 0 мест
осей в облаке ИИ = 4 из 4
$ python3 proverka.py primer-chelovek.txt
1. тема названа прямо : 0 мест
2. побочная линия : 1 мест
3. скачки во времени : 1 мест
4. неоднозначность выбора : 1 мест
осей в облаке ИИ = 0 из 4
Разница в один-два признака на абзац, а ощущение от текста меняется полностью. Это и есть ответ на вопрос, почему правка слов не помогает: ты чинишь не тот слой
Точность 93.2 процента по нарративным признакам и 93.9 после стилевой правки я сверил по абстракту на странице работы, а состав авторов и институции - по README их же репозитория с кодом
У каждой модели свой почерк поверх общего
Работа угадывает конкретную модель в 68.4 процента случаев, и вот по каким приметам
| Модель | Её личная привычка |
|---|---|
| Claude | ровное нарастание событий без резких скачков, любит эпилоги |
| GPT | двигает сюжет слухами и разговорами, много героев сразу |
| Gemini | мрачнее обстановка и самые аккуратно закрытые концовки |
| DeepSeek | вываливает важный контекст очень рано |
| Kimi | почти без примет, самый усреднённый |
Таблица прокручивается вбок →
Практический смысл: если ты пишешь через одну модель постоянно, её личная привычка накладывается на твои тексты поверх общей машинности. Смена модели между черновиками ломает эту вторую примету, хотя первую не трогает. Как устроены сами запросы к модели, я разбирал в гайде по промптам для Claude
Где это ломается на практике
Три вещи, о которых стоит знать до того, как начнёшь чинить свои тексты
Первое: работа измеряла ХУДОЖЕСТВЕННЫЕ тексты, рассказы. Для поста в блог и рабочего письма признаки переносятся частично: побочная линия в инструкции по установке программы будет мешать, а не помогать. Бери оттуда то, что подходит жанру, а не всё подряд, и сверяйся с тем, как устроена статья, написанная с ИИ
Второе: детекторы, которыми пользуются проверяющие, устроены иначе. Они смотрят на предсказуемость слов и часто ошибаются на живых людях. Эта статья не про то, как обмануть детектор, а про то, как перестать писать машинно
Третье: 52 процента людей тоже проговаривают мысль прямо. Если твой текст попал в облако по одной оси из четырёх, это ещё ничего не значит. Тревожиться стоит, когда все четыре
Памятка: четыре оси одной таблицей
| Ось | Что проверить | Как починить |
|---|---|---|
| Смысл назван вслух | есть ли фразы «и в этом была мысль» | вычеркнуть целиком, не заменяя |
| Одна линия | всё ли крутится вокруг главного героя | вставить абзац про параллельное событие |
| Линейное время | идут ли события строго по порядку | перенести сцену, добавить воспоминание |
| Однозначный выбор | понятно ли, что герой прав | добавить цену решения, не оценивать её |
Таблица прокручивается вбок →
Источники
Все числа сняты мной с первоисточника 14 сентября 2026, прогоны лежат рядом со статьёй
- StoryScope на arXiv - сама работа, абстракт со всеми числами
- Та же работа на alphaXiv - страница с составом авторов и институций, мой кадр снят отсюда
- Код StoryScope на GitHub - репозиторий авторов
- Разбор в Tech Times - независимое изложение про устойчивость к правке стиля
- Заметка AI Weekly - про долю 77 процентов
- Документация Anthropic по промптам - как формулировать задачу модели, если пишешь через неё
Памятка: что проверить перед тем, как отдавать текст
Шесть строк, на которых чаще всего остаётся машинный след
Сохрани себе
- в тексте нет ни одного предложения, объясняющего его же смысл
- есть хотя бы одна линия помимо главной
- время хотя бы раз ломается: воспоминание, скачок, «за семь лет до этого»
- у выбора героя названа цена, и оценка этой цены читателю не выдана
- диалоги двигают события, а не обсуждают мораль происходящего
- проверка запущена на своём файле, и число осей в облаке записано до правок и после
Куда это ведёт
Это работает не только на рассказах
Тот же слой конструкции решает в посте, в письме и в сценарии ролика: там тоже видно, проговариваешь ли ты вывод за читателя и оставляешь ли ему работу. Меняется жанр, механика остаётся
Я собираю такие тексты каждый день и на Лагере показываю это на живых материалах участников: берём твой текст, разбираем конструкцию, переписываем и сравниваем, что изменилось
Кнопка ведёт в мой закрытый канал. Жмёшь «Подать заявку», впускаю сразу, бот пишет в личку и отдаёт путёвку. Бесплатно
Частые вопросы
Правда ли, что переписывание слов совсем не помогает?
Против проверки по конструкции почти не помогает: в работе после стилевой правки точность осталась 93.9 процента вместо 93.2. Против простых детекторов, которые смотрят на предсказуемость слов, правка лексики даёт эффект. Это разные проверки, и путать их дорого
Мой текст получил 4 из 4, он точно машинный?
Нет, и такой вывод делать нельзя. Скрипт показывает, что текст собран так же, как обычно собирает нейросеть. Человек, который пишет ровно и любит объяснять вывод, получит те же 4 из 4 честно
Почему у людей те же признаки, просто реже?
Потому что это не машинные приметы, а привычки письма. Проговаривать мысль в конце учат в школе, поэтому так пишет половина людей. Модель просто делает это чаще, потому что обучена быть предельно понятной
Работают ли эти правки для деловых текстов?
Частично. Первая и четвёртая работают везде: не объяснять свой же смысл и называть цену решения полезно и в письме. Вторая и третья заточены под историю, в инструкции они будут мешать
Где взять сам скрипт проверки?
Он целиком напечатан выше, в разделе «Проверь свой текст»: скопируй блок кода в файл proverka.py и запусти. Ставить ничего не надо, кроме самого Python. Если его нет, там же лежит путь 1 - тот же счёт обычным поиском по тексту, без единой программы
Читать дальше
Я соло-предприниматель на Claude, Claude Code и агентах
Всё, что не влезает в статью, лежит у меня в канале: разборы исследований до того, как их перескажут, и внутрянка моих вайб-маркетинговых проектов - что я запускаю, что из этого не работает и почему
Открытый канал, подписка в одно нажатие