Гайд · тексты · август 2026
Как написать статью с помощью ИИ: от идеи до Дзена за вечер
Одно сообщение даёт текст, который читается ровно и при этом не проходит ни на одну площадку. К концу этой страницы у тебя будет одна опубликованная в Дзене статья и папка с файлом фактов, которую можно переиспользовать на следующей теме. Дзен выбран как единственная площадка этого пути - она открывается без аккаунта разработчика и без запрета на тексты от нейросети, в отличие от Хабра. Команды и цифры - с реальных прогонов 14 августа
ИИ пишет статью по частям для Дзена: каркас из поисковых заголовков, файл фактов, разделы по 150-400 слов через помощника, потом вычитка. Сырой прогон на 667 слов дал 21 длинное тире и 14 чисел без источника - за это площадки ограничивают показ
Зачем этот путь целиком
Одна статья против потока однотипных страниц
Как поставить выпуск на поток без риска нарваться на правила, показываем отдельно
Почему статью от ИИ не дочитывают и не пускают в топ
Сырой текст от модели проваливается по двум независимым причинам: Хабр видит в нём нарушение правил прямым пунктом, а читатель не находит ни одного факта, которого нет без этой статьи. Лечатся они по-разному
С площадками всё написано буквально. Правила Хабра:
«Не следует размещать тексты: частично или полностью сгенерированные нейросетями или написанные и отредактированные при помощи нейросетей;»
Правила сайта Хабр, раздел о том, что не следует размещать (habr.com)
Слово «отредактированные» тут ключевое: под запрет попадает и генерация, и правка моделью, исключение - только обложка и мелкий фрагмент внутри крупной технической статьи
Поисковики формулируют мягче. Google в правилах против спама:
«Scaled content abuse is when many pages are generated for the primary purpose of manipulating search rankings and not helping users»
Google Search Central, spam policies (developers.google.com)
Много страниц ради манипуляции выдачей - вот что под ударом, не сам факт генерации. Яндекс в советах вебмастеру формулирует короче, про то же: в списке нарушений стоят «Сайты с автоматически сгенерированным и бесполезным для пользователя контентом»
| Где публикуешь | Что запрещено дословно | Что это значит на практике |
|---|---|---|
| Хабр | тексты, «написанные и отредактированные при помощи нейросетей» | нельзя даже вычитывать моделью |
| «generate many pages without adding value for users» | поток однотипных страниц нет | |
| Яндекс | «Сайты с автоматически сгенерированным и бесполезным для пользователя контентом» | наказывает связка «автомат плюс бесполезно» |
| Дзен | пункта про ИИ в правилах нет на 14.08.2026 | ограничивают через неоригинальность |
| vc.ru | пункта про ИИ в правилах нет на 14.08.2026 | ограничивают через запрет копий |
Таблица прокручивается вбок →
Вторая причина видна на замере: попросил модель написать статью на 700 слов про выбор ноутбука и прогнал через свой чекер машинного почерка
Прогнал этот текст 14 августа 2026 года. На сыром варианте (667 слов, 73 предложения) чекер почти не нашёл стилевых оборотов-паразитов - всего 2 штуки, 3.00 на тысячу слов при пороге 8.0, то есть по этому счётчику текст выглядит чистым. А вот длинных и коротких тире в нём 21 штука на 667 слов - и это уже жёсткое замечание. На вычитанной версии той же статьи, в 4093 слова, тот же чекер не нашёл ни одного тире
Сырой текст ломается в другом месте, чем его чинят. Люди правят «стиль», а проваливает статью один символ и отсутствие проверяемых фактов. Оба дефекта закрываются по шагам ниже
Порядок шагов дальше сквозной и совпадает с памяткой в конце: Шаг 0 - помощник и папка, Шаг 1 - площадка, Шаг 2 - каркас, Шаг 3 - файл фактов, Шаг 4 - разделы, Шаг 5 - машинный след, Шаг 6 - первый экран, Шаг 7 - публикация, дальше первые сутки
Шаг 0. Поставить помощника и завести папку под статью
До первого сообщения нужны две вещи: помощник, которому можно писать обычными словами, и отдельная папка под черновик и файл фактов. Первое ставится один раз, второе занимает минуту и переиспользуется на каждой следующей статье
Шаг 0. Помощник и папка под черновик
- Поставь Claude Code по отдельному пошаговому гайду установки после установки на компьютере появится окно, куда можно писать словами - как в мессенджере: пишешь фразу и жмёшь Enter. Без него вставлять сообщения дальше будет некуда
- Создай новую папку и назови её как удобно, например «Моя статья» увидишь пустую папку в списке файлов - сюда лягут черновик, файл фактов и готовые разделы, и они не потеряются среди остальных документов
- Открой эту папку внутри Claude Code через верхнее меню «File» → «Open Folder» слева появится список файлов именно этой папки - с этой минуты помощник читает и создаёт файлы только внутри неё, а не где попало
гайд установки - пошаговая инструкция для новичка
Файл фактов заводится следом, отдельным шагом - без него модель подставляет цифры сама, а не берёт их готовыми: в сыром прогоне из предыдущего раздела 14 чисел без единого источника, потому что такого файла у него не было
Нужен короткий текст под задачу вместо длинного материала? Путь короче и описан отдельно: как поручить текст нейросети. Здесь дальше только длинная форма
Шаг 1. Почему Дзен, а не Хабр, vc.ru или свой блог
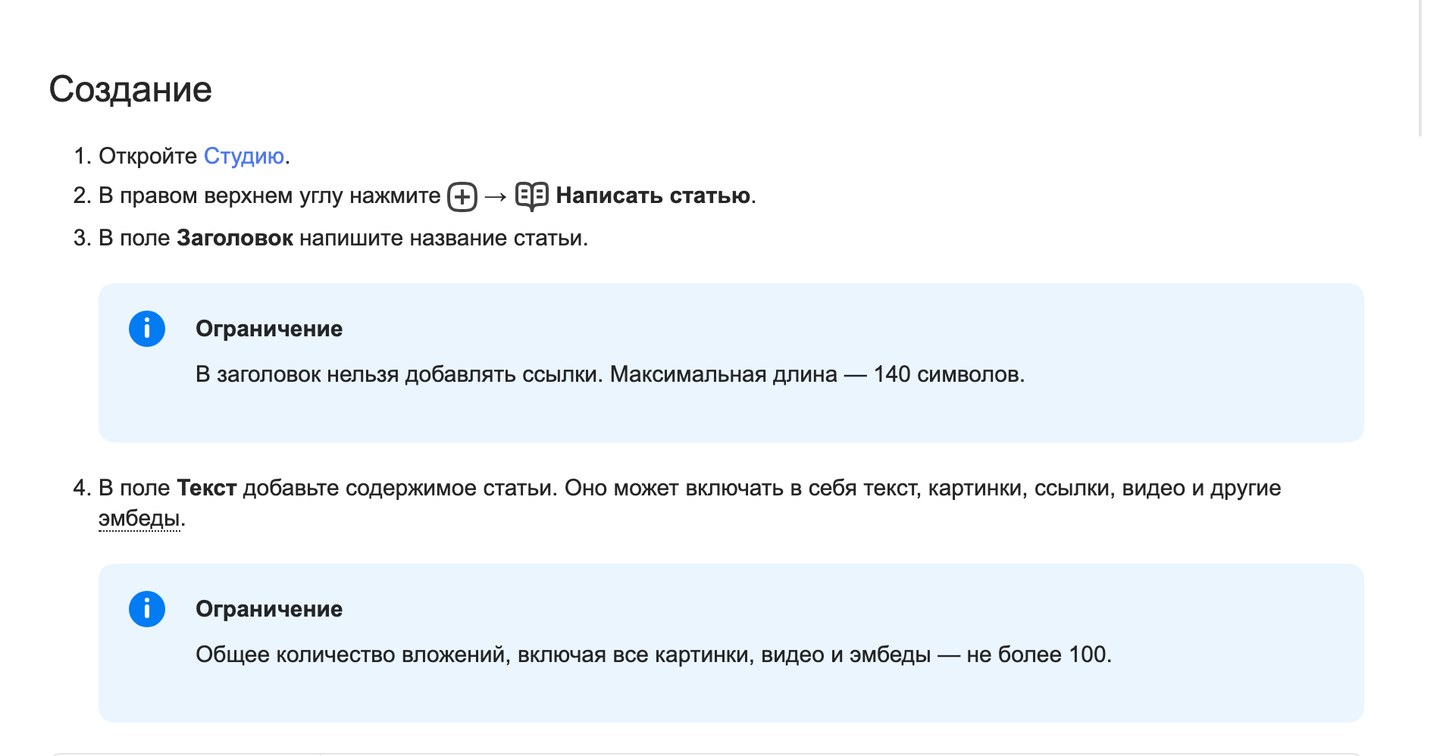
Дзен подходит новичку по умолчанию: у него нет минимальной длины (справка называет только потолок - 100 000 знаков в теле), нет запрета на тексты от нейросети и не нужен ни свой сайт, ни аккаунт разработчика - только кнопка «Написать статью» после входа
Если тянет на другую площадку
- Тема техническая, с кодом и воспроизводимым экспериментом - на Хабр этот путь не годится: правила прямо запрещают тексты, «написанные и отредактированные при помощи нейросетей», исключение только для обложки
- Нужен кейс с цифрами и готовность отвечать в комментариях под ним - это vc.ru, но там отдельное правило про копии: «Публиковать новые копии ранее опубликованных материалов без согласования запрещено»
- Уже есть свой сайт и хочется войти в поиск, а не в ленту - тогда нужен не этот путь, а разбор [как поручить текст нейросети](/guide-neyroset-napisat-tekst/) под площадку с капсулой и источниками
Вот как выглядит Студия Дзена у автора, который только завёл канал - ноль подписчиков, пустая статистика и подсказка, с чего начинать:
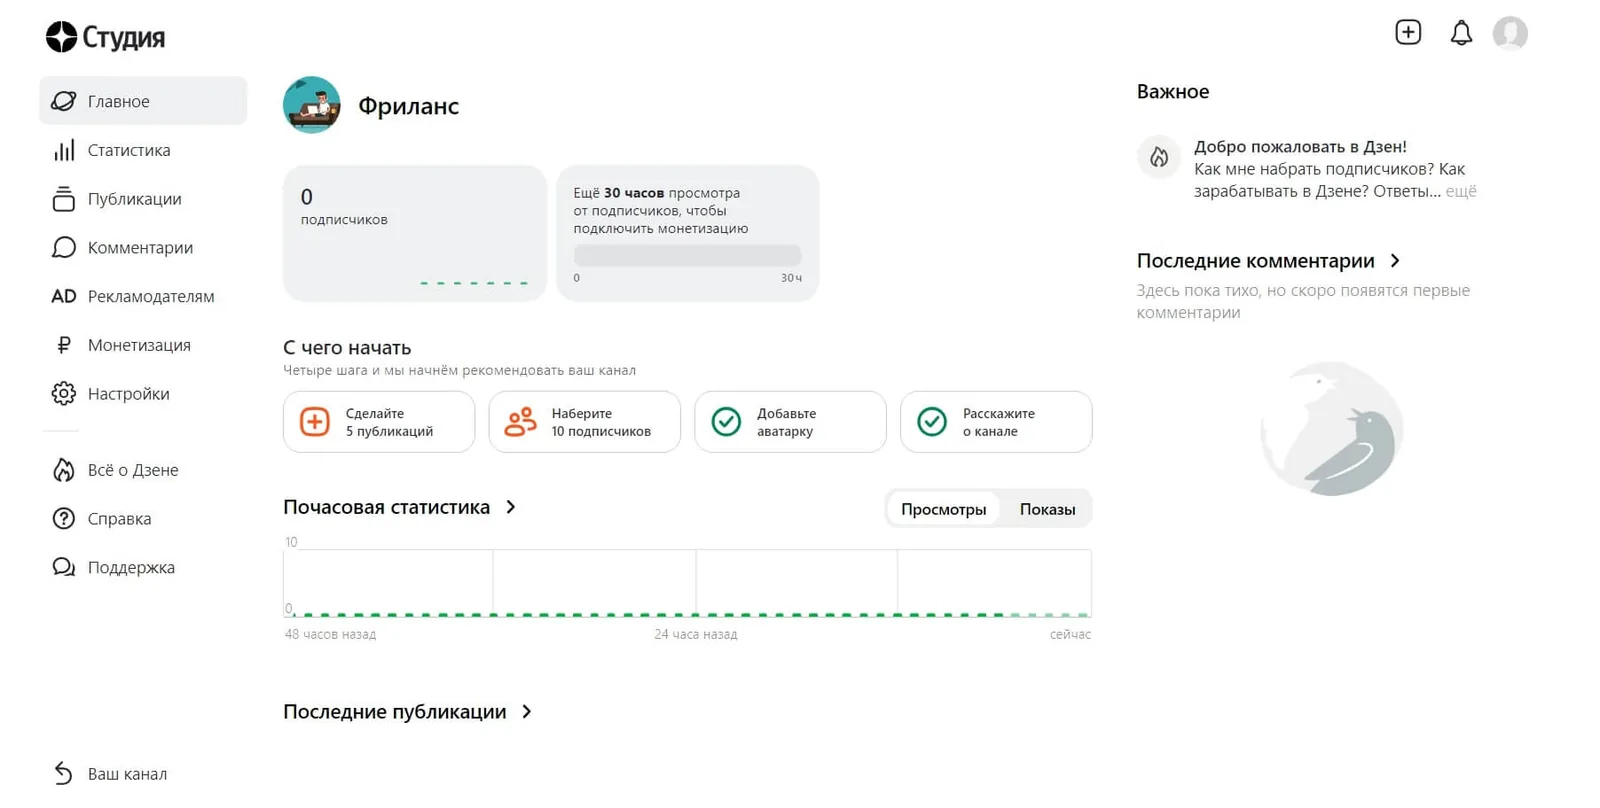
Записал в файл фактов: площадка - Дзен, лимит тела - 100 000 знаков, лимит заголовка - 140 символов. Дальше каркас
Шаг 2. Каркас статьи: 8-14 заголовков в виде поисковых запросов
Основа тут поисковые запросы: 8-14 строк, каждая звучит так, как человек набирает её в строке Яндекса, а логика темы идёт вторым слоем. Попросишь у помощника «план статьи» - вернутся названия глав, красивые и мёртвые для поиска
Заголовки из того самого прогона про ноутбук, дословно:
- Как выбрать ноутбук для работы из дома
- Начните с вопроса «что я буду делать»
- Процессор и оперативная память - сердце и лёгкие
- Накопитель: только SSD
- Экран - то, на что вы смотрите весь день
- Не забывайте про «мелочи», которые решают всё
- Windows, macOS или что-то ещё
- Итог: соберите свой минимум
Восемь строк, и в поисковую строку человек вводит совсем другое. Лечится одной формулировкой в поручении: не «план статьи», а «заголовки в том виде, как человек набирает запрос». По тому же правилу «один H2 - один запрос» те же темы переписываются так:
- «Процессор и оперативная память - сердце и лёгкие» → «сколько оперативной памяти нужно ноутбуку»
- «Накопитель: только SSD» → «SSD или HDD для ноутбука в 2026»
- «Windows, macOS или что-то ещё» → «какую операционную систему выбрать для ноутбука»
Разница между списками и есть весь каркас: во втором каждая строка - вопрос, на который раздел отвечает первой фразой
Правило, которое держит каркас в рабочем виде: один H2 - один запрос - один ответ в первой фразе раздела. Первая фраза сразу даёт ответ с цифрой или названием, места на подводку там нет
Заголовок страницы тоже подчиняется правилам: за что его переписывает Google - в Шаге 6
Каркас готов, когда в нём 8-14 строк, каждая звучит как запрос, и на каждую ты можешь ответить одним предложением - не отвечаешь сам, строку выкидываешь или закрываешь фактом дальше
Шаг 3. Файл фактов: один список цифр на все разделы статьи
Цифры и названия приходят в статью только из файла фактов, собранного руками до первого сообщения: без него модель поставила 14 чисел, за которыми не стоит ни один источник
Читается это гладко: спотыканий по чекеру ноль. И при этом в тексте 14 чисел без единого источника: 1, 1080, 14, 15-16, 16, 1920, 32, 5, 500, 512, 7, 700, 8, 8-10. Гладкий текст без прослеживаемых цифр выглядит убедительнее, чем он есть
Шаг 3. Собери файл фактов и защити его одной фразой
- Заведи текстовый файл и впиши туда все цифры, названия и ссылки, которые точно понадобятся одна строка - один факт с адресом источника, например
Дзен, заголовок до 140 символов - dzen.ru/help/ru/channel/article.html, проверено 14.08- увидишь обычный список строк без формул и разметки; даёт: помощник берёт цифры готовыми, а не сочиняет - В конце каждого сообщения-поручения на раздел допиши фразу-предохранитель
Факты бери только из списка выше. Нужной цифры в списке нет - пиши [УТОЧНИТЬ], не подставляй правдоподобное значение- увидишь: если факта не хватило, вместо выдуманного числа в тексте появится метка [УТОЧНИТЬ]; даёт: ты сразу видишь места, которые нужно закрыть своими данными, а не ищешь их по всему тексту - Перед сборкой статьи спроси у помощника словами, сколько раз в файлах разделов встречается пометка [УТОЧНИТЬ] увидишь число по каждому файлу; даёт: ноль везде - разделы готовы к сборке, любое другое число называет файл, где цифра ещё висит без адреса
Ноль во всех файлах - разделы идут в сборку. Любое другое число называет файл, где цифра ещё висит без адреса, и туда подставляется свой замер, а не правдоподобное значение. Ссылку, которую модель нашла сама, открываешь глазами: почему это важно - в разборе про нейропоиск
Зачем эта возня, сформулировал Google в требованиях к полезному контенту - даёт ли материал «original information, reporting, research, or analysis». Свой замер, свой скрин, своя таблица - и есть ответ
Шаг 4. Писать статью по разделам: одно сообщение - один заголовок каркаса
Статья пишется по одному разделу за сообщение, и держится это на замере объёма: на разделе в 200 слов помощник попадает в заданную вилку, на статье в 3000 слов расползается и добирает воду до цифры. Сама связка «каркас, потом секции, потом склейка» на коротком тексте разобрана в соседнем материале: как поручить текст нейросети. Здесь она нужна не ради экономии правок, а ради того, чтобы каждый раздел отвечал на свой поисковый запрос первой фразой - на длинной форме это единственный способ не потерять ни один H2 из каркаса
Шаг 4. Один раздел - одно сообщение помощнику
- Открой строку каркаса и напиши помощнику одним сообщением, что нужно текст сообщения целиком:
Напиши раздел под заголовком «сколько оперативной памяти нужно ноутбуку». Первая фраза - прямой ответ на заголовок с цифрой. 180-220 слов. Факты бери только эти: 8 ГБ хватает на браузер и документы, 16 ГБ нужны при 20+ вкладках и мессенджерах. Если нужна цифра, которой я не дал, пиши [УТОЧНИТЬ]. Выведи только готовый текст раздела, без своих комментариев- увидишь в ответ только сам раздел, без вступлений вида «Конечно, вот текст»; даёт: файл раздела сразу готов, вставлять и чистить ничего не нужно - Сохрани ответ в свой файл раздела и посчитай слова увидишь количество слов в готовом файле; даёт: подтверждение, что раздел попал в вилку и его не придётся ужимать или разгонять
прогон 14.08.2026: просил 180-220 слов, получил 203 - на разделе вилка держится
Четыре обязательные части сообщения: заголовок, требование к первой фразе, вилка объёма, факты с предохранителем. Убери любую - получишь либо воду, либо выдуманные числа
Если ответ пришёл не такой
- В ответе есть фраза вроде «Конечно, вот текст раздела» перед самим текстом - допиши в конец следующего сообщения «выведи только готовый текст, без вступлений», и удали лишнее из уже готового файла руками
- Слов заметно больше верхней границы вилки - помощник «разогнался»: попроси сократить именно этот файл до вилки, а не переписывай заново весь раздел
- В тексте появилась цифра, которой не было в файле фактов, а метки [УТОЧНИТЬ] нет - предохранитель не сработал: вручную замени цифру на [УТОЧНИТЬ] и подставь свою
Так пишутся все 8-14 разделов, каждый в свой файл. Дальше склейка и обязательный проход по тексту целиком: секции писались вслепую друг к другу, в них повторяются определения и рвутся связки
Шаг 5. Машинный след на 3000 слов: прогонять файл целиком, а не абзац
Замер идёт по всему файлу разом, а не на глаз: чекер считает плотность стилевых маркеров на тысячу слов и ловит тире там, где стиль выглядит чистым. У меня такой чекер стоит в контуре публикации, и на сыром против вычитанного текста он показывает разницу одним взглядом: 3.00 стилевых маркера на тысячу слов у сырого текста против 3.42 у вычитанного - почти одна и та же цифра. А вот тире развели их полностью: 21 против нуля
Вывод неудобный для тех, кто «правит стиль»: по стилевой плотности сырой текст и вычитанный разошлись всего на 0.42 пункта, то есть остались рядом. Развёл их именно символ тире
Что делать руками, по порядку:
- Заменить длинные и средние тире на дефис или разбить фразу точкой - одна замена по всему файлу
- Прочитать вслух три случайных абзаца: где запнулся, там и правь
- Выкинуть обороты-пустышки вроде «стоит отметить», «на самом деле», «важно понимать» - смысл без них не меняется
- Схлопнуть синонимичные пары: «быстро и оперативно» - это одно слово, написанное дважды
- Проверить финал каждого абзаца - у модели он почти всегда повторяет сказанное выше
Пункты 2-5 разобраны отдельно: как писать живым языком и что делать с уже готовым машинным текстом
Оговорка: из того, что чекер ловит тире, не следует, что по тире вычисляет поисковик - такого не заявляла ни одна система. Тире ловит человек: читатель, редактор, модератор, и этого хватает, чтобы его убрать
Если своего чекера нет
- Нет отдельной программы для замера - попроси помощника самого посчитать: «Найди в этом файле все длинные и короткие тире, выведи список строк с ними». Список придёт мгновенно, дальше замена руками
- Непонятно, что такое «стилевые обороты-паразиты» - спроси помощника прямо: «Найди в этом тексте фразы вроде "стоит отметить", "на самом деле", "важно понимать" и покажи их»
- Текст большой и вчитываться лень - прочитай вслух только первый и последний абзац каждого раздела: если запинаешься там, запнётся и читатель
Шаг 6. Первый экран под выдачу: заголовок, капсула ответа и оглавление
Экран до первой прокрутки держится на трёх элементах: заголовок, капсула ответа на 40-60 слов и оглавление на весь материал. Остальное работает уже дальше
Капсула ответа. Абзац сразу под заголовком: отвечает на запрос без разгона и содержит хотя бы один проверяемый объект - цифру, название, факт. Не «в этой статье мы разберём», а сам ответ - капсула единственное, что человек из поиска успевает прочитать
Заголовок. Он живёт в двух местах сразу, в выдаче и на странице, и обязан совпадать - иначе Google переписывает его сам, причины свои: устаревшая дата, неточное описание, невнятный H1, шаблонный текст на многих страницах
Жёсткого лимита в символах у Google нет: заголовки обрезаются «typically to fit the device width», «60 символов» - лишь ориентир под ширину экрана. У Дзена лимит настоящий: 140 символов, ссылки внутрь заголовка запрещены
Оформление тела. Три приёма дают больше всего:
- сравнение вариантов - таблицей: три площадки в абзаце читаются как каша, в таблице - за один взгляд
- процесс - нумерованным списком, читателю нужен порядок
- у каждой картинки подпись и текстовое описание для тех, у кого картинки отключены
Чего не надо делать. Не рисуй картинками текст: карточка с буллетами грузится медленнее абзаца и не попадает в поиск. Картинка оправдана там, где показывает то, чего в абзаце физически нет - вид экрана, вид ошибки, взаиморасположение
Шаг 7. Опубликовать в Дзене: пять полей карточки
Что нажать. В студии Дзена «Написать статью» → вставить готовый текст → заполнить пять полей карточки: заголовок, описание, обложку, теги, ссылки → «Опубликовать»
Что увидишь. Статус «В обработке» - держится от минут до часов, затем статья появляется в ленте
Что это тебе даёт. Первый показ в ленте у Дзена бывает один раз, и ошибка в любом из пяти полей стоит дороже, чем правка самого текста - поэтому карточка заполняется внимательно, а не на автомате
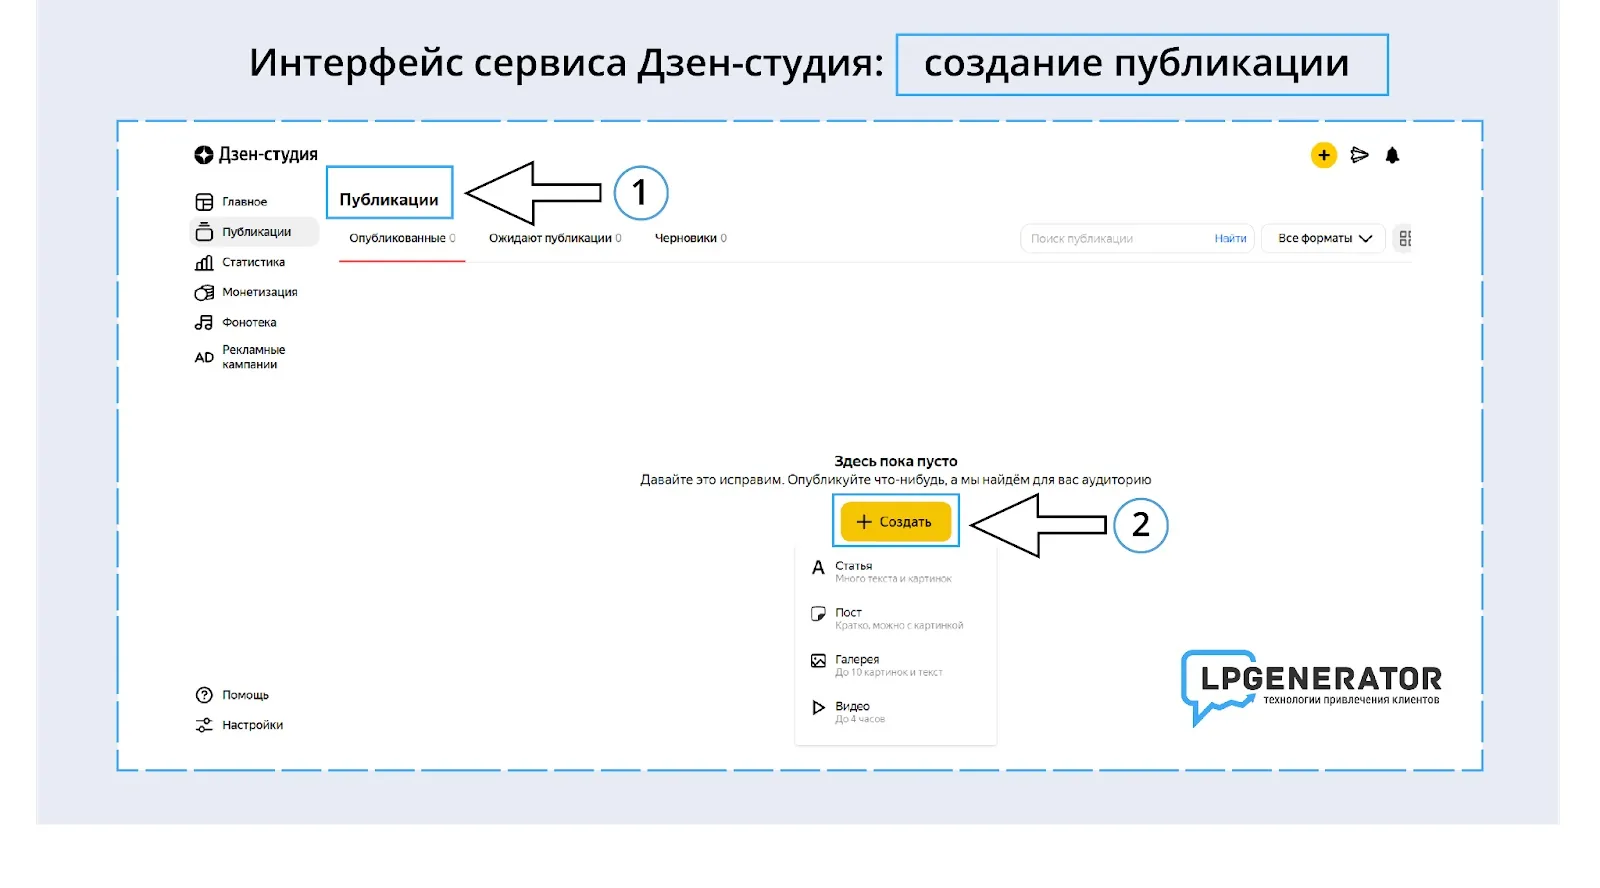
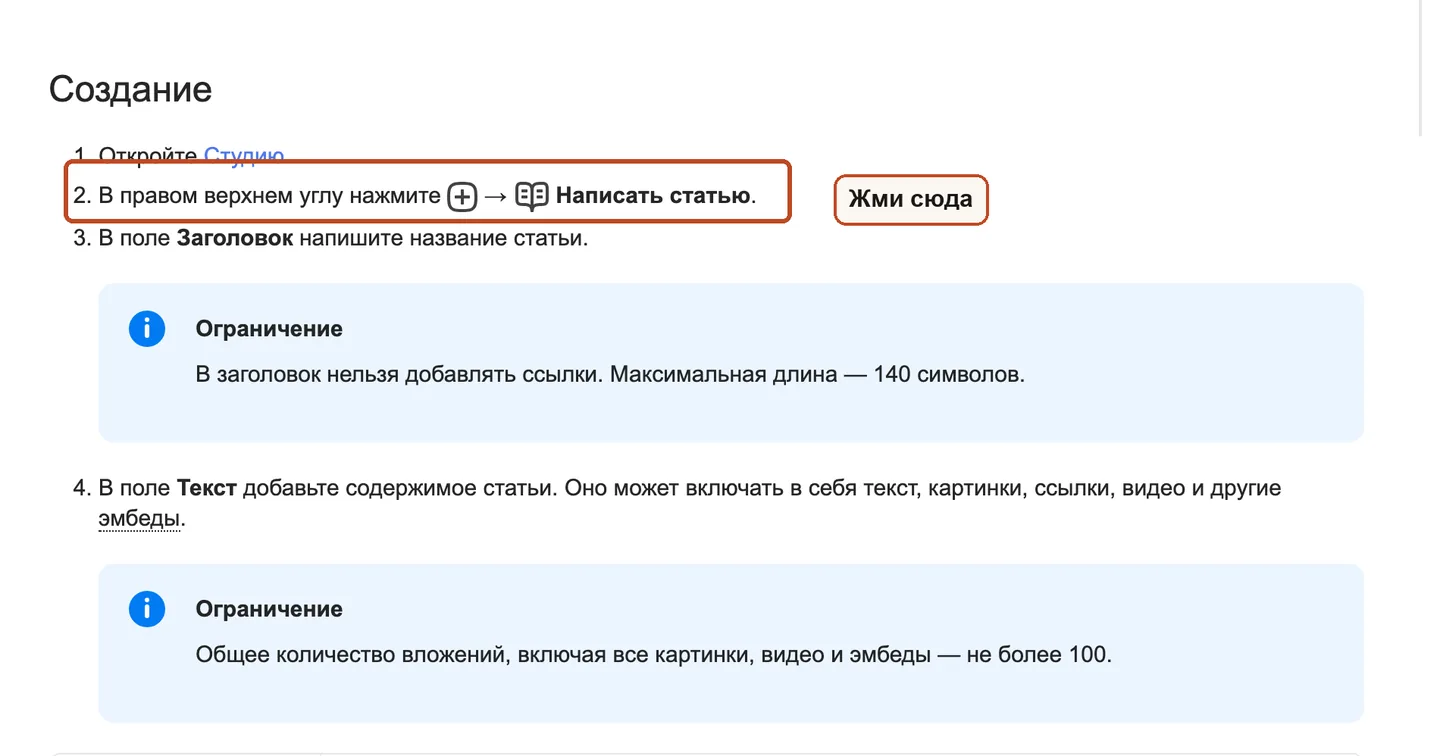
Путь клика до формы статьи выглядит так - «Публикации», потом жёлтая кнопка «Создать» и выбор формата:
| Поле | Что туда идёт | Где ошибаются |
|---|---|---|
| Заголовок | тот же, что H1, символ в символ | в Дзене длиннее 140 символов, хвост обрезается |
| Описание или лид | обещание результата, не оглавление | пересказывают содержание, не результат |
| Обложка | от 300 px по ширине, до 30 Мб | картинка с мелким текстом, в карточке срезается |
| Теги | 3-5 штук по теме | сыплют двадцать «на всякий случай» |
| Ссылки в тексте | на свои материалы и источники | в Дзене ссылка в заголовке - запрещено |
Таблица прокручивается вбок →
Если после публикации что-то не так
- Статус «В обработке» висит дольше нескольких часов - это не сбой, просто модерация ещё не дошла; закрывать и пересоздавать статью не нужно
- Показ ограничен только подписчиками - Дзен определяет кликбейт как «оформление карточки публикации, которое обманывает ожидания пользователей»: сверь, обещает ли заголовок то же, что внутри текста
- Заголовок обрезался в карточке - в нём больше 140 символов: сократи в самой карточке, текст статьи и H1 менять не нужно
Если вместо Дзена всё же нужен vc.ru - там своё правило про копии, публиковать новый материал с другого своего сайта можно, а чужой только со ссылкой и разрешением автора. На Хабр эта статья не идёт вовсе - правила прямо запрещают тексты от нейросети
Опубликовал - не закрывай окно с помощником: следующие сутки решают, увидит ли страницу поиск
Первые сутки: отдать адрес статьи Яндексу и Google
В первые сутки после публикации делаются три вещи: отдать адрес Яндексу и IndexNow, проверить карточку в мессенджере и записать дату - каждая занимает пять минут, и все три чаще всего пропускают
Сообщить Яндексу. Инструмент «Оригинальные тексты», которым годами советовали закреплять авторство, отключён:
«Яндекс Вебмастер перестал поддерживать инструмент «Оригинальные тексты».»
Яндекс Вебмастер, справка инструмента (yandex.ru)
Замена: переобход страниц в Вебмастере или обход по счётчику Метрики - тогда робот узнаёт о новой странице сам
Отдать адрес через IndexNow. Протокол понимают Яндекс и Bing: генерируешь ключ, кладёшь файл в корень сайта, отправляешь адрес запросом, до 10 000 за раз. Обмен адресами между системами документация описывает как требование к самим поисковикам, а не как обещание автору:
«Search engines adopting the IndexNow protocol agree that submitted URLs will be automatically shared with all other participating search engines»
Документация IndexNow, раздел Requirement for search engines (indexnow.org)
Если IndexNow принял запрос - это значит только приём запроса, а не индексацию адреса
Google. Пинга по адресу у него нет с 2023 года: адрес идёт в карту сайта, переобход конкретной страницы - через Search Console
Проверить карточку и записать дату. Кинь ссылку себе в мессенджер, посмотри заголовок и картинку - обрезано или не подтянулось, чинить сейчас. Дата публикации идёт в файл фактов: через 30 дней сравнишь показы и клики
Сколько слов нужно статье: замер девяти страниц в выдаче
Медиана моих статей, которые реально показываются в поиске, - 3023 слова, при этом длина сама по себе кликов не даёт. Взял страницы из Яндекс.Вебмастера за окно 10.02-10.08.2026, оставил те, у которых от 200 показов, сопоставил с длиной черновика
| Страница | Слов | Показы | Клики | CTR% |
|---|---|---|---|---|
| guide-skilly | 921 | 1947 | 99 | 5.08 |
| guide-otkaz | 3576 | 428 | 18 | 4.21 |
| guide-kimi | 2908 | 2591 | 70 | 2.70 |
| guide-sekretar | 3569 | 210 | 4 | 1.90 |
| guide-sora | 2773 | 389 | 7 | 1.80 |
| guide-opus | 2906 | 501 | 5 | 1.00 |
| guide-kontekst | 3311 | 284 | 2 | 0.70 |
| guide-karta | 3633 | 821 | 2 | 0.24 |
| guide-reklama | 3023 | 319 | 0 | 0.00 |
Таблица прокручивается вбок →
Девять страниц с показами от 200 за окно 10.02-10.08.2026. У пяти страниц с CTR не ниже 1% медиана длины 2908 слов, у четырёх с CTR ниже 1% - 3167 слов, а по всем девяти медиана - 3023 слова при разбросе от 921 до 3633
Крайние точки читаются прямо из таблицы: лучший CTR 5.08% у самой короткой страницы на 921 слово, ноль кликов при 319 показах - у страницы на 3023 слова, а самая длинная на 3633 слова дала 0.24%. В верхней половине по кликабельности медиана 2908 слов, в нижней 3167
Честная граница метода: девять страниц - маленькая выборка, и закон «пиши короче» она не доказывает. Она делает другое: опровергает обратное утверждение «чем длиннее, тем лучше», которое до сих пор кочует по руководствам
Практический вывод: объём выводится из каркаса. 8-14 разделов по 150-400 слов дают 2000-3500, и этого хватает на тему целиком. Вышло меньше - добавляй раздел, пример, грабли. А если больше, значит часть абзацев не отвечает ни на один заголовок, и дописывать «до объёма» не надо
Пять поломок статьи: симптом, причина и что чинить
Пять поломок статьи ловятся по внешнему симптому за минуту: человек уходит с первого экрана, Дзен ограничил показ подписчиками, страницы нет в поиске через неделю. Каждой соответствует своя причина:
| Симптом | Причина | Что делать |
|---|---|---|
| Текст читается ровно, но человек уходит с первого экрана | каркас собран из логики темы, а не из запросов | вернуться в Шаг 2, переформулировать H2 в вид запроса |
| Площадка ограничила показ или сняла материал | карточка обещает не то, что внутри - по Дзену это кликбейт | привести заголовок и обложку в соответствие |
| Через неделю страницы нет в поиске | о новом адресе никому не сообщили | переобход в Вебмастере, IndexNow, Search Console |
| Всплывают цифры, которых ты не давал | не было файла фактов и [УТОЧНИТЬ] | собрать файл фактов, пройти поиском по метке |
| Читатель пишет «это же нейросетью написано» | остался машинный след: тире, обороты-пустышки | прогнать чекер, заменить тире, прочитать вслух |
Таблица прокручивается вбок →
Первая строка встречается чаще остальных и лечится дороже всего: переписывать приходится каркас, не абзац
Отдельная ошибка вне таблицы: одну статью раскладывают на четыре площадки сразу. Хабр снимает по правилам о нейросетях, vc.ru по правилу о копиях, Дзен показывает только подписчикам - одна статья, одна площадка
Цена второй статьи: что переиспользуется, а что собирается заново
Вечер уходит на первую статью, на вторую пара часов: файл фактов, поручение на раздел и правила вычитки собираются один раз, а на новой теме меняются только 8-14 заголовков каркаса
Заново на каждой теме делаются два артефакта: сам каркас и факты под него. Остальное лежит готовым с первого раза
Дальше начинается другая задача - какие темы брать, как связать статьи между собой и как поставить вычитку на автомат. Это уже не разовая просьба помощнику, это система - её сборку разбираю отдельно
Источники
- Google Search Central, правила против спама - scaled content abuse
- Google Search Central, полезный контент для людей - рамка «Who, How, Why»
- Google Search Central, заголовок страницы в выдаче - когда заголовок переписывают
- Яндекс Вебмастер, советы вебмастеру - автоматически сгенерированный контент
- Яндекс Вебмастер, оригинальные тексты - инструмент отключён, чем заменили
- Яндекс Вебмастер, поддержка IndexNow - как работает ключ
- Правила сайта Хабр - запрет текстов от нейросетей
- Дзен, как создать и опубликовать статью - лимиты заголовка и обложки
- Дзен, правила и требования к контенту - определение кликбейта
- Правила общения на vc.ru - копии материалов, реклама
- Документация протокола IndexNow - формат запроса, потолок 10 000
- Справочник команд Claude Code - на чём построен помощник в этом гайде
Памятка: путь статьи от установки до переобхода
Девять проверок в том же порядке, что Шаги в тексте, номер шага в скобках
Сохрани себе
- Помощник установлен, папка под разделы заведена (Шаг 0)
- Площадка выбрана до первой строки, на Хабр текст от модели нельзя (Шаг 1)
- Каркас собран: 8-14 заголовков в формулировках поисковых запросов (Шаг 2)
- Файл фактов собран, одна строка - один факт с адресом источника (Шаг 3)
- Разделы пишутся по одному, 150-400 слов, в сообщении - просьба вывести только текст (Шаг 4)
- Счёт по метке УТОЧНИТЬ в файлах разделов даёт ноль до склейки (Шаг 4)
- Прогон чекера сделан, длинных и средних тире в тексте ноль (Шаг 5)
- Капсула 40-60 слов под заголовком, заголовок совпадает с H1 (Шаг 6)
- Пять полей карточки заполнены, переобход и IndexNow отправлены (Шаг 7 и сутки после)
Когда первая статья опубликована
Второй материал обязан стоить дешевле первого
Дорога от установки до переобхода пройдена. Открытым остаётся другое: как превратить разовый заход в повторяемую машину под свои темы
Частые вопросы
Можно ли писать статьи нейросетью и не попасть под фильтр?
Можно, если статья полезна и она одна, а не поток однотипных страниц - Google наказывает именно «scaled content abuse», массовое производство ради выдачи. У Хабра отдельно прямой запрет в правилах
Какой объём статьи считается нормальным?
Рабочая вилка - 2000-3500 слов, получается из каркаса: 8-14 разделов по 150-400. Медиана моих страниц с показами от 200 - 3023 слова, связи между длиной и кликами нет
Как заставить нейросеть не выдумывать цифры?
Собрать файл фактов до первого сообщения: факты только из списка, нужной цифры нет - ставь [УТОЧНИТЬ]. После сборки пройти поиском по метке и закрыть каждую своими данными
Можно ли публиковать текст от нейросети на Хабре?
Нет, прямой запрет в правилах на тексты, «частично или полностью сгенерированные нейросетями или написанные и отредактированные при помощи нейросетей». Исключение - обложка и мелкий фрагмент технической статьи
Что сделать, чтобы статья быстрее попала в поиск?
Сообщить о новом адресе самому: для Яндекса - переобход в Вебмастере или обход по счётчику Метрики, плюс IndexNow. Для Google - адрес в карте сайта и запрос переобхода в Search Console
Чем статья от нейросети отличается от поста?
Единицей и адресом. Пост живёт в ленте день-другой на одном тезисе. Статья живёт в выдаче месяцами, держится на 8-14 разделах, требует источников под цифрами