Инструкция · 18 августа 2026
Нейросеть конспект: 4 шага от часа лекции до тезисов
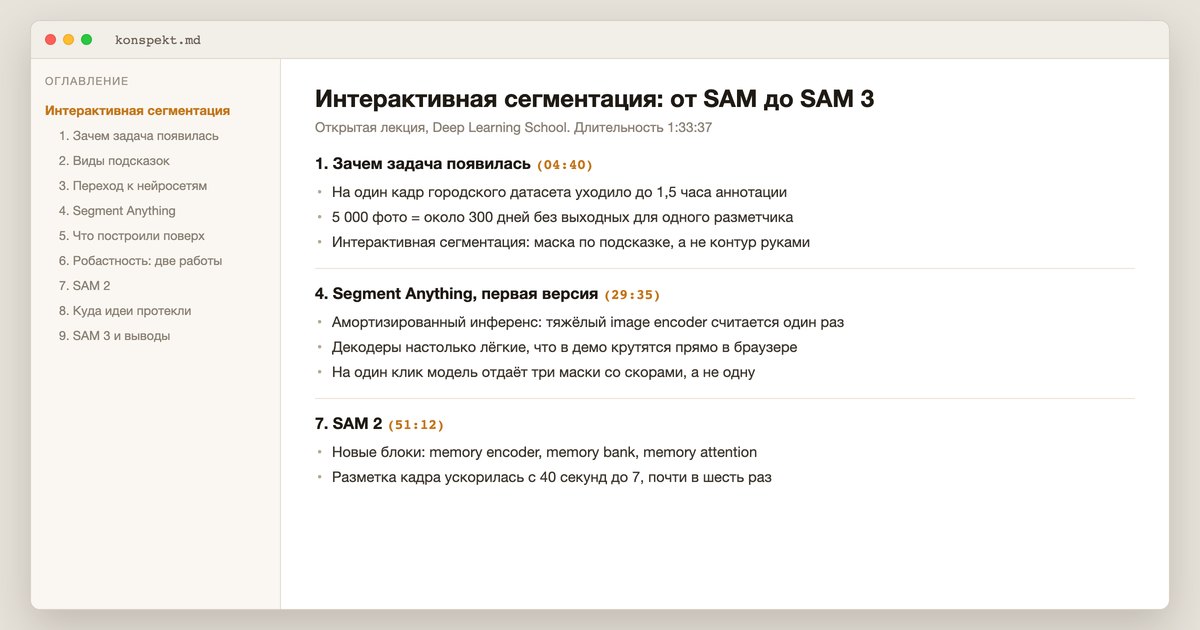
Полтора часа лекции у меня превратились в текст с разделами и таймкодами за три минуты машинного времени. Ниже весь путь целиком: какие команды я вводил, что показал экран, как выглядит готовый конспект и в каком месте модель соврала мне 69 раз
Нейросеть делает конспект в два шага: сначала распознаёт речь в сплошной текст, потом сжимает его в тезисы. На своей машине это бесплатно: лекция длиной 1:33:37 превратилась в текст за 3 минуты 2 секунды, а 10 912 слов расшифровки ужались до 581 слова конспекта. Проверено 18 августа 2026 года
Вопрос, который ты себе уже задал
«А я это вообще потяну без программиста?»
Так себя спрашивает каждый, кто вместо кнопки видит на экране одну строку с командой. Отвечаю честно: понимать код тут не нужно нигде, нужно скопировать три строки и подставить имя своего файла. Один конспект такими строками закрывается за вечер, а вот сложить из них поток, который работает без тебя, это уже отдельная работа, и её разбирает ИИ-Лагерь
Что происходит с записью внутри: два шага, а не один
Нейросеть делает с записью не одно действие, а два разных, и это главное, что стоит понять до первой команды. Сначала работает распознавание речи: звук превращается в сплошной текст без абзацев и заголовков. Потом работает языковая модель: этот текст сжимается в конспект с разделами и тезисами
Сервисы с кнопкой «Сделать конспект» прячут оба шага за одним нажатием, и человек видит только результат. Проблема в том, что шаги ломаются по-разному. Распознавание может не расслышать термин, приписать чужую реплику спикеру или выдать целую фразу там, где в записи была тишина. Сжатие ошибок звука уже не видит: оно честно пересказывает то, что ему принесли, вместе с мусором
Отсюда практический вывод. Если конспект получился странным, чинить надо не промпт (промпт это текстовое задание модели, то, что ты пишешь ей перед материалом), а расшифровку. Открываешь текстовый файл после распознавания, ищешь кусок, где смысл поехал, и смотришь на исходную запись по таймкоду. В девяти случаях из десяти виноват звук: микрофон в стороне, два человека говорят одновременно, спикер отвернулся от камеры
Второй вывод менее очевидный. Первый шаг стоит держать у себя, а второй можно отдавать куда угодно. Распознавание работает на своей машине бесплатно и без загрузки файла в чужое облако, а сжатие уже идёт по обычному тексту, который весит килобайты вместо гигабайт
Какой путь выбрать под свою запись
Путь выбирается по источнику записи, а не по инструменту. Ролик на ютубе, свой аудиофайл и живая встреча требуют разного объёма работы: в первом случае текст уже существует и его надо забрать, во втором и третьем текст придётся получить самому
Разница в стоимости входа большая. Субтитры ролика скачиваются одной командой за секунду. Собственный часовой файл нужно сначала подготовить, потом прогнать через распознавание. Живую встречу нужно ещё и записать, а до этого предупредить собеседников, что идёт запись
| Что на входе | Что делаешь | Сколько занимает у меня | Обо что спотыкаешься |
|---|---|---|---|
| Ролик на ютубе | скачиваешь готовые субтитры | около секунды | автосубтитры без знаков препинания, спикеры не разделены |
| Свой файл (лекция, вебинар, диктофон) | конвертируешь звук и распознаёшь | 3 минуты на полтора часа записи | нужен диск под модель и один раз поставить движок |
| Живая встреча или созвон | записываешь, дальше как свой файл | плюс время самой встречи | микрофон в стороне режет качество сильнее всего остального |
Таблица прокручивается вбок →
Отдельно стоит развести две соседние задачи, которые часто путают. Здесь входящий чужой материал сжимается: лекция, вебинар, созвон уже существуют, надо вытащить из них суть. Обратная задача, когда своя голосовая заметка разворачивается в новый текст, живёт в гайде про голосовые и контент и решается другими промптами. Если на входе не звук, а готовый документ, это третий случай, и он разобран в гайде про работу с документами
Конспект видео с ютуба без распознавания
У ролика на ютубе текст чаще всего уже есть: площадка сама делает автоматические субтитры почти для любого языка. Забрать их можно одной командой, и распознавание в этом случае не нужно вовсе
Скачать субтитры без самого видео
- Скопируй строку
yt-dlp --skip-download --write-auto-subs --sub-langs ru --convert-subs srt -o 'subs' "ССЫЛКА_НА_ВИДЕО"целиком и вставь в окно, где вводишь команды, вместо «ССЫЛКА_НА_ВИДЕО» подставь адрес своего ролика программа не станет качать само видео, а заберёт только русские субтитры и переведёт их в файл с таймкодами - Нажми Enter и подожди, пока строки на экране остановятся рядом появится файл
subs.ru.srt- это и есть готовые субтитры, распознавание речи для них уже не нужно
На лекции длиной 1:33:37 я запустил эту же команду 18 августа 2026 года, и весь процесс занял около секунды: программа сама нашла ролик, скачала русские субтитры и сохранила их файлом весом 781,77 килобайта. Полтора часа речи забрались за секунду - это самый дешёвый вход в конспект из всех, что есть
Только не пугайся размера файла. subs.ru.srt весит 510 килобайт, и если натравить на него счётчик слов, выйдет 50 745 штук. Речи там столько нет: файл несёт 4 109 блоков, у каждого свой номер и строка таймкода, а сам текст ютуб печатает бегущей строкой и повторяет одну фразу в нескольких блоках подряд
Я проверил счётчиком строк: в файле subs.ru.srt ровно 4 109 блоков с таймкодами, а одна и та же фраза «Всё, супер. Тогда сейчас я напишу, что» встретилась среди них три раза подряд - вот откуда берётся разница между объёмом файла и настоящим объёмом речи. Ту же лекцию, распознанную у себя на машине, я померил дальше в статье: там 10 912 слов. Это и есть настоящий объём речи, а 50 745 это объём файла со служебной разметкой и повторами
У автосубтитров есть цена, о которой стоит знать заранее. В них нет знаков препинания, нет разделения на реплики разных людей, и специальные термины площадка часто пишет на слух. В моём файле первая строка выглядит как «пауза, ещё что-то», потому что трансляция началась раньше самой лекции. Перед сжатием такой текст стоит прочитать глазами хотя бы по диагонали
Шаг 0. Что нужно до первой команды
До первой команды нужны три вещи: место, куда эти команды вставлять, около двух гигабайт свободного диска и сама запись в любом обычном формате. Всё это либо уже стоит на машине, либо качается бесплатно и без аккаунта
Дальше идёт путь для своего файла, того самого второго входа из таблицы выше. Он длиннее ютубовского на один вечер настройки, зато работает с любой записью и не зависит от чужого сервиса
Команды ниже вставляются в терминал - так называется окно, где ты печатаешь программе текстом, что сделать, вместо того чтобы нажимать на неё мышкой. На macOS и Linux терминал (то же самое окно) уже стоит в системе и стоит ноль рублей: этого достаточно, чтобы пройти весь путь статьи от начала до конца. У кого Windows, порядок другой, он разобран в гайде по установке на Windows: там то же самое окно называется PowerShell или WSL, команды в нём вводятся точно так же
Отдельно про Claude Code, он попадётся дальше по тексту. Это платный инструмент, нужен аккаунт и подписка, и обязательным элементом пути он не является: и распознавание, и сжатие делаются без него. Удобен он двумя вещами: ему можно сказать словами, что нужно сделать, и он читает длинный файл с диска целиком. Если решишь завести, порядок установки описан в гайде по установке Claude Code: там показано, куда нажимать и что появится на экране
Про диск. Модель распознавания, которую я беру дальше, весит полтора гигабайта. Плюс сама запись и её рабочая копия: часовая лекция в mp3 занимает десятки мегабайт, а её распакованная версия для распознавания разрастается до сотен. Два гигабайта свободного места закрывают весь путь с запасом
Про запись. Годится всё, что играет: mp3, m4a, wav, mp4 с видео. Диктофон телефона тоже подходит. Отдельно готовить ничего не нужно, конвертация будет одной командой на следующем шаге
Если тема нейросетей для тебя вообще новая и хочется сначала общей картины, а не одной задачи, начни с обзорного гайда про обучение нейросетям и вернись сюда потом
Шаг 1. Поставить распознавание и выбрать модель
Распознавание ставится одной командой, модель к нему скачивается второй. Движок называется whisper.cpp, это открытый проект с лицензией MIT, он гоняет модель распознавания Whisper прямо на домашней машине без интернета и без аккаунта
Поставить движок распознавания
- Вставь в окно, где вводишь команды, строку
brew install whisper-cpp, и нажми Enter на macOS и Linux этого достаточно, других действий движок не требует - Дождись, пока строки установки на экране остановятся это значит, что whisper.cpp уже стоит на компьютере, но сам он ещё «пустой» - мозгов для распознавания в нём пока нет
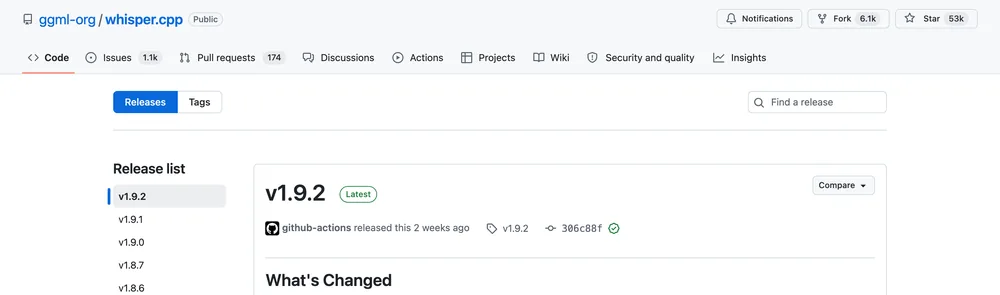
Homebrew - это программа, которая сама ставит нужные инструменты одной командой; на 18 августа 2026 года её версия ставит whisper-cpp 1.9.2, тот же номер, что и на странице релизов проекта. В её справке сразу стоит честная оговорка на английском: «whisper-cpp requires GGML model files to work. These are not downloaded by default». То есть движок приехал, а мозги к нему надо скачать отдельно
Модель качается отдельным файлом. Я беру large-v3-turbo: в описании OpenAI про неё сказано «an optimized version of large-v3 that offers faster transcription speed with a minimal degradation in accuracy», то есть та же большая модель, ускоренная ценой небольшой потери точности. У неё 809 миллионов параметров против 1550 миллионов у полной large, и на русском она держится заметно лучше маленьких
| Модель | Файл на диске, whisper.cpp | Видеопамять, таблица OpenAI | Когда брать |
|---|---|---|---|
| tiny | 75 МиБ | ~1 GB | черновая расшифровка, где важна только суть |
| base | 142 МиБ | ~1 GB | короткие записи с чистым звуком |
| small | 466 МиБ | ~2 GB | компромисс для старого ноутбука |
| large-v3-turbo-q5_0 | 547 МиБ | строки нет | та же модель в сжатом виде, для слабой машины |
| large-v3-turbo | 1.5 ГиБ | ~6 GB (строка turbo) | русская речь, термины, длинные лекции |
Таблица прокручивается вбок →
Два столбца тут из разных мест, и путать их не надо. Размеры файлов взяты из списка моделей самого whisper.cpp. Столбец видеопамяти взят из другой таблицы, из описания питоновой версии Whisper, и подписан там как Required VRAM: это про запуск на видеокарте. У whisper.cpp столбца памяти нет вовсе, и сжатой строки q5_0 в таблице OpenAI тоже нет, поэтому я её не выдумываю
Считай второй столбец верхней прикидкой, а не требованием к своей машине: путь этой статьи гоняет модель через whisper.cpp на обычном процессоре. Мой прогон дальше по тексту показал model size = 1623.92 MB, то есть полтора гигабайта под саму модель, и этого хватило
Файл модели лежит на Hugging Face, качается прямой ссылкой и никакого аккаунта не требует. У whisper.cpp есть готовая команда ./download-ggml-model.sh large-v3-turbo, которая лежит в папке проекта на GitHub - такая папка называется репозиторий, место, где хранится весь код программы. Но модель можно и просто скачать файл браузером и положить в отдельную папку, например ~/whisper-models/. Дальше путь к этому файлу подставляется в команду распознавания
Шаг 2. Час записи в текст одной командой
Час записи превращается в текст двумя вызовами: сначала звук приводится к нужному формату, потом по нему проходит распознавание. Первый вызов занимает секунды, второй на моей машине занял три минуты на полтора часа лекции
Привести звук к нужному виду
- Вставь строку
ffmpeg -i lekciya.mp3 -ar 16000 -ac 1 -c:a pcm_s16le lekciya.wav, поменявlekciya.mp3на имя своего файла, и нажми Enter программа приведёт звук к 16 килогерцам и одной дорожке - именно этого ждёт движок распознавания - Подожди, пока строка на экране остановится рядом появится новый файл
lekciya.wav, готовый к распознаванию; занимает это секунды даже на часовой записи
Запустить распознавание
- Вставь строку
whisper-cli -m ~/whisper-models/ggml-large-v3-turbo.bin -f lekciya.wav -l ru -otxt -osrt -of konspekt-sourceи нажми Enter флаг-l ruсразу говорит модели, что запись на русском - без него модель угадывает язык сама и на смеси русского с английскими терминами иногда ошибается - Подожди, пока модель пройдёт всю запись появятся два файла:
konspekt-source.txt- сплошной текст, иkonspekt-source.srt- тот же текст с таймкодами
Вот что показал собственный прогон на лекции длиной 1:33:37, снятый 18 августа 2026 года: модель весом 1623,92 мегабайта загрузилась за 427,59 миллисекунды, а всё распознавание заняло 182,44 секунды
182.44 секунды на 5617.79 секунды записи. Получается, машина прошла лекцию примерно в 30 раз быстрее, чем её читали живьём. Никакой сети при этом не требовалось: после того как модель скачана, распознавание работает без интернета вообще
Файл konspekt-source.txt весит 118 килобайт и содержит 10 912 слов. Это ещё не конспект, это сырьё для него
Шаг 3. Сжать расшифровку в конспект
Расшифровку нужно отдать языковой модели вместе с промптом, который задаёт форму конспекта. Промпт здесь важнее выбора модели: без него на выходе получается пересказ в три абзаца, из которого потом ничего не найти
Если не до конца понятно, что вообще такое языковая модель под капотом - за 2 минуты объясняю в гайде Что такое GPT: расшифровка простыми словами за 2 минуты
Вот рабочий промпт, его можно скопировать целиком:
Ты работаешь с расшифровкой аудиозаписи. Она сделана автоматически,
в ней есть ошибки распознавания и повторы.

Собери конспект по правилам:
1. Раздели материал на смысловые разделы, каждому дай заголовок
2. К каждому заголовку поставь таймкод первого упоминания темы
3. Внутри раздела - тезисы списком, по одной мысли на строку
4. Сохрани все числа, названия и имена ровно так, как они в расшифровке
5. Ничего не добавляй от себя: если мысль в тексте не закончена, так и напиши
6. Куски, где смысл не восстанавливается, помечай строкой [неразборчиво]

Не пересказывай своими словами то, чего в записи нет.
Расшифровка ниже.
Четыре правила из шести нужны против одной и той же беды: модель любит достраивать. Она видит обрывок про «модель улучшала саму себя» и охотно допишет, каким именно способом, потому что в её знаниях такой способ есть. В конспекте лекции это уже не конспект, а фантазия на тему
Куда вставлять. Если расшифровка короткая, хватит обычного окна чата: копируешь промпт, ниже вставляешь текст. Моя расшифровка лекции в одно окно чата не влезла бы, поэтому файл я отдал через Claude Code: там модель читает файл с диска целиком и не приходится резать текст руками. Если Claude Code ещё не стоит, порядок установки лежит в гайде по установке
Длинную расшифровку можно резать и вручную, по 20-30 минут записи на кусок, а потом склеивать конспекты частей. Резать лучше по смене темы, а не по числу знаков: разорванная посередине мысль теряется у обеих половин
Что вышло на выходе
На выходе 10 912 слов расшифровки стали конспектом на 581 слово: команда для счёта слов подтвердила и то, и другое число, а простое деление даёт сжатие в 18.8 раза. Полтора часа лекции читаются теперь за три минуты, и при этом видно, в какой момент записи искать подробности
Структура получилась такая: заголовок с темой и длительностью, девять пронумерованных разделов с таймкодом у каждого, внутри разделов тезисы списком, в конце отдельный блок с вопросами, которые задавали в чате. Каждый тезис держит числа из лекции: полтора часа на разметку одного кадра, 5 000 фотографий в наборе данных, ускорение разметки с 40 секунд до 7
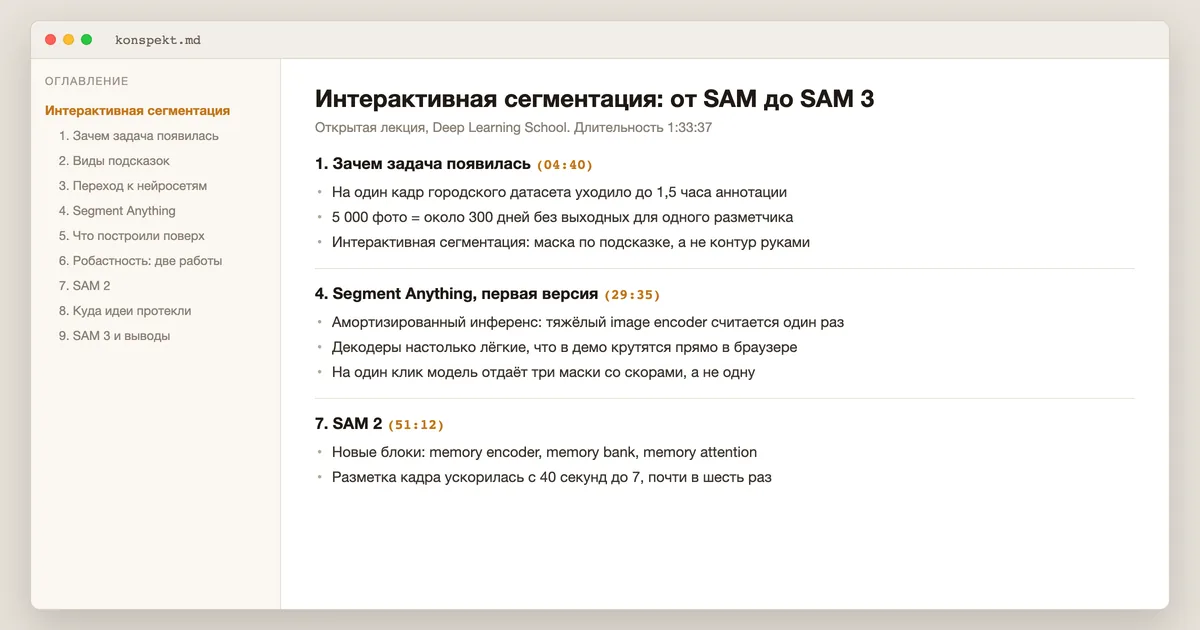
Теперь честная часть. Этот конспект я не считаю готовым документом. Он готовое сырьё: по нему видно, что было в лекции, но решение, что из этого забирать в работу, машина за меня не приняла и не примет
Где конспект врёт и как это ловить
Врёт чаще всего первый шаг, распознавание, и врёт он на тишине и на плохом звуке. В моей расшифровке лекции нашлось 69 строк, которых в записи нет вообще: модель вписала титр «Субтитры создавал DimaTorzok» там, где в звуке была пауза перед началом
Я проверил счётчиком строк тот же кусок записи с двух сторон: в локальной расшифровке лекции выдуманная строка «Субтитры создавал DimaTorzok» нашлась 69 раз, а в официальных автосубтитрах того же ролика (их делает сама площадка) - ни разу, ноль совпадений
Механика простая. Модель училась на роликах вместе с их субтитрами, а в конце роликов часто стоит титр с именем автора субтитров. На участке без речи модель не молчит, а выдаёт самое вероятное продолжение, и им оказывается заученный титр
Это не моя частная беда. Работа Koenecke, Choi, Mei, Schellmann и Sloane «Careless Whisper: Speech-to-Text Hallucination Harms» 2024 года меряла то же самое на большом наборе записей и фиксирует: «roughly 1% of audio transcriptions contained entire hallucinated phrases or sentences which did not exist in any form in the underlying audio»
Про вред там сказано точнее, чем это обычно пересказывают. Дословно: «38% of hallucinations include explicit harms such as perpetuating violence, making up inaccurate associations, or implying false authority». То есть 38% вставок несут явный вред трёх видов: продолжение темы насилия, выдуманные связи между вещами и ложная ссылка на авторитет
Отдельно стоит знать, на чём это мерили. Авторы сравнивали записи людей с афазией и контрольную группу и нашли, что галлюцинации чаще выпадают тем, у кого в речи больше долгих участков без голоса. Мои 69 строк вылезли ровно там же: на паузе перед началом лекции. Сервисы пересказа предупреждают о том же своими словами: на странице Яндекс 300 внизу стоит «Пересказы основаны на оригинале, в них могут быть ошибки и неточности»
Что с этим делать, по шагам:
- Почисти повторы до сжатия. Строку, которая встречается десятками, видно командой
grep -c 'подозрительная фраза' konspekt-source.txtи убирается черезgrep -v - Требуй таймкоды в конспекте. Тезис без таймкода нечем проверить, тезис с таймкодом сверяется за пять секунд
- Сверь выборочно три места. Начало, середину, конец: если в этих трёх точках расшифровка совпала со звуком, остальному можно доверять с обычной осторожностью
- Отдельно проверь числа и имена. Именно на них распознавание ошибается тише всего: «сэм 2» вместо «SAM 2» модель сжатия примет как есть
Сколько это стоит и во что упираются лимиты
Локальный путь стоит ноль рублей за прогон, облачный считает минуты и мегабайты. Разница видна не на первой записи, а на десятой: своя машина не выставляет счёт за повтор, когда захотелось перегнать ту же лекцию другой моделью
Лимит, о который спотыкаются чаще всего, не денежный, а размерный. В официальном руководстве OpenAI по распознаванию речи стоит прямая строка: «Files can be up to 25 MB», а для длинных записей рекомендация «use a compressed audio format or split the file into chunks of 25 MB or less». Мой файл лекции весит 37 мегабайт, то есть в такую загрузку он не помещается и его пришлось бы резать на части
| Путь | Чем платишь | Потолок | Что уезжает наружу |
|---|---|---|---|
| Своя машина, whisper.cpp | временем прогона и местом на диске | упирается только в терпение | ничего, файл не покидает компьютер |
| Облачное распознавание по API | минутами записи, счёт помесячный | загрузка до 25 МБ за файл | вся запись целиком |
| Пересказчик по ссылке | обычно бесплатно, нужен аккаунт | работает со ссылкой, не с твоим файлом | ссылка на чужой публичный ролик |
Таблица прокручивается вбок →
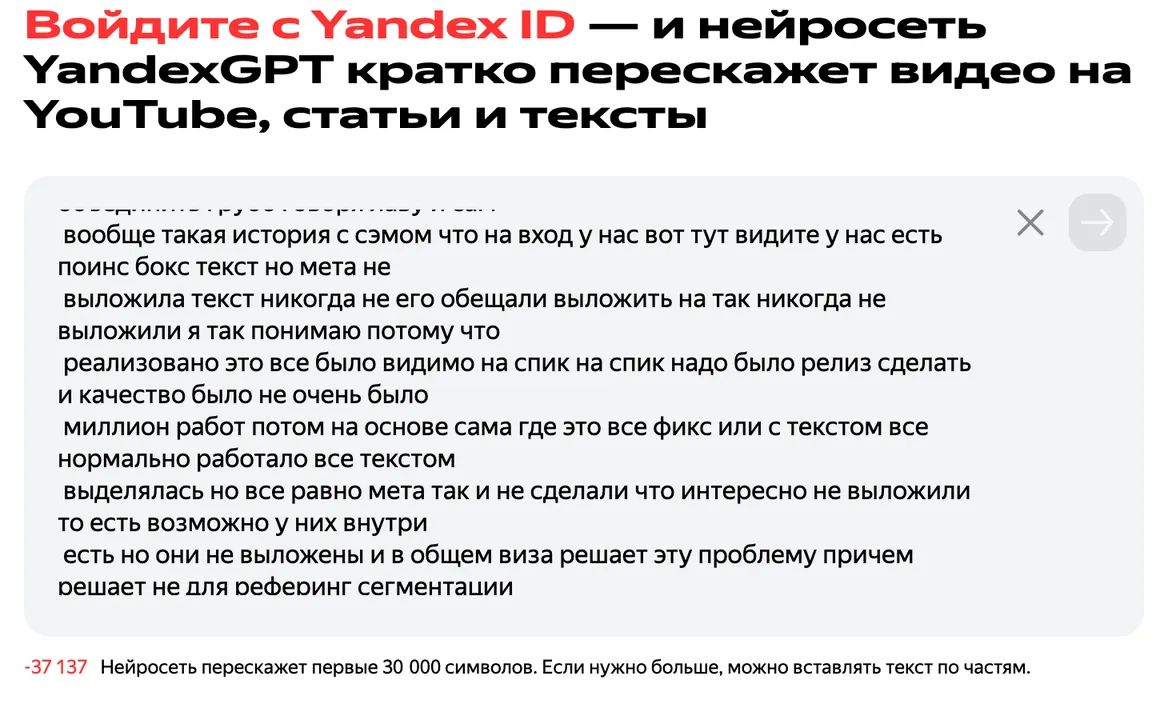
Третья строка таблицы про сервисы вроде Яндекс 300: туда вставляется ссылка на ролик или статью, и нейросеть возвращает короткий пересказ. Для «понять, о чём видео, не смотря его» этого хватает, для конспекта лекции с таймкодами и терминами обычно нет
Отдельная статья расходов, которую не видно на старте, это время на проверку. Час записи распознаётся за три минуты, а вот сверка чисел и имён в готовом конспекте занимает у меня минут десять на каждую лекцию. Эти десять минут не убираются никаким инструментом
Что из этого открывается из России
Из России без VPN открывается ровно то, что нужно для локального пути: и движок, и файл модели качаются напрямую. Часть облачных сервисов при этом сама сообщает, что регион не поддержан
Проверял 18 августа 2026 года с московского сервера - арендованного на время компьютера в дата-центре Москвы, потому что замер с моей машины про Россию ничего не говорит: она работает с турецкого адреса. Прямая ссылка на файл модели на huggingface.co открылась без обходных путей, то есть скачивание идёт без обходных путей
Вторая проверка интереснее. Адрес notebooklm.google.com сам перебросил мой запрос дальше, на страницу с пометкой location=unsupported в конце ссылки. Это уже не догадка по тому, что показал сайт технически, а прямое сообщение самого сервиса о том, что регион не обслуживается
Про остальные сервисы честно скажу, чего не знаю. Я проверил ровно две ссылки, те, что выше, и на них останавливаюсь. Гонять по остальным такую же команду смысла мало: сайт с защитой от ботов отвечает голому запросу без браузерного отпечатка ошибкой в любом случае, откуда бы тот ни пришёл, и делать из этой ошибки вывод «заблокирован для России» нельзя. Проверять их пришлось бы настоящим браузером с российского адреса, чего я не делал, поэтому вердикта по ним здесь нет
Практический итог для того, кто сидит в России: путь из этой статьи работает целиком, потому что после скачивания модели он вообще не ходит в сеть. Записи не уезжают на чужие серверы - на чужие компьютеры в интернете, счётчик минут не тикает, доступность чужого сервиса на результат не влияет
Рядом по теме есть отдельный разбор: Abacus AI ChatLLM из России в 2026
Грабли, на которых спотыкается новичок
Почти все сбои на этом пути приходятся на две вещи: формат звука и язык. Остальное встречается реже и лечится за минуту
- Движок не берёт mp3 напрямую. Команда падает или выдаёт пустой файл. Лечение: прогнать звук через
ffmpegс флагами-ar 16000 -ac 1, как в Шаге 2. Это не прихоть, модель обучена на 16 килогерцах - Не указан язык. На выходе русская лекция расшифрована латиницей или наполовину переведена на английский. Лечение: флаг
-l ruв команде. На смеси русского с англоязычными терминами модель без подсказки ошибается регулярно - Движок стоит, а модели нет. Ошибка говорит, что файл модели не найден. Homebrew (программа, которая ставила движок) про это предупреждает прямым текстом, но читают предупреждение не все. Лечение: скачать
.binотдельно и указать к нему полный путь через-m - Кончилось место на диске. Прогон обрывается на середине без внятного объяснения. Часовая лекция в mp3 весит десятки мегабайт, а её рабочая копия в wav разрастается в разы: мои 37 мегабайт превратились в 171
- Расшифровка целиком уехала в одно окно чата. Модель отвечает по первой трети текста и обрывается. Лечение: либо отдавать файл через Claude Code, который читает его с диска, либо резать текст на куски по 20-30 минут записи
- Конспект собран из грязной расшифровки. В тезисах появляется то, чего в лекции не звучало. Лечение из предыдущего раздела: почистить повторы, потребовать таймкоды, сверить три точки
Отдельная грабля не техническая. Запись живой встречи или созвона нельзя делать молча: собеседников надо предупредить до начала. К конспекту это отношения не имеет, к последствиям имеет самое прямое
Что меняется, когда конспект перестаёт быть ручной работой
Меняется не скорость чтения, а список того, что вообще доходит до работы. Пока конспект стоит полутора часов ручного труда, до конспекта доживают две записи из десяти: остальные лежат в закладках и там же умирают. Когда цена падает до трёх минут машинного времени, планка «стоит ли это разбирать» опускается почти до нуля
У меня это выглядит так. Созвон, который раньше остался бы в памяти двух человек, теперь оставляет файл с таймкодами. Лекция, которую было жалко смотреть полтора часа, разбирается по конспекту за три минуты, и уже по нему видно, надо ли смотреть целиком. Вебинар конкурента превращается в набор тезисов, которые можно положить рядом с чужими тезисами и сравнить
И тут же встаёт настоящая граница. Расшифровка это сырьё, а не результат. Файл с тезисами сам по себе никуда не двигает: он лежит в папке ровно так же, как лежала запись до него. Работать начинает следующий слой, где конспекты складываются в базу, база отвечает на вопросы, а из ответов собирается что-то, за что платят
Этот следующий слой в одну статью не помещается, и притворяться, что помещается, не буду. Здесь ты получаешь рабочий инструмент: час записи в структурированный текст, бесплатно, на своей машине, без загрузки в чужое облако. Что строить дальше, решается уже не набором команд
Источники
- whisper.cpp - репозиторий (папка с кодом на GitHub) команды ggml-org: описание движка, лицензия MIT, как выглядит команда
whisper-cli, таблица моделей. Проверено 18.08.2026 - whisper.cpp, список ggml-моделей - размеры файлов моделей, включая large-v3-turbo и его сжатую версию
- whisper.cpp, страница релизов - актуальный выпуск v1.9.2 с меткой Latest на дату скрина
- OpenAI Whisper, репозиторий - число параметров моделей, сколько памяти нужно каждой, описание модели turbo, лицензия MIT на код и веса
- OpenAI, руководство Speech to text - лимит загрузки 25 МБ на файл и рекомендация резать длинные записи
- Homebrew - так называется программа, которая сама ставит нужные инструменты одной командой; здесь её версия для whisper-cpp, 1.9.2, команда установки, оговорка про то, что модели не скачиваются сами
- Koenecke A. и др. Careless Whisper: Speech-to-Text Hallucination Harms, 2024 - доля записей с целиком выдуманными фразами и доля вредных вставок
- Яндекс 300, пересказ ссылок и текстов - что принимает сервис и его собственная оговорка про ошибки в пересказах
Памятка: от записи до конспекта за семь строк
По строке на шаг, порядок не переставляется
Сохрани себе
- Источник определён: ролик на площадке, свой файл или живая встреча
- Для ролика субтитры забраны одной командой, распознавание не запускалось
- Под свой файл освобождено около двух гигабайт и поставлен движок распознавания
- Модель скачана отдельным файлом, путь к ней подставлен в команду через -m
- Звук приведён к 16 килогерцам и одной дорожке, в команде указан язык записи
- Расшифровка почищена от повторяющихся выдуманных строк до сжатия
- В готовом конспекте выборочно сверены числа, имена и три точки записи по таймкодам
Третий вопрос себе
«Хорошо, текст у меня есть. А дальше-то что?»
Этот вопрос встал у меня самого, когда папка с конспектами выросла до полусотни файлов, а работы они за меня так и не сделали. Расшифровка - сырьё, и превратить сырьё в то, за что платят, инструмент не умеет: это отдельный навык, и именно ему учит ИИ-Лагерь
Частые вопросы
Как сделать конспект видео с ютуба?
Скачать готовые автоматические субтитры и сжать их промптом. Команда yt-dlp --skip-download --write-auto-subs --sub-langs ru --convert-subs srt забирает текст без самого видео: на лекции длиной 1:33:37 файл на 510 килобайт приехал за секунду. Распознавание в этом случае запускать не нужно вовсе
Какая нейросеть делает конспект лекции бесплатно?
Whisper от OpenAI: и код, и веса модели выложены под лицензией MIT, а гонять её на своей машине можно движком whisper.cpp, тоже открытым и тоже под MIT. Платить не нужно ни за прогон, ни за минуты записи. Платные тут только облачные варианты, где считают минуты и ограничивают размер загружаемого файла
Сколько времени занимает конспект часовой записи?
На моей машине лекция длиной 1:33:37 распозналась за 182.44 секунды, то есть примерно в 30 раз быстрее реального времени. Плюс три секунды на конвертацию звука. Сжатие текста промптом добавляет ещё немного времени сверху, но отдельно секундомер на этот шаг я не ставил. На более слабом железе цифра будет другой, и для него есть модели поменьше
Можно ли сделать конспект урока с телефона?
Для ролика по ссылке да: сервисы пересказа работают в браузере и телефона им достаточно. Для своей записи нет: модель распознавания весит полтора гигабайта и требует памяти, поэтому путь из этой статьи рассчитан на компьютер
Почему в конспекте появляются фразы, которых в записи не было?
Потому что на участках тишины и плохого звука модель распознавания не молчит, а выдаёт самое вероятное продолжение. В моей расшифровке так появилось 69 копий титра, которого в лекции нет. Исследование Koenecke и соавторов 2024 года намерило на своём наборе записей около 1% таких вставок, причём чаще они выпадали там, где в речи много долгих участков без голоса. Лечится чисткой повторов до сжатия и выборочной сверкой по таймкодам
Нужен ли VPN, чтобы это работало из России?
Для локального пути нет. Проверено 18 августа 2026 года с московской точки: прямая ссылка на файл модели открывается, то есть скачивание идёт напрямую. После того как модель лежит на диске, распознавание вообще не ходит в сеть. Часть облачных сервисов при этом сама сообщает, что регион не поддерживается