Нейросети и инструменты · сентябрь 2026
Gemini Transcribe: 4 шага до расшифровки часа аудио бесплатно
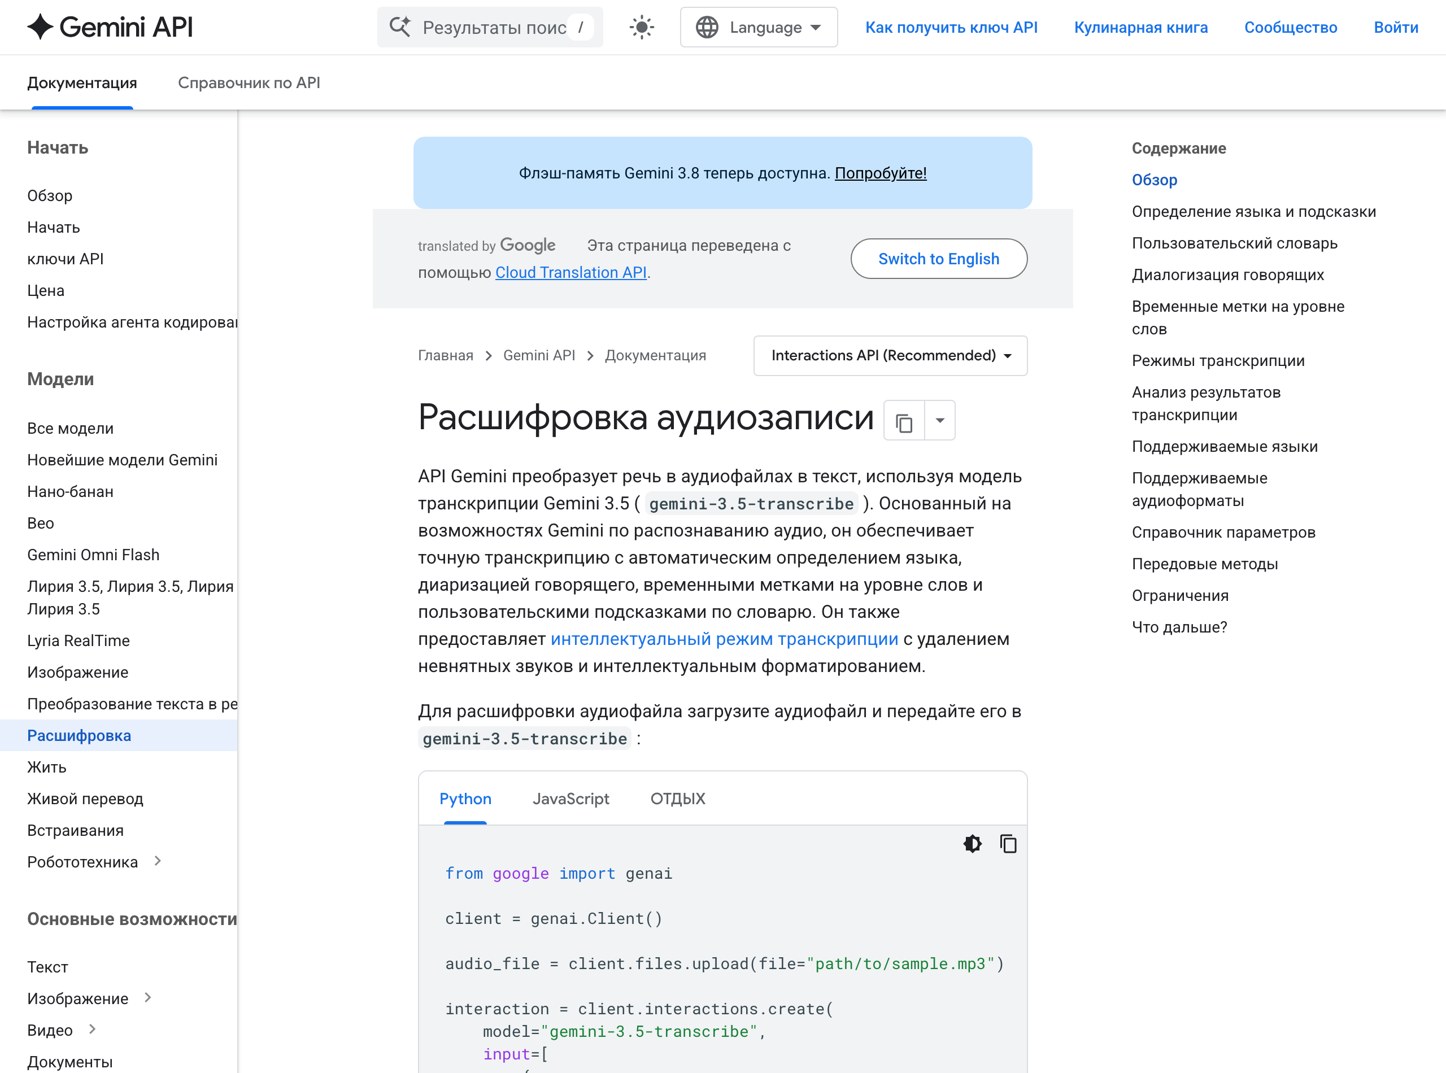
26 августа 2026 Google выпустил Gemini 3.5 Transcribe - отдельную модель, которая переводит звук из аудиофайла в готовый текст. Дальше в статье - как этой моделью получить из часовой записи (лекции, созвона, интервью) читаемый текст, во сколько это обходится и что проверить перед тем, как доверить ей личный разговор
Расшифровать час аудио новой моделью Google можно без установки программ и без единой потраченной копейки: прикрепить файл к сообщению и текстом попросить его расшифровать. Дальше - как это устроено внутри, какие есть ограничения и куда идти, если запись длиннее часа или Google у тебя не открывается
Загрузи аудиофайл в чат AI Studio и попроси текстом расшифровать его - ответ придёт готовым текстом за одну-две минуты, без установки программ и без денег. Файл длиннее часа - раздели на части. Нужны имена говорящих и точное время каждой фразы - для этого есть отдельный путь через личный ключ доступа
Что такое Gemini 3.5 Transcribe и чем это НЕ является
Первая путаница, которую стоит снять сразу: это НЕ новая версия обычного чата, с которым ты, возможно, уже переписывался. Основная линейка моделей чата (3.7 Flash и другие на 18 августа 2026) разобрана в отдельном материале про сам чат этой компании - транскрипция вышла на неделю позже как отдельный, узкоспециализированный продукт под одну конкретную задачу. Если интересно, как этот чат смотрится рядом с другими флагманами рынка - есть отдельное сравнение крупных нейросетей
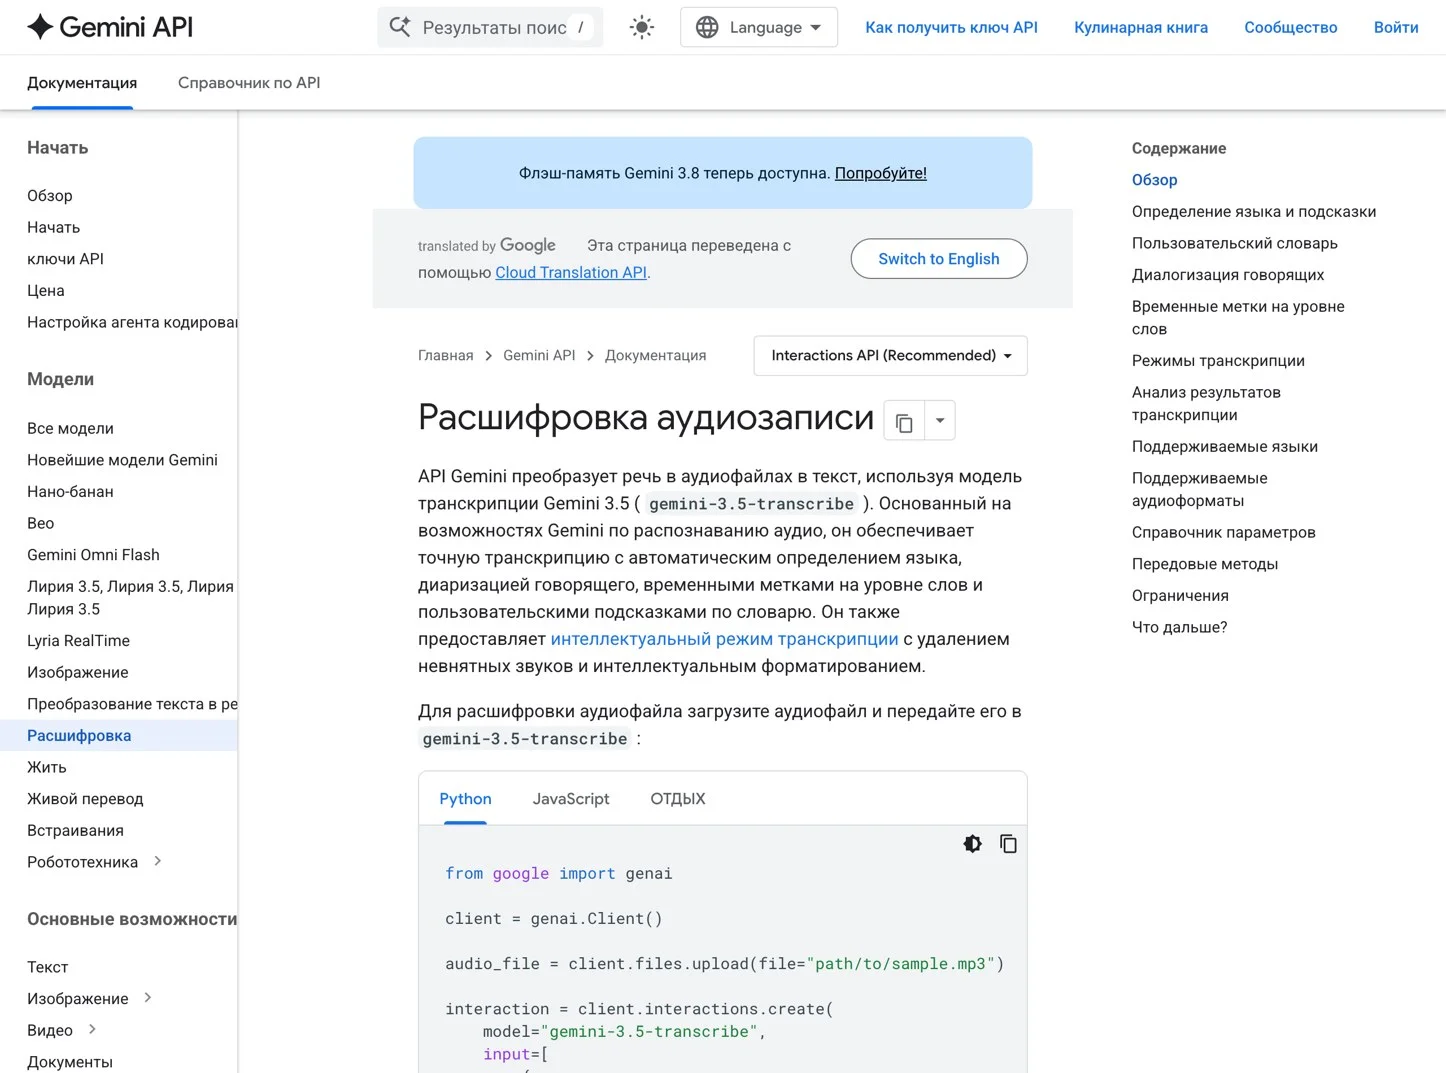
По документации разработчика функция «превращает необработанный звук из аудиофайла прямо в точный, отформатированный текст» - сама определяет говорящего, расставляет знаки препинания и убирает слова-паразиты вроде «эээ» и «ну». Результат выглядит как чистовик, а не сырая распечатка
«Модель преобразует необработанный аудиоконтент прямо в точный, отполированный текст с форматированием»
- анонс компании, 26 августа 2026
Что это тебе даёт: ты сразу ищешь нужную функцию, а не путаешь её с обычным разговором в переписке - формально похожие названия, а задачи совсем разные
Что приготовить заранее
Первая фраза ответа: ничего технического готовить не нужно, хватит двух вещей - самой записи и обычного личного входа
Запись подходит в любом ходовом формате (mp3, wav, m4a, aac) - конвертировать заранее не придётся, форматы принимаются напрямую. Вход - обычный личный аккаунт, тот же, что для почты, отдельная регистрация под эту функцию не нужна
Что это тебе даёт: с готовым файлом и обычным входом весь путь до текста занимает не больше нескольких минут. Если аккаунта ещё нет вообще ни для одного инструмента такого рода - обзор бесплатных нейросетей под разные задачи поможет понять, с чего начать список
Шаг 1. Рабочая панель вместо обычного чата
По документации разработчика функция доступна через рабочую панель AI Studio, а не через привычное окно, где обычно печатают вопросы модели - это отдельный раздел с работой напрямую с файлами, ключами и настройками ответа. Как в неё попасть и что там устроено, подробно с проверкой каждого экрана разобрано в отдельном материале про получение личного ключа для этой же панели - здесь эта часть не дублируется, а сразу переходим к тому, что происходит внутри именно с аудиозаписью
Что происходит внутри, по документации разработчика
- Запись прикладывается вложением как обычный файл к сообщению - никакого отдельного окна загрузки для аудио не предусмотрено
- Модель получает задачу текстом формулировка вроде «расшифруй это аудио» рядом с прикреплённым файлом
- Ответ приходит текстом в тот же чат без отдельного файла для скачивания - готовый текст печатается прямо в переписке
Что это тебе даёт: одна и та же панель обслуживает сразу несколько задач с файлами (текст, картинки, звук) - расшифровка не отдельный сервис, а один из режимов уже знакомого интерфейса. Та же модель умеет создавать готовые документы прямо из переписки - похожий принцип разобран в материале про создание файлов Word и Excel без установки программ, только там это делает другой инструмент того же класса
Шаг 2. Прикрепи запись и опиши задачу словами
По документации разработчика достаточно прикрепить аудиофайл к сообщению и текстом описать, что с ним сделать - формулировки вроде «расшифруй это аудио полностью» хватает, специальной команды или синтаксиса не требуется
Ответ приходит текстом за одну-две минуты для короткой записи, для часовой может понадобиться чуть больше времени. По документации в ответе может стоять разметка по говорящим, если в записи несколько голосов - модель сама распознаёт смену собеседника
Официальный лимит на такой запрос - до одного часа звука за раз, это прямо прописано в документации:
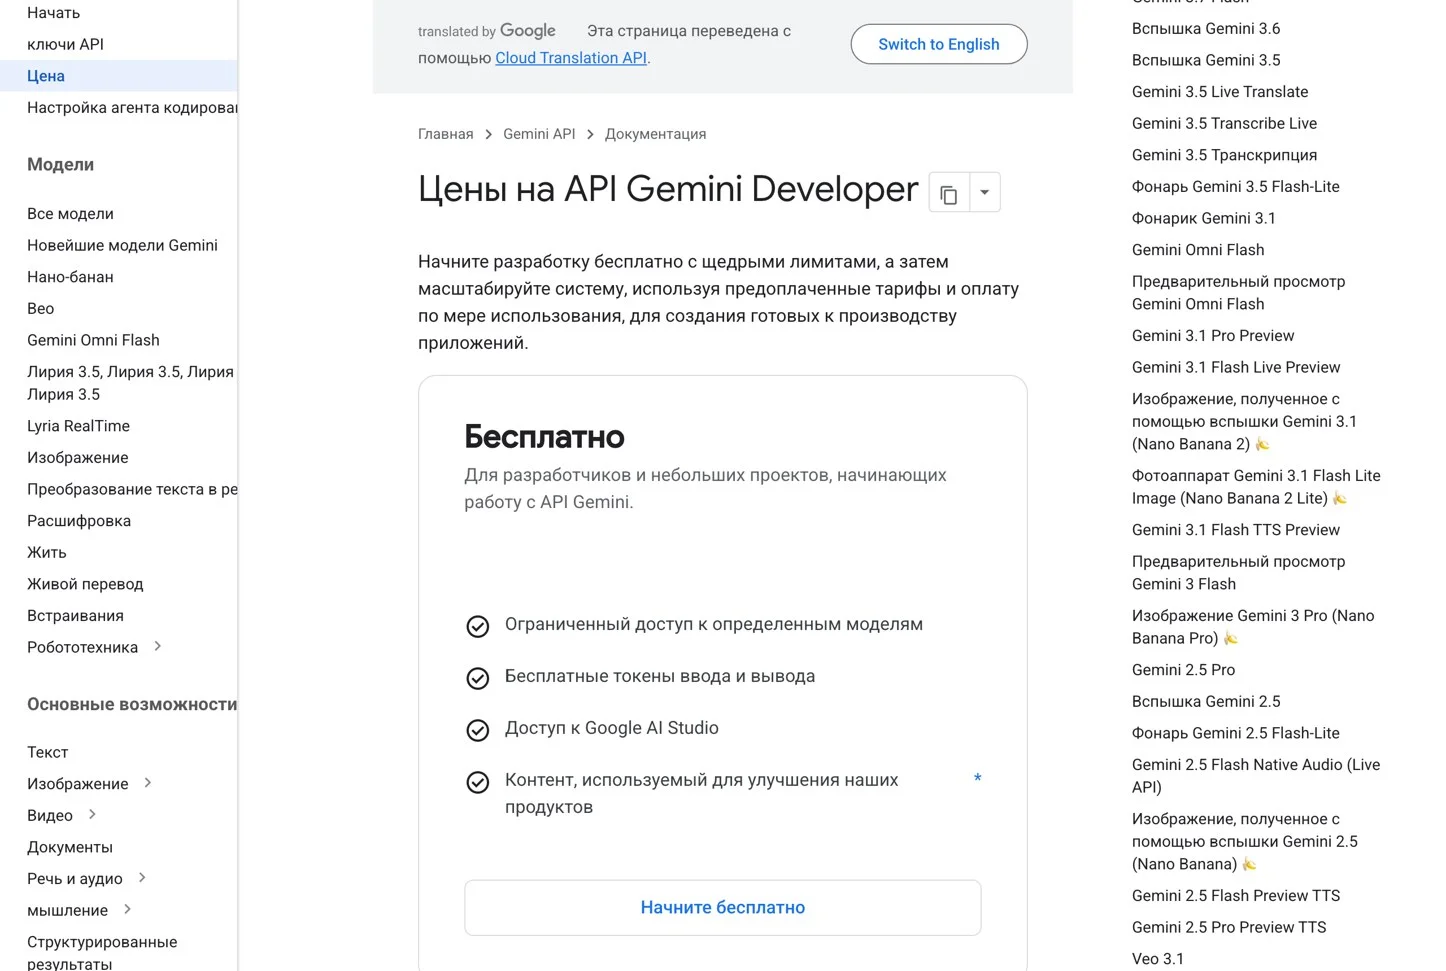
Функция входит в бесплатный уровень полностью - платить нужно только за очень большие объёмы, счётчик идёт по минутам звука, и одна личная запись в месяц в него не упирается
Какие форматы записи принимает функция
Первая фраза ответа: почти любой обычный аудиофайл подходит без конвертации - по документации разработчика список поддерживаемых форматов широкий
| Формат | Расширение файла | Где обычно встречается |
|---|---|---|
| MP3 | .mp3 | Самый частый формат для готовых записей и подкастов |
| WAV | .wav | Несжатая запись с диктофонов и профессиональных микрофонов |
| M4A | .m4a | Стандартный формат записи на iPhone и в приложении Голосовые заметки |
| AAC | .aac | Часто встречается в записях с Android-устройств |
| FLAC | .flac | Формат без потери качества, реже, но тоже принимается |
Таблица прокручивается вбок →
Таблица прокручивается вбок →
Что это тебе даёт: не нужно тратить время на поиск конвертера - запись с телефона, диктофона или профессионального микрофона в подавляющем большинстве случаев подходит как есть
Шаг 3. Раздели длинную запись заранее
Официальный лимит одного запроса - час звука, а с включённой разметкой по говорящим и точным временем каждой фразы - тридцать минут. Дальше: запись длиннее этого стоит разрезать заранее в любом бесплатном редакторе аудио (подойдёт даже встроенный диктофон на телефоне) на два-три файла по 40-50 минут
Что это тебе даёт: вместо одного отказа с ошибкой на середине часа приходит несколько отдельных расшифровок, которые остаётся собрать в один документ простым копированием текста друг за другом
Шаг 4. Если нужны имена говорящих и точное время каждой фразы
Первая фраза ответа: базовый режим не всегда подписывает, кто именно что сказал - для протокола встречи с несколькими голосами иногда важны точные имена и время каждой реплики, и это отдельная возможность той же модели
По документации разметка по говорящим и метки времени на уровне отдельных слов доступны не в обычной переписке, а через персональный ключ доступа - тот же самый, что описан в материале про подключение AI Studio к своим программам. Ключ передаётся программе, а дальше именно она задаёт модели точный формат ответа с именами и временем вместо простого текста
Что это тебе даёт: если хватает обычного текста без разметки по говорящим - три предыдущих шага уже закрывают задачу целиком, ключ нужен только когда важно точно знать, кто и когда что произнёс
Если сервис не открывается напрямую
Первая фраза ответа: доступ к сервисам компании из некоторых стран официально ограничен по региону - и расшифровка звука не исключение из этого правила
На соседней странице про сам чат этой компании 18 августа 2026 зафиксирован прямой замер: адрес отвечал с российского адреса быстро, сеть его не режет - ограничение стоит именно со стороны компании, по региону аккаунта, а не наоборот. Практический вывод: нужен обходной канал доступа или сервис-посредник, который даёт доступ к тем же моделям без прямого обхода - подробный разбор рабочих способов уже собран на той же соседней странице, повторять его здесь смысла нет
Своя проверка доступности, 05.09.2026
Запросил обе страницы (обычный чат и рабочую панель) со своей рабочей точки: страница чата открылась за 0,91 секунды, а рабочая панель перебросила на форму входа за 0,33 секунды - обе живые, ни одна не молчит. Но моя рабочая точка находится не в России (Нидерланды, служебный дата-центр) - честная оговорка: замер показывает, что серверы компании отвечают быстро, а не то, что доступ работает из России без обходного канала
Что это тебе даёт: не тратишь время на прямые попытки там, где ограничение стоит на стороне самой компании
Офлайн-путь без загрузки записи в чужое облако
Первая фраза ответа: если доступ закрыт совсем или запись слишком личная, чтобы отправлять её наружу, у задачи «файл в текст» есть путь без интернета вообще - через открытую модель Whisper, которая работает прямо на компьютере
Важно не перепутать это с диктовкой на лету: диктовка - это когда говоришь, а текст появляется по ходу речи, тому посвящён отдельный материал про включение диктовки на компьютере. Здесь другая задача - готовый файл записи целиком превращается в текст за один проход, а не по ходу разговора
Полный разбор трёх способов такой офлайн- и онлайн-расшифровки (что выбрать по деньгам и по объёму записей) уже собран отдельно на странице чем ещё расшифровать аудио в текст - там разбираются другие сервисы этой задачи, здесь же речь только про функцию одной конкретной компании
| Путь | Стоимость | Файл покидает компьютер | Нужна установка |
|---|---|---|---|
| Рабочая панель компании | Бесплатно до больших объёмов | Да, уходит в облако | Нет, работает в браузере |
| Whisper.cpp | Бесплатно навсегда | Нет, всё на своём диске | Да, разовая настройка через команды |
| MacWhisper | Бесплатная версия есть, полная - 65 евро разово | Нет, всё на своём диске | Да, обычная установка программы |
Таблица прокручивается вбок →
Таблица прокручивается вбок →
Что это тебе даёт: выбор между удобством облака (ничего не ставить, файл уходит наружу) и приватностью офлайна (файл остаётся на месте, но нужна разовая настройка) - какой путь выбрать, зависит от того, что именно записано на этом часе
Лимиты по времени: базовый режим против режима с именами говорящих
Первая фраза ответа: у функции два разных потолка по длительности, и путать их - частая причина недоразумений
| Режим | Максимум за один запрос | Что получаешь на выходе |
|---|---|---|
| Базовый (просто текст) | 60 минут | Сплошной читаемый текст без разметки по говорящим |
| С именами говорящих и временем реплик | 30 минут | Текст с подписью, кто говорил и в какую секунду |
Таблица прокручивается вбок →
Таблица прокручивается вбок →
Что это тебе даёт: если запись длится 45 минут и нужен только текст - делить её не придётся, а вот для того же файла с именами говорящих деление уже понадобится
Русский язык: подтверждено официально
Первая фраза ответа: поддержка русской речи у этой функции подтверждена официально, не косвенно и не догадкой
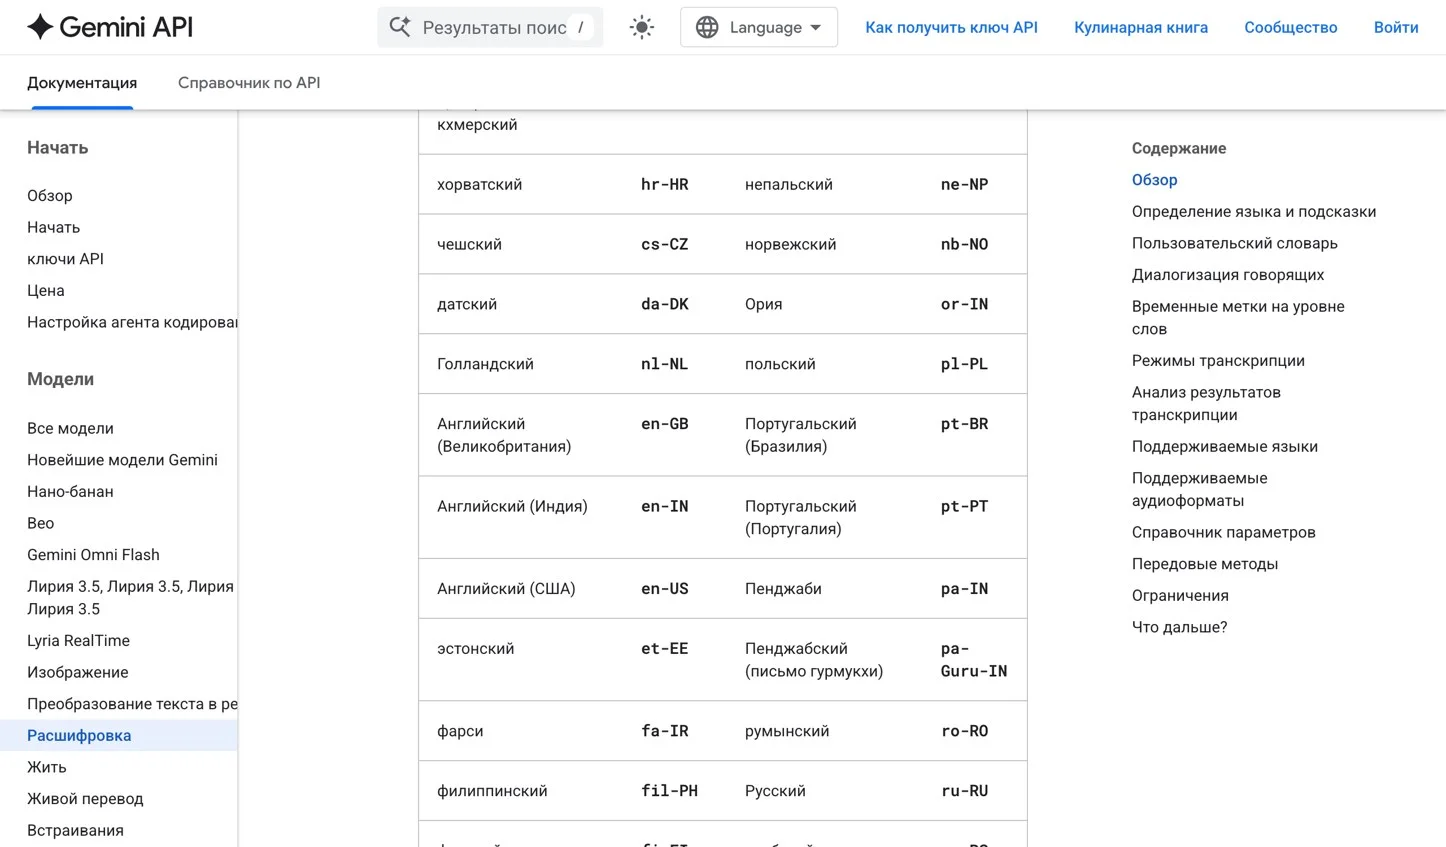
По документации разработчика функция поддерживает больше 85 языков и сама определяет, на каком языке идёт речь, даже если в одной записи несколько языков сразу - переключать ничего вручную не нужно
Что это тебе даёт: загружаешь файл с русской речью как есть, без предварительной настройки языка
Пять ошибок при работе с этой функцией
Пять ошибок и что вместо них
- Загружают запись длиннее часа и получают обрыв на середине лимит официальный, не сбой - запись нужно заранее разделить на части по шагу 3
- Просят имена говорящих и точное время прямо в обычной переписке эта возможность работает только через личный ключ доступа, в обычном чате её нет - см. шаг 4
- Путают новую функцию с обновлением обычного чата это разные продукты одной компании, вышедшие в разные даты - см. первый раздел статьи
- Пытаются зайти напрямую там, где стоит региональное ограничение, и решают, что сервис сломан сервис работает, ограничение стоит на стороне компании - см. раздел про доступ
- Загружают чувствительную запись, не подумав, куда уходит файл для личных или конфиденциальных записей офлайн-путь через Whisper безопаснее - см. раздел выше
- Настраивают расшифровку с нуля там, где уже работает Claude Code если рабочий инструмент уже стоит на компьютере, проще подключить к нему готовый навык - см. [расшифровка через отдельный навык](/guide-whisper-skill-claude/)
Что почитать дальше на этом же сайте
Расшифровка звука - только одна функция в экосистеме инструментов, и рядом с ней есть ещё несколько связанных тем
- Сам чат этой компании: 6 шагов до первого ответа - если ещё не пользовался обычной перепиской и нужен вход с нуля
- Получение личного ключа для AI Studio за 3 шага - продвинутый путь с именами говорящих и временем реплик начинается именно с этого ключа
- Чем ещё расшифровать аудио в текст: 3 способа - если нужно сравнение с другими сервисами и офлайн-вариантами по деньгам
- Голосовой ввод: 3 способа включить бесплатно - если нужна диктовка на лету, а не расшифровка готового файла
- Нейросеть для перевода видео: 5 шагов до русской озвучки - смежная задача, когда запись нужно не расшифровать, а перевести на другой язык
- Расшифровка через отдельный навык в Claude - ещё один путь для тех, кто уже работает в этой среде
- Нейросети и инструменты - полный список материалов про инструменты на этом сайте
Источники
Все страницы открыты живьём 05.09.2026, замер доступности через curl - собственный own-run того же дня
- Официальный анонс модели: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5-transcribe
- Официальная карточка модели в документации разработчика: ai.google.dev/gemini-api/docs/models/gemini-3.5-transcribe
- Документация по расшифровке: лимиты, форматы, языки - ai.google.dev/gemini-api/docs/transcribe
- Та же документация, раздел про языки: строка «Русский | ru-RU» - ai.google.dev/gemini-api/docs/transcribe#supported-languages
- Страница тарифов, подтверждение бесплатного уровня - ai.google.dev/gemini-api/docs/pricing
- 9to5Google, независимый разбор анонса: 9to5google.com/2026/08/26/gemini-3-5-transcribe
Памятка: расшифровка часа аудио бесплатно
Пять строк, по которым проходит весь путь
Сохрани себе
- Функция живёт в рабочей панели AI Studio, отдельно от привычного окна переписки
- Запись прикладывается вложением, задача описывается текстом рядом с ней
- Лимит - час звука на один запрос, длиннее - разбить на части по 40-50 минут
- Имена говорящих и точное время реплик - только через личный ключ доступа
- Доступ закрыт по региону или запись слишком личная - офлайн-путь через Whisper
Что дальше
Через три дня расшифровка становится частью системы, а не разовым фокусом
Люди, которые приходили с одной надиктованной лекцией, к третьему дню показывают в чате конспекты, разложенные по темам, и планы, собранные из трёх созвонов сразу Три дня, бесплатно, начать можно сегодня
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Сколько стоит расшифровка звука этой функцией?
Ничего, если это одна-две личные записи в месяц - функция входит в бесплатный уровень целиком, счётчик платы начинается только на очень больших объёмах, недоступных обычному человеку за один месяц
Какой максимальный размер записи можно загрузить?
Официальный лимит - час звука на один запрос без дополнительных возможностей, тридцать минут - если включена разметка по говорящим и время каждой фразы. Запись длиннее нужно заранее разделить любым бесплатным редактором аудио
Понимает ли эта функция русскую речь?
Да, официально подтверждено - русский язык входит в список из 85+ языков, которые распознаются и расшифровываются автоматически, включать его отдельно не требуется
Чем это отличается от обычной переписки с моделью?
Это отдельный продукт именно для перевода звука в текст, вышедший позже основной линейки чата (26 августа против 18 августа у актуальной на тот момент версии чата) - другая задача, не разговор, а расшифровка готовой записи
Что делать, если сервис не открывается из России?
Зайти напрямую без обходного канала не получится - ограничение стоит со стороны компании по региону аккаунта. Рабочие способы подключения подробно разобраны в материале про сам чат этой компании
Можно ли расшифровать звук совсем без интернета?
Да, через открытую модель Whisper - она работает полностью на своём компьютере, без передачи файла куда-либо. Настройка медленнее, зато запись никогда не покидает устройство; сравнение способов - в материале чем ещё расшифровать аудио в текст
Куда девать готовый текст расшифровки дальше?
Смотря какая задача стояла изначально: если нужен был просто текст для поиска и цитирования - расшифровка уже финал. Если из неё предстоит собрать конспект, план или пост - для этого нужен уже не разовый чат, а инструмент, которому можно объяснить дальнейшую задачу словами, как в материале про ключ доступа к рабочей панели