Текст для нейросетей · плотность фактов
Текст, который цитируют нейросети в 2026 году: проверь свой сейчас
Открой свой текст и пройди по нему один раз: есть ли в каждом абзаце факт с числом, датой или ссылкой на источник, а не просто общее утверждение. Абзац без этого машина при сборке ответа пропускает мимо, даже если он написан хорошим языком. Дальше в статье - готовый промпт, который делает эту проверку за один запрос и находит конкретные слабые места
К концу статьи у тебя будет: 4 вопроса, по которым проверяется любой абзац, список приёмов с измеренным эффектом (и список приёмов, которые не работают вообще), и готовый промпт для самопроверки текста в любом ИИ-чате - вставляешь и получаешь список абзацев на переписывание. Если у тебя ещё не настроено окно, где удобно держать рядом черновик и переписку с ИИ, для начала пригодится короткий разбор Claude Code с нуля
Возьми свой текст и прогони его через готовый промпт из этой статьи (раздел «Промпт для самопроверки») - вставь промпт и свой текст в любой чат с ИИ одним сообщением. За один запрос модель построчно покажет, в каких абзацах нет извлекаемого факта и что именно добавить: дату, источник или конкретный объект
Что вообще значит «текст, который цитируют»
Когда человек спрашивает у ChatGPT, Perplexity или Google AI Overviews что-то конкретное, машина не просто ищет страницы по ключевым словам - она читает несколько кандидатов и выбирает, чьи именно фразы вставить в готовый ответ прямой цитатой или пересказом близко к тексту. Твоя страница может быть проиндексирована, может даже стоять высоко в обычной выдаче - и всё равно ни разу не попасть в такой ответ, если из неё нечего процитировать
Разница между «текст, который читают» и «текст, который цитируют» - это разница между общим впечатлением от статьи и конкретным извлекаемым куском. Абзац «сервисы для работы с текстом сильно изменились за последний год» читать приятно, но процитировать нечего: нет числа, нет даты, нет ни одного факта, который можно вырвать из контекста и вставить в чужой ответ. Абзац «12 августа 2026 года независимый разбор показал прирост цитируемости на 40% при добавлении статистики в текст» - готовая цитата, машине не нужно ничего додумывать
Если ты пишешь через готовые промпты, а не с чистого листа, у Claude на каждый день есть набор рабочих формулировок на такие случаи - в том числе для того, чтобы сразу просить модель добавить факт с датой, а не общую фразу
Проверь абзац по 4 вопросам: утверждение, объект, время, условие
В основе плотности лежит простое правило: полезный для машины абзац несёт не общее рассуждение, а конкретную единицу факта. Возьми любой свой абзац и ответь по нему на 4 вопроса подряд - если хотя бы на один ответа нет, факт не извлекаемый
4 вопроса к абзацу - проверь свой прямо сейчас
- Что произошло? ищи глагол действия, а не оценку - «выросло», «показало», «добавили», а не «стало лучше». Нет глагола действия - вопрос не закрыт
- К чему это относится? ищи конкретный метод, инструмент или страницу, а не местоимение «это» или «такой подход». Абзац без названного объекта машина не сможет привязать факт ни к чему конкретному
- Когда это измерено? ищи дату, а не слово «недавно» или «сейчас». Без даты число через полгода читается как устаревшее вранье, а не как факт с историей
- При каких условиях это верно? ищи, на каких данных, для какой группы или при каком пороге верно утверждение. Без условия число выглядит универсальным законом, хотя таким почти никогда не бывает
Пример неплотного абзаца: «Добавление источников в текст помогает нейросетям его цитировать» - на все 4 вопроса ответа нет: какое действие? нет глагола. К чему? непонятно. Когда? Не сказано. При каких условиях? Неизвестно
Пример плотного абзаца: «По данным исследования Принстонского университета 2026 года, добавление ссылок на источники в текст статьи подняло видимость в ответах ИИ на 30-40%, а у страниц вне топ-5 выдачи - на 115% (условие: контролируемая среда с пятью источниками на один запрос)» - подняло видимость (что произошло), добавление ссылок на источники (к чему относится), 2026 год (когда), контролируемая среда с пятью источниками (при каких условиях). Из него машина может вытащить готовую цитату целиком
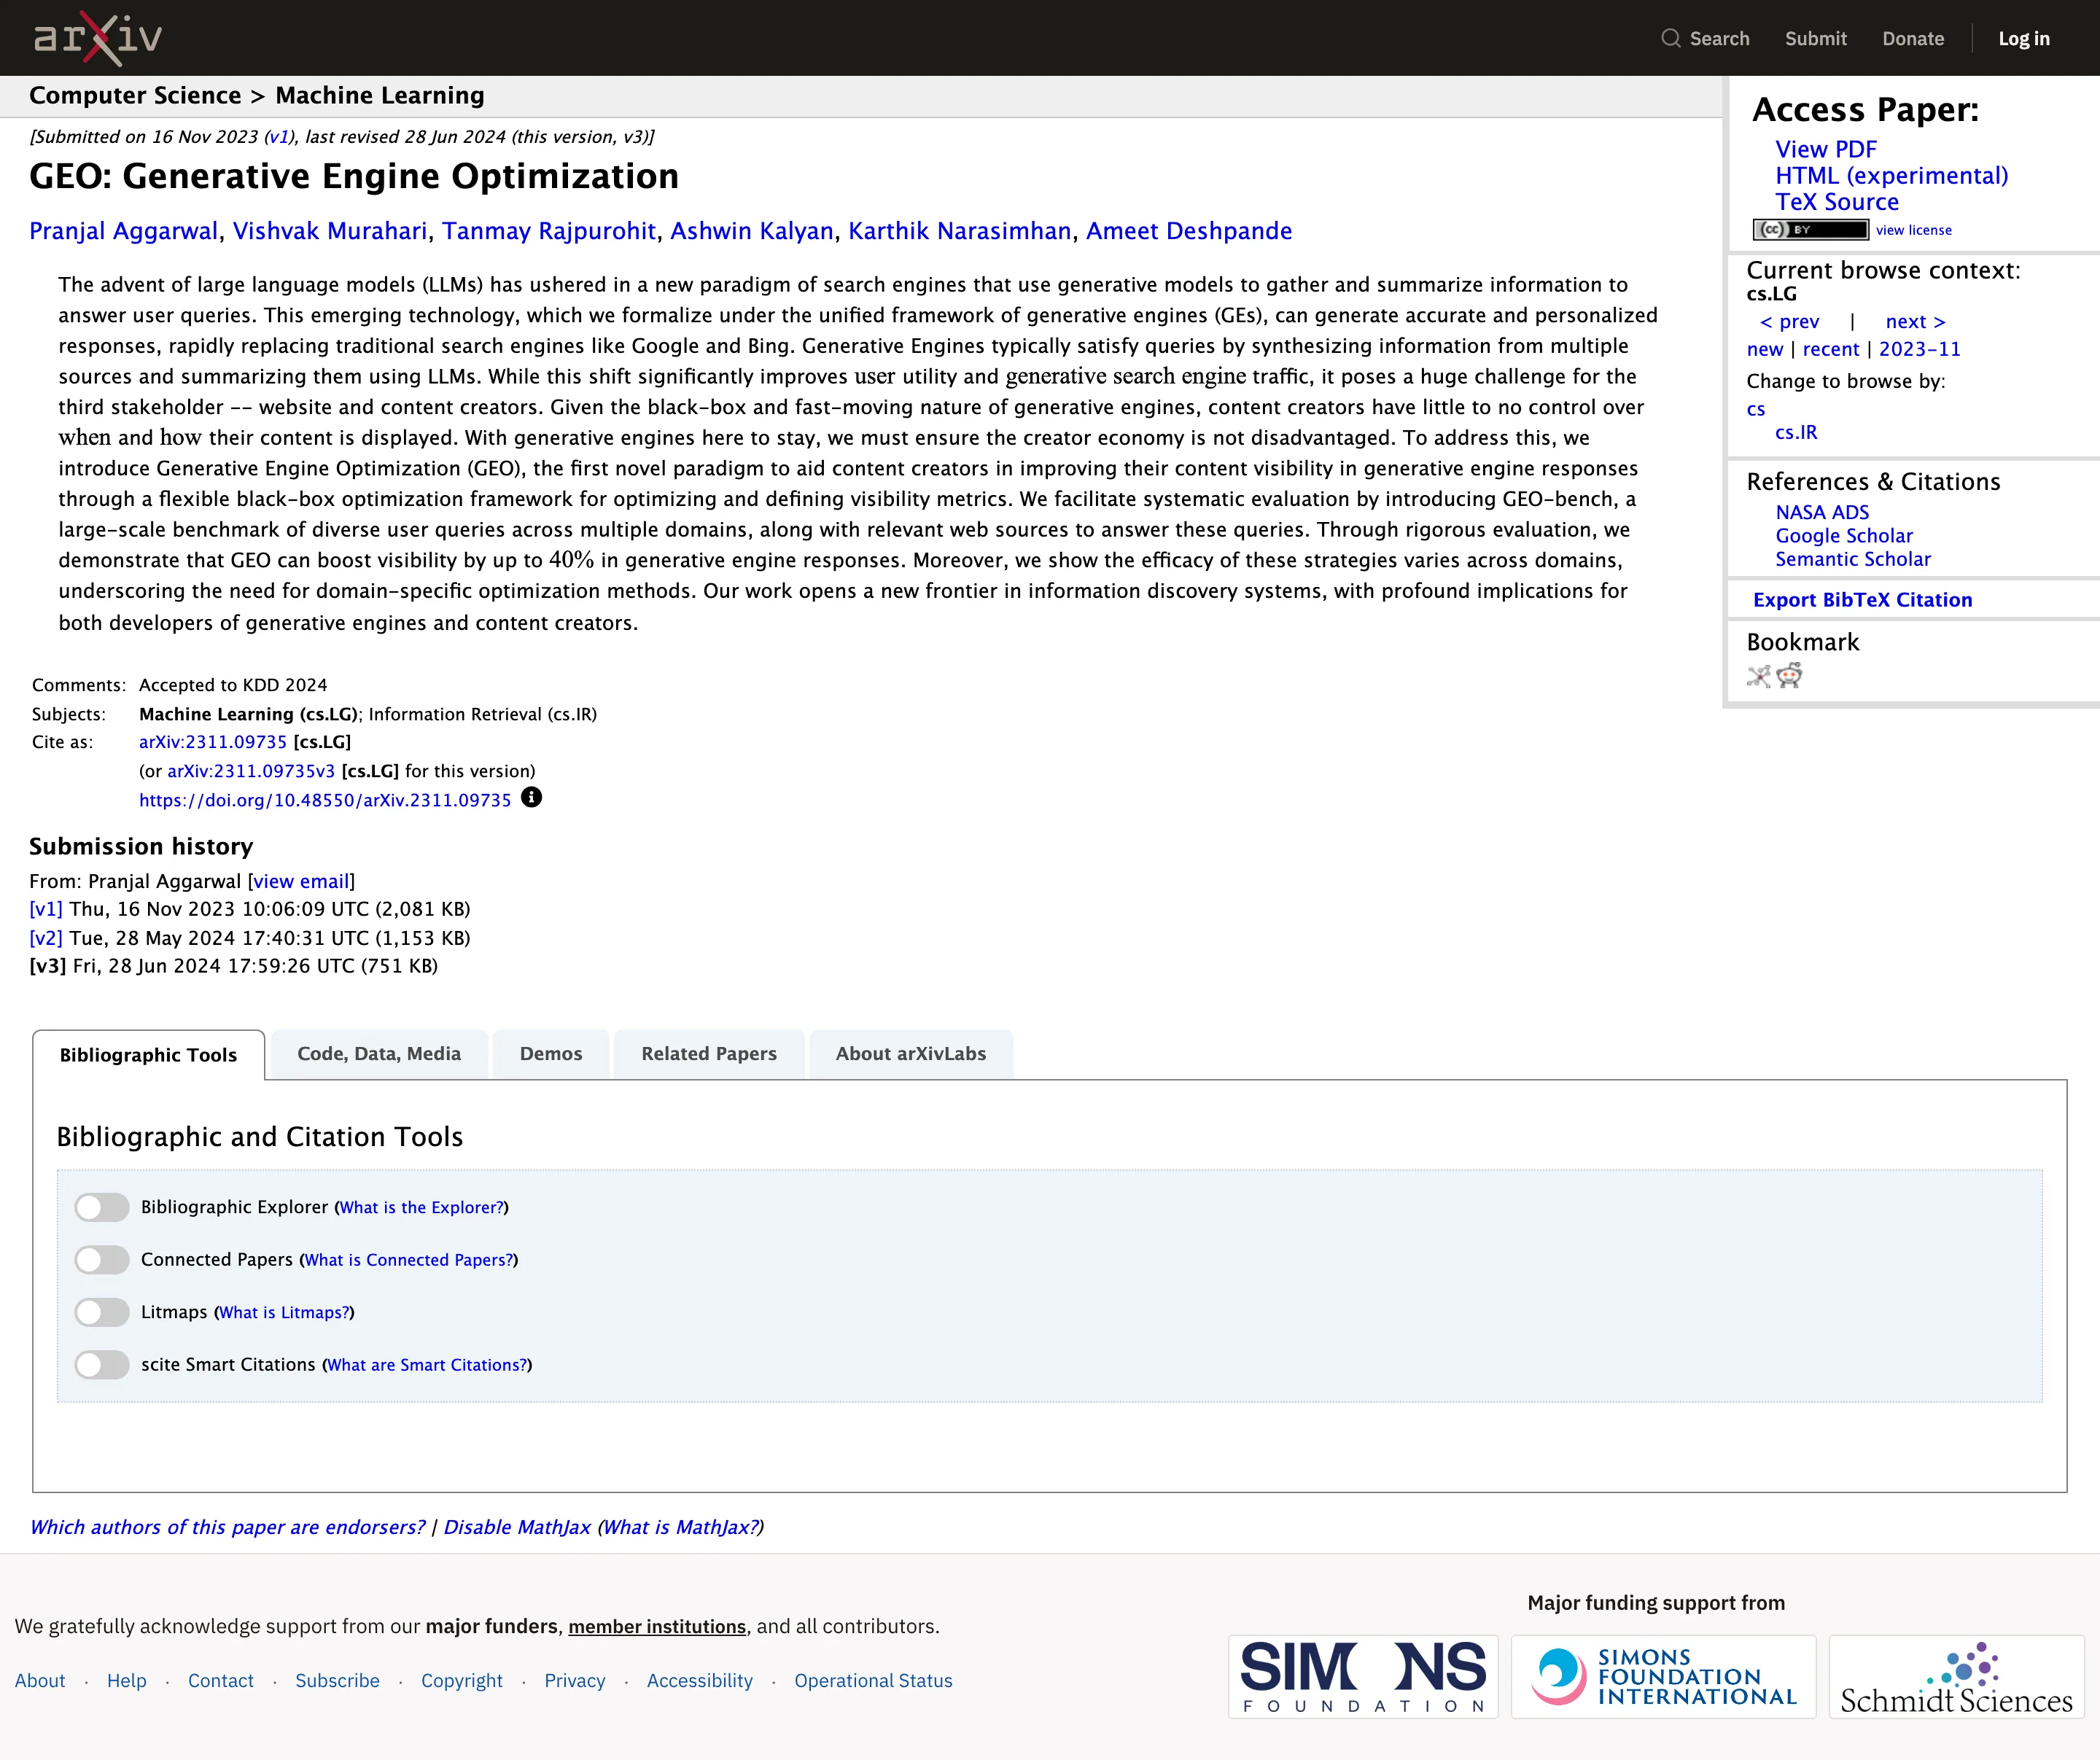
Это первое в своём роде масштабное исследование того, какие именно приёмы письма влияют на цитируемость в ответах генеративных ИИ-систем, а какие - только маркетинговый миф. Дальше - конкретные цифры по каждому приёму, а не общие советы «пиши убедительнее»
Какие приёмы реально работают: цифры по методам, а не одна на всё
Здесь и находится главная ошибка большинства советов по теме: они называют одну общую цифру прироста для всех приёмов сразу, хотя методы работают с очень разной силой. Вот разбитые по отдельности данные:
| Приём | Что делать | Измеренный эффект |
|---|---|---|
| Добавить ссылки на источники | к каждому факту - ссылка на документ, откуда он взят | +30-40%, у страниц вне топ-5 выдачи - до +115% |
| Добавить статистику | заменить общую фразу на число с датой | +30-40% |
| Добавить прямые цитаты | вставить дословную цитату эксперта или документа с указанием, откуда она | +30-40% |
| Улучшить читаемость текста | короче предложения, понятнее структура | +15-30% |
| Уверенный, авторитетный тон | формулировки без сомнения, но с опорой на факты | +10-20% |
Таблица прокручивается вбок →
Важная деталь, которую часто опускают: чем ниже страница стоит в обычной выдаче, тем сильнее на неё действует эта настройка. Страница на первой позиции почти не выигрывает от добавления источников и статистики - она и так попадает в поле зрения машины первой. А вот страница на пятой позиции и ниже получает максимальный прирост именно от плотности фактов: там решает не позиция в поиске, а то, насколько легко из текста вытащить готовую цитату
Если тебе только предстоит выбрать, какими инструментами вообще собирать контент под эту цель, полезно сначала посмотреть на набор нейросетей под разные форматы контента - проверка по 4 вопросам одинаково применима что к статье, что к посту, но инструмент сборки текста у них может отличаться
Если видишь у себя эти симптомы: что НЕ работает, хотя выглядит логично
Это вторая половина того же исследования, и её почти никогда не упоминают, когда советуют «добавляй больше фактов». Не всё усложнение текста работает в плюс - три приёма дали ноль или минус:
| Если видишь у себя | Почему кажется логичным | Что показало измерение |
|---|---|---|
| Текст стал длиннее, но абзацев без факта не меньше | больше текста - больше шанс, что что-то зацепится | Никакого прироста цитируемости - объём сам по себе не помогает |
| Ключевое слово темы повторяется в каждом абзаце | так делали в классическом SEO | Ноль эффекта, а в одной из систем даже небольшое снижение |
| Формулировки звучат уверенно, а цифр и дат нет | убедительный текст лучше держит внимание | Небольшой отрицательный эффект - без фактов уверенный тон читается как пустая уверенность |
Таблица прокручивается вбок →
Отсюда практический вывод: плотность - это не количество текста и не количество прилагательных, а именно доля абзацев, у которых закрыты все 4 вопроса выше. Абзац можно сократить вдвое и сделать плотнее, если убрать воду вокруг факта, а не наоборот - раздуть его цифрами без разбора
Привычка писать короткие точные формулировки пригодится и в другую сторону: если сам текст создаёт нейросеть по твоему заданию, короткие точные промпты для ChatGPT и Claude дают на выходе меньше воды с самого начала - меньше придётся уплотнять готовый черновик задним числом
Честная оговорка: откуда взяты эти проценты
Важно сказать прямо, а не продавать волшебное решение. Эти цифры - результат одного научного исследования (Принстонский университет, конец 2023 - начало 2024 года), которое тестировало приёмы на одной конкретной модели того времени в контролируемой лабораторной среде: пять источников соревновались за каждый запрос, а сами оптимизации текста создавал не человек, а другая модель
Это значит две вещи: во-первых, проценты - относительные показатели внутри лабораторных условий, в реальной конкурентной нише с десятками похожих страниц прирост скорее всего окажется меньше заявленных цифр. Во-вторых, современные системы (Google AI Overviews, Perplexity, Claude) устроены не идентично той модели, на которой шёл эксперимент - направление приёмов остаётся верным (факт вместо воды всегда лучше), но точные проценты не переносятся один в один на любую систему сегодня
Плотность фактов не гарантирует цитирования - она снимает у машины неоднозначность и повышает шанс, что выберут именно твой абзац, а не абзац конкурента с той же мыслью, но без опоры на факт
Если текст статьи изначально писала нейросеть, у неё есть свой набор типовых оборотов, который легко узнать по словам-маркерам ИИ - и это отдельная от плотности задача: убрать штампованные связки нужно для живого читателя, а добавить факт с датой и источником - для машины, которая собирает ответ. Обе задачи решаются на одном и том же черновике, но разными проходами
Промпт для самопроверки своего текста
Вот готовый промпт. Скопируй его целиком и вставь в окно чата с любым ИИ (ChatGPT, Claude, Gemini) вместе со своим текстом статьи - модель построчно разберёт, где плотность есть, а где её не хватает:
Ты - редактор, который проверяет текст на плотность извлекаемых фактов
для цитирования нейросетями. У тебя есть текст ниже. Пройди по каждому
абзацу и для каждого ответь на 4 вопроса:

1. Что произошло или что установлено - есть ли глагол действия, а не
   общая оценка вроде «стало лучше»?
2. К чему именно это относится - назван ли конкретный метод, инструмент
   или страница, а не «это» и «такой подход»?
3. Когда это измерено или произошло - есть ли дата, а не «недавно»
   или «сейчас»?
4. При каких условиях это верно - названы ли данные, группа или порог,
   при котором утверждение работает?

В конце дай список из 3-5 самых слабых абзацев (там, где ответа хотя бы
на один вопрос нет) и предложи, как переписать каждый - без выдумывания
новых цифр, только указывая, какой вопрос закрыть.

Текст для проверки:
[вставь сюда свой текст]
Промпт целиком вставляется в любое окно переписки с ИИ (например, в Claude Code или в веб-версию ChatGPT), строка в квадратных скобках заменяется на твой собственный текст, а дальше запрос просто отправляется как обычное сообщение. В ответ приходит построчный разбор твоих абзацев с пометками, где факт закрыт полностью, а где не хватает даты, источника или условия, и список из нескольких самых слабых мест с готовым предложением, что добавить
За один такой запрос ты получаешь ровно то же, что делает алгоритм нейросети при отборе цитат - проверку, есть ли в абзаце готовый извлекаемый факт, вместо того чтобы гадать на глаз, какие места текста стоит усилить
Этот промпт закрывает только один узкий слой проверки - плотность фактов. Если нужна более широкая проверка всего текста перед отправкой (ошибки, тон, понятность), для этого есть отдельная методика - 4 слоя проверки текста через ИИ, где плотность фактов - лишь один из четырёх пунктов, а не вся проверка целиком
Свой прогон: как проверен этот же принцип на живом корпусе статей
Этот же принцип зашит в проверки, через которые проходит каждая статья этого сайта - а их на 05.09.2026 опубликовано 624 (подсчёт по слепку корпуса). Проверки смотрят не на то, что «текст длинный и красивый», а на то, достаточно ли в нём извлекаемых фактов с источниками
Полный набор проверок этого инструмента прошёл 381 из 381 теста при собственном самотесте (прогон 05.09.2026) - значит логика, которую он проверяет на каждой моей статье, работает без сбоев, а не на словах
Одна из этих проверок конкретно смотрит на список источников статьи и требует минимум пять внешних ссылок, причём каждая ссылка обязана быть реально открытым документом, а не выдуманной ради количества. Это тот же принцип, что и в промпте выше: факт без источника машина либо не берёт в ответ вообще, либо доверяет ему меньше, чем факту с открытой ссылкой
Весь этот прогон делается прямо в [Claude Code](/guide-claude-code/) - том же окне, где обычно пишутся и правятся сами статьи, без переключения между разными программами для текста и для проверки
Как это соотносится с технической настройкой сайта
Плотность фактов внутри текста - это одна часть задачи, но не вся. Даже идеально плотный текст не попадёт в ответ нейросети, если сам сайт технически закрыт от её ботов, у него нет структуры данных, объясняющей машине, что перед ней статья с автором и источниками, или нет простого файла-каталога для быстрого обхода. Это отдельная, техническая настройка - три двери, которые открывают доступ к сайту в принципе, а не улучшают конкретный текст. Она разобрана отдельно в гайде про три двери GEO-настройки сайта: если проверка по 4 вопросам не даёт результата, первое, что стоит проверить, - открыт ли сайт для ИИ-ботов вообще, прежде чем разбирать плотность конкретных абзацев
Частые грабли при повышении плотности
Если видишь у себя одну из этих трёх вещей - остановись
- Цифры без даты число «40% прироста» без указания, когда и на каких данных оно получено, через полгода читается как устаревшее или выдуманное - дата обязательна рядом с каждым числом
- Перегруз цифрами в одном абзаце нужен ОДИН плотный факт на абзац, а не три подряд - абзац с пятью числами без структуры читается как свалка, а не как извлекаемый факт
- Уверенный тон вместо факта убедительные формулировки («точно», «однозначно», «доказано») без опоры на конкретное число или источник работают в минус, а не в плюс - это ровно тот приём, что показал отрицательный эффект в исследовании выше
Отдельно стоит проверить итоговый текст ещё и на признаки того, что его писала нейросеть без правки - независимые детекторы ИИ-текста иногда снижают доверие к странице у самих читателей, даже если проверка по 4 вопросам пройдена идеально
Где в тексте размещать плотные факты
Плотность важна не только сама по себе - важно ещё, в каком месте текста она стоит. По данным анализа SparkToro за январь 2026 года, 44,2% всех цитирований из ответов ИИ-систем приходят именно из первых 30% текста статьи - то есть из введения и первых разделов после него. Средняя треть текста даёт 31,1% цитирований, а последняя треть - всего 24,7%
Практический вывод простой: самый плотный, самый фактурный абзац этой статьи должен идти не в середине и не в конце, а в первых нескольких абзацах после заголовка. Если у тебя есть один самый сильный факт - число с источником, которое лучше всего доказывает главную мысль статьи - ему место в начале, а не там, где ты «наконец до него дошёл» после долгого разгона
Это работает и в обратную сторону, если ты пишешь текст под контент-план: посмотри на 200 готовых идей контента - у каждой такой темы обычно уже есть один сильный факт-крючок, вокруг которого и строится вступление, а не наоборот
Что делать, если фактов под рукой пока мало
Частая ситуация: тема есть, а собственных цифр, замеров или свежих данных нет. Три честных пути, а не выдумывание фактов:
| Путь | Что делать | Когда подходит |
|---|---|---|
| Взять чужое исследование с датой и условием | процитировать конкретную цифру со ссылкой на первоисточник, не выдавая её за свою | тема, где есть научные данные или открытая статистика |
| Провести свой маленький замер | посчитать что-то самому - время, количество, результат одного своего действия | тема про твой личный процесс или инструмент |
| Честно назвать пробел | написать прямо: «здесь пока нет открытых данных, проверю и обновлю статью» | тема совсем новая, данных ни у кого ещё нет |
Таблица прокручивается вбок →
Выдуманное число хуже честного пробела: нейросеть, если процитирует неточный факт, а потом кто-то его опровергнет, теряет доверие не только к цифре, но и ко всему источнику
Свой маленький замер не обязан быть сложным - иногда достаточно посчитать время одного действия у себя же в Claude для контента: сколько минут заняло собрать черновик, сколько - найти источники. Это уже конкретная цифра со своим условием, а не выдумка
Твой набор бесплатных инструментов
| Инструмент | Что делает | Нужна ли регистрация |
|---|---|---|
| промпт самопроверки из этой статьи | построчно находит абзацы без факта или с неполным ответом на 4 вопроса | нет, работает в любом бесплатном чате с ИИ |
| любой чат с ИИ (ChatGPT, Claude, Gemini) | запускает промпт и выдаёт разбор твоего текста | часто нет, у большинства есть бесплатный доступ без регистрации |
| 4 вопроса из этой статьи | ручная проверка одного абзаца за 10 секунд, без инструмента вообще | не требуется |
Таблица прокручивается вбок →
Что ещё почитать про сайты и текст для нейросетей
- Как попасть в ответы нейросетей: 3 двери GEO - техническая настройка сайта: открытость для ботов, разметка, файл-каталог, дополняет проверку из этой статьи
- ПРОДУКТ: как сделать, чтобы ChatGPT и Claude советовали ваш продукт - если задача шире одного текста, а нужен целый продукт, который рекомендуют нейросети
- Как сделать, чтобы нейросети советовали тебя клиентам - если цель не техническая настройка текста, а личная рекомендация тебя как эксперта
- SEO-скилл для Клода: 5 шагов к плану страниц - если дальше нужен план и семантика будущих статей, а не только проверка одного текста
- Claude Code: что это и как пользоваться - если промпт самопроверки удобнее прогонять прямо в окне, где пишешь тексты
- Контент и продвижение на ИИ: разборы и гайды - если тема продвижения через нейросети интересна шире одной статьи
Источники
Все источники проверены прямым запросом 5 сентября 2026 года; факт-чек донора и цифры проверены минимум двумя независимыми источниками каждая, кадр критического разбора пересъят 9 сентября 2026 года
- Princeton GEO paper: GEO: Generative Engine Optimization (arXiv 2311.09735) - первоисточник исследования методов, из которого выведены измеренные проценты
- Независимый разбор Princeton GEO paper с точными процентами по методам - Citation Addition, Quotation Addition, Statistics Addition, Fluency Optimization, Authoritative Voice и провальные тактики
- Критический разбор методологии Princeton GEO paper - оговорки про лабораторные условия, устаревшую модель теста, относительность процентов
- Собственная страница исследования на Princeton Collaborate - официальная карточка публикации, entity recognition и корреляция vs причинность
- Анализ SparkToro про распределение LLM-цитирований по структуре текста - 44,2% цитирований из первых 30% текста, январь 2026
Памятка: как сделать текст плотнее
Пять строк, которые закрывают всю проверку
Сохрани себе
- 4 вопроса к абзацу: что произошло, к чему относится, когда измерено, при каких условиях верно - ответ должен быть на все четыре
- Работает сильнее всего: ссылки на источники, статистика, прямые цитаты - от +30% до +115% у страниц вне топ-5
- Не работает вообще: больше слов без разбора, повтор ключевых слов, убеждение без опоры на факт
- Промпт самопроверки: вставь текст в любой чат с ИИ и попроси найти абзацы без факта или с неполным ответом на 4 вопроса
- Честная граница: плотность повышает шанс на цитирование, а не гарантирует его - решает ещё и техническая настройка сайта
Порог входа
Проверку прошёл бесплатно, следующий шаг - тоже
Всё, что нужно для проверки своего текста на плотность фактов, ты только что получил бесплатно: 4 вопроса, измеренные приёмы и готовый промпт для самопроверки. Следующий шаг - три дня разбора и сборки рабочего порядка вокруг твоего же контента - тоже стоит ровно ноль
Это заявка в мой закрытый канал, не оплата. Впускаю сразу, дальше бот в личке отдаёт путёвку на три дня
Частые вопросы
Что такое плотность фактов простыми словами?
Это доля абзацев твоего текста, из которых можно вытащить готовый факт - число, дату, результат с указанием источника - вместо общего рассуждения без опоры. Абзац с плотным фактом нейросеть может процитировать напрямую, абзац без него - пропускает при сборке ответа
Сколько плотных абзацев должно быть в статье?
Точной нормы не существует, и любая цифра здесь была бы выдумкой без источника. Практический ориентир - проверить промптом из этой статьи весь текст и переписать хотя бы самые слабые 3-5 абзацев, которые сейчас не несут ни одного факта
Достаточно ли просто добавить побольше цифр в текст?
Нет, и это ключевая ошибка. Исследование прямо показало, что простое увеличение объёма текста и добавление слов без разбора не повышает цитируемость вообще. Работает не количество, а полный ответ на все 4 вопроса у каждого отдельного факта
Как проверка по 4 вопросам соотносится с технической настройкой сайта под нейросети?
Это разные, дополняющие друг друга задачи. Плотность фактов - про содержание конкретного текста. Открытость сайта для ИИ-ботов, структура данных и файл-каталог сайта - про техническую возможность машине вообще дойти до этого текста и понять его структуру. Обе задачи нужны вместе, техническая сторона разобрана в гайде про GEO-настройку сайта, а если проверку нужно применить не к одной статье, а сразу к плану кластера тем, для этого есть набор скиллов Claude для контента
Работают ли эти проценты одинаково для любой нейросети?
Нет. Исходное исследование тестировало один набор приёмов на одной модели в контролируемых лабораторных условиях - направление приёмов (факт вместо воды) остаётся верным для любой системы, но точные проценты прироста не переносятся дословно на каждый сервис и могут отличаться в реальных условиях сильнее, чем в лаборатории