Нейросети · Контент
Нейросеть для озвучки на русском: 5 сервисов и клон голоса

Нейросеть для озвучки текста превращает набранный текст в аудиофайл голосом, который трудно отличить от человеческого. Бесплатно и без карты русский текст озвучивает edge-tts - модуль ставится одной командой и отдаёт mp3 за секунды. Живой голос с эмоциями и клон собственного голоса живут в ElevenLabs: бесплатный план даёт 10 000 знаков в месяц, клонирование открывается на плане Starter за $6
Я озвучиваю ролики и уроки нейросетью каждую неделю и микрофон включаю всё реже. Ниже - разбор без рекламы: чем озвучить бесплатно прямо сейчас, как снять клон со своего голоса, сколько это стоит по живым тарифам и обо что спотыкается русский язык
Нейросеть для озвучки текста превращает набранный текст в аудиофайл голосом, который трудно отличить от человеческого. Бесплатно и без карты русский текст озвучивает edge-tts - модуль ставится одной командой и отдаёт mp3 за секунды. Живой голос с эмоциями и клон собственного голоса живут в ElevenLabs: бесплатный план даёт 10 000 знаков в месяц, клонирование открывается на плане Starter за $6
Озвучил ролик - и это только один шаг из десяти. Собрать остальные девять помогаю на ИИ-Лагере
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Что такое нейросеть для озвучки и что она умеет в 2026
Нейросеть для озвучки - это модель синтеза речи, по-английски text-to-speech: на вход идёт текст, на выходе получается готовый аудиофайл с интонацией, паузами и дыханием. Старые синтезаторы читали по слогам и выдавали робота, модели 2026 года читают смысл: замедляются на важном, поднимают тон в вопросе, делают паузу там, где человек набирает воздух
Переломом стала модель Eleven v3 от ElevenLabs, вышедшая в феврале 2026. Она поддерживает больше 70 языков против 28 у предыдущей Multilingual v2, и русский среди них. Формулировка на странице модели прямая: «Generate lifelike speech in 70+ languages with emotion, direction, and multi-speaker control»
Эмоцией теперь можно управлять руками. Прямо в тексте ставятся аудио-теги в квадратных скобках: [laughs], [whispers], [sigh], [excited] - и голос отыгрывает их вместо того, чтобы прочитать вслух. Отдельный режим Text to Dialogue сшивает несколько голосов в диалог и сам расставляет переходы между репликами
Чего ждать не стоит. Нейросеть не понимает, что именно ты написал: она не догадается, какое слово в предложении главное, и не поставит ударение в спорном слове по смыслу. Она не спасёт плохой текст - озвученная вода останется водой, просто теперь с приятным голосом. И она не заменит живой эфир: там ценность в том, что человек отвечает на вопросы, а не в тембре
Если нужен обзор соседних инструментов под контент, у меня лежит каталог из 14 нейросетей со ссылками - озвучка там один из блоков
Какая нейросеть для озвучки лучше на русском: сравнение пяти вариантов
Под русский язык в 2026 году рабочих вариантов пять, и выбор между ними решается не качеством звука, а тремя вопросами: нужен ли коммерческий статус, нужен ли твой собственный голос и чем ты собираешься платить. Универсального победителя тут нет
| Инструмент | Цена входа | Русский | Клон голоса | Кому подходит |
|---|---|---|---|---|
| edge-tts | бесплатно, без аккаунта | 2 голоса | нет | черновики, драфты, длинные тексты |
| ElevenLabs | Free 10 000 кредитов, Starter $6 | 70+ языков в v3 | с плана Starter | ролики, курсы, аудиокниги |
| HeyGen | Free до 1 минуты, Creator $29 | перевод на 175+ языков | 1 клон на Creator | дубляж и переозвучка видео |
| SaluteSpeech | Freemium 200 000 знаков | родной | Brand Voice для бизнеса | те, кому нужна оплата рублями |
| Silero | бесплатно, локально | 5 голосов | нет | офлайн и работа без подписок |
Логика выбора укладывается в пять коротких развилок. Звук нужен прямо сейчас и черновой интонации не жалко - edge-tts, он не спрашивает ни карту, ни почту. Голос идёт в продающий ролик - ElevenLabs. Надо переозвучить готовое видео с попаданием в губы - HeyGen. Платить хочется рублями с российского счёта - смотри в сторону SaluteSpeech, но там есть засада, о ней в разделе про цены. Текст вообще не должен уходить в чужое облако - тогда Silero на своём компьютере
Про качество скажу отдельно. Разница между бесплатным и платным слышна не на одной фразе, а на трёх минутах подряд: у бесплатных голосов ровный ритм, и через минуту ухо начинает уставать. Для сторис и черновиков это неважно, для урока на сорок минут - критично
Шаг 0. Что нужно приготовить до первой озвучки?
До первой озвучки нужны три вещи: текст без сокращений и цифр, пустая папка под mp3 и решение, нужен ли тебе именно свой голос. Микрофон понадобится только в одном случае - если собираешься клонировать себя
Готовим четыре вещи:
- Текст в отдельном файле, разбитый на абзацы по 2-4 предложения - так модель дышит там, где надо
- Цифры и сокращения, переписанные словами: «25 %» превращается в «двадцать пять процентов», «т.к.» в «так как»
- Пустая папка под аудио с латинским именем без пробелов, например
ozvuchka - Для клона голоса - запись своего голоса длиной 1-2 минуты в тихой комнате, без музыки и эха
Требования к записи для клона у ElevenLabs описаны точно: нужна «Approximately 1-2 minutes of clear audio without any reverb, artifacts, or background noise of any kind». Формат - MP3 от 128 kbps или WAV на 44,1 либо 48 кГц с разрядностью от 24 бит. Читать в запись лучше свой обычный текст спокойным темпом, а не стихи с выражением: клон подхватит именно ту манеру, которую услышит
Если планируешь идти по бесплатному пути через терминал, а терминала на компьютере ещё не было, посмотри пошаговую установку среды - там разобран вход с нуля. И до озвучки прогони текст на живость: как убрать из текста слова-маркеры нейросети я разбирал отдельно, потому что озвученный шаблонный текст звучит вдвое хуже написанного
Шаг 1. Как озвучить текст на русском бесплатно, без карты и регистрации?
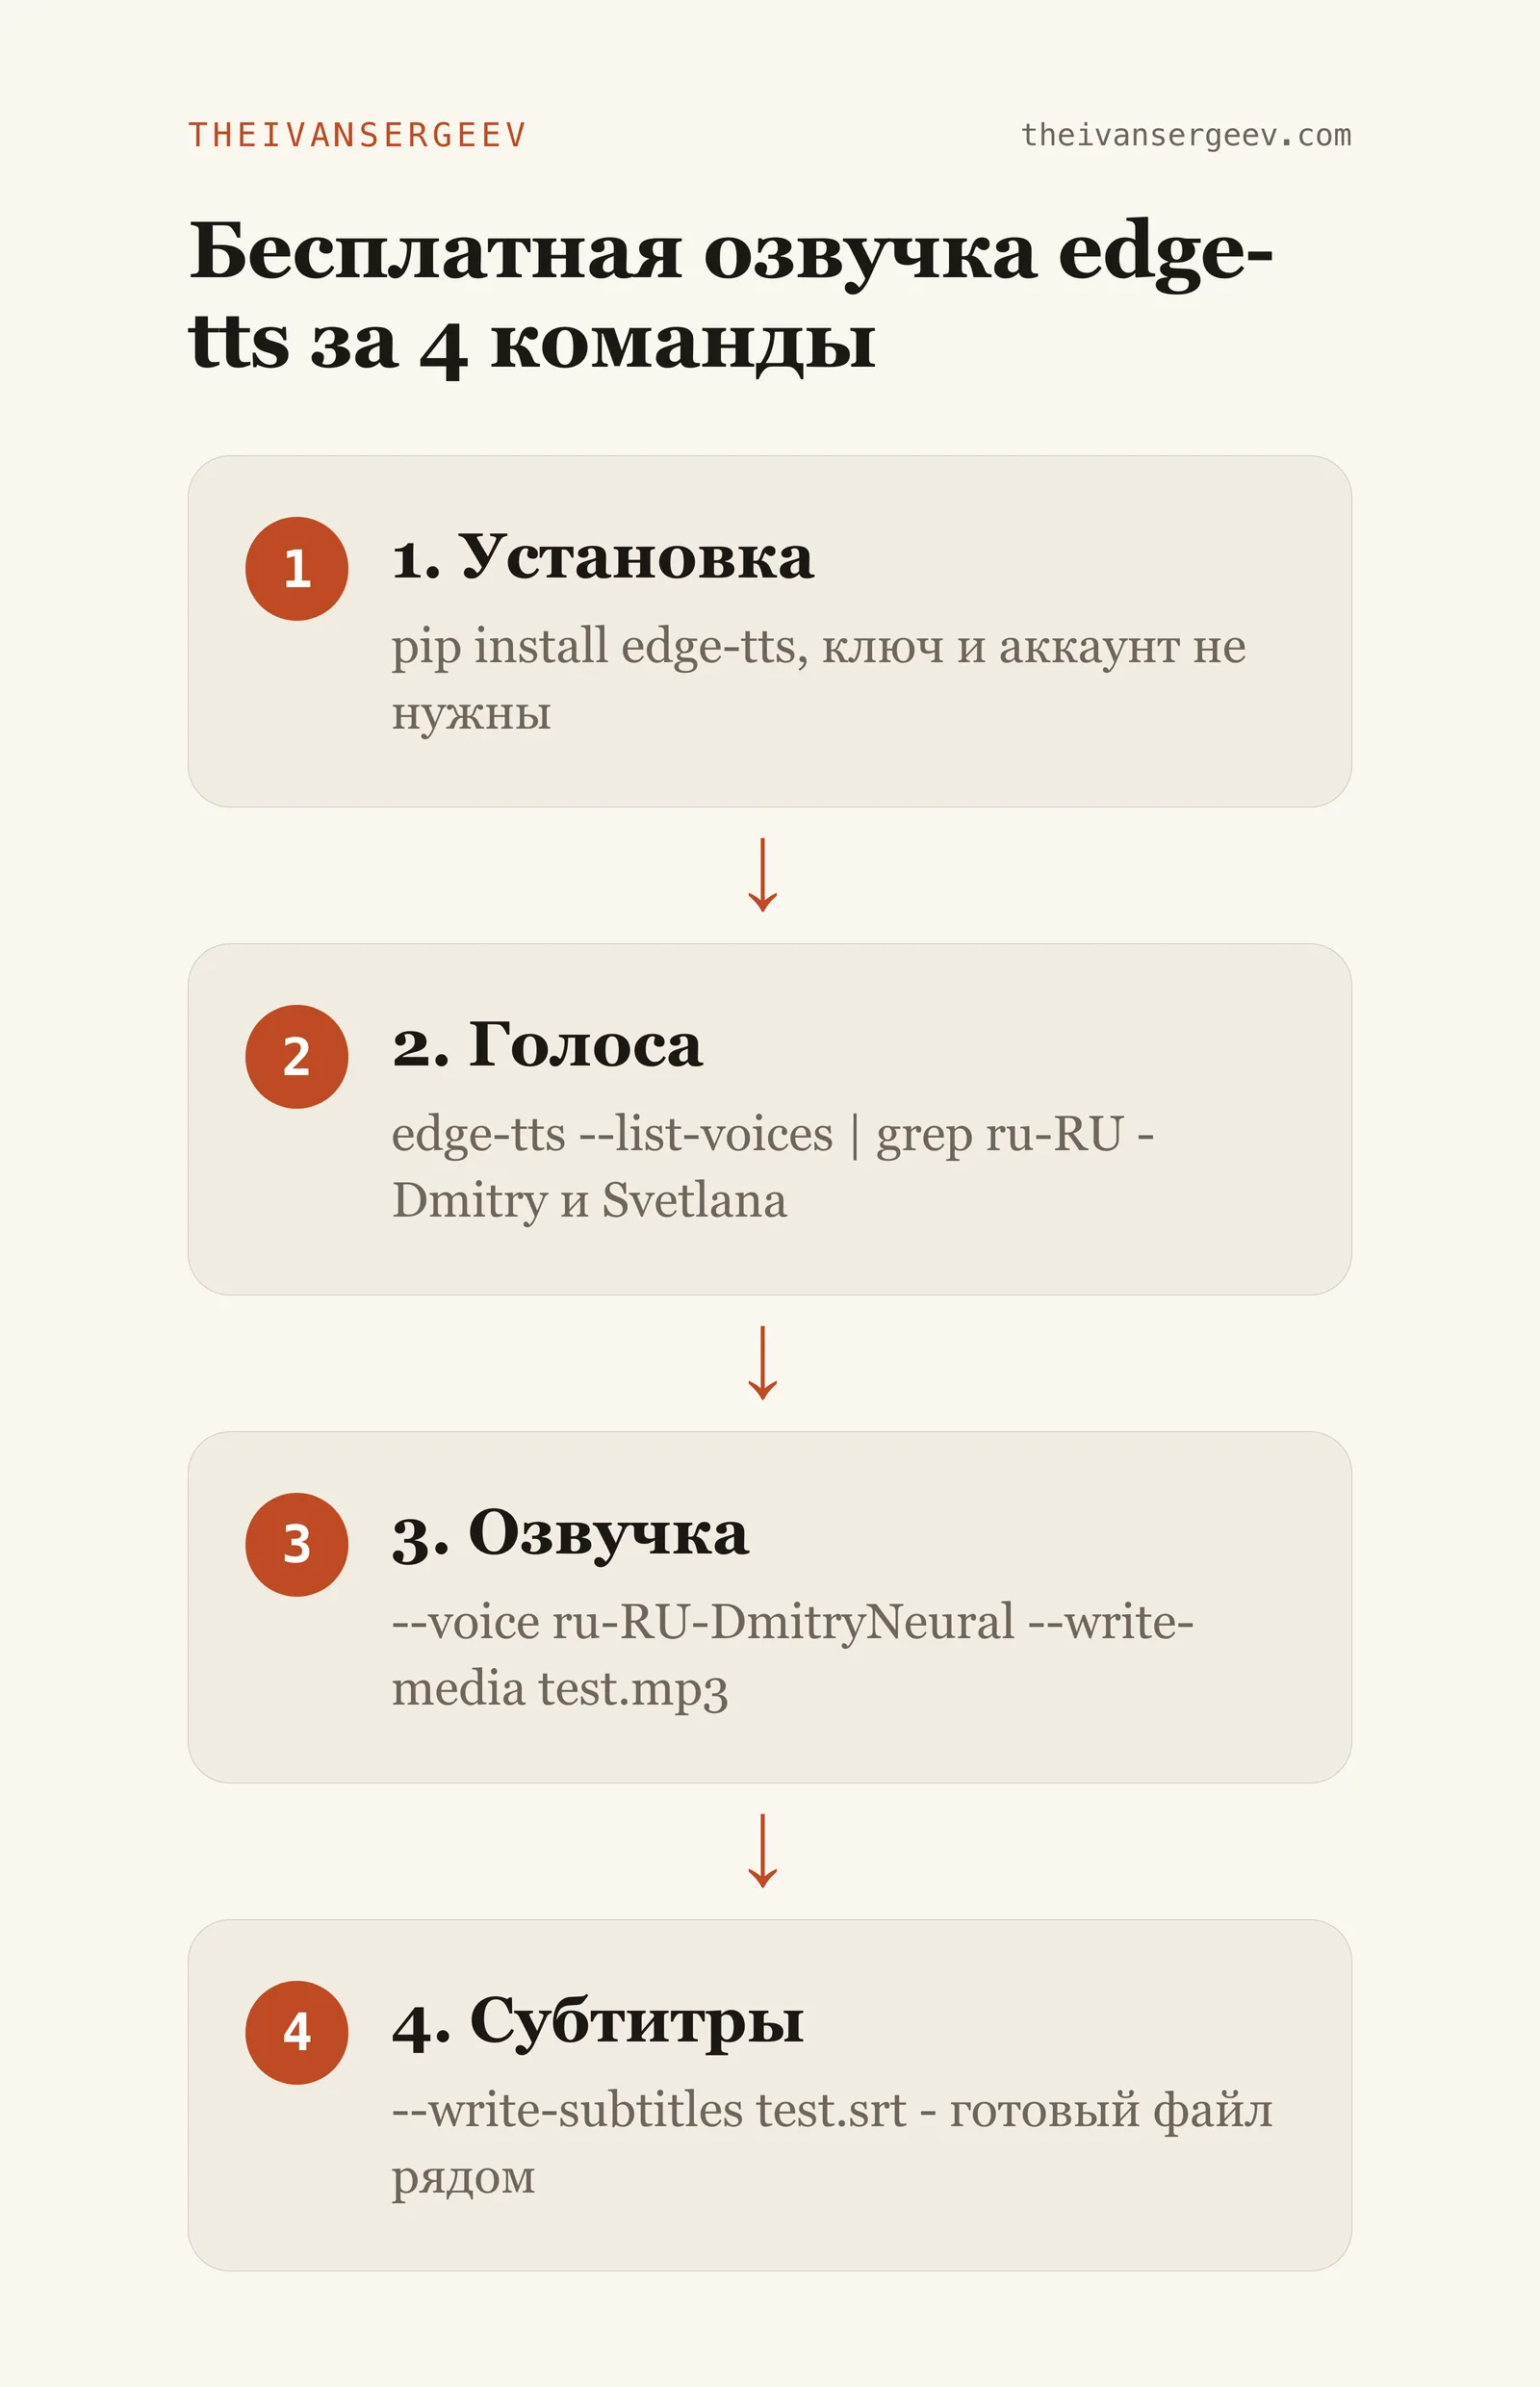
Бесплатно и без аккаунта русский текст озвучивает edge-tts - модуль на Python, который обращается к синтезу речи из браузера Microsoft Edge. В README сказано прямо: он бесплатный и не требует ни ключа API, ни аккаунта. Ставится одной командой и отдаёт mp3 вместе с файлом субтитров
Ставим модуль:
pip install edge-ttsСмотрим, какие русские голоса есть в наличии:
edge-tts --list-voices | grep ru-RUЧто увидишь - две строки, я снял их со своего прогона 7 августа 2026:
ru-RU-DmitryNeural      Male      General      Friendly, Positive
ru-RU-SvetlanaNeural    Female    General      Friendly, Positive
Озвучиваем текст мужским голосом и сразу забираем субтитры:
edge-tts --voice ru-RU-DmitryNeural \
  --text "Привет. Это тестовая озвучка текста нейросетью на русском языке." \
  --write-media test.mp3 --write-subtitles test.srt
В моём прогоне команда отработала за 3,2 секунды и положила рядом два файла: test.mp3 весом 36 000 байт длительностью ровно 6,0 секунды и test.srt на 185 байт с разбивкой по фразам. Версия модуля - 7.2.8. Шестьдесят два знака текста превратились в шесть секунд звука, значит на минуту аудио уходит примерно 600-700 знаков
Файл субтитров тут даром: его сразу можно подгрузить в монтажку и получить готовые подписи, не набивая их руками. Длинный текст удобнее скармливать не флагом --text, а файлом через --file script.txt, иначе командная строка захлебнётся на кавычках. Как из такой связки собирается конвейер контента, я показывал в разборе про месяц постов из одной голосовой
Шаг 2. Как сделать живой голос в ElevenLabs и куда там нажимать?
В ElevenLabs первая озвучка занимает минут пять: регистрация по почте, вкладка Text to Speech, выбор модели, вставка текста и кнопка Generate. Бесплатный план стоит $0 и даёт 10 000 кредитов в месяц по живой странице тарифов на 7 августа 2026
Порядок действий:
- Открой elevenlabs.io и зарегистрируйся по почте, карта на бесплатном плане не нужна
- В левом меню выбери Text to Speech
- В списке моделей поставь Eleven v3 - это та самая модель с эмоциями и 70+ языками
- В списке голосов возьми любой из библиотеки, для русского ориентируйся на пометку языка в карточке голоса
- Вставь текст в поле и нажми Generate
- Забери файл кнопкой скачивания под плеером
Что увидишь: под полем ввода появится плеер с дорожкой, а счётчик кредитов в углу уменьшится ровно на число знаков текста. Расход считается буквально, страница тарифов формулирует это так: «For V2 Multilingual models, 1 text character equals 1 credit»
Перевод в минуты простой: на минуту обычной начитки уходит около 1000 знаков, то есть бесплатных 10 000 кредитов хватает примерно на десять минут готового аудио в месяц. Для проб и коротких роликов нормально, для курса - нет
Полезная мелочь на старте: эмоции в v3 ставятся тегами прямо в тексте. Строка вида [whispers] Только между нами. [laughs] Ладно, шучу озвучится шёпотом, а потом со смешком - теги в звук не читаются. Начни с двух-трёх тегов на абзац, иначе голос начнёт переигрывать
Шаг 3. Как клонировать свой голос нейросетью: что записать и куда загрузить?
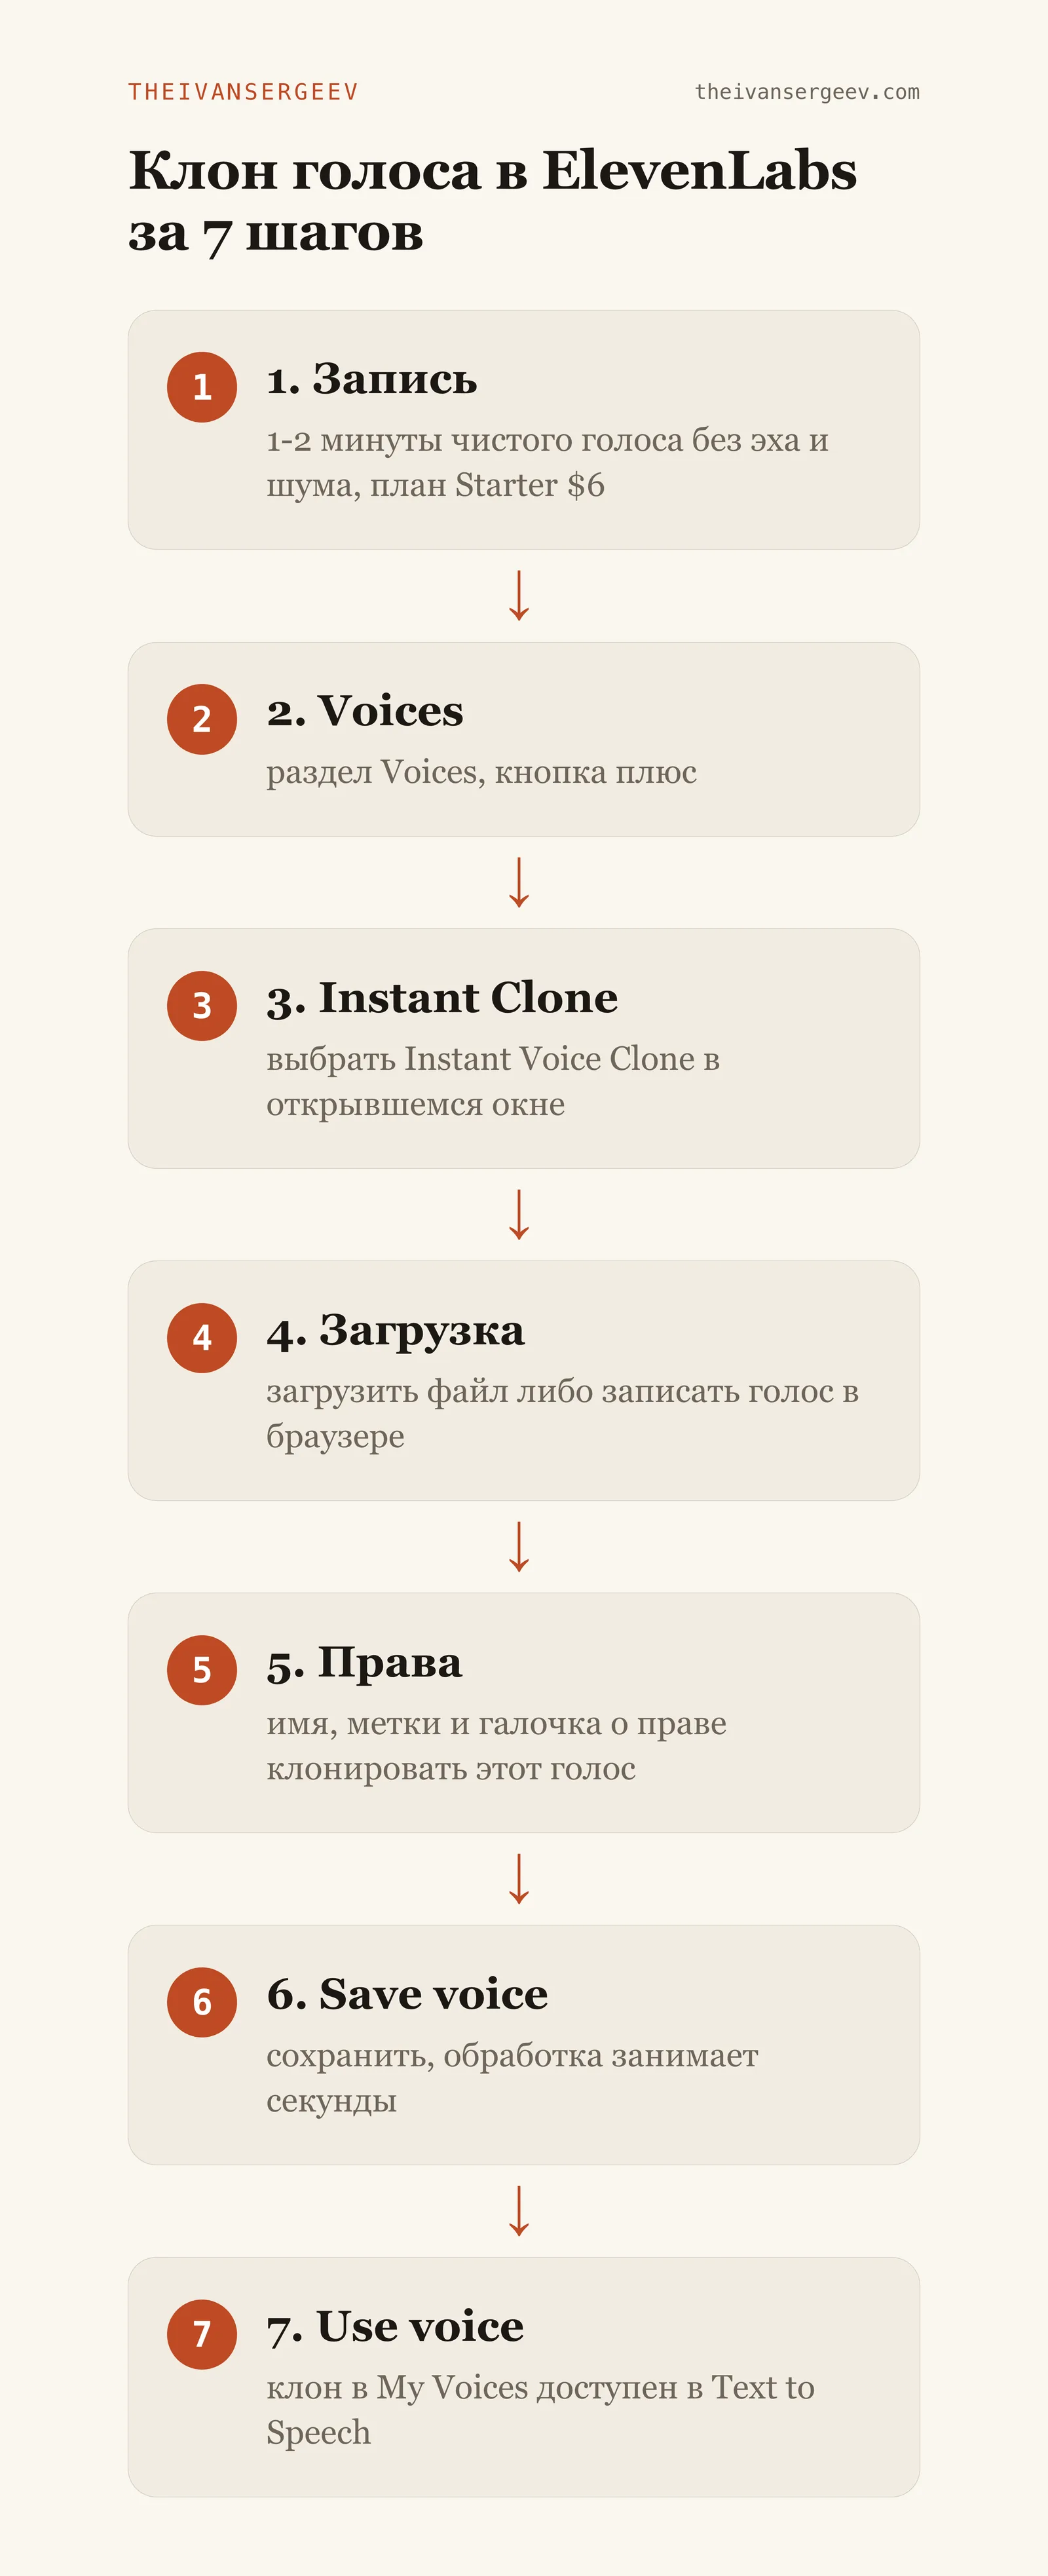
Клон голоса в ElevenLabs собирается из 1-2 минут чистой записи, а функция Instant Voice Cloning открывается на плане Starter за $6 в месяц. Тот же план снимает главное ограничение бесплатного - даёт коммерческую лицензию на то, что ты наозвучиваешь
Сначала запись. Требования документации жёсткие и понятные: аудио без эха, шумов и артефактов, ровная громкость и одна манера от начала до конца. Записывать больше трёх минут смысла нет, в документации сказано отдельно: «Avoid recording more than 3 minutes, this will yield little improvement and can, in some cases, even be detrimental to the clone». И ещё важное: значение имеет не количество файлов, а суммарная длительность - «it is the total combined length (total runtime) that is the important part»
Дальше сборка клона по шагам:
- Зайди в раздел Voices и нажми плюс
- Выбери Instant Voice Clone в открывшемся окне
- Загрузи свой файл или запиши голос прямо в браузере
- Дай клону имя и проставь метки
- Подтверди галочкой, что имеешь право клонировать этот голос
- Нажми Save voice
- Найди клон в My Voices и нажми Use voice
Что увидишь: клон появится в общем списке голосов и станет доступен в Text to Speech наравне с библиотечными. Обработка занимает секунды, ждать очереди не нужно
Куда клон обычно проваливается: запись с зумом или с телефона в машине даёт клон с той же комнатной гулкостью, и убрать её потом нельзя. Если голос вышел «не твой», причина почти всегда в исходнике, а не в модели - перепиши минуту заново в тихой комнате с одной интонацией
Шаг 4. Как озвучить готовое видео и сделать дубляж на другой язык?
Готовое видео озвучивают двумя путями: либо подкладывают синтезированную дорожку под монтаж вручную, либо отдают ролик целиком в HeyGen, где голос переозвучивается и губы подгоняются под новый язык. Перевод у HeyGen заявлен на 175+ языков
Ручной путь короткий и бесплатный. Пишешь текст под видеоряд, гонишь его через edge-tts или ElevenLabs, кладёшь mp3 на звуковую дорожку в монтажке и подрезаешь по картинке. Файл субтитров из первого шага ложится сюда же и экономит полчаса на подписях
Автоматический путь нужен, когда в кадре говорящий человек и нужно, чтобы он заговорил на другом языке своим голосом. Живые тарифы HeyGen на 7 августа 2026 выглядят так. Бесплатный план даёт ролики до 1 минуты. Creator стоит $29 в месяц: 600 кредитов, ролики до 30 минут, один клон голоса. Pro за $49 снимает лимит на число клонов, Business за $149 плюс $20 за место поднимает длину до 60 минут
У ElevenLabs есть своя Dubbing Studio, и открывается она на том же плане Starter за $6 - список функций плана перечисляет её прямым текстом. Разница простая: ElevenLabs переозвучивает дорожку, HeyGen ещё и синхронизирует губы
Про закон и совесть. Клонировать чужой голос без разрешения нельзя, ElevenLabs не зря заставляет ставить галочку о правах на голос. Свой голос - пожалуйста, голос знакомого - только с его согласия. Как из готовых кусков собирается вертикальное видео на автомате, я показывал в разборе про монтаж Reels руками Claude
Сколько стоит озвучка нейросетью: живые тарифы на 7 августа 2026
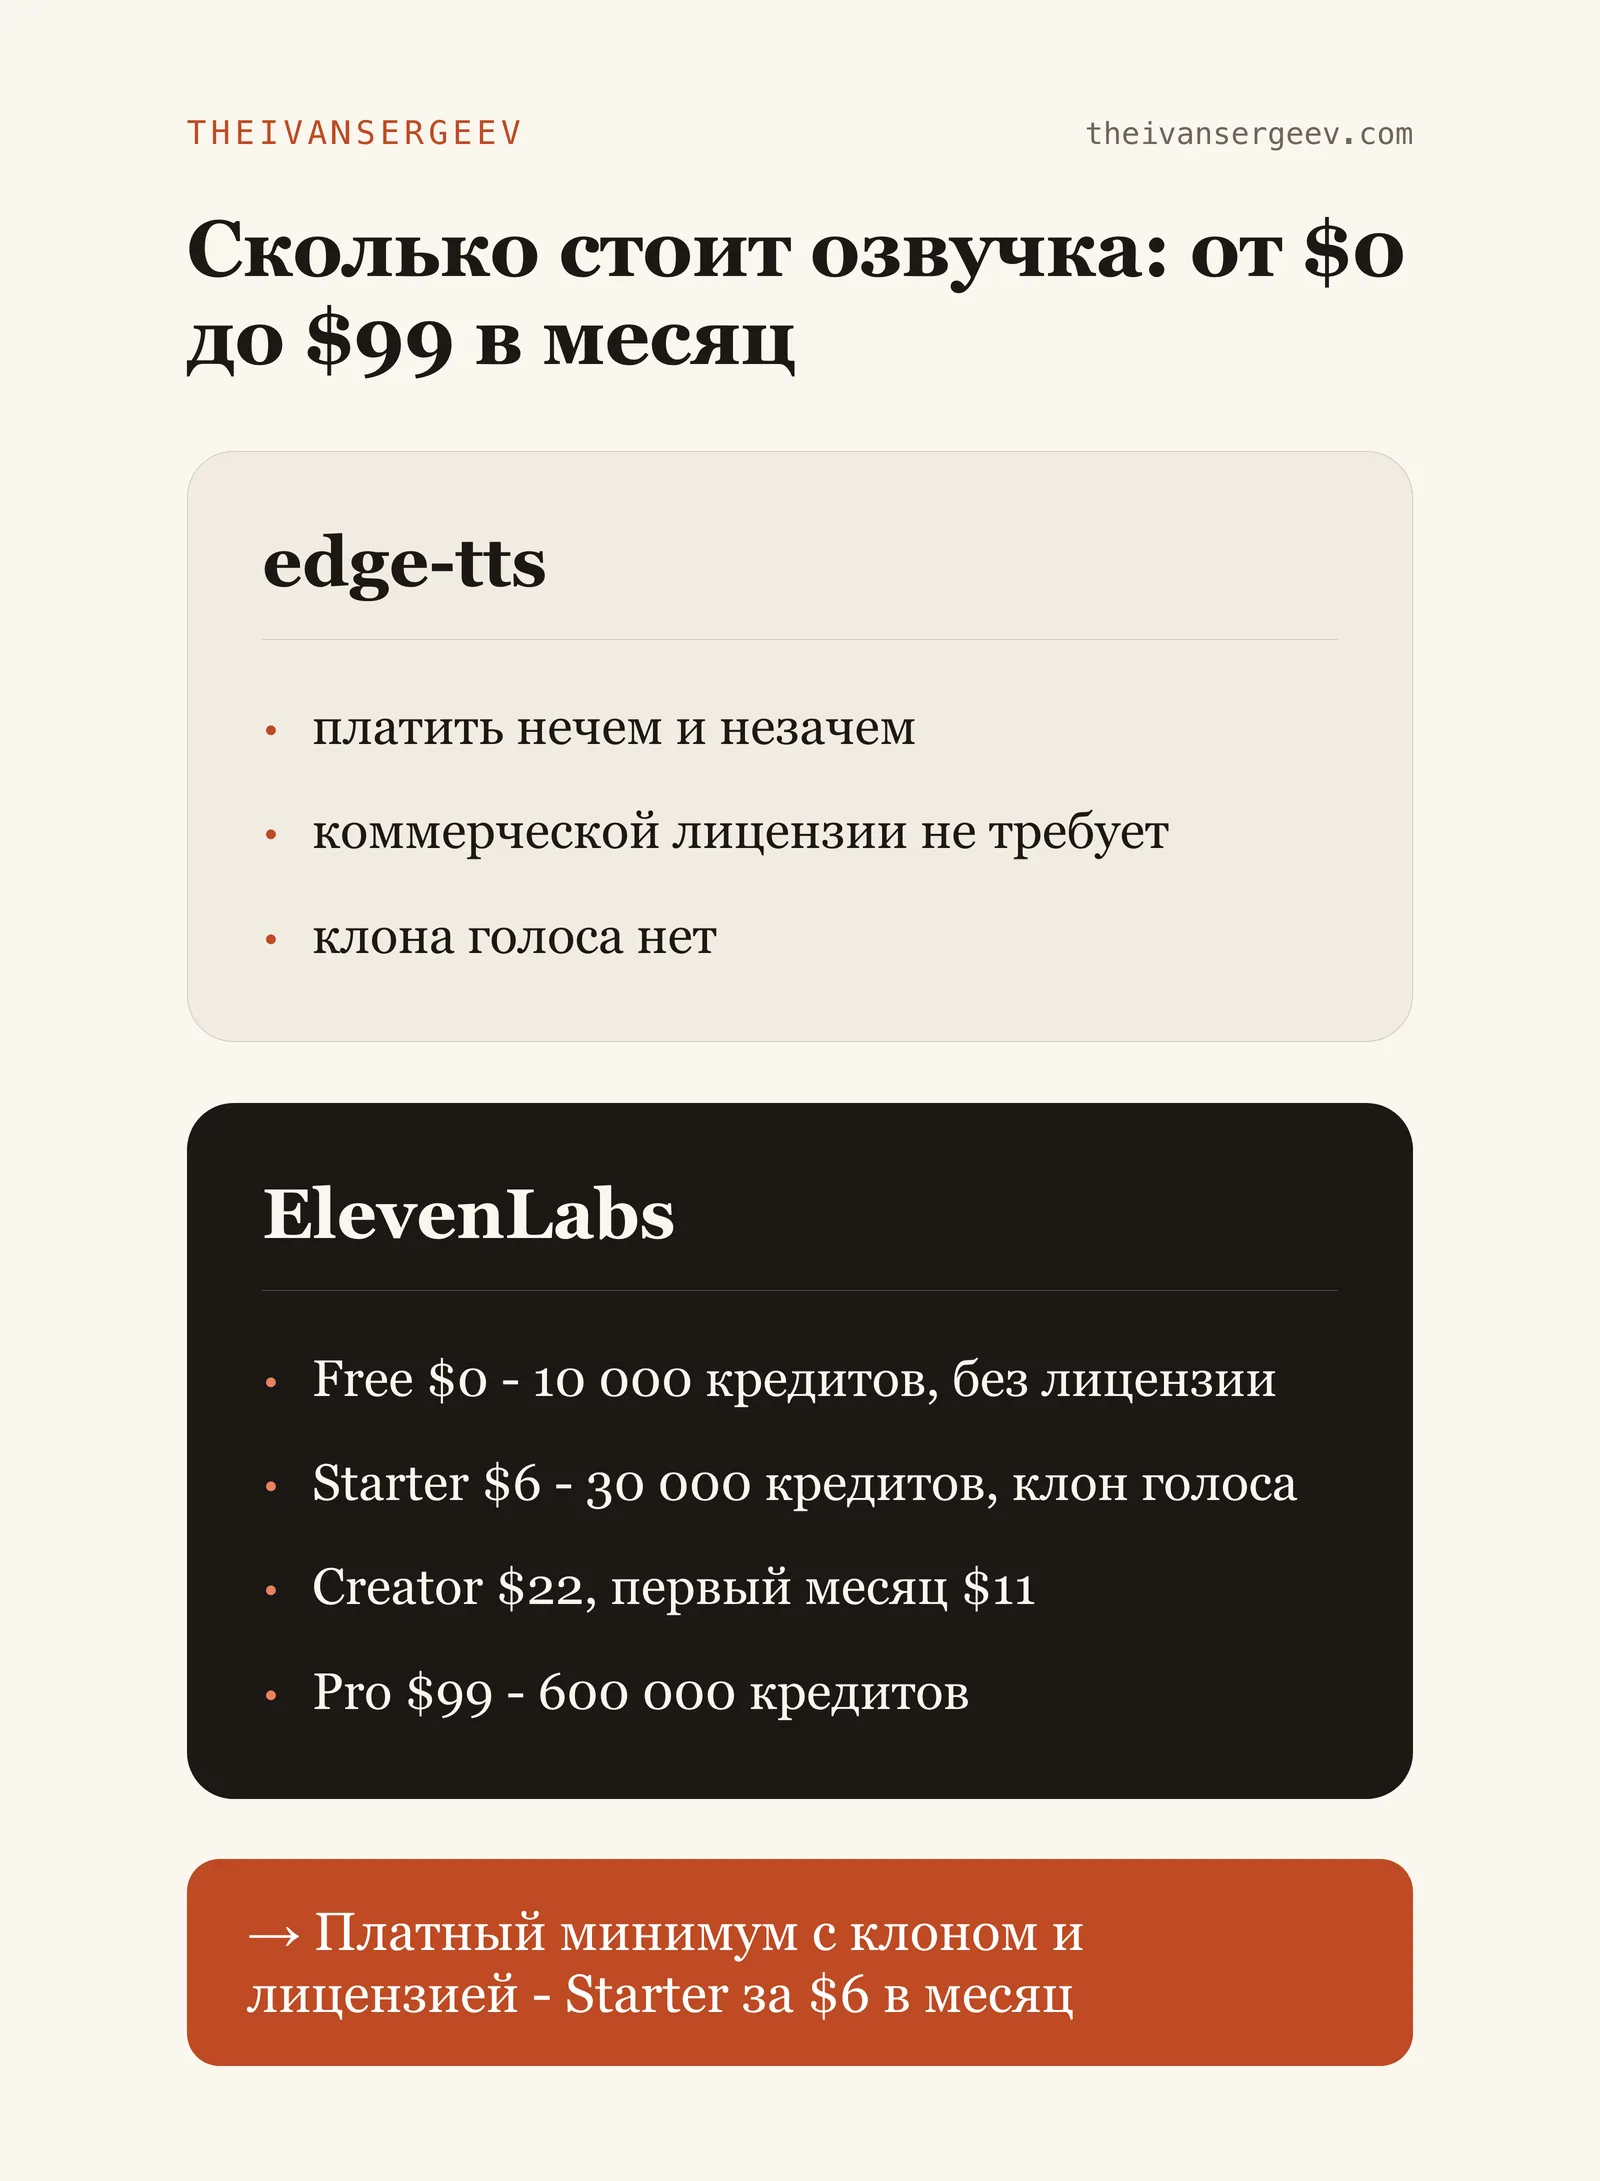
Озвучка стоит от нуля до $99 в месяц, и цена зависит не от качества звука, а от двух вещей: нужна ли коммерческая лицензия и нужен ли клон голоса. Платный минимум у ElevenLabs - $6 в месяц, и этих денег хватает большинству
| План ElevenLabs | Цена в месяц | Кредитов | Что открывает |
|---|---|---|---|
| Free | $0 | 10 000 | проба, без коммерческой лицензии |
| Starter | $6 | 30 000 | коммерческая лицензия, клон голоса, Dubbing Studio |
| Creator | $22, первый месяц $11 | 121 000 | профессиональный клон голоса |
| Pro | $99 | 600 000 | объём под курс или подкаст |
Кредит равен одному знаку текста, так что перевод в минуты считается на салфетке: 30 000 кредитов Starter - это около тридцати минут готовой начитки в месяц. Дальше цена одной минуты падает: у Pro за $99 идёт 600 000 кредитов, то есть примерно десять часов
С российскими сервисами вышло грустнее. У SaluteSpeech от Сбера для физлиц был бесплатный уровень на 200 000 символов синтеза в месяц и пакет на 1 000 000 символов за 1000 ₽. Именно был: страница тарифов сообщает, что с 15 июля 2026 продажа новых пакетов и продление Freemium для физических лиц остановлены, действующие пакеты доживают свой срок. У Yandex SpeechKit оплата посимвольная, актуальную цену смотри на странице тарификации - она меняется, и приводить её по памяти я не буду
Теперь про оплату, честно. Российские карты в платёжной форме ElevenLabs напрямую не проходят, гайд vc.ru от 5 июля 2026 разбирает обходные пути через посредников. Бесплатного плана и edge-tts это не касается вообще - там платить нечем и незачем
Почему нейросеть коверкает ударения, числа и сокращения?
Русский текст ломает синтез речи в трёх одинаковых местах: омографы вроде «замок» и «мука», цифры внутри предложения и сокращения. Лечится это правкой текста и словарём произношения, а не сменой сервиса - в новом сервисе будут ровно те же грабли
Грабля первая: омографы. Слова «замок», «мука», «духи» без контекста читаются наугад, и модель регулярно попадает мимо. Простое лекарство - переписать фразу так, чтобы слово стало однозначным: не «замок на горе», а «старинная крепость на горе». Локальная модель Silero в версии v5_5_ru заявляет поддержку автоударений и разбора омографов, у облачных сервисов такой гарантии нет
Вторая беда - цифры и даты. «25.07» модель прочитает то как «двадцать пять ноль семь», то как дату, «1500 ₽» может стать «одна тысяча пятьсот рубль». Тут работает грубая сила: всё, что важно, пишем словами прямо в тексте для озвучки. Отдельный файл под озвучку с прописанными числами экономит больше времени, чем любые настройки
Третья беда - имена, бренды и аббревиатуры, и у ElevenLabs под неё есть штатное решение. Словари произношения в Studio живут в Pronunciations Editor, через API подключаются отдельным словарём. Поддерживаются и замена по алиасу, и точная фонетическая запись через IPA или CMU. Заводишь правило один раз, и «HeyGen» перестаёт звучать как «хейген» во всех проектах
Есть и четвёртая, невидимая: длинные абзацы. Модель дышит по знакам препинания, и текст на десять строк без точки она читает на одном дыхании. Режь абзацы на 2-4 предложения - это одновременно лечит и озвучку, и читаемость исходника
Как озвучивать локально, без интернета и подписки?
Локально русский текст озвучивает Silero: модель скачивается один раз и дальше работает на твоём компьютере без интернета, без аккаунта и без оплаты. В модели v5_5_ru пять голосов - aidar, baya, kseniya, xenia, eugene - и частоты дискретизации 8000, 24000 и 48000 Гц
Минимальный рабочий пример на Python выглядит так:
import torch

model, example_text = torch.hub.load(
    repo_or_dir='snakers4/silero-models',
    model='silero_tts',
    language='ru',
    speaker='v5_5_ru')
model.to(torch.device('cpu'))

audio = model.apply_tts(
    text='Привет. Это локальная озвучка на своём компьютере.',
    speaker='xenia',
    sample_rate=48000)
Что увидишь: при первом запуске модель скачается в кэш PyTorch, дальше запуски идут без сети. На выходе получается тензор со звуком, который сохраняется в wav-файл стандартными средствами
Главное ограничение живёт не в технике, а в лицензии. Основные модели Silero выложены под CC-NC-BY, то есть некоммерческое использование - продавать озвученный ими курс нельзя. Под MIT лежат только базовые модели cis-tts. Проверь лицензию до того, как соберёшь на этом продукт: переделывать озвучку сорока уроков после запуска - худший способ провести неделю
Зачем вообще связываться с локальным путём, если облако удобнее. Тексты не уходят наружу, счёт за кредиты не растёт с объёмом, конвейер не встаёт, когда у сервиса падает API или заканчивается лимит
Что меняется, когда голос перестаёт быть узким местом
Озвучка снимает главный тормоз видеоконтента: у меня 62 знака текста превратились в 6 секунд звука за 3,2 секунды работы команды edge-tts. Записывать себя перестаёт быть обязательным шагом, и текст едет в звук быстрее, чем ты успеваешь настроить микрофон
Дальше меняется сама логика производства. Раньше цепочка была «выспаться, привести себя в порядок, дождаться тишины, записать, переписать три дубля». Теперь цепочка другая: написал текст, прогнал через синтез, положил дорожку под картинку. Плохое настроение, севший голос и ремонт у соседей перестают быть причинами сорвать выпуск
Второй эффект - переделки становятся дешёвыми. Раньше правка одного предложения в середине урока означала переписать блок целиком и подгонять склейку. Теперь правишь строку в файле, гоняешь команду и получаешь новую дорожку без единого дубля
Третий эффект - масштаб. Один текст легко превращается в русскую и английскую версии, в короткий вертикальный ролик и в длинный урок, причём одним и тем же голосом. Это уже не «записать видео», а сборка на конвейере, и работает она с любым объёмом
Оговорюсь честно: сама по себе озвучка денег не приносит. Она убирает трение из производства, а результат зависит от того, что ты производишь и кому это нужно. О том, какие умения закрывают остальные шаги контента, я писал в разборе про 10 скиллов Claude для текстов и рилсов
Где заканчивается озвучка и начинается система
Озвучка закрывает один шаг конвейера из десяти: голос есть, а сценария, монтажа, обложки и выкладки нет - их не отдаст ни edge-tts, ни ElevenLabs. Четыре инструмента из этой статьи закрывают каждый свой кусок, готовый ролик целиком не выдаёт ни один из них
Первая половина статьи даёт рабочий результат: у тебя есть способ озвучить любой текст бесплатно, есть понимание, что делает платный план, и есть инструкция, как снять клон со своего голоса. Этого достаточно, чтобы озвучить курс, серию сторис или закадровый голос под ролики
Если хочешь сначала закрыть соседний кусок конвейера, посмотри промпты Claude под сценарии Reels - озвучка ложится на них следующим шагом
Источники
- ElevenLabs, страница тарифов - elevenlabs.io/pricing
- ElevenLabs, страница модели Eleven v3 - elevenlabs.io/v3
- ElevenLabs, анонс Eleven v3 и число языков - elevenlabs.io/blog/eleven-v3
- ElevenLabs, документация по Instant Voice Cloning - elevenlabs.io/docs
- ElevenLabs, справка о длительности образцов для клона - help.elevenlabs.io
- ElevenLabs, словари произношения - elevenlabs.io/docs
- rany2, репозиторий edge-tts - github.com/rany2/edge-tts
- HeyGen, страница тарифов - heygen.com/pricing
- Сбер, тарифы SaluteSpeech для физлиц - developers.sber.ru
- Yandex AI Studio, тарификация SpeechKit - aistudio.yandex.ru
- snakers4, репозиторий silero-models - github.com/snakers4/silero-models
- vc.ru, гайд по работе с ElevenLabs из России - vc.ru/services/3012451
Чек-лист: первая озвучка за один вечер
Сохрани себе
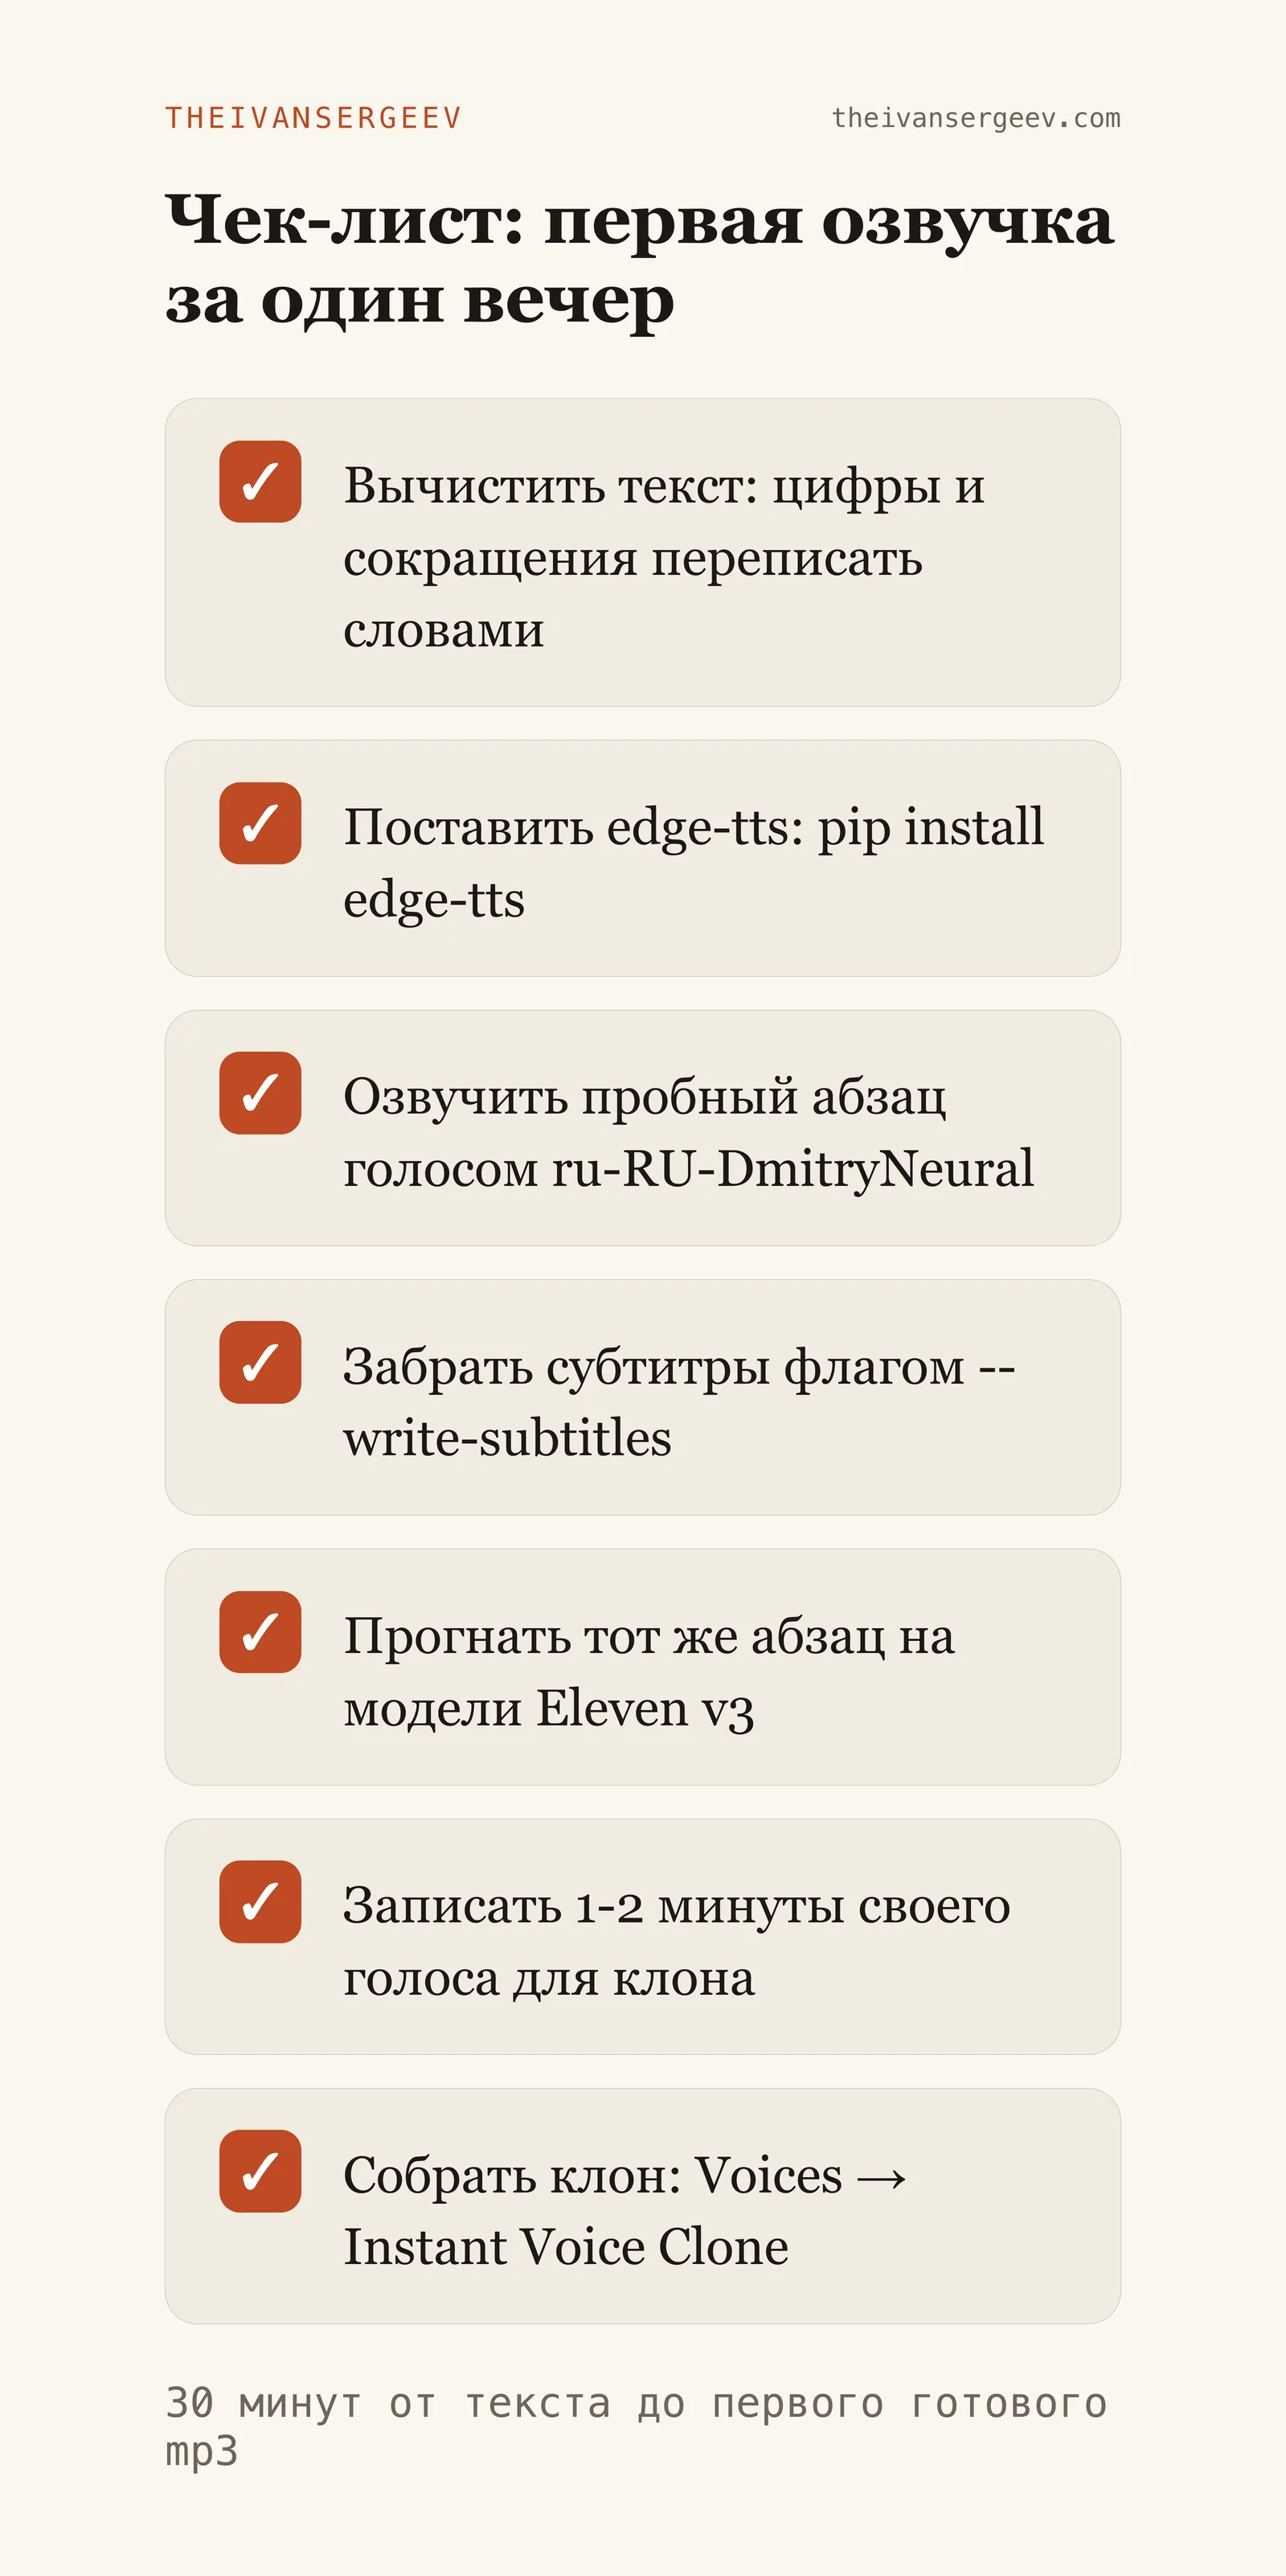
- Вычистить текст: цифры и сокращения переписать словами, абзацы порезать на 2-4 предложения
- Поставить edge-tts командой pip install edge-tts и посмотреть русские голоса через --list-voices
- Озвучить пробный абзац голосом ru-RU-DmitryNeural и послушать, где режет ухо
- Забрать заодно файл субтитров флагом --write-subtitles
- Завести бесплатный аккаунт ElevenLabs и прогнать тот же абзац на модели Eleven v3
- Сравнить две дорожки на трёх минутах подряд, а не на одной фразе
- Записать 1-2 минуты своего голоса в тихой комнате одной интонацией
- Собрать клон через Voices → плюс → Instant Voice Clone и подтвердить права на голос
- Проверить спорные слова: имена, бренды, аббревиатуры, омографы
- Решить по объёму: до десяти минут в месяц хватает бесплатного, дальше нужен план от $6
ИИ-Лагерь · три дня, бесплатно
Люди заходят на Лагерь без единого озвученного ролика
И к третьему дню в чате у них уже готовый сценарий с озвучкой и обложкой, а не одинокий голос без текста вокруг. Меня самого это каждый раз удивляет
Заявка в закрытый канал, одобряю сразу. Бот сам напишет первым и покажет, как забрать три дня Лагеря. Бесплатно
Частые вопросы
Какая нейросеть для озвучки текста лучше на русском?
Для качества и клона голоса - ElevenLabs с моделью Eleven v3, она поддерживает больше 70 языков, включая русский. Для бесплатных черновиков - edge-tts с голосами ru-RU-DmitryNeural и ru-RU-SvetlanaNeural. Для дубляжа готового видео - HeyGen с переводом на 175+ языков. Выбор зависит от задачи, а не от рейтингов
Можно ли озвучить текст нейросетью бесплатно?
Да. Модуль edge-tts работает бесплатно и не просит ни карту, ни аккаунт, ни ключ API: ставится командой pip install edge-tts и сразу отдаёт mp3. У ElevenLabs бесплатный план даёт 10 000 кредитов в месяц, это примерно десять минут аудио, но без коммерческой лицензии
Сколько нужно записи, чтобы клонировать свой голос?
Документация ElevenLabs просит примерно 1-2 минуты чистого аудио без эха и шумов и предупреждает не записывать больше трёх минут: качество от этого не растёт, а иногда падает. Важна суммарная длительность, а не количество файлов. Формат - MP3 от 128 kbps либо WAV на 44,1 или 48 кГц
Сколько стоит нейросеть для озвучки?
У ElevenLabs на 7 августа 2026: Free $0 за 10 000 кредитов, Starter $6 за 30 000, Creator $22 за 121 000, Pro $99 за 600 000. Один кредит равен одному знаку текста. У HeyGen дубляж видео начинается с плана Creator за $29 в месяц
Работает ли ElevenLabs в России и можно ли оплатить российской картой?
Российские карты в платёжной форме напрямую не проходят, обходные пути через посредников разбирает гайд vc.ru от 5 июля 2026. Бесплатный план при этом доступен без карты, а edge-tts и Silero не требуют оплаты вообще
Как озвучить видео нейросетью на другом языке?
Загрузи ролик в HeyGen и выбери перевод: сервис переозвучивает речь клоном голоса спикера и подгоняет губы под новый язык, языков заявлено больше 175. Альтернатива - Dubbing Studio у ElevenLabs, она открывается на плане Starter за $6, но синхронизации губ там нет
Почему нейросеть неправильно ставит ударения в русских словах?
Модель не понимает контекст и на омографах вроде «замок» или «мука» выбирает вариант наугад. Чинится тремя способами: переписать фразу, чтобы слово стало однозначным; завести словарь произношения в ElevenLabs; взять локальную Silero v5_5_ru, где заявлена поддержка автоударений и омографов
Вайбмаркетинг и вайбкодинг для тех, кто начинает с нуля. Разбираю ИИ-инструменты по шагам и показываю на своих проектах
Читайте также
Контент через нейросеть: месяц постов из одной голосовой за 30 минут
Как из одной голосовой заметки собрать месяц постов нейросетью
Claude сам монтирует Reels: РИЛЗЫ на автомате из видео-библиотеки
Как Claude собирает вертикальные Reels из готовых дублей
Claude для контента: 10 скиллов для создания текстов и рилсов
10 скиллов Claude, которые закрывают тексты и рилсы
Текст нейросети: как убрать слова-маркеры ИИ и сделать его живым
Как убрать из текста нейросети слова-маркеры и штампы