Вайбмаркетинг · монтаж рилзов без таймлайна · сентябрь 2026
Нейросеть-монтажёр рилзов: 3 сообщения вместо часа монтажа
Ты записал рилз одним дублем, а дальше - час или два на таймлайне: вырезаешь «э-э», ищешь повторы фразы, вручную натягиваешь субтитры. Нейросеть с доступом к папке на компьютере (Cowork в Claude или Work в ChatGPT) делает это одним сообщением: сама вызывает 2 бесплатные программы - ffmpeg и whisper.cpp - и добавляет субтитры.
Скопируй, открой Cowork в Claude или Work в ChatGPT и вставь как есть:
В папке лежит video.mp4 - запись рилза одним дублем. Вырежи паузы длиннее секунды,
оговорки вроде "э-э" и "ну" и повторные заходы на одну и ту же фразу - оставь только
последний чистый вариант. Сохрани результат как video-clean.mp4
Замени video.mp4 на имя своего файла.
Включается это в два клика. В Claude открой поле сообщения и выбери режим «Cowork» рядом с ним (в новой версии Cowork включается сам, переключать не нужно). В ChatGPT рядом с полем ввода выбери «Work» вместо «Chat». Дальше подключи папку с видео - приложение само предложит её выбрать.
Cowork/Work: подключить папку → написать задачу словами → получить готовый файл + список спорных местДальше в статье: как включить нужный режим по шагам, из чего это работает и что делать, если что-то пошло не так.
Подключи Claude Cowork или ChatGPT Work к папке с видео и напиши одним сообщением, что вырезать. Нейросеть сама ставит ffmpeg (резка и звук) и whisper.cpp (распознавание речи локально) и за один проход отдаёт чистый файл с субтитрами.
Что вообще нужно, чтобы нейросеть сама монтировала
Обычный чат с нейросетью файлы на компьютере не видит - только то, что ты вставил текстом. Чтобы она могла открыть видео, порезать его и записать результат рядом, ей нужен отдельный режим с доступом к папке:
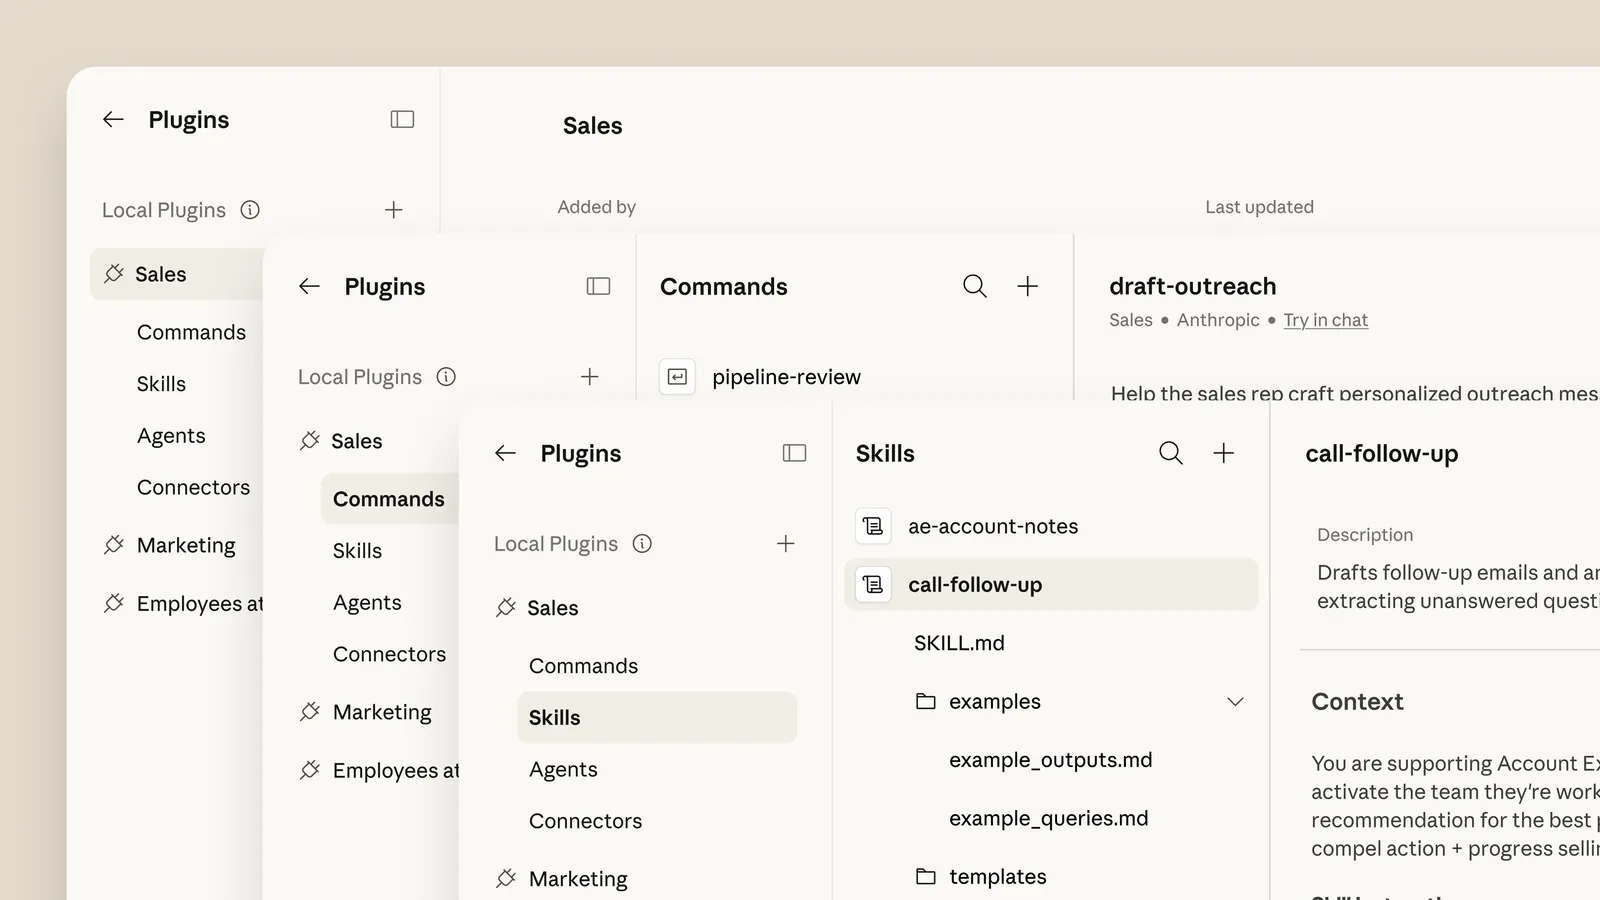
Claude в режиме Cowork. Указываешь конкретную папку на своём компьютере, и Claude читает и пишет файлы только в ней - ни на что за её пределами доступа нет. Работает в десктоп-приложении Claude.
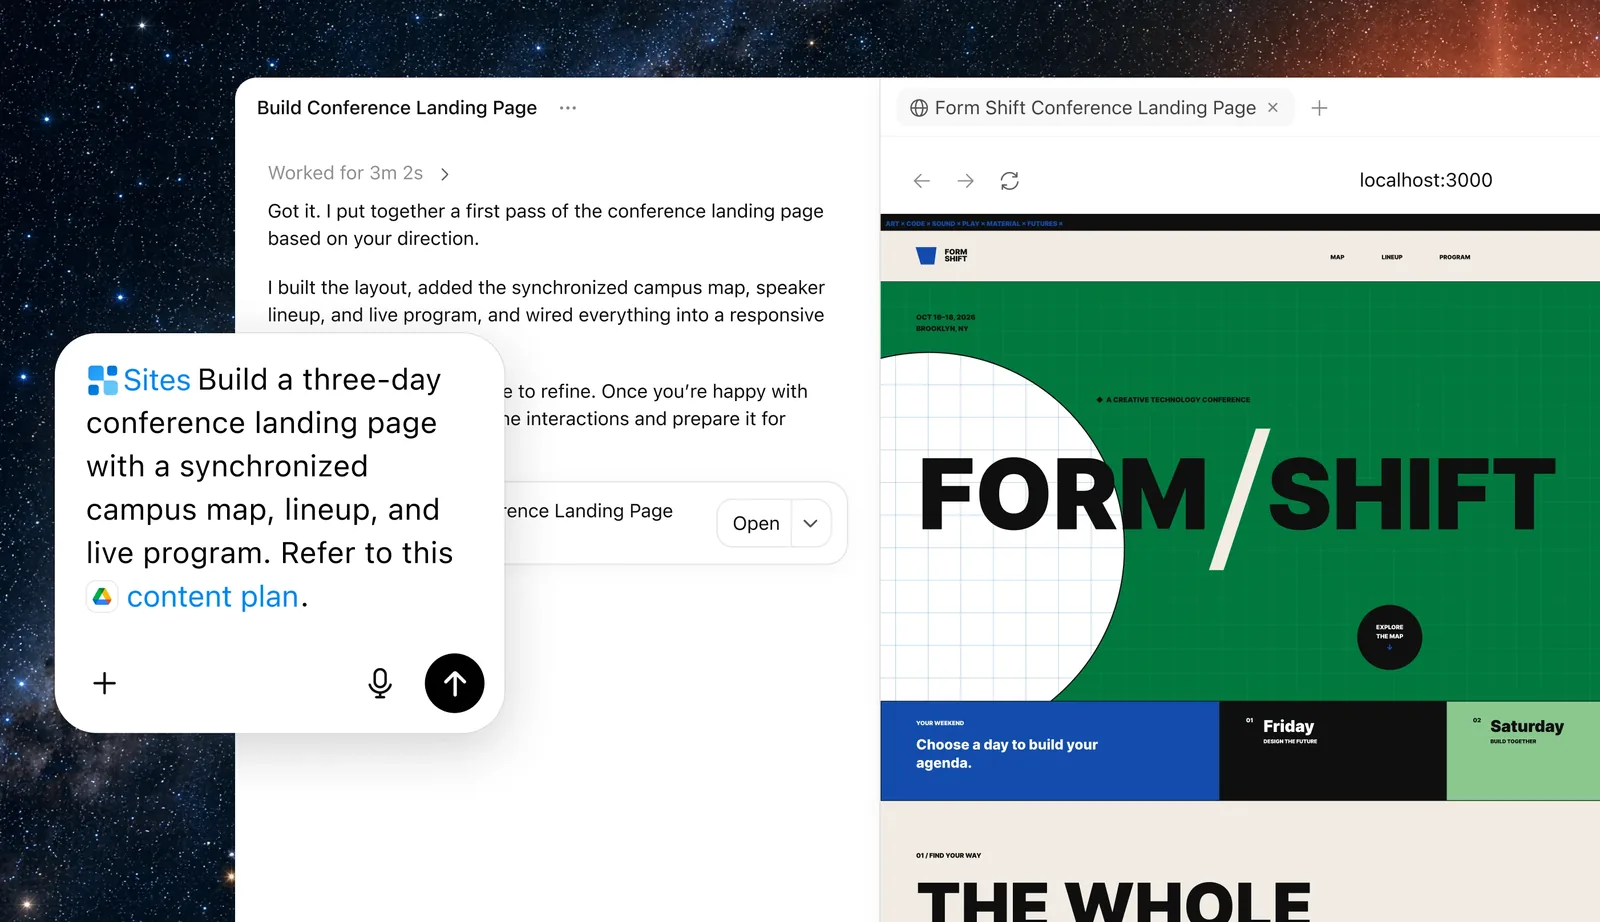
ChatGPT в режиме Work. Тот же принцип: агент для длинных многошаговых задач, а не для быстрых ответов. Доступ к файлам на диске есть только в десктоп-приложении - в браузере или на телефоне Work работает в облаке и до твоих файлов не достаёт.
Любой из двух вариантов подходит. Разницы в результате для монтажа нет - дальше вся механика одинаковая.
Из чего это работает
Сама нейросеть видео не режет и речь не распознаёт - для этого она вызывает две отдельные бесплатные программы, как человек вызывал бы их из терминала:
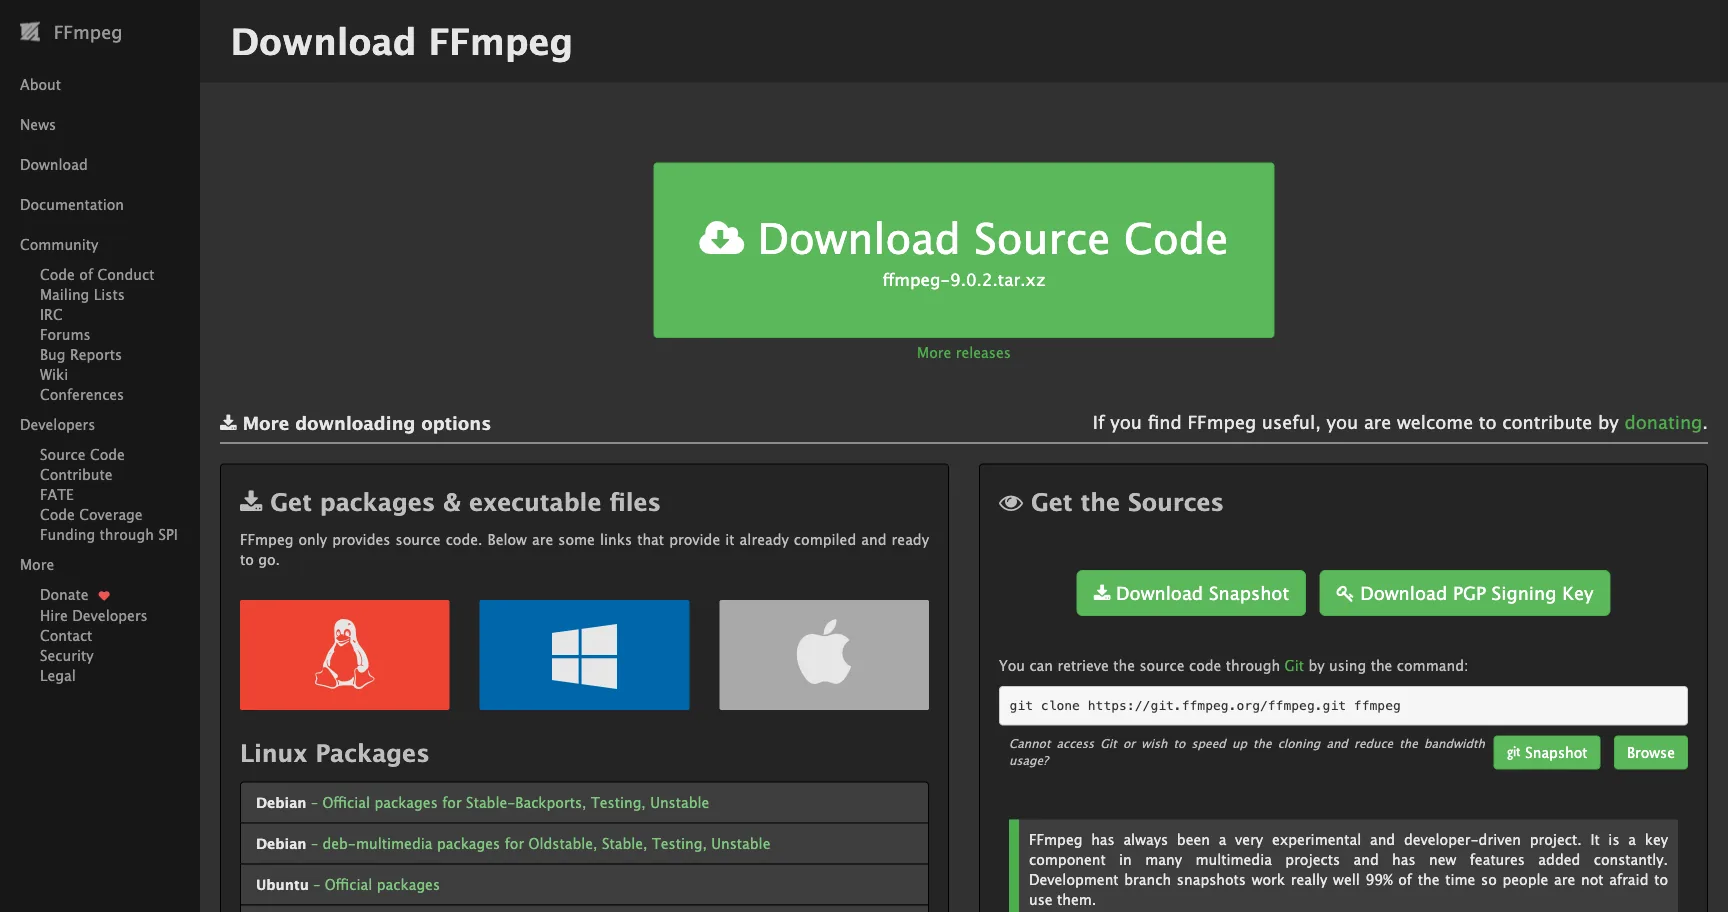
ffmpeg режет ролик, склеивает куски и выравнивает громкость. Программа с открытым кодом, бесплатна для любого использования.
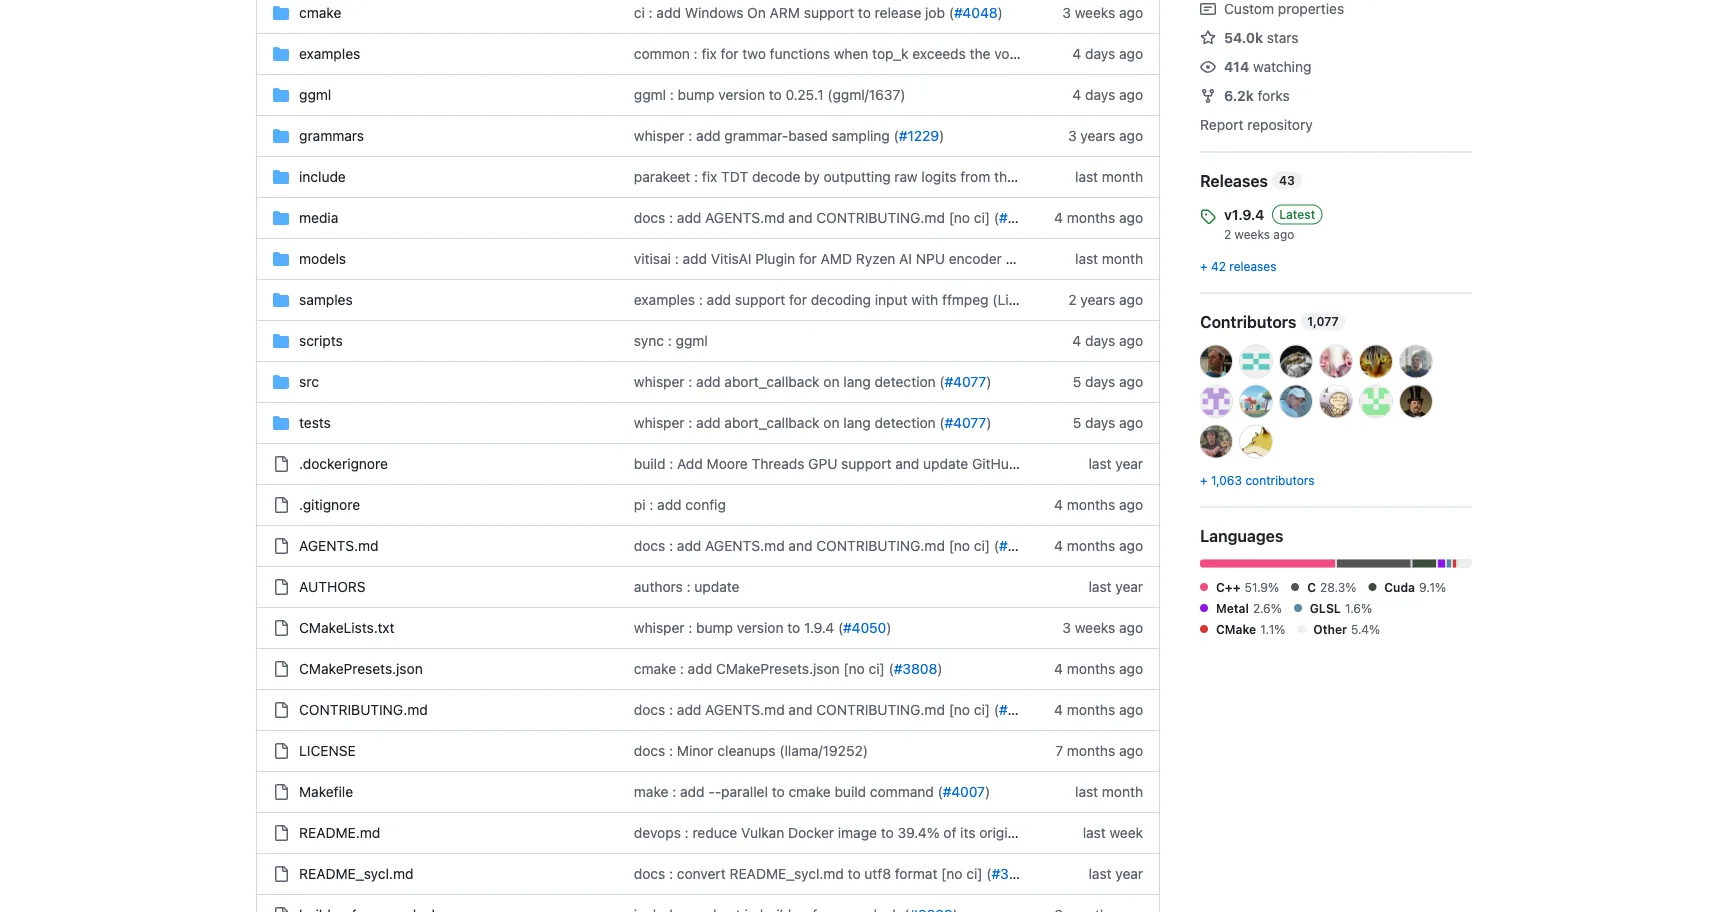
whisper.cpp превращает речь в текст с таймкодами - отсюда нейросеть узнаёт, где пауза, где повтор фразы, и на этом же тексте строит субтитры. Это тоже открытый код, лицензия MIT, и главное отличие от онлайн-распознавания - запись никуда не отправляется, всё считается локально.
Я прогнал оба инструмента на реальной записи речи: whisper-cli с моделью на 487 МБ распознал 11 секунд речи за 407 миллисекунд без подключения к интернету, текст совпал с записью слово в слово, а ffmpeg вырезал кусок и выровнял громкость за 0.09 секунды. Полные логи прогона лежат рядом со статьёй
Платишь в этой связке ровно за одно - подписку на саму нейросеть (Claude или ChatGPT), которой и так пользуешься. ffmpeg и whisper.cpp денег не берут ни за что.
Как попросить нейросеть словами, а не через таймлайн
Дальше три сообщения, которые закрывают почти весь монтаж рилза. Пишешь их обычным текстом в чат Cowork/Work, без единого термина программиста.
Первое сообщение (то самое, что ты уже отправил в начале статьи, после того как подключил папку):
В папке лежит video.mp4 - запись рилза одним дублем. Вырежи паузы длиннее секунды,
оговорки вроде "э-э" и "ну" и повторные заходы на одну и ту же фразу - оставь только
последний чистый вариант. Сохрани результат как video-clean.mp4
Второе (звук и субтитры):
Теперь выровняй громкость по всему ролику и наложи субтитры по словам поверх
video-clean.mp4. Сохрани с субтитрами как video-final.mp4
Третье, если нейросеть на чём-то застряла:
Покажи ровно то место, где ты не уверена, и почему - я отвечу словами, что с ним делатьТретье сообщение реально работает: модель сама останавливается там, где два голоса наложились друг на друга или речь звучит нечётко, показывает именно это место вместо того, чтобы гадать - отвечаешь ей парой слов, и она продолжает.
Получилось или нет
Открой video-final.mp4 и проверь на глаз и на слух:
| Что проверяешь | Хороший результат |
|---|---|
| Паузы между фразами | Нет провисаний длиннее обычной паузы в разговоре |
| Оговорки и "э-э" | Не слышно ни одной, речь идёт сплошным потоком |
| Повторные дубли | Каждая мысль звучит один раз, а не два-три подряд |
| Громкость | Ровная от начала до конца, без резких провалов и всплесков |
| Субтитры | Появляются вместе с речью, слово в слово, без рассинхрона |
Таблица прокручивается вбок →
Если что-то из списка не выполнено - вернись в чат и опиши ровно эту проблему тем же простым языком: «в третьей минуте субтитры отстают» работает лучше, чем «переделай всё».
Развилки: если у тебя другой случай
Запись длиннее нескольких минут. Первое сообщение остаётся тем же, просто добавь: «файл длинный, работай частями по 5 минут и покажи прогресс после каждой части» - так проще следить, что происходит, и не упереться в лимит одного ответа модели.
Хочешь Claude, но привык к ChatGPT (или наоборот). Механика одинаковая для обоих, слова из примеров выше не меняются ни на букву - разница только в том, где именно в приложении включается Cowork или Work. Claude ещё не стоит - вот гайд по установке с нуля.
Несколько роликов подряд. Не переоткрывай папку заново на каждый файл - в одном сообщении перечисли имена всех файлов и попроси обработать по очереди тем же правилом. Похожим способом можно резать паузы и словами через Codex - смотри разбор монтажа видео словами.
Нужно не почистить черновик, а собрать ролик из кусков длинной записи. Это другая задача - выбор нужных фрагментов, а не автоматическая чистка. Для неё у меня есть отдельный разбор: монтаж видео через Claude.
Голос двух людей в одной записи (интервью, дуэт). Уточни в первом сообщении: «в записи два голоса, субтитры подписывай именем говорящего» - whisper.cpp различает смену голоса по паузам и интонации, а не по одной короткой фразе.
Что ломается и что делать
| Что видишь | Причина | Что сделать |
|---|---|---|
| Нейросеть пишет, что не видит файл | Папка не подключена или подключена другая | Проверь в настройках Cowork/Work, какая именно папка выбрана |
| Просит поставить программу и виснет | Первая установка ffmpeg или whisper.cpp идёт через сеть, медленное соединение | Подожди - это разовая установка, дальше все следующие ролики обрабатываются без неё |
| Субтитры на английском вместо русского | Модель распознавания взяла язык по умолчанию | Напиши прямо: «распознавай речь по-русски» |
| Вырезала лишний кусок с настоящей мыслью | Пауза внутри мысли была длиннее, чем между репликами | Уточни порог словами: «не режь паузы короче двух секунд» |
| Результат не появился в папке | Нейросеть сохранила файл под другим именем | Спроси прямо: «под каким именем ты сохранила результат» |
Таблица прокручивается вбок →
Сколько это реально занимает
| Что | Сколько времени | Как часто |
|---|---|---|
| Разовая настройка (поставить Cowork/Work, дать команду на установку ffmpeg и whisper.cpp) | 5-10 минут | один раз |
| Распознавание речи на твоём компьютере | секунды (мой прогон - 407 мс на 11 с речи) | на каждый рилз |
| Сама нейросеть читает результат и решает, что резать | минуты, зависит от длины записи | на каждый рилз |
Таблица прокручивается вбок →
Деньгами это не сильно отличается от того, что ты уже платишь: единственная статья расхода - подписка на Claude или ChatGPT, которой ты и так пользуешься для остального. Отдельно за ffmpeg или whisper.cpp платить нечего.
Что дальше
Три сообщения выше закрывают монтаж одного рилза. Если тексты для нейросети хочется не придумывать самому, а взять готовыми и точными - у меня есть отдельный разбор, как самому находить системные инструкции топовых нейросетей (те самые правила, которые задают им стиль ответа) и собирать из них свою за 4 шага. А если после монтажа нужна ещё и сборка самого ролика по скрипту - смотри подборку готовых наборов скиллов для сборки рилза в Claude Code.
Задача этой статьи - почистить ОДНУ уже готовую запись. Если вместо этого у тебя часовой эфир или подкаст, который нужно нарезать на несколько отдельных роликов, - это другая механика, смотри разбор автонарезки видео нейросетью.
Источники
- Get started with Claude Cowork - Claude Help Center, официальная инструкция подключения папки
- ChatGPT Work and Codex - OpenAI Help Center, режим Work и доступ к файлам компьютера
- FFmpeg - официальный сайт, бесплатная лицензия LGPL/GPL
- ggml-org/whisper.cpp - официальный репозиторий на GitHub, лицензия MIT
Памятка: три сообщения для монтажа рилза
Скопируй и вставь, поменяв только имя файла
Сохрани себе
- Подключи папку с видео в Cowork (Claude) или Work (ChatGPT)
- Сообщение 1 - вырезать паузы, оговорки и повторные дубли, сохранить как video-clean.mp4
- Сообщение 2 - выровнять громкость и наложить субтитры, сохранить как video-final.mp4
- Сообщение 3 (если нужно) - попросить показать спорное место и объяснить, что с ним делать
Куда это ведёт
Монтаж - это один процесс, а стабильный поток контента - другой
Убрать ручной монтаж - хорошо, но дальше встаёт вопрос: что снимать, как часто и что с этим потоком делать. На Лагере я веду через сборку контент-процесса целиком, на живом проекте
Кнопка ведёт в мой закрытый канал. Жмёшь «Подать заявку», впускаю сразу, бот пишет в личку и отдаёт путёвку
Частые вопросы
Это точно бесплатно, а не скрытая подписка?
ffmpeg и whisper.cpp - бесплатные программы с открытым кодом, денег не берут ни за что. Платишь только за подписку на саму нейросеть (Claude или ChatGPT), которой и так пользуешься
Нужно ли уметь программировать?
Нет. Все три сообщения из статьи - обычный текст на русском языке, без единой команды терминала. Нейросеть сама вызывает программы внутри себя
А если у меня только браузерная версия ChatGPT или Claude, без десктоп-приложения?
Доступ к файлам на компьютере есть только в десктоп-приложении - Claude Desktop или приложение ChatGPT. В браузере и на телефоне Cowork/Work работают, но без доступа к твоему диску
Куда уходит моя запись, она загружается в интернет?
Само видео обрабатывает ffmpeg на твоём компьютере. Распознавание речи через whisper.cpp тоже идёт локально, без отправки записи на сторонний сервер - это и есть его отличие от онлайн-распознавания
Что если нейросеть вырезала что-то важное по ошибке?
Всегда работай с копией исходной записи, а не с оригиналом, и попроси нейросеть сохранять результат отдельным файлом (как в примерах выше) - оригинал при этом остаётся нетронутым
Читать дальше
Я соло-предприниматель на Claude, Claude Code и агентах
Всё, что не влезает в статью, лежит у меня в канале: разборы бесплатных инструментов раньше, чем о них снимают ролики, и внутрянка моих вайб-маркетинговых проектов
Открытый канал, подписка в одно нажатие