Гайд · учёба и ИИ · август 2026
Нейросеть для курсовой: 7 шагов от плана до декларации
Нейросеть закрывает механическую часть курсовой: план глав, черновой список литературы, редактуру твоих формулировок и вопросы оппонента. Тезис, данные предприятия и ответы на защите остаются твоими. Ниже маршрут из 7 шагов: план за 53 секунды, сверка каждого источника по каталогу, декларация использования ИИ из 4 пунктов и цена проверки от 466 ₽
Нейросеть закрывает механическую часть курсовой: план глав, черновой список литературы, редактуру твоих формулировок и вопросы оппонента. Тезис, данные предприятия и ответы на защите остаются твоими. Ниже маршрут из 7 шагов: план за 53 секунды, сверка каждого источника по каталогу, декларация использования ИИ из 4 пунктов и цена проверки от 466 ₽
Чего в этой статье нет
Промпта, который напишет курсовую за тебя, здесь не будет
Ниже маршрут, где автор ты, а модель работает ассистентом: приносит, раскладывает и задаёт неудобные вопросы. Готовый текст под сдачу тут не выдают. Зато остаётся навык, который живёт дольше зачётки, и эту линию я веду дальше в закрытом канале ИИ-Лагерь
Что нейросеть делает с курсовой, а что остаётся тебе?
Нейросеть снимает механическую часть работы и не трогает содержательную: план глав, черновой список литературы, редактура твоих формулировок и поиск дыр в логике уходят на минуты - план на 6 параграфов у меня вернулся за 53 секунды. Тезис, который ты защищаешь, данные конкретного предприятия и ответ на вопрос комиссии остаются твоими, потому что их физически неоткуда взять кроме твоей головы и твоего материала
Разделение проще увидеть таблицей. Слева этап работы, дальше - кто что делает
| Этап курсовой | Что берёт на себя модель | Что остаётся тебе |
|---|---|---|
| Формулировка темы | 5-7 вариантов сужения темы под объём | выбор и согласование с научруком |
| План глав | скелет с параграфами и логикой доказательства | сверка с методичкой кафедры |
| Список литературы | черновой список по теме | проверка, что каждый источник существует |
| Черновик | редактура твоего текста, поиск противоречий | сам тезис и фактура практической части |
| Оформление | подсказки по требованиям к структуре | приведение файла к методичке |
| Проверка | вопросы оппонента, слабые места | ответы на защите |
Таблица прокручивается вбок →
Логика такая: модель хорошо работает там, где есть образец и правило, и плывёт там, где нужно решение с ответственностью. План курсовой по менеджменту она видела тысячи раз, поэтому скелет выдаёт крепкий. А вот почему именно в твоём ООО текучесть выросла за год, она не знает и знать не может
Отсюда и весь дальнейший маршрут. Семь шагов, где на каждом ты остаёшься автором, а модель работает научным ассистентом. Такой сценарий не спорит с правилами вуза, и это следующий раздел
Что вуз считает нарушением, а что разрешает?
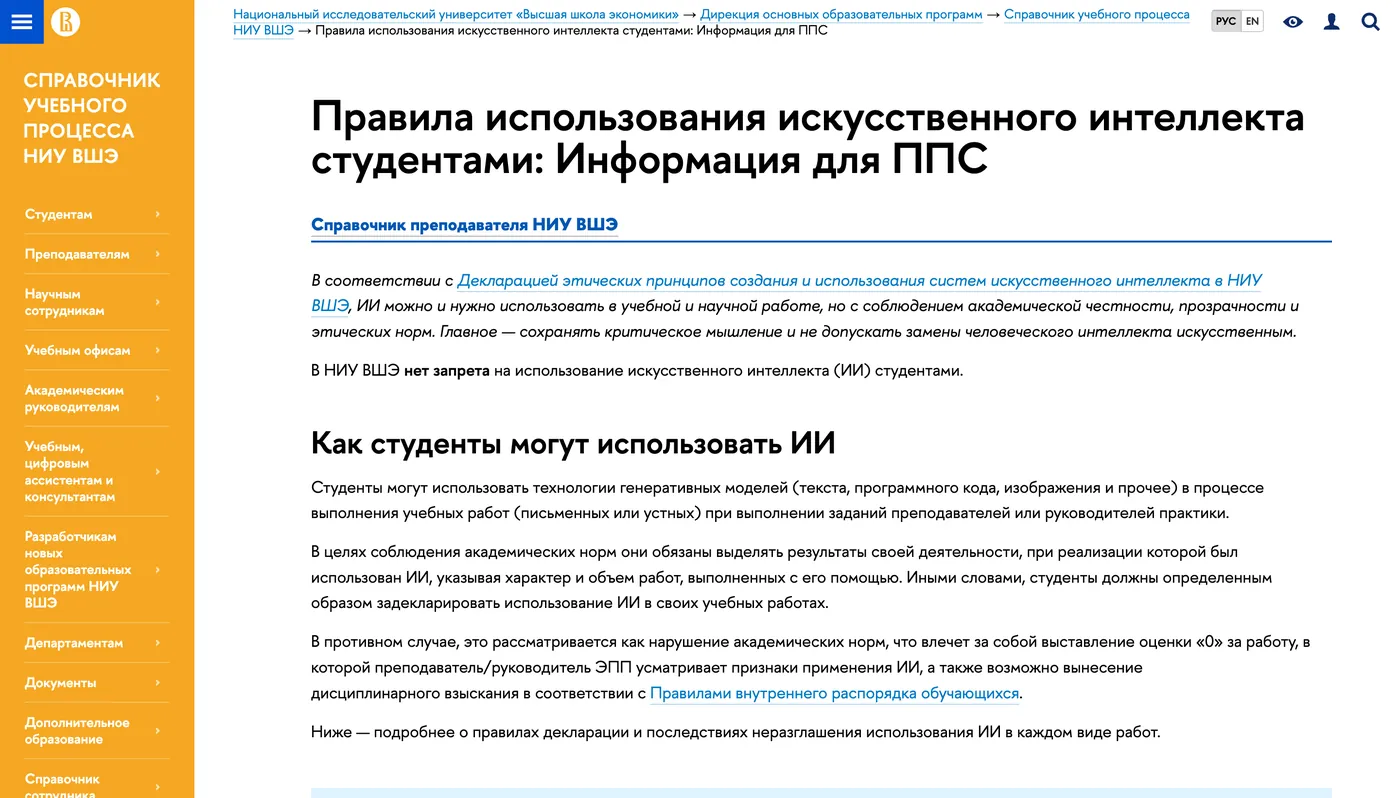
Само использование нейросети запрещено не везде: в регламенте НИУ ВШЭ, например, наказывают не за нейросеть, а за то, что студент о ней промолчал, и записано это в справочнике учебного процесса этого вуза. Формулировка не моя, и она разбивает главный студенческий страх «спалят и отчислят». Дальше по разделу держи в голове: это правила одного вуза, у твоего они могут быть другими
«В НИУ ВШЭ нет запрета на использование искусственного интеллекта (ИИ) студентами.»
НИУ ВШЭ, Правила использования искусственного интеллекта студентами
Дальше в том же документе стоит условие, ради которого этот раздел вообще написан:
«Иными словами, студенты должны определенным образом задекларировать использование ИИ в своих учебных работах. В противном случае, это рассматривается как нарушение академических норм, что влечет за собой выставление оценки «0» за работу, в которой преподаватель/руководитель ЭПП усматривает признаки применения ИИ, а также возможно вынесение дисциплинарного взыскания в соответствии с Правилами внутреннего распорядка обучающихся»
НИУ ВШЭ, Правила использования искусственного интеллекта студентами
ЭПП в этой цитате - элемент практической подготовки, то есть практика или проект с руководителем
Проверять умеют не на глаз. В том же тексте сказано, что система проверки работ на недопустимые заимствования с января 2024 года использует плагин для распознавания сгенерированных текстов, а незадекларированным считается «выявление в письменной учебной работе текста, созданного с использованием алгоритмов искусственного интеллекта, без заполнения специального раздела». Для курсовой цена вопроса - ноль за работу, для выпускной квалификационной, которая идёт частью итоговой аттестации, в правилах прямо названо отчисление как мера дисциплинарного взыскания
| Как ты работаешь | Как это читает вуз |
|---|---|
| попросил план, собрал работу сам, декларацию заполнил | правомерное использование, решает преподаватель |
| отдал модели свой абзац на редактуру и написал об этом | правомерное использование |
| сгенерировал текст целиком и промолчал | нарушение академических норм, оценка «0» |
| преподаватель запретил ИИ в программе дисциплины, а ты применил | нарушение, даже если декларация заполнена |
Таблица прокручивается вбок →
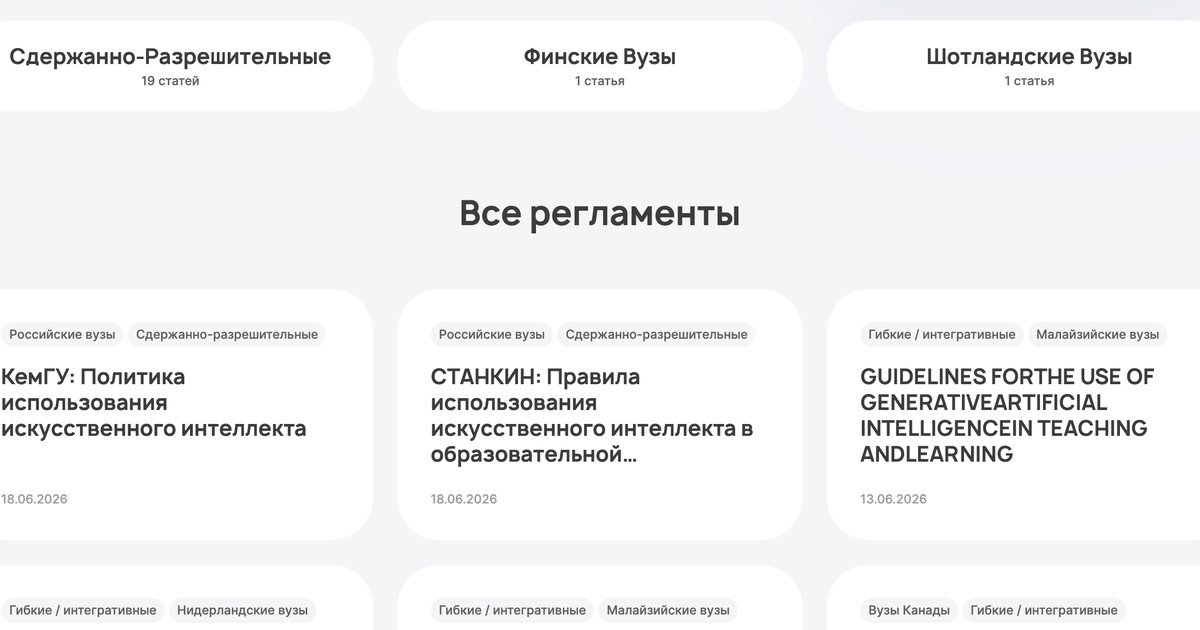
Теперь оговорка, без которой этот раздел был бы враньём. Правила у вузов разные, и одного общего документа по стране нет. Компания «Антиплагиат» вместе с Университетским консорциумом исследователей больших данных собрала библиотеку ИИ-регламентов: на 18.08.2026 там 35 материалов по российским вузам и 61 по категории гибких политик, а свежие карточки - КемГУ и СТАНКИН от 18.06.2026. Пятнадцать минут в этой библиотеке и на сайте своей кафедры стоят дешевле, чем пересдача
Дальше я исхожу из простого правила: любой шаг делается так, чтобы его можно было честно описать в декларации. Если шаг стыдно записать - его не делаем
Шаг 0: что приготовить до первого запроса
Три вещи, и первая из них не нейросеть: методичка кафедры, доступ к модели и один файл, куда ты складываешь куски работы. Пятнадцать минут на подготовку снимают половину будущих переделок
Методичка. Она лежит на сайте кафедры или у методиста, и в ней стоят четыре числа, которые задают всю работу: объём в страницах, количество источников, порог оригинальности и требования к оформлению списка литературы. Порог оригинальности задаёт вуз, а не сервис проверки, поэтому цифру берут отсюда и ниоткуда больше. Методички нет вовсе - не гадай, а спроси на кафедре, по какому образцу у вас оформляют. За образец часто берут ГОСТ 7.32-2017, но помни, что написан он для отчётов о научно-исследовательской работе, а не для курсовых: раздел 4 там так и называется - «Структурные элементы отчета». Переносить его к себе вслепую нельзя. Пункт 5.7.1, например, требует от введения сведений о патентных исследованиях и о метрологическом обеспечении - в курсовой такого не бывает, и кафедра этого не ждёт
Доступ к модели. Подойдёт любой чат в браузере: открыл, вставил запрос, забрал ответ. Если само слово «нейросеть» пока пустой звук, я разбирал что это такое без формул отдельно. Мне удобнее Claude Code в терминале, потому что он видит папку с файлами целиком и правит черновик прямо в документе, а не через копипаст туда-сюда. Ставится он за вечер, порядок действий разобран отдельно в гайде по установке. Если терминал пугает, оставайся в браузере: все запросы ниже работают одинаково в обоих случаях
Файл. Заведи один документ и складывай туда всё подряд: план, ссылки на источники, свои черновые абзацы, вопросы к научруку. Не десять файлов на рабочем столе, а один. Дальше он же станет черновиком, а скачанные PDF статей отдают модели отдельно - как это сделать без лишних токенов, я показывал в гайде про MarkItDown
Эта подготовка и есть первый из семи шагов. Следующий - план, потому что без него модель пишет красивый текст ни о чём
Шаг 1: как получить структуру и план глав?
Одним запросом, если в нём есть четыре вещи: тема, дисциплина, объём в страницах и требование объяснить, что доказывается в каждом параграфе. Без последнего пункта возвращается оглавление, а не план. Общие правила разговора с моделью, из которых это вырастает, я разбирал в отдельном гайде
Вот запрос, который я реально прогнал, целиком и без сокращений. Скопируй его, подставь свою тему и дисциплину, вставь в окно нейросети:
Ты научный руководитель по дисциплине «Менеджмент». Тема курсовой работы: «Мотивация персонала в малом бизнесе», объём 30 страниц.
Составь план работы: введение с актуальностью, целью, задачами, объектом, предметом и методами исследования; две главы по три параграфа; заключение.
К каждому параграфу добавь одну строку - что именно в нём доказывается. Без воды и общих слов.
Прогон занял меньше минуты. У себя увидишь такой же план, только по своей теме.
Лог этого прогона подтверждает: сама команда отработала 53,731 секунды по системному таймеру («2.78s user 2.67s system 10% cpu 53.731 total»), а в ответе, откуда я вырезал повторяющиеся строки, стоят «Глава 1. Теоретические основы мотивации персонала в малом бизнесе (11 стр.)», «Глава 2. Анализ и совершенствование системы мотивации персонала ООО «X» (12 стр.)» и «Список литературы (1,5 стр.)» с требованием 20-25 источников, не старше 5 лет минимум наполовину.
53,731 секунды. За это время вернулись введение с актуальностью, целью, шестью задачами, объектом, предметом и шестью методами; две главы по три параграфа с пояснением, что доказывается в каждом; заключение; раскладка объёма теория 11 страниц против практики 12; строка про 20-25 источников в списке литературы
Ценно тут не оглавление, а строки «доказывается». Параграф 1.2, например, вернулся с пояснением, что содержательные теории отвечают на вопрос «что мотивирует», а процессуальные - «как именно». Это уже тезис, с которым можно спорить, а спорить и есть работа автора
Теперь то, что делаешь руками и не перепоручаешь. Открой методичку и сверь план с ней построчно: число глав, число параграфов, наличие практической части, объём. Модель ничего не знает про требования твоей кафедры и спокойно предложит структуру, которую у вас не принимают. Дальше выкинь всё, что не твоё: нет доступа к предприятию - параграф «организационно-экономическая характеристика» превращается в выдумку, и лучше поменять сужение темы, чем защищать выдуманное ООО
И последнее по этому шагу. План согласовывают с научруком до того, как написана первая страница. Переписать план стоит десять минут, переписать главу - выходные
Шаг 2: где брать источники и как убедиться, что они существуют?
Источники берут в научных каталогах, а у модели - только черновой список, который ты потом проверяешь по каталогу. Порядок именно такой, и менять его нельзя: список литературы читает научрук, а не нейросеть
Четыре каталога закрывают почти любую тему курсовой. Их и сайт сервиса проверки, который понадобится на Шаге 5, я прогнал на доступность 18.08.2026 замером с московского адреса, чтобы не отправлять тебя на страницу, которая не открывается. Команда одна на каждый адрес, в логе она повторяется пять раз, тут оставил её один раз.
Лог подтверждает: все пять адресов открылись, быстрее всего - https://elibrary.ru/ за 0.076693 секунды, следом https://www.antiplagiat.ru/ (0.086440) и https://cyberleninka.ru/ (0.092678), а медленнее всех дальний https://scholar.google.com/ - почти секунда, 0.848919, и https://www.dissercat.com/ - 0.719644.
| Каталог | Что внутри | Чем полезен курсовой |
|---|---|---|
| КиберЛенинка | статьи российских научных журналов, полные тексты открыты | фильтры по ВАК, RSCI, Scopus и по году: сразу видно, что свежее и что прошло рецензию |
| eLIBRARY.RU | российская научная электронная библиотека | оформленное описание статьи под список литературы, индекс цитирования |
| Google Scholar | научные работы на всех языках | быстро показывает, кто ещё писал по теме и что цитируют |
| disserCat | диссертации и авторефераты | готовые обзоры литературы, откуда видно классику вопроса |
Таблица прокручивается вбок →
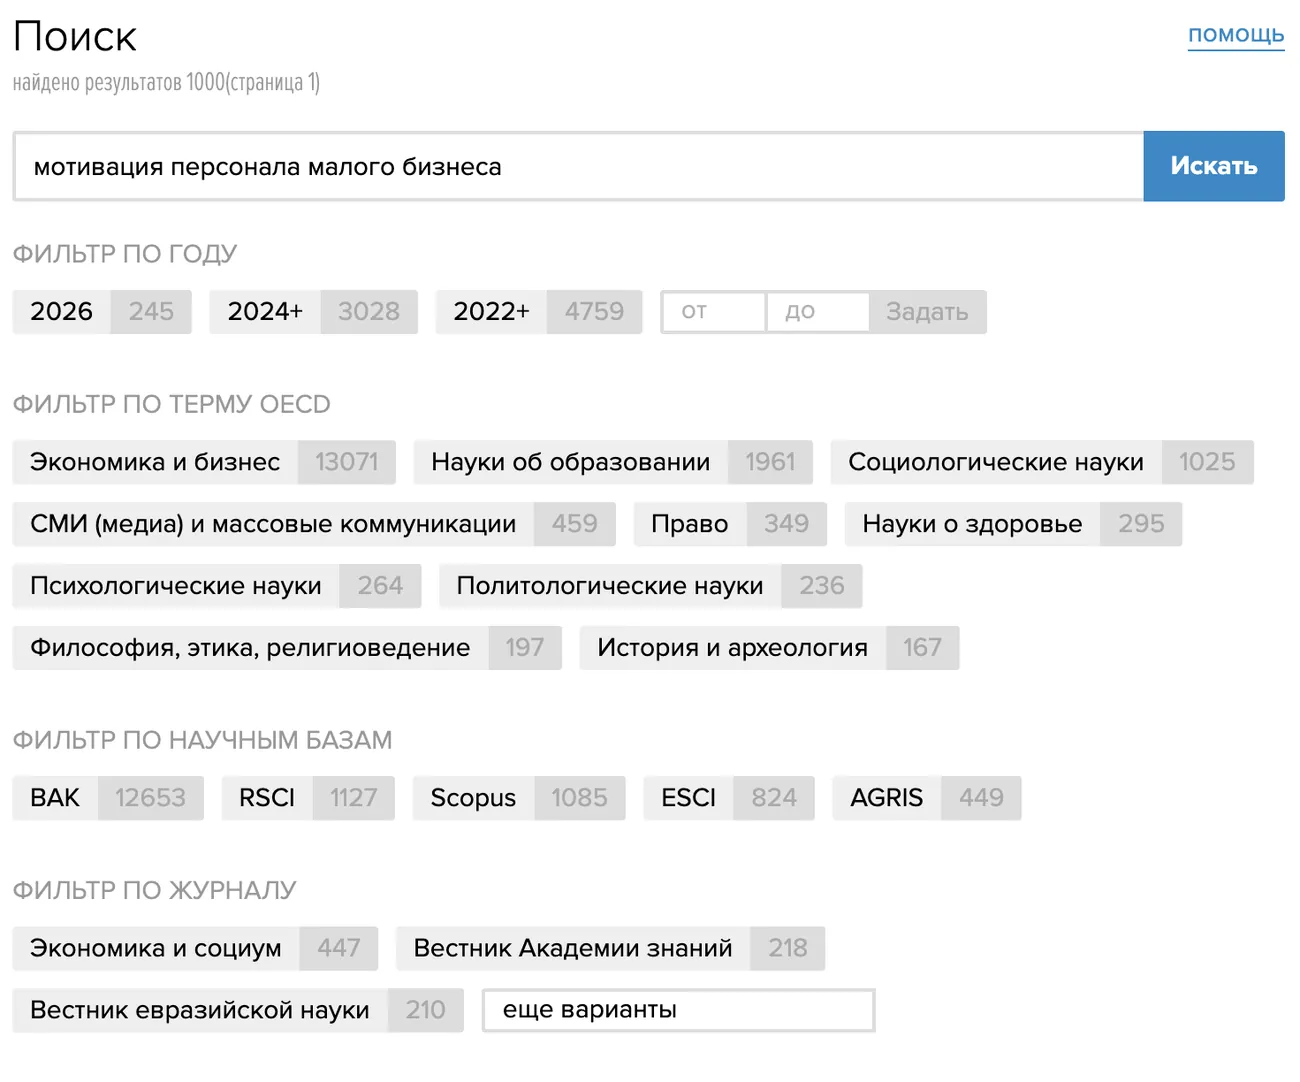
Внутри каталога работают фильтры, и они экономят больше времени, чем любой запрос к модели. По тестовой теме «мотивация персонала малого бизнеса» КиберЛенинка отдала 1000 результатов, а рядом стоят счётчики по научным базам: 12 653 работы в журналах перечня ВАК (Высшая аттестационная комиссия, её перечень означает, что журнал рецензируемый), 1 127 в RSCI и 1 085 в Scopus - это международные базы научных статей. Плюс фильтр по году: 2026 - 245 работ, с 2024-го - 3 028. Методичка обычно требует свежие источники, и это требование закрывается двумя кликами
Теперь про черновой список от модели. Я попросил пять книг и пять статей по той же теме, а потом проверил каждую статью по каталогу: искал заголовок и сверял, совпадает ли он дословно.
Лог проверки подтверждает: по каждому из пяти запросов КиберЛенинка выдала «статей в выдаче: 10», «совпало слов заголовка: 100%» и «вердикт: НАЙДЕНА» - «Особенности системы мотивации персонала на предприятиях малого бизнеса», «Аудит системы мотивации персонала предприятия малого бизнеса», «Управление мотивацией персонала в коммерческих организациях малого бизнеса», «Теоретические и практические подходы к мотивации персонала в малом и среднем предпринимательстве» и «Мотивация к труду персонала и повышение эффективности функционирования малых предприятий», а итоговая строка лога подводит черту: «ИТОГО подтверждено дословно: 5 из 5».
Пять из пяти нашлись, у всех совпали автор и год. Дальше честная граница: это один прогон по одной теме на одной модели, и вывод «нейросети не выдумывают источники» из него не следует. Массовые темы вроде мотивации персонала описаны тысячами работ, модель их видела. Узкая тема, свежая отрасль, редкий журнал - и картина будет другая
Поэтому правило одно, и оно не про доверие, а про цену ошибки. Ссылку, которую ты не открыл своими руками, в список литературы не ставят. Проверка занимает минуту на источник: копируешь заголовок, вставляешь в каталог, смотришь, есть ли карточка и совпадают ли автор с годом. Двадцать источников - двадцать минут. Разбор на защите за один выдуманный источник стоит дороже. Есть и обходной путь: дать модели свои файлы и заставить отвечать только по ним - как это собирается, я показывал в гайде про базу знаний
Шаг 3: как писать черновик своими мыслями?
Сначала свой тезис на три-пять строк, и только потом модель на редактуру этого текста, а не наоборот: порядок кажется мелочью, но именно он отделяет работу, которую ты защитишь, от текста, за который ставят ноль
Механика простая. Ты открываешь параграф 1.2, смотришь на строку «доказывается» из плана и пишешь своими словами, коряво, без терминов: что ты вообще хочешь тут сказать. Пять строк. Тему совсем не понимаешь - сначала разбери её, а не пиши: как ставить модели роль преподавателя, я разбирал в гайде про репетитора, а как доводить объяснение до понимания диалогом, а не пересказом - в методе обучения диалогом. Дальше отдаёшь свои пять строк на редактуру. Вставь запрос ниже, а под ним - свой абзац:
Ниже мой черновой абзац для параграфа курсовой по менеджменту. Отредактируй его под научный стиль: убери разговорные обороты, выстрой логику, приведи к академической подаче.
ЗАПРЕЩЕНО: добавлять факты, цифры, имена авторов и утверждения, которых нет в моём тексте. Работай только с тем, что написано.
Верни отредактированный вариант и отдельным списком - что ты изменил и почему.
[твой абзац]
Строка про запрет добавлять факты тут главная. Без неё модель дописывает красивое «по данным исследований» и вешает на тебя утверждение, которое нечем подтвердить на защите
Второй запрос - на дыры. Он неприятный, и поэтому полезный. Вставь его тем же способом, ответом появится список слабых мест:
Прочитай мой абзац как строгий рецензент. Найди места, где вывод не следует из сказанного, где утверждение подано без обоснования и где я подменил доказательство пересказом.
Ничего не переписывай. Верни список: номер претензии, к какой фразе, что именно не сходится.
Теперь про запрос, который писать не надо: «напиши параграф 1.2 на две страницы». Причина не в морали, а в механике. Во-первых, вернётся текст без фактуры твоего предприятия и без твоей позиции, потому что модель их не знает, и первый же вопрос «а почему вы так решили» упрётся в пустоту. Во-вторых, полностью сгенерированный текст ловится: система проверки на заимствования с января 2024 года использует плагин распознавания сгенерированных текстов, и это записано прямо в правилах вуза. В-третьих, такой абзац нельзя честно описать в декларации, а описать придётся: об этом Шаг 6
Рабочий ритм получается такой: свой тезис, редактура, вопросы рецензента, правка. Один параграф проходит этот цикл примерно за полчаса - это моя прикидка по ощущению, а не замер. Тридцать страниц собираются не за вечер, но собираются твоими руками
Шаг 4: как проверить работу до научрука?
Прогнать её через вопросы, которые задаст комиссия, и модель для этого подходит лучше однокурсника: она не жалеет автора, не устаёт на третьей странице и спрашивает ровно то, что неудобно
Первая проверка - сцепка. Курсовую заваливают не за плохой стиль, а за то, что введение обещает одно, главы делают другое, а заключение подводит итог третьему. Проверяется механически. Вставь запрос, приложи введение, заключение и оглавление, и увидишь таблицу совпадений:
Вот введение и заключение моей курсовой, а также оглавление с названиями параграфов.
Проверь сцепку: каждой задаче из введения должен соответствовать параграф, а каждому параграфу - вывод в заключении.
Верни таблицу: задача - где решается - где вывод. Пустые клетки помечай словом ПРОБЕЛ.
Таблица с пробелами и есть список того, что доделать. В тестовом плане шесть задач и шесть параграфов сошлись не случайно: требование объяснить каждый параграф было вписано в запрос на Шаге 1
Вторая проверка - оппонент. Тут запрос злее. Вставь его вместе с текстом работы и увидишь пять вопросов, на которых работа поплывёт:
Побудь оппонентом на защите курсовой. Прочитай текст и задай 5 вопросов, на которых работа поплывёт.
Спрашивай про: источник каждой цифры, границы вывода, почему выбран именно этот метод, что противоречит выводу, что автор не проверил.
Формулируй как на защите - коротко и в лоб. Ответы не пиши.
Пять вопросов, на которые у тебя нет ответа, - это пять мест, которые закрывают до сдачи, а не на защите. Часть снимается одним абзацем, часть - таблицей в приложении, а что-то окажется настоящей дырой, о которой ты и сам догадывался
Третья проверка - на своё же враньё. Пройдись по тексту и на каждую цифру ответь себе: откуда она. Нет ссылки - либо ставишь ссылку, либо убираешь цифру. Тот же приём работает на любом тексте, не только на учебном: как гонять черновик через модель на ошибки, тон и факты, разобрано в гайде про проверку текста
После этих трёх проходов работа готова уйти на проверку. Дальше начинается то, чего боятся больше всего
Шаг 5: сколько стоит проверка на заимствования и на ИИ?
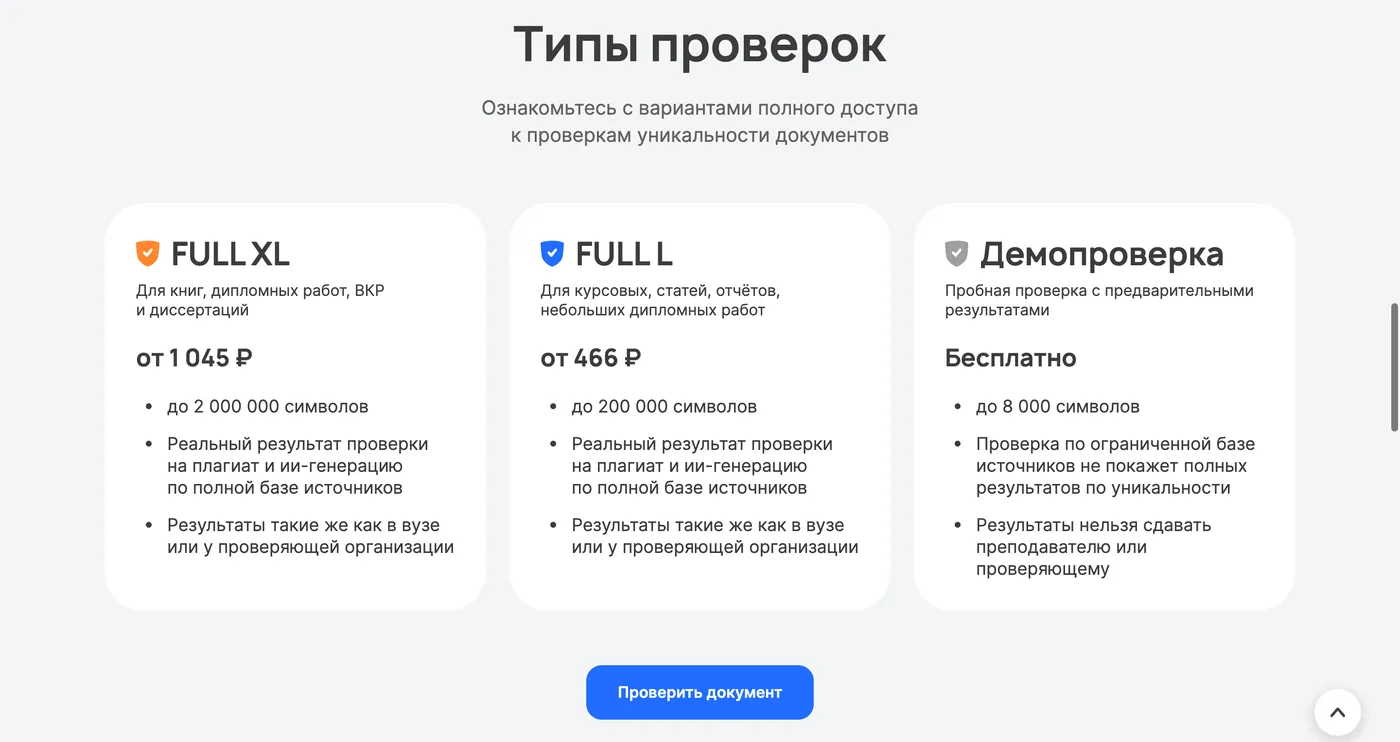
Демопроверка бесплатна и берёт до 8 000 символов, а полная проверка курсовой начинается от 466 ₽: обе цифры сняты с официальной страницы сервиса 18.08.2026, и разница между тарифами не только в цене
| Тип проверки | Цена | Объём | Для чего по описанию сервиса |
|---|---|---|---|
| FULL XL | от 1 045 ₽ | до 2 000 000 символов | книги, дипломные работы, ВКР (выпускные квалификационные) и диссертации |
| FULL L | от 466 ₽ | до 200 000 символов | курсовые, статьи, отчёты, небольшие дипломные |
| Демопроверка | бесплатно | до 8 000 символов | пробная проверка по ограниченной базе, результат сдавать нельзя |
Таблица прокручивается вбок →
Курсовая целиком в 8 000 символов не влезет: это примерно четыре страницы. Демопроверкой имеет смысл прогнать кусок, где выше всего доля чужого текста, - обычно это теоретическая глава, - а полную покупать перед сдачей
Теперь про базу, по которой ищут. Ищут не по «интернету вообще»: хранилищ четыре, и одно из них - именно то, откуда студенты берут теорию:
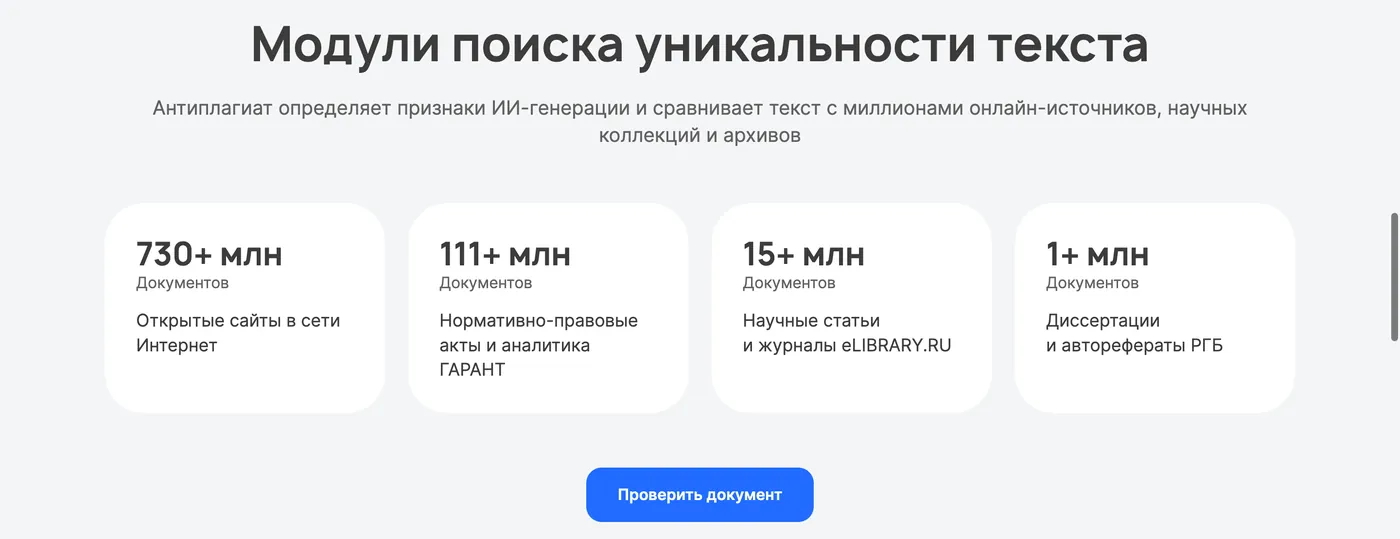
730+ млн документов открытого интернета, 111+ млн нормативных актов и аналитики ГАРАНТ, 15+ млн научных статей eLIBRARY.RU и 1+ млн диссертаций и авторефератов РГБ. Отдельными модулями сервис ищет обходы проверки: скрытое копирование, перефразирование, переводные заимствования и дубликаты работ, которые уже проверялись в другом вузе
Детектор сгенерированного текста работает не по словарю запрещённых слов, а по устройству фразы. Сервис описывает это так: «Нейросети генерируют текст на основе вероятности появления следующего слова. Машинные материалы часто получаются слишком предсказуемыми, шаблонными и одинаковыми по структуре...» - дальше он объясняет это тем, что модель не думает, а подставляет следующее слово по вероятности. Анализируются построение предложений, связность, повторяемость конструкций и смысловые связи между кусками. Ловит популярные генеративные системы, включая ChatGPT, DeepSeek, Gemini, Claude и Алису AI
Ошибаться он тоже умеет, и сервис признаёт это сам: «Полностью исключить вероятность ошибки нельзя...» - причиной названо то, что генеративные системы постоянно развиваются. Следом на той же странице стоит цифра: «доля ошибок классификации сейчас не превышает 1%». Отсюда практический вывод: текст, написанный тобой и отредактированный моделью, попадает в серую зону, и защищает тебя не хитрость, а декларация из следующего шага
Про порог оригинальности отдельно. Своей цифры сервис не называет: сколько процентов нужно именно тебе, написано в методичке твоей кафедры. Любая статья, которая обещает «нужно от 70%», просто выдумывает число за твой вуз
Шаг 6: как задекларировать использование ИИ?
Отдельным разделом работы из четырёх пунктов, и это не формальность и не признание вины: именно незаполненный раздел превращает нормальную работу в нарушение академических норм
Формулировка, которую я разбираю, взята из справочника учебного процесса НИУ ВШЭ - там раздел называется «Описание применения генеративной модели» и требует указать:
- части текста, подготовленные с использованием генеративных моделей: вся работа, отдельные разделы или отдельные фрагменты;
- для каждой такой части - цели и способ применения: полностью сгенерированный текст, сгенерированный текст с авторской редакцией или авторский текст с использованием сгенерированных материалов;
- для каждой использованной модели - её название и адрес сайта в интернете либо описание иного источника модели;
- оценку эффективности применения генеративных моделей для достижения поставленных целей.
Четвёртый пункт студенты пропускают чаще всего, а он самый простой: напиши честно, где модель помогла, а где пришлось переделывать руками
Как это выглядит для маршрута из этой статьи. Если ты шёл по шагам выше, декларация получается примерно такая: план работы - сгенерированный текст, подвергнутый авторской редакции; черновой список литературы - авторский текст с использованием сгенерированных материалов, проверенных по каталогу; текст глав - тоже авторский текст с использованием сгенерированных материалов, потому что модель правила стиль; выводы и практическая часть - авторские, без генерации. Формулировки тут не свои: это ровно те три варианта, которые перечислены в правилах, и вуз ждёт именно их. Дальше название модели с адресом сайта и абзац про то, что дала эта работа
Три вещи, которые стоит проверить до сдачи. Первое: у твоего вуза может быть своя форма декларации, и искать её надо на сайте кафедры, а не додумывать. Второе: преподаватель имеет право запретить генеративные модели на конкретном элементе контроля, и тогда запрет стоит в программе дисциплины - декларация в этом случае не спасает, потому что нарушено само правило. Третье: при загрузке работы специальный раздел под декларацию часто уже есть в интерфейсе, и его просто не замечают
Цена вопроса названа в тех же правилах прямо. За незадекларированное использование в обычной работе ставят «0», а для выпускной квалификационной, которая идёт частью итоговой аттестации, там названо отчисление как мера дисциплинарного взыскания
Какие ошибки заваливают работу?
Пять, и первая из них - список литературы, который никто не открывал; дальше по убыванию частоты, и все пять чинятся до сдачи, если взяться за них заранее
1. Источники не проверены по каталогу. Модель выдала пять строк с журналом, годом и страницами: выглядит убедительно, поэтому проверять лень. В моём прогоне все пять статей нашлись дословно, но это была массовая тема. На узкой теме первым же вопросом научрука будет «покажите статью», и открывать её придётся при нём. Лечится минутой на источник, механика в Шаге 2
2. Введение и заключение живут отдельно от глав. Задачи обещают шесть пунктов, параграфов пять, в заключении выводы про что-то седьмое. Комиссия видит это по оглавлению, даже не открывая текст. Лечится таблицей сцепки из Шага 4
3. Текст сгенерирован целиком и не задекларирован. Тут даже не нужен детектор: научрук, который два года читает твои работы, замечает смену голоса на первой странице. А система проверки на заимствования с января 2024 года ещё и использует плагин распознавания сгенерированных текстов. Цена по правилам - ноль за работу
4. Практическая часть про предприятие, которого ты не видел. Модель охотно напишет характеристику ООО с численностью, оборотом и текучестью. Все цифры будут правдоподобными и все - выдуманными. Один уточняющий вопрос на защите, и работа рассыпается. Нет доступа к предприятию - меняй сужение темы на то, где данные открытые, а если доступ есть, вытаскивать выводы из своей же таблицы я показывал в гайде про анализ данных
5. Ноль результатов принимают за факт, а не за сломанный инструмент. Это моя собственная ошибка из этого прогона 18.08.2026, и она стоит отдельного абзаца. Первая версия скрипта ходила в каталог обычным curl, и по каждой из пяти статей печатала «НЕ НАЙДЕНА», а внизу подводила итог. Если у себя увидишь такой же ряд из одних «НЕ НАЙДЕНА», это не приговор источникам, а сломанный инструмент.
Лог этой попытки подтверждает: по всем пяти запросам страница открылась и вернула немаленький ответ - 26386, 26272, 26434, 26674 и 26590 байт по каждому, но карточек статей внутри скрипт нашёл ноль - «статей в выдаче: 0», «вердикт: НЕ НАЙДЕНА» по каждому запросу, а строка итога подводит черту: «ИТОГО подтверждено дословно: 0 из 5».
Вывод напрашивался сам: модель всё выдумала. Я открыл каталог руками - все пять статей были на месте. Разгадка в двух числах выше: страница пришла (26 килобайт), а карточек в ней ноль, потому что выдачу каталога рисует скрипт уже в браузере. Переписал проверку на настоящий браузер, получил 5 из 5 - тот самый лог из Шага 2
Правило отсюда простое и работает шире курсовой: пустой результат сначала проверяют на исправность инструмента, и только потом делают вывод о мире. Стоит это две минуты, а неверный вывод стоит переписанной главы
Источники
- НИУ ВШЭ: правила использования искусственного интеллекта студентами - отсутствие запрета, требование декларации, состав раздела и санкции, обращение 18.08.2026
- Антиплагиат: библиотека ИИ-регламентов в образовании - счётчики регламентов по категориям и странам, свежие карточки вузов, обращение 18.08.2026
- Антиплагиат: проверка текстов на ИИ - модули поиска, объёмы баз, типы проверок и цены, механизм детектора, обращение 18.08.2026
- ГОСТ 7.32-2017, официальный текст - стандарт на отчёты о научно-исследовательской работе: раздел 4 «Структурные элементы отчета» и требования пункта 5.7.1 к введению, обращение 18.08.2026
- КиберЛенинка - фильтры по научным базам и по году, живая выдача по тестовому запросу, обращение 18.08.2026
- eLIBRARY.RU - научная электронная библиотека, замер доступности с московского адреса 18.08.2026
- Google Scholar - поиск научных работ, замер доступности с московского адреса 18.08.2026
Памятка: курсовая с ИИ, которую не завернут
Семь строк, которые стоит перечитать перед сдачей
Сохрани себе
- методичка кафедры открыта, порог оригинальности и число источников выписаны
- план согласован с научруком до первой написанной страницы
- каждый источник открыт руками в каталоге, автор и год совпали
- текст глав написан тобой, модель работала только на редактуре
- таблица сцепки «задача - параграф - вывод» заполнена без пробелов
- декларация использования ИИ собрана по четырём пунктам
- регламент своего вуза найден и прочитан, а не додуман по чужому
Что эта статья не закрывает
Диплом эта статья не напишет
Она доводит до сданной курсовой, и на этом её работа заканчивается. Что делать с навыком дальше - собирать свои заготовки, работать с файлами вместо копипаста, ставить проверки, которые срабатывают без тебя, - в семь шагов не помещается. Продолжение живёт там же, где я это делаю каждый день: ИИ-Лагерь
Частые вопросы
Можно ли писать курсовую с нейросетью?
Смотря какой вуз: единого документа по стране нет, и ответ даёт регламент твоего. В правилах НИУ ВШЭ, например, прямо сказано, что запрета на ИИ для студентов нет, но требуется заполнить специальный раздел с описанием применения генеративной модели. Свой регламент ищи на сайте кафедры или в библиотеке ИИ-регламентов Антиплагиата, а не по чужой статье
Определит ли антиплагиат текст нейросети?
Сервис заявляет отдельный модуль определения ИИ-генерации: анализируются построение предложений, связность, повторяемость конструкций и смысловые связи между фрагментами. Ловит популярные системы, включая ChatGPT, DeepSeek, Gemini, Claude и Алису AI. Ошибки признаются самим сервисом: по его данным, доля ошибок классификации не превышает 1%
Сколько стоит проверить курсовую на антиплагиат?
Демопроверка бесплатна и берёт до 8 000 символов, но её результат нельзя сдавать преподавателю. Тариф FULL L для курсовых стоит от 466 ₽ и берёт до 200 000 символов, FULL XL для дипломных и диссертаций - от 1 045 ₽ до 2 000 000 символов. Цены с официальной страницы сервиса на 18.08.2026
Какая нейросеть лучше подходит для курсовой?
Решает не выбор модели, а роль, которую ты ей задаёшь. План, черновой список источников и редактура получаются на любой распространённой модели, а разница между ними меньше, чем разница между запросом «напиши курсовую» и запросом с темой, дисциплиной, объёмом и требованием объяснить каждый параграф. Я гонял примеры из статьи через Claude Code
Может ли нейросеть придумать несуществующие источники?
Может, поэтому список от модели считается черновым до проверки. В моём прогоне 18.08.2026 все пять предложенных статей нашлись в каталоге КиберЛенинки дословно, у всех совпали автор и год, но это один прогон по массовой теме. На узкой теме или свежей отрасли риск выше, и каждую ссылку открывают руками до того, как она попадёт в список литературы
Отчислят ли за использование нейросети в курсовой?
За саму нейросеть - нет, за незадекларированное использование - санкции есть. По правилам НИУ ВШЭ это нарушение академических норм с оценкой «0» за работу, а для выпускной квалификационной работы, которая входит в итоговую аттестацию, там названо отчисление как мера дисциплинарного взыскания. Отдельный случай - когда преподаватель запретил ИИ в программе дисциплины: тогда нарушено само правило и декларация не помогает
Сколько времени занимает курсовая с нейросетью?
План глав вернулся за 53,731 секунды - это замер, он есть в логе. Проверка двадцати источников по каталогу занимает около двадцати минут, а один параграф проходит цикл «свой тезис - редактура - вопросы рецензента - правка» примерно за полчаса; последние две цифры - прикидка по опыту, а не секундомер. Работа целиком за вечер не собирается: экономится подготовка и вычитка, а не написание
Читайте также
Промпты для репетитора Claude: учат любому навыку с нуля за 4 часа
Разобрать непонятную теорию до того, как писать главу
Как проверить текст через ИИ: 4 слоя проверки до отправки
Ошибки, тон и факты в черновике до сдачи
Обучение нейросетям с нуля: с чего начать и где учиться
Что делать с навыком, когда зачётка закончилась