Нейросети · Тексты
Водяной знак Claude в тексте: 5 проверок своими руками
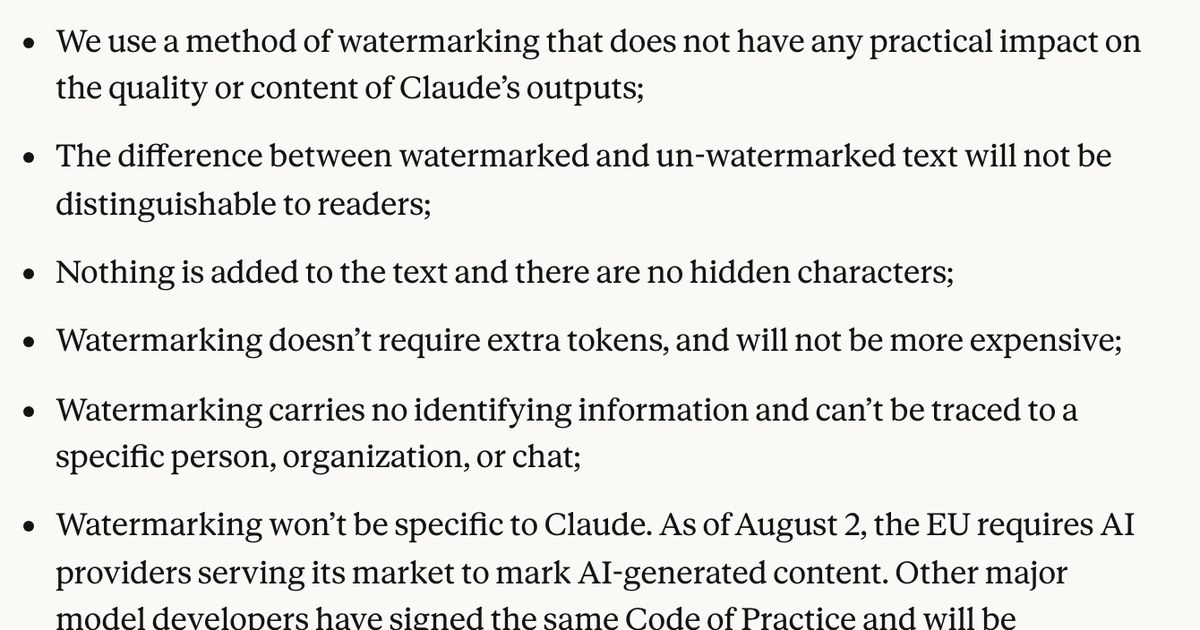
За неделю тема «Claude помечает всё, что пишет» разошлась по чатам вместе с советом прогнать текст через пересказ. Я взял первоисточник от 14 августа, прогнал 4 собственные проверки на 349 078 знаках своих статей и свёл результат в одну картину: что метка ловит, чего не ловит и что сегодня проверяется руками без всякого ключа
Метка Claude - это не символ и не значок: Anthropic пишет дословно, что в текст ничего не добавляется и скрытых знаков там нет. Я прогнал 349 078 знаков своих статей 19 августа 2026 года и нашёл ноль невидимых символов. Метка живёт в выборе слов, а публичной проверки на эту дату ещё нет
Проверка текста - одна операция, а работа состоит из десятков таких операций подряд. ИИ-Лагерь - это три дня, за которые я показываю, как они складываются в один рабочий порядок
Водяной знак Claude: с какого дня он стоит в текстах и на что распространяется?
Anthropic объявила 11 августа 2026 года, что тексты Claude будут нести встроенную метку, а 14 августа выпустила разбор, как эта метка устроена. Причина названа прямо: европейский закон об ИИ с 2 августа требует от поставщиков помечать то, что сгенерировано машиной, и Anthropic вместе с другими крупными разработчиками подписала общий свод правил прозрачности
По сообщению TechCrunch от 11 августа речь про весь набор: обычный чат, работа в редакторе кода, рабочие пространства и обращения через ключ доступа для программ. Модели, вышедшие до 2 августа 2026 года, получают метку постепенно, у них по закону есть переходный период
Дальше важное для тебя: метка ставится по всему миру, а не только для Европы. Anthropic пишет, что пока не умеет включать её только для отдельных стран, поэтому включила везде. Значит российский пользователь, который зашёл любым путём, получает текст ровно с той же меткой
| Что метка делает | Чего она не делает |
|---|---|
| показывает вероятность, что Claude участвовал в написании | не называет, кто именно писал: ни человека, ни компанию, ни номер чата |
| путешествует вместе с текстом при копировании | не мешает тексту: читатель разницы не видит |
| работает и в переводе, сделанном Claude | не ловит другие нейросети: у них свои ключи или свои способы |
| остаётся при лёгкой правке | не доказывает, что текст написан человеком |
Таблица прокручивается вбок →
Проверить свой текст сегодня нечем: своя проверка у Anthropic обещана, но не открыта. Дословно в разборе от 14 августа сказано «We will soon be offering a watermark detection API», то есть проверку скоро дадут, а даты нет. На 19 августа 2026 года публичной проверки чужих текстов не существует, и это первое, что снимает панику
Как метка попадает в текст, если в него ничего не добавляют?
Метка живёт в выборе слов: в разборе от 14 августа 2026 года Anthropic пишет, что в текст ничего не добавляется и никаких скрытых символов там нет. Формулировка первоисточника:
«Nothing is added to the text and there are no hidden characters»
Anthropic, разбор механики водяного знака от 14.08.2026
Механика простыми словами. Нейросеть пишет по одному слову за раз, и на каждом месте у неё есть несколько одинаково подходящих вариантов. В примере самой Anthropic после «The weather today was cold and...» одинаково годятся «overcast» и «grey»: смысл не меняется, и выбор решает случайность. Метка не подсовывает редкое слово, она меняет только источник этой случайности - вместо произвольного числа берётся секретный ключ и несколько предыдущих слов
Anthropic объясняет это через настольную игру: ходы делают по броску кубика, а если вместо кубика взять подряд идущие цифры числа пи, для игроков не изменится ни один ход. Зато потом, зная эту книжку с цифрами, можно посмотреть на партию и сказать, что ходы шли оттуда. Ключ у Anthropic и есть такая книжка, а твой текст - партия
Отсюда три следствия. Искать в тексте невидимые закорючки бесполезно, их там нет. Чем длиннее кусок, тем увереннее считается вероятность. И проверяет только тот, у кого ключ, то есть одна компания, а не любой сайт-детектор
На какой вопрос метка отвечает и на какие не отвечает?
Метка отвечает ровно на один вопрос: насколько вероятно, что Claude приложил руку к этому тексту. Всё остальное, что ей успели приписать за неделю, она не умеет. Anthropic пишет это открытым текстом: «It cannot distinguish "Claude wrote this" from "Claude heavily edited this"», то есть отличить «написал» от «сильно поправил» проверка не может
| Вопрос | Ответ метки |
|---|---|
| Писал ли этот текст Claude? | вероятность, а не факт |
| Писал ли его человек? | ответа нет вообще |
| Это ChatGPT или Gemini? | ответа нет, у них другие ключи |
| Кто именно из пользователей? | нет, опознавательных данных в метке не заложено |
| Претензии по авторским правам? | нет, права и ответственность метка не меняет |
| Это машина или редактура человека? | нет, «написал» и «отредактировал» она не различает |
Таблица прокручивается вбок →
Картинки и файлы идут по другой линии: когда Claude отдаёт .png, .jpg или .svg, к файлу прикладывается запись о происхождении по стандарту C2PA, который придумали производители фотокамер. Сама картинка при этом не меняется, а подпись снимается вместе со свойствами файла. С текстовой меткой это лучше не путать
Короткий текст, факты, код и вычитка: почему на них следа почти нет
Метке не за что зацепиться в четырёх местах, и все четыре названы у Anthropic: короткий кусок, фактический текст, программный код и вычитка твоего текста. Причина общая: след остаётся там, где у модели был свободный выбор слов
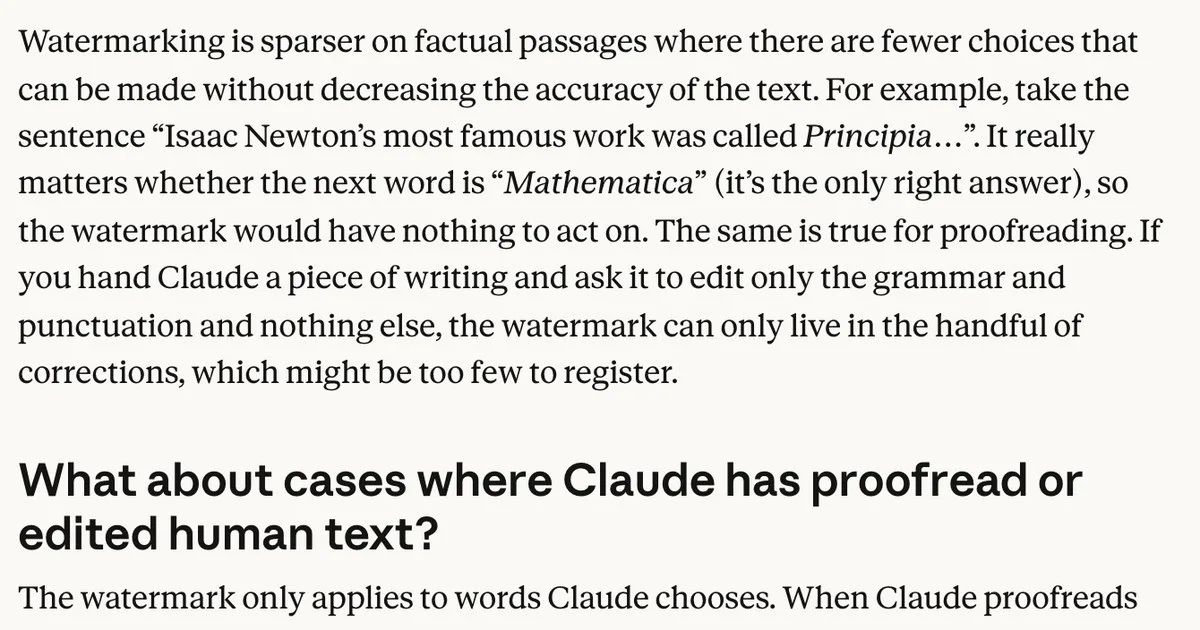
| Где метка слабеет | Почему так | Что это значит на практике |
|---|---|---|
| короткий кусок | мест со свободным выбором мало | абзац в три строки почти ничего не расскажет |
| фактический текст | у правильного ответа нет замены | инструкции, цифры, названия несут метку хуже |
| программный код | код обязан работать буквально | в самом коде метки почти нет, разве что в комментариях |
| вычитка твоего текста | слова остались твоими | правка запятых следа не оставляет |
Таблица прокручивается вбок →
Пример из разбора Anthropic про факты перескажу коротко. Во фразе «Isaac Newton's most famous work was called Principia...» следующее слово может быть только одно, правильное. Свободы выбора нет, метке негде поселиться
Отсюда практический вывод. Отдаёшь модели свой готовый текст и просишь поправить запятые - следа почти не остаётся. Модель пишет за тебя длинную статью с нуля - следа много. Между этими полюсами лежит вся реальная работа, и вот здесь начинается то, что можно проверить руками
Шаг 0. Что приготовить, чтобы проверить свой текст самому
Нужны две вещи, обе бесплатные: файл с твоим текстом и окно Claude Code, где ты обычными словами пишешь ИИ, что сделать. У меня это Claude Code внутри редактора VS Code, ставится за десять минут, порядок установки разобран по шагам в гайде как поставить себе такое окно
Что увидишь после установки: слева список файлов твоей папки, внизу поле, куда пишешь задачу словами. Что это даёт: любой файл на компьютере можно попросить проверить обычной человеческой фразой, без единой команды наизусть
Отдельный плюс такого окна в том, что оно видит файлы целиком. Не нужно копировать статью кусками в чат и следить, влезла она или обрезалась на середине
Ставить ничего не хочешь - первые две проверки пройдут в любом чате с нейросетью: текст вставляешь прямо в окно диалога, разница только в удобстве, когда файлов много
Проверка 1. Есть ли в твоём тексте невидимые символы
Невидимых символов в тексте от нейросети нет: я прогнал 12 своих статей, 349 078 знаков, и нашёл ноль символов нулевой ширины. Начал я с этой проверки, потому что первый испуг у всех одинаковый: «а вдруг там между букв что-то вшито, и я этого не вижу»
Символы нулевой ширины - это знаки, которые занимают место в файле, но не рисуются на экране. Вот что показал прогон 19 августа: показываю три строки файлов из двенадцати, в остальных девяти те же нули, а итог и хвост прогона идут дословно:
ПРОВЕРКА ТЕКСТОВ НА СКРЫТЫЕ СИМВОЛЫ
файлов в проверке: 12
guide-notion-ai                            знаков   29736 | скрытых  0 | смешанных слов  0
guide-deepseek                             знаков   27162 | скрытых  0 | смешанных слов  0
guide-gemini                               знаков   48588 | скрытых  0 | смешанных слов  0
[... остальные девять файлов: в каждом те же нули ...]
ИТОГО знаков проверено: 349078
ИТОГО скрытых символов нулевой ширины: 0
ИТОГО слов со смешанным алфавитом: 0
Видимые особые пробелы (это форматирование, не метка):
   U+00A0 NO-BREAK SPACE: 0
   U+2009 THIN SPACE: 0
   U+202F NARROW NO-BREAK SPACE: 0
ВЫВОД: скрытых символов НЕ НАЙДЕНО
349 078 знаков, ноль находок. Заодно закрыт вопрос про подмену русских букв латинскими: таких слов тоже ноль. И три вида особых пробелов, которые чаще всего принимают за метку, тоже дали нули
Ту же проверку ты сделаешь на своём тексте. Скопируй блок ниже целиком, вставь его в окно нейросети вместе со своим текстом, нажми Enter и увидишь короткий отчёт с числами:
Проверь текст ниже на скрытые символы. Посчитай отдельно: символы нулевой
ширины, мягкие переносы, неразрывные пробелы и слова, где русские и
латинские буквы перемешаны внутри одного слова. Ответь таблицей: что
искали, сколько нашли. Если ничего не нашлось, так и напиши.

<сюда вставь свой текст>
Что увидишь: таблицу из четырёх строк с числами. Что это даёт: ты своими глазами убеждаешься, что в файле не спрятано ничего, что находится поиском
Проверка на скрытые символы за одну минуту
- Открой свой текст любой файл или заметка: возьми то, что ты правда отправлял заказчику
- Скопируй блок с задачей выше кнопка «Скопировать» в правом углу блока, текст уйдёт в буфер обмена
- Вставь в окно нейросети и нажми Enter ответ придёт таблицей с числами, ждать примерно десять секунд
- Посмотри на строку с нулями нули означают, что в символах искать больше нечего, и можно идти к следующей проверке
Проверка 2. По каким повадкам текст узнают без всякого ключа
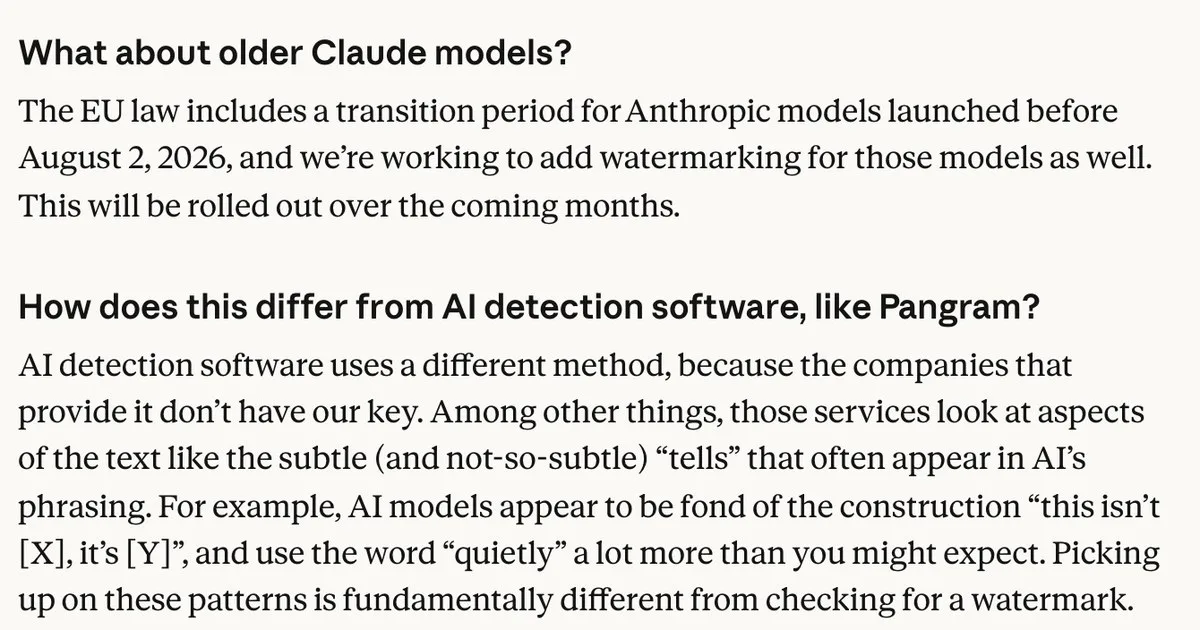
Узнают тебя по повадкам, и вот их проверить можно без ключа: Anthropic сама называет две приметы, по которым работают сторонние сервисы, конструкцию «this isn't [X], it's [Y]» и слово «quietly», которое машина ставит чаще живого человека
Я взял одну свою статью в двух состояниях: 11 разделов черновика и те же 11 разделов после правки, которую я гоняю своим проходом по антиклише (в логе наборы так и подписаны, «до ручной правки» и «после ручной правки»). Считал русские родственники этих примет: оборот «не X, а Y», штампы вроде «важно понимать», длинные тире. Первый набор ниже идёт целиком, во втором показываю строку, которая изменилась, и итог:
НАБОР: черновик до ручной правки
файлов: 11, слов: 2944
   оборот «не X, а Y»              7
   оборот «это не просто»          0
   слово «тихо/незаметно»          0
   длинное тире                    0
   «в современном мире»            0
   «важно понимать/отметить»       0
   «стоит отметить»                0
   «давайте разберём»              0
   «в мире X»                      0
   «ключевой момент»               0
ВСЕГО повадок: 7
ПЛОТНОСТЬ на 1000 слов: 2.38

НАБОР: тот же текст после ручной правки
файлов: 11, слов: 3284
   оборот «не X, а Y»              9
[... остальные девять строк списка: те же нули ...]
ВСЕГО повадок: 9
ПЛОТНОСТЬ на 1000 слов: 2.74
Результат вышел неудобный для меня, поэтому и показываю. Штампов в черновике не было с самого начала: девять строк списка стояли на нуле ещё до прохода, вычищать там было нечего. А единственная ненулевая строка, та самая конструкция, которую Anthropic называет приметой машины, проход пережила и подросла: 7 штук против 9, плотность 2.38 против 2.74. Заодно видно, что текст в проходе не только чистится, но и прибавляет: 2944 слова против 3284
Вывод получается сильнее, чем я ждал: чистый от штампов текст всё равно остаётся с машинной повадкой, и она даже прибавляет. Штампы я вижу и убираю на автомате, а любимый оборот пролезает мимо глаза, потому что звучит нормально. Отдельно про слова-маркеры я разбирал приёмы в гайде как убрать слова-маркеры ИИ: там речь про качество своего языка, а не про то, как пройти чью-то проверку. Признаки машинного текста по внешнему виду - в разборе как проверить текст на ИИ
Проверка 3. Что остаётся от текста, если переписать его целиком
Переписать так, чтобы не осталось ни одного исходного слова, почти невозможно: в моём замере от 19 августа уцелел 31 процент разных слов. А в сети сразу появился совет «прогони через пересказ, и метки нет». Anthropic отвечает на него дословно: «Light editing probably won't remove the watermark completely; a complete rewrite where every word is replaced will», то есть лёгкая правка знак не снимает, а полная замена каждого слова снимает
Ключевое слово тут «каждого». Я взял абзац из своей опубликованной статьи и переписал его так старательно, как смог, а потом посчитал, сколько разных слов уцелело:
СРАВНЕНИЕ: исходный абзац против переписанного заново
слов в исходном: 46 (разных 42)
слов в переписанном: 38 (разных 37)
разных слов уцелело: 13
доля уцелевших от исходного: 31.0%
31 процент разных слов остался на месте после честной попытки переписать всё: уцелели названия, предлоги и служебные слова, которые в русском заменить нечем. На своём тексте увидишь ту же картину, если возьмёшь абзац с именами и цифрами
Отсюда две честные границы. Первая: мой замер считает уцелевшие слова, а не саму метку - детектора у меня нет и быть не может, ключ у вендора. Вторая: даже открытая реализация того же способа от Google прямо говорит, что уверенность проверки сильно падает при глубоком переписывании и при переводе помеченного текста чужим инструментом. Перевод, который делает сам Claude, метку несёт: там каждое слово снова выбирает Claude, поэтому строка в таблице выше и строка про падение уверенности говорят о разных случаях. Значит правильный вывод звучит иначе: переписывание меняет текст сильнее, чем ты думаешь, и вместе с меткой уносит твой смысл
Из этого же следует, что советы вида «прогони текст через сервис уникализации» бьют мимо: ты получаешь чужую манеру письма вместо своей, а вопрос авторства не решаешь никак
Проверка 4. Как собрать доказательства своего авторства
Авторство доказывает история работы, и собирается она заранее из 4 вещей: папка проекта, черновики с датой в названии, свои заметки и замеры рядом с готовым текстом. Метка отвечает на вопрос «участвовала ли машина», а спор с заказчиком или преподавателем идёт про другое, про то, твоя ли это работа
Что собрать, чтобы спор закончился в твою пользу
- Заведи одну папку под проект внутри лежат черновики: видно, что текст рос, а не появился готовым
- Сохраняй версии по датам файл с датой в названии показывает порядок работы лучше любых слов
- Держи свои исходники рядом заметки, интервью, фотографии, замеры: этого у машины физически нет
- Проговаривай роль ИИ в начале работы заказчик заранее знает, где помощник, а где ты, и потом это не станет сюрпризом
Список факторов, которые ослабляют метку, это оценка самой Anthropic из её разбора, инструкцией по обходу он не работает. Планировать работу на идее «поправлю пару абзацев, и следа нет» рискованно: проверку обещают открыть, и открывать её будут не для тебя
Проверка 5. Открывается ли Claude из России и что на этот счёт в законе
Метка приезжает к российскому пользователю целиком, а сам сервис Claude из России не открывается: 19 августа 2026 года адрес чата увёл мой запрос на страницу «app-unavailable-in-region». Проверял прямым запросом с московского адреса, без пересказов с форумов, и ниже прогон целиком, все шесть строк:
https://www.anthropic.com/news/claude-text-watermark -> 200 0.468047s
https://claude.ai/ -> 302 0.080102s
https://deepmind.google/science/synthid/ -> 301 0.120954s
https://www.antiplagiat.ru/ -> 301 0.051704s
https://claude.ai/ -> код 200, конечный адрес https://claude.com/app-unavailable-in-region
https://deepmind.google/science/synthid/ -> код 200, конечный адрес https://deepmind.google/models/synthid/
Что тут видно: страница с разбором Anthropic открывается с московского адреса за полсекунды, читать первоисточник можно спокойно. А рабочий адрес чата уводит запрос на страницу «app-unavailable-in-region», то есть приложение в этом регионе недоступно, и так отвечает сам сервис. Две строки - обычный переезд страницы: сайт Антиплагиата отвечает штатно, а страница технологии у Google просто переехала на новый адрес
Практический смысл: заходишь ты к Claude обходным путём или через чужой доступ, текст всё равно приходит с меткой, она включена по всему миру и от способа входа не зависит
Про наш закон коротко. Российский закон о развитии технологий искусственного интеллекта (243-ФЗ от 26 июля 2026 года) обязательной маркировки для автора не вводит, а его нормы про маркировку начинают работать только с 1 марта 2027 года, то есть сегодня они ещё не действуют. С этой даты обязанность появится у площадок с суточной аудиторией больше 500 тысяч пользователей из России: дать людям возможность пометить свой материал, а ставить пометку или нет, человек решит сам. Для нашей темы важнее другое: написана эта норма про материалы в аудио- и визуальной форме, обычного текста она сейчас не касается вовсе. Отдельные поправки, которые переложили бы маркировку на сами сервисы генерации, внесли в Госдуму 17 августа 2026 года. Правила биржи, редакции или вуза действуют отдельно от закона, и на практике решают именно они
Антиплагиат и подобные системы работают своим способом: ключа Anthropic у них нет, заявлений о доступе к нему тоже нет. Сам сервис из России отвечает штатно, это четвёртая строка прогона выше, а вот что именно он считает признаком машины, снаружи не проверить. Граница честности проходит ровно здесь
Три разговора, которые теперь пойдут иначе: заказ, учёба, свой канал
Меняется способ договариваться, и в трёх разговорах это выглядит по-разному: текст на заказ, работа в вузе и свой канал приносят разные вопросы про Claude от разных людей
Текст на заказ. Заказчик и раньше мог заподозрить машину по манере письма, теперь к манере добавится проверка от вендора. Рабочий ход один: договориться на входе, где помогает помощник, а где пишешь ты, и держать черновики
Учёба и курсовая. Вуз работает по своим правилам, и спор решается тем же, чем раньше: планом, источниками, черновиками по датам, умением объяснить каждый абзац вслух. Работа, где ИИ помогал со структурой и проверкой фактов, спокойно защищается. Работа, целиком написанная за тебя, не защищается независимо от меток
Свой канал и посты. Длинный текст несёт метку сильнее короткого, а посты обычно короткие. Зато повадки в постах виднее: читатель видит десятки твоих текстов подряд. Мой замер как раз про это, штампов в черновике не было вовсе, а машинный оборот всё равно остался и подрос. Значит работа идёт со своим языком, и об этом отдельный разбор как очеловечить текст нейросети
Общее правило для всех трёх разговоров: прятать использование ИИ - плохая ставка. Проверку обещают, а доверие ломается один раз. Честная рамка «я работаю с помощником, вот мой вклад» держится и без всяких ключей
Где заканчивается проверка и начинается система
Пять проверок дают картину по одному тексту, а завтра приходит новый файл, и всё начинается заново: те же пять заходов на каждую новую статью складываются в часы. Проверил, поймал свой оборот, сохранил черновики - и по кругу
Разница между «проверил разок» и «спокойно работаешь» в том, что во втором случае у тебя собран порядок: где живут исходники, каким проходом чистится язык, как быстро текст доходит от заметки до готового файла. Это уже маленький конвейер, и собирается он руками один раз
Кстати, проверить текст на ошибки, тон и факты той же нейросетью можно в том же окне, куда ты вставлял задачу из первой проверки: два прохода вместо одного, а времени уходит столько же
Источники
- Anthropic, «How Claude's text watermark works», 14.08.2026 - anthropic.com
- Anthropic объявила о маркировке текстов, 11.08.2026, TechCrunch - techcrunch.com
- Подробности механики знака, 15.08.2026, TechCrunch - techcrunch.com
- Dathathri и соавторы, «Scalable watermarking for identifying large language model outputs», Nature, том 634, страницы 818-823, 23.10.2024 - nature.com
- Google DeepMind, страница технологии SynthID - deepmind.google
- Открытая реализация SynthID Text в библиотеке Transformers, 23.10.2024 - huggingface.co
- Разбор закона об искусственном интеллекте 243-ФЗ - ppt.ru
- Справка Сбера о маркировке ИИ-контента в России - developers.sber.ru
- Предложенные поправки о маркировке на стороне сервисов, 19.08.2026, «Ведомости» - vedomosti.ru
- Реакция рынка на объявление, 13.08.2026, Forbes - forbes.com
Памятка: что проверить в своём тексте
Сохрани себе
- Открыть свой файл и прогнать его на скрытые символы одной задачей в окне ИИ
- Убедиться, что нулей четыре: символы нулевой ширины, переносы, пробелы, смешанные слова
- Посчитать в тексте оборот «не X, а Y» и оставить его не чаще одного раза на страницу
- Поискать слова, которые ты повторяешь чаще людей: «тихо», «незаметно», «важно понимать»
- Не пытаться снять метку переписыванием: уцелеет треть слов, а смысл уедет
- Завести папку проекта и сохранять черновики с датой в названии
- Держать рядом свои исходники: заметки, замеры, фотографии, записи разговоров
- Сказать заказчику на входе, где работает помощник, а где ты
- Проверять первоисточник, а не пересказы: страница Anthropic открывается из России
- Помнить границу: проверить чужой текст на метку сегодня нельзя ничем
ИИ-Лагерь · мой обычный рабочий день
Я гоняю такой порядок каждый день
Свои статьи я проверяю тем же способом, который показал выше, и учу тому, что работает у меня, а не тому, что красиво выглядит на слайде. Начать можно сегодня, доустанавливать ничего не нужно
Частые вопросы
Ставит ли Claude водяной знак на каждый текст?
Anthropic объявила 11 августа 2026 года, что новые модели Claude будут генерировать текст со встроенной меткой, а моделям, вышедшим до 2 августа 2026 года, её добавляют постепенно. Метка включена по всему миру и работает в чате, в редакторе кода и при обращении через ключ доступа
Как проверить свой текст на водяной знак Claude?
Проверить саму метку сегодня нельзя: ключ есть только у Anthropic, публичная проверка обещана без даты. Проверяются соседние вещи: скрытые символы, повторяющиеся обороты и доля слов, уцелевших после переписывания. Первая проверка делается одной задачей в любом окне с нейросетью
Есть ли в тексте от нейросети невидимые символы?
Нет. Anthropic пишет дословно, что в текст ничего не добавляется и скрытых символов там нет. Я прогнал 349 078 знаков своих статей 19 августа 2026 года: символов нулевой ширины ноль, слов со смешанным алфавитом ноль, особых пробелов ноль
Убирается ли метка, если переписать текст своими словами?
Лёгкая правка её не снимает, полная замена каждого слова снимает - так формулирует сама Anthropic. На практике полная замена почти недостижима: в моём замере после старательного переписывания абзаца уцелел 31 процент разных слов, потому что названия, предлоги и служебные слова заменить нечем
Заметит ли водяной знак Антиплагиат или другой сервис проверки?
Сторонние сервисы работают другим способом: ключа Anthropic у них нет, и они ловят приметы в манере письма. Anthropic называет две такие приметы прямо: конструкцию «this isn't [X], it's [Y]», по-русски «это не X, а Y», и слово «quietly», которое машина ставит чаще людей. Заявлений о доступе таких сервисов к ключу нет, и проверить это утверждение нечем
Что метка доказывает в споре с заказчиком?
Только вероятность участия Claude в тексте. Она не отличает «написал» от «сильно поправил», не называет человека или компанию и не меняет права на текст. Спор об авторстве решается ходом работы: черновиками по датам и исходниками
Работает ли метка на текстах, полученных из России?
Да, метка включена глобально и от способа входа не зависит. При этом сам чат из России не открывается: 19 августа 2026 года запрос с московского адреса увёл меня на страницу о недоступности приложения в регионе
Вайбмаркетинг и вайбкодинг для тех, кто начинает с нуля. Разбираю ИИ-инструменты по шагам и показываю на своих проектах
Читайте также
Как проверить текст на ИИ: признаки, что писала нейросеть
Приметы машинного текста, которые видит человек без всякого ключа
Текст нейросети: как убрать слова-маркеры ИИ и сделать его живым
Что именно вычищать в тексте после нейросети, по списку
Как очеловечить текст нейросети: 8 промптов
Готовые формулировки, которые меняют манеру письма, а не отдельные слова
Как проверить текст через ИИ: 4 слоя проверки до отправки
Второй проход по тому же файлу: что стоит проверить перед отправкой